
【大模型Wiki】02 · 从 GPT 到大模型时代(GPT-1 → GPT-6)
从 GPT 到大模型时代(GPT-1 → GPT-6)
这篇 Wiki 沿着"GPT 家族"的演进主线,串起整个大模型时代的关键范式转变:从 GPT-1 的两段式"预训练+微调",到 GPT-2 的 zero-shot 提示,到 GPT-3 的 few-shot / 上下文学习,再到以 RLHF 为代表的人类对齐,以及 2024 年以后多模态、推理模型与 Agent 的浪潮。读完后你会理解一句话:大模型的能力,是"数据规模 × 架构 × 训练范式"三者共同推出来的。
1、OPENAI简介
OpenAI总部位于旧金山,由特斯拉的马斯克、Sam Altman及其他投资者在2015年共同创立,目标是开发造福全人类的AI技术。而马斯克则在2018年时因公司发展方向分歧而离开。
此前,OpenAI 因推出 GPT系列自然语言处理模型而闻名。从2018年起,OpenAI就开始发布生成式预训练语言模型GPT(Generative Pre-trained Transformer),可用于生成文章、代码、机器翻译、问答等各类内容。每一代GPT模型的参数量都爆炸式增长,堪称"越大越好"。2019年2月发布的GPT-2参数量为15亿,而2020年5月的GPT-3,参数量达到了1750亿。从下面的参数量可以看出,这是个多么恐怖的模型。
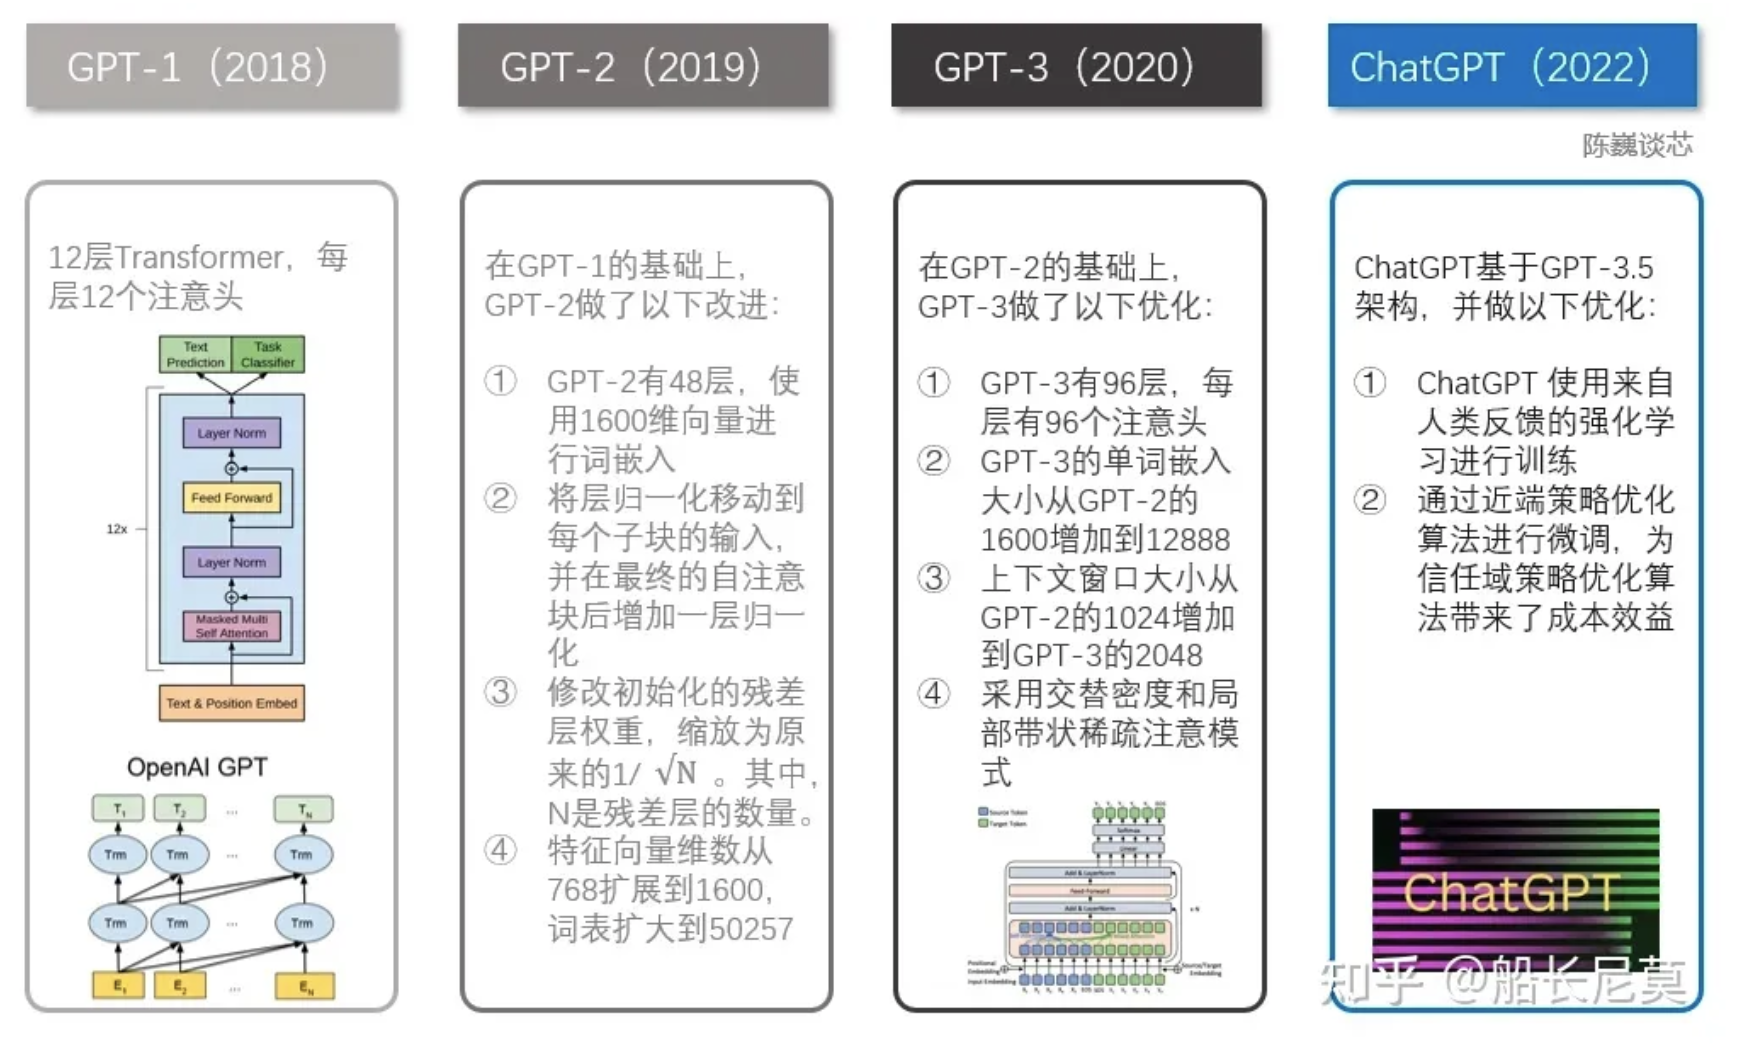
补充几点背景(帮助理解后面"为什么是 OpenAI 跑通这条路"):
- OpenAI 早期是非营利组织,后设立"利润上限(capped-profit)"的 OpenAI LP 以吸收巨额算力投资。大模型本质是资本与算力密集型事业,GPT-3 级别的训练需要成千上万张 GPU 和数千万美元,这天然筛掉了大多数参与者。
- "Scaling Law(缩放定律)"是这条路线的理论信仰:只要算力、数据、参数同步放大,模型性能(通常用 loss 衡量)会平滑下降(提升)。GPT 系列是这一信念最激进的实践者。
2、GPT-1介绍
论文链接:GPT Improving Language Understanding by Generative Pre-Training. 2018.
2018年由OpenAI的研究团队发布的一篇论文。它介绍了一种名为"生成式预训练"(Generative Pre-Training,简称GPT)的新型语言模型,该模型通过在大规模语料库上进行训练,能够学习自然语言的模式和规律,从而实现更好的语言理解。
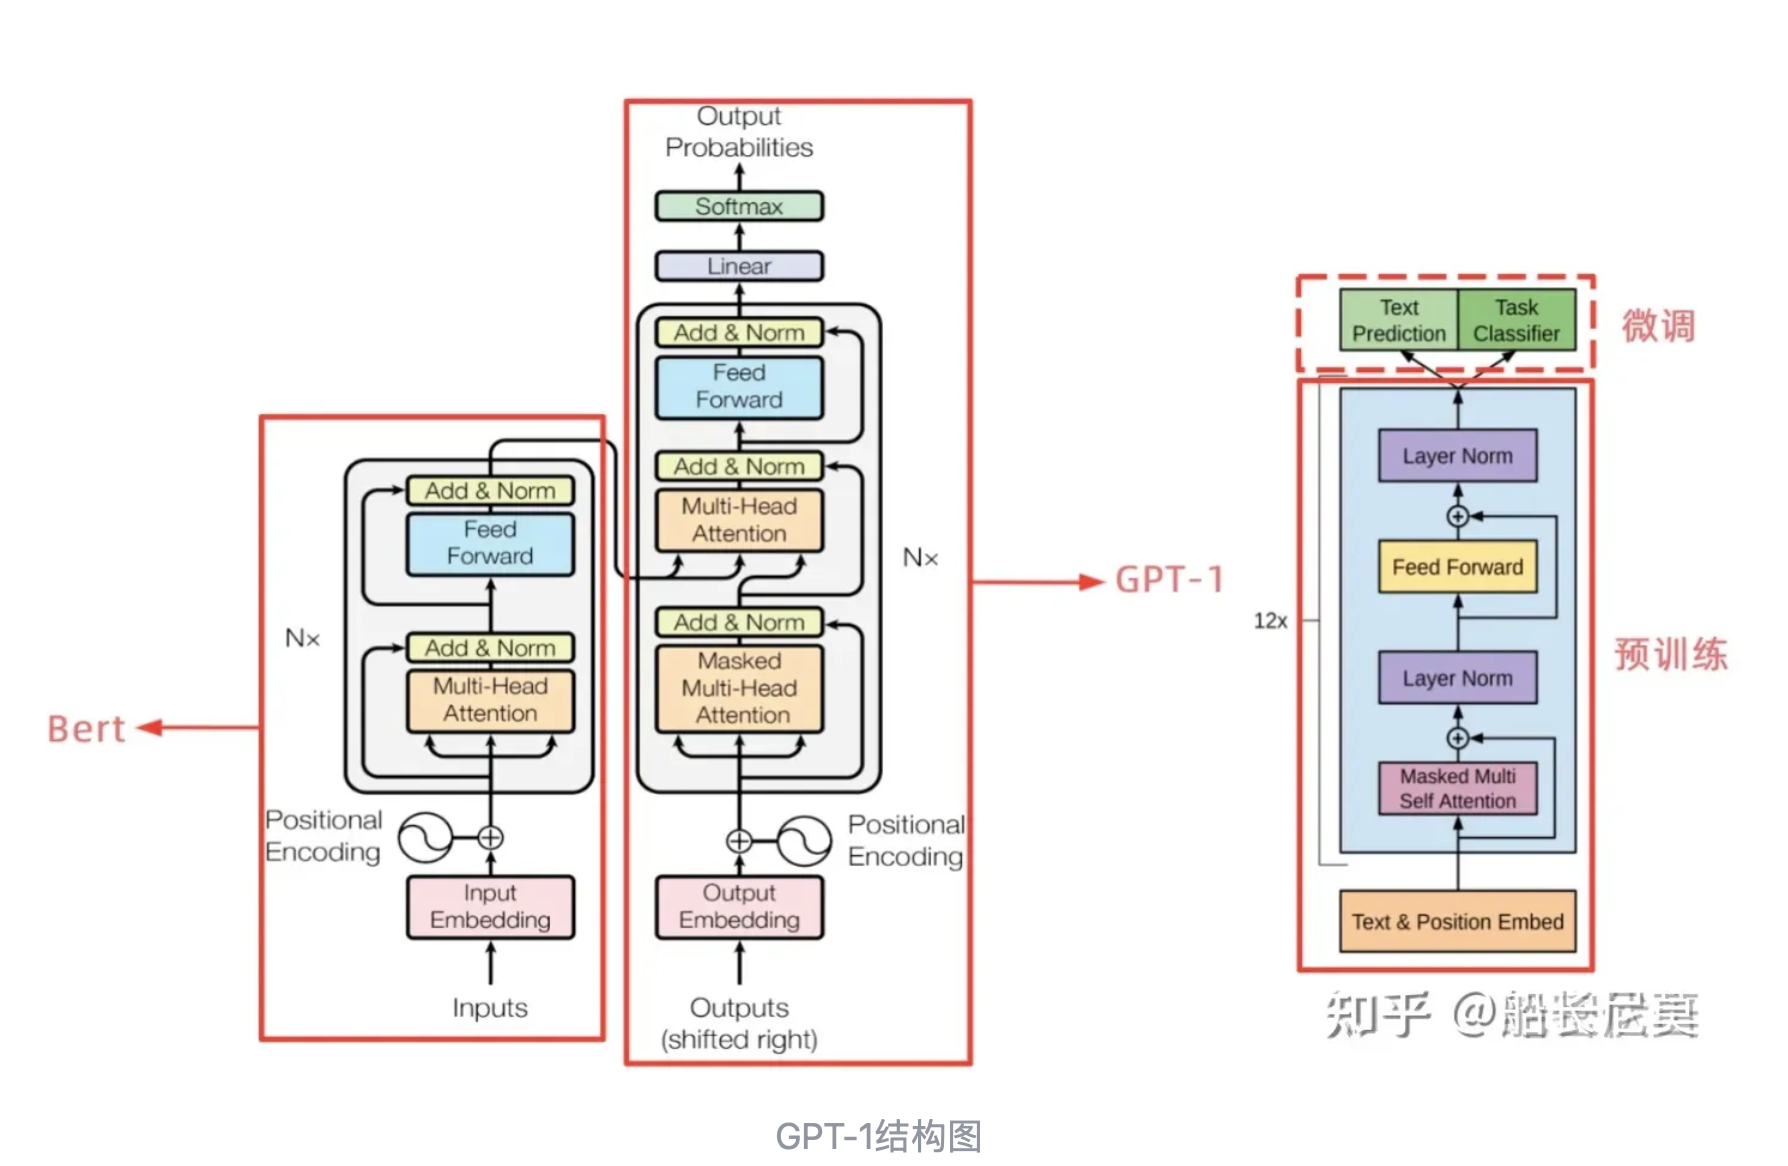
GPT模型是一种基于神经网络的自回归语言模型。该模型使用了一个称为"Transformer"的架构,这是一种新型的序列到序列模型,能够在处理长序列数据时避免传统的循环神经网络(Recurrent Neural Network,RNN)中存在的梯度消失问题。Transformer架构中的关键组件包括多头注意力机制和残差连接等。GPT使用了Transformer的解码器部分。
以下是GPT1的主要技术特点:
基于Transformer架构:GPT1采用了Transformer架构,其中包括多头自注意力机制和前向神经网络。这使得GPT1可以在处理自然语言时捕捉长距离依赖性,并且具有高效的并行性。
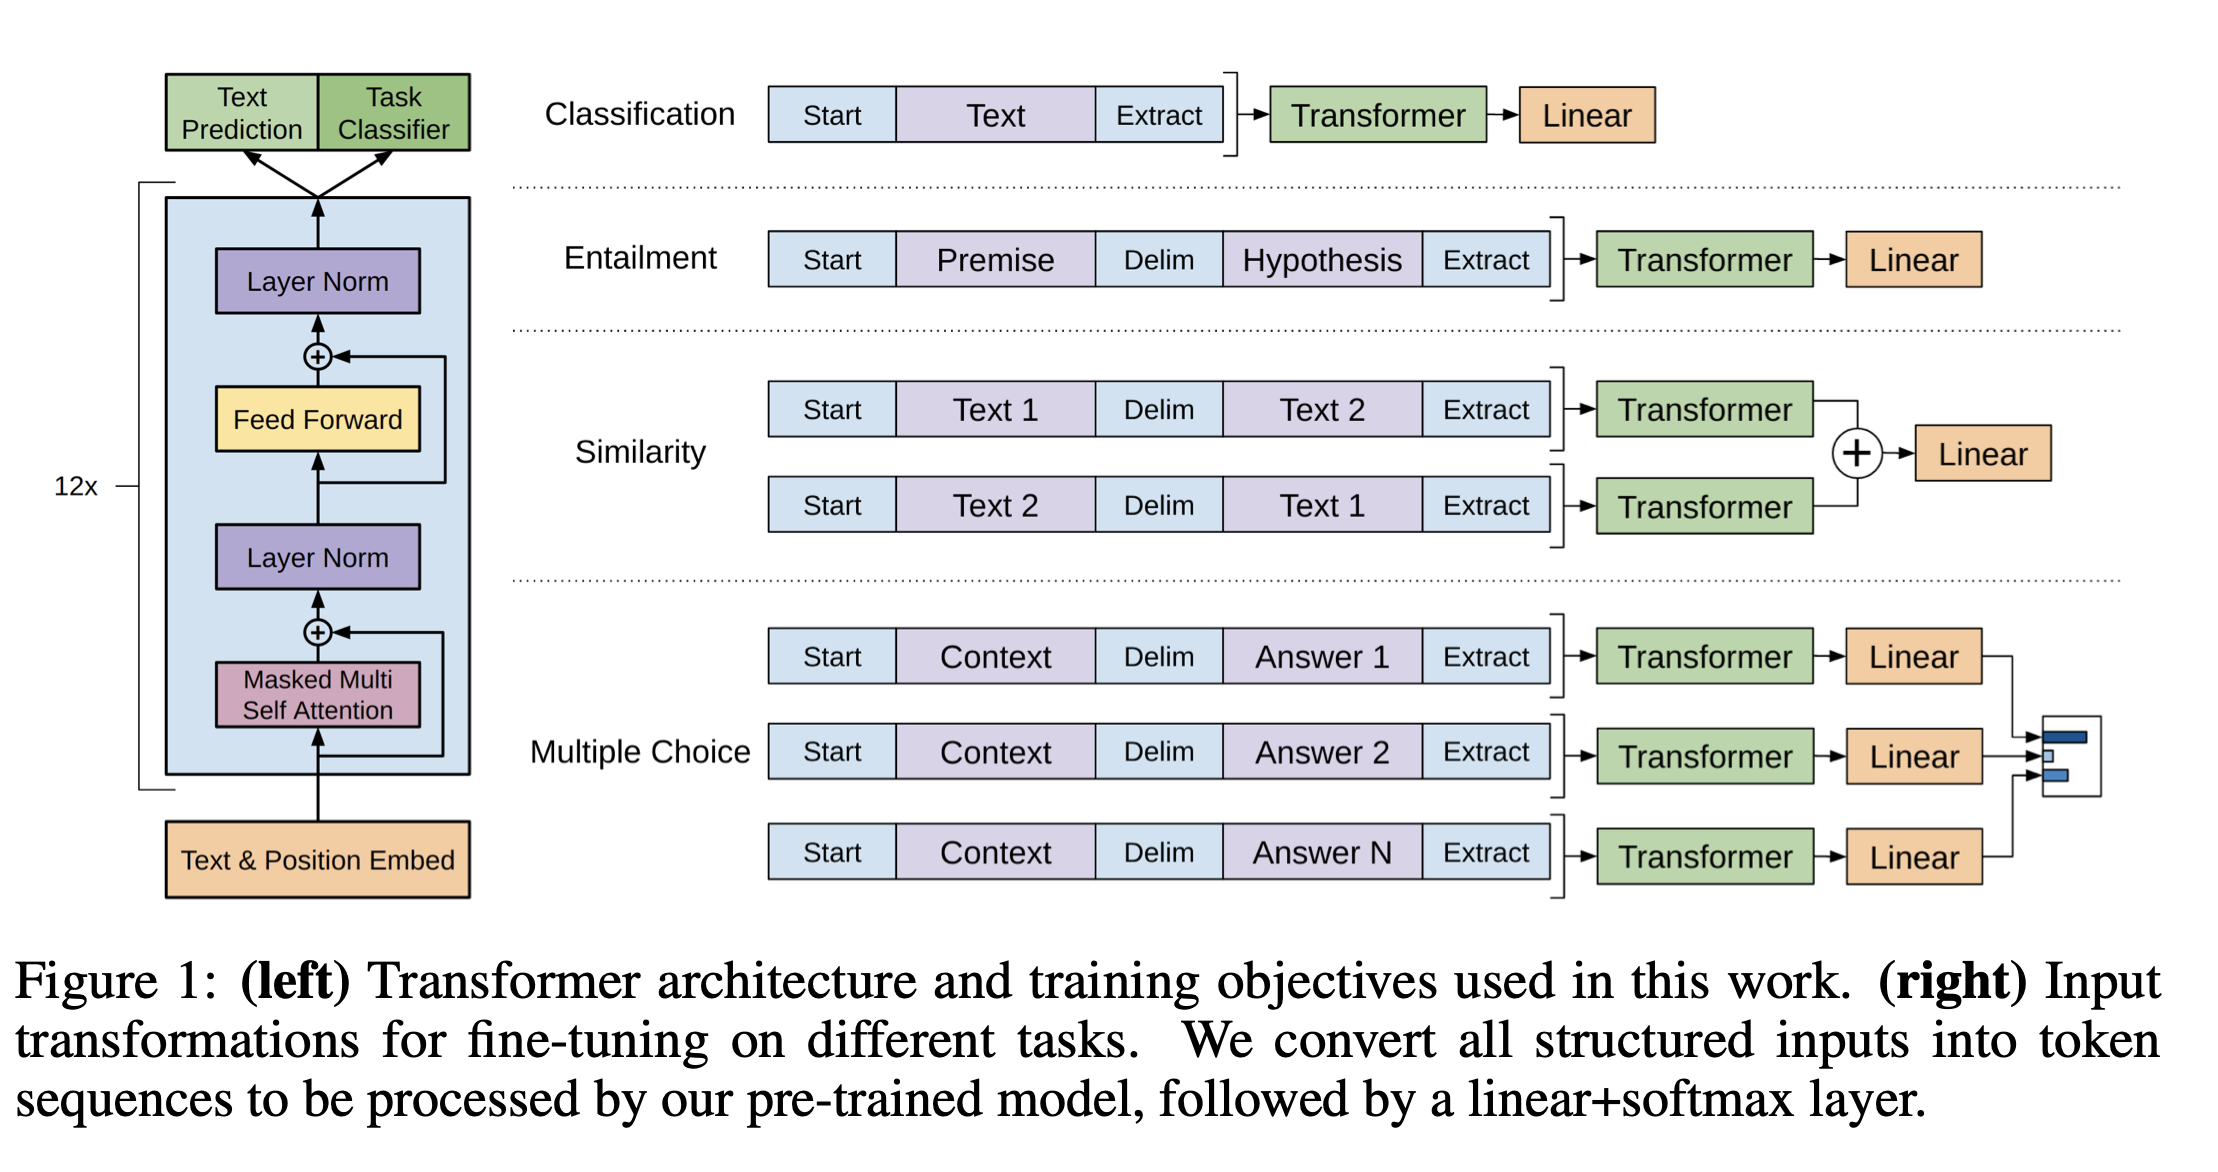
预训练技术:GPT-1使用了一种称为"生成式预训练"(Generative Pre-Training,GPT)的技术。预训练分为两个阶段:预训练和微调(fine-tuning)。在预训练阶段,GPT-1使用了大量的无标注文本数据集,例如维基百科和网页文本等。通过最大化预训练数据集上的log-likelihood来训练模型参数。在微调阶段,GPT-1将预训练模型的参数用于特定的自然语言处理任务,如文本分类和问答系统等。
多层模型:GPT-1模型由多个堆叠的Transformer编码器组成,每个编码器包含多个注意力头和前向神经网络。这使得模型可以从多个抽象层次对文本进行建模,从而更好地捕捉文本的语义信息。通过使用上述预训练任务,研究团队成功地训练出了一个大规模的语言模型GPT。该模型在多项语言理解任务上取得了显著的成果,包括阅读理解、情感分类和自然语言推理等任务。
通过微调GPT模型,可以针对特定的任务进行优化,例如文本生成、机器翻译和对话系统等。
2.1、GPT-1 的关键事实与意义
- 规模与结构:GPT-1 约 1.17 亿(原文概称"1 亿")参数,是一个 12 层、隐藏维度 768 的 Decoder-only Transformer(只用解码器 + Causal Mask,没有编码器)。
- 预训练数据:BooksCorpus,约 5GB、7000 余本未出版书籍文本,长文本多,适合学习长距离依赖。
- 训练目标:标准的自回归语言建模,最大化"在给定前文的条件下,下一个词"的似然(log-likelihood)。这正是后来所有 GPT 系的统一目标。
- 范式贡献:首次把"无监督生成式预训练 + 有监督任务微调"跑通并验证有效。12 个 NLP 任务上取得 SOTA(当时)。它证明了"先广泛读书、再针对任务精修"这条路可行,是后续一切的基石。
注意:原文写"GPT-1 由多个堆叠的 Transformer 编码器组成"是通俗说法;严格说 GPT 用的是 Transformer 解码器(Decoder),因为只有单向因果注意力。这一点在 01 篇已详述。
3、GPT2介绍
Language Models are Unsupervised Multitask Learners. 2018.
GPT-2和GPT-1的区别在于GPT-2使用了更多的网络参数和更大的数据集,以此来训练一个泛化能力更强的词向量模型。GPT-2相比于GPT-1有如下几点区别:
- 主推zero-shot,而GPT-1为pre-train+fine-tuning;
- 模型更大,参数量达到了15亿个,而GPT-1只有1亿个;
- 数据集更大,WebText数据集包含了40GB的文本数据,而GPT-1只有5GB;
- 训练参数变化,batch_size 从 64 增加到 512,上文窗口大小从 512 增加到 1024;
3.1、Zero-Shot方法
在 GPT-1 中,模型预训练完成之后会在下游任务上微调,在构造不同任务的对应输入时,我们会引入开始符(Start)、分隔符(Delim)、结束符(Extract)。虽然模型在预训练阶段从未见过这些特殊符号,但是毕竟有微调阶段的参数调整,模型会学着慢慢理解这些符号的意思。
现在,在 GPT-2 中,要做的是 zero-shot,也就是没有任何调整的过程了。这时我们在构造输入时就不能用那些在预训练时没有出现过的特殊符号了。所幸自然语言处理的灵活性很强,我们只要把想要模型做的任务 "告诉" 模型即可,如果有足够量预训练文本支撑,模型想必是能理解我们的要求的。
举个机器翻译的例子,要用 GPT-2 做 zero-shot 的机器翻译,只要将输入给模型的文本构造成 translate english to chinese, [englist text], [chinese text] 就好了。比如:translate english to chinese, [machine learning], [机器学习] 。这种做法就是日后鼎鼎大名的 prompt。下面还有其他任务的zero-shot形式:
3.2、GPT-2 为什么是"分水岭"
GPT-2 最重要的不是结构创新(它和 GPT-1 几乎同构,只是更深更宽),而是提出了一个影响深远的观点:
"任何有监督任务,都是无监督语言模型的一个子集。"(all tasks are language modeling)
换句话说,只要把任务用自然语言描述成"续写"的形式,一个足够大的语言模型就能直接做,不需要再为每个任务单独微调。这就是后来 Prompt / 提示学习 的思想雏形。GPT-2 当时生成的假新闻足以以假乱真,甚至被一些平台限制使用——它第一次让业界直观感受到"规模本身会带来能力"。
- 规模:最大版本 15 亿(1.5B)参数,48 层。
- 数据:WebText,从 Reddit 外链的高赞网页爬取并清洗,约 40GB、800 万文档,质量远高于随机网页。
- 上下文:1024 token 窗口。
- 谨慎发布:OpenAI 当时担心滥用,只开源了小版本,最大模型分阶段放出。
4、GPT3介绍
Language Models are Few-Shot Learners
GPT模型指出,如果用Transformer的解码器和大量的无标签样本去预训练一个语言模型,然后在子任务上提供少量的标注样本做微调,就可以很大的提高模型的性能。GPT2则是更往前走了一步,说在子任务上不去提供任何相关的训练样本,而是直接用足够大的预训练模型去理解自然语言表达的要求,并基于此做预测。但是,GPT2的性能太差,有效性低。
GPT-3是一种语言模型,它可以通过少量的样本进行学习,因此被称为"Few-Shot Learner"。和人类一样,GPT-3不需要完全不看任何样例就能学习,只需要看一小部分样例就能学会更多的知识。GPT-3的体量非常庞大,因此在下游任务中进行fine-tune的成本很高。为了解决这个问题,GPT-3使用了" In-Context Learning"的方式,在不进行梯度更新或fine-tune的情况下,直接在上下文中进行学习。
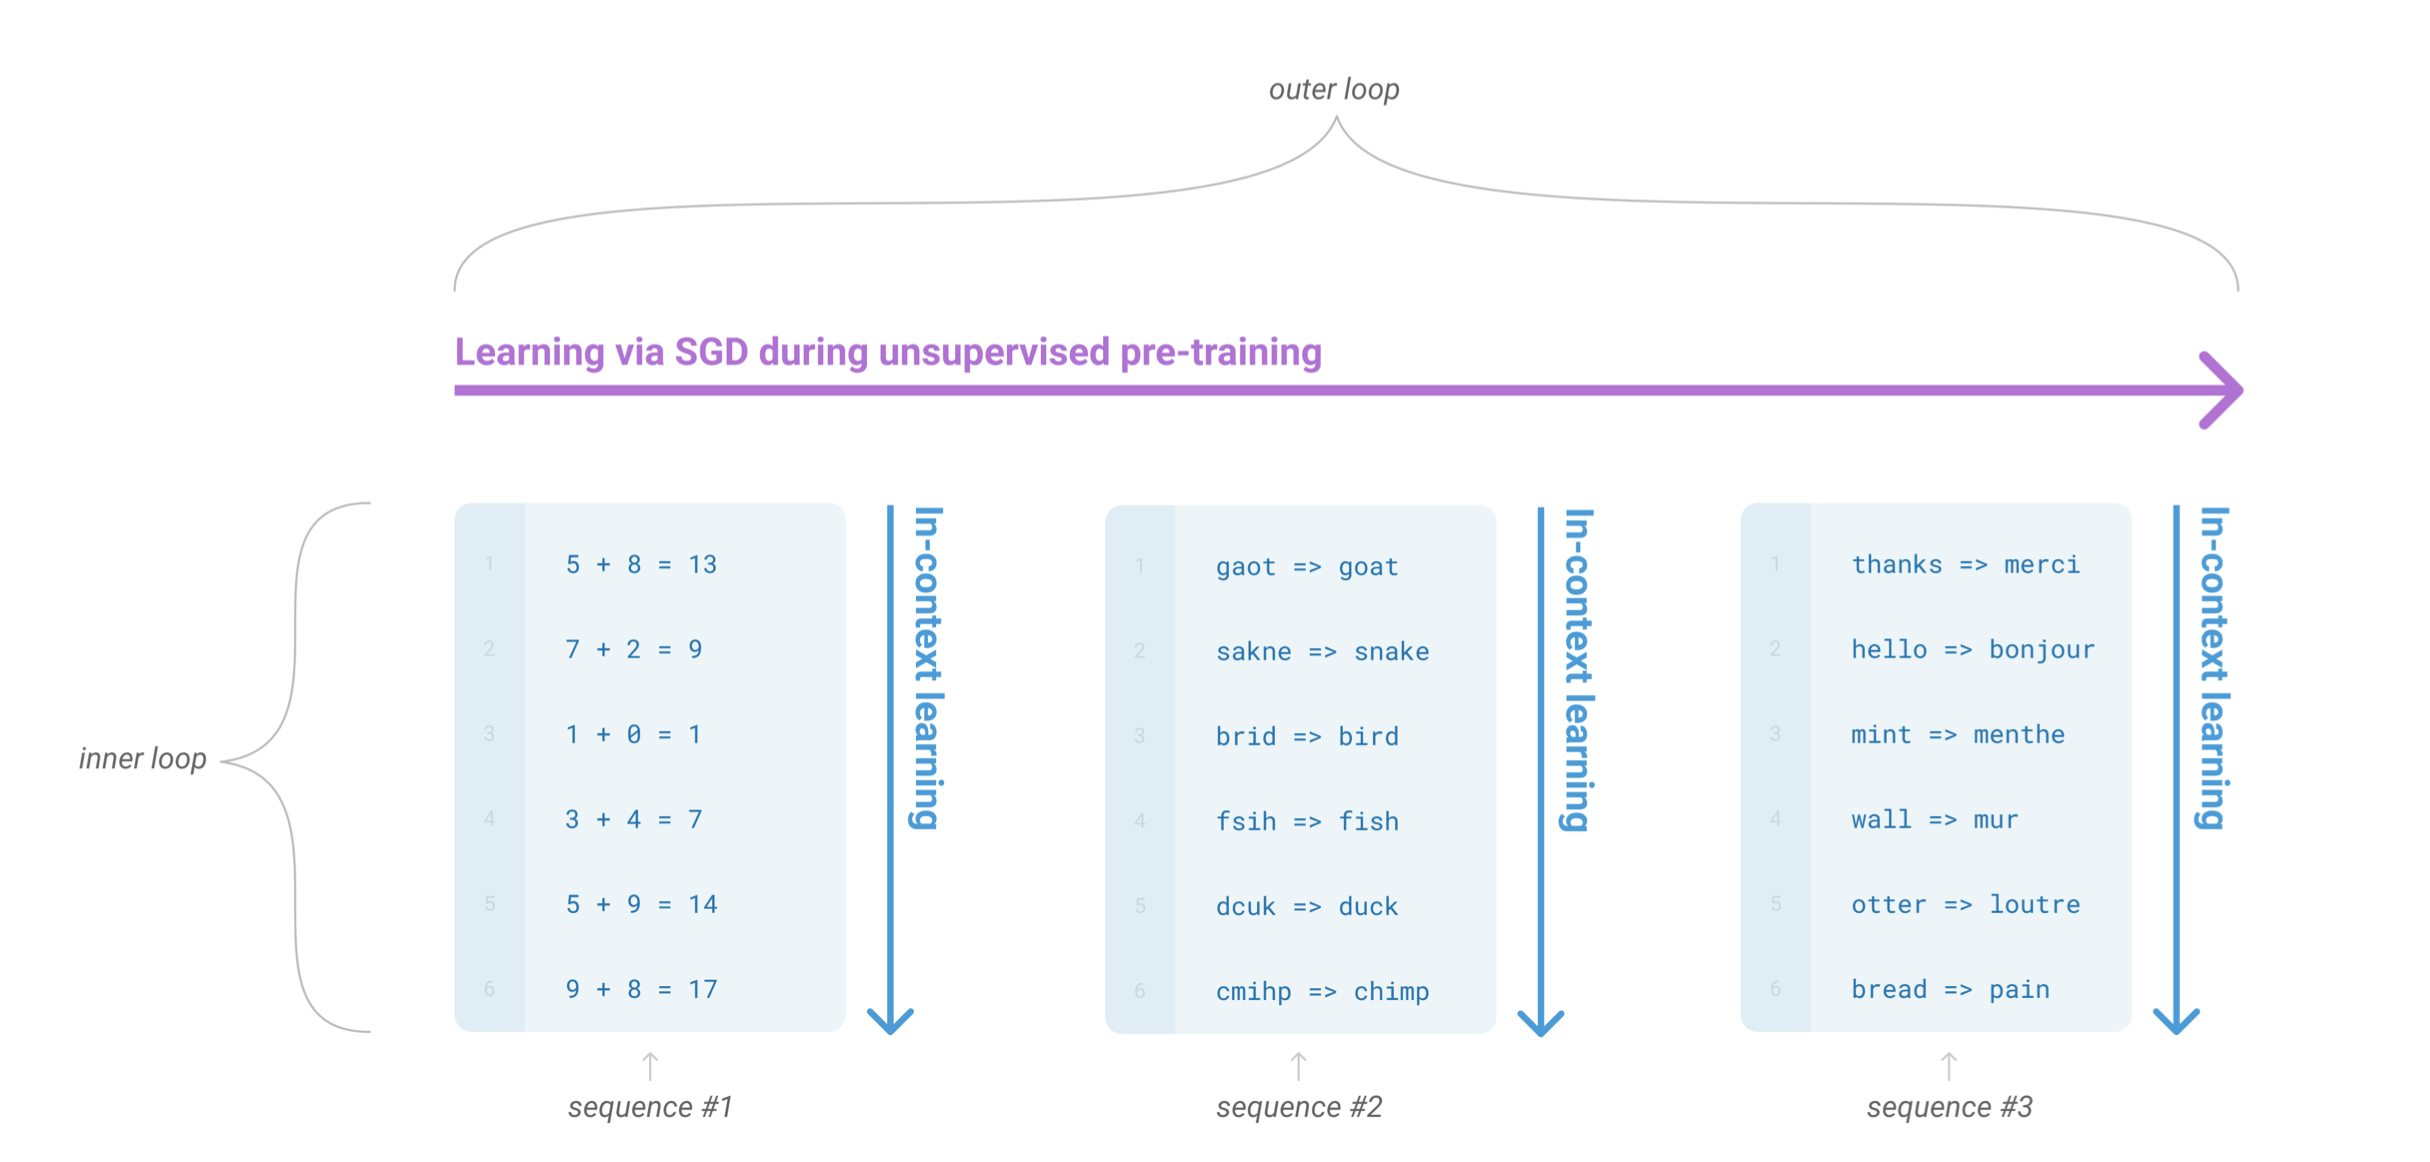
4.1、GPT-3的few-shot learning是不会做梯度下降,它是怎么做的:
只做预测,不做训练,我们希望Transformer在做前向推理的时候,能够通过注意力机制,从我们给他的输入之中抽取出有用的信息,从而进行预测任务,而预测出来的结果其实也就是我们的任务指示了。这就是上下文学习(In context learning)。
要理解in-context learning,我们需要先理解meta-learning(元学习)。对于一个少样本的任务来说,模型的初始化值非常重要,从一个好的初始化值作为起点,模型能够尽快收敛,使得到的结果非常快的逼近全局最优解。元学习的核心思想在于通过少量的数据寻找一个合适的初始化范围,使得模型能够在有限的数据集上快速拟合,并获得不错的效果。
为了体现ICL,OpenAI用三个方法来评估他:
1、Few Shot Learning(FS):用自然语言告诉模型任务;对每个子任务,提供10~100个训练样本。
2、One-shot Learning(1S):用自然语言告诉模型任务,而后只给该任务提供1个样本。
3、Zero-shot learning(0S):用自然语言告诉模型任务,但一个样本都不给**。
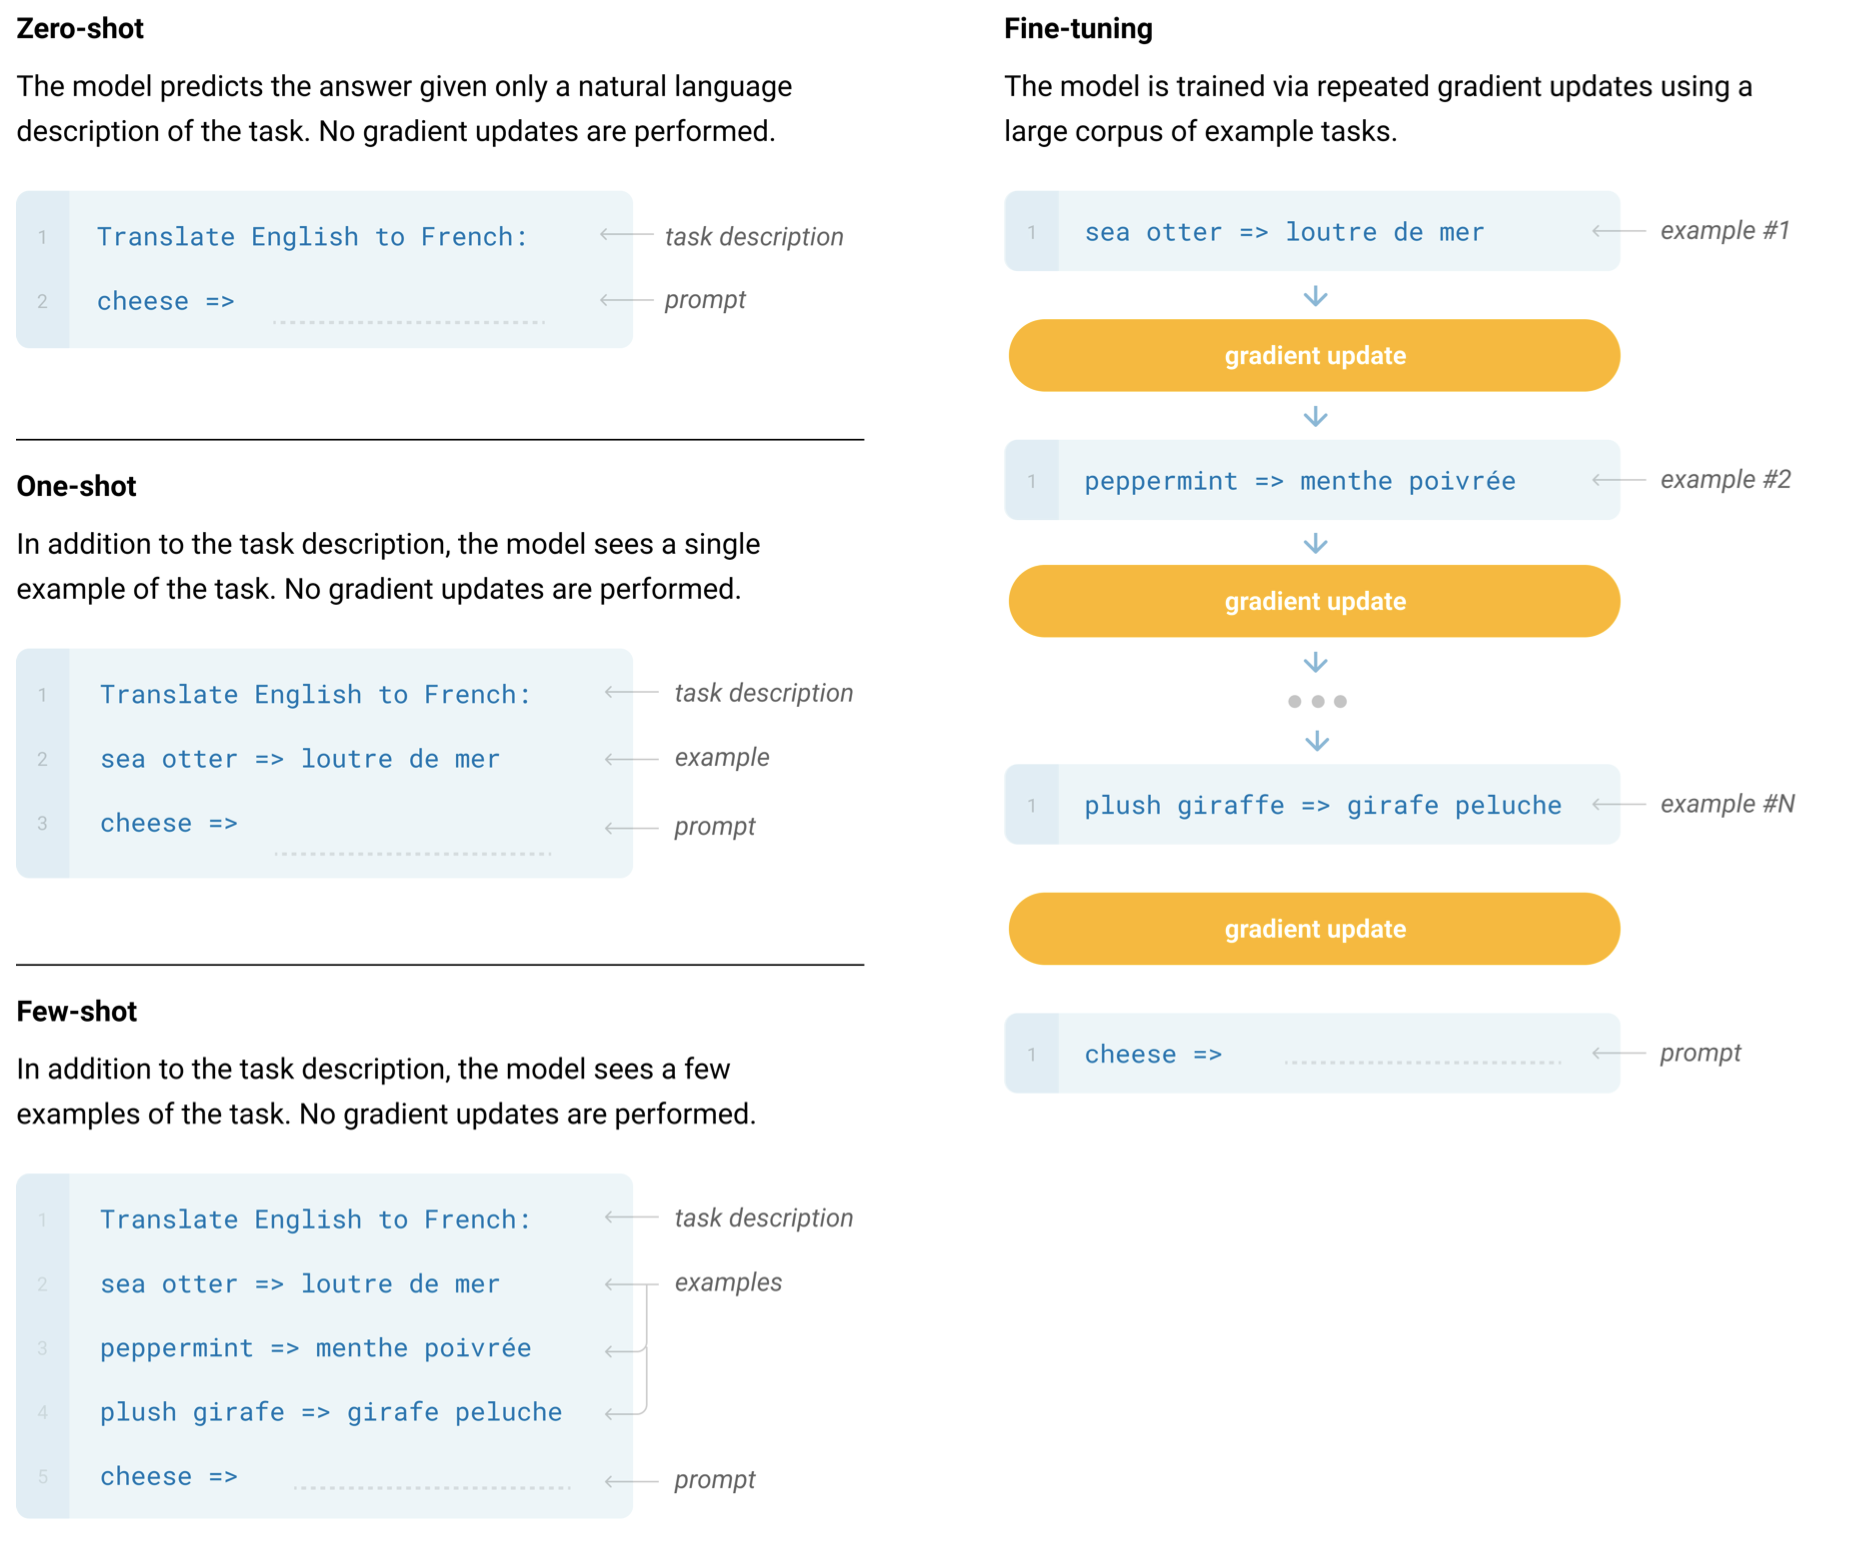
这个模式的缺陷:
- GPT-3的输入窗口长度是有限的,不可能无限的堆叠example的数量,即有限的输入窗口限制了我们利用海量数据的能力。
- 每次做一次新的预测,模型都要从输入的中间抓取有用的信息;可是我们做不到把从上一个输入中抓取到的信息存起来,存在模型中,用到下一次输入里。
4.2、GPT-3 的关键事实与"三范式"收束
- 规模:1750 亿(175B)参数,96 层,上下文窗口 2048 token。训练数据约 3000 亿(300B)token,来自 CommonCrawl、WebText2、Books、Wikipedia 等多源混合。
- 核心贡献——In-Context Learning(ICL,上下文学习):不需要改任何权重,只要把"任务说明 + 若干示例 + 待预测样本"塞进 prompt,模型就能照着示例的格式作答。它把"学习"从"更新参数"变成了"在上下文里检索模式"。
- 元学习视角:GPT-3 论文把 ICL 解释为"隐式微调"——预训练阶段模型事实上在学"如何在前向过程中利用上下文示例",相当于把海量任务的分布压缩进了参数,推理时给出几个例子就激活对应能力。
至此,GPT 系列把三代范式清晰呈现出来,也为后面 ChatGPT 的"对齐"埋下伏笔:
| 范式 | 代表 | 是否需要梯度更新 | 核心思想 |
|---|---|---|---|
| 预训练 + 微调 | GPT-1 | 是(fine-tune) | 先读书,再为每个任务改参数 |
| Zero-shot 提示 | GPT-2 | 否 | 用自然语言描述任务,直接续写 |
| Few-shot / ICL | GPT-3 | 否 | 给少量示例,模型在上下文里学 |
| 人类对齐(RLHF) | InstructGPT/ChatGPT | 是(PPO) | 用人类偏好把"会写"变成"写得好、听话" |
注意:zero-shot / few-shot 解决的是"能力涌现与任务适配",但模型仍然可能输出有害、不服从指令、答非所问的内容。这正是 RLHF 要解决的——让模型不仅"强",而且"对齐人类意图"。
4.3、"涌现能力"(Emergent Abilities)与缩放定律
GPT-3 之后一个被反复讨论的现象是涌现:很多能力(如多步推理、代码生成、翻译小语种)并不是随参数平滑提升,而是在模型规模/数据越过某个临界点后"突然"出现。这带来两点启示:
- 量变引起质变:同一架构,只把参数和数据放大一个数量级,就可能解锁之前完全不具备的任务能力。这正是"越大越好"信念的经验来源。
- 但涌现不是魔法:后来的研究指出,部分"涌现"是评测指标(如精确匹配)的非连续性造成的;若换成更平滑的指标,能力提升其实是连续的。真正稳健的是 Scaling Law:在固定计算预算下,模型参数量 N、训练 token 数 D、算力 C 之间存在可预测的幂律关系,loss 随规模平滑下降。
理解这两点,就能既相信"规模有用",又不被"堆参数一定出奇迹"误导——数据质量、训练方法与目标设计,决定规模能不能被有效"吸收"。
4.4、GPT 系列关键节点一览(公开信息)
| 版本 | 时间 | 大致参数量 | 标志性范式 |
|---|---|---|---|
| GPT-1 | 2018.06 | ~1.17 亿 | 预训练 + 微调 |
| GPT-2 | 2019.02 | 15 亿 | zero-shot 提示 |
| GPT-3 | 2020.05 | 1750 亿 | few-shot / ICL |
| GPT-3.5 | 2022 | 未公开 | 指令微调 + RLHF 雏形(ChatGPT 基座) |
| GPT-4 | 2023.03 | 未公开 | 多模态、强推理 |
| o 系列 | 2024+ | 未公开 | test-time compute / 长思考 |
说明:OpenAI 自 GPT-3 之后不再公开参数量,因此 3.5 及以后仅标注能力与范式,不臆测数字。
5、GPT-4 及以后:多模态、推理与 Agent 时代
标题写的是 "GPT-1 → GPT-6",下面把 GPT-3 之后的关键走向补上(OpenAI 未公开后续模型的参数量与架构细节,因此这里只描述能力与范式,不编造数字)。
- GPT-4(2023.03):首个广为人知的多模态大模型,可接受图像+文本输入,输出文本;在各类专业/学术考试上达到人类水平附近,逻辑推理与可靠性显著强于 GPT-3.5。OpenAI 未公开其参数规模与是否采用 MoE,但业界普遍推测其为大规模稀疏/多专家架构以兼顾能力与成本。
- GPT-4o / omni 系列:进一步把语音、视觉、文本统一进一个模型,追求低延迟实时交互。
- 推理模型(o1 / o3 等 "thinking" 系列):不再只靠"一次性输出",而是引入 test-time compute(测试期计算)——模型在回答前先做一长串内部"思维链(CoT)"推理,再给出答案。这把"能力"从"训练期吃数据"扩展到"推理期吃算力",在数学、代码、科学题上带来质变。
- GPT-5 及以后(趋势):行业主线是"更强的通用推理 + 工具调用(Agent)+ 多模态统一"。所谓 "GPT-6" 更多是代际演进的代称,方向集中在:(1)更长上下文与更稳的外推;(2)更可靠的 Agent 长任务执行;(3)更省成本的稀疏/蒸馏/量化架构。具体数字以官方发布为准,本文不臆测。
这一阶段的本质变化可以概括为:训练期吃数据 → 后训练吃对齐(SFT+RLHF/RLAIF)→ 推理期吃计算(long thinking / Agent 多步搜索)。
补充理解几个关键转变:
- 多模态如何"塞进"同一个 Transformer:主流做法是用一个视觉编码器(如 ViT)把图像切成若干 patch,编码成和文本 token 同维度的向量序列,然后和文本 token 拼在一起喂给同一个 Transformer。模型不需要为"看图"单独设计结构,而是把图当成"另一种语言的 token"来统一处理——这也是 GPT-4V、Qwen-VL 等的共同思路。
- 推理模型为什么有效:传统模型"想一下立刻答",思维链(CoT)研究发现,让模型先写出中间推理步骤,再给结论,复杂题正确率会大幅提升。o1/R1 把这一步"内化"并做长:在给出最终答案前,模型自发生成长段、可回溯的内部思考(test-time compute),并通过 RL 被训练成"愿意且善于多想"。代价是单次回答更慢更贵。
- Agent 化:当模型具备稳定的指令遵循 + 工具调用 + 长上下文记忆后,就能被外部 Harness 驱动去"多步完成任务"(查资料→写代码→跑测试→改错)。这把大模型从"问答机"升级为"可执行任务的智能体"。
6、开源阵营与中国力量
| 系列 | 特点 |
|---|---|
| Llama(Meta) | 最早带动开源生态(1→2→3→4),学术与产业基座 |
| DeepSeek(深度求索) | V3 以极致的 MoE/MLA 工程把训练成本打到一个量级;R1(2025.01) 用纯强化学习(GRPO)复现 o1 级推理并开源权重,引发全球性关注;V3.2 进一步强化 Agent 能力 |
| Qwen 通义(阿里) | Qwen2.5/3 全尺寸开源,长上下文、多模态、Coder/Math 全家桶,全球下载量最大的开源模型家族之一 |
| GLM(智谱) | ChatGLM 系列演进至 GLM-4/GLM-4.5,中英双语长于 Agent 任务 |
| 其他 | Mistral、Kimi(K2,MoE)、MiniMax、Gemma(Google 开源)等 |
补充理解:
- 开源的意义:Llama 把"接近 GPT-3.5 水平"的权重开放出来,直接催生了无数下游应用与中文社区微调(如 ChatGLM、Baichuan)。开源降低了门槛,也让"私有化部署 + 行业微调"成为可能。
- 中国力量的共性:不完全追求最大参数,而是在性价比、长上下文、中文/代码/数学专项、Agent 工具调用上做差异化;DeepSeek 更是用 MLA/MoE 工程把训练成本压到同性能模型的数分之一,并用 GRPO 证明了"纯 RL 也能激发复杂推理"。
实践上如何选基座:个人/小团队做应用,通常优先选开源、有社区生态、尺寸适配显存的模型(如 Qwen、Llama、DeepSeek 的小尺寸版),在自有数据上做轻量微调或 RAG,而不是从头训练。是否自训大模型,取决于是否有独有海量数据、充足算力与明确的差异化需求——对绝大多数业务,微调/蒸馏/检索增强远比"造一个 GPT"现实。
7、对齐技术的演进:RLHF 之后
| 方法 | 一句话 | 出处 |
|---|---|---|
| RLHF + PPO | 在线强化学习,需要 RM + 价值模型,工程复杂 | InstructGPT |
| DPO | 直接偏好优化:跳过 RM 和 RL,用偏好对做类似监督学习的闭式损失 | 2023,Llama3 等广泛采用 |
| GRPO | 组相对策略优化:同一 prompt 采一组回答,用组内平均做 baseline 省掉价值模型,纯 RL 也能激发推理 | DeepSeek-Math/R1 |
| RLVR | 可验证奖励(代码能跑通、数学答案对错)做 RL,比人工偏好更可靠 | R1、Qwen3 |
一句话总结这四年的演进:预训练吃数据 → 后训练吃对齐(SFT+RLHF)→ 推理期吃计算(test-time compute / 长思考);而 2025-2026 的前沿是 Agent 时代——模型不再只答题,而是被 Harness 驱动持续使用工具完成长任务(见本 Wiki 08-10 篇)。
补充:
- RLAIF(AI 反馈替代人类反馈):用更强的模型(或规则)生成偏好标签来训练 RM,缓解人工标注成本高、一致性差的问题。
- 为什么 DPO 流行:PPO 要同时维护策略模型、参考模型、奖励模型、价值模型四个模型,工程极重;DPO 把"偏好对"直接变成一个分类式损失,只需策略+参考两个模型,训练简单很多,因此被广泛采用。
- GRPO 的精髓:不训练单独的价值网络,而是对同一问题采样一组回答,用这组回答的平均奖励当 baseline,从而估计优势(advantage)。这大幅降低了显存与实现复杂度,是 DeepSeek-R1 用纯 RL 做出推理能力的关键。
8、最小可运行示例与训练/推理流程
下面给出面向理解的实现片段(非生产级,但能跑通思路)。
8.1、一个极简的 GPT 风格因果语言模型(PyTorch)
import torch
import torch.nn as nn

class TinyGPT(nn.Module):
    def __init__(self, vocab_size=1000, d_model=128, n_heads=4,
                 n_layers=4, max_len=512):
        super().__init__()
        self.token_emb = nn.Embedding(vocab_size, d_model)
        self.pos_emb   = nn.Embedding(max_len, d_model)
        # 用现成的 TransformerDecoderLayer 拼一个 Decoder-only 骨架
        layer = nn.TransformerDecoderLayer(
            d_model=d_model, nhead=n_heads,
            dim_feedforward=4*d_model, batch_first=True)
        self.decoder = nn.TransformerDecoder(layer, num_layers=n_layers)
        self.lm_head = nn.Linear(d_model, vocab_size)

    def forward(self, x):  # x: (batch, seq_len)  token id
        b, s = x.shape
        pos = torch.arange(s, device=x.device).unsqueeze(0)
        h = self.token_emb(x) + self.pos_emb(pos)        # 词向量 + 位置向量
        # 因果掩码:第 i 个位置只能看 <= i 的位置
        causal = torch.triu(torch.ones(s, s), diagonal=1).bool()
        h = self.decoder(h, h, tgt_mask=causal)          # 自回归(K/V 同源)
        return self.lm_head(h)                           # (batch, seq_len, vocab)

# 训练一步的骨架
model = TinyGPT()
loss_fn = nn.CrossEntropyLoss()
opt = torch.optim.AdamW(model.parameters(), lr=3e-4)
x = torch.randint(0, 1000, (2, 32))          # batch=2, seq=32 的 token
logits = model(x)                            # 预测每个位置的下一个词
loss = loss_fn(logits[:, :-1].reshape(-1, 1000), x[:, 1:].reshape(-1))
loss.backward(); opt.step()
要点:tgt_mask 就是第 1 篇讲的 Causal Mask;logits[:, :-1] 与 x[:, 1:] 错一位,正好构成"用前文预测下一个词"的自回归目标。
8.2、预训练流程伪代码
输入: 海量文本语料 corpus, 词表 tokenizer
1. 把语料切分成 token 序列, 按 max_len 切段
2. 随机初始化 Transformer(Decoder-only) 参数 θ
3. for step in 1..N:
4.     batch = 随机采样一批 token 段 x  (形状 B×L)
5.     logits = model(x)                  # 前向, 内部 causal mask
6.     loss = CrossEntropy(logits[:,:-1], x[:,1:])   # 自回归 LM loss
7.     loss.backward(); optimizer.step()  # AdamW + 学习率预热/衰减
8. 得到预训练模型 base-LM
8.3、对齐(RLHF)三阶段流程伪代码
# 阶段一 SFT: 用人工示范 (prompt, good_answer) 微调 base-LM
for (x, y) in SFT_data:
    loss = CrossEntropy(model(x), y);  loss.backward(); step()
sft_model = model

# 阶段二 RM: 对同一 x 生成多个回答, 人工排序, 训练奖励模型
for (x, y_w, y_l) in comparison_data:   # y_w 优于 y_l
    r_w = RM(x, y_w);  r_l = RM(x, y_l)
    loss = -log(sigmoid(r_w - r_l));    loss.backward(); step()

# 阶段三 PPO: 用 RM 的奖励微调 sft_model
ref_model = copy(sft_model)
for x in prompts:
    y = ppo_model.generate(x)            # 采样回答
    r = RM(x, y) - β·KL(ppo_model||ref_model)   # 奖励 - KL 惩罚
    policy_gradient_update(ppo_model, r) # PPO 算法
8.4、推理(生成)流程伪代码
输入: 用户 prompt, 生成参数 T(温度), top_p, max_new_tokens
1. ids = tokenizer(prompt)
2. past_kv = None
3. for step in 1..max_new_tokens:
4.     logits, past_kv = model(ids, past_kv)   # 用 KV Cache 增量推理
5.     next_logits = logits[:, -1, :] / T       # 只看最后一个位置, 除温度
6.     probs = softmax(next_logits)
7.     next_id = sample(probs, top_p=top_p)     # 核采样
8.     ids = append(ids, next_id)
9.     if next_id == EOS: break
10. return tokenizer.decode(ids)
8.5、分词(Tokenizer / BPE)是怎么回事
GPT 系列使用的分词器大多基于 BPE(Byte Pair Encoding):从字符/字节出发,反复把"出现最频繁的相邻字节对"合并成新符号,直到词表达到目标大小。这带来几个工程现实:
- 模型看到的不是"字"也不是"词",而是 subword(子词)。常见英文词会被拆成若干 token,"unhappy" 可能拆成 "un" + "happy"。
- 压缩率影响成本:不同语言/字符集下,同一段文字的 token 数差异很大(中文通常比英文耗费更多 token),直接关系到 API 计费与上下文长度预算。
- 词表大小是固定超参,改词表意味着改 Embedding 层和 LM Head,通常不建议在微调时动它。
9、实践细节与踩坑
- 上下文窗口不是越大越好用:窗口增大带来 O(n²) 注意力和 O(n) 的 KV Cache 显存。未做外推训练的模型,超过训练长度后效果会骤降(位置编码越界)。
- few-shot 示例的顺序与格式很敏感:GPT-3 级别模型对示例的排布、分隔符、示例质量都很敏感;示例放错或格式不一致会明显掉点。
- prompt 泄漏与注入:把外部不可信文本塞进 prompt(如网页内容)可能触发提示注入攻击,生产系统要隔离"指令"与"数据"。
- RLHF 的工程复杂度被严重低估:要同时维护 4 个模型(策略、参考、RM、价值),显存和稳定性都是坑;小团队优先用 DPO/GRPO 这类更轻量的对齐方法。
- 数据质量 >> 数据数量:GPT 系的成功很大程度上来自 WebText/精心清洗的语料。脏数据(重复、噪声、毒性)会污染模型,且难以靠堆量抵消。
- Scaling Law 不是无条件的:数据重复、分布偏移、训练不稳定性都会让"越大越好"失效;有效的关键是数据多样性与训练稳定性。
- 推理成本优化:KV Cache、量化(INT8/FP4)、投机解码(speculative decoding)、批处理(continuous batching)是上线必做项。
- 评测要对齐真实场景:benchmark 高分 ≠ 产品好用;指令遵循、安全性、长程一致性需要独立评测。
- 灾难性遗忘:在某一任务上过度微调/SFT,可能让模型在通用能力上退化;常用"混合原预训练数据(replay)"或加 KL 约束来缓解这个问题。
- 训练不稳定:大模型训练常遇到 loss 突刺(loss spike)、NaN 等;常用方案是精心初始化、warmup 学习率、梯度裁剪、以及发现异常时回滚到上一个 checkpoint 再换更小的学习率续训。
- 蒸馏与小型化:不是所有场景都需 175B 级模型。用大模型(teacher)蒸馏到小模型(student),或做量化/剪枝,能在保住大部分能力的情况下大幅降本,是落地常用手段。
10、常见面试问题
- GPT 系列三代(GPT-1/2/3)在范式上的核心区别是什么?(答:微调 → zero-shot 提示 → few-shot/ICL;见第 4.2 节表格。)
- 什么是 In-Context Learning?它和 fine-tuning 的本质区别?(答:ICL 不改权重,只在上下文给示例;fine-tune 更新参数。)
- 为什么 GPT-3 之后大家不再靠堆样本微调,而转向提示/对齐?(答:175B 微调成本太高;ICL 零样本适配;RLHF 解决"强但不听话"。)
- zero-shot / one-shot / few-shot 分别指什么?(答:给 0 / 1 / 少量示例。)
- RLHF 三阶段分别训练什么模型、产出什么?(答:SFT 模型、RM 奖励模型、PPO 微调后的策略;见 8.3。)
- DPO 相比 PPO 好在哪?GRPO 又解决了什么?(答:DPO 免去 RL 与价值模型;GRPO 用组内均值当 baseline 省价值网络,适合推理。)
- OpenAI 为什么对 GPT-2 谨慎发布、对 GPT-4 不公开参数?(答:安全/竞争考量;GPT 规模带来滥用风险与商业壁垒。)
- 什么是 test-time compute?它和预训练 scaling 有什么不同?(答:推理期用更多计算做思维链/搜索提升质量,而非训练期堆参数。)
- 开源模型(Llama/DeepSeek/Qwen)与大模型时代的关系?(答:降低门槛、推动私有化与生态;中国力量在性价比/长上下文/专项能力上差异化。)
- Scaling Law 的适用边界?(答:依赖数据质量与训练稳定,非无条件成立。)
11、与后续技术的联系
- Transformer 骨架:GPT 是 Decoder-only Transformer 最纯粹的延续(见 01 篇)。
- ChatGPT / InstructGPT:在 GPT-3.5 基座上做 SFT→RM→PPO(见 03 篇),把"会写"变成"听话、安全、好用"。
- 推理模型(o1/R1):把"训练期吃数据"扩展到"推理期吃计算",用 RL(GRPO/RLVR)激发长链推理。
- Agent:模型从"答一句"到"多步调用工具完成长任务",需要更强的指令遵循、长上下文与工具调用训练。
- 多模态:ViT/视觉编码器 + 文本 Transformer 统一,催生 GPT-4V、Qwen-VL 等。
- 高效训练/推理:MoE(稀疏激活)、MLA(压缩 KV)、GQA(共享 KV)、量化与投机解码,都是为了让"大模型"既强又用得起。
- 对齐新方法:DPO/RLAIF/RLVR 正在逐步替代或补充传统 RLHF,使对齐更便宜、更可验证。
12、参考
- InstructGPT:https://arxiv.org/abs/2203.02155
- DPO:https://arxiv.org/abs/2305.18290
- DeepSeek-R1:https://arxiv.org/abs/2501.12948
- RLHF 技术分解(HF 中文博客):https://huggingface.co/blog/zh/rlhf
- GPT-1 论文:https://s3-us-west-2.amazonaws.com/openai-assets/research-covers/language-unsupervised/language_understanding_paper.pdf
- GPT-2 论文:https://d4mucfpksywv.cloudfront.net/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
- GPT-3 论文:https://arxiv.org/abs/2005.14165

 浙公网安备 33010602011771号