
【大模型Wiki】01 · Transformer 与注意力机制
参考:https://www.zhihu.com/tardis/bd/art/600773858?source_id=1001
Transformer是谷歌在2017年的论文《Attention Is All You Need》中提出的,用于NLP的各项任务。这篇论文的意义怎么强调都不为过:它第一次证明,单纯依靠注意力机制、完全抛弃循环(RNN)和卷积(CNN),就能在机器翻译上超越当时的所有模型,并且具备天然的并行性。此后几乎所有的大语言模型(GPT、BERT、Llama、Qwen、DeepSeek 等)都把 Transformer 当作骨架。
本文先按"黑盒 → 编码器/解码器 → 模块内部"的顺序把原始论文的结构讲清楚,再补充 2020 年以后的关键演进(RoPE、GQA、MoE、FlashAttention 等),最后给出手写注意力、训练/推理流程、实践踩坑与常见面试题。
1、Transformer整体结构
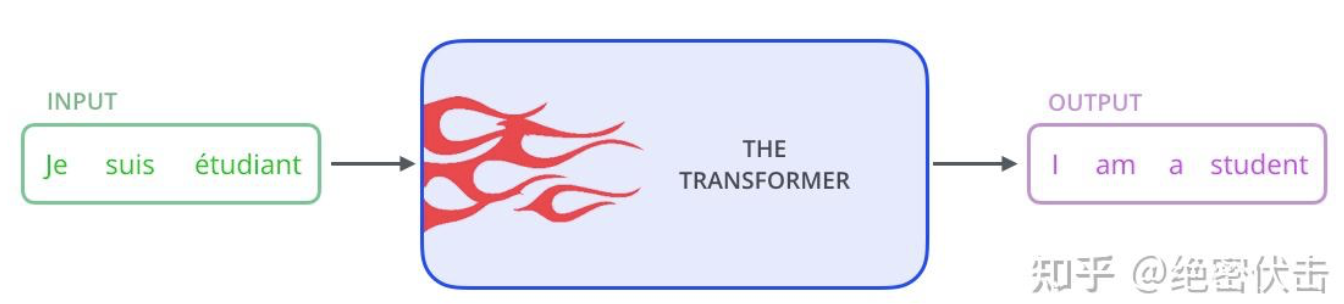
在机器翻译中,Transformer可以将一种语言翻译成另一种语言,如果把Transformer看成一个黑盒,那么其结构如下图所示:
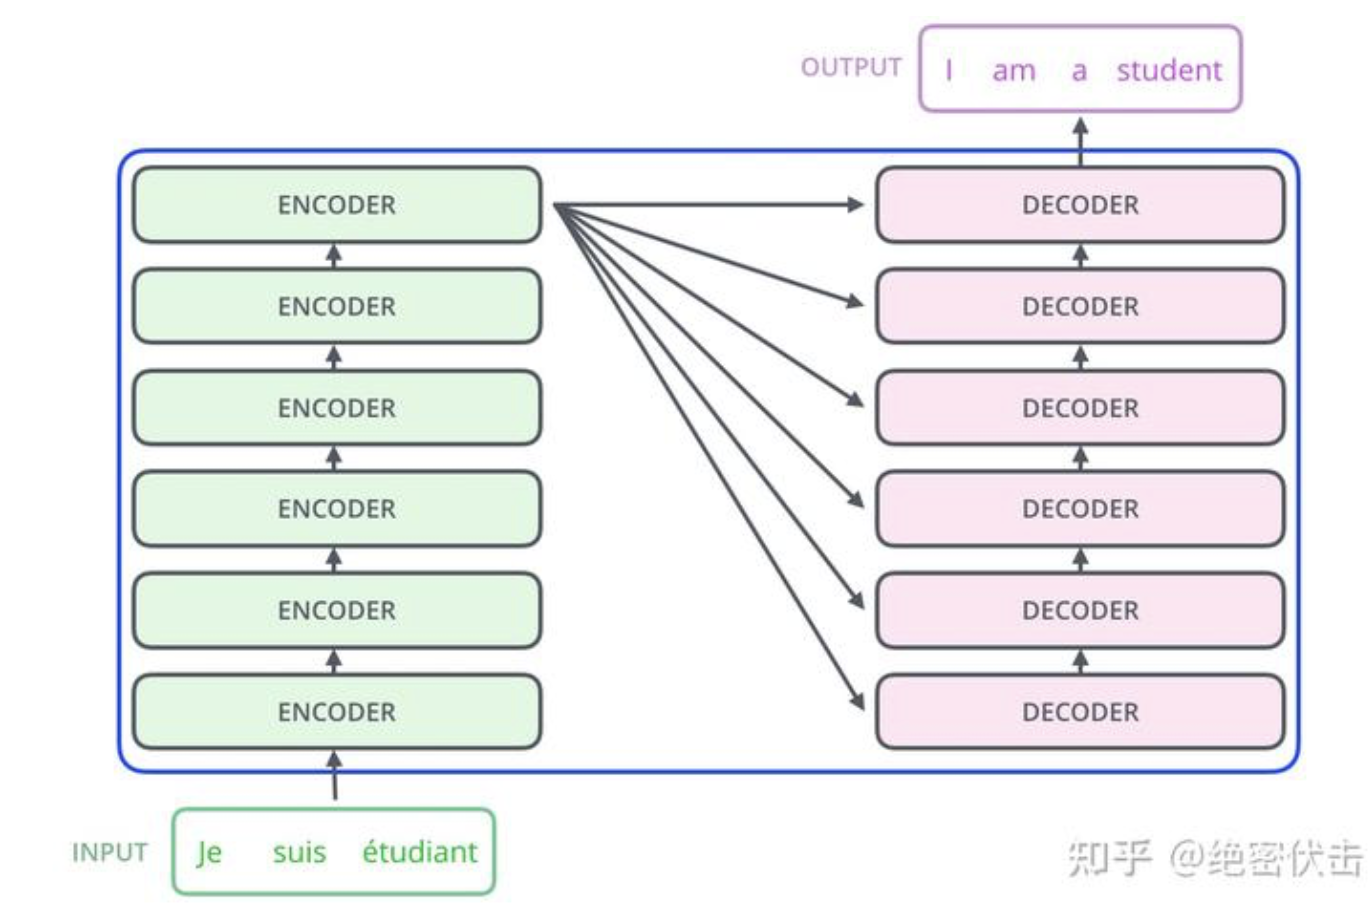
拆开这个黑盒,那么可以看到Transformer由若干个编码器和解码器组成,如下图所示
继续将Encoder和Decoder拆开,可以看到完整的结构,如下图所示:
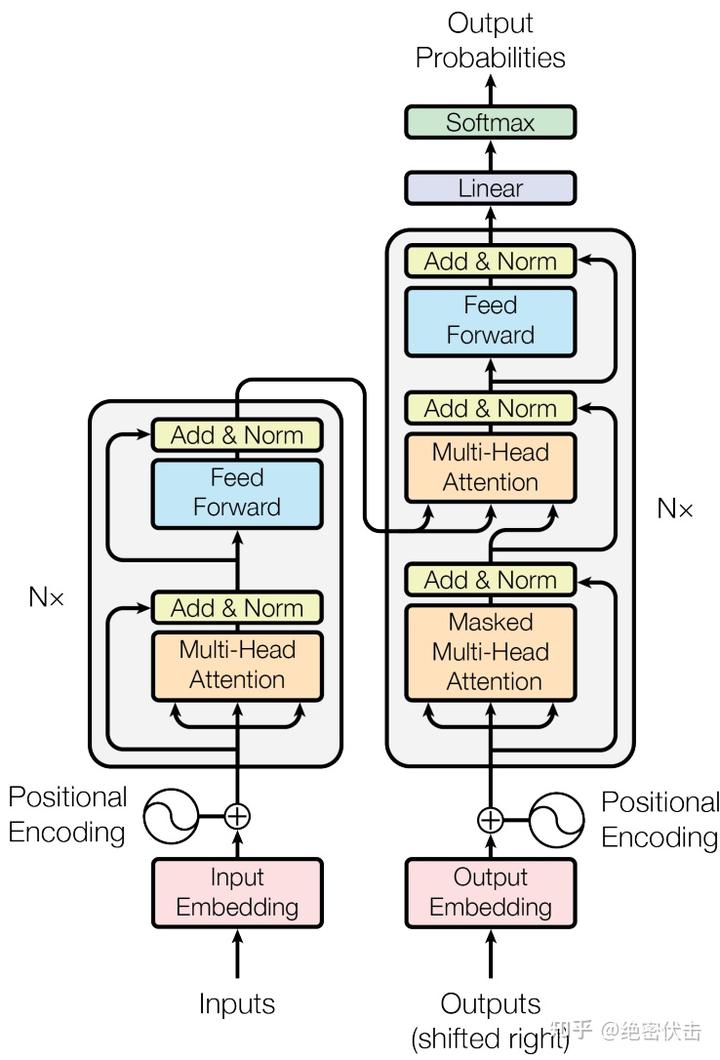
可以看到Encoder包含一个Muti-Head Attention模块,是由多个Self-Attention组成,而Decoder包含两个Muti-Head Attention。Muti-Head Attention上方还包括一个 Add & Norm 层,Add 表示残差连接 (Residual Connection) 用于防止网络退化,Norm 表示 Layer Normalization,用于对每一层的激活值进行归一化。
1.1 为什么是 Transformer:与 RNN / CNN 的对比
在 Transformer 之前,序列建模主要有两条路线:
- RNN / LSTM / GRU:按时间步顺序计算,第 t 个隐藏状态依赖第 t-1 个。优点是天然适合序列,缺点是(1)无法并行,训练慢;(2)长程依赖时梯度容易消失/爆炸;(3)前面 token 的信息要经过很多步才能传到后面。
- CNN(如 ConvS2S、ByteNet):用卷积核捕捉局部 n-gram 特征,可以并行,但感受野随层数线性/次线性增长,要看到很远的位置就得堆很多层。
Transformer 用的自注意力(Self-Attention)则让任意两个位置直接"对话":序列里第 i 个词和第 j 个词的关联程度,一步就能算出来,路径长度是 O(1),与距离无关。代价是计算量随序列长度 n 变成 O(n²),这也是后来长上下文优化的核心矛盾(见第 7 节)。
一句话直觉:RNN 是"传话游戏",信息逐层衰减;Self-Attention 是"圆桌会议",每个词同时看所有人。
1.2 自注意力的核心直觉
Self-Attention 想回答的问题是:对于序列中的某个词,它应该"关注"序列里的哪些词、各自关注多少,来更好地表示自己? 比如 "The animal didn't cross the street because it was too tired" 中的 "it" 应该关注 "animal" 而不是 "street"。注意力就是给每个词对(query 与 key)打分,再用分数对 value 做加权求和。
假设我们的输入包含两个单词,我们看一下Transformer的整体结构:
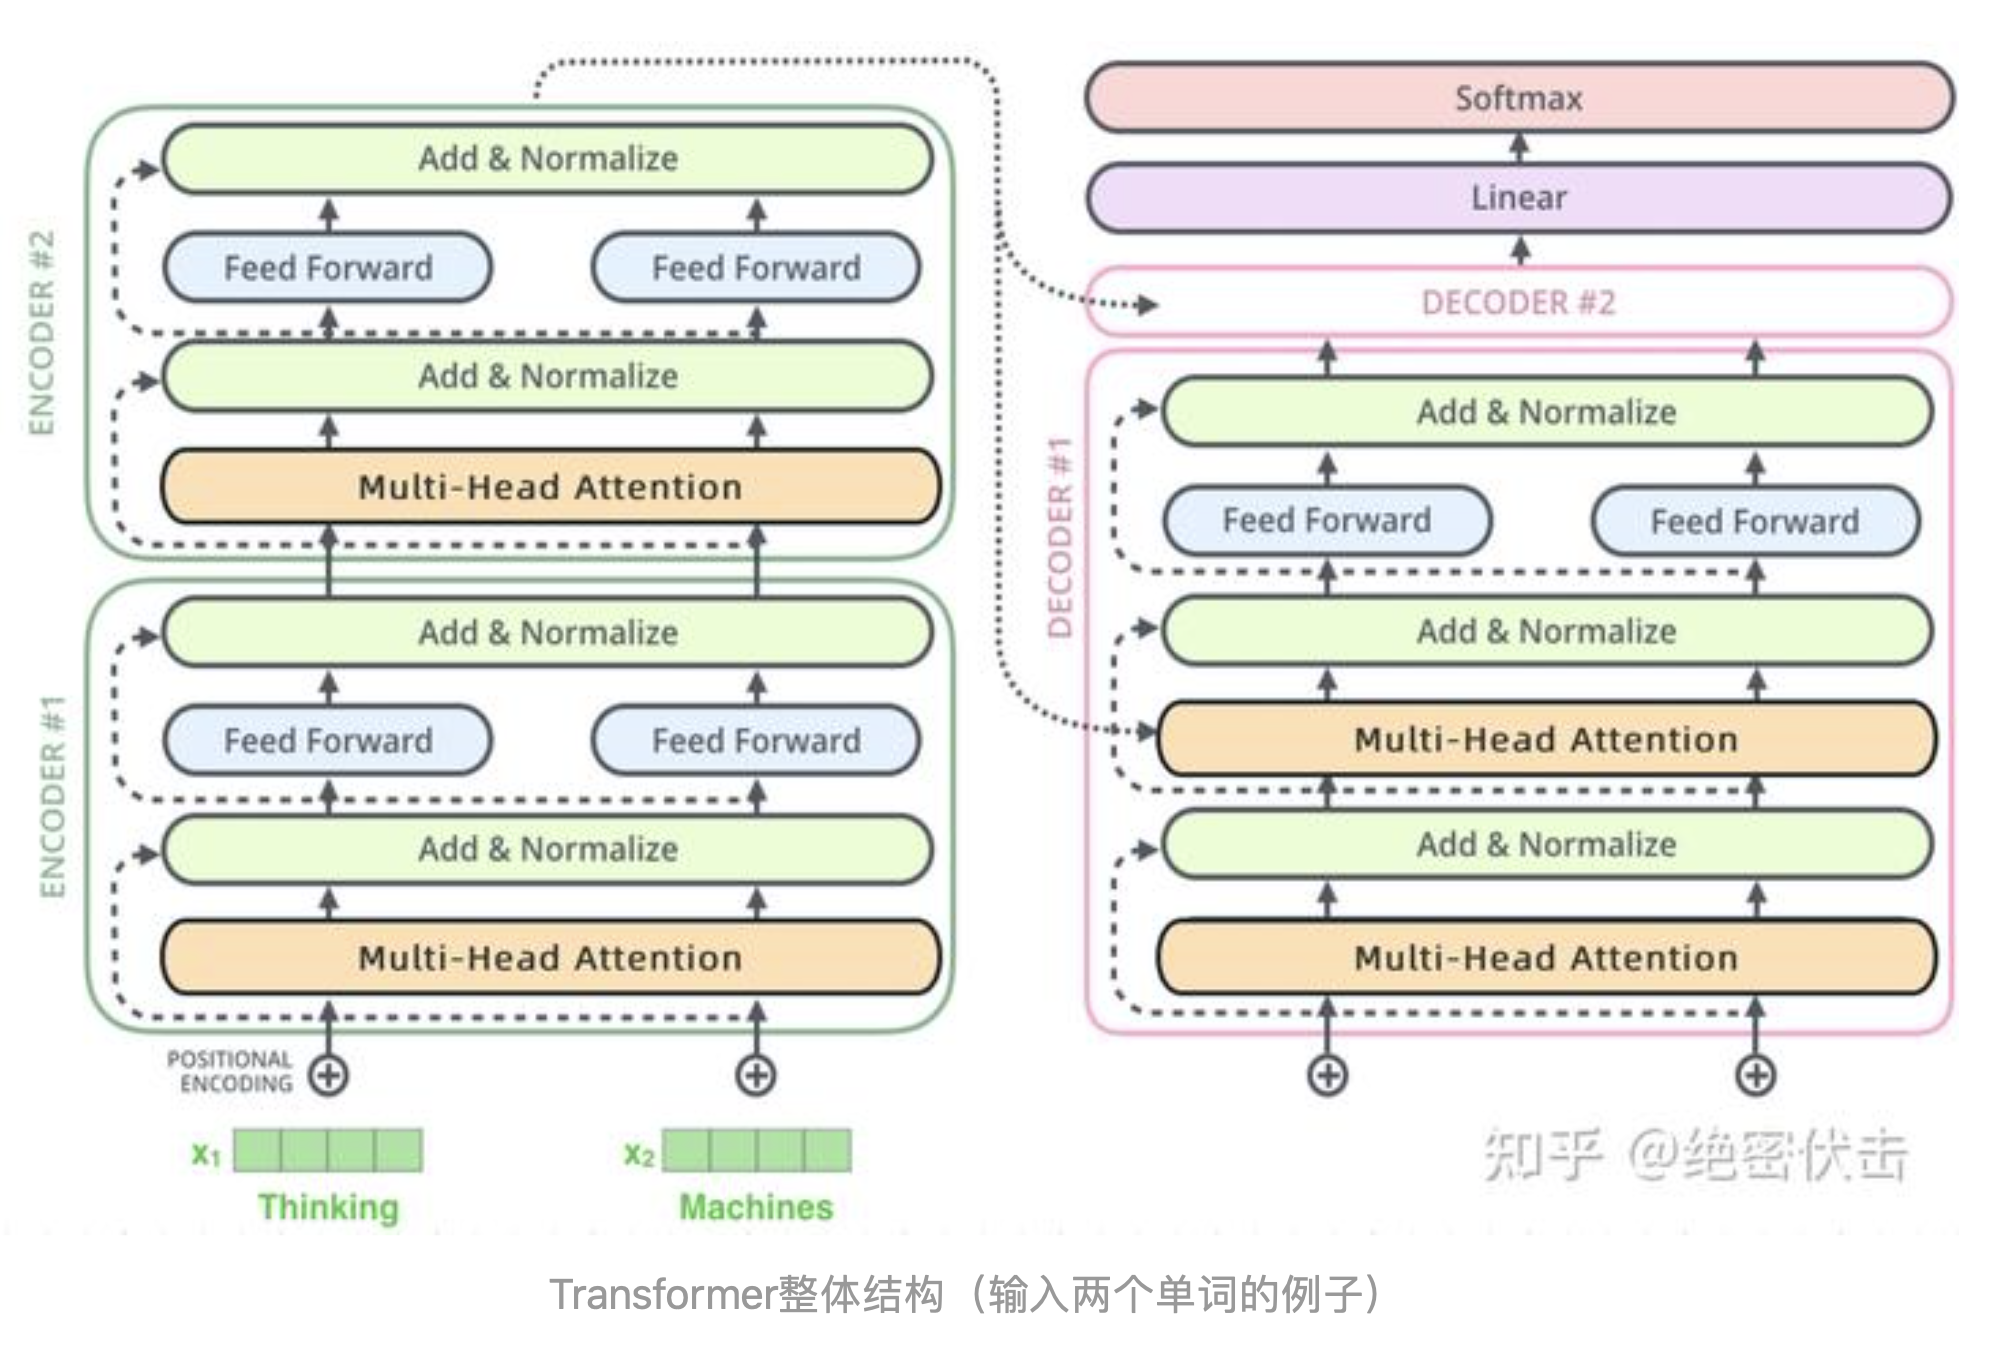
为了能够对Transformer的流程有个大致的了解,我们举一个简单的例子,还是以之前的为例,将法语"Je suis etudiant"翻译成英文。
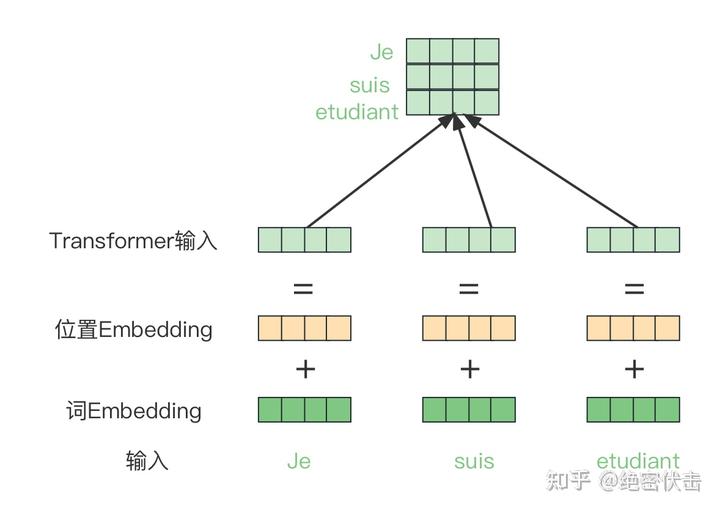
- 第一步:获取输入句子的每一个单词的表示向量 \bm{x},由单词的Embedding和单词位置的Embedding 相加得到。
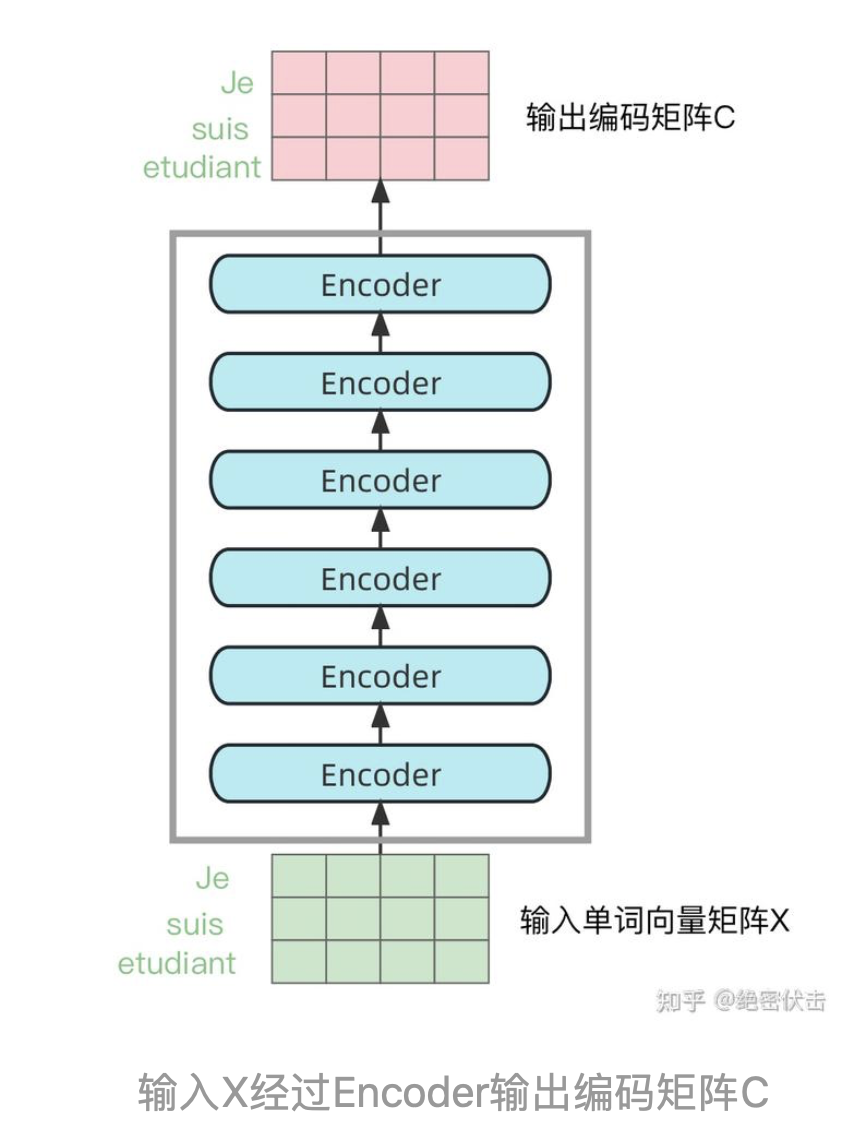
- 第二步:将单词向量矩阵传入Encoder模块,经过N个Encoder后得到句子所有单词的编码信息矩阵C,如下图。输入句子的单词向量矩阵用 $ X \in{R} ^ {n \times d}$表示,其中n是单词个数,d表示向量的维度,每一个Encoder输出的矩阵维度与输入完全一致。
-
第三步:将Encoder输出的编码矩阵C传递到Decoder中,Decoder会根据当前翻译过的单词1~i,翻译下一个单词i+1,如下图所示。
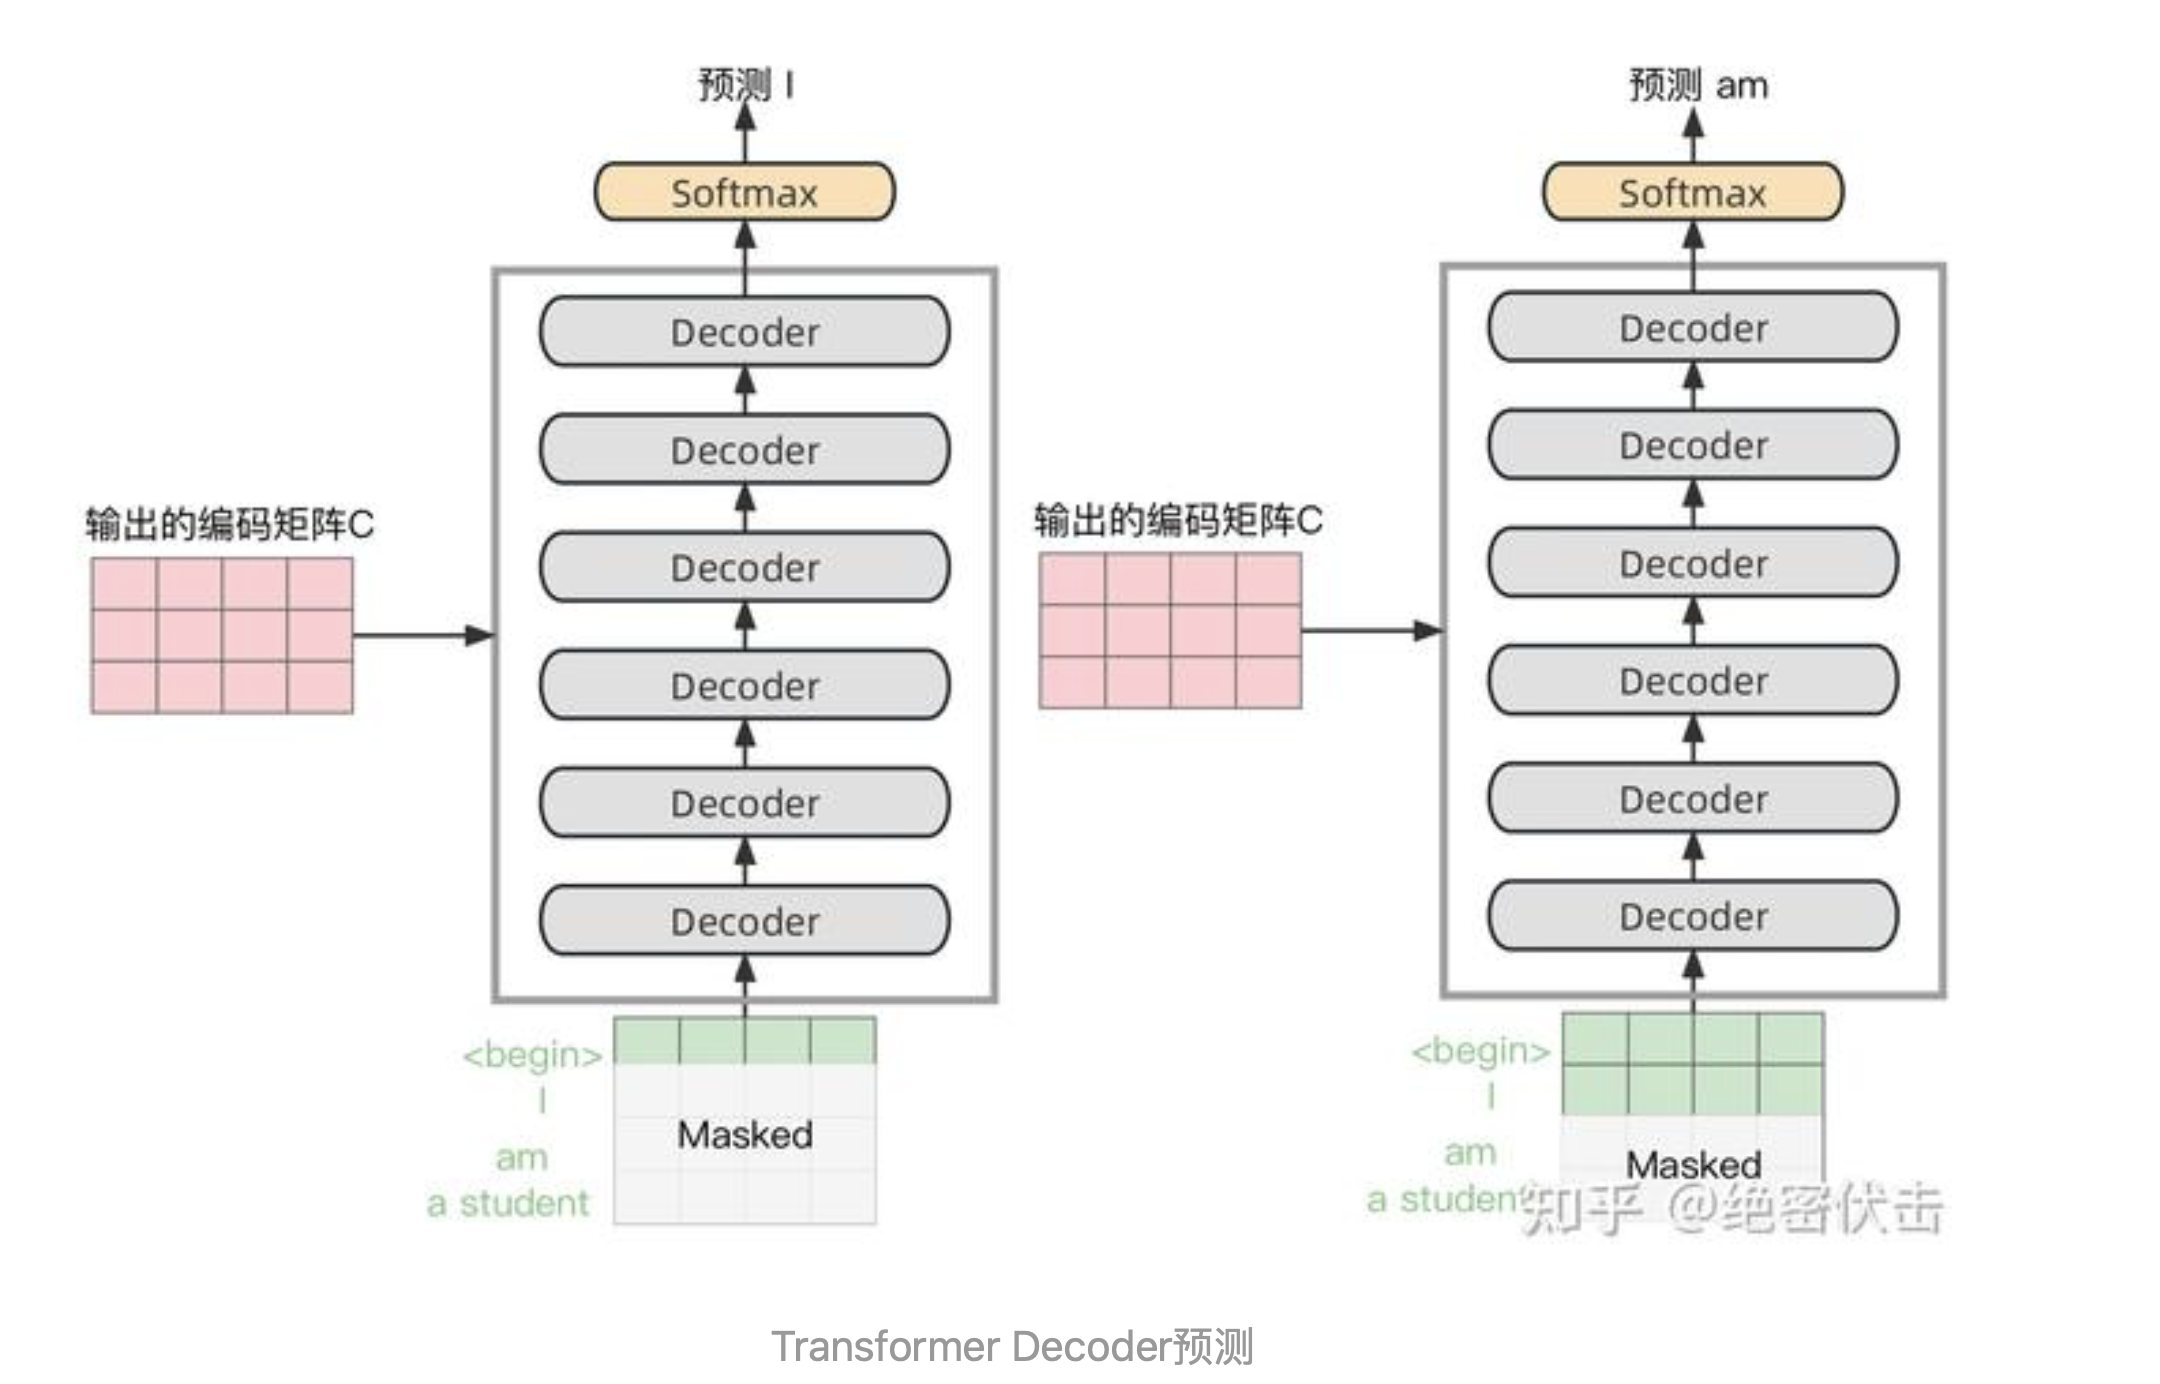
上图Decoder接收了Encoder的编码矩阵,然后首先输入一个开始符 "
1.3 一个最小可运行的 Self-Attention(PyTorch 手写)
下面这段代码实现了论文中最核心的 "Scaled Dot-Product Attention",带中文注释,可直接运行,用来建立从公式到代码的映射:
import torch
import torch.nn.functional as F

def scaled_dot_product_attention(Q, K, V, mask=None):
    """
    Q, K, V: 形状均为 (batch_size, seq_len, d_k)
    mask:     可选,形状与注意力分数矩阵兼容,True/1 的位置被屏蔽
    返回:     注意力输出 (batch_size, seq_len, d_k)
    """
    d_k = Q.size(-1)
    # 1) 计算 Query 与 Key 的点积,并除以 sqrt(d_k) 做缩放
    scores = torch.matmul(Q, K.transpose(-2, -1)) / (d_k ** 0.5)
    # 2) 可选:在 softmax 之前把未来位置/非法位置置为 -inf
    if mask is not None:
        scores = scores.masked_fill(mask == 0, float('-inf'))
    # 3) 对最后一维(被注意的那些位置)做 softmax 得到注意力权重
    attn = F.softmax(scores, dim=-1)
    # 4) 用权重对 Value 加权求和
    output = torch.matmul(attn, V)
    return output, attn

# 演示:3 个 token,每个 d_k=4
Q = K = V = torch.randn(1, 3, 4)
out, weights = scaled_dot_product_attention(Q, K, V)
print("输出形状:", out.shape)        # torch.Size([1, 3, 4])
print("注意力权重(每行和为1):", weights.sum(-1))  # 约等于 1
这段代码对应论文公式:
注意 scores 是一个 seq_len × seq_len 的矩阵,第 i 行第 j 列表示"第 i 个 query 对第 j 个 key 的关注程度"。这也是后面 O(n²) 复杂度与 KV Cache 优化(第 5 节)的由来。
2、Transformer的输入表示
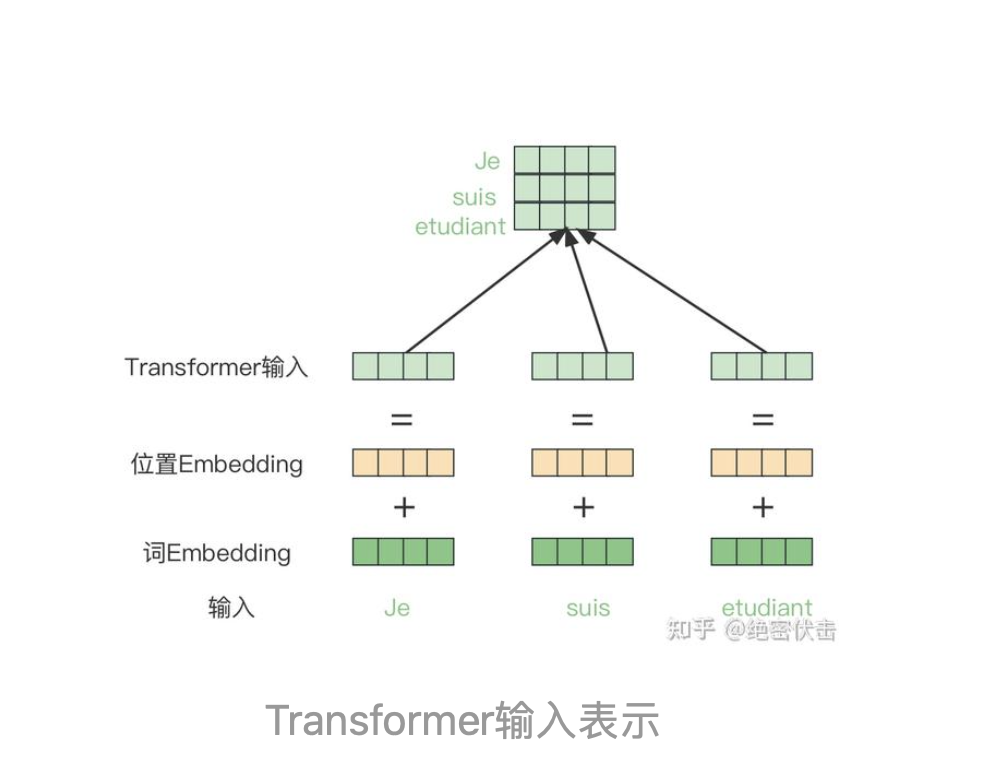
Transformer中单词的输入表示由单词Embedding和位置Embedding(Positional Encoding)相加得到。
2.1、单词Embedding
单词的Embedding可以通过Word2vec等模型预训练得到,可以在Transformer中加入Embedding层。在原始论文里,输入和输出(解码器端)共用同一套词表 Embedding(但分别训练),词表大小约 3.7 万(使用 BPE 分词)。Embedding 的维度 d_model 与后续所有子层的维度一致(论文取 512),这样残差相加时维度才匹配。
需要注意的一点:Embedding 层的权重在训练初期是随机初始化的,随模型一起学习;它不是冻结的查表,而是端到端训练的一部分。现代大模型(如 GPT)同样如此,并且在词表很大时会单独占用可观的参数量(Embedding 参数量 ≈ 词表大小 × d_model)。
2.2、位置Embedding
Transformer 中除了单词的Embedding,还需要使用位置Embedding 表示单词出现在句子中的位置。因为 Transformer不采用RNN结构,而是使用全局信息,不能利用单词的顺序信息,而这部分信息对于NLP来说非常重要。所以Transformer中使用位置Embedding保存单词在序列中的相对或绝对位置。
换句话说,自注意力本身是排列不变(permutation invariant)的:把输入词序打乱,只要集合不变,注意力输出(在重排后)也不变。这与 RNN 天然携带顺序信息完全不同。因此必须显式地把"位置"注入进去,否则 "猫吃鱼" 和 "鱼吃猫" 在模型眼里没有区别。
原始论文采用可加性的方式:最终输入 = 单词 Embedding + 位置 Embedding,两者维度相同,逐元素相加。
2.3、位置编码的演进:Sinusoidal → RoPE → ALiBi
位置编码是 Transformer 后续演进最活跃的方向之一,下面把三种代表性方案放在一起对比(这是理解现代 LLM 的关键)。
2.3.1 Sinusoidal(原始正弦位置编码)
论文使用不同频率的正弦/余弦函数直接生成,不通过学习得到:
- 每个维度对应一个频率,低频维度随位置变化慢、高频变化快。
- 优点:可以外推——训练时没见过的更长位置,函数照样能算(虽然论文实际没做长外推)。
- 它还有一个漂亮的性质:对任意固定偏移 \(k\),\(\text{PE}_{pos+k}\) 可以表示为 \(\text{PE}_{pos}\) 的线性函数,这使得模型容易学到"相对位置"关系。
- 缺点:它是绝对位置编码,且是加到 token 上的固定信号;当上下文长度远超训练长度时,泛化较差。这也是后来被 RoPE 等取代的主因。
2.3.2 RoPE(旋转位置编码,Rotary Position Embedding)
RoPE 的思想是:不在 token 上"加"位置,而是对 Query 和 Key 向量做按位置旋转的变换,让两个向量的内积 \(Q^T K\) 天然只包含它们的相对位置信息。
- 实现上:把向量按相邻两维一组,旋转角度与位置 pos 成正比(角度 = pos × θ,θ 随维度递减)。
- 性质:旋转后的 \(\tilde q_m^T \tilde k_n\) 只依赖于 \((m-n)\),即相对距离;同时保留向量本身的内容信息。
- 为什么现代模型(Llama、Qwen、DeepSeek、ChatGLM)几乎都用它:因为它把"相对位置"编码进了注意力分数本身,对长上下文外推、长度泛化更友好;配合 "NTK-aware" 或 "YaRN" 等缩放技巧,可以几乎不微调地把上下文窗口扩到训练长度的几倍甚至几十倍。
2.3.3 ALiBi(Attention with Linear Biases)
ALiBi 走向另一个极端:完全不加位置编码。它直接在注意力分数上叠加一个与距离成线性关系的偏置:
其中 \(m\) 是每个注意力头不同的斜率。距离越远(|i-j| 越大),惩罚越大,模型自然更关注近处。
- 优点:零额外参数、天然外推能力强(训练 2k 长度,推理可直接用到 10k+)。
- 代表:BLOOM、GLM 系列等采用。
- 缺点:相对位置是"隐式"的,且对所有头用固定斜率,灵活性不如 RoPE。
小结:Sinusoidal 是绝对+可加;RoPE 是相对+旋转进内积;ALiBi 是相对+分数偏置。三者都解决了"Transformer 看不出顺序"的问题,但对外推和长上下文的友好程度依次变化,这也是现代开源模型普遍选 RoPE 的原因。
3、Multi-Head Attention(多头注意力机制)
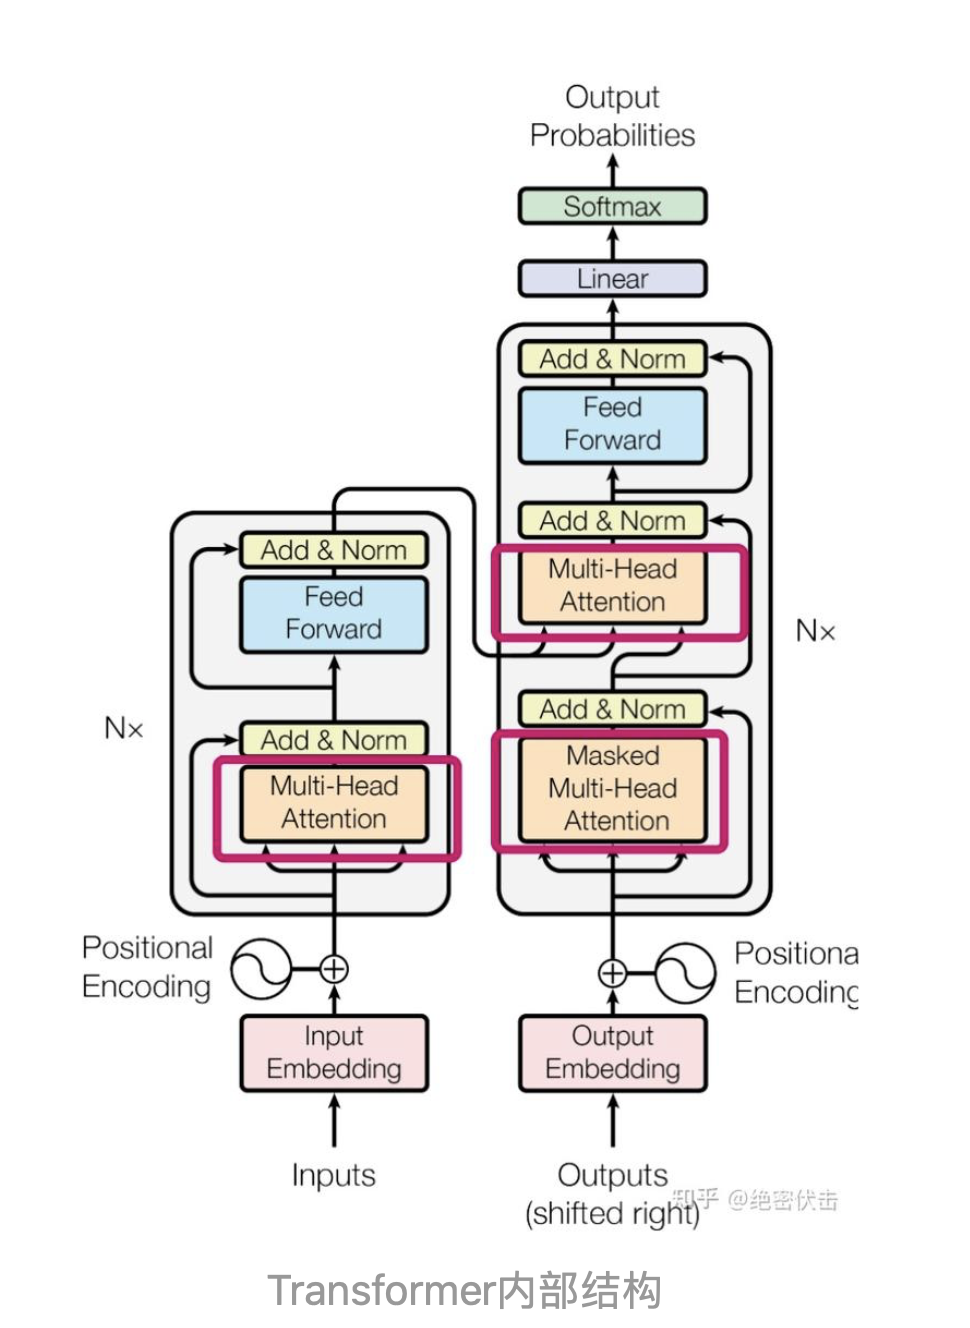
上图是Transformer的内部结构,其中红色方框内为Multi-Head Attention,是由多个Self-Attention组成,具体结构如下图:
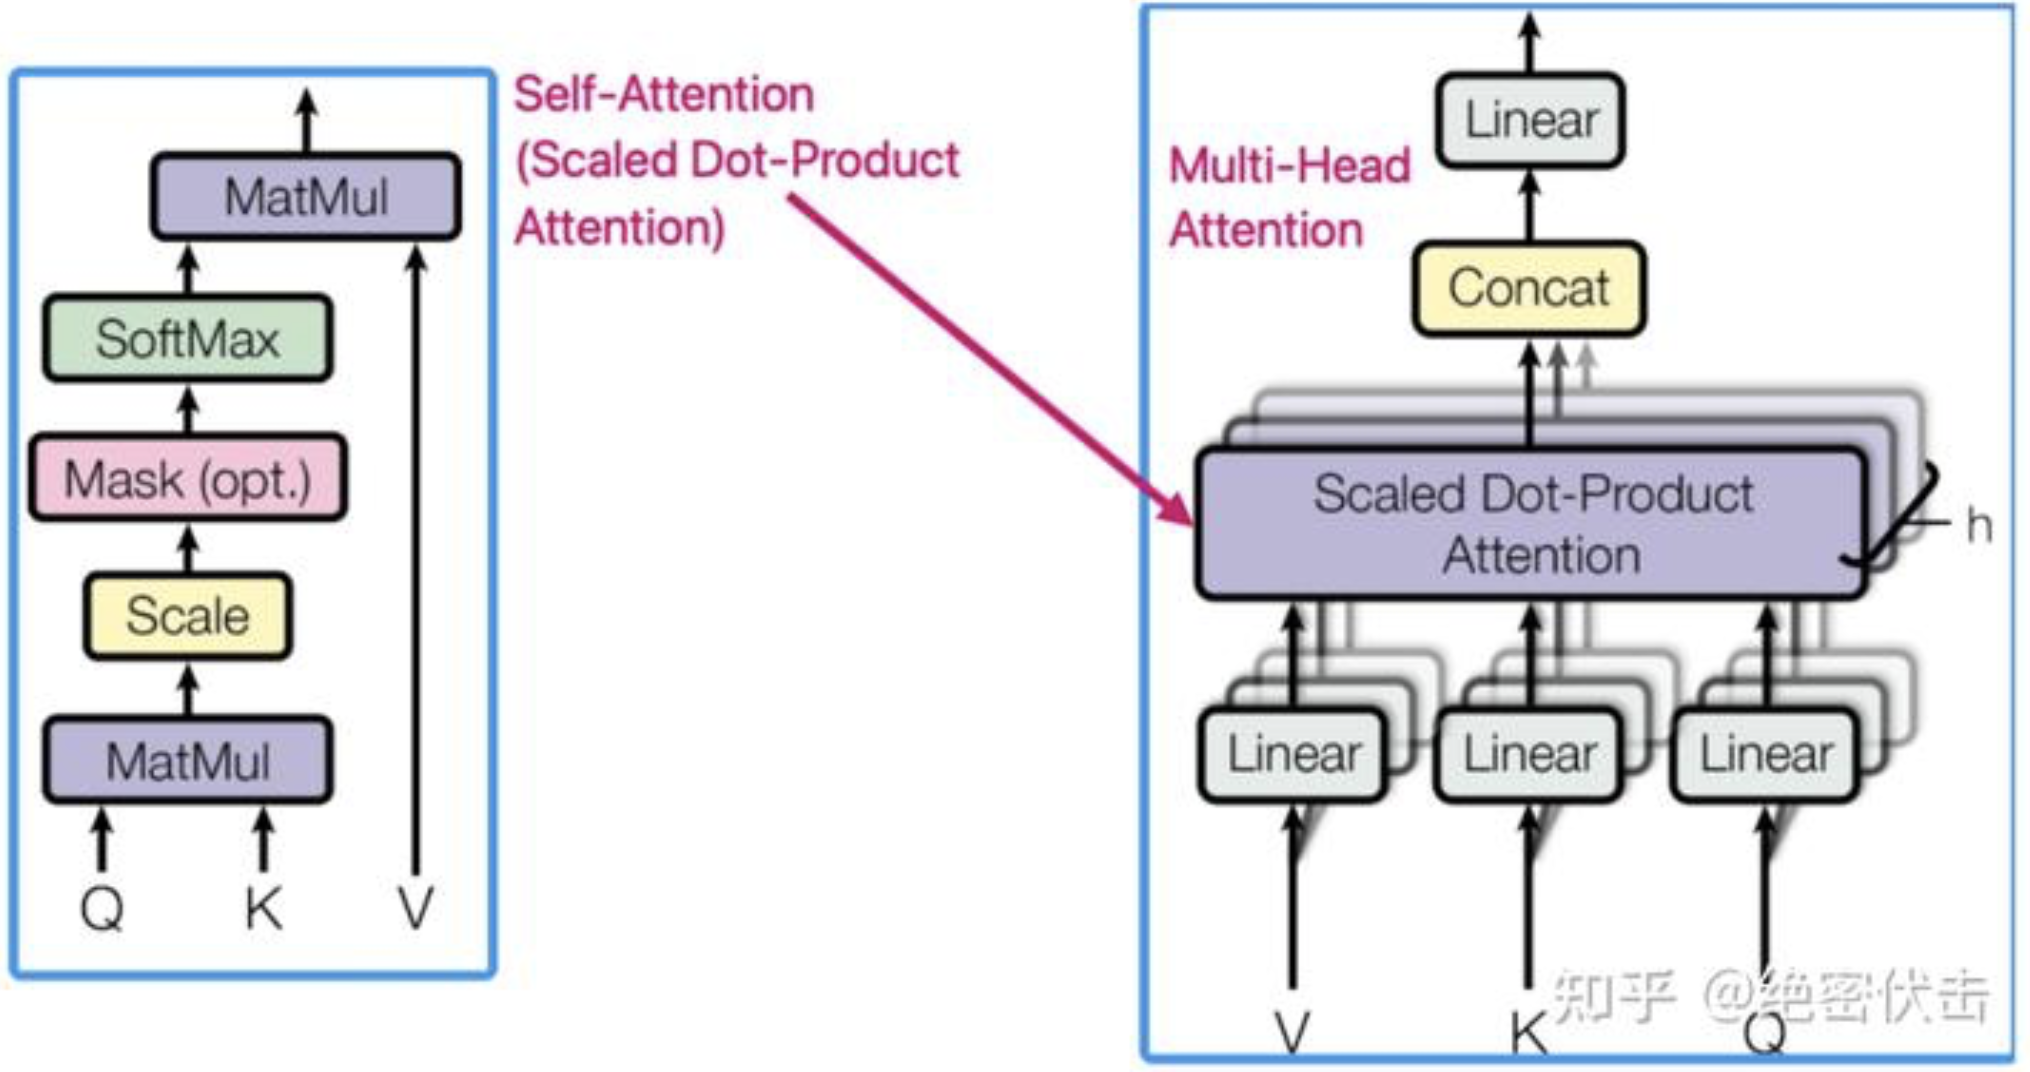
因为Self-Attention是Transformer的重点,所以我们重点关注 Multi-Head Attention 以及 Self-Attention,首先介绍下Self-Attention的内部逻辑。
3.1 Self-Attention结构
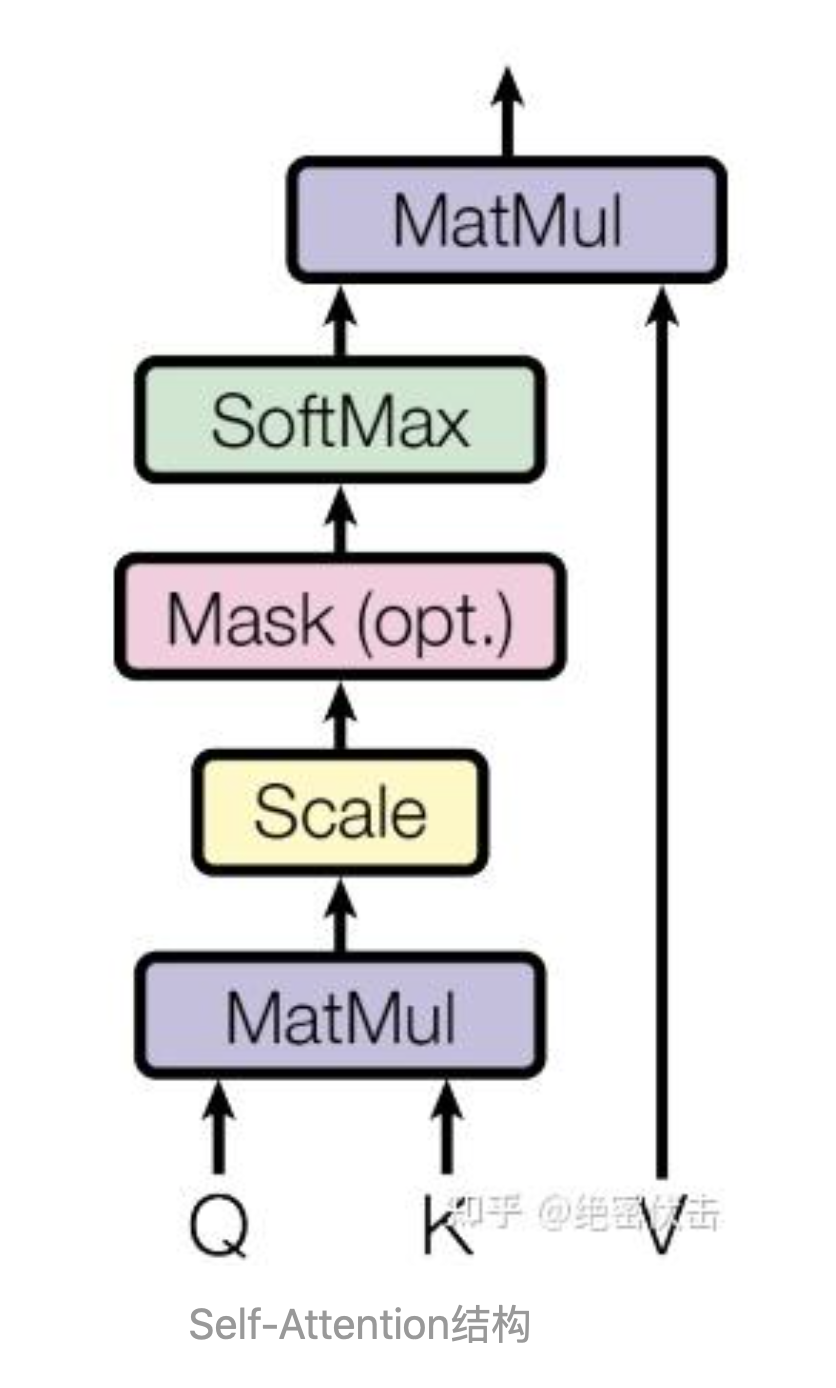
上图是Self-Attention结构,最下面是Q查询、K键值、V值矩阵,是通过输入矩阵X和权重矩阵Wk,Wq,Wv相乘得到的。
3.1.1 Q / K / V 的计算与维度
设输入矩阵 \(X \in \mathbb{R}^{n\times d_{model}}\)(n 个 token,每个维度 d_model)。通过三组可学习权重投影得到:
其中 \(W_Q, W_K, W_V \in \mathbb{R}^{d_{model}\times d_k}\)。在原始论文里 \(d_{model}=512\),头数 \(h=8\),于是每个头的维度 \(d_k = d_v = d_{model}/h = 64\)。也就是说,多头不是把 512 维拆成 8 个 64 维分别算注意力,而是先用 8 套不同的 W_Q/W_K/W_V 各自投影到 64 维,再各自算注意力。
为什么要除以 \(\sqrt{d_k}\)?点积的均值方差会随维度 \(d_k\) 增大而增大;当 \(d_k\) 很大时,\(QK^T\) 的数值会非常大,把 softmax 推到梯度极小的饱和区(softmax 对大数值差异不敏感,梯度趋近于 0)。除以 \(\sqrt{d_k}\) 把方差拉回 1 附近,训练更稳定。这是工程上非常关键的一个 trick。
得到Q,K,V之后就可以计算出Self-Attention的输出,如下图所示:
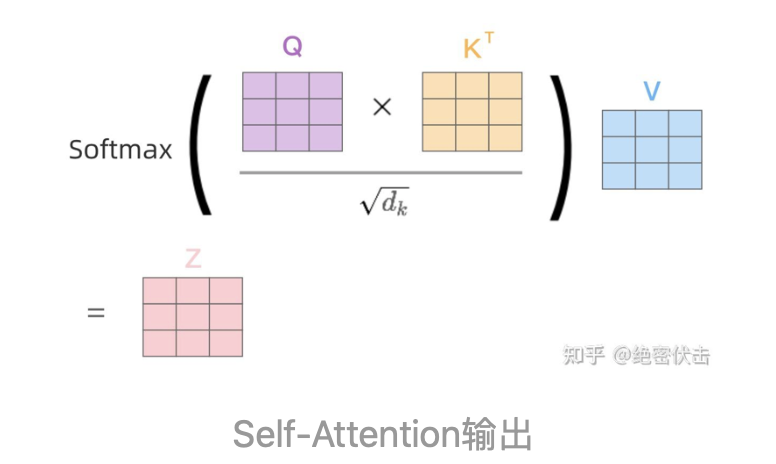
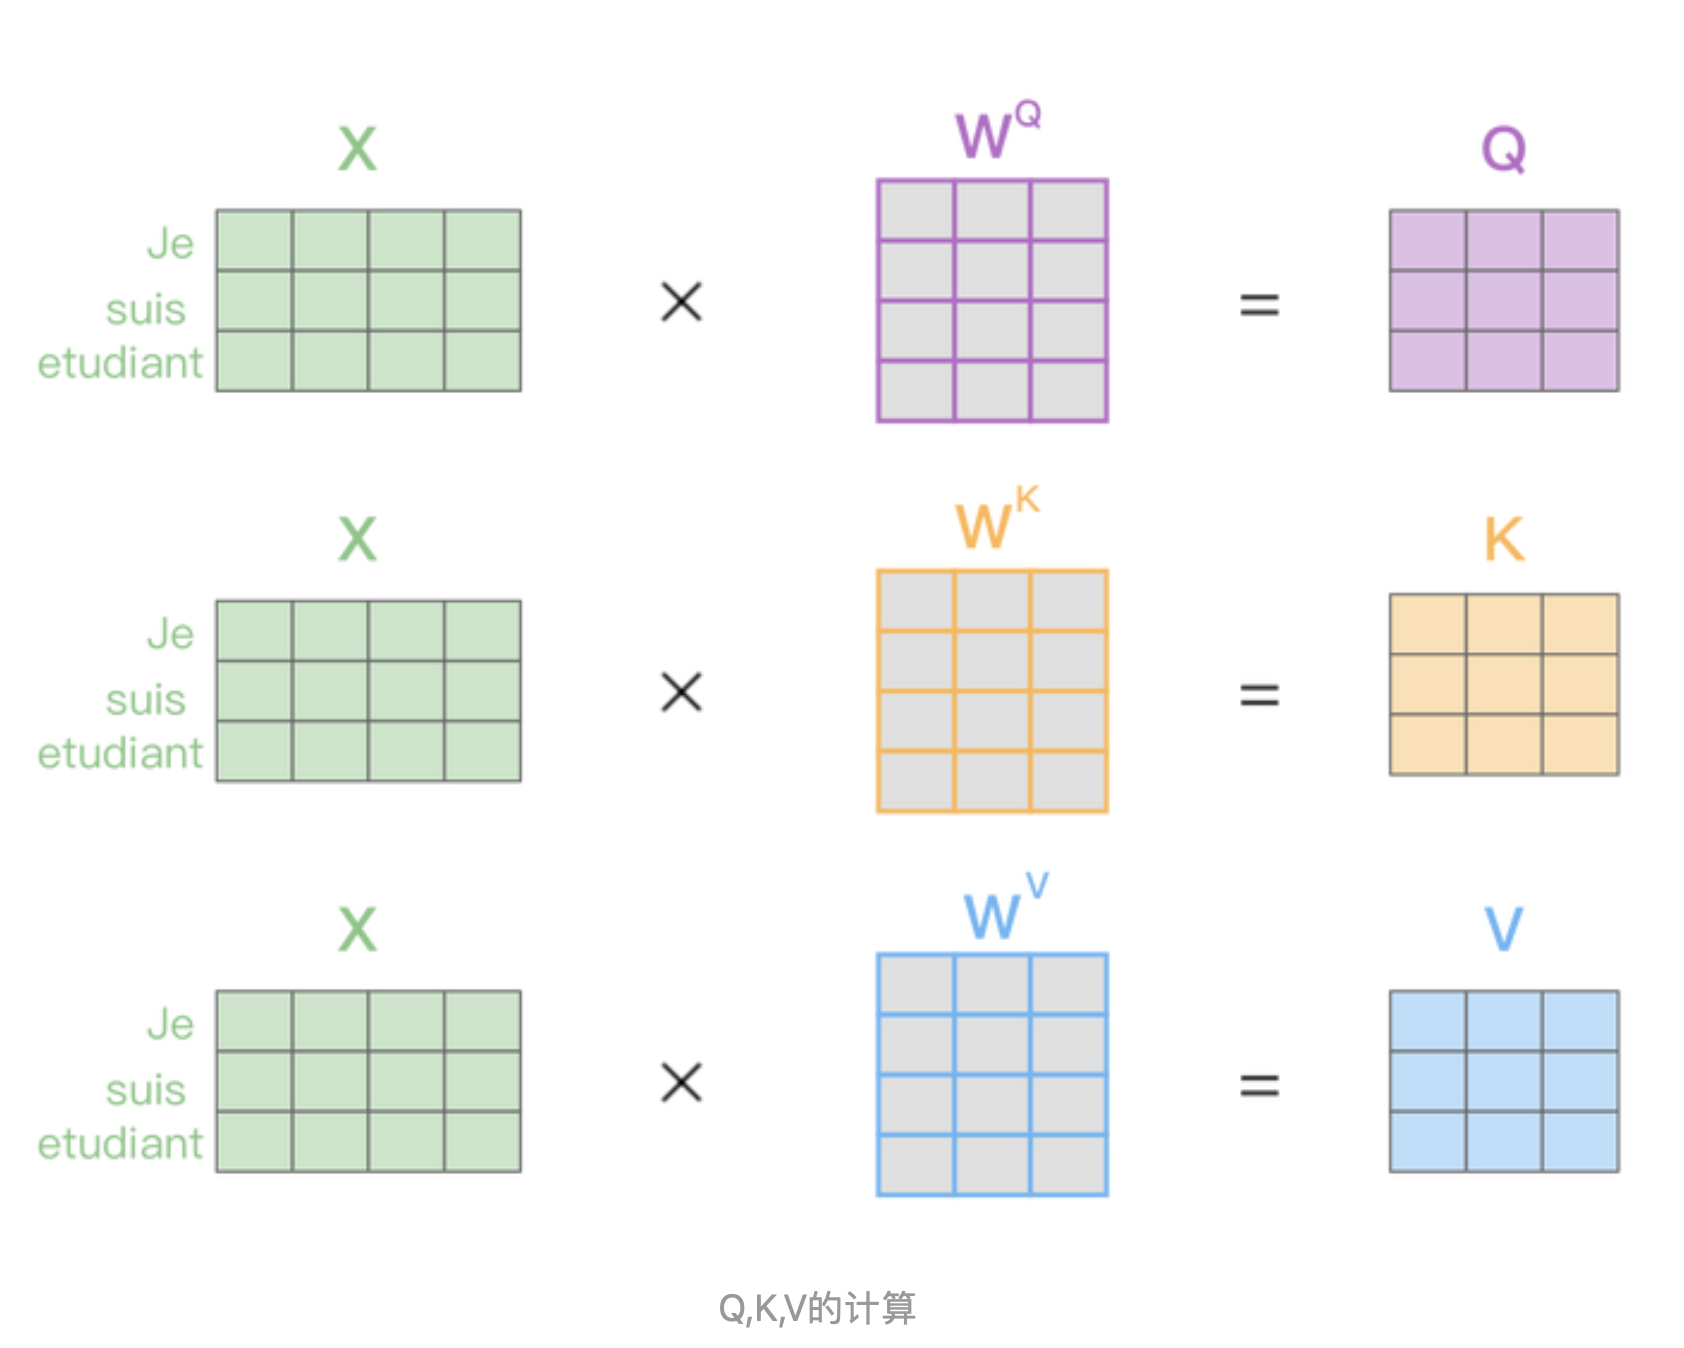
3.1.2 从矩阵视角再看一遍
把整批 token 一起算时(而不是逐 token),Self-Attention 就是:
scores = Q @ K^T / sqrt(d_k)→ 形状(n, n)- 若有 mask(解码器),把未来位置填
-inf attn = softmax(scores, dim=-1)→ 每行是一个概率分布,表示"该位置应当从哪些位置取信息"output = attn @ V→ 形状(n, d_k)
可以验证:输出每个位置都是"所有位置 value 的加权平均",权重由 query 与 key 的相似度决定。这就是"用相关性吸收全局信息"的精确含义。
3.2 Multi-Head Attention输出
在上一步,我们已经知道怎么通过Self-Attention计算得到输出矩阵Z,而Multi-Head Attention是由多个Self-Attention组合形成的,下图是论文中Multi-Head Attention的结构图。
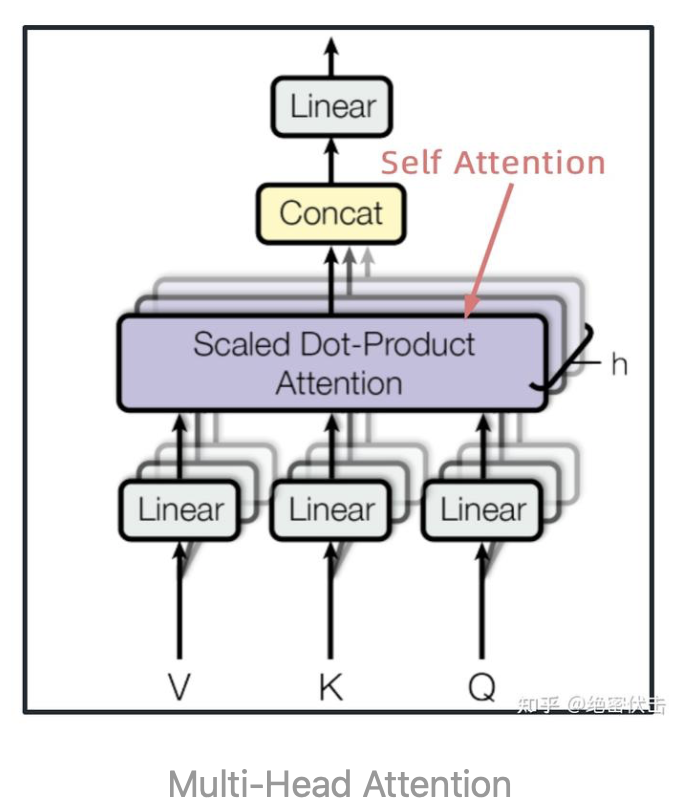
从上图可以看到Multi-Head Attention包含多个Self-Attention层,首先将输入X分别传递到 h个不同的Self-Attention中,计算得到 ![h]个输出矩阵 Z。下图是h=8的情况,此时会得到 8 个输出矩阵Z 。
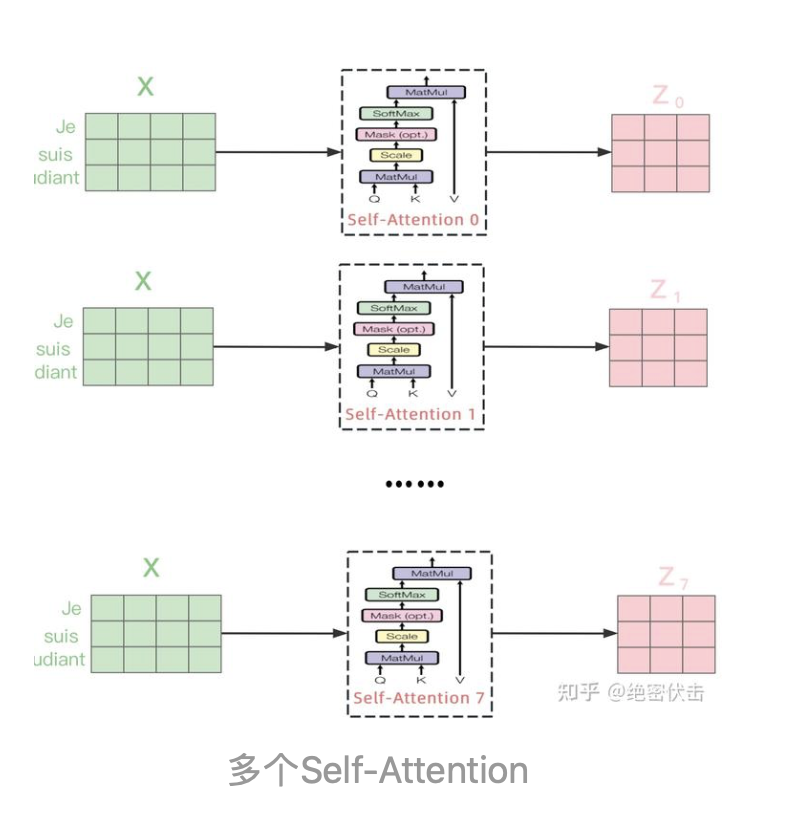
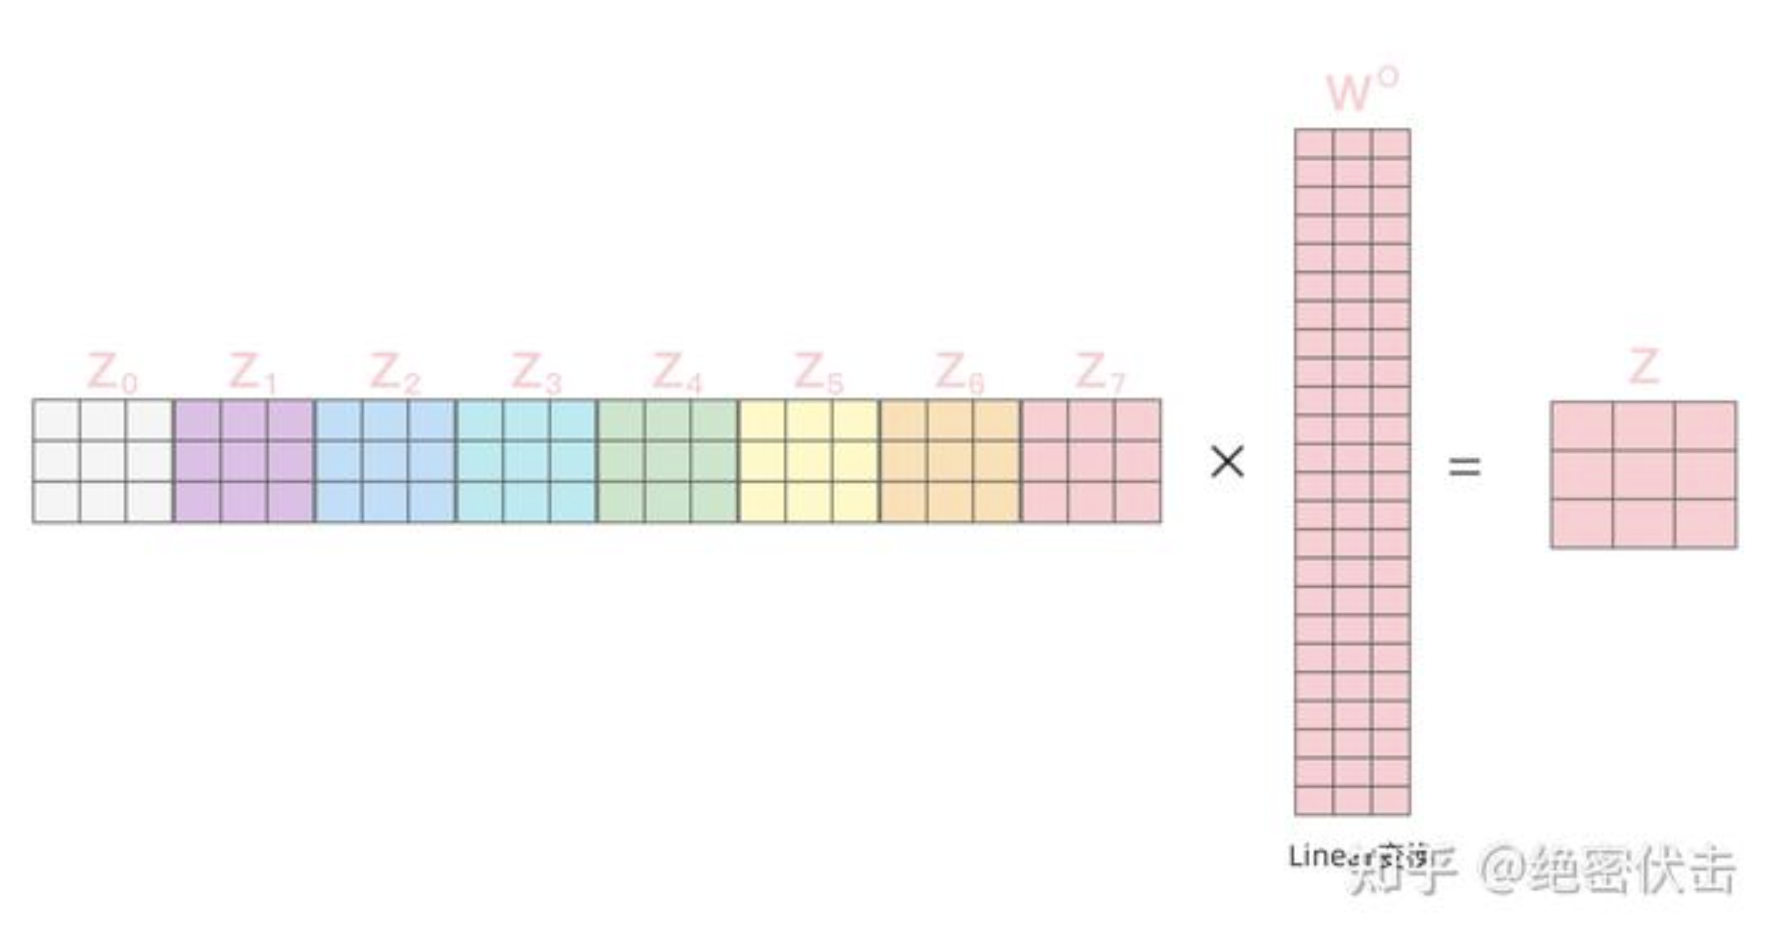
得到8个输出矩阵 \({Z}_0\sim {Z}_7\)后,Multi-Head Attention将它们拼接在一起(Concat),然后传入一个Linear层,得到Multi-Head Attention最终的输出矩阵Z 。
3.2.1 多头到底有什么意义
单个注意力头只能学到一种"关注模式"。多个头并行,可以让模型在同一层同时关注不同类型的关系,例如:
- 一个头关注句法依存(主语-谓语);
- 一个头关注指代(it → animal);
- 一个头关注局部相邻词;
- 一个头关注长距离语义关联。
每个头有独立的 \(W_Q^i/W_K^i/W_V^i\),因此投影到不同的子空间去"看"输入。最后拼接(Concat)回 (n, h*d_k) = (n, d_model),再过一个输出线性层 \(W^O\) 做信息融合。多头不是"更多容量"那么简单,而是"多视角表示"——这正是 Transformer 表达力强的来源之一。
注:8 个 64 维头拼起来正好是 512 维,与输入维度一致,因此后面残差相加时形状才匹配。
4、编码器Encoder结构
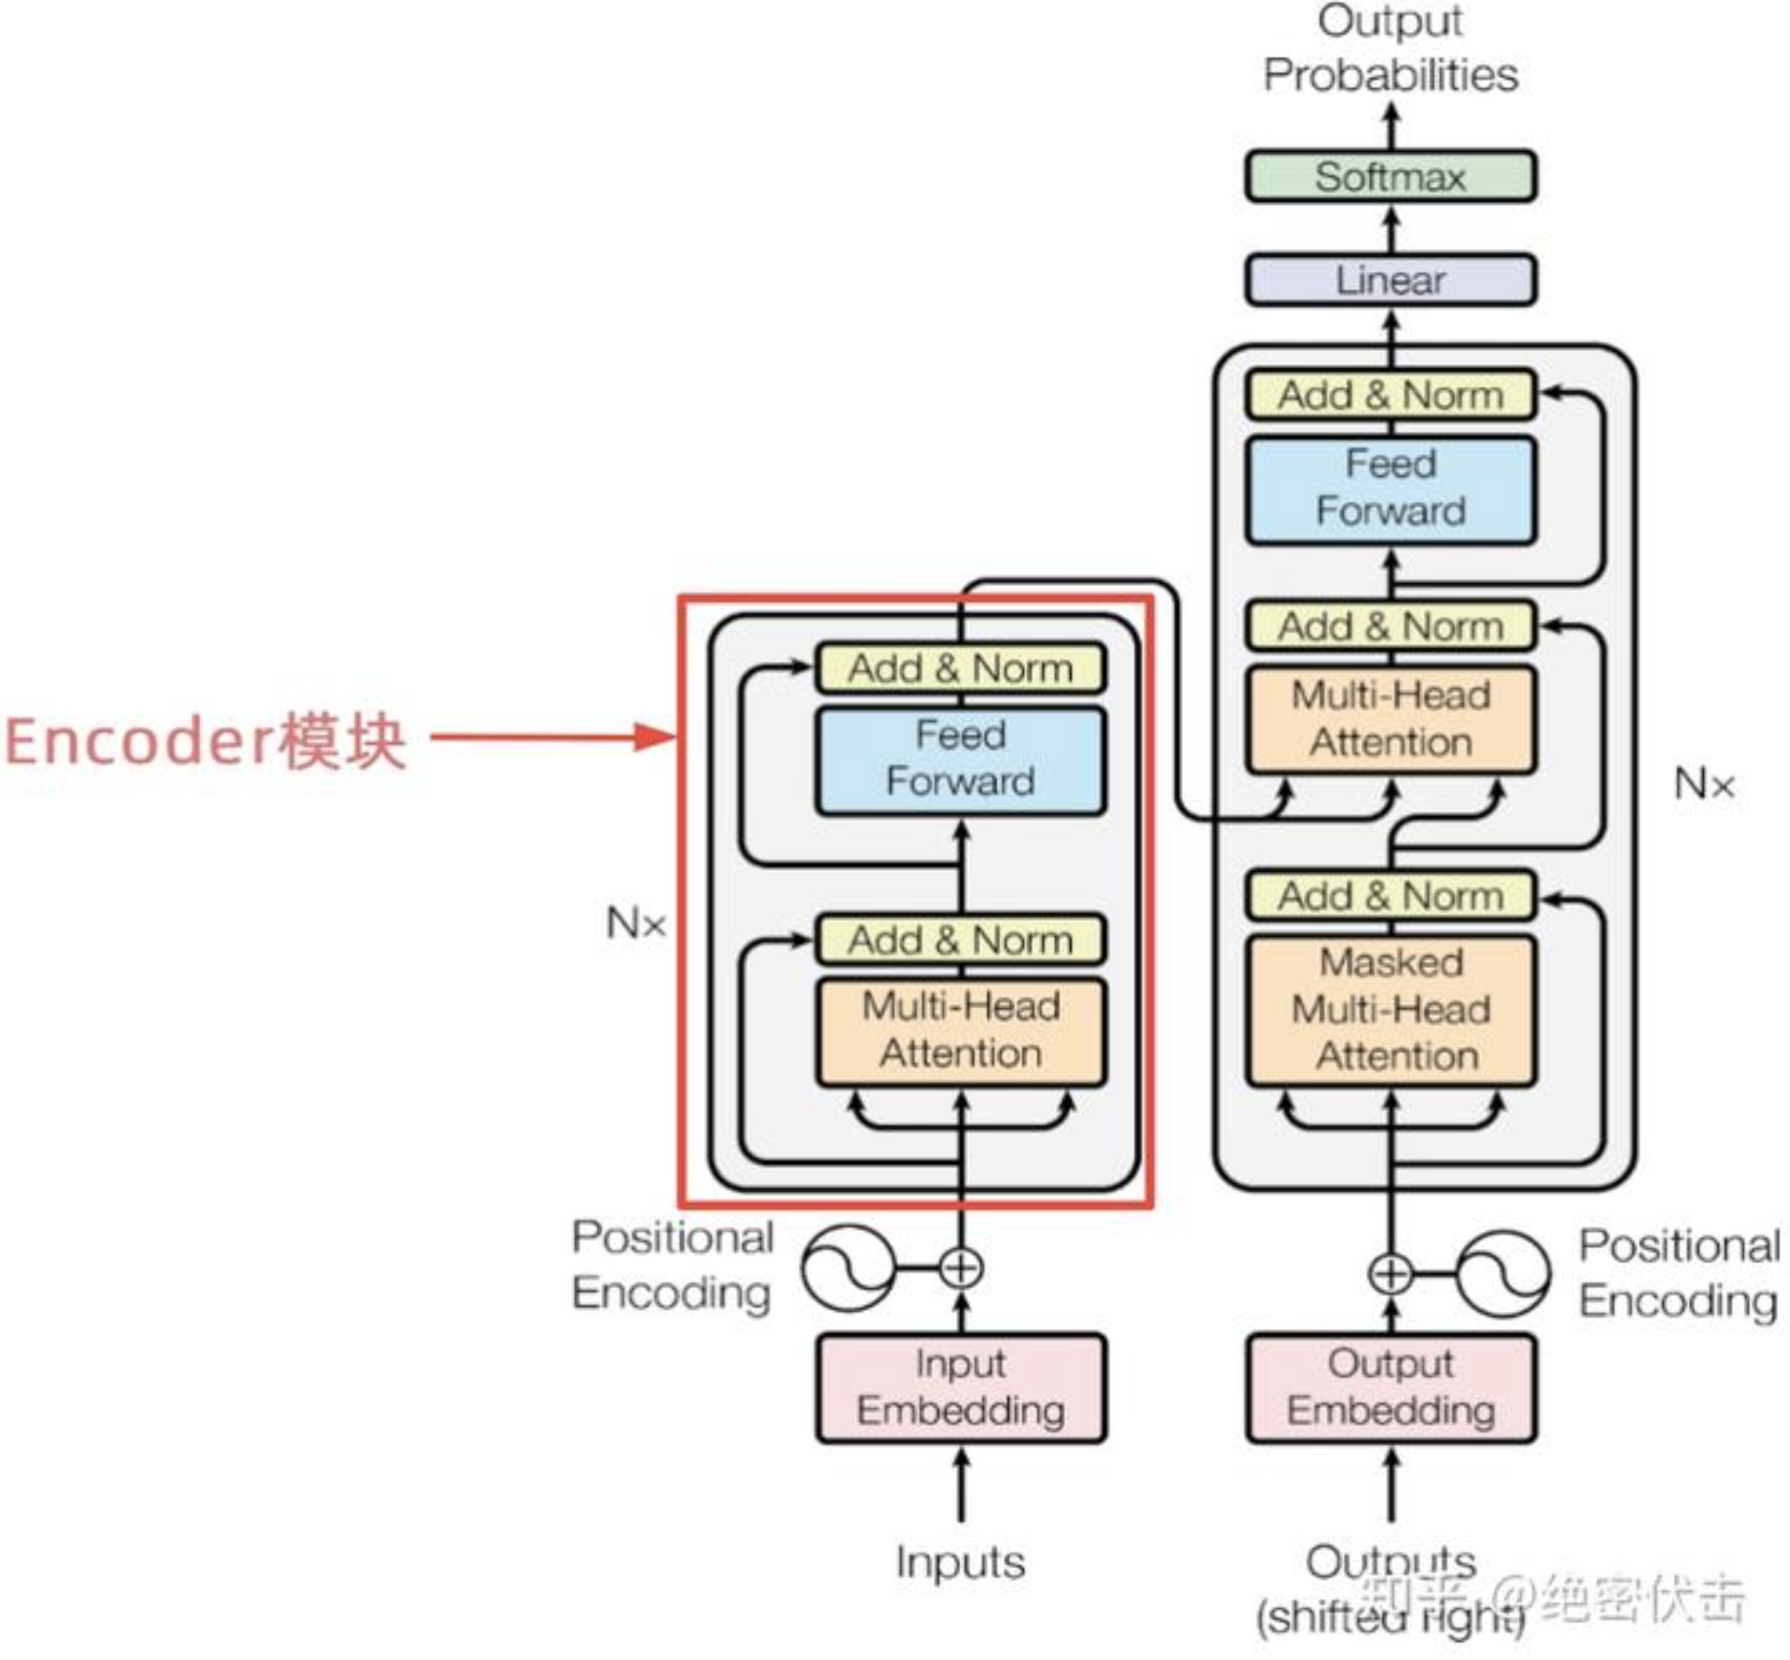
上图红色部分是Transformer的Encoder结构,N表示Encoder的个数,可以看到是由Multi-Head Attention、Add & Norm、Feed Forward、Add & Norm组成的。前面已经介绍了Multi-Head Attention的计算过程,现在了解一下Add & Norm和 Feed Forward部分。
原始论文中 Encoder 堆叠了 N=6 层。每一层结构是固定的两个子层:(1) Multi-Head Self-Attention;(2) Position-wise Feed Forward。每个子层外面都包着 "Add & Norm"(残差 + LayerNorm)。
4.1 单个Encoder输出
Add & Norm是指残差连接后使用LayerNormalization,表示如下:
Sublayer表示经过的变换,比如第一个Add & Norm中Sublayer表示Multi-Head Attention。
4.1.1 LayerNorm 与残差:为什么这样搭
残差连接(Residual / Skip Connection):把子层输入 X 直接加到子层输出上(X + Sublayer(X))。它的作用是缓解深层网络的梯度消失/退化问题——梯度可以沿着"捷径"直接回传,使得网络可以堆到很深层(几十甚至上百层)而不退化。没有残差,深层 Transformer 几乎训不动。
Layer Normalization:对每一个样本的特征维度做标准化(均值、方差在该样本的所有特征上计算),而不是像 BatchNorm 那样跨 batch 算。公式:
其中 \(\mu,\sigma\) 是该样本特征维的均值与标准差,\(\gamma,\beta\) 是可学习缩放/偏移参数。为什么用 LayerNorm 而不用 BatchNorm?
- Transformer 训练常用大 batch + 长序列,BatchNorm 在单样本或小 batch 时统计量不稳定;
- 推理时序列长度变化大,BatchNorm 的 running mean/var 难以适配;
- LayerNorm 与 batch 大小、序列长度无关,只依赖单样本,更稳定、更适合 NLP 和生成场景。
现代变体:很多大模型(如 Llama、GPT-NeoX)把 LayerNorm 换成 RMSNorm(Root Mean Square Norm),去掉了减均值这一步,计算更便宜且效果相当:
RMSNorm(x) = x / sqrt(mean(x²)+ε) * γ。
Feed Forward**是指全连接层,表示如下:
FFN 是"逐位置(position-wise)"的:它对每个 token 独立地做一个两层 MLP(先升维到 \(d_{ff}=2048\),经 ReLU/GeLU 激活,再降回 \(d_{model}=512\))。注意它不混合不同 token 的信息(token 间的信息混合发生在注意力层),所以被称为 position-wise feed-forward。它相当于给每个位置一个"非线性加工"的小网络,是容量的主要来源之一。
因此输入矩阵X经过一个Encoder后,输出表示如下:
4.2 多个Encoder输出
通过上面的单个Encoder,输入矩阵 ${X}\in \mathbb{R}^{n\times d} $,最后输出矩阵 \({O}\in \mathbb{R}^{n\times d}\)。通过多个Encoder叠加,最后便是编码器Encoder的输出。
叠多层的效果是"表示逐步抽象":底层可能捕捉词法/局部依存,高层捕捉语义角色、篇章关系。底层输出直接喂给解码器的交叉注意力(Cross-Attention)作为 K、V(见第 5.2 节)。
5、解码器Decoder结构
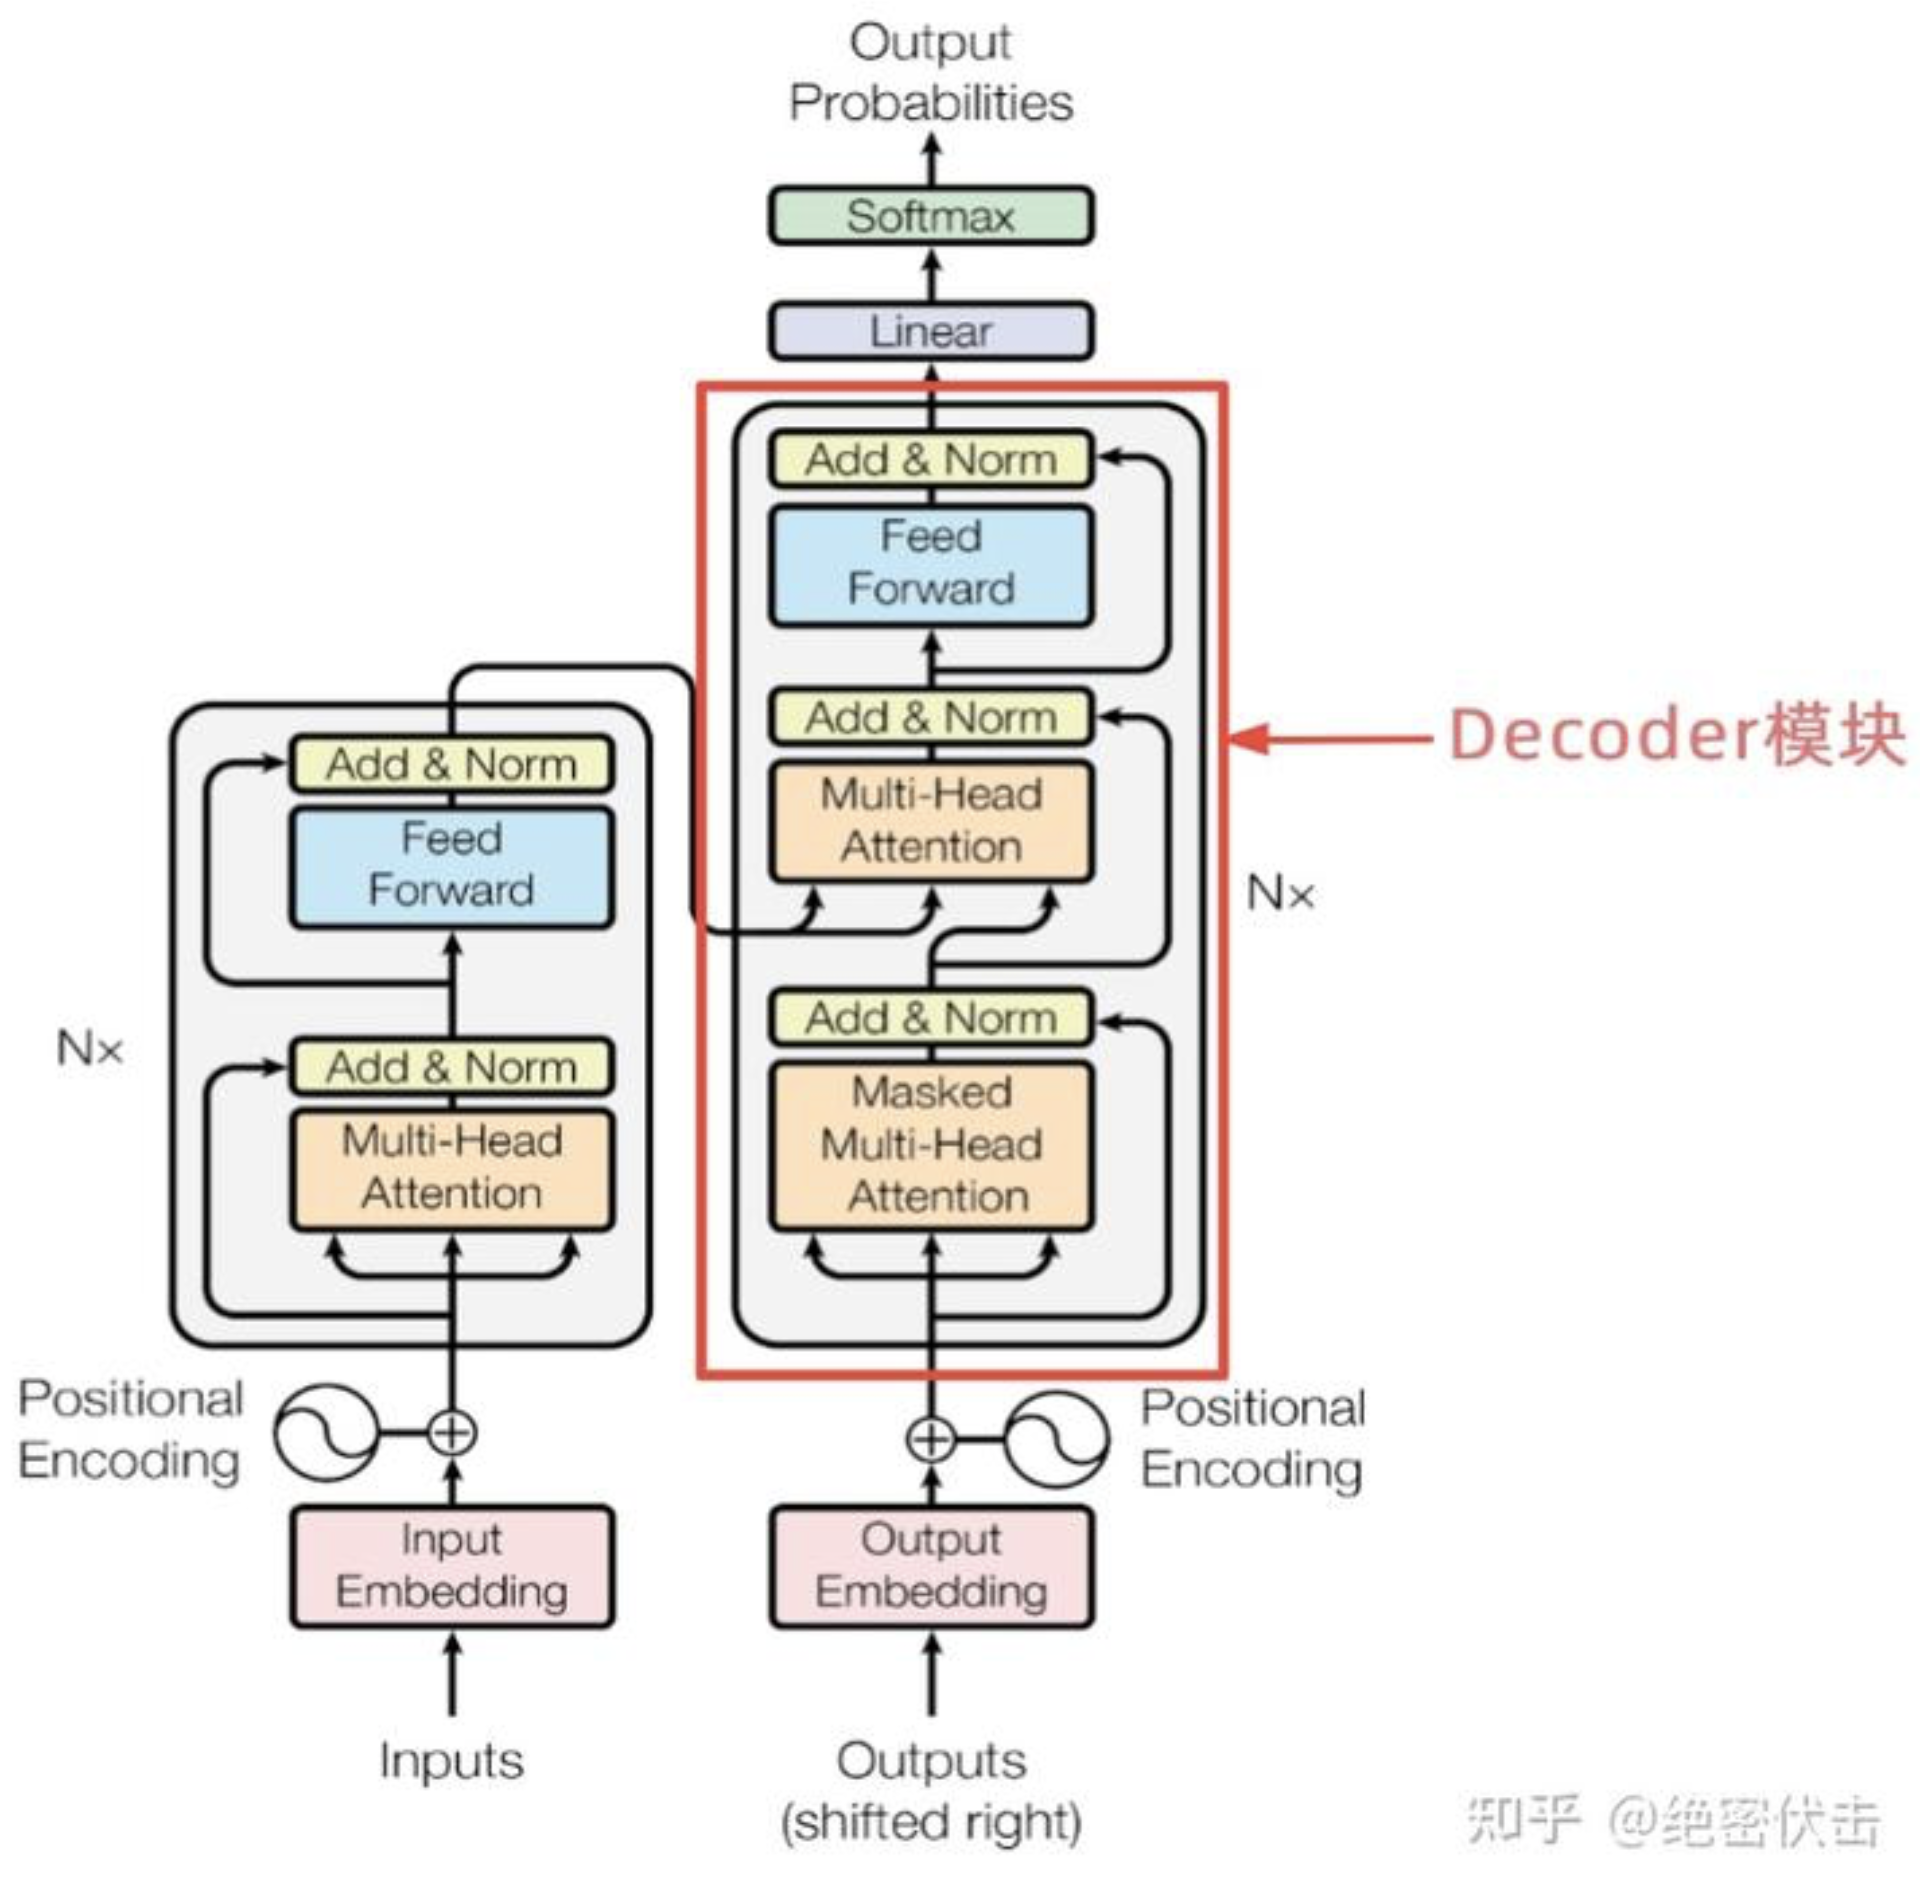
上图红色部分为Transformer的Decoder结构,与Encoder相似,但是存在一些区别:
- 包含两个Multi-Head Attention
- 第一个Multi-Head Attention采用了Masked操作
- 第二个Multi-Head Attention的 \({K},{V}\) 矩阵使用Encoder的**编码信息矩阵 \({C}\)进行计算,而 \({Q}\)使用上一个 Decoder的输出计算
- 最后有一个Softmax层计算下一个翻译单词的概率
解码器同样堆叠 N=6 层,但每层有三个子层:Masked Self-Attention → Cross-Attention(看编码器输出)→ FFN。
5.1、第一个Multi-Head Attention
Decoder的第一个Multi-Head Attention采用了Masked操作,因为在翻译的过程中是顺序翻译的,即翻译完第 \(i\)个单词,才可以翻译第 \(i+1\)个单词。通过 Masked 操作可以防止第 \(i\)个单词知道 \(i+1\)个单词之后的信息。下面以法语"Je suis etudiant"翻译成英文"I am a student"为例,了解一下Masked 操作。
在Decoder的时候,需要根据之前翻译的单词,预测当前最有可能翻译的单词,如下图所示。首先根据输入"
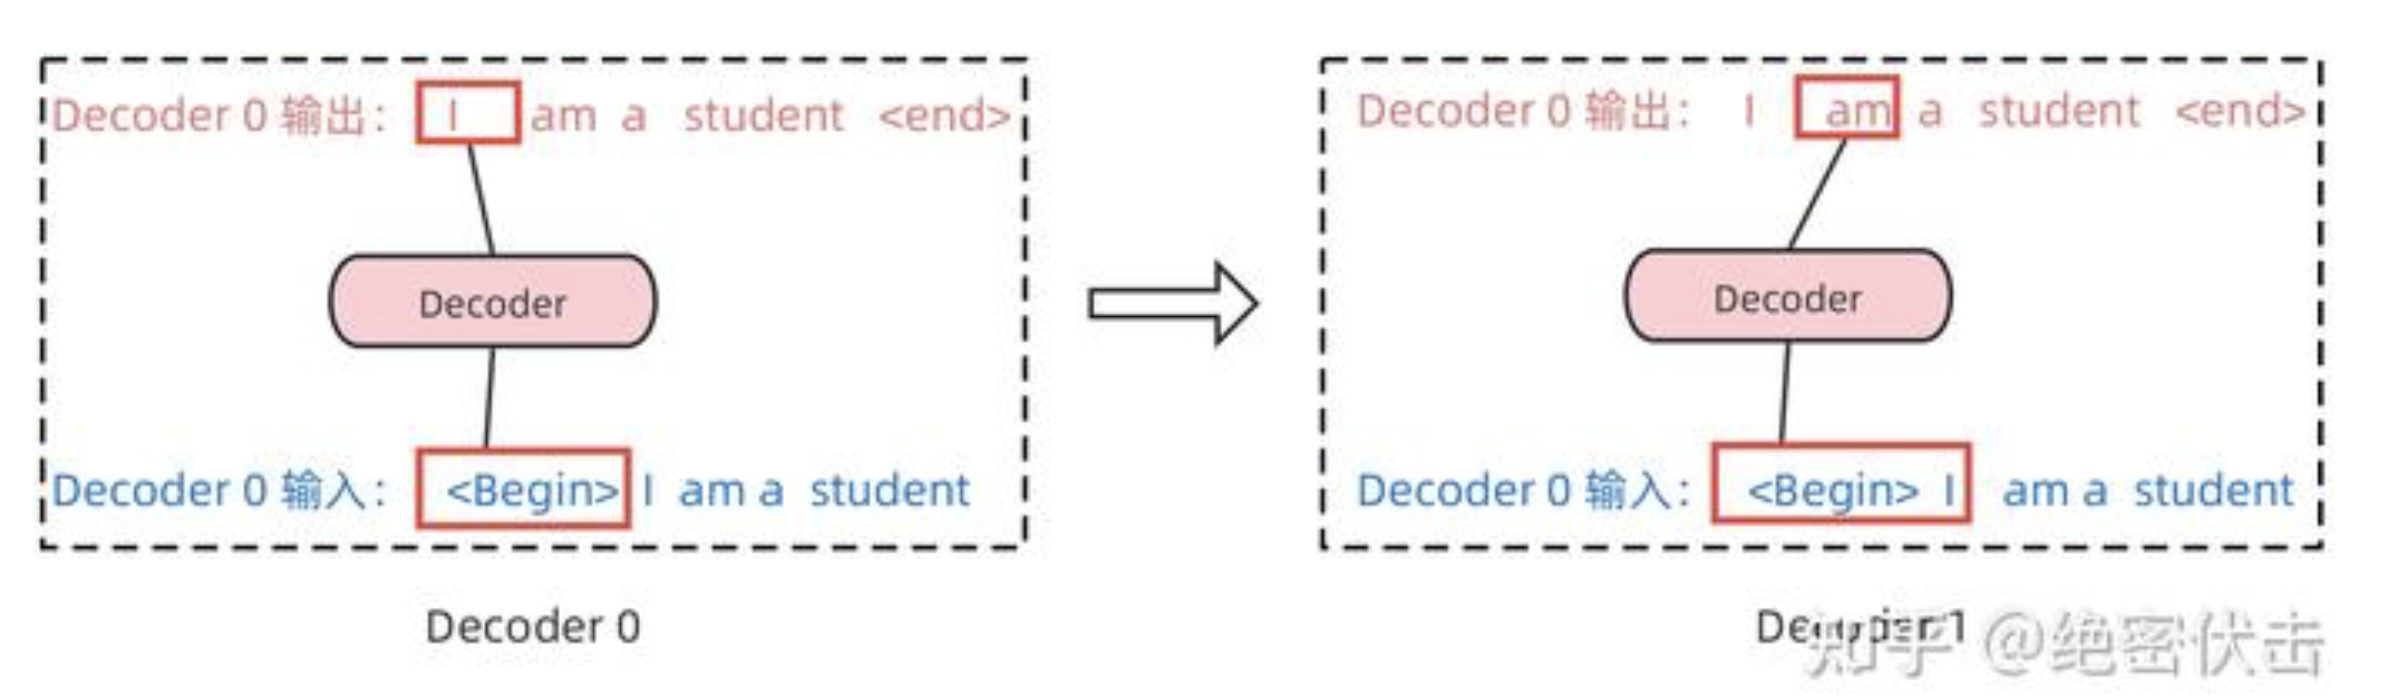
Decoder在预测第i个输出时,需要将第i+1之后的单词掩盖住,Mask操作是在Self-Attention的Softmax之前使用的,下面以前面的"I am a student"为例。
第一步:是Decoder的输入矩阵和Mask矩阵,输入矩阵包含"
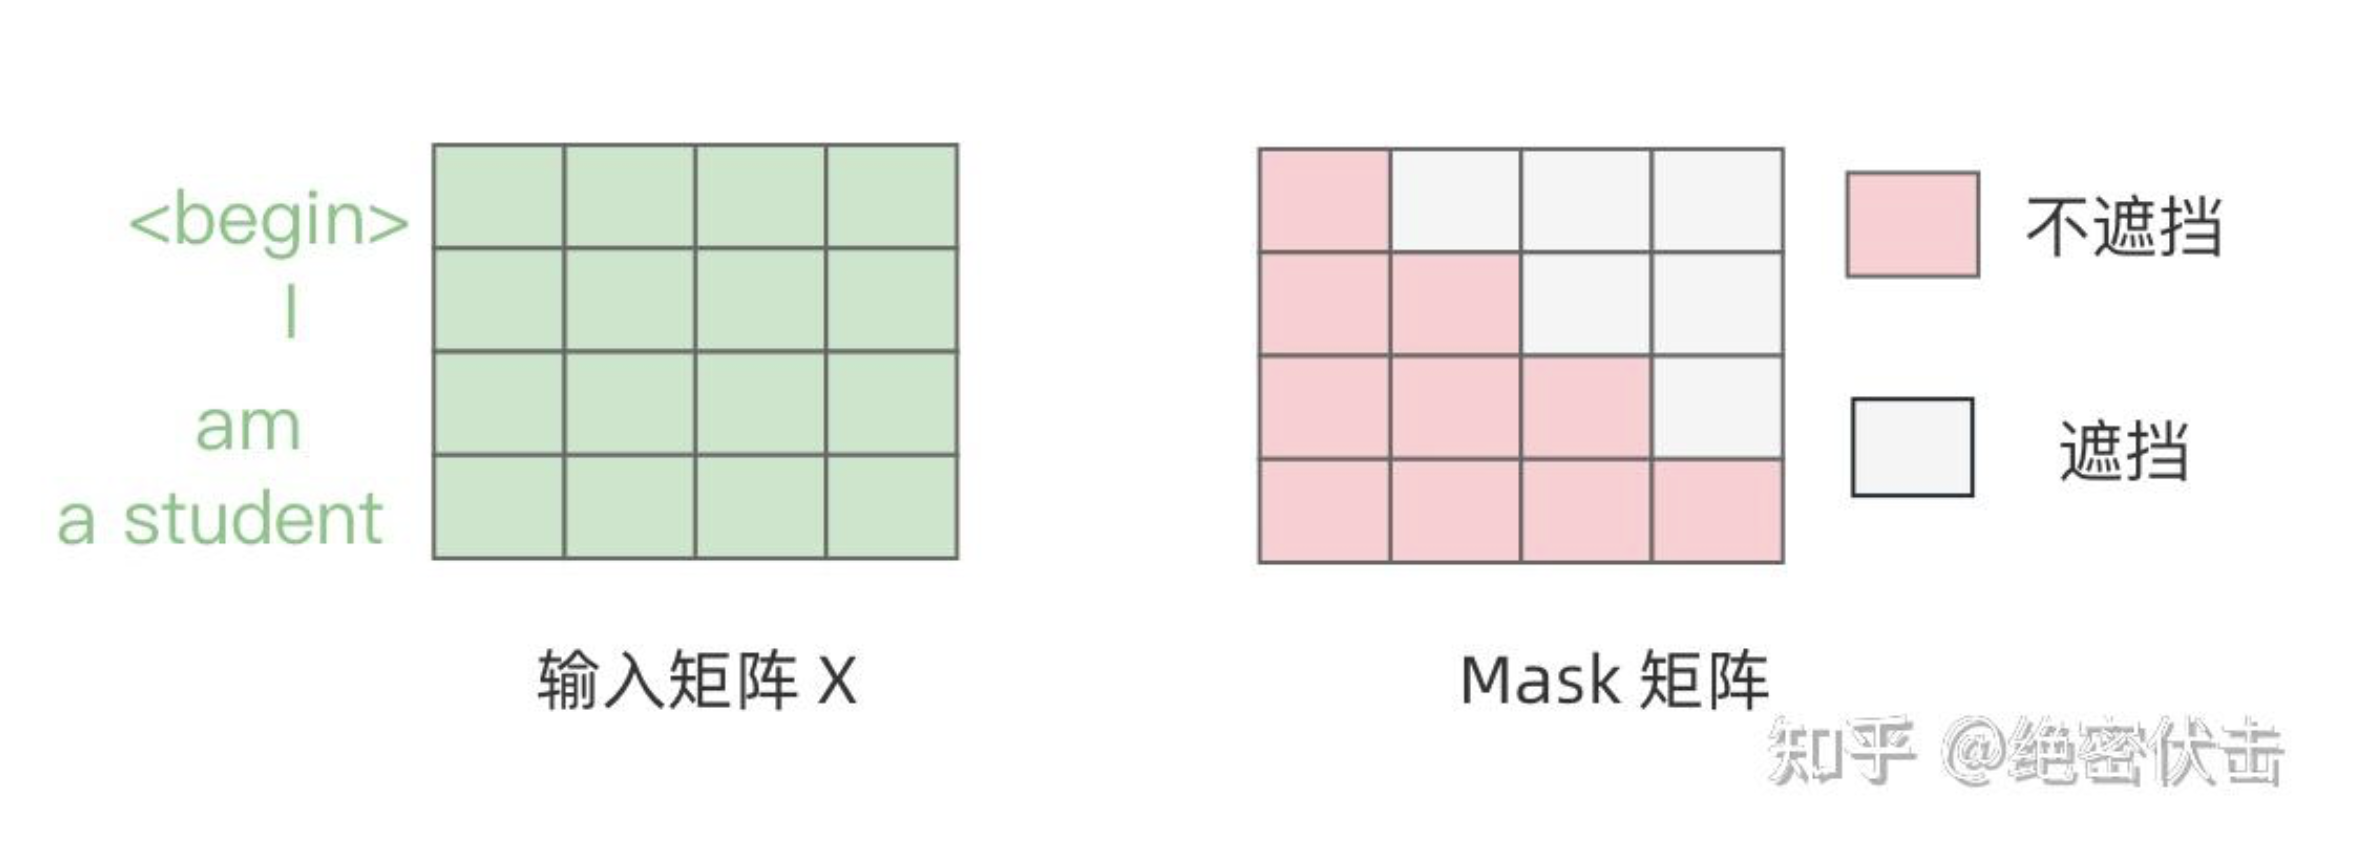
第二步:接下来的操作和之前Encoder中的Self-Attention一样,只是在Softmax之前需要进行Mask操作。
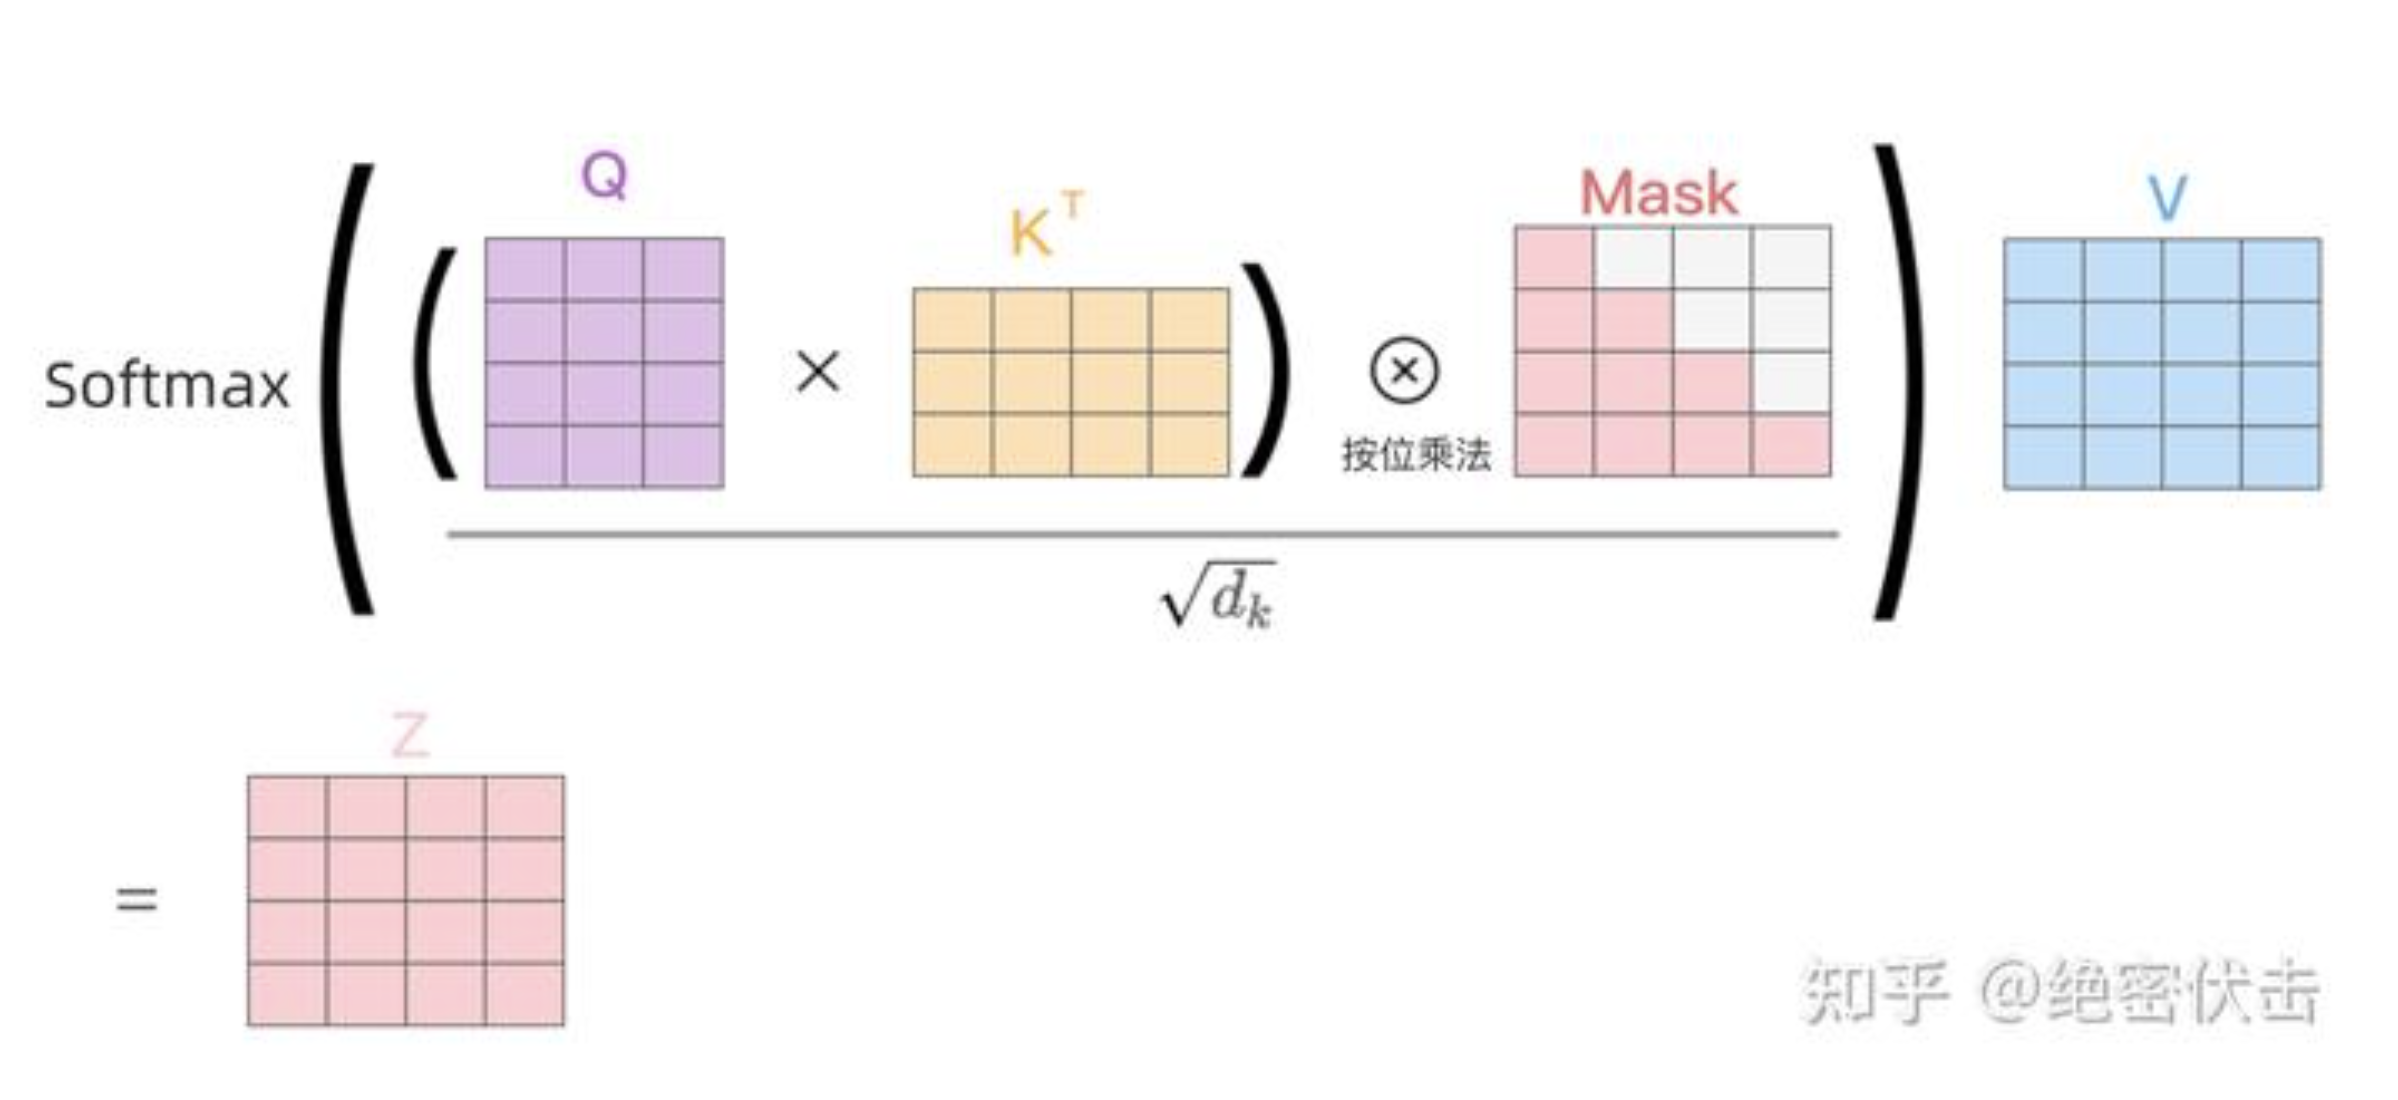
第三步:通过上述步骤就可以得到一个Mask Self-Attention的输出矩 \(Z_{i}\),然后和Encoder类似,通过Multi-Head Attention拼接多个输出 \(Z_{i}\)然后计算得到第一个Multi-Head Attention的输出 \({Z}\),与输入 $ X $ 维度一样。
5.1.1 Causal Mask 的实现细节
上面那个 \(4\times4\) 的 Mask 矩阵,本质上是一个下三角矩阵(含对角线)。实现时常见的两种做法:
- Additive Mask:在 softmax 前,把未来位置对应的 scores 加上一个很大的负数(如
-1e9),softmax 后这些位置权重≈0。 - Causal Attention:直接利用"第 i 行只能看到第 ≤i 列"的下三角结构,配合 FlashAttention 的变体高效实现。
这一步就是后来所有自回归生成式模型(GPT 系列)的核心:训练时把"答案"整体喂入,但用 causal mask 保证每个位置只看前文,从而可以并行训练(一次前向就把整句话都算了),而推理时却是一个词一个词吐出来的。训练并行、推理串行,这个差异非常重要。
5.2、第二个Muti-Head Attention
- Decoder的第二个Multi-Head Attention主要的区别在于其中Self-Attention的 \({K},{V}\) 矩阵不是使用上一个Multi-Head Attention的输出,而是使用Encoder的编码信息矩阵 \({C}\) 计算的。
- 根据Encoder的输出 \({C}\) 计算得到 \(K,V\),根据上一个Multi-Head Attention的输出$ {Z} $计算 $ Q $ 。这样做的好处是在Decoder的时候,每一位单词(这里是指"I am a student")都可以利用到Encoder所有单词的信息(这里是指"Je suis etudiant")。
这一层叫 Cross-Attention(交叉注意力):Query 来自解码器自身(已生成的部分),Key/Value 来自编码器(源语言全文)。它让解码器在生成每个目标词时,都能"回头看"源句子的全部信息——这正是机器翻译、摘要等 seq2seq 任务能对齐来源的依据。
GPT 等 Decoder-only 模型没有这一层(因为没有编码器),它们只有 Masked Self-Attention + FFN,Self-Attention 的 Q/K/V 全部来自同一段上文。
5.3、KV Cache:自回归推理的必备优化
这是理解"大模型为什么能流畅生成"的关键工程机制。
推理时,模型是一个 token 一个 token 往外蹦的。如果每次生成一个新 token,都把之前所有 token 重新跑一遍完整的注意力,那第 t 步的计算量会是 O(t²),越生成越慢,完全不可接受。
KV Cache 的做法:既然历史 token 的 K、V 在生成过程中不会变(它们只依赖历史输入,而历史输入已固定),那就把每一层、每一个历史位置的 K 和 V 缓存下来。生成第 t 个 token 时:
- 只需对新 token 算它自己的 Q、K、V;
- 新 K、V 追加进缓存;
- 新 Q 与缓存里所有历史 K 算注意力,得到新 token 的输出。
这样每步注意力计算量从 O(t²) 降到 O(t),代价是多占显存(要存下所有层的 K、V)。显存占用 ≈ 层数 × batch × 已生成长度 × 2(K,V) × 头数 × 每头维度 × 精度字节数。这也正是后面 GQA / MQA / MLA(第 7 节)要省显存的根本动机——KV Cache 太大了。
6、Softmax预测输出
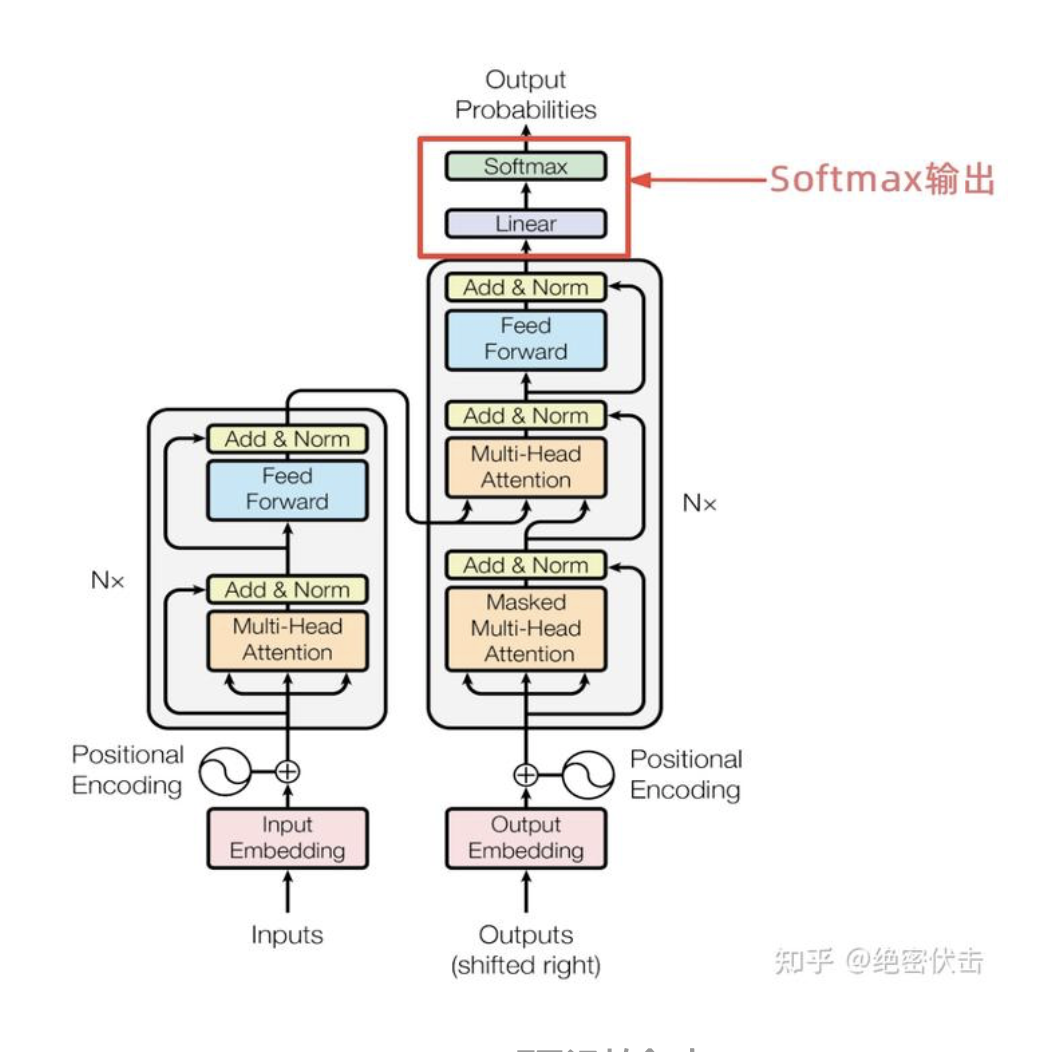
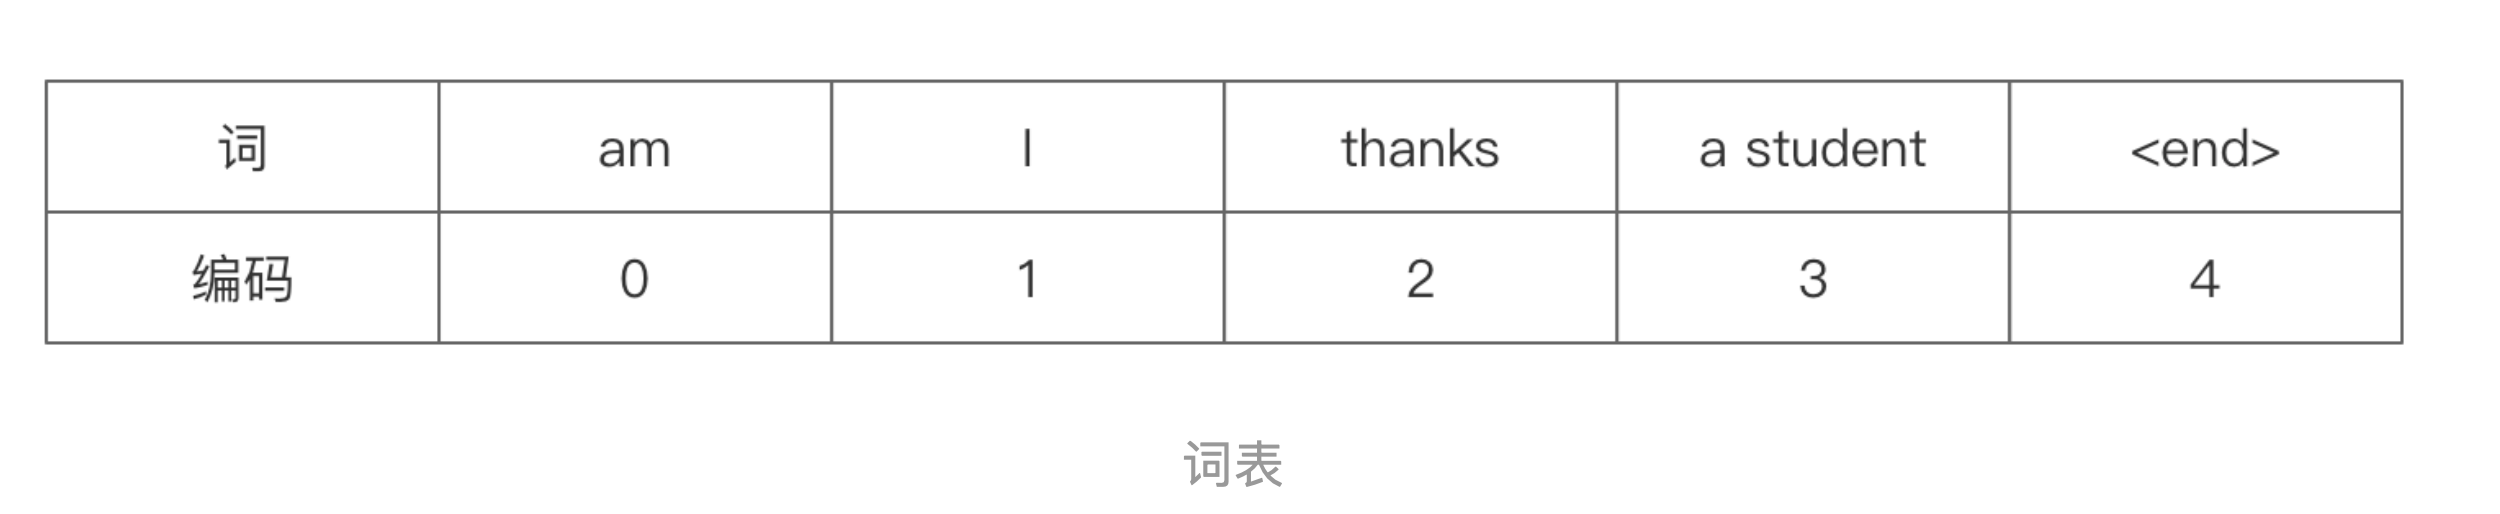
编码器Decoder最后的部分是利用 Softmax 预测下一个单词,在Softmax之前,会经过Linear变换,将维度转换为词表的个数。假设我们的词表只有6个单词,表示如下:
最后的输出为
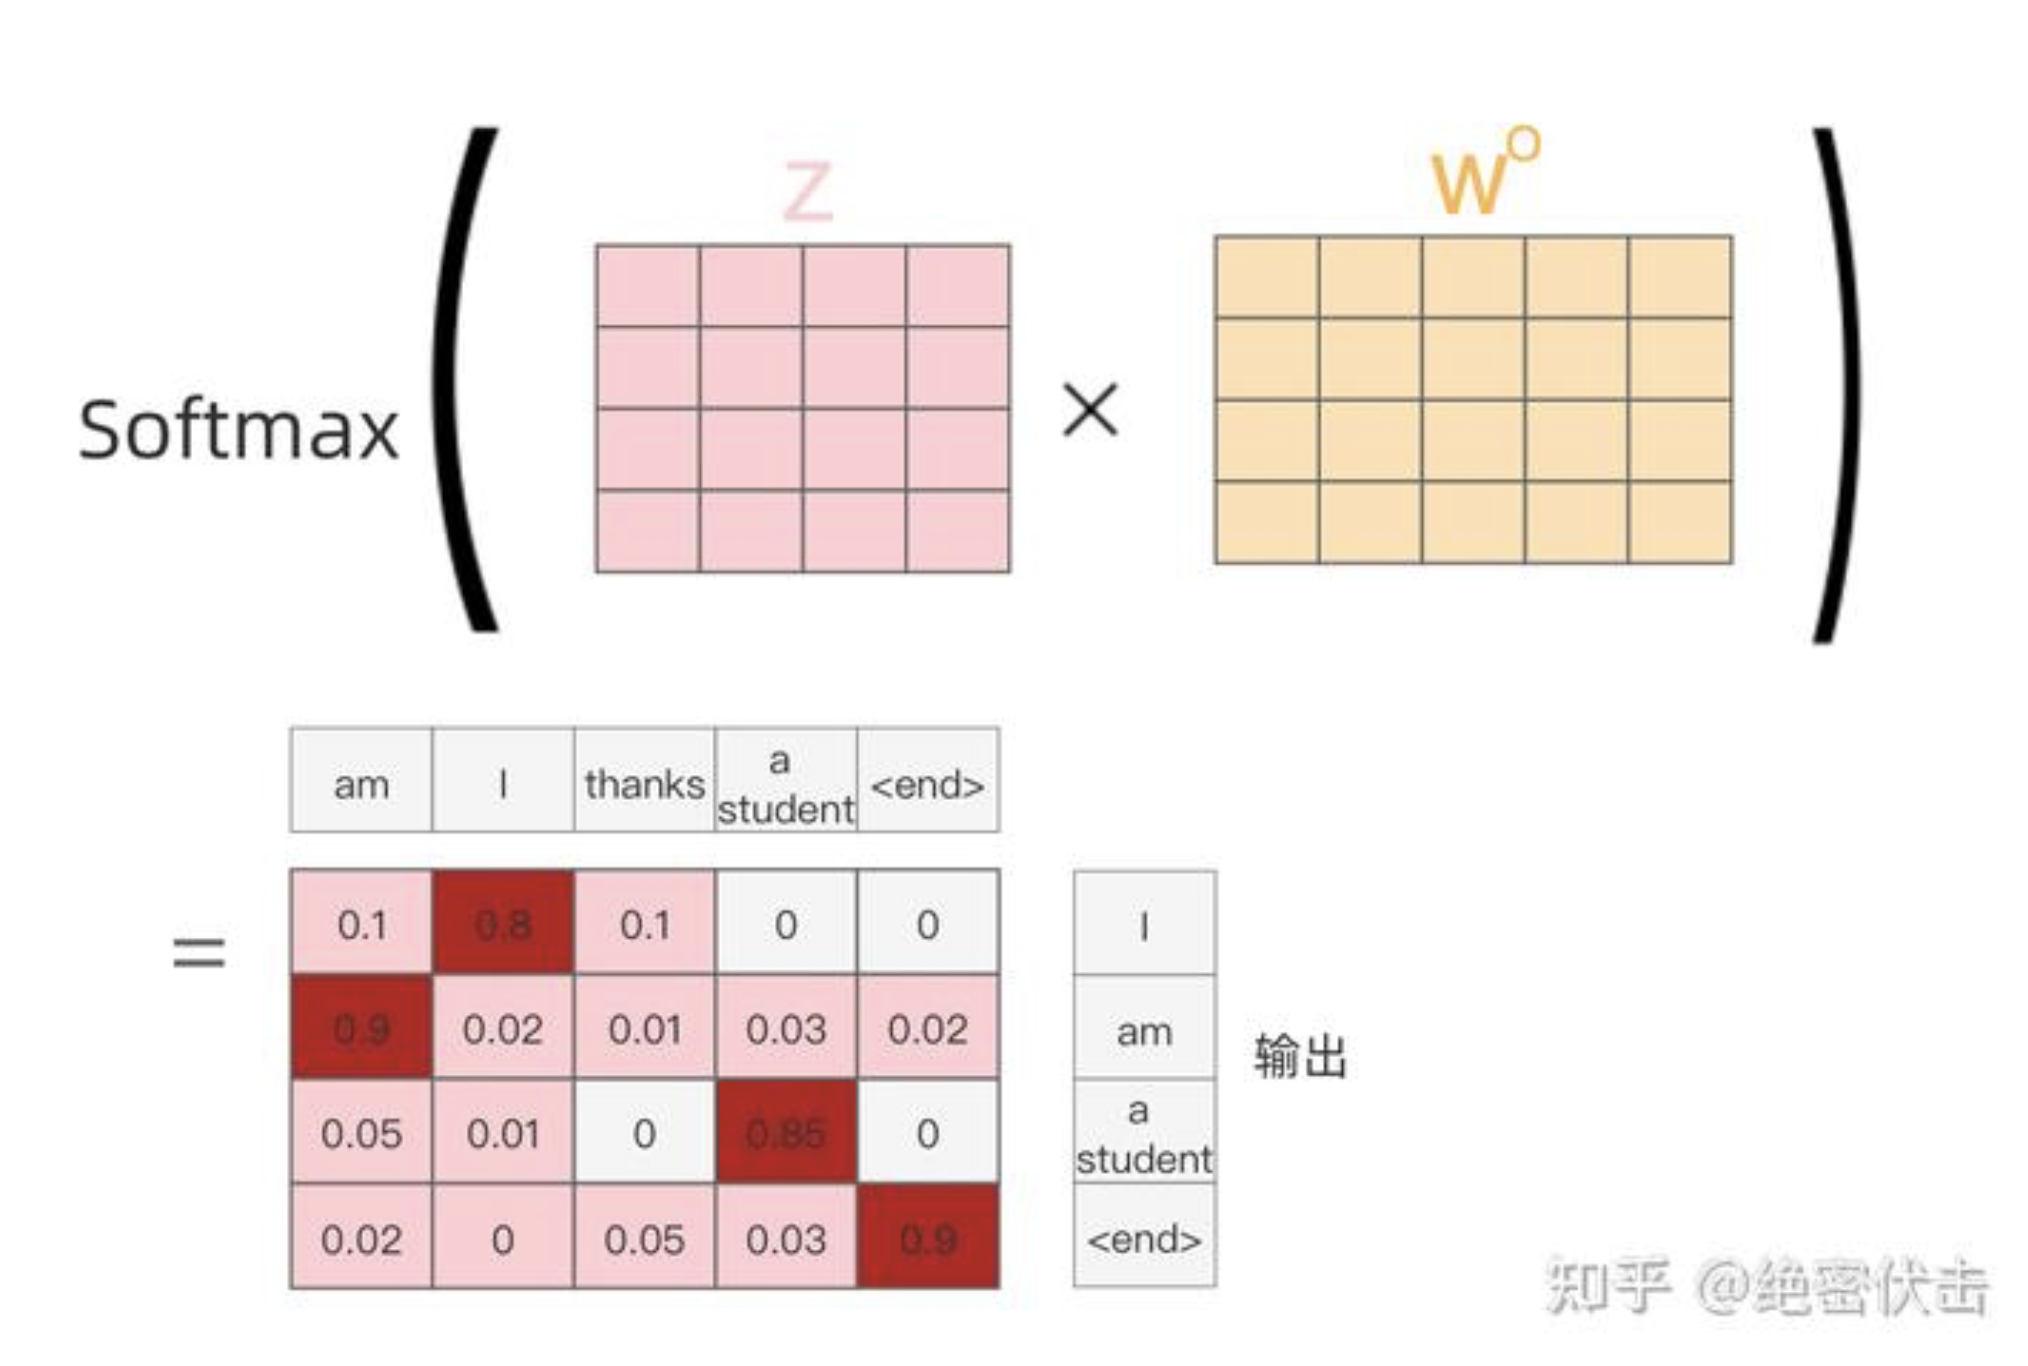
最后这一步本质是语言模型头(LM Head):一个线性层把隐藏向量从 d_model 投影到词表大小 V,再 softmax 得到"下一个词"的概率分布。训练目标是让正确下一个词的 log 概率最大(交叉熵损失),这就是标准的自回归语言建模损失。
两个工程现实:
- 词表很大(通常 3 万~20 万),最后这个线性层参数量 =
d_model × V,在 GPT-3(175B)里它约占数百亿参数,不可忽视。 - 采样策略:推理时并不总取 argmax,而是用 temperature、top-k、top-p 等控制多样性(详见 03-ChatGPT原理 的温度/top-p 章节)。这里只需知道:softmax 给出的分布是后续所有采样策略的输入。
7、2020 → 2026 的架构演进
原论文之后,Transformer 衍生出三大流派,并不断被改进:
7.1、三大流派
| 流派 | 代表 | 结构 |
|---|---|---|
| Encoder-only | BERT、RoBERTa | 双向注意力,适合理解类任务(分类/检索) |
| Decoder-only | GPT 系、DeepSeek、Qwen、Llama | 单向因果注意力,生成式预训练,如今的大模型主流 |
| Encoder-Decoder | T5、BART | 翻译/摘要等 seq2seq 任务 |
为什么 Decoder-only 最终胜出?一个被广泛接受的解释是:因果语言建模(predict next token)是一个极其通用且无标注成本的预训练目标——互联网上任意文本都能当训练数据;而 Encoder-only 的掩码目标、Encoder-Decoder 的翻译目标都更"窄"。当数据和参数规模上去后,Decoder-only 的"通用续写"能力可以涌现出指令遵循、推理、代码等多种能力。
7.2、关键改进技术
| 技术 | 解决的问题 | 代表 |
|---|---|---|
| RoPE 旋转位置编码 | 外推到更长上下文(替代原始正弦位置编码) | Llama、Qwen、DeepSeek |
| GQA / MQA | 多头 KV 缓存太大 → 分组共享 KV,推理省显存 | Llama 2/3、DeepSeek-V2 |
| MoE 混合专家 | 用稀疏激活把总参数量和单 token 计算量解耦 | DeepSeek-V3(671B 总参/37B 激活)、Mixtral |
| MLA 多头潜在注意力 | 把 KV 压缩到低秩潜空间,缓存大幅缩小 | DeepSeek-V2/V3 |
| FlashAttention / PagedAttention | 注意力与 KV Cache 的工程实现优化 | vLLM、几乎所有推理框架 |
| 长上下文 | 4k → 128k → 1M+ 窗口 | 各家旗舰模型标配 |
补充几点理解:
- MQA / GQA:标准多头注意力每个 query 头有独立的 K、V 头,KV Cache 随头数线性增长。MQA 让所有 query 头共享一组 K/V 头,省显存但可能损质量;GQA(Grouped-Query Attention)折中——把 query 头分成若干组,每组共享一对 K/V 头,兼顾显存与质量,被 Llama 2/3 采用。
- FlashAttention:不改变注意力的数学结果,而是通过"分块(tiling)+ 重计算"减少 GPU 显存与高带宽内存(HBM)之间的读写,既快又省显存,是当今训练/推理的底层标配。
- MoE:每个 token 只激活少数几个"专家"前馈层,总参数很大但单 token 算力可控,是"大模型"参数破千亿/万亿却还能训练得动的秘诀。
7.3、如何看现代模型的结构
如今的"大模型"已经很少是裸 Transformer:DeepSeek-V3 = MoE + MLA + RoPE + MTP(多 token 预测训练目标);Qwen3、Llama 4 也是 Decoder-only 的变体。但自注意力"让每个位置按相关性吸收全局信息"这一核心机制没有变——理解了本文的 Q/K/V 与 Mask,就理解了所有现代 LLM 的骨架。
8、实践细节与踩坑
这一节汇总实际训练/使用 Transformer 时最容易踩的坑,面向有编程基础的读者。
- padding 与 attention mask 必须配套:变长序列要 pad 到同一长度,但 pad 位置不能参与注意力(否则模型会从 padding 里"偷看"信息)。一定要构造 key_padding_mask 或把 pad 对应的 score 置
-inf。漏掉这一步是新手最常见的 bug。 - position id 在推理时要连续递增:用 KV Cache 生成时,新 token 的 position 必须接着历史位置 +1,否则 RoPE/位置编码错位,生成质量崩塌。
- 缩放因子 \(\sqrt{d_k}\) 别忘:手写注意力时如果漏掉除以 \(\sqrt{d_k}\),大维度下 softmax 饱和,训练几乎不更新。
- LayerNorm 的位置(Pre-LN vs Post-LN):原始论文是 Post-LN(子层输出后再 Norm)。但深层网络用 Post-LN 容易训练不稳,现代大模型普遍改用 Pre-LN(先 Norm 再进子层,结果再残差加回),训练更稳、对学习率更鲁棒。
- 数值精度与 softmax 溢出:长序列下 scores 可能很大,用
torch.softmax一般会内部做 max 平移;但混合精度训练时要注意 fp16 的溢出,必要时用 fp32 算 attention。 - 显存瓶颈在激活值而非参数:训练时 O(n²) 的注意力激活、以及反向传播的中间结果,往往比模型参数更吃显存,所以才有 activation checkpointing、FlashAttention 等优化。
- batch 内序列长度差异大时,用 packing / 动态 mask 比统一 pad 到最长更省算力和显存。
9、常见面试问题
下面这些问题是 Transformer 相关面试的高频题,建议结合本文亲手推导/写代码。
- Self-Attention 的时间/空间复杂度是多少?与序列长度 n 的关系?(答:O(n²·d),主要来自 QK^T 的 n×n 矩阵。)
- 为什么要除以 \(\sqrt{d_k}\)?(答:防止点积过大导致 softmax 饱和、梯度消失。)
- Multi-Head 的意义是什么?能不能只加大 d_model 而不分头?(答:多头提供多子空间的多视角表示;单纯加宽不如多头解耦有效。)
- LayerNorm 和 BatchNorm 的区别?为什么 Transformer 用 LN?(答:LN 在特征维、逐样本归一化,与 batch/长度无关,适合变长序列。)
- 位置编码有哪几种?RoPE 为什么比 Sinusoidal 更适合长上下文?(答:见 2.3 节;RoPE 把相对位置编码进内积,外推更友好。)
- 什么是 Causal Mask?训练和推理分别是怎么做的?(答:下三角,保证只看前文;训练并行、推理串行+KV Cache。)
- KV Cache 解决了什么问题?它的显存开销怎么估算?(答:避免重复计算历史,开销见 5.3 节公式。)
- 残差连接的作用?Pre-LN 和 Post-LN 有何不同?(答:缓解退化;Pre-LN 训练更稳。)
- Encoder-Decoder 与 Decoder-only 的核心区别?为什么现在主流是 Decoder-only?(答:见 7.1 节。)
- Cross-Attention 的 Q/K/V 分别来自哪里?(答:Q 来自解码器,K/V 来自编码器。)
10、与后续技术的联系
- GPT 系列 / 大模型预训练:GPT 只用 Decoder-only + Causal Mask,把"预测下一个词"做成超大规模预训练目标,是本文结构最直接的后代(见 02-从GPT到大模型时代)。
- BERT / 检索 / 分类:Encoder-only 双向注意力,做"完形填空"式预训练,适合理解任务。
- RLHF / 对齐(ChatGPT):在预训练好的 Transformer 基础上,用 SFT → 奖励模型 → PPO 做人类偏好对齐(见 03-ChatGPT原理)。
- 高效注意力:FlashAttention、稀疏注意力、线性注意力(如 Reformer 的 LSH)都在试图把 O(n²) 降下来。
- 长上下文与外推:RoPE + YaRN / NTK scaling,配合位置插值(PI),让 4k 训练的模型用到 128k+。
- 推理优化:GQA/MQA/MLA 减小 KV Cache;PagedAttention(vLLM)做显存分页;量化(INT8/FP4)进一步降本。
- 多模态:ViT 把图像切成 patch 当作 token,和文本共用同一套 Transformer 骨架,催生 GPT-4V、Qwen-VL 等多模态模型。
11、参考
- 原论文:https://arxiv.org/abs/1706.03762
- The Illustrated Transformer:https://jalammar.github.io/illustrated-transformer/
- DeepSeek-V2(MLA):https://arxiv.org/abs/2405.04434
- DeepSeek-V3(MoE + MTP):https://arxiv.org/abs/2412.19437
- RoPE 原文:https://arxiv.org/abs/2104.09864
- ALiBi 原文:https://arxiv.org/abs/2108.12409
- FlashAttention:https://arxiv.org/abs/2205.14135

 浙公网安备 33010602011771号