
【WebWiki】09 · MySQL 整理笔记
一、数据库概念
1.1、什么是数据库
数据库 ( DataBase , 简称DB )
概念 : 长期存放在计算机内,有组织,可共享的大量数据的集合,是一个数据 "仓库"
作用 : 保存,并能安全管理数据(如:增删改查等),减少冗余...
数据库总览 :
-
关系型数据库 ( SQL )
-
- MySQL , Oracle , SQL Server , SQLite , DB2 , ...
- 关系型数据库通过外键关联来建立表与表之间的关系
-
非关系型数据库 ( NOSQL )
-
- Redis , MongoDB , ...
- 非关系型数据库通常指数据以对象的形式存储在数据库中,而对象之间的关系通过每个对象自身的属性来决定
实战补充(与 08 篇互补角度):08 篇侧重安装、配置与基础运维,本篇侧重"写对 SQL、写好 SQL"。日常开发中 80% 的性能问题来自索引失效、错误 JOIN、大表无分区与备份缺失。理解下面的"概念"不是背定义,而是要清楚关系型数据库用二维表 + SQL 表达关系,而 SQL 是声明式的——你只描述"要什么",优化器决定"怎么做",所以真正影响性能的是你写的 SQL 长什么样、索引怎么建。
1.2、什么是DBMS
数据库管理系统 ( DataBase Management System )
数据库管理软件 , 科学组织和存储数据 , 高效地获取和维护数据
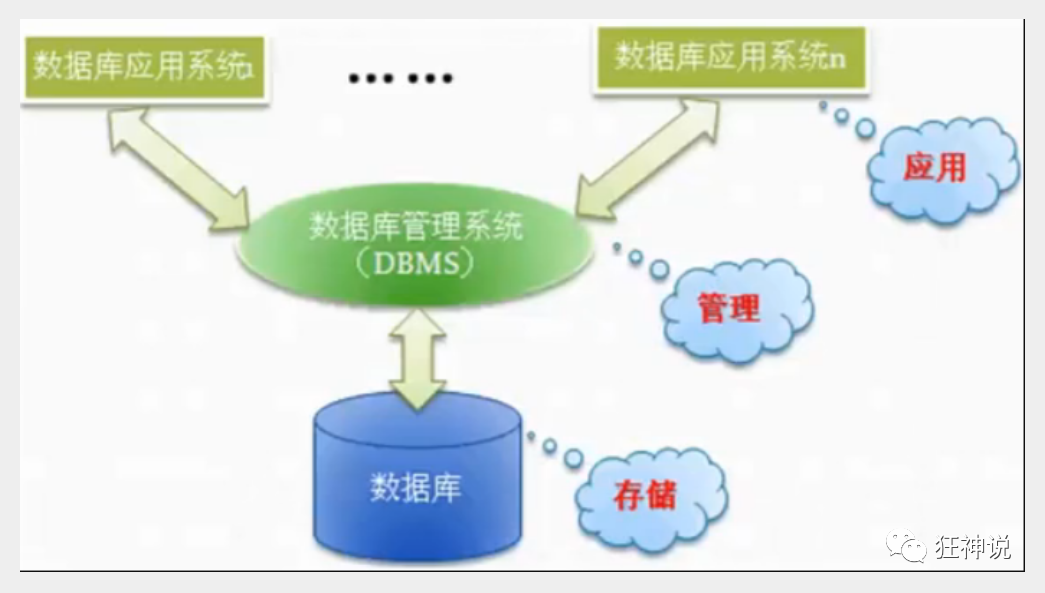
MySQL应该算是一个数据库管理系统.
补充:Server 层与存储引擎层:MySQL 的 DBMS 分两层。Server 层负责连接、查询缓存(8.0 已移除)、解析、优化、执行,以及内置函数、存储过程、触发器、视图;存储引擎层(InnoDB / MyISAM 等)负责数据的存储与提取。一条 SQL 经过的流程是:连接器 → 查询缓存(8.0 前)→ 分析器(词法/语法)→ 优化器(选索引、决定 JOIN 顺序)→ 执行器 → 存储引擎。理解这条链路,后面讲索引失效、执行计划才有抓手。
1.3、MySQL简介
概念 : 是现在流行的开源的,免费的 关系型数据库
历史 : 由瑞典MySQL AB 公司开发,目前属于 Oracle 旗下产品。
特点 :
- 免费 , 开源数据库
- 小巧 , 功能齐全
- 使用便捷
- 可运行于Windows或Linux操作系统
- 可适用于中小型甚至大型网站应用
版本选择提示:生产环境优先选 5.7 或 8.0 的稳定小版本。8.0 默认使用
utf8mb4、隐藏主键、CTE( WITH 子句)、窗口函数、不可见索引、instant DDL等特性,且默认caching_sha2_password认证插件(老驱动需改回mysql_native_password)。5.7 仍是大量存量系统主力。注意utf8在 MySQL 里只支持最多 3 字节,存不了 emoji,务必用utf8mb4。
二、数据库操作
2.1、结构化查询语句分类
| 名称 | 解释 | 命令 |
|---|---|---|
| DDL数据库定义语言 | 定义和管理数据对象,库表等 | create,drop,alter... |
| DML数据库操作语言 | 操作数据 | INSERT,UPDATE,DELETE |
| DQL数据查询语言 | 查询 | select |
| DCL数据控制语言 | 管理数据库的语言,修改权限等 | grant,commit,roolback |
补充:TCL 事务控制语言:除了上表四类,还常把
COMMIT / ROLLBACK / SAVEPOINT / SET TRANSACTION单独归为 TCL(Transaction Control Language)。DQL 本质属于 DML 的子集但习惯单列。记住分类有助于理解"哪些语句会隐式提交事务":DDL(create/alter/drop)在 MySQL 中会隐式提交当前事务,这正是"建表前的事务未提交会丢失"的原因,也是线上执行 DDL 要谨慎的点。
2.2、数据库操作
命令行操作数据库
创建数据库 :  create database [if not exists] 数据库名;
删除数据库 : drop database [if exists] 数据库名;
查看数据库 : show databases;
使用数据库 : use 数据库名;
2.2.1、创建数据表
属于DDL的一种,语法 :
create table [if not exists] `表名`(
   '字段名1' 列类型 [属性][索引][注释],
   '字段名2' 列类型 [属性][索引][注释],
   '字段名n' 列类型 [属性][索引][注释]
)[表类型][表字符集][注释];
说明 : 反引号用于区别MySQL保留字与普通字符而引入的 (键盘esc下面的键).
实战补充:建表规范
- 显式指定
ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci,不要依赖 server 默认值。- 每个表都要有主键(即使业务无自然主键,也用
BIGINT UNSIGNED AUTO_INCREMENT自增主键,让二级索引叶子节点存主键而非行指针,减少索引膨胀与页分裂)。- 字段能 NOT NULL 就 NOT NULL,NULL 会增加索引与优化器判断成本,且
COUNT(col)不统计 NULL。- 金额用
DECIMAL(10,2)或整型"分",不要用FLOAT/DOUBLE会丢精度。- 时间优先
DATETIME(与时区无关、8 字节)或TIMESTAMP(有 2038 上限、4 字节),需要"软删除/归档时间"可加deleted_at。
2.2.2、数据值和列类型
列类型 : 规定数据库中该列存放的数据类型
2.2.2.1、数值类型
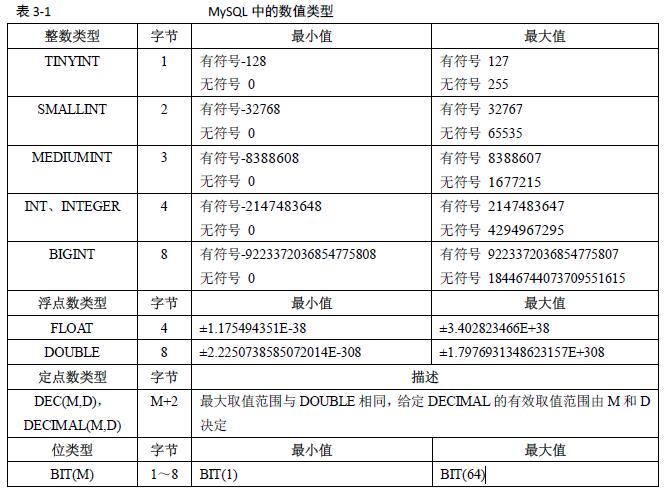
补充:整型的显示宽度与 zerofill 是"显示用"不是"存储用":
INT(11)和INT(4)占用空间一样(都是 4 字节),括号里的数字只是显示宽度提示;8.0 已不推荐使用INT(M)的显示宽度语法。选型上,能用INT就不用BIGINT(省空间=省内存=省 IO),但分布式/雪花 ID 必须用BIGINT。
2.2.2.2、字符串类型
| 类型 | 大小 | 用途 |
|---|---|---|
| CHAR | 0-255 bytes | 定长字符串 |
| VARCHAR | 0-65535 bytes | 变长字符串 |
| TINYBLOB | 0-255 bytes | 不超过 255 个字符的二进制字符串 |
| TINYTEXT | 0-255 bytes | 短文本字符串 |
| BLOB | 0-65 535 bytes | 二进制形式的长文本数据 |
| TEXT | 0-65 535 bytes | 长文本数据 |
| MEDIUMBLOB | 0-16 777 215 bytes | 二进制形式的中等长度文本数据 |
| MEDIUMTEXT | 0-16 777 215 bytes | 中等长度文本数据 |
| LONGBLOB | 0-4 294 967 295 bytes | 二进制形式的极大文本数据 |
| LONGTEXT | 0-4 294 967 295 bytes | 极大文本数据 |
补充:
VARCHAR的"行溢出"与最大长度:VARCHAR实际占真实长度 + 1~2 字节长度标记;当单行总长度超过约 65535 字节(受页 16KB 限制,实际可用约 8126 字节)时,InnoDB 会把超长列放到"溢出页"(off-page),主记录只留 20 字节指针。因此大文本/JSON 优先用TEXT/JSON类型,避免把超大字段塞进频繁访问的宽表里。定长枚举(如性别、状态)用CHAR(1)或TINYINT比VARCHAR更省、更快。
2.2.2.3、日期和时间型数值类型
| 类型 | 大小 ( bytes) | 范围 | 格式 | 用途 |
|---|---|---|---|---|
| DATE | 3 | 1000-01-01/9999-12-31 | YYYY-MM-DD | 日期值 |
| TIME | 3 | '-838:59:59'/'838:59:59' | HH:MM:SS | 时间值或持续时间 |
| YEAR | 1 | 1901/2155 | YYYY | 年份值 |
| DATETIME | 8 | 1000-01-01 00:00:00/9999-12-31 23:59:59 | YYYY-MM-DD HH:MM:SS | 混合日期和时间值 |
| TIMESTAMP | 4 | 1970-01-01 00:00:00/2038 结束时间是第 2147483647 秒,北京时间 2038-1-19 11:14:07,格林尼治时间 2038年1月19日 凌晨 03:14:07 | YYYYMMDD HHMMSS | 混合日期和时间值,时间戳 |
2.2.2.4、NULL值
- 理解为 "没有值" 或 "未知值"
- 不要用NULL进行算术运算 , 结果仍为NULL
2.2.3、数据字段属性
UnSigned
- 无符号的
- 声明该数据列不允许负数 .
ZEROFILL
- 0填充的
- 不足位数的用0来填充 , 如int(3),5则为005
Auto_InCrement
-
自动增长的 , 每添加一条数据 , 自动在上一个记录数上加 1(默认)
-
通常用于设置主键 , 且为整数类型
-
可定义起始值和步长
-
- 当前表设置步长(AUTO_INCREMENT=100) : 只影响当前表
- SET @@auto_increment_increment=5 ; 影响所有使用自增的表(全局)
NULL 和 NOT NULL
- 默认为NULL , 即没有插入该列的数值
- 如果设置为NOT NULL , 则该列必须有值
DEFAULT
- 默认的
- 用于设置默认值
- 例如,性别字段,默认为"男" , 否则为 "女" ; 若无指定该列的值 , 则默认值为"男"的值
-- 目标 : 创建一个school数据库
-- 创建学生表(列,字段)
-- 学号int 登录密码varchar(20) 姓名,性别varchar(2),出生日期(datatime),家庭住址,email
-- 创建表之前 , 一定要先选择数据库

CREATE TABLE IF NOT EXISTS `student` (
`id` int(4) NOT NULL AUTO_INCREMENT COMMENT '学号',
`name` varchar(30) NOT NULL DEFAULT '匿名' COMMENT '姓名',
`pwd` varchar(20) NOT NULL DEFAULT '123456' COMMENT '密码',
`sex` varchar(2) NOT NULL DEFAULT '男' COMMENT '性别',
`birthday` datetime DEFAULT NULL COMMENT '生日',
`address` varchar(100) DEFAULT NULL COMMENT '地址',
`email` varchar(50) DEFAULT NULL COMMENT '邮箱',
PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8

-- 查看数据库的定义
SHOW CREATE DATABASE school;
-- 查看数据表的定义
SHOW CREATE TABLE student;
-- 显示表结构
DESC student;  -- 设置严格检查模式(不能容错了)SET sql_mode='STRICT_TRANS_TABLES';
补充:
AUTO_INCREMENT与并发/批量插入的坑
- 高并发下自增主键靠
innodb_autoinc_lock_mode控制:=2(交错锁模式)性能最好但有"主从复制(statement 格式)不安全"的坑;=1(默认,连续)最常用;=0(传统表锁)最稳但慢。- 自增值用掉不回收:删除最大 id 行后,再插入仍从"下一个"开始,不会复用,所以自增主键会出现空洞,这是正常的,不要误以为"删了数据 id 会回退"。
- 批量
INSERT ... SELECT或LOAD DATA时自增分配会按需预占,可能造成跳号,属预期行为。
2.2.4、数据表的类型
设置数据表的类型
CREATE TABLE 表名(
   -- 省略一些代码
   -- Mysql注释
   -- 1. # 单行注释
   -- 2. /*...*/ 多行注释
)ENGINE = MyISAM (or InnoDB)

-- 查看mysql所支持的引擎类型 (表类型)
SHOW ENGINES;
MySQL的数据表的类型 : MyISAM , InnoDB , HEAP , BOB , CSV等...
常见的 MyISAM 与 InnoDB 类型:
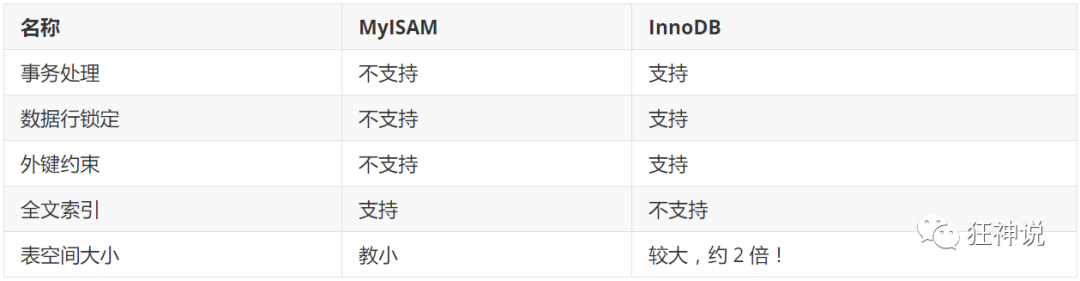
经验 ( 适用场合 ) :
- 适用 MyISAM : 节约空间及相应速度
- 适用 InnoDB : 安全性 , 事务处理及多用户操作数据表
数据表的存储位置
-
MySQL数据表以文件方式存放在磁盘中
-
- 包括表文件 , 数据文件 , 以及数据库的选项文件
- 位置 : Mysql安装目录\data\下存放数据表 . 目录名对应数据库名 , 该目录下文件名对应数据表 .
-
注意 :
-
-
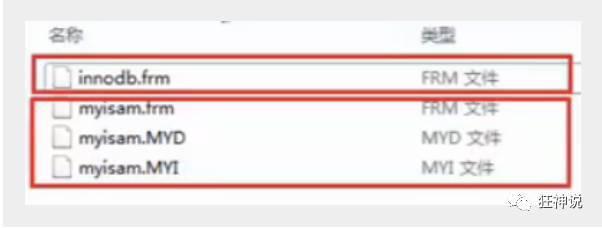
* . frm -- 表结构定义文件
-
* . MYD -- 数据文件 ( data )
-
* . MYI -- 索引文件 ( index )
-
InnoDB类型数据表只有一个 *.frm文件 , 以及上一级目录的ibdata1文件
-
MyISAM类型数据表对应三个文件 :
-
设置数据表字符集
我们可为数据库,数据表,数据列设定不同的字符集,设定方法 :
- 创建时通过命令来设置 , 如 : CREATE TABLE 表名()CHARSET = utf8;
- 如无设定 , 则根据MySQL数据库配置文件 my.ini 中的参数设定
实战补充:InnoDB 的表空间与文件演变
- 8.0 起
*.frm被取消,表结构合并进数据字典(独立mysql.ibd)。- InnoDB 有"独立表空间"(
innodb_file_per_table=ON,每张表一个表名.ibd)与"系统表空间"(ibdata1)两种。生产默认开独立表空间,方便TRUNCATE/回收空间;但单表超大(如几百 G)时ibd单文件维护也麻烦。- MyISAM 的
*.MYD/*.MYI分离,在只读/报表场景仍有用;但在崩溃恢复、事务、外键上全面弱于 InnoDB,新业务一律 InnoDB。- 字符集务必
utf8mb4;utf8是历史别名仅 3 字节,存 emoji/生僻字会报Incorrect string value。
2.2.5、修改数据库
修改表 ( ALTER TABLE )
修改表名 :ALTER TABLE 旧表名 RENAME AS 新表名
添加字段 : ALTER TABLE 表名 ADD字段名 列属性[属性]
修改字段 :
ALTER TABLE 表名 MODIFY 字段名 列类型[属性]ALTER TABLE 表名 CHANGE 旧字段名 新字段名 列属性[属性]
删除字段 : ALTER TABLE 表名 DROP 字段名
删除数据表
语法:DROP TABLE [IF EXISTS] 表名
- IF EXISTS为可选 , 判断是否存在该数据表
- 如删除不存在的数据表会抛出错误
补充:在线 DDL 与锁表(8.0 之前尤其要命)
ALTER TABLE加列/改类型在很多版本会"锁表 + 重建整表",大表可能锁几分钟到几小时。- 8.0 支持
ALGORITHM=INSTANT的少量操作(加列末尾、加虚拟列等)几乎瞬间完成;5.7 用ALGORITHM=INPLACE, LOCK=NONE(Online DDL)也要看操作类型。- 大表改结构强烈建议用
gh-ost或pt-online-schema-change,通过触发器/ binlog 增量,边写边建新表,几乎无锁。- 记住:DDL 会隐式提交事务,不要在事务里混着改表结构。
2.3、外键
如果公共关键字在一个关系中是主关键字,那么这个公共关键字被称为另一个关系的外键。由此可见,外键表示了两个关系之间的相关联系。
以另一个关系的外键作主关键字的表被称为主表,具有此外键的表被称为主表的从表。
在实际操作中,将一个表的值放入第二个表来表示关联,所使用的值是第一个表的主键值(在必要时可包括复合主键值)。此时,第二个表中保存这些值的属性称为外键(foreign key)。
外键作用
保持数据一致性,完整性,主要目的是控制存储在外键表中的数据,约束。使两张表形成关联,外键只能引用外表中的列的值或使用空值。
实战补充:互联网业务慎用外键
- 外键能保证一致性,但每次写从表都要去查/锁主表,存在跨表开销;删除主表数据还要先处理从表(或设
ON DELETE CASCADE/SET NULL)。- 高并发、分库分表场景下,外键根本无法跨库。因此多数互联网系统设计选择在应用层维护关联、用字段冗余/对账任务保证一致性,而不是靠数据库外键。
- 外键仍有价值:内部后台系统、强一致要求的财务/权限表,用外键省心。按场景取舍,别一刀切。
2.4、创建外键
1、建表时指定外键约束
-- 创建外键的方式一 : 创建子表同时创建外键

-- 年级表 (id\年级名称)
CREATE TABLE `grade` (
`gradeid` INT(10) NOT NULL AUTO_INCREMENT COMMENT '年级ID',
`gradename` VARCHAR(50) NOT NULL COMMENT '年级名称',
PRIMARY KEY (`gradeid`)
) ENGINE=INNODB DEFAULT CHARSET=utf8

-- 学生信息表 (学号,姓名,性别,年级,手机,地址,出生日期,邮箱,身份证号)
CREATE TABLE `student` (
`studentno` INT(4) NOT NULL COMMENT '学号',
`studentname` VARCHAR(20) NOT NULL DEFAULT '匿名' COMMENT '姓名',
`sex` TINYINT(1) DEFAULT '1' COMMENT '性别',
`gradeid` INT(10) DEFAULT NULL COMMENT '年级',
`phoneNum` VARCHAR(50) NOT NULL COMMENT '手机',
`address` VARCHAR(255) DEFAULT NULL COMMENT '地址',
`borndate` DATETIME DEFAULT NULL COMMENT '生日',
`email` VARCHAR(50) DEFAULT NULL COMMENT '邮箱',
`idCard` VARCHAR(18) DEFAULT NULL COMMENT '身份证号',
PRIMARY KEY (`studentno`),
KEY `FK_gradeid` (`gradeid`),
CONSTRAINT `FK_gradeid` FOREIGN KEY (`gradeid`) REFERENCES `grade` (`gradeid`)
) ENGINE=INNODB DEFAULT CHARSET=utf8
2、建表后修改
-- 创建外键方式二 : 创建子表完毕后,修改子表添加外键
ALTER TABLE `student`
ADD CONSTRAINT `FK_gradeid` FOREIGN KEY (`gradeid`) REFERENCES `grade` (`gradeid`);
2.5、删除外键
操作:删除 grade 表,发现报错
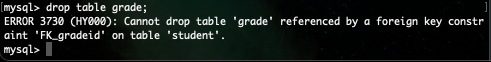
注意 : 删除具有主外键关系的表时 , 要先删子表 , 后删主表
-- 删除外键
ALTER TABLE student DROP FOREIGN KEY FK_gradeid;
-- 发现执行完上面的,索引还在,所以还要删除索引
-- 注:这个索引是建立外键的时候默认生成的
ALTER TABLE student DROP INDEX FK_gradeid;
三、DML语言
数据库意义 : 数据存储、数据管理
管理数据库数据方法:
- 通过navicat等管理工具管理数据库数据
- 通过DML语句管理数据库数据
DML语言:数据操作语言
-
用于操作数据库对象中所包含的数据
-
包括 :
-
- INSERT (添加数据语句)
- UPDATE (更新数据语句)
- DELETE (删除数据语句)
3.1、添加数据
INSERT INTO 表名[(字段1,字段2,字段3,...)] VALUES('值1','值2','值3')
实战补充:INSERT 的高效写法
- 多值批量:
INSERT INTO t(c1,c2) VALUES (...),(...),(...);一次插 N 行,比 N 条单值 INSERT 快很多(减少网络往返与事务开销),单批建议 500~1000 行。- 需要"存在则更新、不存在则插入"用
INSERT ... ON DUPLICATE KEY UPDATE( upsert,依赖唯一/主键冲突触发更新),或 8.0 的INSERT ... ON DUPLICATE KEY UPDATE+VALUES()。- 忽略重复:
INSERT IGNORE INTO,冲突时跳过不报错。- 从查询插入:
INSERT INTO t1 SELECT ... FROM t2 WHERE ...,做数据迁移/打平很方便。- 大批量导入优先
LOAD DATA INFILE(比 INSERT 快一个数量级),注意local与权限。
3.2、修改数据
update命令
语法:
UPDATE 表名 SET column_name=value [,column_name2=value2,...] [WHERE condition];
where条件子句
可以简单的理解为 : 有条件地从表中筛选数据
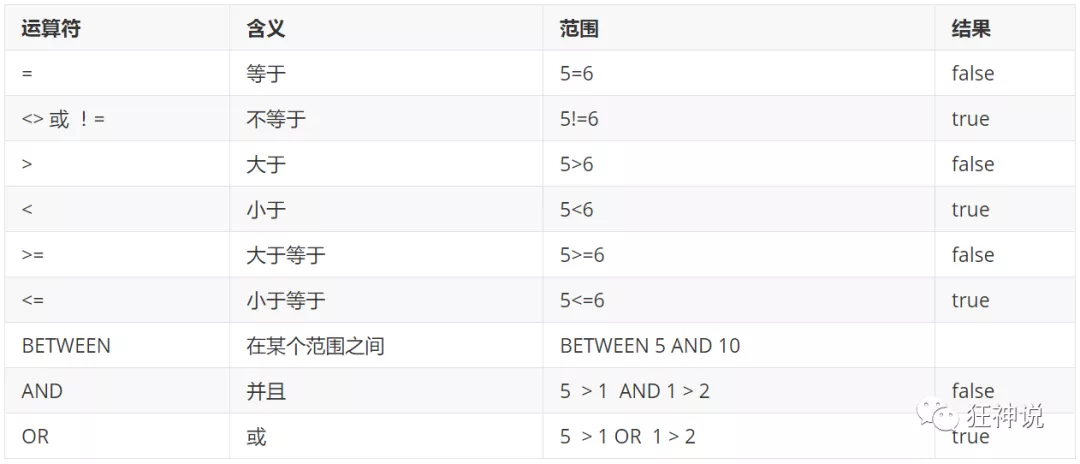 测试:
-- 修改年级信息
UPDATE grade SET gradename = '高中' WHERE gradeid = 1;
实战补充:UPDATE 的致命坑——忘写 WHERE 全表更新
UPDATE不带WHERE会更新整张表,且无法"回滚到更新前"除非有备份/事务未提交。生产务必开启--safe-updates(即sql_safe_updates=1),强制要求 UPDATE/DELETE 带WHERE且命中索引或LIMIT。- 大表 UPDATE 建议"分批 + LIMIT":
UPDATE t SET ... WHERE id BETWEEN ? AND ? LIMIT 1000;,循环推进,避免长时间持锁、主从延迟。- 跨表更新:
UPDATE a JOIN b ON a.id=b.id SET a.x=b.y WHERE ...,比先查再更干净,但同样要加条件防误伤。
3.3、删除数据
DELETE命令
语法:
DELETE FROM 表名 [WHERE condition];
注意:condition为筛选条件 , 如不指定则删除该表的所有列数据
-- 删除最后一个数据
DELETE FROM grade WHERE gradeid = 5
TRUNCATE命令
作用:用于完全清空表数据 , 但表结构 , 索引 , 约束等不变 ;
语法:
TRUNCATE [TABLE] table_name;

-- 清空年级表
TRUNCATE grade
注意:区别于DELETE命令
-
相同 : 都能删除数据 , 不删除表结构 , 但TRUNCATE速度更快
-
不同 :
-
- 使用TRUNCATE TABLE 重新设置AUTO_INCREMENT计数器
- 使用TRUNCATE TABLE不会对事务有影响 (事务后面会说)
测试:
-- 创建一个测试表
CREATE TABLE `test` (
`id` INT(4) NOT NULL AUTO_INCREMENT,
`coll` VARCHAR(20) NOT NULL,
PRIMARY KEY (`id`)
) ENGINE=INNODB DEFAULT CHARSET=utf8

-- 插入几个测试数据
INSERT INTO test(coll) VALUES('row1'),('row2'),('row3');

-- 删除表数据(不带where条件的delete)
DELETE FROM test;
-- 结论:如不指定Where则删除该表的所有列数据,自增当前值依然从原来基础上进行,会记录日志.

-- 删除表数据(truncate)
TRUNCATE TABLE test;
-- 结论:truncate删除数据,自增当前值会恢复到初始值重新开始;不会记录日志.

-- 同样使用DELETE清空不同引擎的数据库表数据.重启数据库服务后
-- InnoDB : 自增列从初始值重新开始 (因为是存储在内存中,断电即失)
-- MyISAM : 自增列依然从上一个自增数据基础上开始 (存在文件中,不会丢失)
实战补充:DELETE 大表的正确姿势
DELETE FROM 大表会逐行加锁、写 undo/redo、产生大量 binlog,且 InnoDB 把"已删除"行标记后并不立即释放空间,表文件反而可能变大。大表清数据首选TRUNCATE(但它是 DDL、不可带条件、会重置自增)。- 需要"按条件删部分"且量大时,务必分批 DELETE + LIMIT + sleep,例如每次删 2000 行,循环到删完,避免长事务与主从延迟。
- 逻辑删除(软删)比物理删除更常见:加
deleted_at字段、UPDATE ... SET deleted_at=NOW(),查询统一带deleted_at IS NULL,可审计、可恢复,代价是查询都要带条件、索引要包含该列。
四、使用DQL查询数据
4.1、DQL( Data Query Language 数据查询语言 )
- 查询数据库数据 , 如SELECT语句
- 简单的单表查询或多表的复杂查询和嵌套查询
- 是数据库语言中最核心,最重要的语句
- 使用频率最高的语句
SELECT语法
SELECT [ALL | DISTINCT]
{* | table.* | [table.field1[as alias1][,table.field2[as alias2]][,...]]}
FROM table_name [as table_alias]
  [left | right | inner join table_name2]  -- 联合查询
  [WHERE ...]  -- 指定结果需满足的条件
  [GROUP BY ...]  -- 指定结果按照哪几个字段来分组
  [HAVING]  -- 过滤分组的记录必须满足的次要条件
  [ORDER BY ...]  -- 指定查询记录按一个或多个条件排序
  [LIMIT {[offset,]row_count | row_countOFFSET offset}];
   -- 指定查询的记录从哪条至哪条
注意 : [ ] 括号代表可选的 , { }括号代表必选得
实战补充:SQL 执行顺序与书写顺序不一致
书写顺序:SELECT → FROM → WHERE → GROUP BY → HAVING → ORDER BY → LIMIT
执行顺序:FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT
这解释了为什么WHERE里不能用别名(SELECT还没算)、HAVING才能对聚合后用别名过滤、ORDER BY能用SELECT别名。理解执行顺序,写复杂 SQL 才不会"明明列存在却报 Unknown column"。
4.2、指定查询字段
-- 查询表中所有的数据列结果 , 采用 **" \* "** 符号; 但是效率低,不推荐 .

-- 查询所有学生信息
SELECT * FROM student;

-- 查询指定列(学号 , 姓名)
SELECT studentno,studentname FROM student;
补充:
SELECT *为什么不推荐
- 多查字段 → 多读 IO、多占网络/内存;覆盖索引失效(见第六章索引)。
- 表结构变更(加/删列)会让依赖"列顺序"的代码出错。
- 明确列清单,可读性、稳定性、性能都更好。除非临时排查,生产代码别写
*。
4.3、AS 子句作为别名
作用:
- 可给数据列取一个新别名
- 可给表取一个新别名
- 可把经计算或总结的结果用另一个新名称来代替
-- 这里是为列取别名(当然as关键词可以省略)
SELECT studentno AS 学号,studentname AS 姓名 FROM student;

-- 使用as也可以为表取别名
SELECT studentno AS 学号,studentname AS 姓名 FROM student AS s;

-- 使用as,为查询结果取一个新名字
-- CONCAT()函数拼接字符串
SELECT CONCAT('姓名:',studentname) AS 新姓名 FROM student;
DISTINCT关键字的使用
作用 : 去掉SELECT查询返回的记录结果中重复的记录 ( 返回所有列的值都相同 ) , 只返回一条
-- # 查看哪些同学参加了考试(学号) 去除重复项
SELECT * FROM result; -- 查看考试成绩
SELECT studentno FROM result; -- 查看哪些同学参加了考试
SELECT DISTINCT studentno FROM result; -- 了解:DISTINCT 去除重复项 , (默认是ALL)
使用表达式的列
数据库中的表达式 : 一般由文本值 , 列值 , NULL , 函数和操作符等组成
应用场景 :
-
SELECT语句返回结果列中使用
-
SELECT语句中的ORDER BY , HAVING等子句中使用
-
DML语句中的 where 条件语句中使用表达式
-- selcet查询中可以使用表达式 SELECT @@auto_increment_increment; -- 查询自增步长 SELECT VERSION(); -- 查询版本号 SELECT 100*3-1 AS 计算结果; -- 表达式 -- 学员考试成绩集体提分一分查看 SELECT studentno,StudentResult+1 AS '提分后' FROM result; -
避免SQL返回结果中包含 ' . ' , ' * ' 和括号等干扰开发语言程序.
4.4、where条件语句
作用:用于检索数据表中符合条件的记录
搜索条件可由一个或多个逻辑表达式组成 , 结果一般为真或假.
逻辑操作符
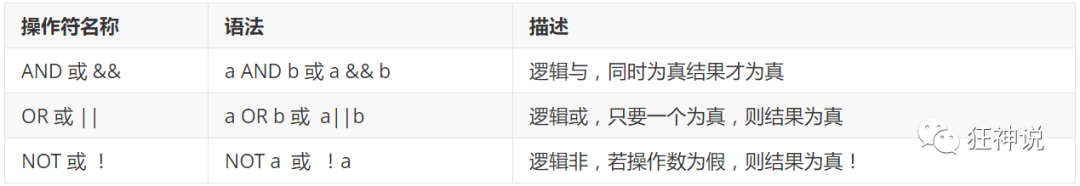
测试
-- 满足条件的查询(where)
SELECT Studentno,StudentResult FROM result;

-- 查询考试成绩在95-100之间的
SELECT Studentno,StudentResult
FROM result
WHERE StudentResult>=95 AND StudentResult<=100;

-- AND也可以写成 &&
SELECT Studentno,StudentResult
FROM result
WHERE StudentResult>=95 && StudentResult<=100;

-- 模糊查询(对应的词:精确查询)
SELECT Studentno,StudentResult
FROM result
WHERE StudentResult BETWEEN 95 AND 100;

-- 除了1000号同学,要其他同学的成绩
SELECT studentno,studentresult
FROM result
WHERE studentno!=1000;

-- 使用NOT
SELECT studentno,studentresult
FROM result
WHERE NOT studentno=1000;
模糊查询 :比较操作符
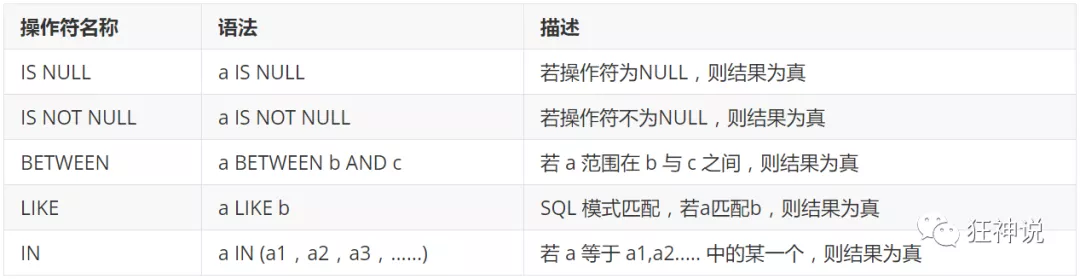
注意:
- 数值数据类型的记录之间才能进行算术运算 ;
- 相同数据类型的数据之间才能进行比较 ;
测试
-- 模糊查询 between and \ like \ in \ null

-- =============================================
-- LIKE
-- =============================================
-- 查询姓刘的同学的学号及姓名
-- like结合使用的通配符 : % (代表0到任意个字符) _ (一个字符)
SELECT studentno,studentname FROM student
WHERE studentname LIKE '刘%';

-- 查询姓刘的同学,后面只有一个字的
SELECT studentno,studentname FROM student
WHERE studentname LIKE '刘_';

-- 查询姓刘的同学,后面只有两个字的
SELECT studentno,studentname FROM student
WHERE studentname LIKE '刘__';

-- 查询姓名中含有 嘉 字的
SELECT studentno,studentname FROM student
WHERE studentname LIKE '%嘉%';

-- 查询姓名中含有特殊字符的需要使用转义符号 '\'
-- 自定义转义符关键字: ESCAPE ':'

-- =============================================
-- IN
-- =============================================
-- 查询学号为1000,1001,1002的学生姓名
SELECT studentno,studentname FROM student
WHERE studentno IN (1000,1001,1002);

-- 查询地址在北京,南京,河南洛阳的学生
SELECT studentno,studentname,address FROM student
WHERE address IN ('北京','南京','河南洛阳');

-- =============================================
-- NULL 空
-- =============================================
-- 查询出生日期没有填写的同学
-- 不能直接写=NULL , 这是代表错误的 , 用 is null
SELECT studentname FROM student
WHERE BornDate IS NULL;

-- 查询出生日期填写的同学
SELECT studentname FROM student
WHERE BornDate IS NOT NULL;

-- 查询没有写家庭住址的同学(空字符串不等于null)
SELECT studentname FROM student
WHERE Address='' OR Address IS NULL;
实战补充:LIKE 前缀模糊导致索引失效
LIKE '刘%'(后缀固定)可用到name列索引(范围扫描)。LIKE '%嘉%'、LIKE '%嘉'(前缀带%)无法用 B+Tree 索引的有序性,会全表扫描(或LIKE索引下推失效)。- 解决方案:需要"包含某词"检索且量大时,用 全文索引
MATCH ... AGAINST,或 ES 这类倒排索引引擎(见 12-ES 篇)。IN里常数多(成百上千)时,优化器可能改走index dive或直接 range;极端多值考虑JOIN临时表。
4.5、连接查询
我们已经学会了如何在一张表中读取数据,这是相对简单的,但是在真正的应用中经常需要从多个数据表中读取数据。
你可以在 SELECT, UPDATE 和 DELETE 语句中使用 Mysql 的 JOIN 来联合多表查询。
JOIN 按照功能大致分为如下三类:
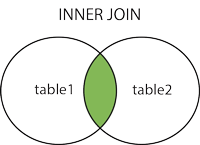
- INNER JOIN(内连接,或等值连接):获取两个表中字段匹配关系的记录。
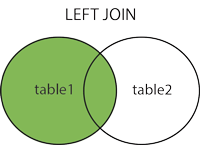
- LEFT JOIN(左连接):获取左表所有记录,即使右表没有对应匹配的记录。
- RIGHT JOIN(右连接): 与 LEFT JOIN 相反,用于获取右表所有记录,即使左表没有对应匹配的记录。
mysql> use RUNOOB;
Database changed
mysql> SELECT * FROM tcount_tbl;
+---------------+--------------+
| runoob_author | runoob_count |
+---------------+--------------+
| 菜鸟教程       | 10           |
| RUNOOB.COM    | 20           |
| Google        | 22           |
+---------------+--------------+
3 rows in set (0.01 sec)

mysql> SELECT * from runoob_tbl;
+-----------+---------------+---------------+-----------------+
| runoob_id | runoob_title  | runoob_author | submission_date |
+-----------+---------------+---------------+-----------------+
| 1         | 学习 PHP       | 菜鸟教程       | 2017-04-12      |
| 2         | 学习 MySQL     | 菜鸟教程       | 2017-04-12      |
| 3         | 学习 Java      | RUNOOB.COM    | 2015-05-01      |
| 4         | 学习 Python    | RUNOOB.COM    | 2016-03-06      |
| 5         | 学习 C         | FK            | 2017-04-05      |
+-----------+---------------+---------------+-----------------+
5 rows in set (0.01 sec)
接下来我们就使用MySQL的INNER JOIN(也可以省略 INNER 使用 JOIN,效果一样)来连接以上两张表来读取
runoob_tbl表中所有runoob_author字段在tcount_tbl表对应的runoob_count字段值:
4.5.1、INNER JOIN:
mysql> SELECT a.runoob_id,a.runoob_author, b.runoob_count
FROM runoob_tbl a INNER JOIN tcount_tbl b
ON a.runoob_author = b.runoob_author;

+-------------+-----------------+----------------+
| a.runoob_id | a.runoob_author | b.runoob_count |
+-------------+-----------------+----------------+
| 1           | 菜鸟教程         | 10             |
| 2           | 菜鸟教程         | 10             |
| 3           | RUNOOB.COM      | 20             |
| 4           | RUNOOB.COM      | 20             |
+-------------+-----------------+----------------+
4 rows in set (0.00 sec)
where
mysql> SELECT a.runoob_id, a.runoob_author, b.runoob_count
FROM runoob_tbl a, tcount_tbl b
WHERE a.runoob_author = b.runoob_author;
+-------------+-----------------+----------------+
| a.runoob_id | a.runoob_author | b.runoob_count |
+-------------+-----------------+----------------+
| 1           | 菜鸟教程         | 10             |
| 2           | 菜鸟教程         | 10             |
| 3           | RUNOOB.COM      | 20             |
| 4           | RUNOOB.COM      | 20             |
+-------------+-----------------+----------------+
4 rows in set (0.01 sec)
4.5.2、MySQL LEFT JOIN
MySQL left join 与 join 有所不同。 MySQL LEFT JOIN 会读取左边数据表的全部数据,即便右边表无对应数据。
尝试以下实例,以 runoob_tbl 为左表,tcount_tbl 为右表,理解 MySQL LEFT JOIN 的应用:
LEFT JOIN
mysql> SELECT a.runoob_id, a.runoob_author, b.runoob_count
FROM runoob_tbl a LEFT JOIN tcount_tbl b
ON a.runoob_author = b.runoob_author;
+-------------+-----------------+----------------+
| a.runoob_id | a.runoob_author | b.runoob_count |
+-------------+-----------------+----------------+
| 1           | 菜鸟教程         | 10             |
| 2           | 菜鸟教程         | 10             |
| 3           | RUNOOB.COM      | 20             |
| 4           | RUNOOB.COM      | 20             |
| 5           | FK              | NULL           |
+-------------+-----------------+----------------+
5 rows in set (0.01 sec)
以上实例中使用了 LEFT JOIN,该语句会读取左边的数据表 runoob_tbl 的所有选取的字段数据,即便在右侧表 tcount_tbl中 没有对应的 runoob_author 字段值。

实战补充:JOIN 的底层原理(这是面试与优化必考)
MySQL 执行 JOIN 只有两种基础算法,优化器按"谁小谁驱动"选择:
- Nested-Loop Join(NLJ,嵌套循环):选一张表作"驱动表"(外层),逐行取连接键,去"被驱动表"用索引查找。伪代码:
关键点:被驱动表的连接列必须有索引,否则变成"逐行全表扫",复杂度 O(N×M)。所以"小表驱动大表 + 大表连接列建索引"是 JOIN 性能铁律。for each row R in 驱动表: for each row S in 被驱动表 where S.key = R.key: -- 走被驱动表索引 输出 <R, S>- Block Nested-Loop Join(BNL,8.0 前大表无索引时的退化算法):把驱动表一批行放进
join buffer,一次性和被驱动表比对,减少被驱动表扫描次数。但仍是 O(N×M) 量级且占内存(join_buffer_size),有索引就不要让它走到 BNL。EXPLAIN里Extra出现Using join buffer (Block Nested Loop)即警告。- 8.0 引入 Hash Join:对大表无索引的等值 JOIN 用哈希表,比 BNL 高效很多(执行计划
Extra: Using join buffer (hash join))。驱动表怎么选?
INNER JOIN优化器会自动挑"估算行数小"的作驱动表;LEFT JOIN左表固定为驱动表(这也是为什么LEFT JOIN有时比INNER JOIN慢——左表若是大表就亏了)。需要强制驱动顺序可用STRAIGHT_JOIN。JOIN 实战踩坑
- 超过 3 张表的 JOIN 往往说明模型该冗余/宽表化;多表 JOIN 易触发临时表落盘(
Using temporary)。ON是连接条件(决定怎么匹配),WHERE是过滤条件(匹配后筛);LEFT JOIN把过滤条件放WHERE会悄悄把 NULL 行滤掉,变成"类 INNER JOIN",应放ON。
4.6、排序和分页
我们知道从 MySQL 表中使用 SQL SELECT 语句来读取数据。
如果我们需要对读取的数据进行排序,我们就可以使用 MySQL 的 ORDER BY 子句来设定你想按哪个字段哪种方式来进行排序,再返回搜索结果。
4.6.1、排序语法
以下是 SQL SELECT 语句使用 ORDER BY 子句将查询数据排序后再返回数据:
SELECT field1, field2,...fieldN FROM table_name1, table_name2...
ORDER BY field1 [ASC [DESC][默认 ASC]], [field2...] [ASC [DESC][默认 ASC]]
- 你可以使用任何字段来作为排序的条件,从而返回排序后的查询结果。
- 你可以设定多个字段来排序。
- 你可以使用 ASC 或 DESC 关键字来设置查询结果是按升序或降序排列。 默认情况下,它是按升序排列。
- 你可以添加 WHERE...LIKE 子句来设置条件。
以下将在 SQL SELECT 语句中使用 ORDER BY 子句来读取MySQL 数据表 runoob_tbl 中的数据:
尝试以下实例,结果将按升序及降序排列。
mysql> use RUNOOB;
Database changed
mysql> SELECT * from runoob_tbl ORDER BY submission_date ASC;
+-----------+---------------+---------------+-----------------+
| runoob_id | runoob_title  | runoob_author | submission_date |
+-----------+---------------+---------------+-----------------+
| 3         | 学习 Java   | RUNOOB.COM    | 2015-05-01      |
| 4         | 学习 Python | RUNOOB.COM    | 2016-03-06      |
| 1         | 学习 PHP    | 菜鸟教程  | 2017-04-12      |
| 2         | 学习 MySQL  | 菜鸟教程  | 2017-04-12      |
+-----------+---------------+---------------+-----------------+
4 rows in set (0.01 sec)

mysql> SELECT * from runoob_tbl ORDER BY submission_date DESC;
+-----------+---------------+---------------+-----------------+
| runoob_id | runoob_title  | runoob_author | submission_date |
+-----------+---------------+---------------+-----------------+
| 1         | 学习 PHP    | 菜鸟教程  | 2017-04-12      |
| 2         | 学习 MySQL  | 菜鸟教程  | 2017-04-12      |
| 4         | 学习 Python | RUNOOB.COM    | 2016-03-06      |
| 3         | 学习 Java   | RUNOOB.COM    | 2015-05-01      |
+-----------+---------------+---------------+-----------------+
4 rows in set (0.01 sec)
实战补充:ORDER BY 的索引利用与 filesort
ORDER BY的列顺序与方向(ASC/DESC)与索引一致时,可走索引避免排序(Using index)。- 否则触发 filesort:MySQL 在内存/磁盘对结果集排序。小结果集走内存
sort_buffer_size,大结果集落临时文件多路归并,极慢。- 优化方向:排序列建索引、
WHERE范围与ORDER BY服从"最左前缀"、避免SELECT *(回表成本高)、LIMIT下推减少排序量。
4.6.2、分页语法
-- 每页显示5条数据
SELECT s.studentno,studentname,subjectname,StudentResult
FROM student s
INNER JOIN result r
ON r.studentno = s.studentno
INNER JOIN `subject` sub
ON r.subjectno = sub.subjectno
WHERE subjectname='数据库结构-1'
ORDER BY StudentResult DESC , studentno
LIMIT 0,5

-- 查询 JAVA第一学年 课程成绩前10名并且分数大于80的学生信息(学号,姓名,课程名,分数)
SELECT s.studentno,studentname,subjectname,StudentResult
FROM student s
INNER JOIN result r
ON r.studentno = s.studentno
INNER JOIN `subject` sub
ON r.subjectno = sub.subjectno
WHERE subjectname='JAVA第一学年'
ORDER BY StudentResult DESC
LIMIT 0,10
实战补充:深度分页的" LIMIT 100000,20 " 灾难
LIMIT 100000, 20的含义是"先读 100020 行,丢掉前 100000,返回 20"。越往后越慢,因为要扫描并丢弃的越来越多。- 优化 1(游标/游标分页):用"上一页最大 id"替代 offset:
必须SELECT * FROM orders WHERE id > 上一页最大id ORDER BY id ASC LIMIT 20;ORDER BY同一有序键(通常主键),性能恒定 O(20)。- 优化 2(延迟关联):先通过索引取 id,再回表:
子查询只走索引拿主键,避免回表大字段,最后再 JOIN 取详情。SELECT * FROM orders a JOIN (SELECT id FROM orders WHERE ... ORDER BY create_time LIMIT 100000,20) b ON a.id = b.id;- 前端"无限滚动"天然适合游标分页;"跳到第 N 页"才需要 offset,且应加页数上限(如最多 100 页)。
4.7、分组
mysql> set names utf8;
mysql> SELECT * FROM employee_tbl;
+----+--------+---------------------+--------+
| id | name   | date                | singin |
+----+--------+---------------------+--------+
|  1 | 小明 | 2016-04-22 15:25:33 |      1 |
|  2 | 小王 | 2016-04-20 15:25:47 |      3 |
|  3 | 小丽 | 2016-04-19 15:26:02 |      2 |
|  4 | 小王 | 2016-04-07 15:26:14 |      4 |
|  5 | 小明 | 2016-04-11 15:26:40 |      4 |
|  6 | 小明 | 2016-04-04 15:26:54 |      2 |
+----+--------+---------------------+--------+
6 rows in set (0.00 sec)

#接下来我们使用 GROUP BY 语句 将数据表按名字进行分组,并统计每个人有多少条记录:
mysql> SELECT name, COUNT(*) FROM   employee_tbl GROUP BY name;
+--------+----------+
| name   | COUNT(*) |
+--------+----------+
| 小丽 |        1 |
| 小明 |        3 |
| 小王 |        2 |
+--------+----------+
3 rows in set (0.01 sec)
4.7.1、使用 WITH ROLLUP
WITH ROLLUP 可以实现在分组统计数据基础上再进行相同的统计(SUM,AVG,COUNT…)。
例如我们将以上的数据表按名字进行分组,再统计每个人登录的次数:
mysql> SELECT name, SUM(singin) as singin_count FROM  employee_tbl GROUP BY name WITH ROLLUP;
+--------+--------------+
| name   | singin_count |
+--------+--------------+
| 小丽 |            2 |
| 小明 |            7 |
| 小王 |            7 |
| NULL   |           16 |
+--------+--------------+
4 rows in set (0.00 sec)
4.7.2、coalesce
我们可以使用 coalesce 来设置一个可以取代 NUll 的名称,coalesce 语法:
select coalesce(a,b,c);
参数说明:如果a==null,则选择b;如果b==null,则选择c;如果a!=null,则选择a;如果a b c 都为null ,则返回为null(没意义)。
以下实例中如果名字为空我们使用总数代替:
mysql> SELECT coalesce(name, '总数'), SUM(singin) as singin_count FROM  employee_tbl GROUP BY name WITH ROLLUP;
+--------------------------+--------------+
| coalesce(name, '总数') | singin_count |
+--------------------------+--------------+
| 小丽                   |            2 |
| 小明                   |            7 |
| 小王                   |            7 |
| 总数                   |           16 |
+--------------------------+--------------+
4 rows in set (0.01 sec)
补充:ONLY_FULL_GROUP_BY 模式
5.7+ 默认开启ONLY_FULL_GROUP_BY:SELECT 里非聚合列必须出现在GROUP BY,否则报错。这能避免"查出来的非聚合列值随机"。老代码开着sql_mode=''能跑,但结果不可信,别为了兼容关掉它,而是改 SQL。
4.8、子查询
4.8.1、什么是子查询?
在查询语句中的WHERE条件子句中,又嵌套了另一个查询语句
嵌套查询可由多个子查询组成,求解的方式是由里及外;
子查询返回的结果一般都是集合,故而建议使用IN关键字;
-- 查询 数据库结构-1 的所有考试结果(学号,科目编号,成绩),并且成绩降序排列
-- 方法一:使用连接查询
SELECT studentno,r.subjectno,StudentResult
FROM result r
INNER JOIN `subject` sub
ON r.`SubjectNo`=sub.`SubjectNo`
WHERE subjectname = '数据库结构-1'
ORDER BY studentresult DESC;

-- 方法二:使用子查询(执行顺序:由里及外)
SELECT studentno,subjectno,StudentResult
FROM result
WHERE subjectno=(
   SELECT subjectno FROM `subject`
   WHERE subjectname = '数据库结构-1'
)
ORDER BY studentresult DESC;

-- 查询课程为 高等数学-2 且分数不小于80分的学生的学号和姓名
-- 方法一:使用连接查询
SELECT s.studentno,studentname
FROM student s
INNER JOIN result r
ON s.`StudentNo` = r.`StudentNo`
INNER JOIN `subject` sub
ON sub.`SubjectNo` = r.`SubjectNo`
WHERE subjectname = '高等数学-2' AND StudentResult>=80

-- 方法二:使用连接查询+子查询
-- 分数不小于80分的学生的学号和姓名
SELECT r.studentno,studentname FROM student s
INNER JOIN result r ON s.`StudentNo`=r.`StudentNo`
WHERE StudentResult>=80

-- 在上面SQL基础上,添加需求:课程为 高等数学-2
SELECT r.studentno,studentname FROM student s
INNER JOIN result r ON s.`StudentNo`=r.`StudentNo`
WHERE StudentResult>=80 AND subjectno=(
   SELECT subjectno FROM `subject`
   WHERE subjectname = '高等数学-2'
)

-- 方法三:使用子查询
-- 分步写简单sql语句,然后将其嵌套起来
SELECT studentno,studentname FROM student WHERE studentno IN(
   SELECT studentno FROM result WHERE StudentResult>=80 AND subjectno=(
       SELECT subjectno FROM `subject` WHERE subjectname = '高等数学-2'
  )
)
实战补充:子查询 vs JOIN 的性能
IN (子查询)在老版本会"逐行执行子查询"(DEPENDENT SUBQUERY),极慢;新优化器会改写成 semi-join / materialized(物化),性能接近 JOIN。- 经验法则:能用 JOIN 先考虑 JOIN,子查询可读性高但复杂嵌套易让优化器选错执行计划。排查时
EXPLAIN看select_type(SUBQUERY / DEPENDENT SUBQUERY / MATERIALIZED)。- 标量子查询(
SELECT (SELECT ...)作为列)每行都执行一次,量大必慢,改写为 JOIN。
4.9、unino查询
MySQL UNION 操作符用于连接两个以上的 SELECT 语句的结果组合到一个结果集合中。多个 SELECT 语句会删除重复的数据。
MySQL UNION 操作符语法格式:
SELECT expression1, expression2, ... expression_n
FROM tables
[WHERE conditions]
UNION [ALL | DISTINCT]
SELECT expression1, expression2, ... expression_n
FROM tables
[WHERE conditions];
- expression1, expression2, ... expression_n: 要检索的列。
- tables: 要检索的数据表。
- WHERE conditions: 可选, 检索条件。
- DISTINCT: 可选,删除结果集中重复的数据。默认情况下 UNION 操作符已经删除了重复数据,所以 DISTINCT 修饰符对结果没啥影响。
- ALL: 可选,返回所有结果集,包含重复数据。
mysql> SELECT * FROM Websites;
+----+--------------+---------------------------+-------+---------+
| id | name         | url                       | alexa | country |
+----+--------------+---------------------------+-------+---------+
| 1  | Google       | https://www.google.cm/    | 1     | USA     |
| 2  | 淘宝          | https://www.taobao.com/   | 13    | CN      |
| 3  | 菜鸟教程      | http://www.runoob.com/    | 4689  | CN      |
| 4  | 微博          | http://weibo.com/         | 20    | CN      |
| 5  | Facebook     | https://www.facebook.com/ | 3     | USA     |
| 7  | stackoverflow | http://stackoverflow.com/ |   0 | IND     |
+----+---------------+---------------------------+-------+---------+

mysql> SELECT * FROM apps;
+----+------------+-------------------------+---------+
| id | app_name   | url                     | country |
+----+------------+-------------------------+---------+
|  1 | QQ APP     | http://im.qq.com/       | CN      |
|  2 | 微博 APP | http://weibo.com/       | CN      |
|  3 | 淘宝 APP | https://www.taobao.com/ | CN      |
+----+------------+-------------------------+---------+
3 rows in set (0.00 sec)
4.9.1、实例
下面的 SQL 语句从 "Websites" 和 "apps" 表中选取所有不同的country(只有不同的值):
执行SQL 输出结果如下:
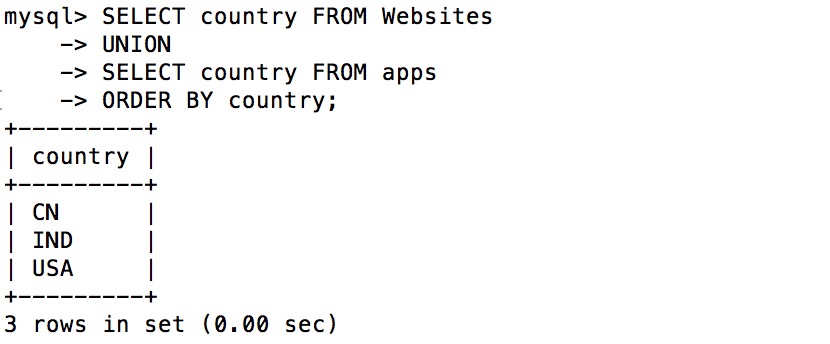
注释:UNION 不能用于列出两个表中所有的country。如果一些网站和APP来自同一个国家,每个国家只会列出一次。UNION 只会选取不同的
4.9.2、SQL UNION ALL 实例
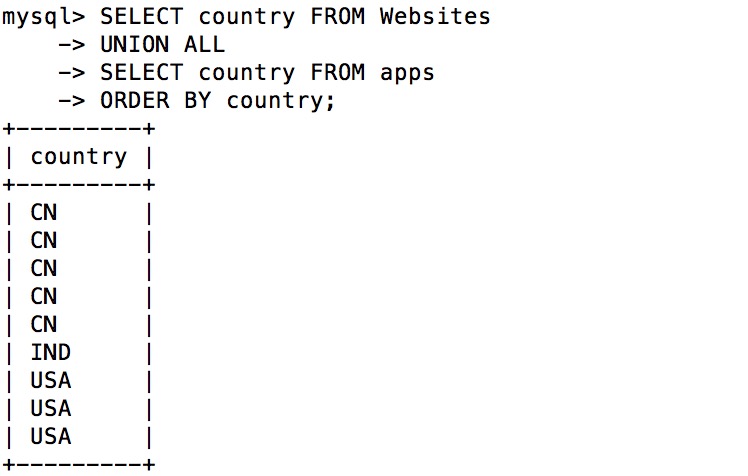
下面的 SQL 语句使用 UNION ALL 从 "Websites" 和 "apps" 表中选取所有的country值。请使用 UNION ALL 来选取重复的值!
4.9.3、带有 WHERE 的 SQL UNION ALL
下面的 SQL 语句使用 UNION ALL 从 "Websites" 和 "apps" 表中选取所有的中国(CN)的数据(也有重复的值):
执行SQL 输出结果如下:
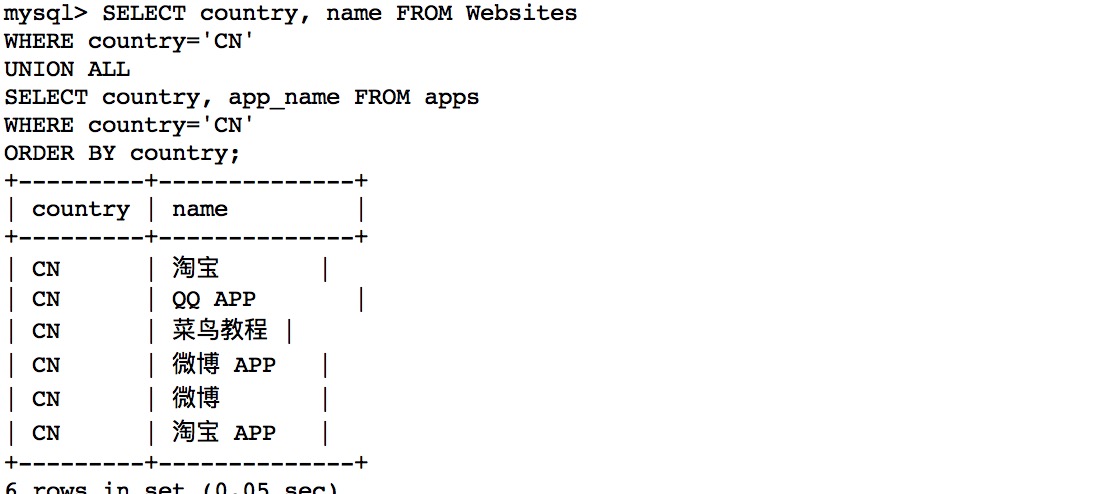
补充:
UNION去重有代价:UNION(默认 DISTINCT)会对合并结果排序去重,比UNION ALL多一次排序。确定无重复或不在乎重复时,一律用UNION ALL。UNION 要求各段列数、顺序一致,类型兼容;列名以第一段为准。
五、mysql函数
5.1、常用函数
数据函数
 SELECT ABS(-8);  /*绝对值*/
 SELECT CEILING(9.4); /*向上取整*/
 SELECT FLOOR(9.4);   /*向下取整*/
 SELECT RAND();  /*随机数,返回一个0-1之间的随机数*/
 SELECT SIGN(0); /*符号函数: 负数返回-1,正数返回1,0返回0*/
字符串函数
 SELECT CHAR_LENGTH('狂神说坚持就能成功'); /*返回字符串包含的字符数*/
 SELECT CONCAT('我','爱','程序');  /*合并字符串,参数可以有多个*/
 SELECT INSERT('我爱编程helloworld',1,2,'超级热爱');  /*替换字符串,从某个位置开始替换某个长度*/
 SELECT LOWER('KuangShen'); /*小写*/
 SELECT UPPER('KuangShen'); /*大写*/
 SELECT LEFT('hello,world',5);   /*从左边截取*/
 SELECT RIGHT('hello,world',5);  /*从右边截取*/
 SELECT REPLACE('狂神说坚持就能成功','坚持','努力');  /*替换字符串*/
 SELECT SUBSTR('狂神说坚持就能成功',4,6); /*截取字符串,开始和长度*/
 SELECT REVERSE('狂神说坚持就能成功'); /*反转

 -- 查询姓周的同学,改成邹
 SELECT REPLACE(studentname,'周','邹') AS 新名字
 FROM student WHERE studentname LIKE '周%';
日期和时间函数
 SELECT CURRENT_DATE();   /*获取当前日期*/
 SELECT CURDATE();   /*获取当前日期*/
 SELECT NOW();   /*获取当前日期和时间*/
 SELECT LOCALTIME();   /*获取当前日期和时间*/
 SELECT SYSDATE();   /*获取当前日期和时间*/

 -- 获取年月日,时分秒
 SELECT YEAR(NOW());
 SELECT MONTH(NOW());
 SELECT DAY(NOW());
 SELECT HOUR(NOW());
 SELECT MINUTE(NOW());
 SELECT SECOND(NOW());
系统信息函数
 SELECT VERSION();  /*版本*/
 SELECT USER();     /*用户*/
补充:窗口函数(8.0+,分组内排名神器)
8.0 引入ROW_NUMBER() / RANK() / DENSE_RANK() / SUM() OVER (PARTITION BY ... ORDER BY ...)等窗口函数,解决"每组取 Top N"以前要靠变量或子查询的痛点:-- 每个课程成绩排名 SELECT studentno, subjectno, StudentResult, RANK() OVER (PARTITION BY subjectno ORDER BY StudentResult DESC) AS rk FROM result; -- 取每科前3名 SELECT * FROM ( SELECT ..., ROW_NUMBER() OVER (PARTITION BY subjectno ORDER BY StudentResult DESC) AS rn FROM result ) t WHERE rn <= 3;
ROW_NUMBER不并列、RANK并列跳号、DENSE_RANK并列不跳号,按业务选。
5.2、聚合函数
| 函数名称 | 描述 |
|---|---|
| COUNT() | 返回满足Select条件的记录总和数,如 select count(*) 【不建议使用 *,效率低】 |
| SUM() | 返回数字字段或表达式列作统计,返回一列的总和。 |
| AVG() | 通常为数值字段或表达列作统计,返回一列的平均值 |
| MAX() | 可以为数值字段,字符字段或表达式列作统计,返回最大的值。 |
| MIN() | 可以为数值字段,字符字段或表达式列作统计,返回最小的值。 |
 -- 聚合函数
 /*COUNT:非空的*/
 SELECT COUNT(studentname) FROM student;
 SELECT COUNT(*) FROM student;
 SELECT COUNT(1) FROM student;  /*推荐*/

 -- 从含义上讲,count(1) 与 count(*) 都表示对全部数据行的查询。
 -- count(字段) 会统计该字段在表中出现的次数,忽略字段为null 的情况。即不统计字段为null 的记录。
 -- count(*) 包括了所有的列,相当于行数,在统计结果的时候,包含字段为null 的记录;
 -- count(1) 用1代表代码行,在统计结果的时候,包含字段为null 的记录 。
-- 查询不同课程的平均分,最高分,最低分
 -- 前提:根据不同的课程进行分组

 SELECT subjectname,AVG(studentresult) AS 平均分,MAX(StudentResult) AS 最高分,MIN(StudentResult) AS 最低分
 FROM result AS r
 INNER JOIN `subject` AS s
 ON r.subjectno = s.subjectno
 GROUP BY r.subjectno
 HAVING 平均分>80;

 /*
 where写在group by前面.
 要是放在分组后面的筛选
 要使用HAVING..
 因为having是从前面筛选的字段再筛选,而where是从数据表中的>字段直接进行的筛选的
 */
补充:COUNT 的引擎差异
- InnoDB 的
COUNT(*)没有缓存行数,要遍历(走最小二级索引)实时数;MyISAM 把总行数存在表里,COUNT(*)无 WHERE 时直接返回,极快。所以 InnoDB 大表SELECT COUNT(*) FROM t会很慢,要实时总数请用"计数表/Redis 维护"。COUNT(主键)会比COUNT(*)略慢(要走主键索引);COUNT(*)和COUNT(1)性能基本一致,优化器对COUNT(*)有专门优化,推荐写COUNT(*)。
六、事务和索引
6.1、事务
- 事务就是将一组SQL语句放在同一批次内去执行
- 如果一个SQL语句出错,则该批次内的所有SQL都将被取消执行
- MySQL事务处理只支持InnoDB和BDB数据表类型
6.2、事务的ACID原则
原子性(Atomic)
- 整个事务中的所有操作,要么全部完成,要么全部不完成,不可能停滞在中间某个环节。事务在执行过程中发生错误,会被回滚(ROLLBACK)到事务开始前的状态,就像这个事务从来没有执行过一样。
一致性(Consist)
- 一个事务可以封装状态改变(除非它是一个只读的)。事务必须始终保持系统处于一致的状态,不管在任何给定的时间并发事务有多少。也就是说:如果事务是并发多个,系统也必须如同串行事务一样操作。其主要特征是保护性和不变性(Preserving an Invariant),以转账案例为例,假设有五个账户,每个账户余额是100元,那么五个账户总额是500元,如果在这个5个账户之间同时发生多个转账,无论并发多少个,比如在A与B账户之间转账5元,在C与D账户之间转账10元,在B与E之间转账15元,五个账户总额也应该还是500元,这就是保护性和不变性。
隔离性(Isolated)
- 隔离状态执行事务,使它们好像是系统在给定时间内执行的唯一操作。如果有两个事务,运行在相同的时间内,执行相同的功能,事务的隔离性将确保每一事务在系统中认为只有该事务在使用系统。这种属性有时称为串行化,为了防止事务操作间的混淆,必须串行化或序列化请求,使得在同一时间仅有一个请求用于同一数据。
持久性(Durable)
- 在事务完成以后,该事务对数据库所作的更改便持久的保存在数据库之中,并不会被回滚。
-- 使用set语句来改变自动提交模式
SET autocommit = 0;   /*关闭*/
SET autocommit = 1;   /*开启*/

-- 注意:
--- 1.MySQL中默认是自动提交
--- 2.使用事务时应先关闭自动提交

-- 开始一个事务,标记事务的起始点
START TRANSACTION

-- 提交一个事务给数据库
COMMIT

-- 将事务回滚,数据回到本次事务的初始状态
ROLLBACK

-- 还原MySQL数据库的自动提交
SET autocommit =1;

-- 保存点
SAVEPOINT 保存点名称 -- 设置一个事务保存点
ROLLBACK TO SAVEPOINT 保存点名称 -- 回滚到保存点
RELEASE SAVEPOINT 保存点名称 -- 删除保存点
test
mysql> use RUNOOB;
Database changed
mysql> CREATE TABLE runoob_transaction_test( id int(5)) engine=innodb;  # 创建数据表
Query OK, 0 rows affected (0.04 sec)

mysql> select * from runoob_transaction_test;
Empty set (0.01 sec)

mysql> begin;  # 开始事务
Query OK, 0 rows affected (0.00 sec)

mysql> insert into runoob_transaction_test value(5);
Query OK, 1 rows affected (0.01 sec)

mysql> insert into runoob_transaction_test value(6);
Query OK, 1 rows affected (0.00 sec)

mysql> commit; # 提交事务
Query OK, 0 rows affected (0.01 sec)

mysql>  select * from runoob_transaction_test;
+------+
| id   |
+------+
| 5    |
| 6    |
+------+
2 rows in set (0.01 sec)

mysql> begin;    # 开始事务
Query OK, 0 rows affected (0.00 sec)

mysql>  insert into runoob_transaction_test values(7);
Query OK, 1 rows affected (0.00 sec)

mysql> rollback;   # 回滚
Query OK, 0 rows affected (0.00 sec)

mysql>   select * from runoob_transaction_test;   # 因为回滚所以数据没有插入
+------+
| id   |
+------+
| 5    |
| 6    |
+------+
2 rows in set (0.01 sec)

mysql>
实战补充:事务隔离级别与并发问题
隔离级别 脏读 不可重复读 幻读 说明 READ UNCOMMITTED 可能 可能 可能 读未提交,几乎不用 READ COMMITTED (RC) 否 可能 可能 多数互联网默认,解决脏读 REPEATABLE READ (RR) 否 否 否(快照+间隙锁) MySQL InnoDB 默认,靠 MVCC + 间隙锁解决幻读 SERIALIZABLE 否 否 否 串行化,性能差
- 查看/设置:
SELECT @@tx_isolation;(5.7)/SELECT @@transaction_isolation;(8.0);SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;- MVCC(多版本并发控制):每行隐藏
trx_id、roll_pointer,读操作走"快照读"(读已提交版本),写操作加行锁,读写互不阻塞。RR 下事务第一次读建立快照,之后都读同一快照 → 可重复读。- 长事务是毒药:占 undo log、锁资源不释放、主从延迟。监控
information_schema.innodb_trx找长事务。
6.3、索引
6.3.1、索引的作用
- 提高查询速度
- 确保数据的唯一性
- 可以加速表和表之间的连接 , 实现表与表之间的参照完整性
- 使用分组和排序子句进行数据检索时 , 可以显著减少分组和排序的时间
- 全文检索字段进行搜索优化.
6.3.2、普通索引
6.3.2.1、创建索引
这是最基本的索引,它没有任何限制。它有以下几种创建方式:
CREATE INDEX indexName ON table_name (column_name)
如果是CHAR,VARCHAR类型,length可以小于字段实际长度;如果是BLOB和TEXT类型,必须指定 length。
6.3.2.2、修改表结构(添加索引)
ALTER table tableName ADD INDEX indexName(columnName)
6.3.2.3、创建表的时候直接指定
CREATE TABLE mytable(

ID INT NOT NULL,

username VARCHAR(16) NOT NULL,

INDEX (username(length))

);
6.3.2.4、删除索引的语法
DROP INDEX [indexName] ON mytable;
6.3.3、唯一索引
它与前面的普通索引类似,不同的就是:索引列的值必须唯一,但允许有空值。如果是组合索引,则列值的组合必须唯一。它有以下几种创建方式:
6.3.3.1、创建索引
CREATE UNIQUE INDEX indexName ON mytable(username(length))
6.3.3.2、修改表结构
ALTER table mytable ADD UNIQUE [indexName] (username(length))
6.3.3.3、创建表的时候直接指定
CREATE TABLE mytable(

ID INT NOT NULL,

username VARCHAR(16) NOT NULL,

UNIQUE (username(length))

);
6.3.4、使用ALTER 命令添加和删除索引
有四种方式来添加数据表的索引:
-
ALTER TABLE tbl_name ADD PRIMARY KEY (column_list):
该语句添加一个主键,这意味着索引值必须是唯一的,且不能为NULL。
-
ALTER TABLE tbl_name ADD UNIQUE index_name (column_list): 这条语句创建索引的值必须是唯一的(除了NULL外,NULL可能会出现多次)。
-
ALTER TABLE tbl_name ADD INDEX index_name (column_list): 添加普通索引,索引值可出现多次。
-
ALTER TABLE tbl_name ADD FULLTEXT index_name (column_list):该语句指定了索引为 FULLTEXT ,用于全文索引。
以下实例为在表中添加索引。
mysql> ALTER TABLE testalter_tbl ADD INDEX (c);
你还可以在 ALTER 命令中使用 DROP 子句来删除索引。尝试以下实例删除索引:
mysql> ALTER TABLE testalter_tbl DROP INDEX c;
6.3.5、使用 ALTER 命令添加和删除主键
主键作用于列上(可以一个列或多个列联合主键),添加主键索引时,你需要确保该主键默认不为空(NOT NULL)。实例如下:
mysql> ALTER TABLE testalter_tbl MODIFY i INT NOT NULL;
mysql> ALTER TABLE testalert_tbl ADD PRIMARY KEY (i);
你也可以使用 ALTER 命令删除主键:
mysql> ALTER TABLE testalter_tbl DROP PRIMARY KEY;
删除主键时只需指定PRIMARY KEY,但在删除索引时,你必须知道索引名。
6.3.6、显示索引信息
你可以使用 SHOW INDEX 命令来列出表中的相关的索引信息。可以通过添加 \G 来格式化输出信息。
尝试以下实例:
mysql> SHOW INDEX FROM table_name;
补充:索引的底层——B+Tree(必须理解)
InnoDB 的索引是 B+Tree(多路平衡搜索树,非二叉树):
- 非叶子节点只存"键 + 指针",不存数据,所以一层能放更多键 → 树很矮(3 层即可存千万级数据),IO 次数少。
- 叶子节点用双向链表串起来,且存整行数据(聚簇索引)或主键(二级索引)。
- 范围查询
WHERE id BETWEEN 1 AND 100只需定位到第一个叶子再沿链表扫,非常快——这正是 B+Tree 优于 Hash 索引(只能等值)的地方。- 聚簇索引(主键):InnoDB 表数据即按主键 B+Tree 排列,叶子是完整行;所以"主键即数据"。二级索引叶子存的是主键值,回表时拿主键再去聚簇索引找整行(这就是"回表")。
- 覆盖索引:
SELECT的列恰好都在某个二级索引里,无需回表,EXPLAIN显示Using index,极快。尽量让查询走覆盖索引。
6.3.7、索引失效的常见场景(实战重点)
索引建了不生效,是最常踩的坑。以下场景会让优化器放弃走索引、退化全表扫描:
- 违反最左前缀:联合索引
(a,b,c),只查WHERE b=1或WHERE b=1 AND c=2用不到该索引(缺 a);WHERE a=1 AND c=2只用上 a 部分。 - 对索引列做函数/运算:
WHERE YEAR(create_time)=2026、WHERE amount*1.1 > 100会让索引失效。改为范围:WHERE create_time >= '2026-01-01' AND create_time < '2027-01-01'。 - 隐式类型转换:列是字符串
varchar,查询写WHERE phone = 13800138000(数字),MySQL 会把列转数字 → 索引失效。务必WHERE phone = '13800138000'。 - 隐式字符集/排序规则转换:两表 JOIN 字符集或 collation 不一致,会对列转换 → 索引失效,且
Using join buffer退化。建表统一utf8mb4 / utf8mb4_general_ci。 - 前导
%模糊:LIKE '%xx'、LIKE '%xx%'用不到 B+Tree 有序性。 - OR 连接非索引列:
WHERE a=1 OR b=1,若 b 无索引,整体退全表(可改UNION或给 b 建索引)。WHERE a=1 OR a=2这种同列没事。 - 负向查询:
!=、<>、NOT IN、NOT LIKE大多不走索引(优化器认为要扫大部分)。 - 索引列使用 IS NULL / IS NOT NULL:当 NULL 占比高时可能走,占比低时不走,看直方图/统计信息;不建议依赖。
- 优化器认为全表更快:查回表行数超过阈值(如 > 30% 数据),优化器会选全表而非索引(因为随机 IO 比顺序 IO 贵)。
- 排序/范围后的列失效:联合索引
(a,b,c),WHERE a=1 AND b>10 ORDER BY c—— b 用了范围,c 就不能走索引排序(只能 filesort)。
-- 用 EXPLAIN 验证是否走索引
EXPLAIN SELECT * FROM orders WHERE user_id = 100 AND status = 'PAID';
-- 关注输出:
-- type:    const > eq_ref > ref > range > index > ALL(ALL=全表,要警惕)
-- key:    实际使用的索引名(NULL=没用索引)
-- rows:   估算扫描行数(越小越好)
-- Extra:  Using index(覆盖) / Using where / Using filesort(排序没走索引) / Using temporary(用了临时表)
最左前缀实战口诀:"带头不能断、范围断了后、函数运算要避开"。建立联合索引时把等值条件列放前面、范围/排序列放后面。例如高频查询
WHERE a=? AND b=? ORDER BY c,建(a,b,c)。
6.4、执行计划 EXPLAIN 与慢查询
写 SQL 不
EXPLAIN,等于闭眼开车。生产调优第一件事就是看执行计划。
-- 基本用法:在 SELECT 前加 EXPLAIN
EXPLAIN SELECT * FROM orders WHERE user_id = 100;

-- 8.0 支持更直观的 FORMAT=JSON / TREE
EXPLAIN FORMAT=JSON SELECT * FROM orders o JOIN user u ON o.user_id=u.id;
EXPLAIN ANALYZE SELECT ...;   -- 真正执行并给出实际耗时与行数(8.0.18+)
关键字段解读:
id:查询序号,越大越先执行;相同 id 从上往下。select_type:SIMPLE / PRIMARY / SUBQUERY / DERIVED(派生表)/ MATERIALIZED。type(访问类型,性能从好到差):system > const > eq_ref > ref > ref_or_null > range > index > ALL。看到 ALL(全表扫描)和 index(全索引扫描)要警惕。possible_keys/key:可能用 / 实际用到的索引。key_len:用到索引的长度(字节),判断联合索引用到几列。ref:索引的匹配对象(const / 列 / func)。rows:估算扫描行数,重要优化指标。filtered:过滤后剩百分之多少(8.0)。Extra:见 6.3.7 末尾说明。
慢查询日志开启:
-- 开启慢查询日志,超过 1 秒记为慢 SQL
SET GLOBAL slow_query_log = 'ON';
SET GLOBAL long_query_time = 1;
-- 慢日志位置
SHOW VARIABLES LIKE 'slow_query_log_file';

-- 没走索引的 SQL 也记下来(排查利器)
SET GLOBAL log_queries_not_using_indexes = 'ON';
补充:
SHOW PROCESSLIST抓正在卡住的 SQL:SHOW FULL PROCESSLIST;看State(Sending data / Copying to tmp table / Locked)与Time,定位长事务/慢查询源头;配合kill <id>干掉阻塞会话。
6.5、索引设计实战原则
- 高频查询、高选择性列建索引:区分度
COUNT(DISTINCT col)/COUNT(*)越高越适合(身份证、手机号、user_id);性别/状态这种低区分度列单建索引几乎无效,应放进联合索引尾部或配合其他列。 - 避免过度索引:索引占空间、拖慢
INSERT/UPDATE/DELETE(每次写要维护所有索引)。写多读少表索引从简。 - 利用覆盖索引:
SELECT只取索引包含的列,避免回表。例如(user_id, status)上查SELECT status FROM orders WHERE user_id=?即覆盖。 - 前缀索引:长字符串(如 url、email)用
CREATE INDEX idx ON t(url(20)),取前 N 字符,省空间;用COUNT(DISTINCT LEFT(col,N))/COUNT(*)选合适 N 使区分度接近全列。 - 三星索引(理想目标):一星——WHERE 列进索引;二星——ORDER BY 列进索引避免排序;三星——SELECT 列进索引避免回表。实战尽量凑一两星即可。
- 冗余/重复索引清理:
(a,b)已有又建(a),后者冗余;PRIMARY KEY已是聚簇,再建唯一索引(id)冗余。用sys.schema_redundant_indexes查。
七、设计数据库
7.1、三大范式
7.1.1、第一范式 (1st NF)
第一范式的目标是确保每列的原子性,如果每列都是不可再分的最小数据单元,则满足第一范式
7.1.2、第二范式(2nd NF)
第二范式(2NF)是在第一范式(1NF)的基础上建立起来的,即满足第二范式(2NF)必须先满足第一范式(1NF)。
第二范式要求每个表只描述一件事情
7.1.3、第三范式(3rd NF)
如果一个关系满足第二范式,并且除了主键以外的其他列都不传递依赖于主键列,则满足第三范式.
第三范式需要确保数据表中的每一列数据都和主键直接相关,而不能间接相关。
7.1.4、规范化和性能的关系
为满足某种商业目标 , 数据库性能比规范化数据库更重要
在数据规范化的同时 , 要综合考虑数据库的性能
通过在给定的表中添加额外的字段,以大量减少需要从中搜索信息所需的时间
通过在给定的表中插入计算列,以方便查询
实战补充:反范式化(空间换时间)
- 严格 3NF 会导致大量 JOIN(如订单要 JOIN 用户、商品、店铺才能展示),高并发下 JOIN 昂贵。
- 常用手段:冗余字段(订单表里直接存
user_name、shop_name)、宽表(把关联结果预先打平一张大表,ES 里尤其常见)、汇总表(提前算好日活、销售额)。- 反范式代价是"更新要同步多处分",用触发器/定时任务/CDC 维护。范式与反范式是权衡,不是教条:写少读多、分析型场景大胆反范式;写多、强一致场景守住范式。
八、权限
用户信息表:mysql.user
1、刷新权限
FLUSH PRIVILEGES
2、用户
 CREATE USER kuangshen IDENTIFIED BY '123456'
CREATE USER 用户名 IDENTIFIED BY [PASSWORD] 密码(字符串)
 \- 必须拥有mysql数据库的全局CREATE USER权限,或拥有INSERT权限。
 \- 只能创建用户,不能赋予权限。
 \- 用户名,注意引号:如 'user_name'@'192.168.1.1'
 \- 密码也需引号,纯数字密码也要加引号
 \- 要在纯文本中指定密码,需忽略PASSWORD关键词。要把密码指定为由PASSWORD()函数返回的混编值,需包含关键字PASSWORD

-- 重命名用户 RENAME USER kuangshen TO kuangshen2
RENAME USER old_user TO new_user

-- 设置密码
SET PASSWORD = PASSWORD('密码')   -- 为当前用户设置密码
SET PASSWORD FOR 用户名 = PASSWORD('密码')   -- 为指定用户设置密码

-- 删除用户 DROP USER kuangshen2
DROP USER 用户名

-- 分配权限/添加用户
GRANT 权限列表 ON 表名 TO 用户名 [IDENTIFIED BY [PASSWORD] 'password']
 \- all privileges 表示所有权限
 \- *.* 表示所有库的所有表
 \- 库名.表名 表示某库下面的某表
3、查看权限
-- 查看权限  SHOW GRANTS FOR root@localhost;
SHOW GRANTS FOR 用户名
  -- 查看当前用户权限
 SHOW GRANTS; 或 SHOW GRANTS FOR CURRENT_USER; 或 SHOW GRANTS FOR CURRENT_USER();
4、撤消权限
REVOKE 权限列表 ON 表名 FROM 用户名
REVOKE ALL PRIVILEGES, GRANT OPTION FROM 用户名   -- 撤销所有权限
实战补充:最小权限原则与 % 主机风险
- 应用账号不要用
root,按库按表授权:GRANT SELECT,INSERT,UPDATE,DELETE ON app_db.* TO 'app'@'10.%';,禁止GRANT ALL。'user'@'%'允许任意主机连,公网 DB 极危险,应限定内网网段或具体 IP。- 8.0 角色(Role)管理:
CREATE ROLE、GRANT role TO user,便于批量授权。- 改完权限记得
FLUSH PRIVILEGES(直接改mysql系统表时需要;用GRANT/REVOKE命令一般自动生效)。
九、SQL 实战进阶(与 08 篇互补)
08 篇偏"装好、跑起来、基础运维",本篇补"线上最常用、也最容易出事"的四块:索引失效复盘、JOIN 原理落地、分区表、大表优化、备份恢复。下面都是可直接照做的实战。
9.1、慢 SQL 排查完整流程
- 开慢查询日志(
long_query_time=1)+log_queries_not_using_indexes; - 用
mysqldumpslow/pt-query-digest聚合出 Top 慢 SQL:# 按总耗时排序看前 10 条 mysqldumpslow -s t -t 10 /var/lib/mysql/slow.log # Percona 工具:按次数/耗时/锁分析,输出更直观 pt-query-digest /var/lib/mysql/slow.log - 对目标 SQL 跑
EXPLAIN(见 6.4),定位type=ALL、Using filesort、Using temporary、rows巨大; - 对症:建/调索引、改写 SQL、加 LIMIT、分批、冗余字段;
- 改完再
EXPLAIN+ 压测验证。
9.2、JOIN 实战与优化清单
- 永远给"被驱动表"的连接列建索引(见 4.5.2 原理)。
- 小表驱动大表:
INNER JOIN让优化器选;LEFT JOIN左表固定驱动,若左表是大表考虑改INNER JOIN或STRAIGHT_JOIN。 - 多表 JOIN(>3)警惕临时表落盘(
Using temporary、Using filesort)。 - 字段类型/字符集不一致必导致索引失效与 BNL,先统一再 JOIN。
- 验证:
EXPLAIN SELECT * FROM orders o
JOIN user u ON o.user_id = u.id      -- u.id 必须主键/唯一索引
WHERE o.status = 'PAID';
-- 期望:驱动表 orders 走 status 索引,被驱动表 user 走 PRIMARY (eq_ref)
9.3、分区表(Partitioning)
当单表数据上亿、按时间/地域查询为主,分区表能把"大表"在物理上切成多个分区,查询只扫相关分区(分区裁剪,partition pruning),管理(删旧数据
DROP PARTITION秒级)也更轻。
分区类型与场景:
| 分区类型 | 说明 | 典型场景 |
|---|---|---|
| RANGE | 按范围(如日期、金额区间) | 按时间归档日志、订单 |
| LIST | 按枚举值列表 | 按地区、按租户 |
| HASH | 按哈希分散 | 均匀打散、无明显范围 |
| KEY | 类似 HASH,用 MySQL 内部哈希 | 均匀打散 |
| RANGE COLUMNS | RANGE 增强,支持多列/非整数 | 按 DATE 列直接分区(最常用) |
-- 按时间 RANGE 分区(8.0 支持 RANGE COLUMNS 直接写 DATE)
CREATE TABLE orders (
  id BIGINT NOT NULL,
  user_id BIGINT,
  amount DECIMAL(10,2),
  created_at DATE,
  PRIMARY KEY (id, created_at)   -- 注意:分区键必须出现在所有唯一索引里
)
PARTITION BY RANGE COLUMNS (created_at) (
  PARTITION p202601 VALUES LESS THAN ('2026-02-01'),
  PARTITION p202602 VALUES LESS THAN ('2026-03-01'),
  PARTITION p202603 VALUES LESS THAN ('2026-04-01'),
  PARTITION pmax VALUES LESS THAN (MAXVALUE)   -- 兜底分区,防插入超范围报错
);

-- 查看分区裁剪是否生效
EXPLAIN PARTITIONS SELECT * FROM orders WHERE created_at >= '2026-02-01' AND created_at < '2026-03-01';
-- 期望 partitions 只命中 p202602,而非全部分区

-- 删除一个月数据:直接 DROP 分区,比 DELETE 快且无碎片
ALTER TABLE orders DROP PARTITION p202601;
分区表踩坑
- 分区键必须包含在每个唯一索引/主键中(MySQL 强制),否则建表报
A PRIMARY KEY must include all columns in the table's partitioning function。所以主键常设计成(id, 分区键)。- 分区表不能建外键;跨分区查询仍可能扫多分区。
- 分区数不宜过多(成百上千),否则元数据开销大、优化器选择变慢。
- 分区表不是"分库分表",仍在单实例,解决的是"单表过大、按维度裁剪 + 快速过期",不解决单机容量上限。
9.4、大表优化方案
当单表几千万到上亿、单机已吃力,按层级递进优化:
- 索引与 SQL 优化(9.1/9.2/6.3.7):零成本、见效快,先做。
- 分区表(9.3):单实例内按时间/地域切分,管理方便。
- 冷热分离:热数据(近 3 月、频繁访问)留主库高性能盘;冷数据(历史)归档到廉价存储/历史库,甚至
archive引擎或对象存储。 - 读写分离:主库写、多从库读,分摊读压力(依赖主从复制,见 11-Redis 篇不在此,MySQL 主从略)。读多写少场景立竿见影。
- 分库分表(Sharding):
- 垂直分库:按业务拆(用户库、订单库、商品库),解耦 + 分散连接。
- 垂直分表:大字段(text/blob)拆出去,主表瘦身,减少回表 IO。
- 水平分表:同一结构按分片键(如
user_id % 64、order_id哈希、按时间)拆成 N 张物理表。
-- 应用层按 user_id 取模路由到 64 张表之一 SET @tbl = CONCAT('orders_', user_id % 64); -- 实际由 ShardingSphere / MyCat 等中间件在 SQL 前改写- 分片键选择是核心:选高频等值查询列(如
user_id),避免跨分片查询/JOIN;跨分片聚合(COUNT/排序/分页)代价极高,需中间件兜底或异步汇总。 - 常用中间件:Apache ShardingSphere(JDBC / Proxy)、MyCat、Vitess(云原生)。
- 降级与限流:热点大查询加缓存(Redis,见 10/11 篇)、熔断、返回兜底,保护 DB。
分库分表决策口诀:"先索引、再分区、后冷热、不得已才分片"。分片带来分布式事务、跨片 JOIN、全局 ID、运维复杂度,能不分就不分。
9.5、备份与恢复(DBA 生存技能)
备份不是"有了就行",要能恢复、要演练。下面三种方式按"能容忍的数据丢失"与"恢复速度"选择。
9.5.1、逻辑备份 mysqldump
# 单库备份(含建表/插数语句)
mysqldump -uroot -p --single-transaction --routines --triggers --events \
  mydb > mydb_$(date +%F).sql

# 全库备份
mysqldump -uroot -p --single-transaction --all-databases > full_$(date +%F).sql

# 只导结构 / 只导数据
mysqldump -uroot -p mydb --no-data > schema.sql
mysqldump -uroot -p mydb --no-create-info > data.sql
--single-transaction:InnoDB 下靠 MVCC 拿到一致性快照,不锁表(5.7+/8.0 必备)。- 恢复:
mysql -uroot -p mydb < mydb_2026-09-19.sql。 - 优点:可读、可跨版本/跨引擎迁移;缺点:大库慢、恢复慢(逐条 INSERT)、锁不住元数据时有不一致风险。单库 < 几十 G 够用。
9.5.2、物理热备 xtrabackup(Percona XtraBackup)
# 全量备份到 /backup 目录
xtrabackup --backup --target-dir=/backup/full_20260919 --user=root --password=xxx

# 准备(apply redo log,使备份一致)
xtrabackup --prepare --target-dir=/backup/full_20260919

# 恢复到数据目录(需停库并清空原 data)
xtrabackup --copy-back --target-dir=/backup/full_20260919
chown -R mysql:mysql /var/lib/mysql
- 优势:物理拷贝、速度快、几乎不阻塞线上(热备),适合百 G~T 级大库。
- 支持增量备份(
--incremental)、压缩、流式加密。 - 恢复比 mysqldump 快一个量级(直接拷文件而非重放 SQL)。
9.5.3、binlog 增量备份与点恢复(PITR)
binlog 记录所有改动数据的事件,是实现"秒级恢复"的关键。必须
log_bin=ON、binlog_format=ROW(ROW 最安全、能精确恢复,但量大)。
# 查看 binlog 状态
SHOW VARIABLES LIKE 'log_bin';
SHOW BINARY LOGS;
SHOW MASTER STATUS;

# 基于位置的精确恢复:先全量恢复,再重放 binlog 到指定位置/时间
mysqlbinlog --start-position=154 --stop-position=938 \
  /var/lib/mysql/binlog.000012 | mysql -uroot -p mydb

# 按时间点恢复(误删库后用:恢复到删库前的那一刻)
mysqlbinlog --start-datetime="2026-09-19 02:00:00" \
            --stop-datetime="2026-09-19 03:00:00" \
  binlog.000012 | mysql -uroot -p mydb
完整备份策略(生产推荐)
- 每日全量(xtrabackup 或 mysqldump)+ 持续 binlog 归档;保留 N 天。
- 演练恢复:定期把备份恢复到备机,验证可用(很多人"备份成功、恢复失败")。
- 误删数据别慌:先
FLUSH TABLES WITH READ LOCK或停应用,立刻备份当前 binlog,再按 9.5.3 重放恢复到误删前位置。
9.6、本章小结
- 慢 SQL 排查 = 慢日志 +
EXPLAIN+ 改索引/改写,形成闭环。 - JOIN 铁律:小表驱动、被驱动表连接列有索引、字段类型字符集一致。
- 单表过大优先分区表(按时间裁剪 + 秒级过期),但不解决单机容量。
- 真到容量瓶颈再分库分表,分片键是命门。
- 备份三件套:mysqldump(小库)、xtrabackup(大库热备)、binlog(增量/PITR);备份要演练能恢复。
十、小结:MySQL 实战要点速查
| 主题 | 口诀 / 要点 |
|---|---|
| 索引 | 建对列、走最左、避函数、用覆盖、别过度 |
| 失效 | 一列运算、类型转换、前导%、OR 杂列、范围断序 |
| JOIN | 小驱大、被驱有索引、字符集一致、LEFT 别误 WHERE 过滤 |
| 分页 | 深翻用游标 id、或延迟关联,别 LIMIT 大 offset |
| 事务 | 短事务、选隔离、看长事务 innodb_trx |
| 大表 | 先索引→分区→冷热→分片,能不分就不分 |
| 备份 | dump 小库、xtra 大库、binlog 增量,演练恢复 |
本篇与 08 篇(安装/配置/基础运维)、10/11 篇(Redis 缓存)、12 篇(ES 搜索)配合使用,构成"关系型 + 缓存 + 搜索"的存储全景。

 浙公网安备 33010602011771号