
【WebWiki】13 · ElasticSearch 入门(实操)
1. ElasticSearch概述
ElasticSearch简称es,是一个开源的高扩展的分布式全文检索引擎。它基于 Apache Lucene 构建,对外提供 RESTful API,能够在近乎实时(near real-time,通常 1 秒左右延迟)内完成海量数据的存储、搜索与分析。
一句话理解:Lucene 是一个高性能的全文检索底层库,但它只是库;Elasticsearch 把 Lucene 包装成了一个分布式的、可水平扩展的、带 REST 接口的搜索引擎服务。
为什么需要 ES,而不是用数据库的 LIKE?
- 当数据量达到千万、上亿级别时,
LIKE '%关键词%'无法走索引,只能全表扫描,性能急剧下降; - 关系型数据库对中文分词、相关度打分、高亮、聚合统计(如分类统计、平均值、直方图)支持很弱;
- ES 基于倒排索引,查询复杂度与命中文档数相关,而非与总数据量相关,因此大数据量下依然很快;
- ES 天生的分布式能力:一份数据可以拆成多个分片(shard),分散在多台机器上,既能扩容也能容错。
典型使用场景
- 站内搜索(电商商品、博客文章、文档检索);
- 日志检索与分析(ELK 中的 E 就是 Elasticsearch,配合 Logstash、Kibana);
- 应用性能监控(APM)、安全分析(SIEM);
- 海量数据的聚合统计、大屏可视化。
版本说明(踩坑点)
- 7.x 之后,一个索引只允许一个类型(固定为
_doc),types(如user、order)的概念被废弃,8.x 彻底移除类型; - 7.x 默认不需要在 URL 里写类型,推荐统一用
/索引名/_doc/文档id; - 8.x 默认开启安全认证(用户名/密码 + TLS),而 7.x 默认关闭。新手本地练习若用 8.x,记得在
elasticsearch.yml里把xpack.security.enabled: false关掉,否则连curl都会被拦; - 客户端版本尽量与服务器大版本保持一致(如服务端 7.6,Java 客户端也用 7.x),跨大版本可能不兼容。
2. ELK安装
很简单,指的就是 Elastic Stack。
“ELK”是三个开源项目的首字母缩写,这三个项目分别是:Elasticsearch、Logstash 和 Kibana。
-
Elasticsearch 是一个搜索和分析引擎。
-
Logstash 是服务器端数据处理管道,能够同时从多个来源采集数据,转换数据,然后将数据发送到诸如 Elasticsearch 等“存储库”中。
-
Kibana 则可以让用户在 Elasticsearch 中使用图形和图表对数据进行可视化。
ElasticSearch :https://mirrors.huaweicloud.com/elasticsearch/?C=N&O=D
logstash :https://www.elastic.co/cn/downloads/logstash
kibana : https://mirrors.huaweicloud.com/kibana/?C=N&O=D
版本匹配原则:Elasticsearch、Logstash、Kibana 三者的大版本号必须一致(例如都是 7.6.2),否则 Kibana 启动后连不上 ES,报版本不兼容错误。
2.1、ElasticSearch运行
1、解压Es之后,进入bin目录
可以双击运行软件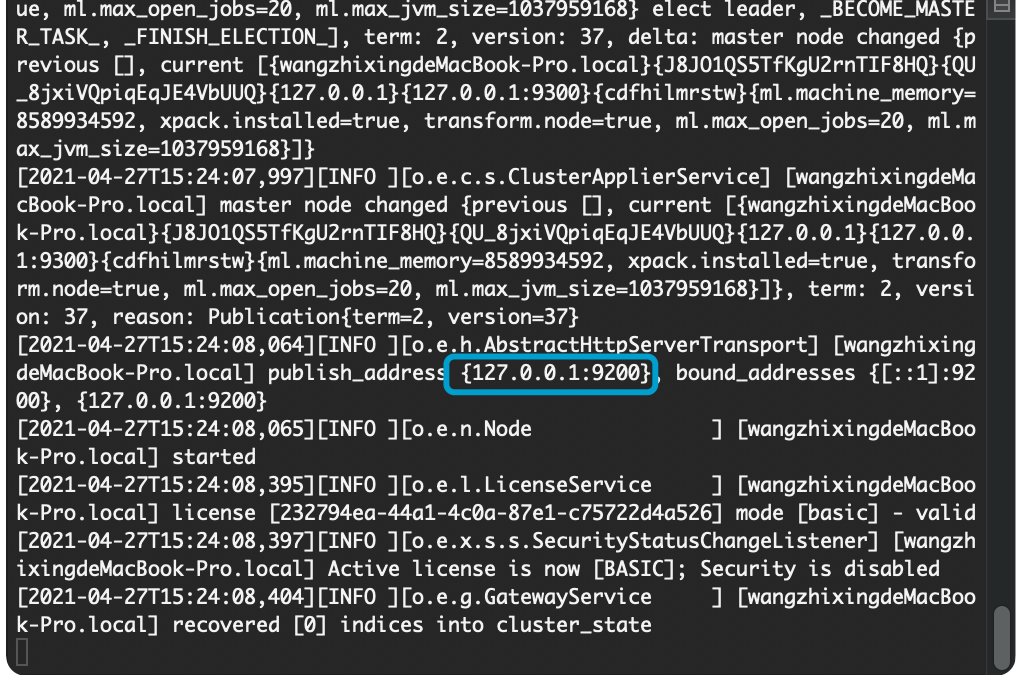
访问127.0.0.1:9200可以看到:
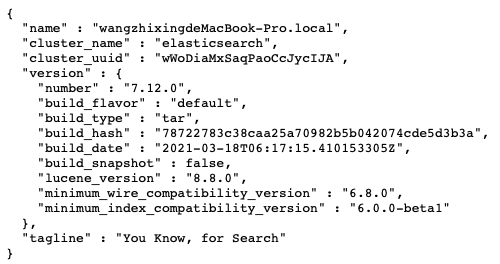
看到返回的 JSON(包含 cluster_name、cluster_uuid、version 等字段),说明 ES 启动成功。如果页面打不开,先排查:
- 是否以 非 root 用户 启动(ES 出于安全考虑禁止 root 直接运行,否则报
can not run elasticsearch as root); - 服务器内存是否足够(默认 JVM 堆 1G,机器内存小于 2G 会启动失败);
elasticsearch.yml里是否绑定了正确 IP(network.host: 0.0.0.0才能外网访问,但生产环境需配合安全配置);- 单台机器上
vm.max_map_count是否足够(Linux 上常报max virtual memory areas vm.max_map_count [65530] is too low,需执行sysctl -w vm.max_map_count=262144)。
2.2.、kibana运行
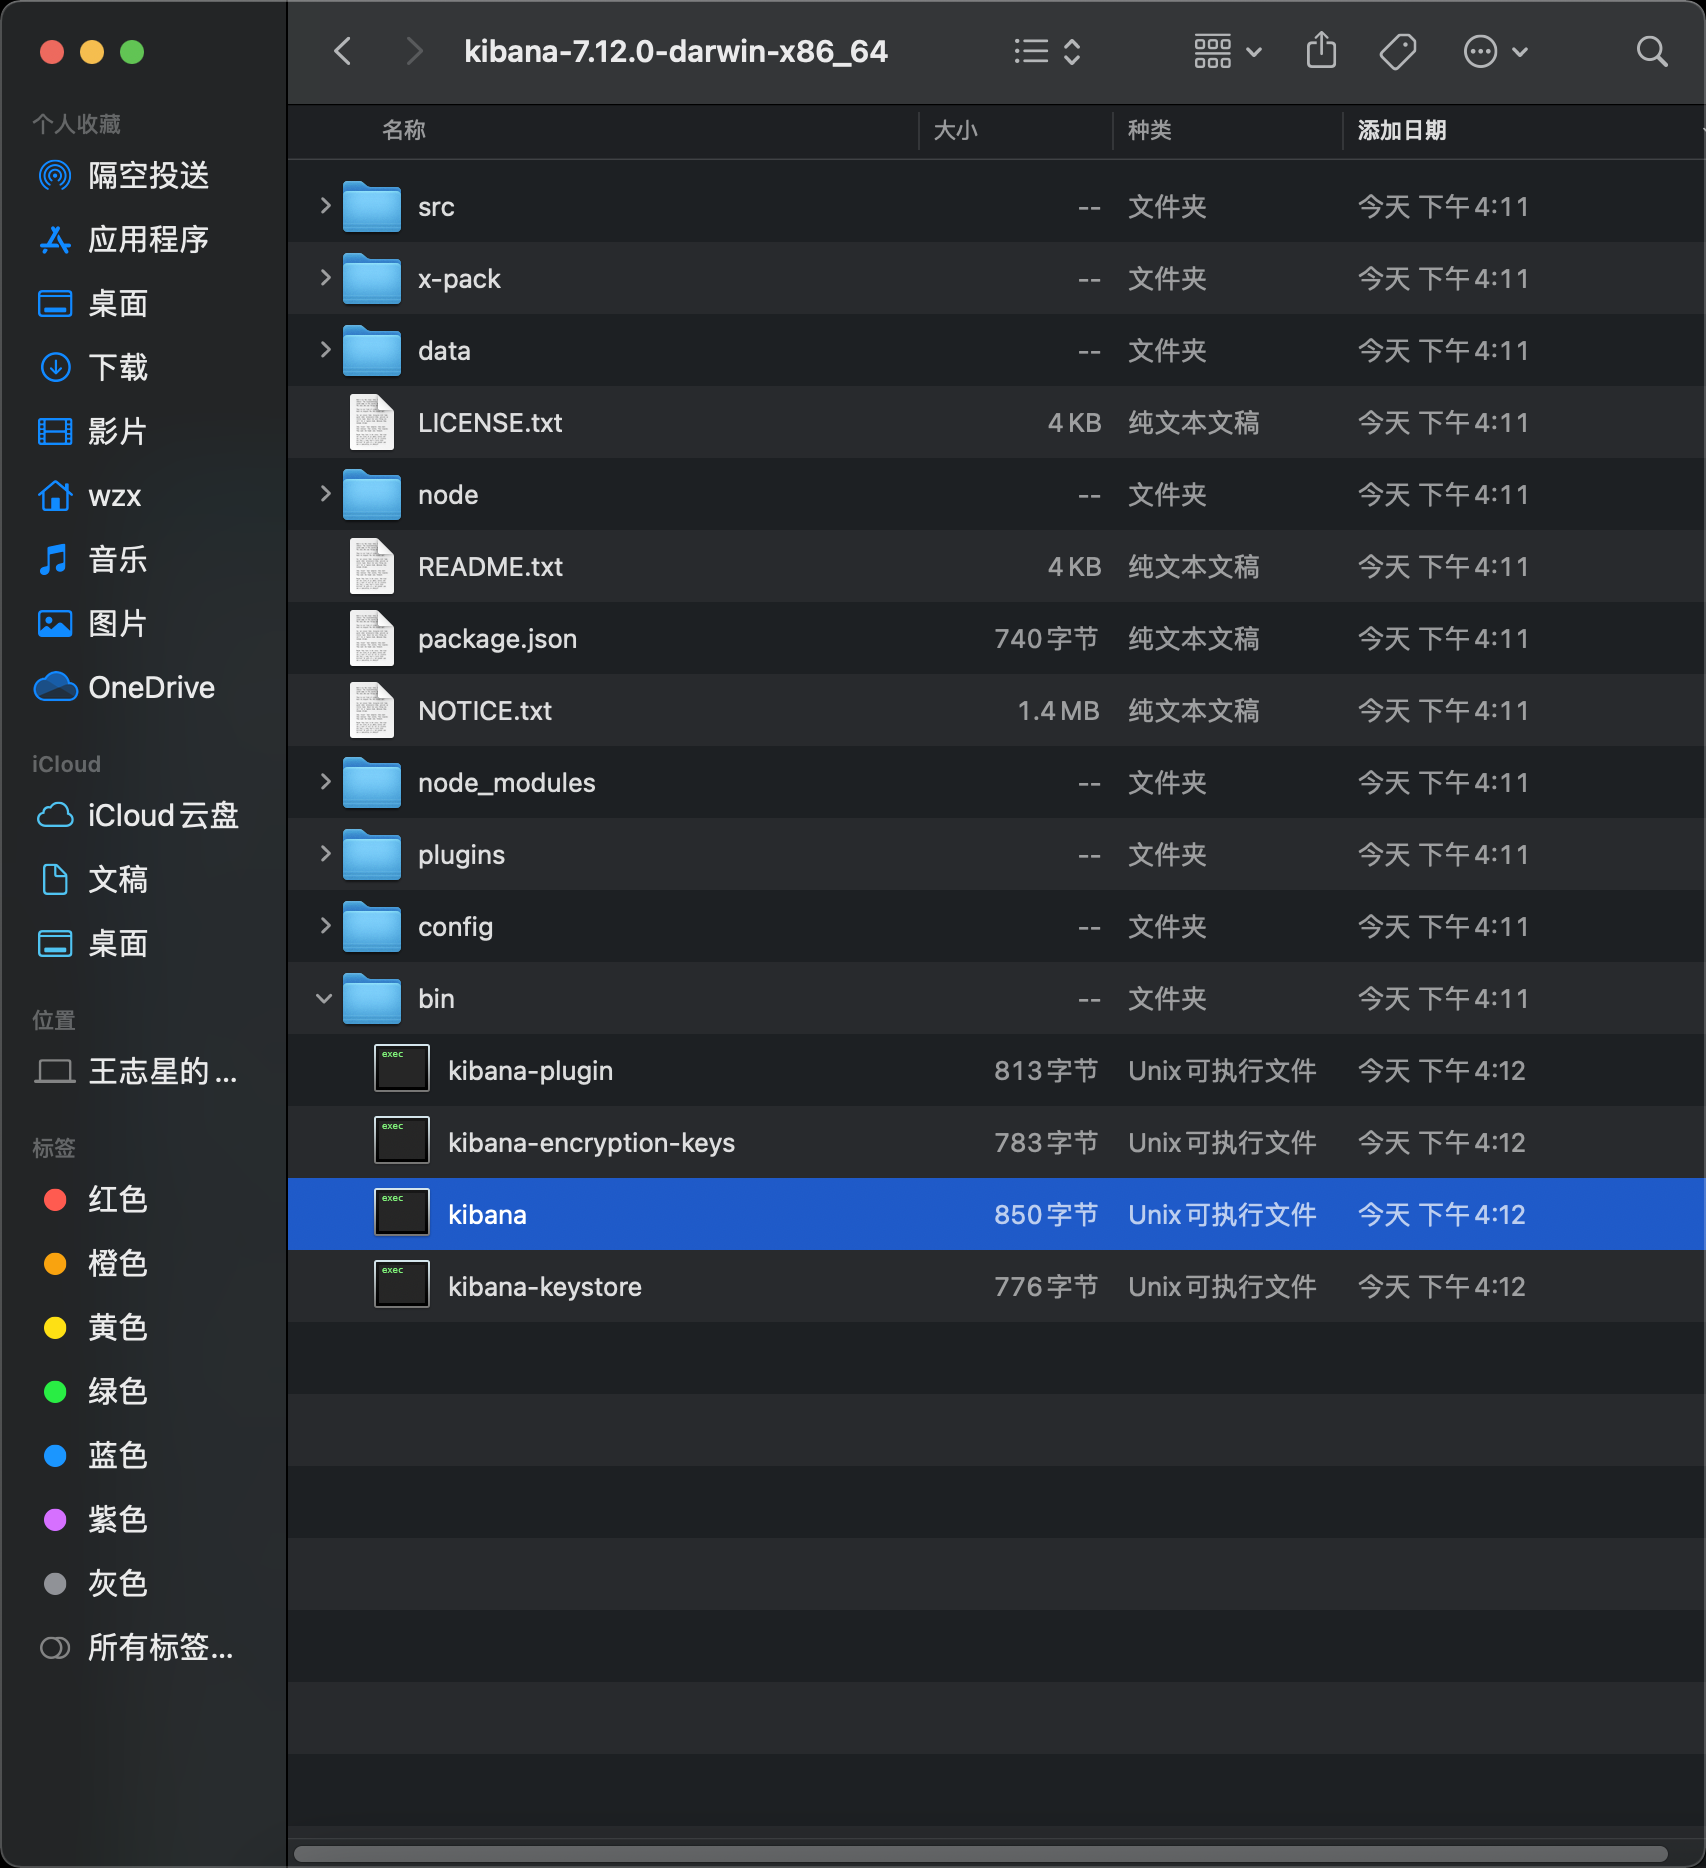
像之前es的一样直接双击kibana即可
访问127.0.0.1:5601
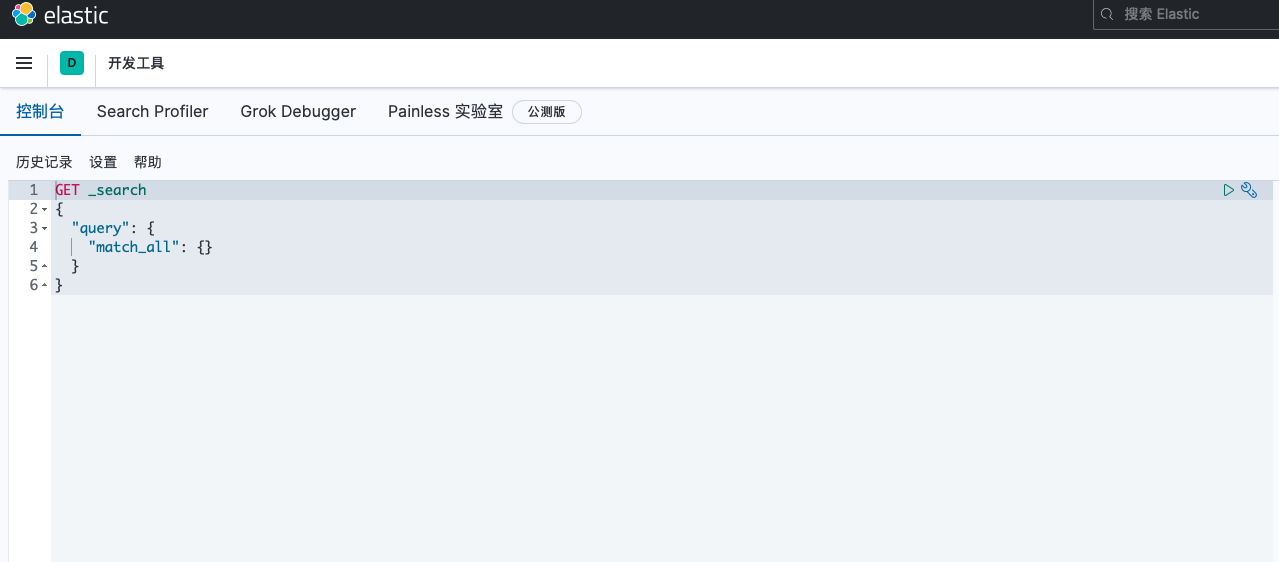
Kibana 启动后,我们后面所有的 DSL 查询都推荐在 Kibana 的 Dev Tools(开发工具) 里执行,地址是 http://127.0.0.1:5601/app/dev_tools。它的 Console 提供自动补全和格式化,比在命令行敲 curl 方便得多。
2.3、Logstash 安装
要测试 Logstash 安装,请运行最基本的 Logstash 管道。 例如:
cd logstash-7.6.2
bin/logstash -e 'input { stdin { } } output { stdout {} }'
等 Logstash 完成启动后,我们在 stdin 里输入一下文字,我们可以看到如下的输出:
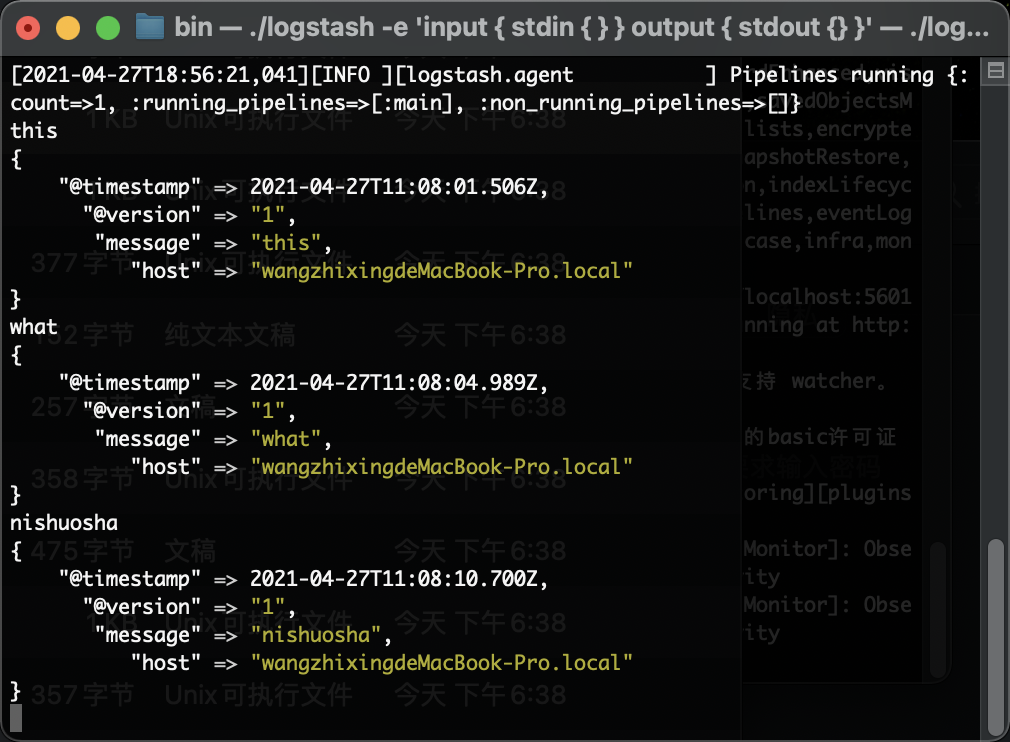
当我们打入一行字符然后回车,那么我们马上可以在 stdout 上看到输出的信息。
如果我们能看到这个输出,说明我们的 Logstash 的安装是成功的。
另外一种运行 Logstash 的方式,也是一种最为常见的运行方式。我们首先需要创建一个配置文件,比如:heartbeat.conf
input {
  heartbeat {
    interval => 10
    type => "heartbeat"
  }
}

output {
  stdout {
    codec => rubydebug
  }
}
使用如下命令执行,发现每隔10s进行一次output
bin/logstash -f heartbeat.conf
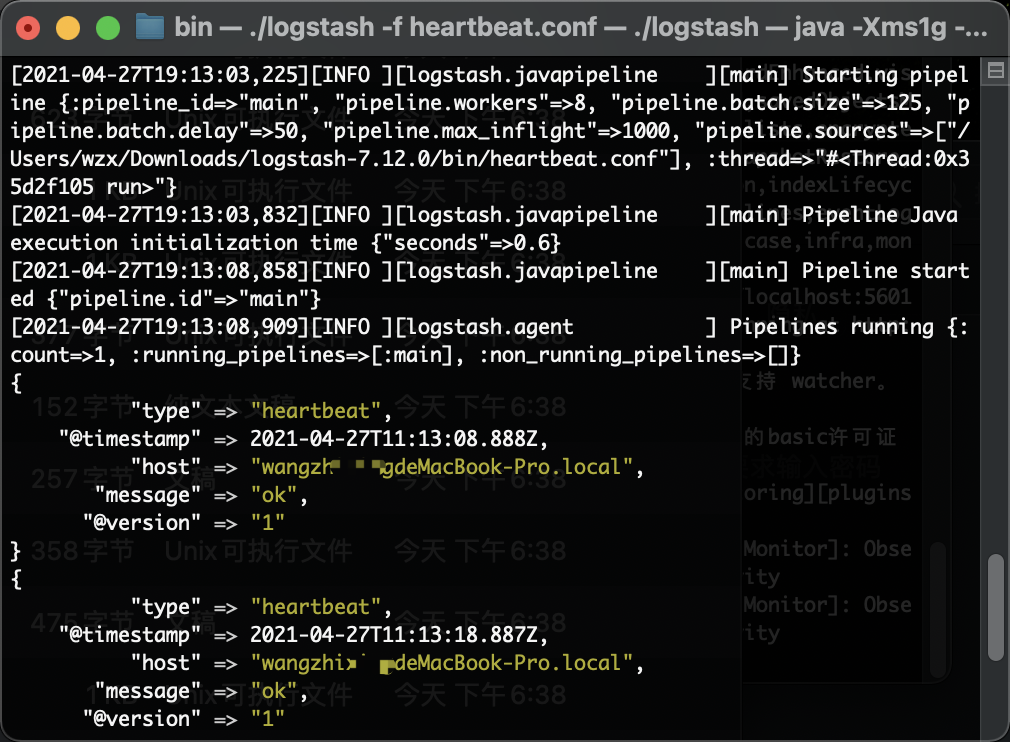
详细的请看:https://elasticstack.blog.csdn.net/article/details/105979677
实际生产中,Logstash 常用来从 MySQL、Kafka、文件(beats)采集数据并写入 ES。它的三段式结构
input { } filter { } output { }是核心心智模型:filter里可以做 grok 解析、字段转换、删除等多步加工。
3、可视化界面elasticsearch-head
下载:https://github.com/mobz/elasticsearch-head
3.1、安装依赖
cnpm install
3.2、启动
npm run start
3.3、访问127.0.0.1:9100
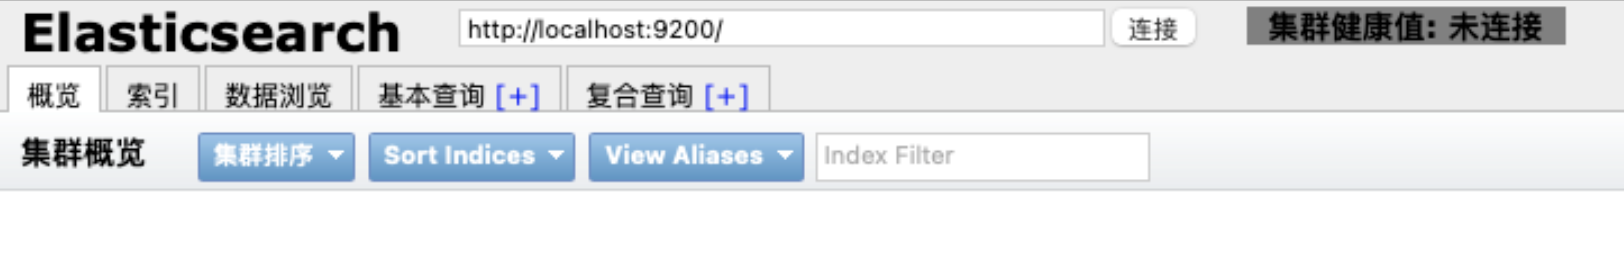
发现连接不上,跨域问题(跨端口,跨网站等)
3.4、修改配置,设置跨域
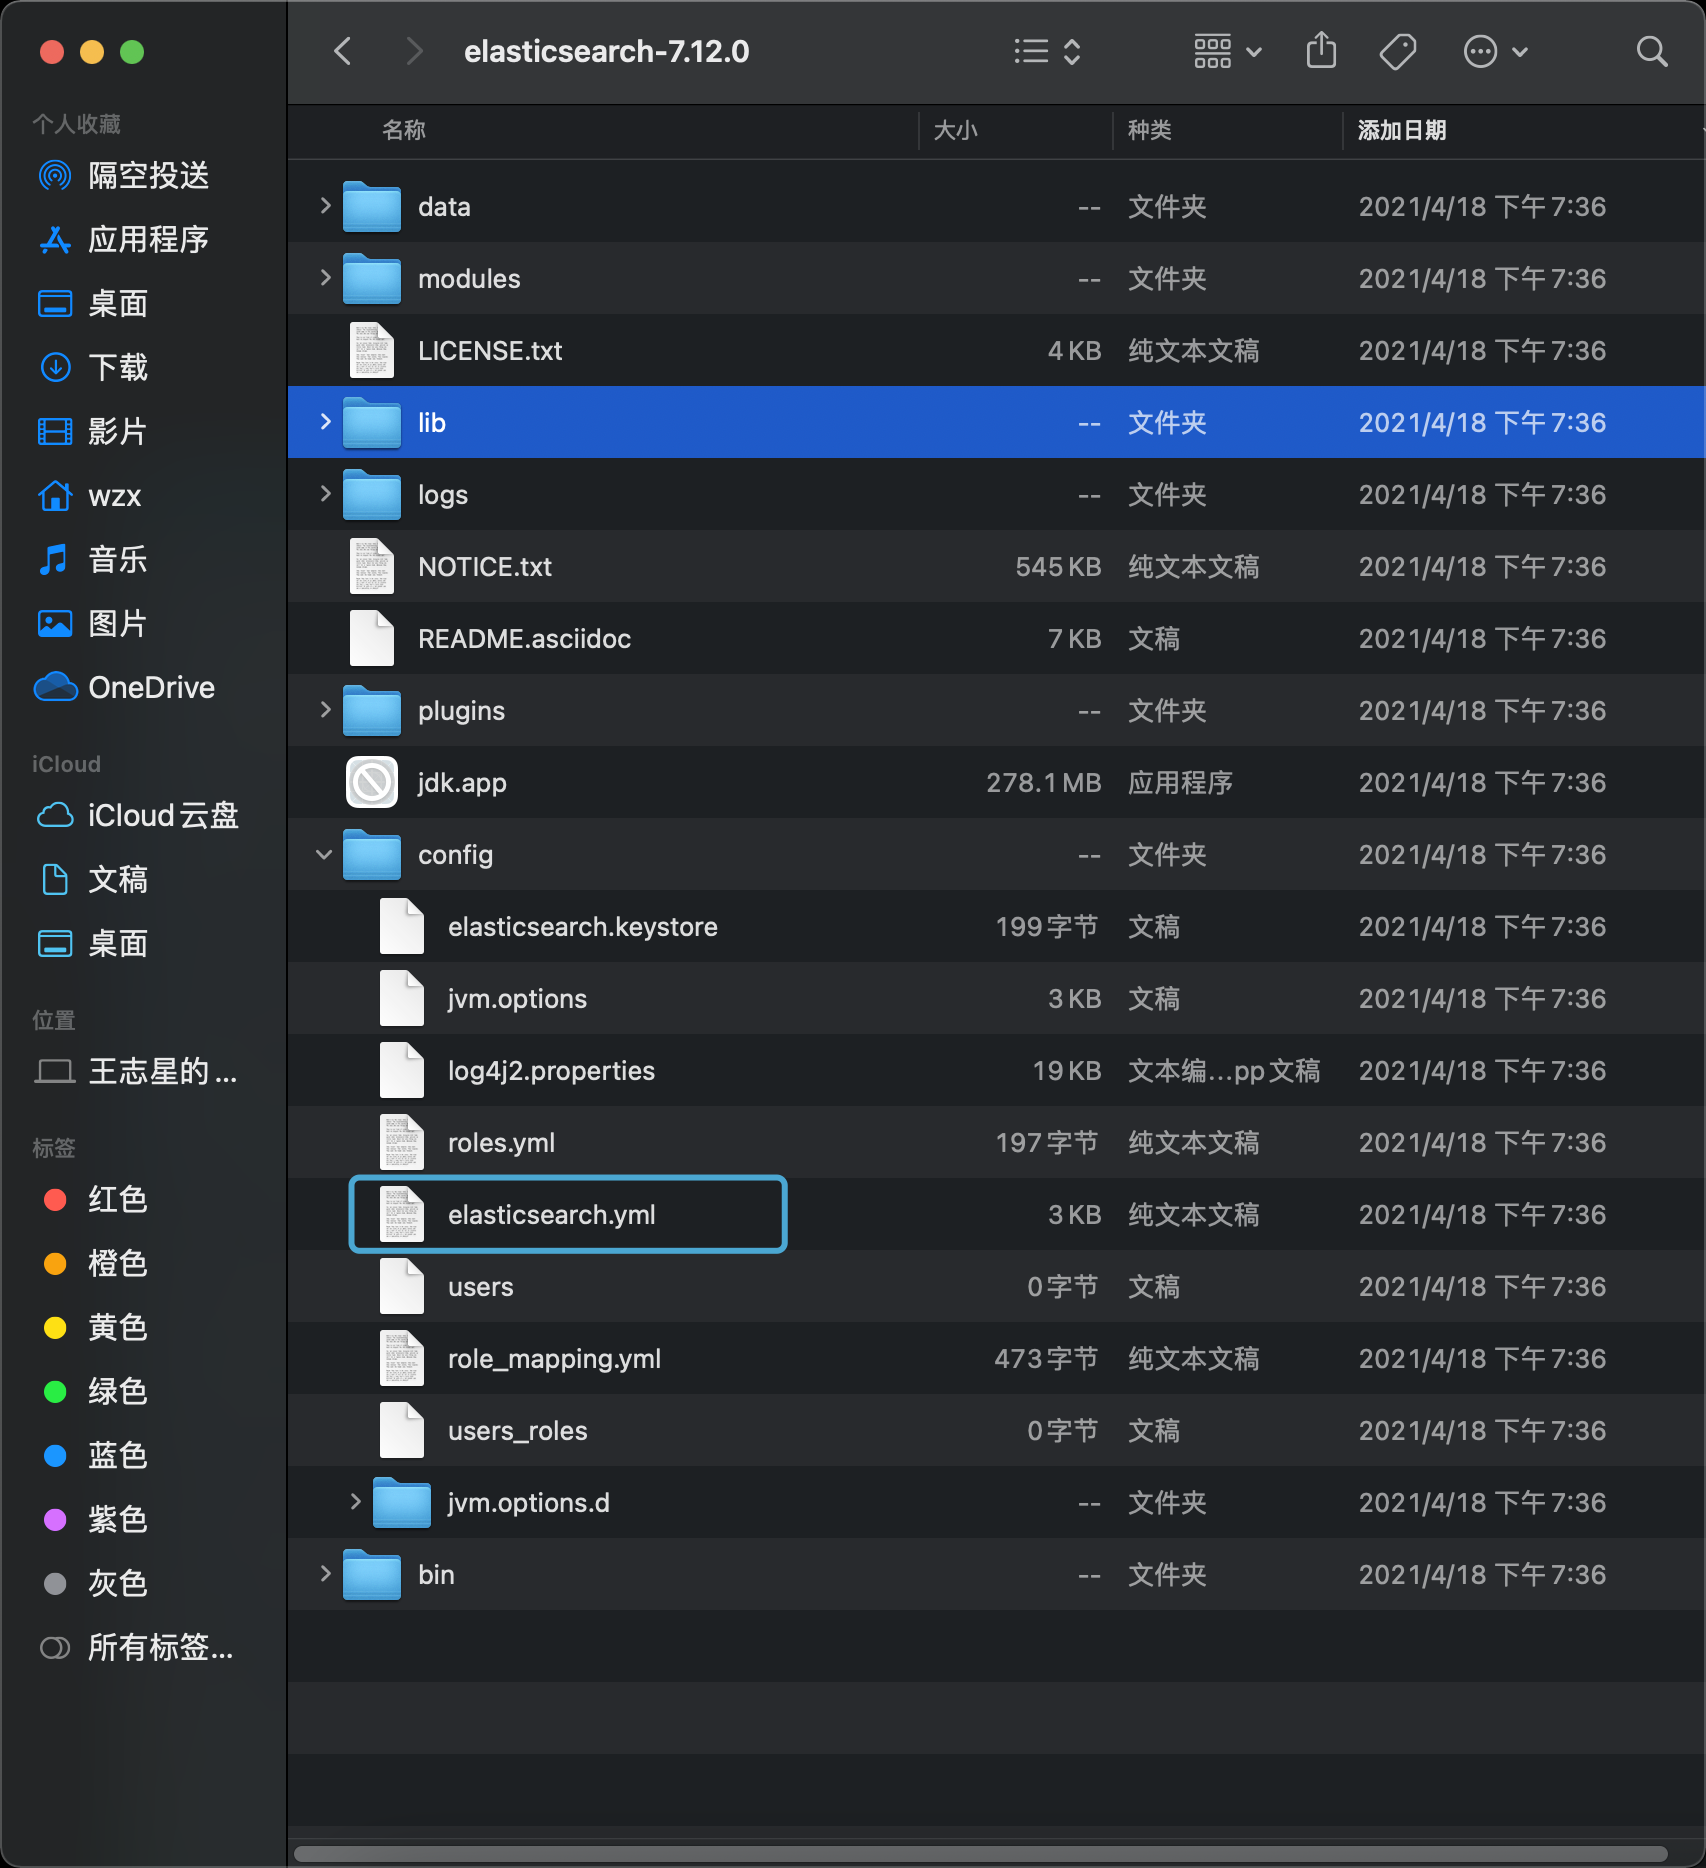
添加两行:
http.cors.enabled: true
http.cors.allow-origin: "*"
注意:
http.cors.allow-origin: "*"仅适合本地练习。生产环境请写成具体的前端域名,否则存在跨站风险。
3.5、重新启动es
再次访问127.0.0.1:9100
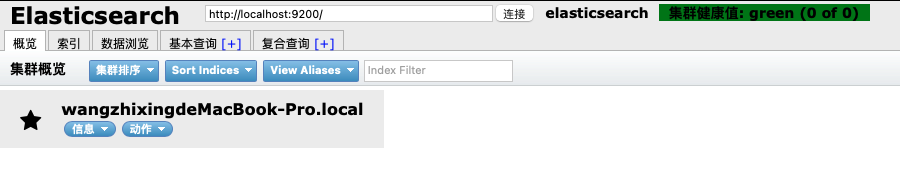
可以发现可以访问了
除了 head,官方更推荐用 Kibana 的 Stack Management / Dev Tools 来管理索引,head 更适合直观看分片分布与健康状态。
4. ES核心概念
集群,节点,索引,类型,文档,分片,映射是什么?
elasticsearch是面向文档,关系型数据库和elasticsearch客观的对比!一切都是json
| Relational DB | Elasticsearch |
|---|---|
| 数据库(database) | 索引(indices) |
| 表(tables) | 类型(types,7.x 后固定为 _doc) |
| 行(rows) | documents |
| 字段(columns) | fields |
物理设计:
- elasticsearch在后台把每个索引划分成多个分片。每个分片可以在集群中的不同服务器间迁移
逻辑设计:
- 一个索引类型中,包含多个文档,当我们索引一篇文档时,可以通过这样的一个顺序找到它:
索引->类型->文档id,通过这个组合我们就能索引到某个具体的文档。注意:ID不必是整数,实际上它是一个字符串。
关于“类型(type)”的重要变更:早期 ES 允许一个索引下有多个 type(像一张库里多张表),但官方发现这会带来Lucene底层实现复杂和性能问题,因此在 6.x 限制为一索引一类型,7.x 固定为 _doc,8.x 彻底移除。因此新项目请始终使用 _doc,不要自定义类型名。
4.1、文档
就是我们的一条条的记录,elasticsearch是面向文档的,那么就意味着索弓和搜索数据的最小单位是文档, elasticsearch中,文档有几个重要属性:
-
自我包含, 一篇文档同时包含字段和对应的值,也就是同时包含key:value !
-
可以是层次型的,一个文档中包含自文档,复杂的逻辑实体就是这么来的!
-
灵活的结构,文档不依赖预先定义的模式,我们知道关系型数据库中,要提前定义字段才能使用,在elasticsearch中,对于字段是非常灵活的,有时候,我们可以忽略该字段,或者动态的添加一个新的字段。
尽管我们可以随意的新增或者忽略某个字段,但是,每个字段的类型非常重要,比如一个年龄字段类型,可以是字符串也可以是整形。因为elasticsearch会保存字段和类型之间的映射及其他的设置。这种映射具体到每个映射的每种类型,这也是为什么在elasticsearch中,类型有时候也称为映射类型。
文档的元数据:每个文档除了业务字段,还自带
_index、_type、_id、_source、_version等元数据。_source是原始 JSON 的原文,查询时默认返回的就是它;_version是版本号,每次写入/更新自增,是乐观锁与并发控制的基础。
4.2、类型
- 类型是文档的逻辑容器,就像关系型数据库一样,表格是行的容器。类型中对于字段的定义称为映射,比如name映射为字符串类型。
- 文档是无模式的 ,它们不需要拥有映射中所定义的所有字段,比如新增一个字段,那么elasticsearch是怎么做的呢?
- elasticsearch会自动的将新字段加入映射,但是这个字段的不确定它是什么类型, elasticsearch就开始猜,如果这个值是18 ,那么elasticsearch会认为它是整形。
- 但是elasticsearch也可能猜不对 ,所以最安全的方式就是提前定义好所需要的映射,这点跟关系型数据库殊途同归了,先定义好字段,然后再使用。
这种“自动猜类型”的机制叫 Dynamic Mapping(动态映射)。比如
"2021-04-27"会被猜成date,"hello"被猜成text并附带一个keyword子字段。但自动映射经常猜错(例如把手机号、身份证号猜成long导致写入失败),所以生产环境务必显式定义 mapping。
4.3、索引
就是数据库。索引是映射类型的容器,。elasticsearch中的索引是一个非常大的文档集合。索引存储了映射类型的字段和其他设置。然后它们被存储到了各个分片上。
物理设计:节点和分片如何工作
一个集群至少有一 个节点,而一个节点就是一个elasricsearch进程,节点可以有多个索引默认的,如果你创建索引,那么索引将会有个5个分片( primary shard,又称主分片)构成的,每一个主分片会有一个副本( replica shard ,又称复制分片)
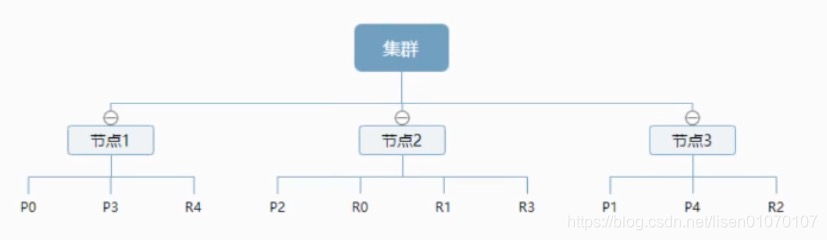
上图是一个有3个节点的集群,可以看到主分片和对应的复制分片都不会在同一个节点内,这样有利于某个节点挂掉了,数据也不至于丢失。
实际上, 一个分片是一个Lucene索引,一个包含倒排索引的文件目录,倒排索引的结构使得elasticsearch在不扫描全部文档的情况下,就能告诉你哪些文档包含特定的关键字。
节点角色补充:一个节点可以是 master(负责集群元数据)、data(存数据)、ingest(预处理)、coordinating(协调节点)等角色。小集群里一个节点身兼数职;大集群会专门指定 node.master / node.data 来分离角色。分片分配(shard allocation)策略会尽量让主分片与副本分片落在不同节点,保证高可用。
4.4、倒排索引
elasticsearch使用的是一种称为倒排索引的结构,采用Lucene倒排索作为底层。
这种结构适用于快速的全文搜索,一个索引由文档中所有不重复的列表构成,对于每一个词,都有一个包含它的文档列表。
1、举例
例如,现在有两个文档,每个文档包含如下内容:
Study every day, good good up to forever  # 文档1包含的内容
To forever, study every day,good good up  # 文档2包含的内容
为创建倒排索引,我们首先要将每个文档拆分成独立的词(或称为词条或者tokens) ,然后创建一一个包含所有不重 复的词条的排序列表,然后列出每个词条出现在哪个文档:
| term | doc_1 | doc_2 |
|---|---|---|
| Study | √ | x |
| To | x | x |
| every | √ | √ |
| forever | √ | √ |
| day | √ | √ |
| study | x | √ |
| good | √ | √ |
| every | √ | √ |
| to | √ | x |
| up | √ | √ |
| 现在,我们试图搜索 to forever,只需要查看包含每个词条的文档 |
| term | doc_1 | doc_2 |
|---|---|---|
| to | √ | x |
| forever | √ | √ |
| total | 2 | 1 |
| 两个文档都匹配,但是第一个文档比第二个匹配程度更高。如果没有别的条件,现在,这两个包含关键字的文档都将返回。 |
相关度打分(relevance score):ES 默认用 BM25 算法计算
_score。它综合了「词频 TF」「逆文档频率 IDF」「字段长度归一化」等因素。上表中 doc_1 命中 2 个词、doc_2 命中 1 个,所以 doc_1 分数更高、排在前面。我们可以用explain: true查看打分细节,用于调优搜索结果。
再来看一个示例,比如我们通过博客标签来搜索博客文章。那么倒排索引列表就是这样的一个结构:
| 博客文章(原始数据) | 博客文章(原始数据) | 索引列表(倒排索引) | 索引列表(倒排索引) |
|---|---|---|---|
| 博客文章ID | 标签 | 标签 | 博客文章ID |
| 1 | python | python | 1,2,3 |
| 2 | python | linux | 3,4 |
| 3 | linux,python | ||
| 4 | linux | ||
| 如果要搜索含有python标签的文章,那相对于查找所有原始数据而言,查找倒排索引后的数据将会快的多。只需要查看标签这一栏,然后获取相关的文章ID即可。完全过滤掉无关的所有数据,提高效率! |
4.5、ik分词器
1、下载
1、https://github.com/medcl/elasticsearch-analysis-ik
2、解压放到plugins
安装方式有两种:
- 方式 A(推荐):用 ES 自带的插件命令,自动下载到对应版本目录:
# 进入 es 安装目录 bin/elasticsearch-plugin install https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.6.2/elasticsearch-analysis-ik-7.6.2.zip- 方式 B(Docker):在
docker run时挂载自定义插件目录,或基于官方镜像写 Dockerfile:FROM docker.elastic.co/elasticsearch/elasticsearch:7.6.2 RUN elasticsearch-plugin install --batch https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.6.2/elasticsearch-analysis-ik-7.6.2.zip注意 版本必须和 ES 完全一致,否则启动报
Plugin [analysis-ik] was built for Elasticsearch ... but version ... is required。
2、测试
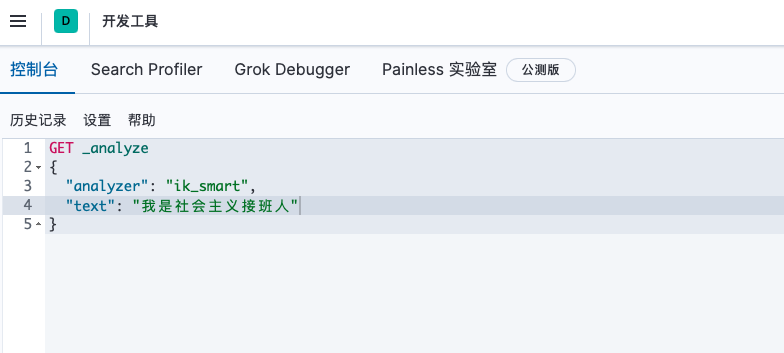
IK提供了两个分词算法: ik_ smart和ik_ max_ word ,其中ik_ smart为最少切分, ik_ max_ _word为最细粒度划分!一会我们测试!
3、什么是IK分词器:
把一句话分词
如果使用中文:推荐IK分词器
两个分词算法:ik_smart(最少切分),ik_max_word(最细粒度划分)
二者的区别:
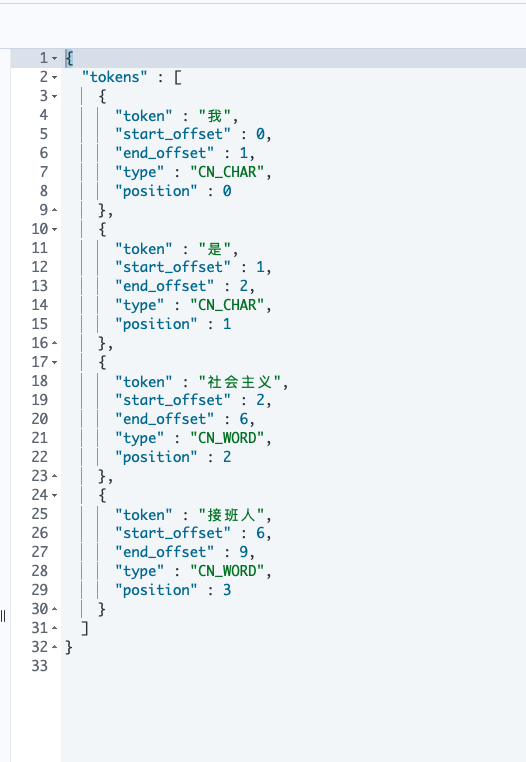
ik_smart:粗粒度,尽量少切。如“中华人民共和国” → “中华人民共和国”。适合搜索时(query 侧)用,结果更聚焦。ik_max_word:细粒度,穷尽词典组合。如“中华人民共和国” → “中华人民共和国 / 中华人民 / 中华 / 华人 / 人民共和国 / 人民 / 共和国 / 共和 / 国”。适合索引时(index 侧)用,召回更全。
常见最佳实践:索引时用 ik_max_word,搜索时用 ik_smart。
4、ik_smart测试:
输出:
5、ik_max_word测试:
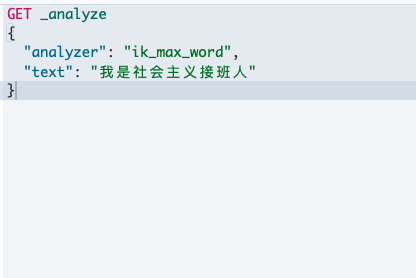
输出
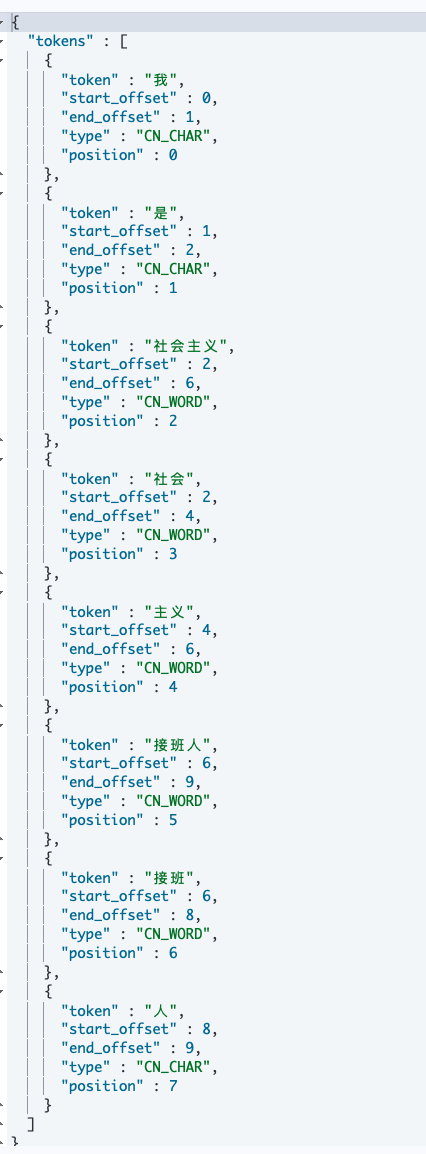
6、自定义词典(扩展词 / 停用词)
默认词典覆盖常用词,但业务词(品牌名、行业术语、人名)往往切不出来。我们需要扩展词典:
- 进入
plugins/elasticsearch-analysis-ik-7.6.2/config/目录; - 编辑
IKAnalyzer.cfg.xml:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd">
<properties>
    <comment>IK Analyzer 扩展配置</comment>
    <!-- 用户可在此添加自己的扩展字典 -->
    <entry key="ext_dict">extra_my.dic</entry>
    <!-- 用户可在此添加自己的扩展停止词字典 -->
    <entry key="ext_stopwords">extra_stopword.dic</entry>
    <!-- 远程扩展词典(热更新,无需重启 ES),内容为每行一个词 -->
    <entry key="remote_ext_dict">http://127.0.0.1:8080/dict/ik/getDict</entry>
    <entry key="remote_ext_stopwords">http://127.0.0.1:8080/dict/ik/getStop</entry>
</properties>
- 在同目录新建
extra_my.dic,写入自定义词(如“螺狮粉”“狂神说”),注意文件必须保存为 UTF-8 无 BOM; - 重启 ES 生效。
热更新技巧:使用
remote_ext_dict指向一个 HTTP 接口,ES 会定时(默认 60s)拉取,接口返回Last-Modified或ETag头,内容有变化才重新加载。这样业务新增词不用重启集群。返回格式非常简单,每行一个词即可:@GetMapping("/dict/ik/getDict") public ResponseEntity<String> getDict() { String words = "螺狮粉\n狂神说\n分布式事务"; // 从数据库动态读 HttpHeaders headers = new HttpHeaders(); headers.setContentType(MediaType.TEXT_PLAIN); return new ResponseEntity<>(words, headers, HttpStatus.OK); }
5、命令模式的使用
5.1、Rest风格说明
一种软件架构风格,而不是标准。更易于实现缓存等机制
| method | url地址 | 描述 |
|---|---|---|
| PUT | localhost:9200/索引名称/类型名称/文档id | 创建文档(指定文档id) |
| POST | localhost:9200/索引名称/类型名称 | 创建文档(随机文档id) |
| POST | localhost:9200/索引名称/类型名称/文档id/_update | 修改文档 |
| DELETE | localhost:9200/索引名称/类型名称/文档id | 删除文档 |
| GET | localhost:9200/索引名称/类型名称/文档id | 通过文档id查询文档 |
| POST | localhost:9200/索引名称/类型名称/_search | 查询所有的数据 |
7.x 之后建议把“类型名称”写成
_doc,即PUT /索引名/_doc/文档id。POST /索引名/_doc不指定 id 时 ES 自动生成。
5.2、创建一个索引
PUT /索引名/类型名/文档id
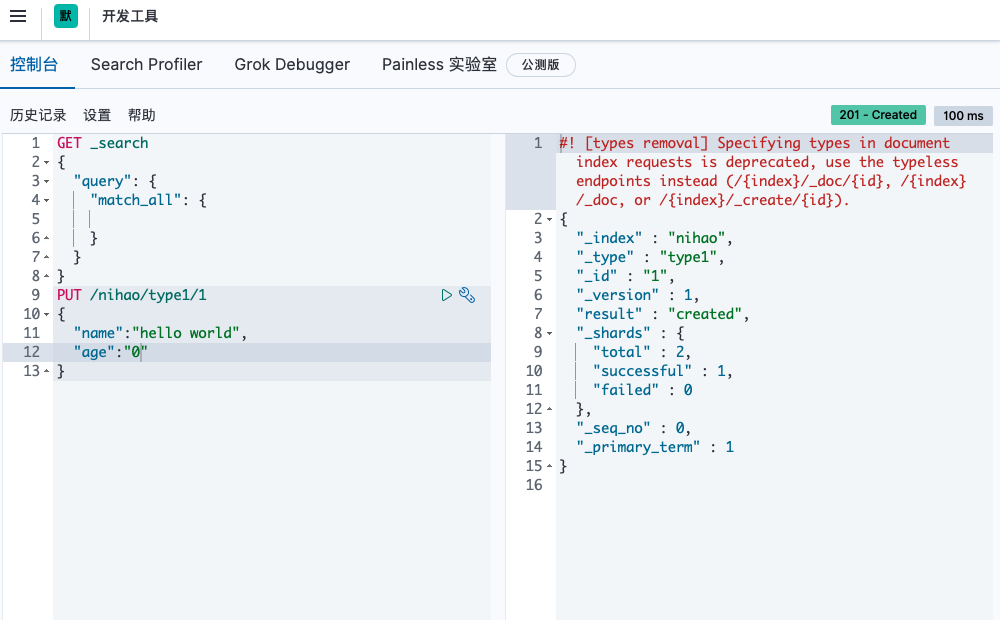
可以看到插入成功。
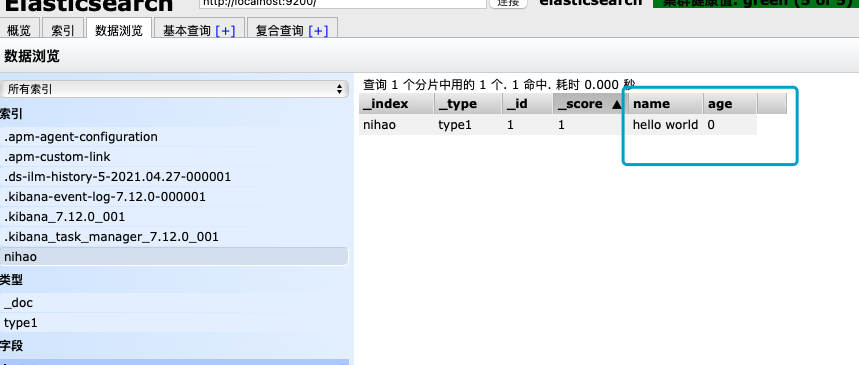
5.2.1、查看属性
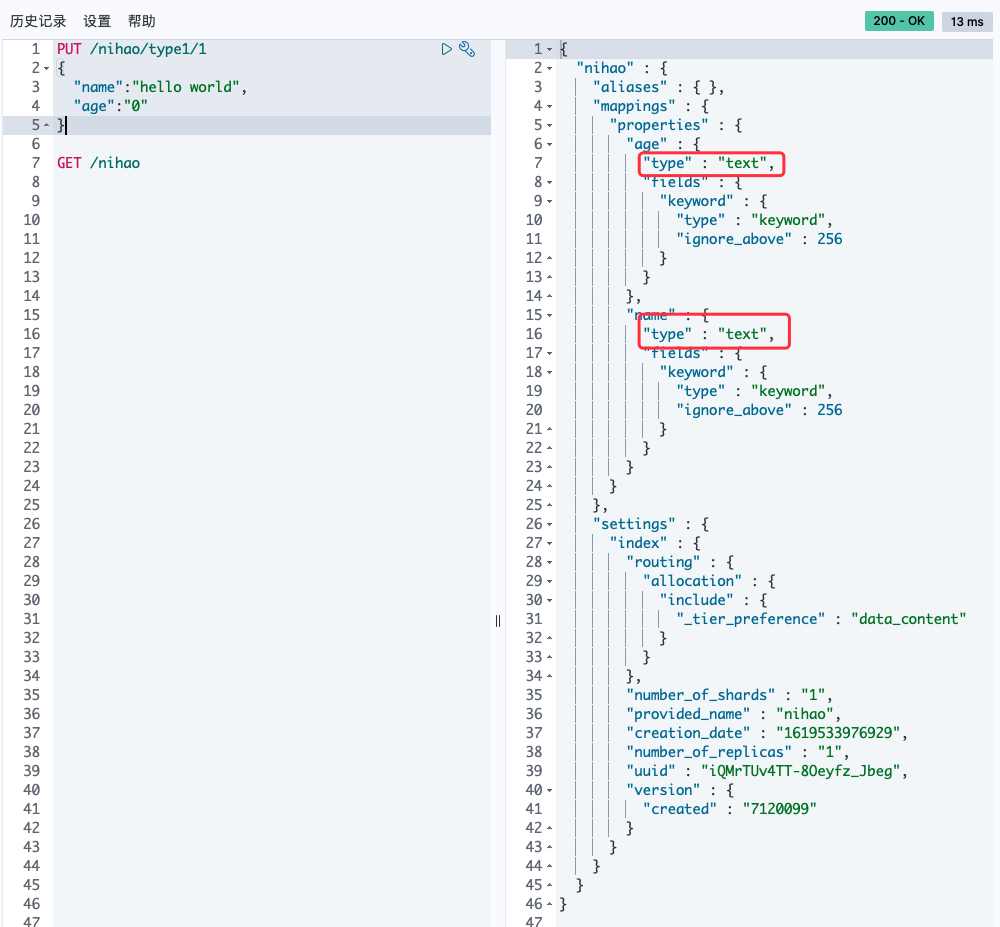
5.2.2、指定字段的类型properties
获得这个规则!可以通过GET请求获得具体的信息
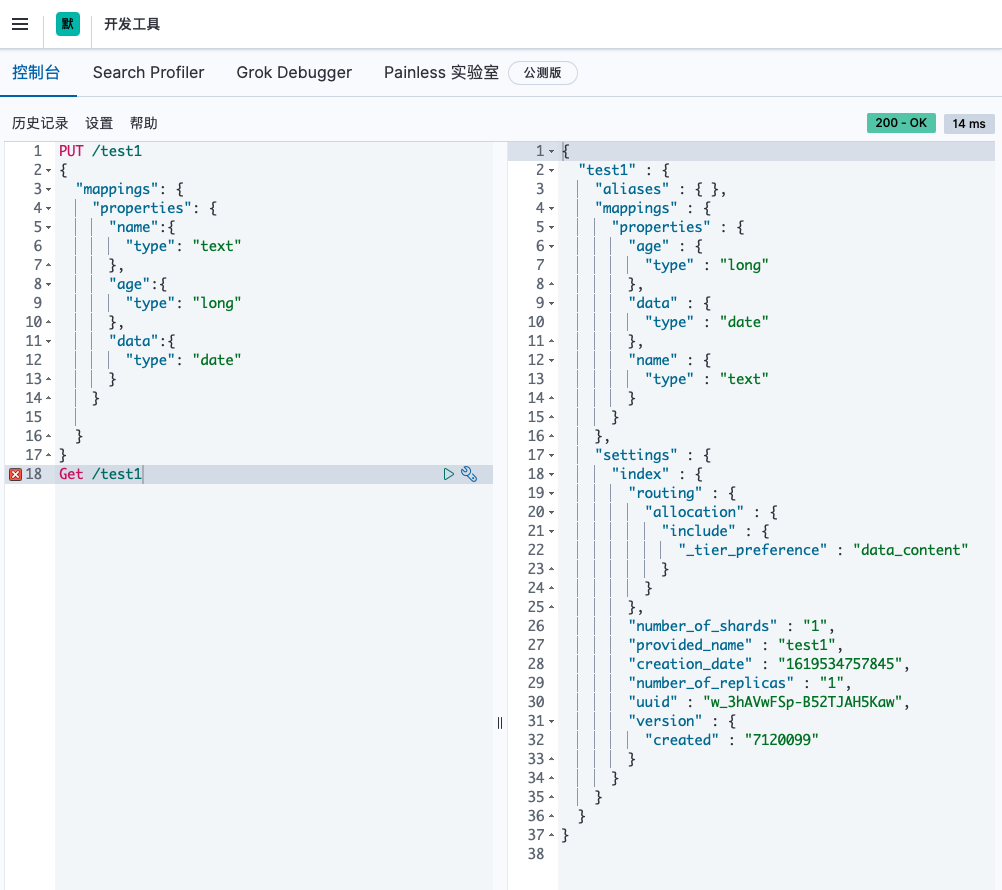
强烈建议在创建索引时显式指定 mapping,而不是依赖动态映射。下面给出一个完整的「建索引 + 指定字段类型」示例,也是真实项目中常见的商品索引设计:
PUT /products
{
  "settings": {
    "number_of_shards": 3,           // 主分片数,一旦设定不可修改(只能 reindex 重建)
    "number_of_replicas": 1,         // 每个主分片的副本数,可随时调整
    "analysis": {
      "analyzer": {
        "ik_pinyin": {               // 自定义分析器(示例:ik + 拼音,可按需删减)
          "type": "custom",
          "tokenizer": "ik_max_word"
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "id":       { "type": "long" },
      "title":    { "type": "text", "analyzer": "ik_max_word", "search_analyzer": "ik_smart" },
      "category": { "type": "keyword" },   // 不分词,用于聚合/精确匹配
      "price":    { "type": "scaled_float", "scaling_factor": 100 }, // 避免浮点误差
      "stock":    { "type": "integer" },
      "onSale":   { "type": "boolean" },
      "tags":     { "type": "keyword" },   // 数组类型,keyword 便于 terms 聚合
      "createTime": { "type": "date", "format": "yyyy-MM-dd HH:mm:ss" },
      "location": { "type": "geo_point" } // 地理坐标,可做距离排序
    }
  }
}
字段类型速查(常用):
text:会分词,用于全文检索(标题、正文)。不能直接用于聚合/排序,需配合keyword子字段;keyword:不分词,原样存储,用于精确匹配、过滤、聚合、排序(状态、分类、标签);integer / long / short:整数;float / double / scaled_float:浮点;date:日期,需指定format;boolean:布尔;nested:对象数组,避免对象扁平化导致跨字段匹配错误(如[{color:红,size:大},{color:蓝,size:小}]用 nested 才能正确查询“红且大”);geo_point/geo_shape:地理位置。
5.2.3、如果自己不设置文档字段类型,那么es会自动给默认类型
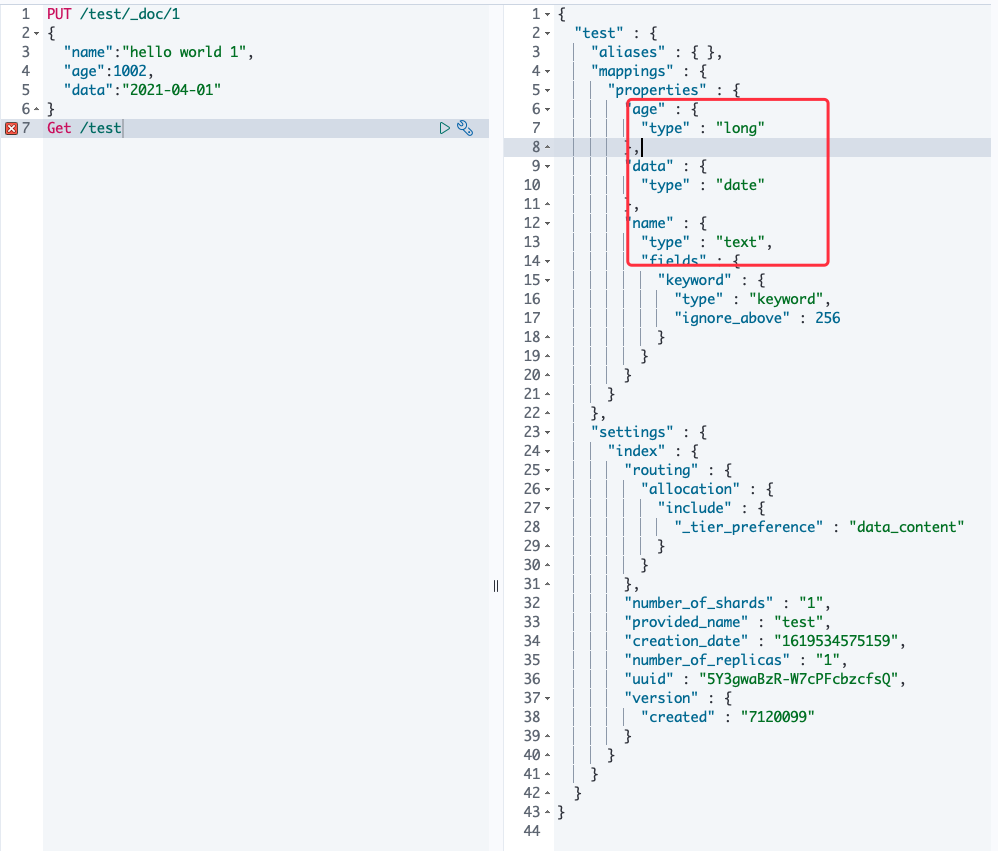
动态映射默认对字符串字段会建
text类型并附带.keyword子字段(如name和name.keyword),所以name能全文搜、name.keyword能聚合。但数字字符串(如"13012345678")可能被误判成long而写入失败,这就是为什么一定要显式 mapping。
5.3、cat命令
查看健康值
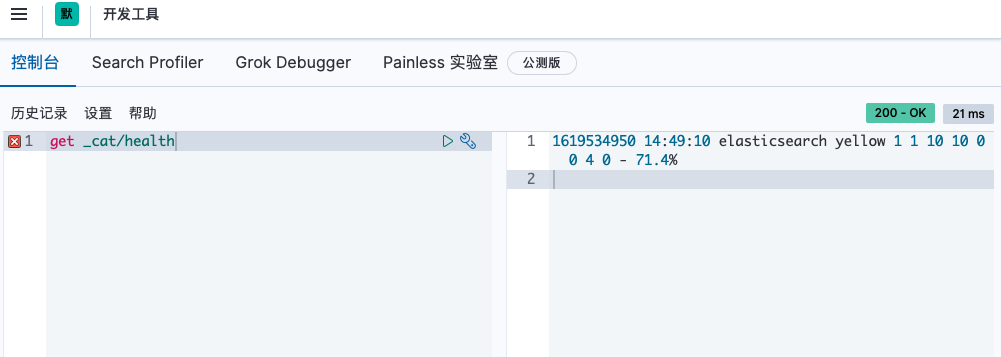
查看所有信息
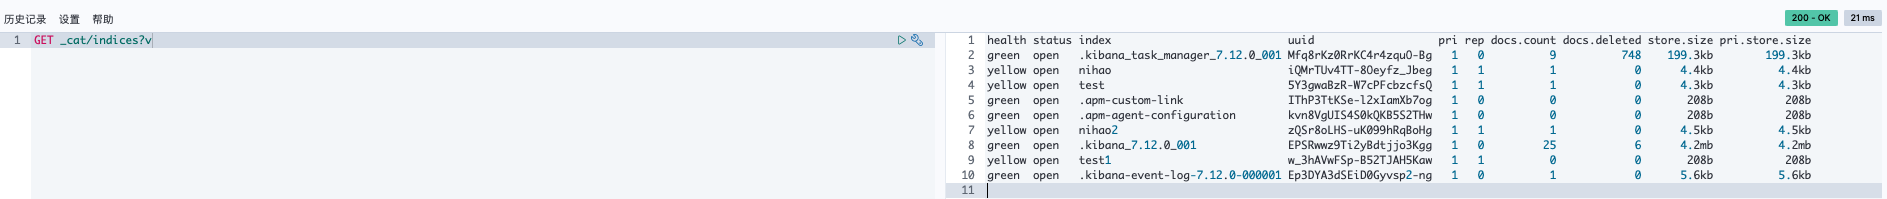
常用 _cat 命令(运维必备):
# 集群健康:green / yellow / red
GET /_cat/health?v

# 节点列表与资源占用
GET /_cat/nodes?v

# 所有索引及文档数、存储大小
GET /_cat/indices?v

# 分片分布(排查未分配分片很有用)
GET /_cat/shards?v

# 查看某个索引的 mapping
GET /products/_mapping

# 查看某个索引的设置
GET /products/_settings
健康状态含义:
green主副分片都正常;yellow主分片正常但副本未分配(通常单机集群会 yellow,不影响使用);red有主分片丢失,部分数据不可用时,需紧急处理。
5.4、修改索引
1.修改我们可以还是用原来的PUT的命令,根据id来修改
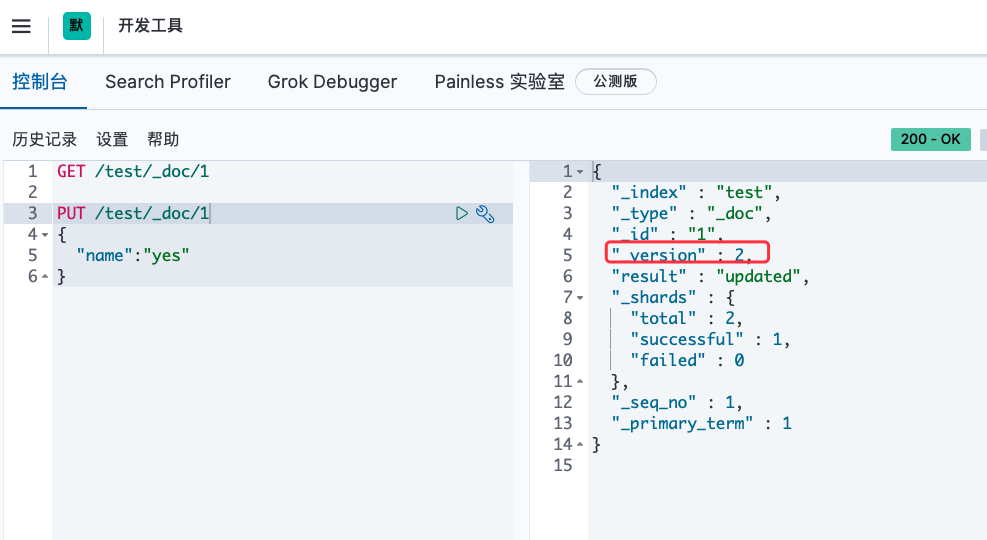
可以看到version为2证明已经是修改过的了
但是如果没有填写的字段 会重置为空了 ,相当于java接口传对象修改,如果只是传id的某些字段,那其他没传的值都为空了。
2.还有一种update方法 这种不设置某些值 数据不会丢失
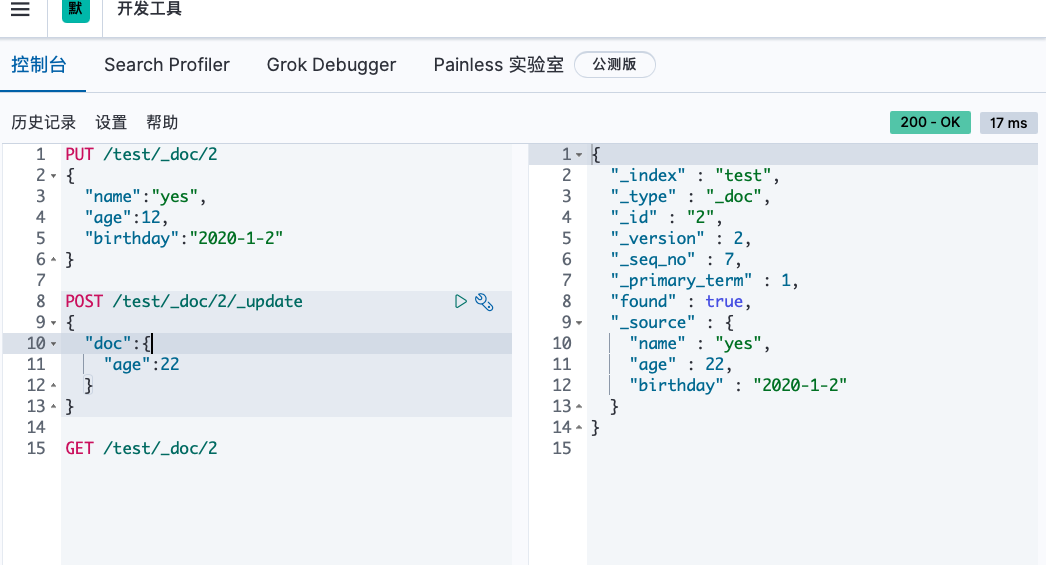
推荐用
_update+ 部分字段,而不是整体 PUT。整体 PUT 会覆盖整个文档(先删后建),未传字段变空;_update是真正的局部更新(merge)。还可以用脚本更新:
POST /products/_update/1001
{
  "script": {
    "source": "ctx._source.stock += params.inc",
    "lang": "painless",
    "params": { "inc": 5 }
  }
}
5.5、删除索引
通过DELETE命令实现删除,根据你的请求来判断是删除索引还是删除文档记录。
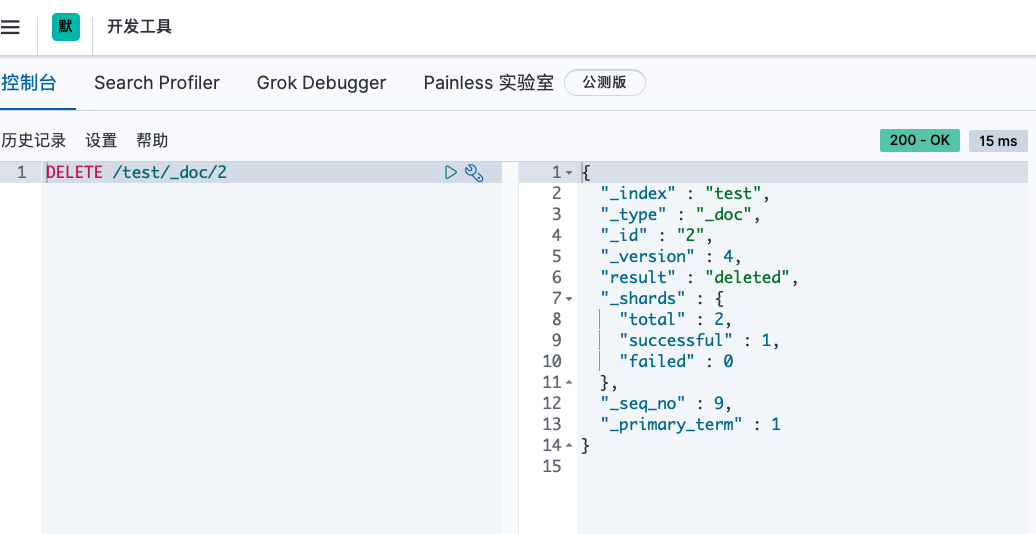
# 删整个索引(危险!不可恢复,除非有快照)
DELETE /products

# 只删某条文档
DELETE /products/_doc/1001
生产环境建议给删除操作加防护:在
elasticsearch.yml设置action.destructive_requires_name: true,禁止DELETE /*这种通配符误删全部索引。
5.6、关于文档的基本操作
最简单的搜索是GET
搜索功能search
Get /test/_doc/_search?q=name:yes
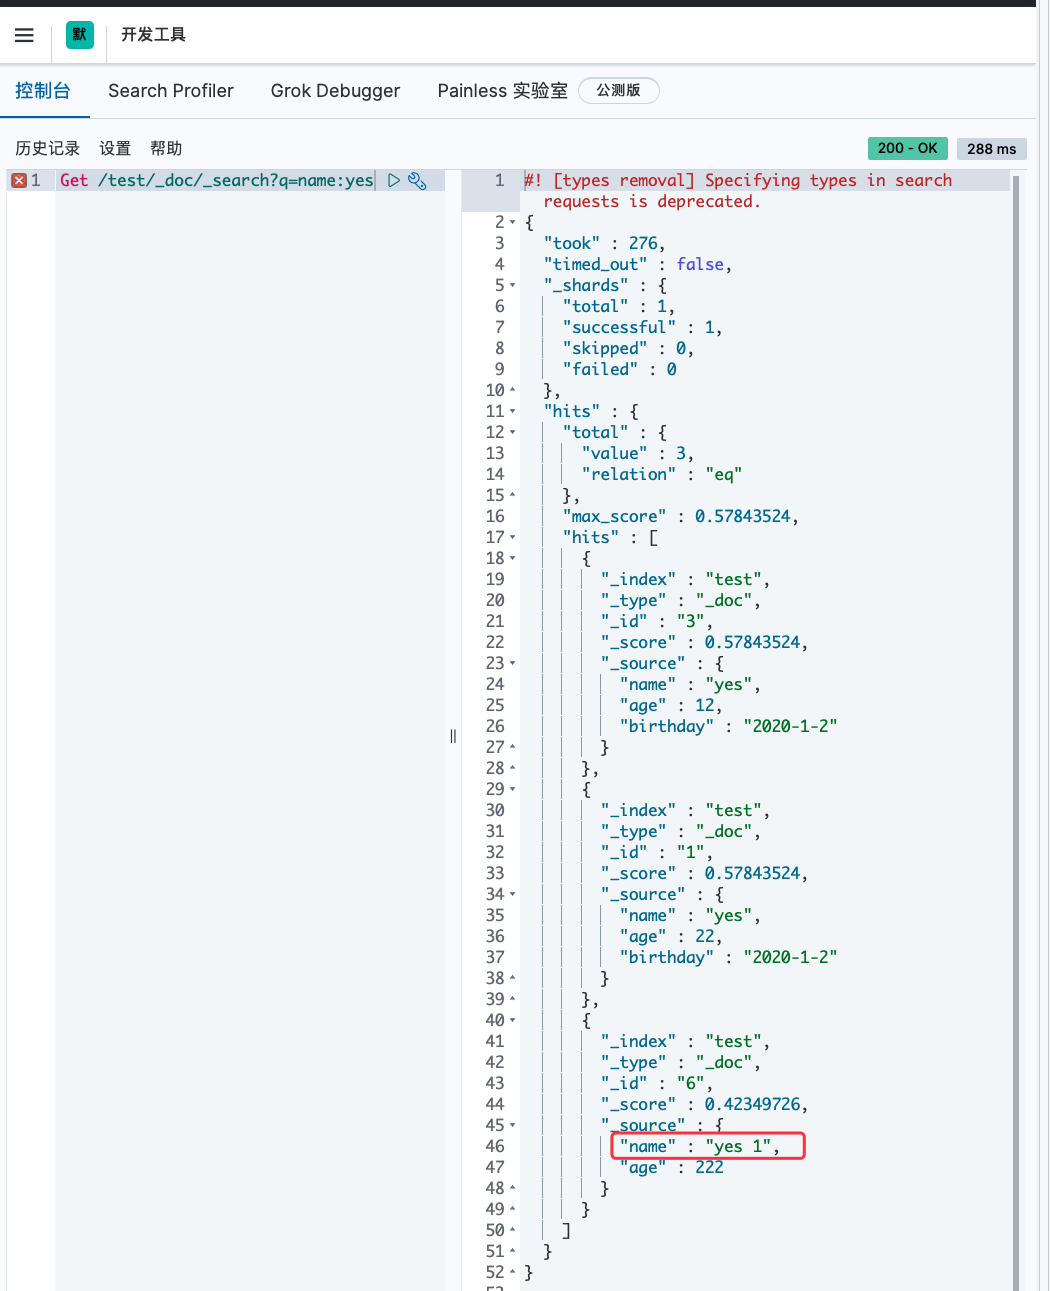
这边name是text 所以做了分词的查询 如果是keyword就不会分词搜索了
这里的
q=name:yes是 URI Search(简单查询串),适合临时查。真正的复杂查询用 Request Body Search(下面 5.7),把查询条件写在 JSON 请求体里。
5.7、复杂操作搜索select(排序,分页,高亮,模糊查询,精准查询)
Get /test/_doc/_search?q=name:yes

GET /test/_doc/_search
{
  "query": {
    "match": {
      "name": "yes"
    }
  },
  "_source":["name"]
}
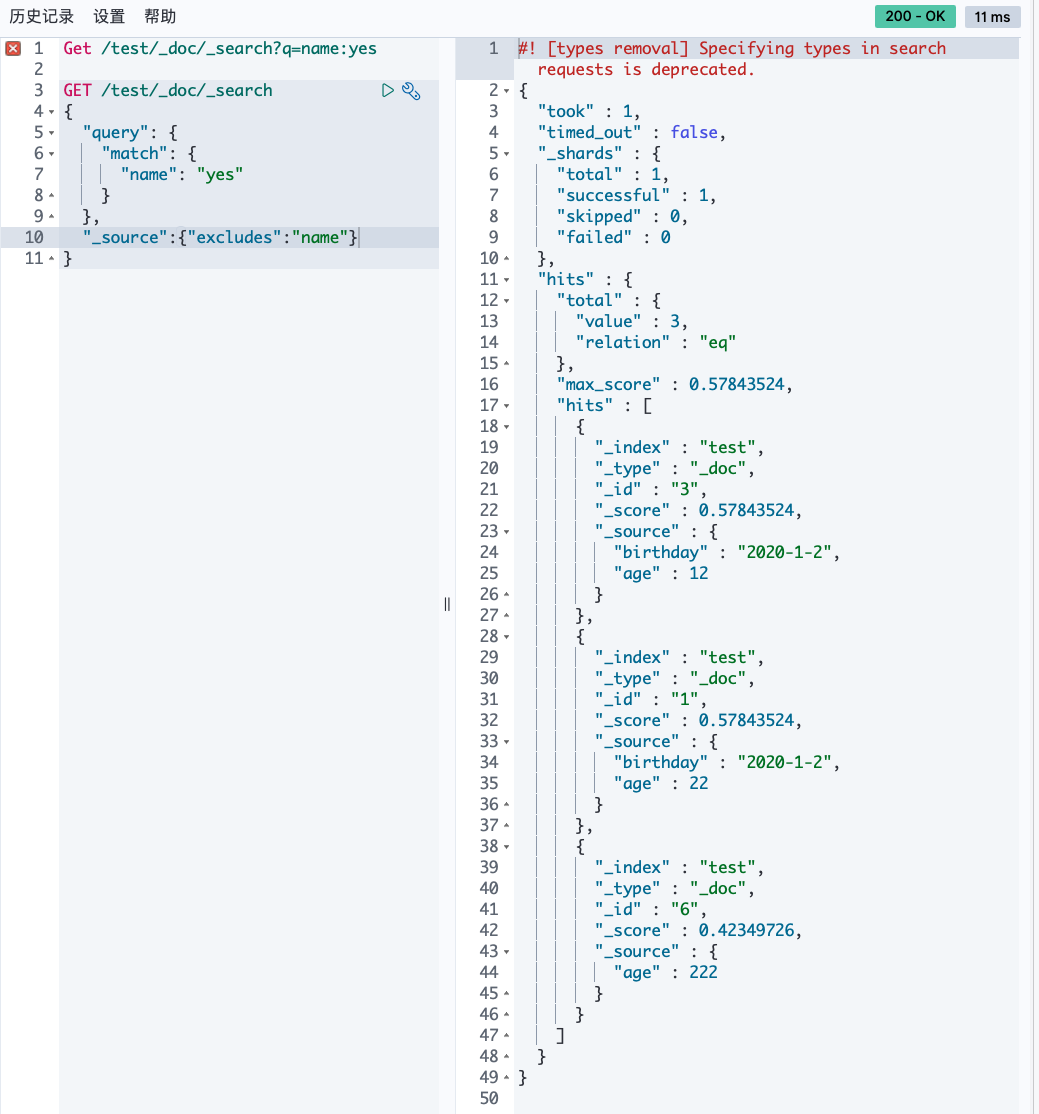
结果过滤,就是只展示列表中某些字段
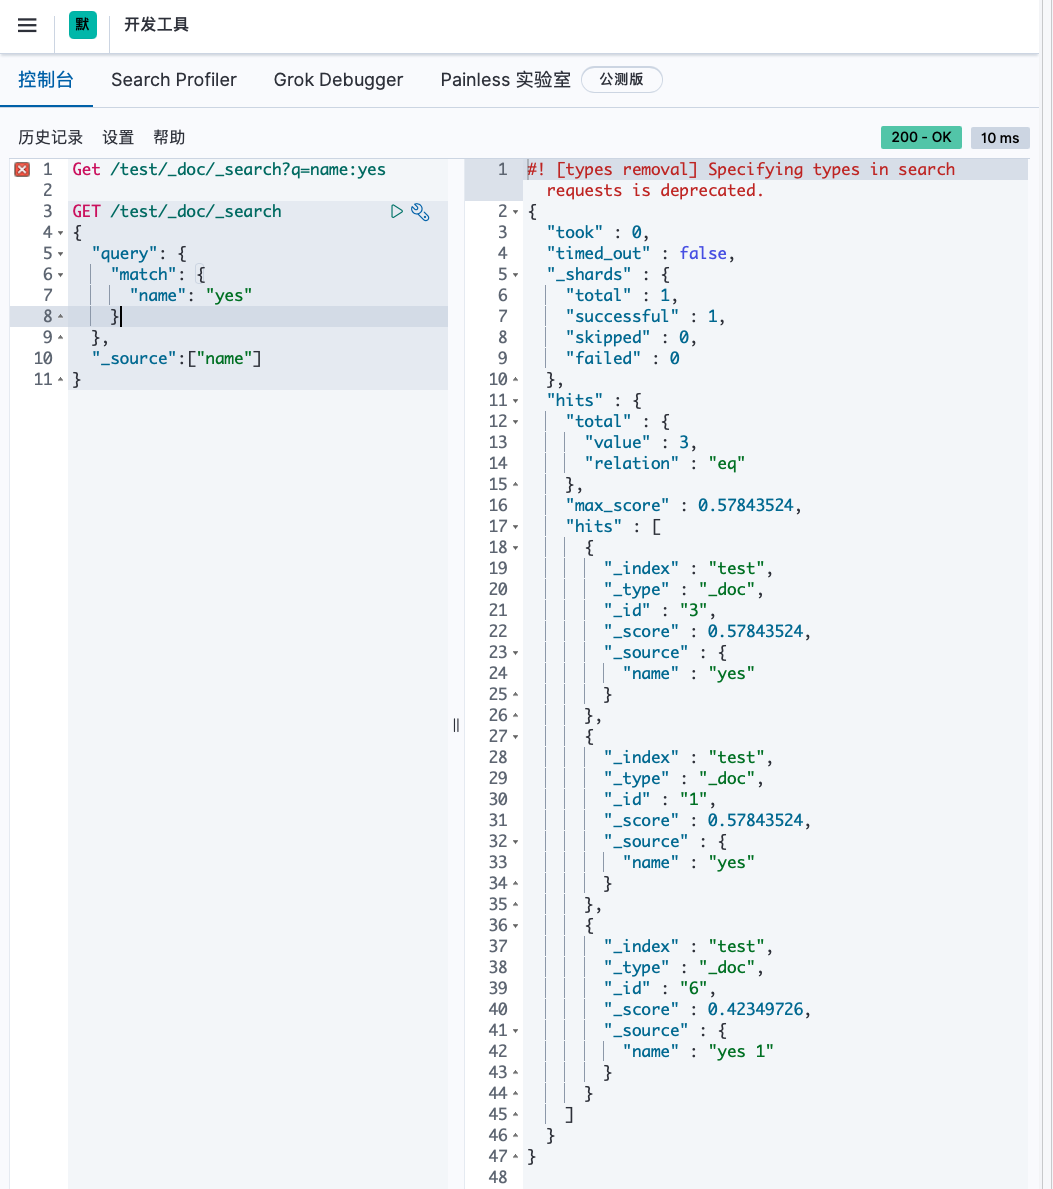
不包含
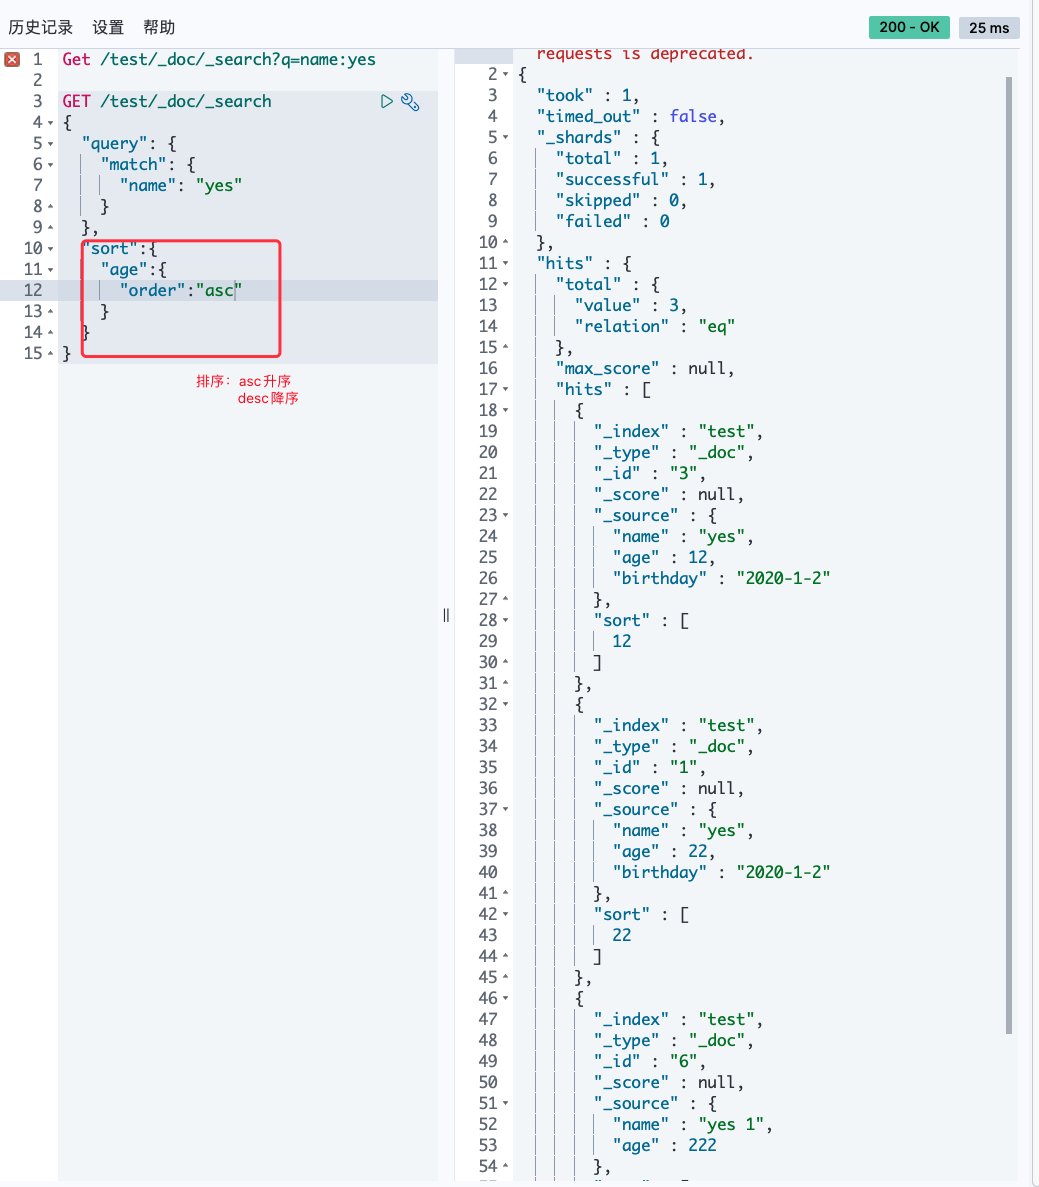
排序
分页
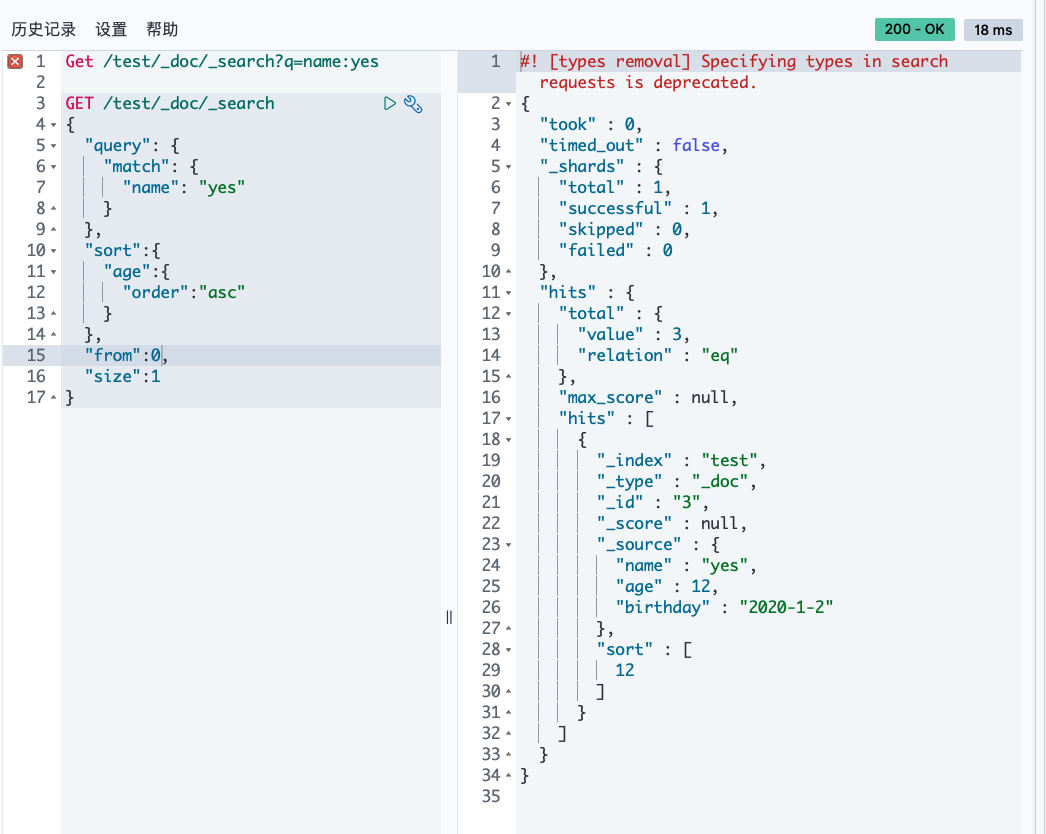
5.7.1、DSL 查询完整示例(核心,必会)
下面把日常最常用的查询集中演示一遍。假设索引 products 已按上面的 mapping 建好。
(1) match 全文检索(会分词)
GET /products/_search
{
  "query": {
    "match": {
      "title": "华为手机"      // ik_smart 分词后检索,相关度排序
    }
  }
}
(2) term 精确匹配(不分词,用于 keyword / 数值 / 布尔)
GET /products/_search
{
  "query": {
    "term": { "category": "手机" }   // category 是 keyword,必须精确相等
  }
}
常见坑:
term对text字段查不到,因为 text 被分词成多个 term;要对 text 做精确匹配请用.keyword子字段,或改用match。
(3) terms 多值匹配(IN 查询)
GET /products/_search
{
  "query": { "terms": { "category": ["手机", "电脑", "平板"] } }
}
(4) match_phrase 短语匹配(词序一致)
GET /products/_search
{
  "query": { "match_phrase": { "title": "华为手机" } }  // 必须连续出现“华为 手机”
}
(5) range 范围查询
GET /products/_search
{
  "query": {
    "range": {
      "price": { "gte": 1000, "lte": 5000 },
      "createTime": { "gte": "2024-01-01 00:00:00" }
    }
  }
}
(6) bool 组合查询(must / should / must_not / filter)
GET /products/_search
{
  "query": {
    "bool": {
      "must": [                       // 必须满足,参与打分
        { "match": { "title": "华为" } }
      ],
      "filter": [                     // 过滤,不参与打分,可缓存,性能好
        { "term": { "onSale": true } },
        { "range": { "price": { "gte": 1000, "lte": 5000 } } }
      ],
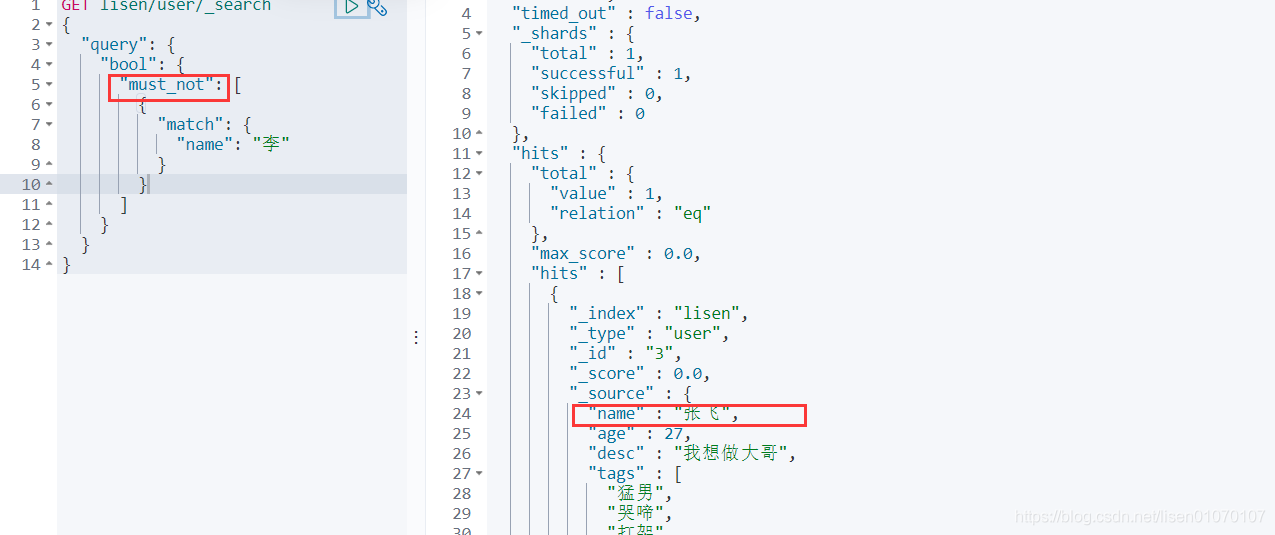
      "must_not": [                   // 必须不满足
        { "term": { "category": "配件" } }
      ],
      "should": [                     // 应该满足(or,打分加权)
        { "match": { "title": "Pro" } }
      ]
    }
  }
}
filtervsmust:二者都能过滤数据,但filter不计算相关度分数、结果可被缓存,因此能用 filter 就用 filter,性能更好。
(7) 排序 + 分页 + 结果字段过滤
GET /products/_search
{
  "query": { "match_all": {} },
  "_source": ["title", "price", "category"],
  "from": 0,                          // 从第几条开始(页码-1)* size
  "size": 20,                         // 每页条数
  "sort": [
    { "price": { "order": "desc" } },
    { "_score": { "order": "desc" } }
  ]
}
深度分页陷阱:ES 默认
from + size不能超过index.max_result_window(10000)。翻到第 10001 条会报错。海量翻页要用search_after(基于上一页最后一条的排序值游标)或scroll(快照式遍历)。
(8) 聚合查询(aggs):分类统计 + 平均价
GET /products/_search
{
  "size": 0,                          // 不返回具体文档,只看聚合结果
  "aggs": {
    "group_by_category": {
      "terms": { "field": "category", "size": 10 }   // 按分类分组计数
    },
    "avg_price": {
      "avg": { "field": "price" }                       // 全局平均价
    }
  }
}
(9) 高亮
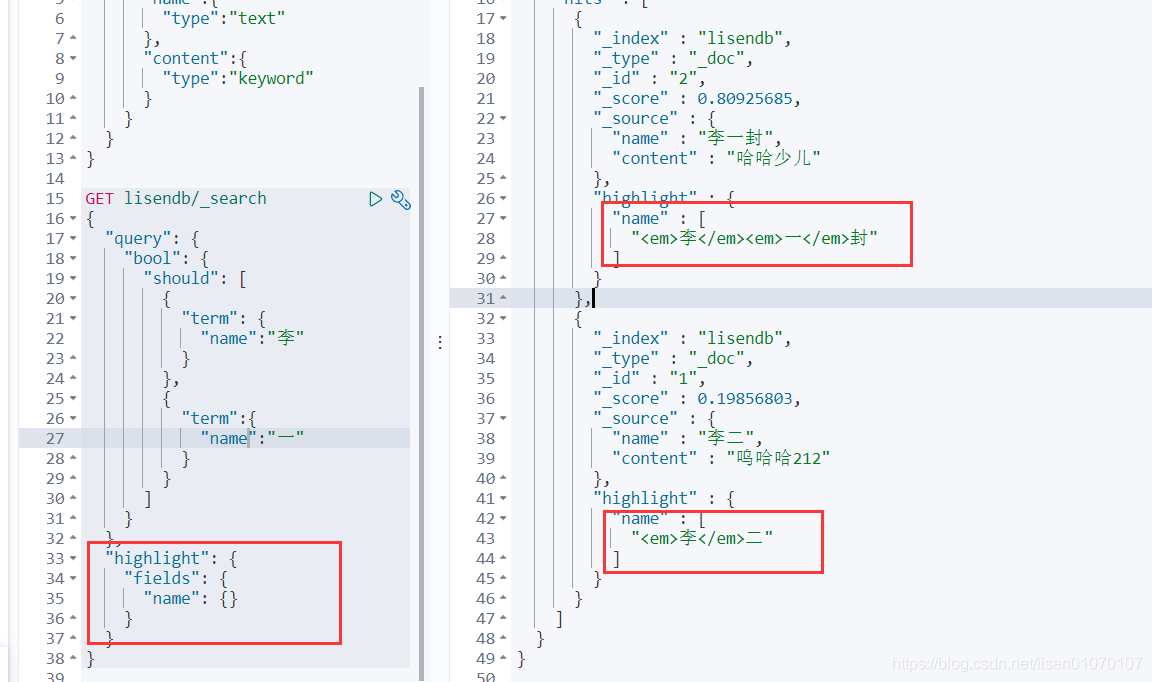
还能自定义高亮的样式
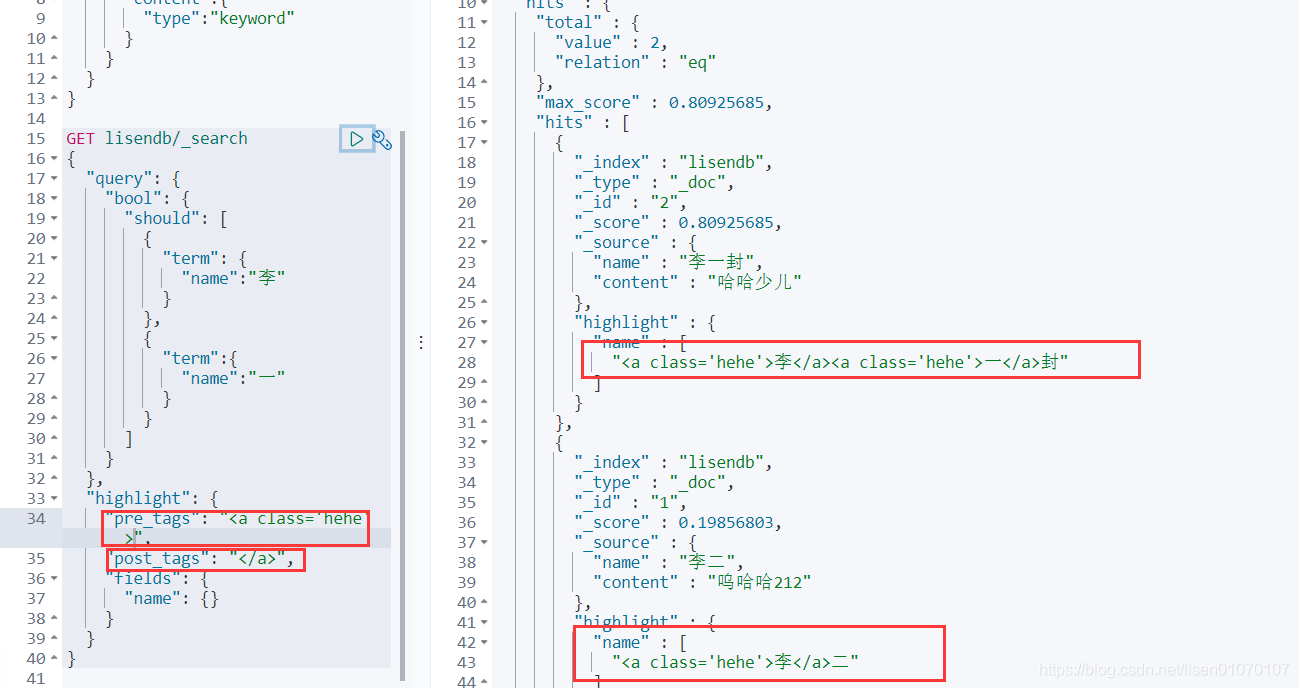
GET /products/_search
{
  "query": { "match": { "title": "华为" } },
  "highlight": {
    "pre_tags": ["<span style='color:red'>"],
    "post_tags": ["</span>"],
    "fields": { "title": {} }
  }
}
(10) 模糊与通配
GET /products/_search
{
  "query": { "fuzzy": { "title": { "value": "华维", "fuzziness": 1 } } }  // 允许 1 个字符差异
}
GET /products/_search
{
  "query": { "wildcard": { "category": "手*" } }   // 通配符
}
多条件查询
布尔值查询
must(and),所有的条件都要符合
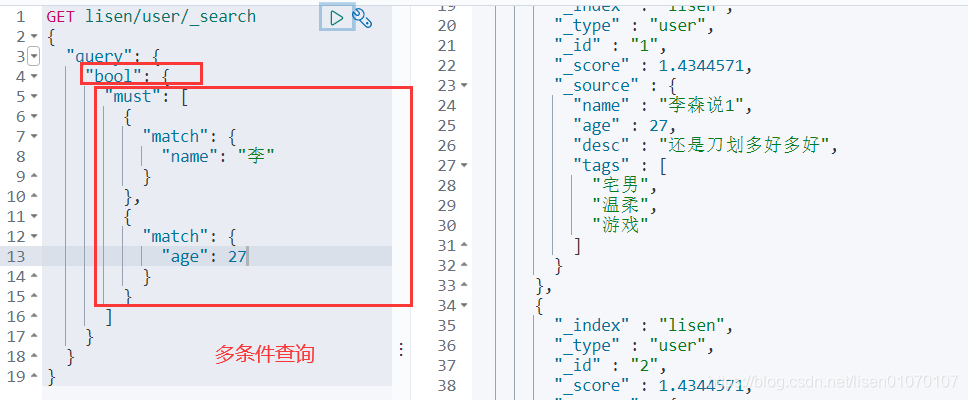
should(or)或者的 跟数据库一样

must_not(not)
条件区间
-
gt大于
-
gte大于等于
-
lte小于
-
lte小于等于
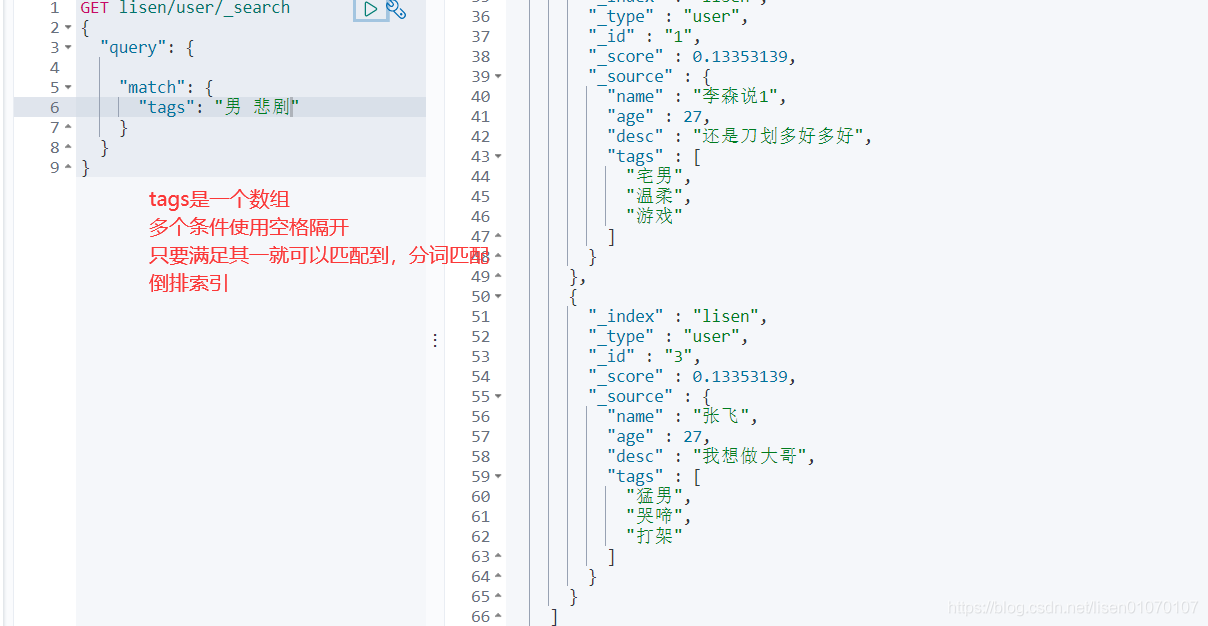
匹配多个条件(数组)
5.7.2、批量操作与索引别名(实用)
# 1. 批量写入(bulk),一行 action 一行 data
POST /products/_bulk
{ "index": { "_id": 1 } }
{ "title": "华为 Mate 60", "category": "手机", "price": 6999, "onSale": true }
{ "index": { "_id": 2 } }
{ "title": "小米 14 Pro", "category": "手机", "price": 4999, "onSale": true }

# 2. 索引别名:对外暴露稳定名称,重建索引时无缝切换
POST /_aliases
{
  "actions": [
    { "remove": { "index": "products_v1", "alias": "products" } },
    { "add":    { "index": "products_v2", "alias": "products" } }
  ]
}
别名(alias)是线上零停机改 mapping 的关键手段:先在
products_v2上建好新结构并 reindex 数据,再把别名从 v1 切到 v2,应用无感知。
# reindex:把旧索引数据搬到新索引(改 mapping 的标配)
POST /_reindex
{
  "source": { "index": "products_v1" },
  "dest":   { "index": "products_v2" }
}
6、springboot集成
1、添加依赖
<dependency>
  <groupId>org.springframework.boot</groupId>
  <artifactId>spring-boot-starter-data-elasticsearch</artifactId>
  <version>2.3.7.RELEASE</version>
</dependency>
版本提示:
spring-boot-starter-data-elasticsearch在 Spring Boot 2.3 中封装的是RestHighLevelClient(7.x 客户端)。该客户端在 ES 8.x 已被标记为废弃,官方推荐使用新的 Java API Client(co.elastic.clients:elasticsearch-java)。如果是 7.x 服务端,下面代码可直接用;若用 8.x,请改用新客户端,API 写法不同但思路一致。
2、自定义配置
package com.xiaofan.config;

import org.apache.http.HttpHost;
import org.elasticsearch.client.RestClient;
import org.elasticsearch.client.RestHighLevelClient;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class ElasticSearchClientConfig {
  @Bean
  public RestHighLevelClient restHighLevelClient() {
    RestHighLevelClient client = new RestHighLevelClient(
      RestClient.builder(
        new HttpHost("127.0.0.1", 9200, "http")
      )
    );

    return client;
  }
}
3、测试
package com.example.demo;

import org.elasticsearch.action.admin.indices.delete.DeleteIndexRequest;
import org.elasticsearch.action.support.master.AcknowledgedResponse;
import org.elasticsearch.client.RequestOptions;
import org.elasticsearch.client.RestHighLevelClient;
import org.elasticsearch.client.indices.CreateIndexRequest;
import org.elasticsearch.client.indices.CreateIndexResponse;
import org.elasticsearch.client.indices.GetIndexRequest;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.boot.test.context.SpringBootTest;

import java.io.IOException;

@SpringBootTest
class DemoApplicationTests {


    @Autowired
    @Qualifier(value = "restHighLevelClient")
    private RestHighLevelClient client;


    @Test
    void testCreateIndex() throws IOException {
        //1.创建索引的请求
        CreateIndexRequest request = new CreateIndexRequest("lisen_index");
        //2客户端执行请求,请求后获得响应
        CreateIndexResponse response = client.indices().create(request, RequestOptions.DEFAULT);
        System.out.println(response);
    }

    //测试索引是否存在
    @Test
    void testExistIndex() throws IOException {
        //1.创建索引的请求
        GetIndexRequest request = new GetIndexRequest("lisen_index");
        //2客户端执行请求,请求后获得响应
        boolean exist = client.indices().exists(request, RequestOptions.DEFAULT);
        System.out.println("测试索引是否存在-----" + exist);
    }

    //删除索引
    @Test
    void testDeleteIndex() throws IOException {
        DeleteIndexRequest request = new DeleteIndexRequest("lisen_index");
        AcknowledgedResponse delete = client.indices().delete(request, RequestOptions.DEFAULT);
        System.out.println("删除索引--------" + delete.isAcknowledged());
    }
}
6.1、使用 Spring Data Elasticsearch 的实体与 Repository(推荐)
除了底层 RestHighLevelClient,Spring Data ES 还提供声明式 Repository,开发更省心。
(1) 文档实体
import org.springframework.data.annotation.Id;
import org.springframework.data.elasticsearch.annotations.Document;
import org.springframework.data.elasticsearch.annotations.Field;
import org.springframework.data.elasticsearch.annotations.FieldType;

@Document(indexName = "products")   // 对应索引名
public class Product {

    @Id
    private Long id;

    @Field(type = FieldType.Text, analyzer = "ik_max_word", searchAnalyzer = "ik_smart")
    private String title;            // 中文分词

    @Field(type = FieldType.Keyword)
    private String category;         // 不分词

    @Field(type = FieldType.Double)
    private Double price;

    @Field(type = FieldType.Boolean)
    private Boolean onSale;

    // getter/setter 省略
}
(2) Repository 接口
import org.springframework.data.elasticsearch.repository.ElasticsearchRepository;

public interface ProductRepository extends ElasticsearchRepository<Product, Long> {
    // 方法名自动推导查询:按分类精确查
    List<Product> findByCategory(String category);
    // 按标题全文检索
    List<Product> findByTitle(String keyword);
}
(3) 业务层调用
@Service
public class ProductService {

    @Autowired
    private ProductRepository productRepository;

    public void save(Product p) {
        productRepository.save(p);                  // 单条写入
    }

    public void batchSave(List<Product> list) {
        productRepository.saveAll(list);             // 批量写入
    }

    public List<Product> search(String keyword) {
        return productRepository.findByTitle(keyword);
    }
}
踩坑提示:
@Document(indexName = "products")如果索引不存在,默认不会自动创建带 ik 分词的 mapping,而是用动态映射,导致中文搜索失效。要么提前用 PUT 建好 mapping,要么配置indexName并在配置里开启自动创建(并用ElasticsearchOperations手动 putMapping);- 实体字段类型和 ES mapping 要对得上,否则写入报 mapper_parsing_exception。
7实战:模拟全文搜索-京东搜索
github链接:https://github.com/fanjianhai/CODE/tree/main/SpringBoot/springboot-11-elasticsearch-jd
7.1、搭建springboot项目,添加依赖
<dependencies>
  <!--springboot的elasticsearch服务-->
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-elasticsearch</artifactId>
    <version>2.3.7.RELEASE</version>
  </dependency>
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-thymeleaf</artifactId>
    <version>2.4.5</version>
  </dependency>
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-test</artifactId>
    <scope>test</scope>
    <exclusions>
      <exclusion>
        <groupId>org.junit.vintage</groupId>
        <artifactId>junit-vintage-engine</artifactId>
      </exclusion>
    </exclusions>
  </dependency>
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
  </dependency>
  <!-- 解析网页用 -->
  <dependency>
    <groupId>org.jsoup</groupId>
    <artifactId>jsoup</artifactId>
    <version>1.13.1</version>
  </dependency>
</dependencies>
7.2、配置esconfig
@Configuration
public class ElasticSearchClientConfig {
    @Bean
    public RestHighLevelClient restHighLevelClient(){
        RestHighLevelClient client = new RestHighLevelClient(
                RestClient.builder(new HttpHost("127.0.0.1",9200,"http"))
        );
        return client;
    }
}
7.3、定义content
public class Content implements Serializable {
    private String title;
    private String imgUrl;
    private String price;

    public Content() {
    }

    public Content(String title, String imgUrl, String price) {
        this.title = title;
        this.imgUrl = imgUrl;
        this.price = price;
    }

    public String getTitle() {
        return title;
    }

    public void setTitle(String title) {
        this.title = title;
    }

    public String getImgUrl() {
        return imgUrl;
    }

    public void setImgUrl(String imgUrl) {
        this.imgUrl = imgUrl;
    }

    public String getPrice() {
        return price;
    }

    public void setPrice(String price) {
        this.price = price;
    }

    @Override
    public String toString() {
        return "Content{" +
                "title='" + title + '\'' +
                ", imgUrl='" + imgUrl + '\'' +
                ", price='" + price + '\'' +
                '}';
    }
}
7.4、爬虫
@Component
public class HtmlParseUtl {
    public List<Content> parseJD(String keywords) throws IOException {
        String url = "https://search.jd.com/Search?keyword=" + keywords;
        Document document = Jsoup.parse(new URL(url), 30000);
        Element divElement = document.getElementById("J_goodsList");
        Elements lis = divElement.getElementsByTag("li");

        List<Content> contents = new ArrayList<>();

        for (Element li : lis) {
            String title = li.getElementsByClass("p-name").eq(0).text();
            // 注意:懒加载的图片
            String imgUrl = li.getElementsByTag("img").eq(0).attr("data-lazy-img");
            String price = li.getElementsByClass("p-price").eq(0).text();
            contents.add(new Content(title, imgUrl, price));
        }
        return contents;
    }
}
实战踩坑:京东商品图是懒加载,
src为空,真实地址在data-lazy-img(或新版data-lazy-img/src2)。另外京东有反爬,真实项目建议用其开放 API 或自己后端数据库,不要直接爬线上。
7.5、设置index.html
<!DOCTYPE html>
<html xmlns:th="http://www.thymeleaf.org">

<head>
    <meta charset="utf-8"/>
    <title>狂神说Java-ES仿京东实战</title>
    <link rel="stylesheet" th:href="@{/css/style.css}"/>
</head>

<body class="pg">
<div class="page" id="app">
    <div id="mallPage" class=" mallist tmall- page-not-market ">

        <!-- 头部搜索 -->
        <div id="header" class=" header-list-app">
            <div class="headerLayout">
                <div class="headerCon ">
                    <!-- Logo-->
                    <h1 id="mallLogo">
                        <img th:src="@{/images/jdlogo.png}" alt="">
                    </h1>

                    <div class="header-extra">

                        <!--搜索-->
                        <div id="mallSearch" class="mall-search">
                            <form name="searchTop" class="mallSearch-form clearfix">
                                <fieldset>
                                    <legend>天猫搜索</legend>
                                    <div class="mallSearch-input clearfix">
                                        <div class="s-combobox" id="s-combobox-685">
                                            <div class="s-combobox-input-wrap">
                                                <input v-model="keyword" type="text" autocomplete="off" value="dd" id="mq"
                                                       class="s-combobox-input" aria-haspopup="true">
                                            </div>
                                        </div>
                                        <button type="submit" @click.prevent="searchKey" id="searchbtn">搜索</button>
                                    </div>
                                </fieldset>
                            </form>
                            <ul class="relKeyTop">
                                <li><a>狂神说Java</a></li>
                                <li><a>狂神说前端</a></li>
                                <li><a>狂神说Linux</a></li>
                                <li><a>狂神说大数据</a></li>
                                <li><a>狂神聊理财</a></li>
                            </ul>
                        </div>
                    </div>
                </div>
            </div>
        </div>

        <!-- 商品详情页面 -->
        <div id="content">
            <div class="main">
                <!-- 品牌分类 -->
                <form class="navAttrsForm">
                    <div class="attrs j_NavAttrs" style="display:block">
                        <div class="brandAttr j_nav_brand">
                            <div class="j_Brand attr">
                                <div class="attrKey">
                                    品牌
                                </div>
                                <div class="attrValues">
                                    <ul class="av-collapse row-2">
                                        <li><a href="#"> 狂神说 </a></li>
                                        <li><a href="#"> Java </a></li>
                                    </ul>
                                </div>
                            </div>
                        </div>
                    </div>
                </form>

                <!-- 排序规则 -->
                <div class="filter clearfix">
                    <a class="fSort fSort-cur">综合<i class="f-ico-arrow-d"></i></a>
                    <a class="fSort">人气<i class="f-ico-arrow-d"></i></a>
                    <a class="fSort">新品<i class="f-ico-arrow-d"></i></a>
                    <a class="fSort">销量<i class="f-ico-arrow-d"></i></a>
                    <a class="fSort">价格<i class="f-ico-triangle-mt"></i><i class="f-ico-triangle-mb"></i></a>
                </div>

                <!-- 商品详情 -->
                <div class="view grid-nosku">

                    <div class="product" v-for="result in results">
                        <div class="product-iWrap">
                            <!--商品封面-->
                            <div class="productImg-wrap">
                                <a class="productImg">
                                    <img :src="result.imgUrl">
                                </a>
                            </div>
                            <!--价格-->
                            <p class="productPrice">
                                <em>{{result.price}}</em>
                            </p>
                            <!--标题-->
                            <p class="productTitle">
                                <a v-html="result.title"> </a>
                            </p>
                            <!-- 店铺名 -->
                            <div class="productShop">
                                <span>店铺: 狂神说Java </span>
                            </div>
                            <!-- 成交信息 -->
                            <p class="productStatus">
                                <span>月成交<em>999笔</em></span>
                                <span>评价 <a>3</a></span>
                            </p>
                        </div>
                    </div>
                </div>
            </div>
        </div>
    </div>
</div>
<script th:src="@{/js/axios.min.js}"></script>
<script th:src="@{/js/vue.min.js}"></script>
<script>
    new Vue({
        el: '#app',
        data:{
            keyword: '',
            results:[]
        },
        methods:{
            searchKey(){
                let keyword=this.keyword;
                console.log(keyword);
                ///search/{keyword}/{pageNum}/{pageSize}
                axios.get('search/'+keyword+"/1/20").then(response=>{
                    console.log(response);
                    this.results=response.data;
                });
            }
        }

    })
</script>

</body>
</html>
7.6、设置路由
@Controller
public class IndexController {

    @RequestMapping("/")
    public String index() {
        return "index.html";
    }
}
@RestController
public class ContentController {

    @Autowired
    private ContentService contentService;

    @GetMapping("/parse/{keyword}")
    public Boolean parse(@PathVariable("keyword") String keyword) throws IOException {
        return contentService.parseContent(keyword);
    }

    @GetMapping("/search/{keywords}/{pageNo}/{pageSize}")
    public List<Map<String, Object>> search(@PathVariable("keywords") String keywords, @PathVariable("pageNo") int pageNo, @PathVariable("pageSize") int pageSize) throws IOException {
        return contentService.searchPageForHighlight(keywords, pageNo, pageSize);
    }
}
7.7、设置常量
public class CommonConstant {
    public static final String INDEX = "test_jd_goods";
}
7.8、业务
/**
 * 业务编写
 */
@Service
public class ContentService {

    @Autowired
    private RestHighLevelClient restHighLevelClient;

    // 1. 解析数据放入到es索引当中
    public Boolean parseContent(String keywords) throws IOException {
        List<Content> contents = new HtmlParseUtl().parseJD(keywords);
        BulkRequest bulkRequest = new BulkRequest();
        bulkRequest.timeout("2m");

        for (int i = 0; i < contents.size(); i++) {
            bulkRequest.add(
                    new IndexRequest(CommonConstant.INDEX)
                            .source(JSON.toJSONString(contents.get(i)), XContentType.JSON));
        }

        BulkResponse bulk = restHighLevelClient.bulk(bulkRequest, RequestOptions.DEFAULT);
        return !bulk.hasFailures();
    }

    // 2. 查询这些数据实现搜索功能
    public List<Map<String, Object>> searchPage(String keywords, int pageNo, int pageSize) throws IOException {
        if (pageNo <= 1) {
            pageNo = 1;
        }
        // 条件搜索
        SearchRequest searchRequest = new SearchRequest(CommonConstant.INDEX);
        SearchSourceBuilder sourceBuilder = new SearchSourceBuilder();
        // 分页
        sourceBuilder.from(pageNo);
        sourceBuilder.size(pageSize);
        // 精准匹配
        TermQueryBuilder termQueryBuilder = QueryBuilders.termQuery("title", keywords);
        sourceBuilder.query(termQueryBuilder);
        sourceBuilder.timeout(new TimeValue(60, TimeUnit.SECONDS));
        // 执行搜索
        searchRequest.source(sourceBuilder);
        SearchResponse searchResponse = restHighLevelClient.search(searchRequest, RequestOptions.DEFAULT);
        // 解析结果
        List<Map<String, Object>> list = new ArrayList<>();
        for (SearchHit documentField : searchResponse.getHits().getHits()) {
            list.add(documentField.getSourceAsMap());
        }
        return list;
    }

    // 2. 查询这些数据实现搜索功能
    public List<Map<String, Object>> searchPageForHighlight(String keywords, int pageNo, int pageSize) throws IOException {
        if (pageNo <= 1) {
            pageNo = 1;
        }
        // 条件搜索
        SearchRequest searchRequest = new SearchRequest(CommonConstant.INDEX);
        SearchSourceBuilder sourceBuilder = new SearchSourceBuilder();
        // 分页
        sourceBuilder.from(pageNo);
        sourceBuilder.size(pageSize);
        // 精准匹配
        TermQueryBuilder termQueryBuilder = QueryBuilders.termQuery("title", keywords);
        sourceBuilder.query(termQueryBuilder);
        sourceBuilder.timeout(new TimeValue(60, TimeUnit.SECONDS));
        // 高亮
        HighlightBuilder highlightBuilder = new HighlightBuilder();
        highlightBuilder.field("title");
        highlightBuilder.requireFieldMatch(false);   // 多个高亮显示!
        highlightBuilder.preTags("<span style='color:red'>");
        highlightBuilder.postTags("</span>");
        sourceBuilder.highlighter(highlightBuilder);

        // 执行搜索
        searchRequest.source(sourceBuilder);
        SearchResponse searchResponse = restHighLevelClient.search(searchRequest, RequestOptions.DEFAULT);
        // 解析结果
        List<Map<String, Object>> list = new ArrayList<>();
        for (SearchHit documentField : searchResponse.getHits().getHits()) {
            Map<String, HighlightField> highlightFields = documentField.getHighlightFields();
            HighlightField title = highlightFields.get("title");
            Map<String, Object> sourceAsMap = documentField.getSourceAsMap();   // 原来的结果
            // 解析高亮的字段, 将原来的字段换为我们高亮的字段即可!
            if (title != null) {
                Text[] fragments = title.fragments();
                String n_title = "";
                for (Text text : fragments) {
                    n_title += text;
                }
                sourceAsMap.put("title", n_title);
            }
            list.add(sourceAsMap);
        }
        return list;
    }
}
实战提示:这里用的是
TermQueryBuilder(精确匹配),而京东标题是text且中文需要分词,建议改成QueryBuilders.matchQuery("title", keywords)才能真正搜到。这正是 5.7 中强调的term/match区别。
7.9、爬数据
访问:
127.0.0.1:9090/parse/java
7.10、查看es
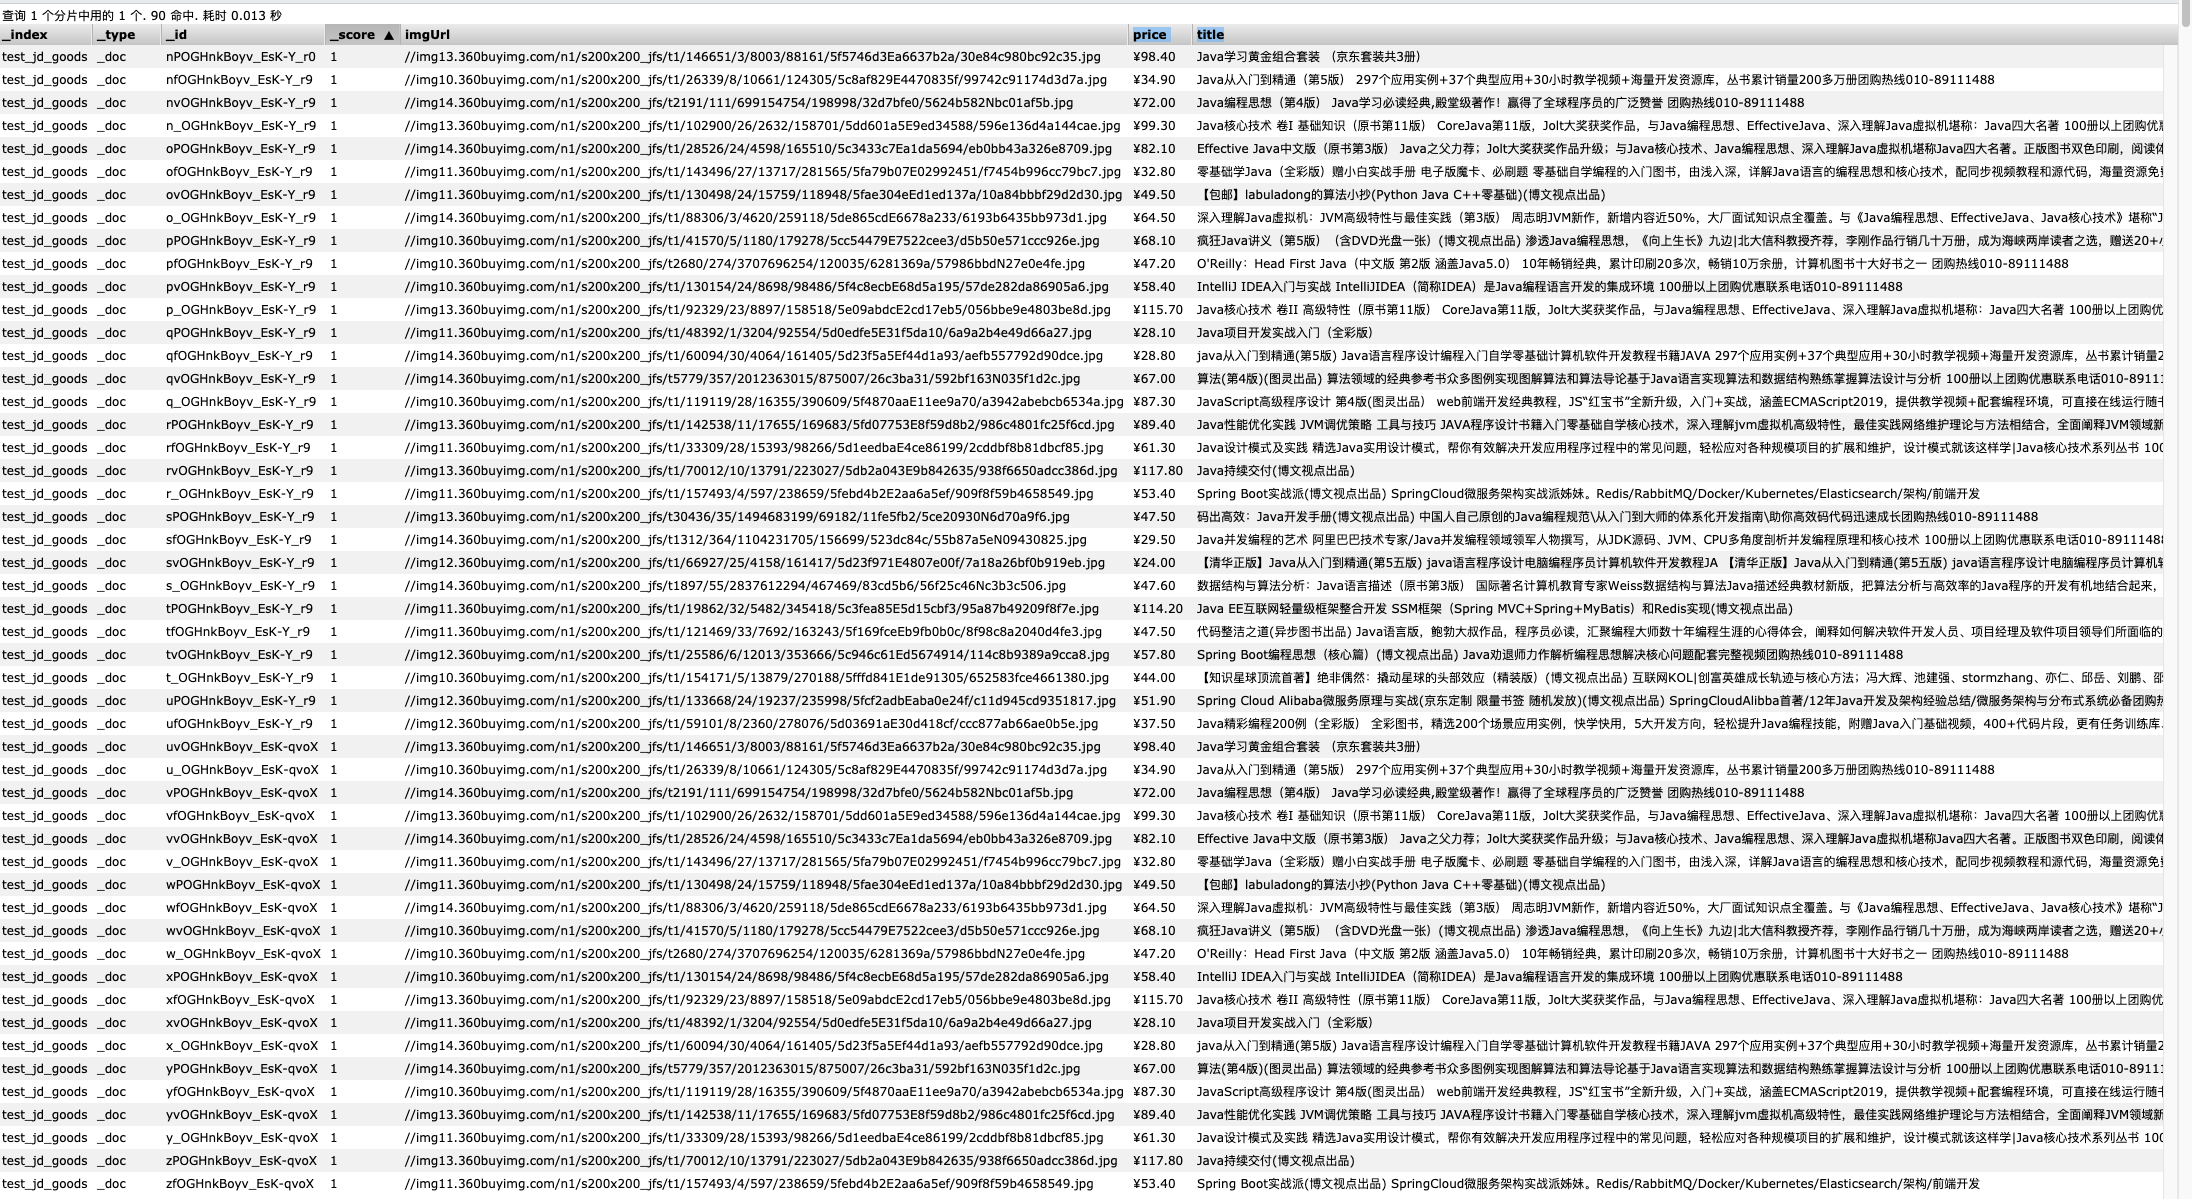
7.11、访问首页
成功搜索
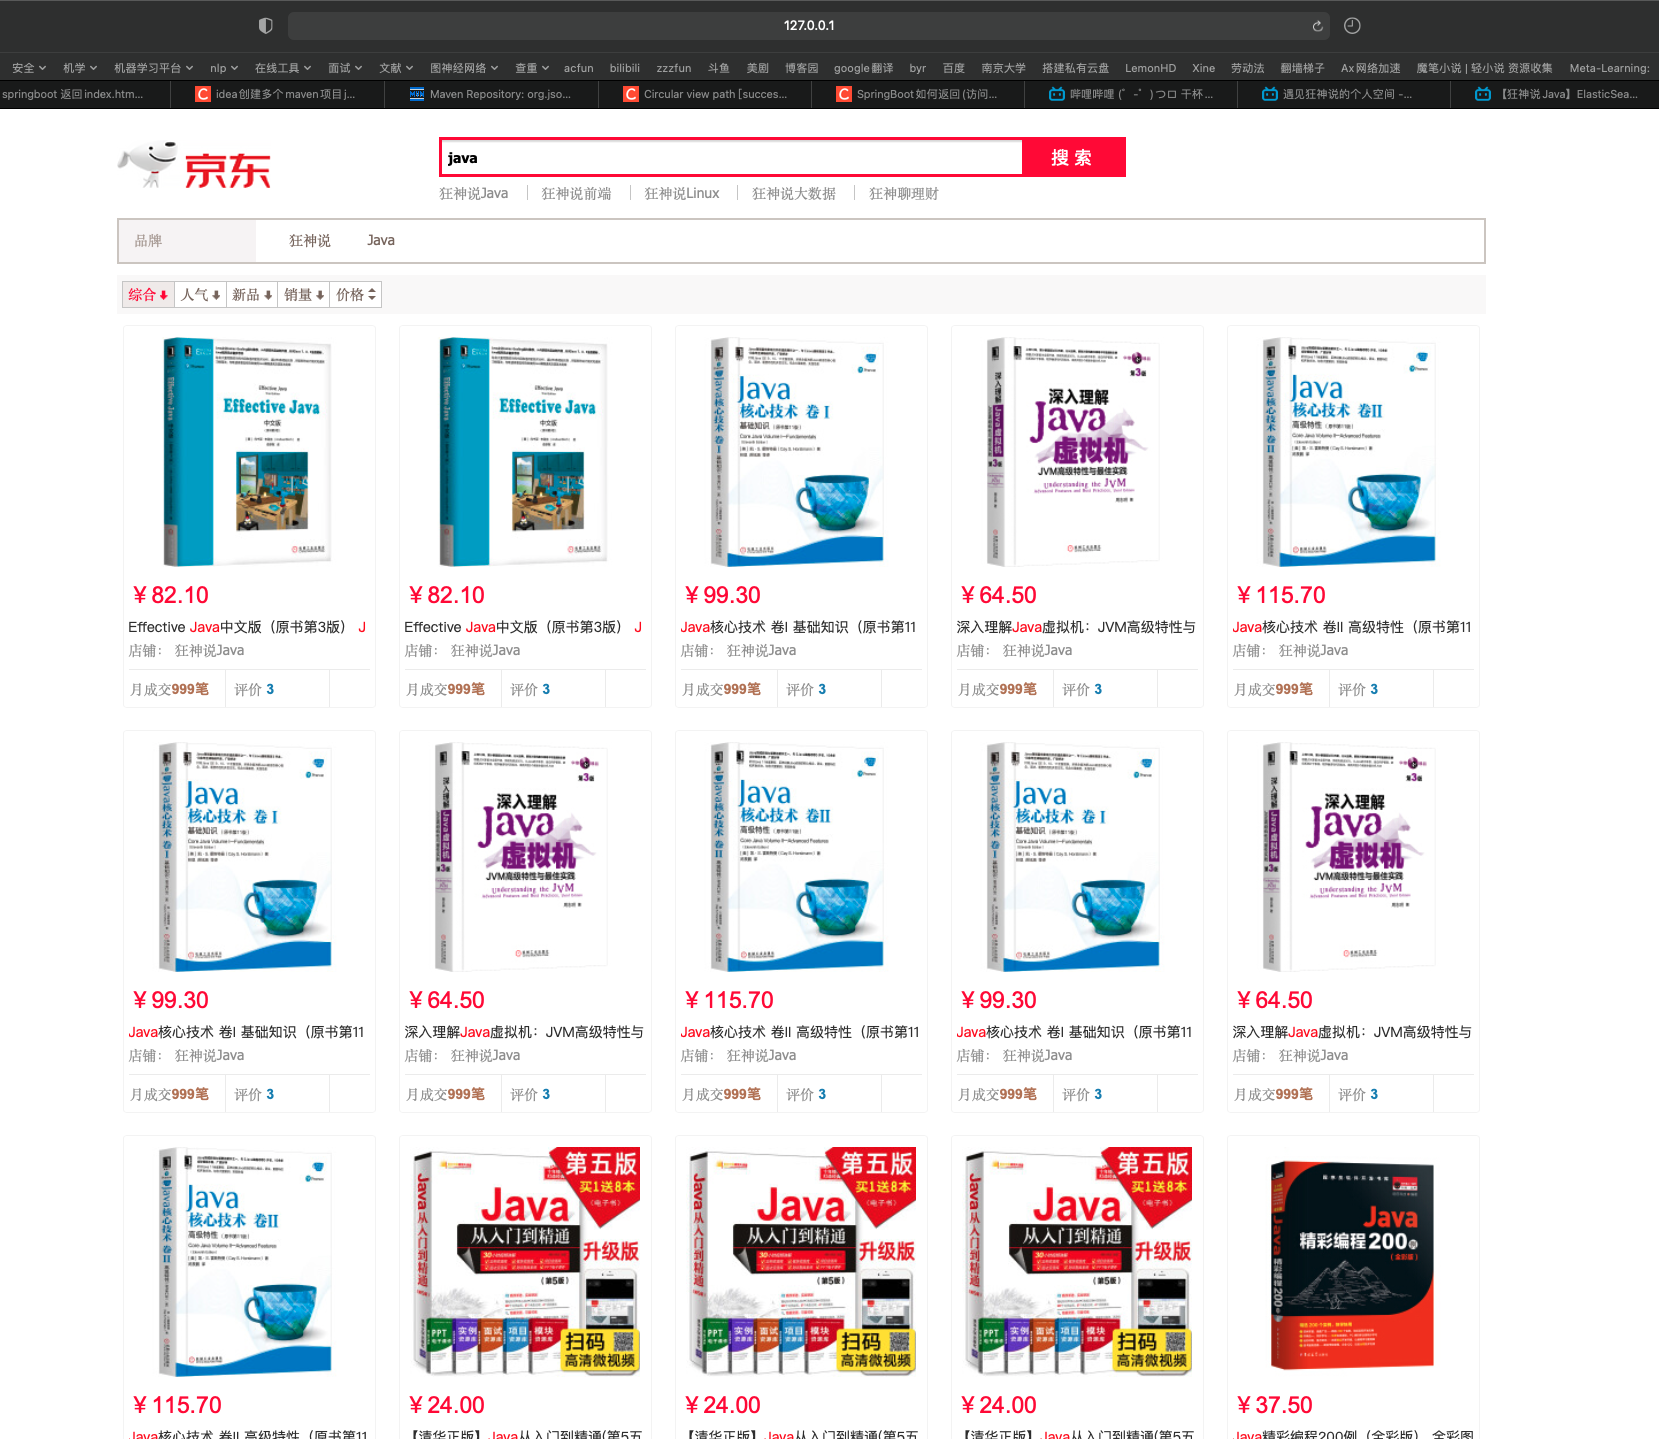
8、小结与进阶
- ES 的本质是「分布式 + 倒排索引 + 近实时」,理解倒排索引与 mapping 是入门一半;
- 中文场景一定上 ik 分词器,索引用
ik_max_word、搜索用ik_smart; - 查询优先用
bool.filter+term/range,全文检索才用match,分页避免深翻(用search_after); - 改 mapping 的标准姿势:
reindex+ 别名切换,实现零停机; - Java 整合:7.x 用
RestHighLevelClient/ Spring Data Repository,8.x 迁移到新的 Java API Client; - 生产务必关注:集群健康(yellow/red)、分片大小(单分片建议 10–50GB)、堆内存(不超过物理内存 50% 且 < 32GB)、避免用
*误删索引。
下一步可深入:聚合分析(date_histogram、bucket 嵌套)、拼音/简繁体搜索、ELK 日志管道、冷热架构与索引生命周期管理(ILM)。

 浙公网安备 33010602011771号