
随手记:一摞验收照片交给 bl vision describe,六行清单三秒一张,坑有三个先说
最近帮店里整理货架照片,有无主体、姿态、材质、背景、有无文字,一格一格填表填到烦。照片是同一组问题,答案却要人肉搬,搬到后面自己都不信自己。
后来把这组问题写成清单文本,交给阿里云百炼命令行里的 bl vision describe:一张照片一条命令,三四秒回六行"字段: 值"。三张自产货架照实测三点八、三点二、三点九秒,行序稳稳的,拼进表格就是记录雏形。批量没有现成参数,一个 for 循环走完一摞,六行块追加同一个文件,完事。
bl vision describe --image shelfA.png --prompt "逐行回答,每行格式为「字段: 值」,只输出六行:主体: 有无橘色狐狸玩偶;姿态: 直立坐姿/四足站姿/无;白色腹部: 有/无;货架材质: ;背景物体: ;画面文字: 有/无"
坑有三个,都是跑出来才知道的。第一个,空货架那张否定答案把行格式写塌了:模型把选项串回显进值里,"主体: 有无橘色狐狸玩偶: 无",语义还在但切分会拿到脏值,解析得兜底取末段。第二个,侧身那张被报"白色腹部: 有",放大看躯干全橘、只有颈部一点浅色,二选一字段也拦不住它把相近特征算成有,所以表里要留人工复核位,误报格标出来别删。第三个,不传提问时它默认回英文散文,中文清单必须显式传 prompt,第一版我就是这么拿到两段英文的。
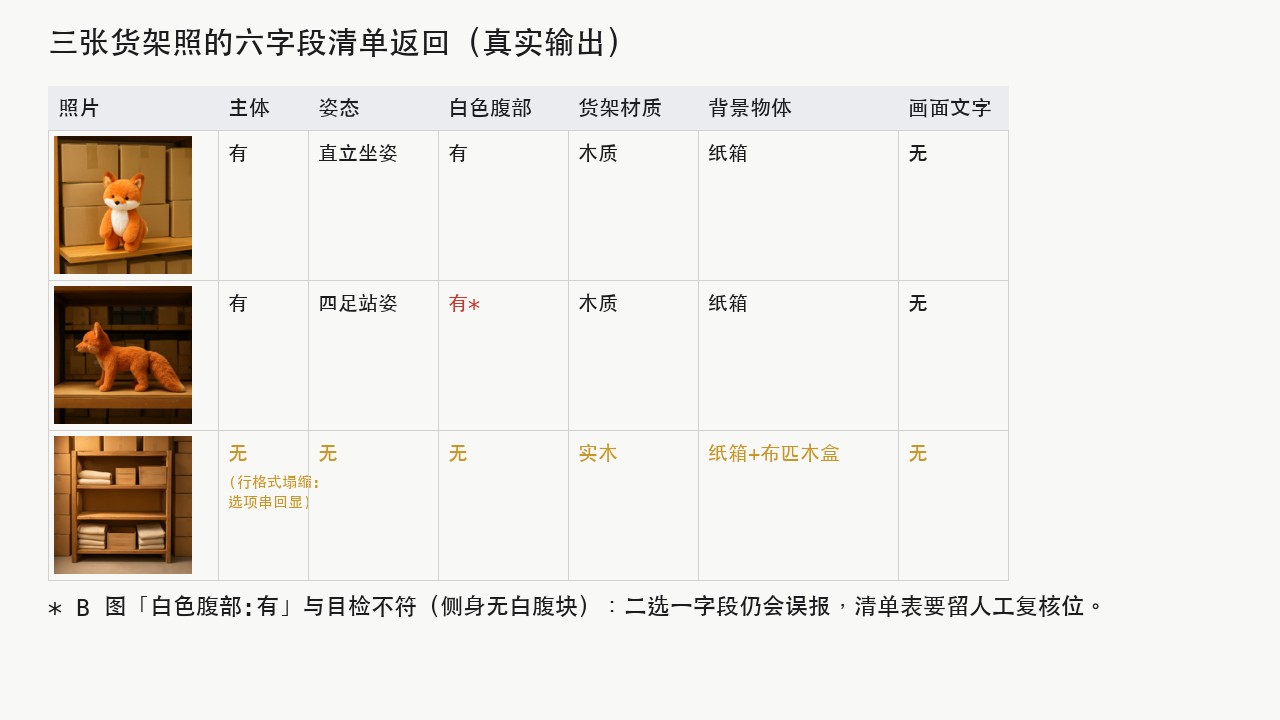
也有惊喜。跨照片核对时,正面照报"直立坐姿"、侧身照报"四足站姿",摆放状态不一致当场跳出来,验收规则直接消费这个差异。视频也能进:--video 传本地 mp4 不用先上传,五秒片七点一秒回三行,动作按时间轴拆成四段,连右下角"AI 生成"角标都认得出来,合规标注核验以后可以写成清单字段。
视频那段也记一下逐字返回:主体一行写完眼镜卫衣白尖尾,动作一行把零点二到四秒拆成四段,角标一行说右下角始终显示白色文字 AI 生成。七秒换一份带时间轴的验收记录,比人盯着看五秒片再补记录靠谱。
循环里我给自己定了两条纪律:退出码 2 和 1 分两个队列重跑,别混;单张耗时记下来(三点八、三点二、三点九秒),整摞排期按张数乘四秒留一倍余量。还有 worked row 的摆法:六值进数据列,退出码/耗时/复核标记三列跟着,原始六行块逐字存档在行旁边,以后扯皮先翻存档不重跑。
出错也分层:路径不存在和扩展名不对都是退出码 2(后者会提示支持的格式),模型名写错是退出码 1 回 404 带 Request ID。批量脚本按码分流就行,不用读报错散文。
感受是:这活的价值不在"AI 会看图",在字段由业务定、返回能进表、错误能分流。门店验收、盘点、上架、归档都适用;要毫米级测量或证件鉴真的别找它,它是语义核验不是计量器具。字段也别贪多,十个以内稳,宽表拆两次问。
有人问为什么不用 OCR 或相册识别:OCR 抽的是文字,我的字段大半是"有没有/什么姿态"这类语义;相册标签是平台定死的类别,业务字段对不上。字段能自定义,是这条命令唯一但决定性的差异。
附:本包实测读数清单(2026-10-30,bl 2.5.0,默认模型 qwen3-vl-plus):单图清单问 3.8 / 3.2 / 3.9 秒;视频五秒片 7.1 秒;开放问回中文散文、默认问回英文散文、清单问回六行;否定答案塌缩 1 例(空货架行)、二选一误报 1 例(侧身照白色腹部);错误探针 exit 2 File not found、exit 2 Unsupported image format ".mp3"、exit 1 HTTP 404 带 Request ID;ground truth 先目检登记三张;有效调用 6 次、失败探针 3 次。
不适合的也记一笔:要毫米级测量、证件鉴真的别找它;字段贪多到十几个就开始飘,拆两次问;误报零容忍又没复核位的流程不适合直接上。
跑完别删原始六行块和 ground truth 那三行登记,争议来了先翻存档;以后加字段就升 schema 版本重跑登记,旧行留着旧标签,别在同一列里混形状。
退出码 2 和 1 我也分两个队列重跑,混在一起日志会搅成一团;单张耗时记着,整摞排期心里有数。
入口照旧:CLI 安装页装命令行,控制台密钥管理页领 Key。先拿三张照片定你的六字段清单,跑通再上整摞,第一份六行返回出来的时候你就知道这张表值不值得交给它。

 浙公网安备 33010602011771号