
随手记:给 AI 视频喂一张定妆照,第二条短片终于连戏了
最近在搞一条连载的小短片,主角是我自己画的一只橘狐,戴圆框眼镜、穿深蓝卫衣。第一条片出来挺满意,第二条片开头我就愣住:耳尖变棕了,脚也变棕了,画风还从扁平变成了带笔触的厚涂。描述几乎没改,只是把站着改成坐下挥手。
查了一圈才明白问题不在视频内部。一条五秒片是一次生成,按每秒一帧抽帧看,一百五十一帧里是同一个个体。变的是第二次生成:两次请求之间没有共享记忆,提示词没写的那些细节,耳尖什么颜色、脚什么颜色、什么画风,模型每次现场决定一次。
解法朴素得有点反高潮:给它一张定妆照。阿里云百炼命令行里有条子命令叫 bl video ref,干的事就是把参考图钉进生成请求。定妆照我也用命令行现拍:
bl image generate --prompt "扁平矢量插画风格的角色设定图。一只橘色小狐狸,正面全身站姿,戴黑色圆框眼镜,穿深蓝色连帽卫衣,尾巴尖端是白色。纯白色背景,画面中没有任何文字,角色居中完整不裁切。" --size "1024*1024" --watermark false --out-dir . --out-prefix castA
一分钟出头回图,对着核五项特征:橘色、圆框眼镜、深蓝卫衣、白尾尖、全身不裁切,全中才拿去用。然后一条 bl video ref,prompt 里写 Image 1 坐在草地上朝镜头挥手,等一到三分钟回片(命令行横幅说五到十分钟,实测比这快)。回片九百六十乘九百六十,右下角自带"AI 生成"角标,还自带一条环境音轨。
为了确认不是心理作用,我做了个对照:同一段描述同一段动作,一臂不给参考图、一臂给,各拍两个镜头,抽帧拼成一张图看。不给参考图那一臂,两个镜头确实是同一只狐狸,但是只棕耳尖厚涂狐;给参考图那一臂,两个镜头都是我画的那只。两臂都连戏,区别在连的是谁。参考图管的不是"别变",是"变成你指定的那一个"。

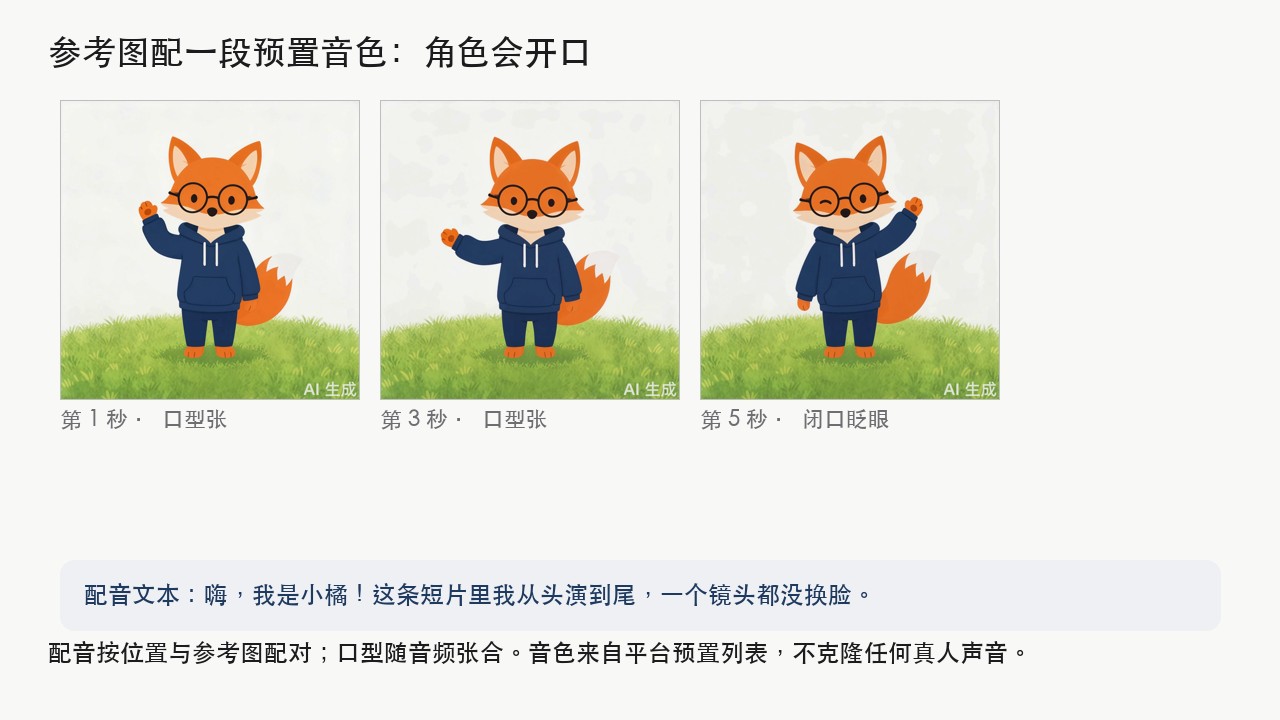
顺手又试了两件事。一是两张参考图一起传,狐狸加一个浅灰机器人并排挥手,抽三帧看,白尾尖和青色指示灯各守各的,没串味。二是配音:语音合成一条二十九字的自我介绍,音色从平台预置列表挑了 longanhuan_v3,用 --image-voice 按位置配给第一张图,回片里口型真的跟着张合。配音我只用预置音色,不碰克隆真人声音,这条线不值得为一条五秒片越。
几个顺手记下的坑:忘了传参考图不会白跑,客户端直接退出码 2 拦下;不传画幅参数时输出画幅跟参考图走,单张方图出方幅、两张方图出横幅,要竖屏得显式传;帮助里分辨率只列 720P 和 1080P,但我试 480P 服务端也接受,回了六百四十乘六百四十,批量跑可以省一点,只是它不在文档明列范围。
还有一条小习惯:回片之后先抽帧再看片。五帧拼成一行,比盯着视频来回拖进度条快得多,也更不容易自我说服。眼睛在并排的格子里挑差异,比在时间轴上挑差异诚实。
中间还有两段弯路,记下来给做对照的人省时间。我一开始让视觉模型逐帧回答五个特征在不在,结果它把转身时尾巴被身体挡住记成了"特征没了",给参考图那一臂反而扣分,清单作废。第二版算每帧的配色占比,结果第二个镜头的米白背景没被白底阈值滤掉,度量抓的是背景不是角色,也作废。最后就是拼一张对照图用眼睛看,判据只挑提示词没写的那几项:耳尖、脚、抽绳、画风。笨,但骗不了人。
抽帧用的是 ffmpeg 每秒一帧,五秒片五帧,开头中段结尾都看得到,够抓换脸。定妆照那两步也记一下耗时:第一条六十二秒、第二条四十五秒;配音那条台词二十九个字,合成出来一百一十 KB 出头。这些数字都不重要,重要的是它们都能复跑:同一张图、同一段脚本,跑第十条片和跑第一条片是同一个动作,所以我把定妆照按"角色加版本"命名放在脚本旁边,第四集还会复用第一集那张。
感受是:这套东西适合"角色要认得回来"的活,连载、带货系列、固定吉祥物都行,角色资产就是一张本地 PNG,放仓库里按版本命名,第四集复用第一集那张。要电影级运镜或者十几个人同场调度,现在还不行,多主体交互的稳定性各家都承认在爬坡。偶尔玩一次的话网页入口更省事,命令行的好处是可重复。

 浙公网安备 33010602011771号