
每次开新对话都要重新自我介绍,这件事我终于不用忍了
每次打开一个新的对话窗口,我都要把同一段话再打一遍:我是谁、我在做什么、我女儿叫什么、上次聊到哪了。
打到第三遍的时候我开始怀疑,昨天聊了两小时的那些上下文,对它来说是不是等于没发生过。
后来我才知道这件事有个专门的命令组:bl memory。它干的事很直白,把你想让它记住的话存下来,下次开新对话的时候能搜回来。声音进去文字出来那种命令大家熟,这个是话进去、记忆出来。
这篇是我自己的使用记录,按我操作的顺序写,中间踩到的坑也一起记下来。我这边是 bl 2.1.0,macOS,标准 API Key 登录。
先把工具装好
npm install -g bailian-cli
bl auth login --api-key <你的Key>
第一步,让它记住一句话
bl memory add --user-id 我自己的编号 --content "我叫小舟,在杭州做小学语文老师,最怕写学期总结。" --output json
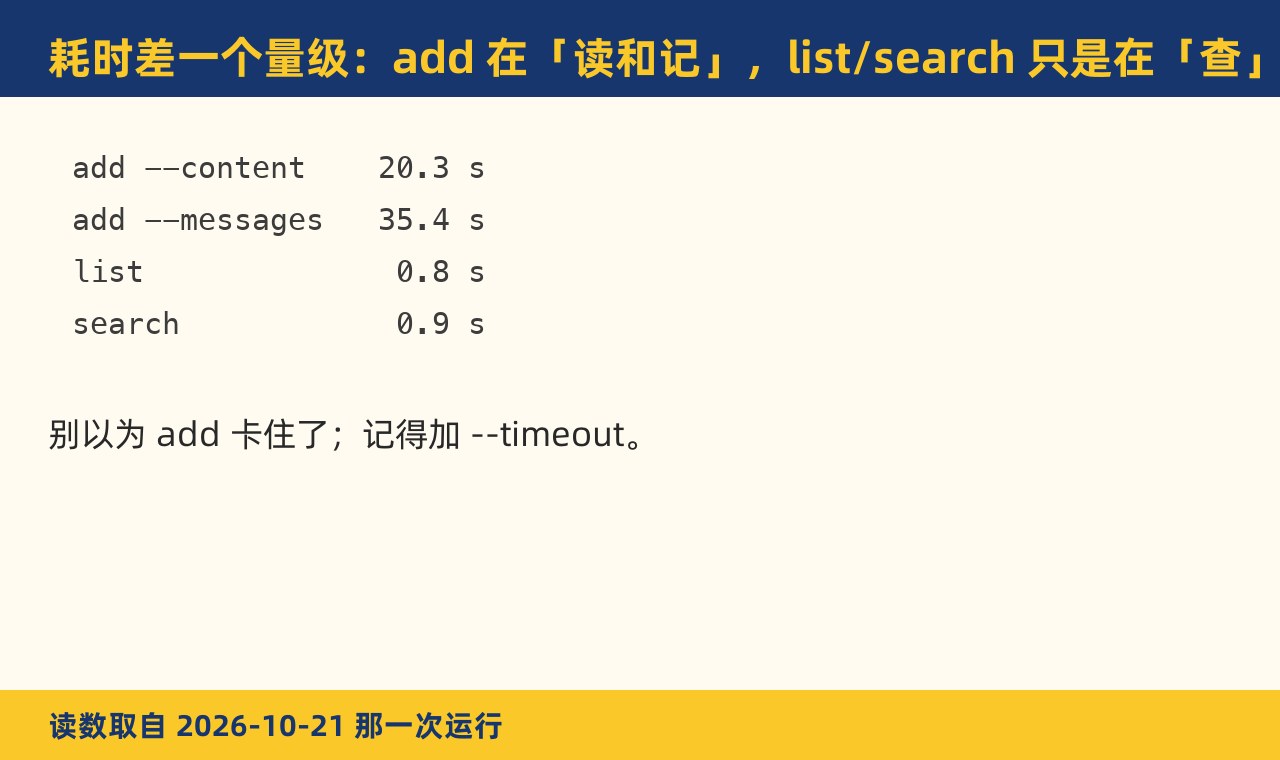
20.3 秒。注意 --user-id 是我自己起的一个编号,用来区分这是谁的记忆。我起了一个只属于这次试用的编号,跑完会把里面的记忆全删掉,不留垃圾。
第二步,喂一段对话给它记
一句话能存,一段对话也能喂。--messages 收一个 JSON 数组,里面是 role 和 content 两个键:
bl memory add --user-id 我自己的编号 --messages '[{"role":"user","content":"我女儿叫朵朵,今年六岁,最近迷恐龙。"}]' --output json
35.4 秒,比存一句话慢不少,原因后面说。
两种输入的差别在于:--content 适合你已经把想让它记的话整理成一句;--messages 适合你不想自己整理,把一段对话原样喂进去,让它自己挑重点。后者慢,就慢在多了"先读一遍再记笔记"这一步。
第三步,看它到底记了哪些
bl memory list --user-id 我自己的编号 --output json
0.8 秒。这里有个我没想到的事:它不是把我那句话原样存起来。我喂了两次,回头用 list 一看,里面是四条记忆,前三条的内容被它自己改写过了。
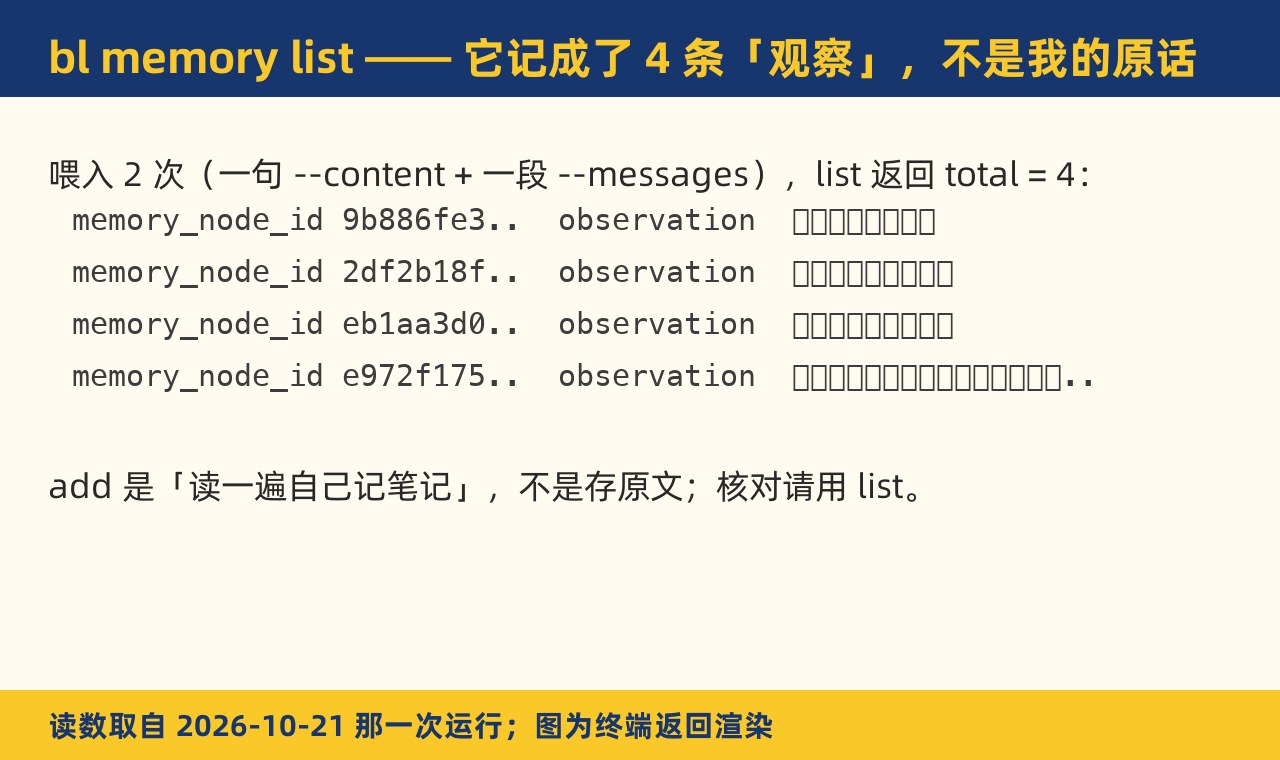
前三条是从那段对话里抽出来的观察:用户的女儿叫朵朵、用户的女儿今年六岁、用户的女儿喜欢恐龙。最后一条才是我的原话。所以 add 更像是让它读一遍然后自己记笔记,不是替我存原文。想知道它记成了什么样,得用 list 去看,不能假设原文还在。
四条的类型字段都是 observation,也就是"观察"。看到这两个字就明白它的定位了:它不是逐字记录的录音笔,是一个听你讲完、替你记笔记的同伴,笔记本上写的是它自己的话。
涉及重要信息的时候,比如名字、数字、约定,我现在的习惯是存完立刻 list 确认一遍。
返回里每条带一个 memory_node_id,一串编号,加上内容和类型。这个编号后面改和删都要用,我先抄了下来。
第四步,问它记不记得
bl memory search --user-id 我自己的编号 --query "我女儿喜欢什么" --output json
0.9 秒,返回最相关的那条,还带一个匹配分,我这次是 0.895。分数不用太当真,它只是告诉我这条最像我要找的,不是准确度。
记错了要改
bl memory update --user-id 我自己的编号 --node-id 抄到的编号 --content "女儿朵朵六岁,最近迷上的不是恐龙是奥特曼。" --output json
把抄到的编号和新的内容给它就行,改完再 list 一眼确认。
要让它忘掉,参数和别人不一样
bl memory delete --node-id 抄到的编号 --yes
这里有个坑:前面几条命令都要带 --user-id,唯独 delete 不带。它只认 --node-id,而且因为删记忆是不可逆的高风险操作,必须再加一个 --yes 表示我知道我在删什么。
我第一次照着前面的习惯加了 --user-id,命令直接报错退出,退出码 2。后来对着帮助逐行看才发现,delete 的参数表里根本没有这一项。删之前把编号核对两遍,它不会问第二遍。
顺手记两个边界:add 的时候既不给 --content 也不给 --messages,退出码 2;delete 给一个不存在的编号,也是退出码 2。报错都来得很直接,不用猜。
慢和快差着一个量级
add 是 20.3 秒和 35.4 秒,list 和 search 只要 0.8 秒、0.9 秒。因为 add 要先把我的话读一遍、抽成笔记再存,后面两个只是在查。所以别以为 add 卡住了,给它一点时间,同时记得加 --timeout。
试完删干净
我用的是一个只属于这次试用的编号,试完把里面的记忆逐条删除,四条删完再 list 一次,total 是 0,没有留下任何垃圾数据。
编号这件事,我的习惯
--user-id 我分两种用法。试跑的时候用一个一次性的编号,跑完把里面的记忆全删掉、复核 total 是 0 才算结束。正式用的时候按人或按项目分:我自己的偏好一个编号,班级写作项目一个编号,互不干扰,search 的时候指定去哪个编号的空间里搜就行。
这样分的好处是删的时候删得干净:清空一次性编号就好,不会误删真正在用的那些记忆。
我现在怎么用它
现在的流程很简单:开新对话之前,先 search 一次"这个项目上次聊到哪了",把返回的那条贴进新对话的开头,再接着聊。比重新打一遍自我介绍少打很多字,更重要的是不用怕把上次的进度说错。
和合集第一篇怎么接
合集第一篇《新手学大模型:四条命令,跑完你桌上会有四个文件》解决的是跑通,跑完桌上会有四个文件。这一篇的 memory 是接着用的:把我是谁、我在做哪个项目、我的偏好存进去,以后每次开新对话先 search 一下,就不用再打第三遍自我介绍。第一篇解决跑通,这一篇解决不用重来。
分界也说清楚:只是偶尔聊两句、不需要它记着我,那根本不用这套命令。要长期做同一个项目、要它记得我的偏好和上下文、不想每次重新交代,memory 才是省时间的那条路。
想先在网页上感受一下的,可以去百炼控制台。

 浙公网安备 33010602011771号