
找工作顺手记:20 份岗位匹配分析的批量跑法与结果统计
最近在找工作,收藏夹里攒了 20 条想投的岗位。看过的经验帖都说一份简历投所有岗位基本没戏,得一条岗位改一版,还说别海投,一周精选十到十五个就够。
我按每条手工改 15 分钟估了一下,20 条就是 5 个小时。这个数字让我停下来了,因为我做的其实就是同一件事重复二十遍,材料换一段,套路不变。这种活应该交给脚本。
下面把整个过程记一遍,命令、读数、踩到的坑都在里面。全部是 10 月 19 号我在自己电脑上跑出来的,环境是 bl 2.1.0、macOS、标准 API Key 登录。
准备素材
素材是最花时间的一步,而且跟技术无关。简历存成 resume.txt,518 字;20 条招聘信息各存一个 txt,放在 jd/ 目录下,单条 90 到 152 字。我是从收藏夹里一条条复制粘贴的,20 条大概花了 8 分钟。
工具和密钥配一次就行:
npm install -g bailian-cli
有个前提要先确认:bl text chat 没有文件输入的参数,只有 --message 和 --messages-file。所以 PDF 简历不能直接喂,得先转成文本。
第一晚:想省事,一次塞 20 条
我的第一反应是最省事的那个办法。既然 --messages-file - 能从标准输入收材料,那就把 20 条招聘信息拼进同一个消息里,让它一次给我 20 份分析。
python3 mk_all.py | bl text chat --messages-file - --model qwen3.8-flash --output json > shortlist.json
80.8 秒回来了,20 行,一行一条,格式是"编号 | 匹配度(高/中/低) | 最该突出的一条"。读数是 prompt_tokens 2135、completion_tokens 6195,其中思考占了 5684。匹配度分布:高 1 条(第 14 条)、中 9 条、低 10 条。

这一步不算白跑,它给了我一张短名单,哪 10 条可以直接放弃、哪 1 条值得花最多时间,一眼就看见了。但每行就一句话,没有"对上了招聘要求里的哪一句",没有缺口,也没有能直接用的自我介绍。拿它改简历不够。
第二天:5 行循环逐条跑
于是改成两段:先粗筛收窄,再对留下的逐条跑。
拼材料的脚本 mk.py,从参数读两份 txt,往标准输出写消息数组:
import json, sys, pathlib
resume = pathlib.Path(sys.argv[1]).read_text(encoding='utf-8')
jd = pathlib.Path(sys.argv[2]).read_text(encoding='utf-8')
ask = """下面是我的简历和一条招聘信息。按这个格式输出,不要加别的话,每项不超过两行:
【匹配】三条,每条写清对上了招聘要求里的哪一句
【缺口】最多三条,招聘要求里简历没覆盖的
【该突出】投这条岗位时应该往前放的两条经历
【一句话】一句可以直接用的自我介绍"""
print(json.dumps([
  {"role": "system", "content": "你是帮求职者做岗位匹配分析的助手。只看材料里写了什么,不替材料编造经历。"},
  {"role": "user", "content": ask + "\n\n=== 简历 ===\n" + resume + "\n=== 招聘信息 ===\n" + jd}
], ensure_ascii=False))
循环 batch.sh,真的就 5 行有效代码:
mkdir -p out log
for f in jd/*.txt; do
  n=$(basename "$f" .txt)
  python3 mk.py resume.txt "$f" | bl text chat --messages-file - --model qwen3.8-flash --output json > "out/$n.json"
done
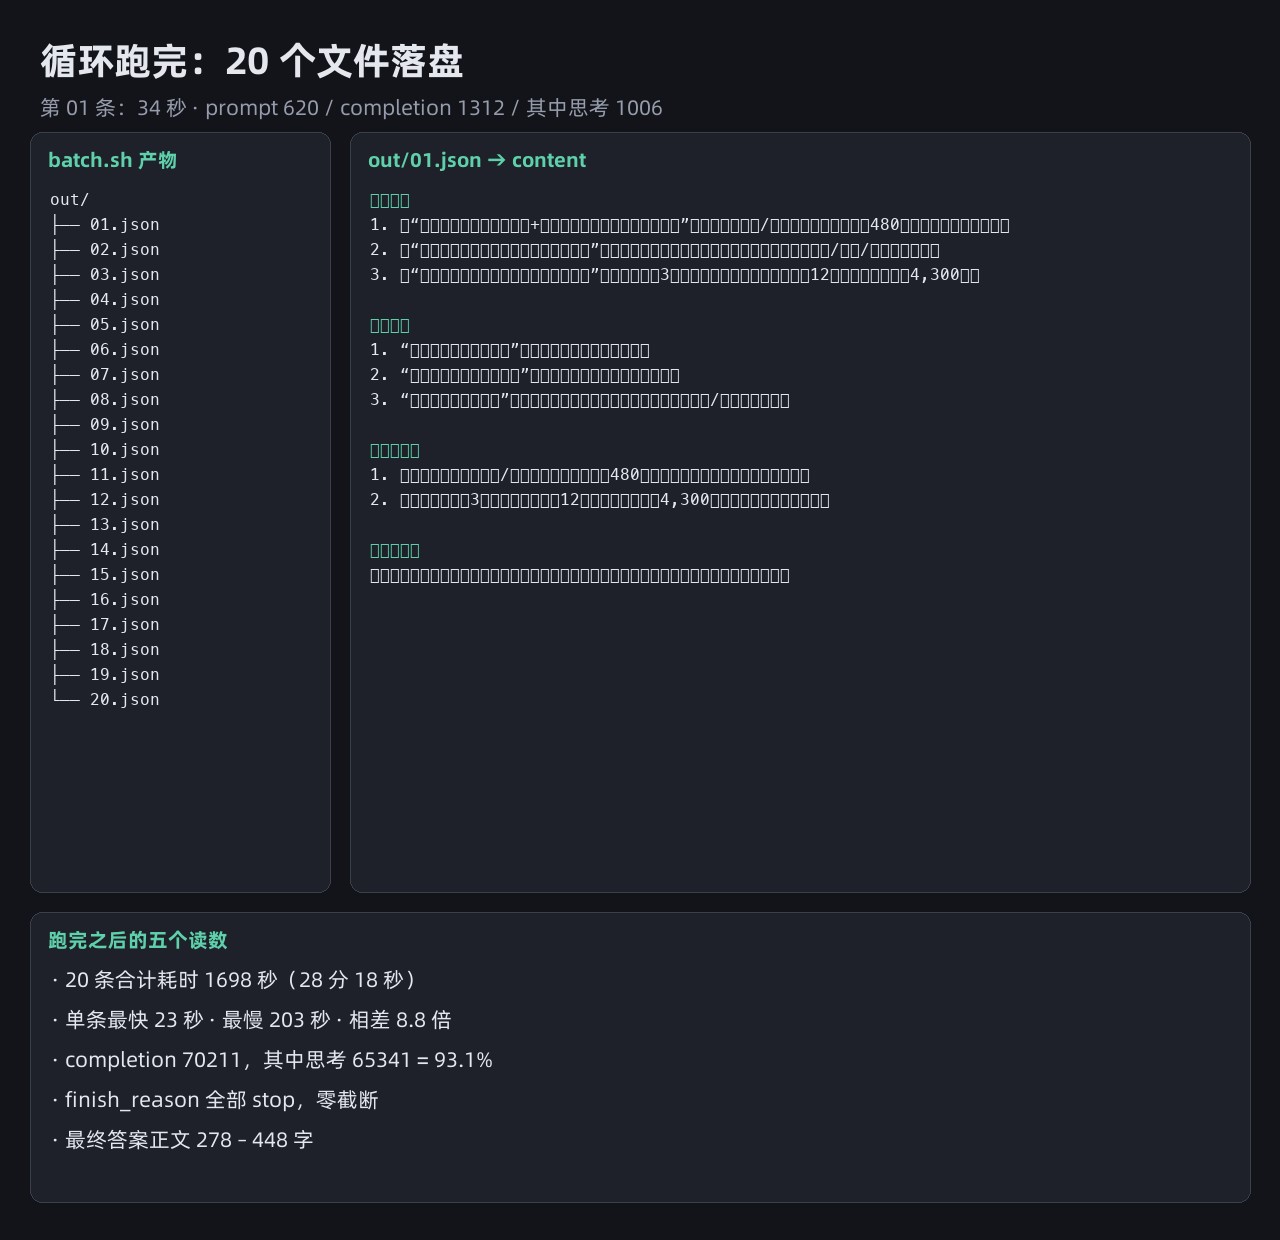
跑完 out/ 里躺着 20 个 json,20 条全部 exit 0,finish_reason 全部是 stop,没有一条被截断。第 01 条那份的【匹配】段长这样,它写的是招聘要求里的原话:
【匹配】
- 2021.09 至 2023.06 新媒体编辑、2023.07 至今内容运营,累计超过 2 年内容经验——对上了"要求:2 年以上内容或电商运营经验"
- 负责公众号与视频号双阵地,日更 2 条图文,参与短视频脚本撰写累计出片 60 余条——对上了"负责店铺内容矩阵(图文+短视频脚本)的日常产出与排期"
- 会用 Excel 数据透视表,且用表格自建内容数据看板、每周输出复盘——对上了"会用 Excel 做基础数据分析"
我喜欢这个写法,因为能拿去核对。它是从材料里找的,还是自己编的,对着简历一眼看得出。
顺手做的几件事
跑完 20 条我还有几个疑问,就顺手又试了三个参数。
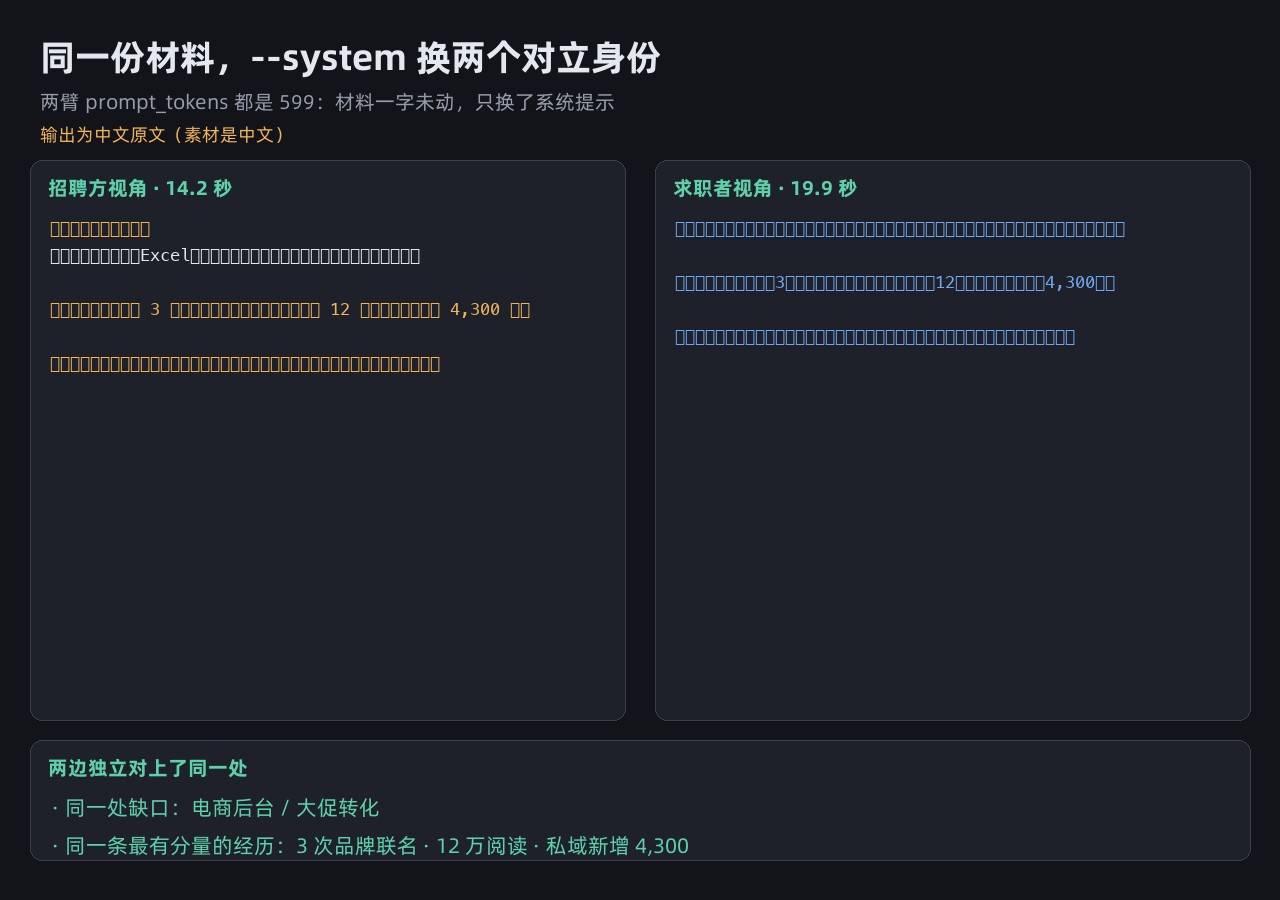
一个是 --system。它可以单独设定模型身份,材料一个字不动。我用同一份简历、同一条招聘信息跑了两个相反的视角,一个扮招聘负责人筛我,一个扮我自己决定投不投。招聘方视角 14.2 秒,读数是 599 / 736 / 643;求职者视角 19.9 秒,599 / 713 / 620。两边 prompt_tokens 都是 599,说明材料确实没动。
让我意外的是,两个对着干的视角各自独立指出了同一处缺口(电商后台、大促转化),也各自挑出了同一条最有分量的经历(3 次品牌联名、单次最高阅读 12 万、私域新增 4,300)。两边对上了,说明这不是某一边的偏见。
一个是 --message 的 role: 前缀。它可以重复出现,还能指定这句话是谁说的,所以能把上一轮对话手工拼进这次请求。我拿它模拟了一次追问,问的是"涨粉最多的那一个月发生了什么",而这个数据我简历里根本没写。13.8 秒回来的答案开头是"峰值月份我没记准",然后接回了材料里真有的数字。系统提示里那句"不替材料编造经历"是真起了作用的。
还有一个是换模型。粗筛把 20 条压成 1 条"高"加 9 条"中",这 10 条我用轻量模型逐条跑完,再从里面挑了第 01 条换成 qwen3.8-max 重跑:
python3 mk.py resume.txt jd/01.txt | bl text chat --messages-file - --model qwen3.8-max --output json > out/01-refined.json
108.0 秒,prompt_tokens 621、completion_tokens 4051(思考占 3807),比轻量模型多给了一节【追问预演】。分工就是这么定的:20 条全用强模型等待时间会翻好几倍,而其中 10 条压根不值得精修。
最后一步跟求职没关系,纯粹是我自己想要。把面试题合成成音频,走路的时候听:
bl speech synthesize --text-file questions.txt --model cosyvoice-v3-flash --voice longcheng_v3 --format mp3 --out interview.mp3
3.9 秒出来一个 mp3,257 KB,时长 12.86 秒。听比看更有压力,看文字的时候你会不自觉地在脑子里打草稿,听的时候它是直接问你的。
跑完数了一遍,直觉是错的
结果落在文件里,就还能再处理一遍。我数了两样东西。
第一样是符号残留。网上讲这类事的帖子,第一条几乎都是"粘贴后忘了删 **"。我特地数了一遍,20 条输出里 ** 出现了 0 次,## 0 次,反引号 0 次。原因是我在提示词里把格式钉死了,用【】当小标题、写明"不要加别的话"。冒出来的是行首的 - ,48 处,贴进招聘网站的输入框会原样留下一排短横线。加一道清洗就行:
python3 -c "import json,glob,re;[open(f.replace('.json','.txt'),'w',encoding='utf-8').write(re.sub(r'^- ','',json.load(open(f,encoding='utf-8'))['choices'][0]['message']['content'],flags=re.M)) for f in sorted(glob.glob('out/*.json'))]"
第二样是缺口词频。我把 20 份结果里的【缺口】段抽出来统计,"转化"出现 4 次(第 01、02、13、15 条),"小红书" 3 次(第 02、07、16 条),"进店"和"管理"各 2 次。而我原以为最扎眼的"电商后台"和"大促",各只出现 1 次,都在第 01 条。
也就是说我读单条结果时的判断是错的。真正反复被指出来的问题是"我只会讲阅读和涨粉,不会讲到成交的转化",还有"我没做过小红书"。这两条才是该优先补的。二十份结果摊在屏幕上人是数不清的,只能统计。
命令与读数清单
| 环节 | 命令要点 | 耗时 | 读数(prompt / completion / 其中思考) |
|---|---|---|---|
| 粗筛 20 条 | --messages-file - 一次进 20 条 |
80.8 秒 | 2135 / 6195 / 5684 |
| 逐条循环 ×20 | 同上,每条一次 | 合计 1698 秒(28 分 18 秒);单条最快 23 秒、最慢 203 秒 | 合计 12058 / 70211 / 65341 |
| 视角对照 A | --system 招聘方 |
14.2 秒 | 599 / 736 / 643 |
| 视角对照 B | --system 求职者 |
19.9 秒 | 599 / 713 / 620 |
| 追问预演 | --message 重复 + role: 前缀 |
13.8 秒 | 675 / 621 / 570 |
| 强模型精修 | --model qwen3.8-max |
108.0 秒 | 621 / 4051 / 3807 |
| 语音合成 | speech synthesize --text-file |
3.9 秒 | mp3 257 KB / 12.86 秒 |
这套动线跑下来是 26 次调用(文本 25 次加语音 1 次),调提示词那会儿我另外试跑了 3 次,不算在里面。20 条最终答案的正文长度在 278 到 448 字之间。
一点感受
这套东西没有让找工作变简单。20 条岗位还是 20 条岗位,该补的经历还是得补。它省掉的是"同一件事做二十遍"里那部分纯体力的活,让我把时间花在判断上:哪些缺口是真的,哪几条岗位值得我认真写。
适合一周要投十到二十条、每条都得单独改的人,也适合材料本来就是文本形态的人。只改一份简历就别装了,网页对话框更省事。管理岗和强创意岗也不合适,这类岗位的差异化恰恰在"只有你能写出来的东西",批量分析帮不上忙。
有三件事它明确不做。不碰招聘网站,不自动投递,动线到"生成文本"就停,绕过平台反爬做自动投递有封号风险。不是离线的,材料是本地 txt,经标准输入进模型,但调用本身还是会把材料发到云端模型,简历里有身份证号、住址这类信息的先删掉再跑。不替你核实数据,每条结论都得对着简历核一遍。
文中的简历人物、20 家公司名、全部经历数字都是我编的虚构素材,用来演示动线,不指向任何真实的人或公司。你自己的简历跑出来的结果会完全不同。
参考
第一次跑别学我一上来就 20 条,先拿 3 条试试提示词合不合你的岗位类型,再放量。

 浙公网安备 33010602011771号