
随手记两条反直觉:temperature 0 不复现,stream 一开字段就没了
最近在啃大模型返回里那堆字段。第一次调用跑通之后,我对着屏幕愣了一会儿:choices、finish_reason、usage、reasoning_content,还有一串参数名 temperature、max-tokens、stream。每个字都认识,合在一起不知道哪个管什么。
网上教程大多告诉你"temperature 控制随机性,调低更稳定"。稳定到什么程度?调到 0 是不是每次答案都一样?没人给过数字。于是我拿同一个问题、同一个模型,把四个参数各做了一次对照实验,顺便把返回里那几层字段读了一遍。
工具是阿里云百炼的 CLI。CLI 就是命令行工具,不开网页,在终端敲一行字让平台干活,百炼那个叫 bl,我是在 GitHub 上翻它的仓库时看到这组参数的。模型用 qwen3.8-flash,每次都是几十 token 的小调用。读数都是 2026-10-13 我在自己电脑上敲出来的,bl 2.1.0。还没跑通第一次调用的话,先看《第一次调用大模型,卡住我的不是代码》,这篇默认你已经能拿到一段返回。
这篇只想记两条最反直觉的:temperature 0 和 stream。剩下两条当陪衬,一起写下来。
一、temperature 调到 0,三次答案还是不一样
这是我最想验的一条。同一个问题"用一句话解释什么是 token。"(token 是模型处理文本的最小单位,你输入的每句话都会先被切成一串 token),--temperature 0 连问三次:
bl text chat --model qwen3.8-flash --message "用一句话解释什么是 token。" --temperature 0 --output json
三次的开头分别是:
- "Token 是 AI 模型处理文本时的基本单位,"
- "Token 是 AI 模型处理文本时使用的最小单"
- "Token 是模型处理文本时使用的最小单位,可以"
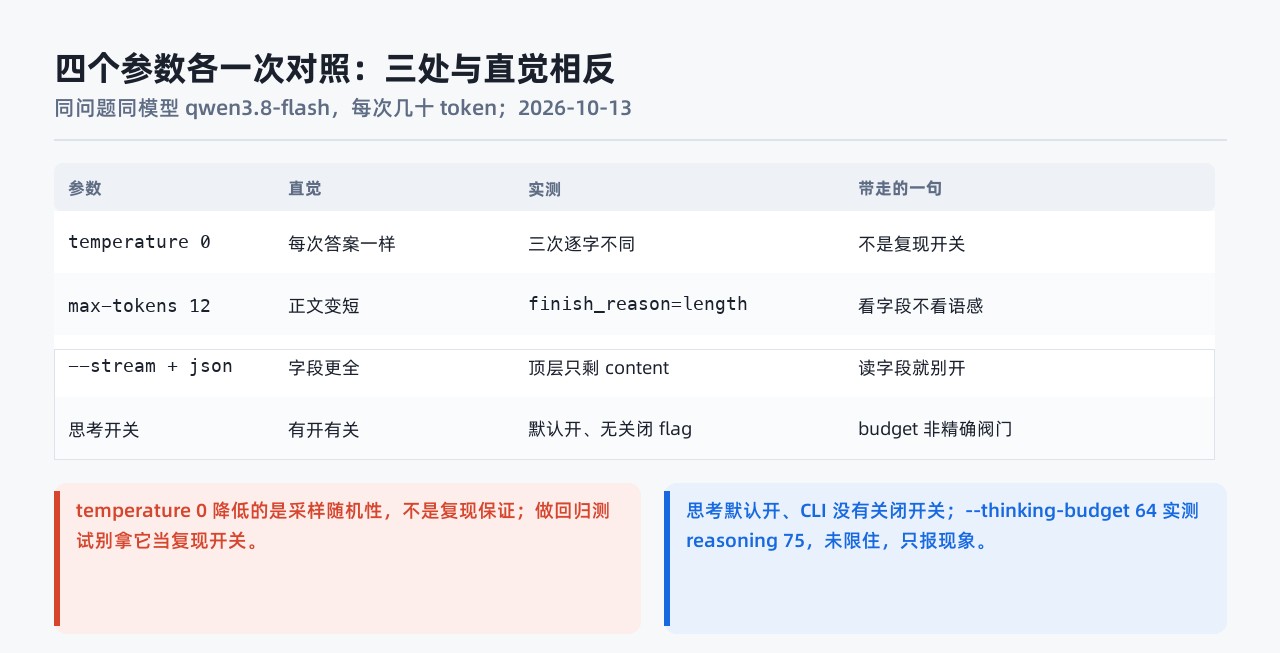
三次逐字相同吗?不相同。
换成 --temperature 1 再连问三次,也不相同,这个在预期内。意外的是 0 那一组。我原本以为 0 就是"钉死",敲三次拿三段一样的文本,可以拿来做基线对比。
所以"调低更稳定"这句话要补一半:temperature 0 降低的是采样随机性,不是复现保证。想要"同一个输入永远同一段输出",靠这个参数做不到。我记下来的一条是:做回归测试、做截图对比的时候,别拿它当复现开关用,真要对比就比关键字段,别比整段文本。
二、开 stream 之后,json 里只剩 content
这条是写脚本的人最容易踩的,我也是在脚本里才发现的。
--stream 是流式输出的开关,意思是答案一段一段往回吐,不用等全部生成完。它的帮助文本写的是"默认在终端里开"(default: on in TTY),也就是你在终端敲命令时看到的是逐字蹦出来的流式输出,而在脚本或管道里默认是非流式。这个默认值的差别,一开始我没在意。
我在脚本环境里对比了两种调法的返回形状:
| 调法 | 返回顶层字段 |
|---|---|
不带 --stream |
choices / created / id / model / object / usage |
带 --stream |
只有 content |
带 stream 的那次,choices、usage、finish_reason 全都没有,顶层就一个 content。我脚本里原本想一边看流式输出一边把 token 用量记下来,结果那些字段一个都取不到。
所以"我想边看流式输出边统计 token"在这条命令上做不到一次调用兼顾:流式看过程是一次调用,结构化读 usage 和 finish_reason 是另一次。记下来的一条是:脚本里要读字段就别开 stream。
三、陪衬一:max-tokens 是把正文截断,返回里会写明
--max-tokens 管这次最多生成多少 token。帮助文本写的默认值是 4096。我故意设成 12,问一个需要三句话的问题:
bl text chat --model qwen3.8-flash --message "把安装、配置、第一次调用三步各用一句话说明。" --max-tokens 12 --output json
返回里 finish_reason 变成 length(这个字段是说"答案为什么停了"),正文停在"安装:执行官方安装命令或下载安装包,完成软件",半句话。平时正常答完时这个字段是 stop。
这就是判断"答案是说完了还是被截了"的唯一可靠信号:看 finish_reason,不要看句子通不通。截断的句子有时候读起来也像完的。
同一次返回里还有一段 reasoning_content,是模型的思考过程(模型在给出答案之前自己推了一遍,这段推理会一起返回),比正文长得多。两个细节:思考段看起来没被那 12 个 token 限住,它和正文的计数口径我没查明,不猜;而且这段思考是默认就有的,下一条说。
四、陪衬二:思考默认是开的,而且这条命令没有关它的开关
不带任何 thinking 相关参数时,qwen3.8-flash 的返回里就有思考段,usage 里也单列了 reasoning_tokens(我这次是 45)。
帮助文本里与思考相关的开关只有两个:--enable-thinking(开启)和 --thinking-budget(思考 token 上限,默认 4096)。没有关闭思考的参数。也就是说在这个模型上,--enable-thinking 更像显式确认,而不是从关到开的开关;想省思考 token,这条命令上没给开关。
顺手验了 budget:设 --thinking-budget 64,reasoning_tokens 是 75,没被限在 64。为什么没限住我没查明,只报现象。你要是对思考长度敏感,别把这个参数当精确阀门。
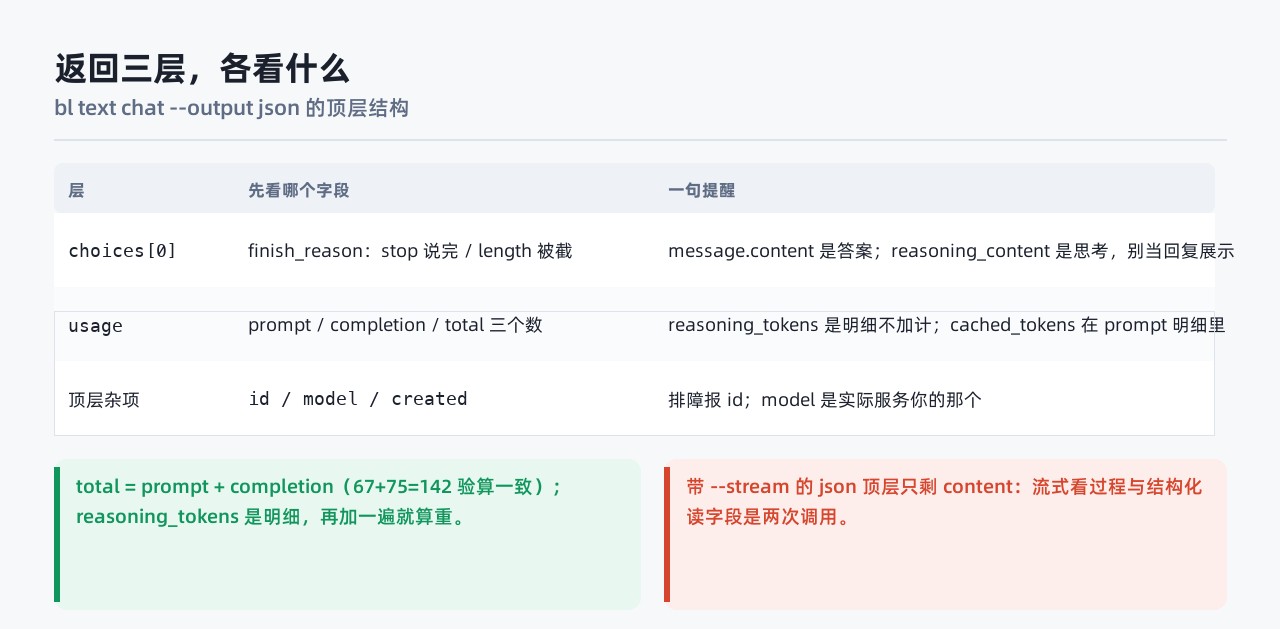
读 usage 时还有一个容易算错的地方。usage 是这次调用的用量统计,单位是 token:total_tokens 等于 prompt_tokens 加 completion_tokens(我这次 67 + 75 = 142,对得上),而 reasoning_tokens 是 completion_tokens_details 里的明细,不再额外加计。把 reasoning 再加一遍就会算重。我第一遍就是这么算错的。
五、返回三层怎么读
拆成三层,够用了:
- 第一层
choices[0]:finish_reason说"说完了(stop)还是被截了(length)";message.content是答案正文;message.reasoning_content是思考过程,不是答案,别把它当回复展示给用户 - 第二层
usage:prompt / completion / total 三个数,加两个明细块(prompt 侧的 cached_tokens、completion 侧的 reasoning_tokens 与 text_tokens)。想知道一次调用"体量多大"看这里;想知道花了多少钱去控制台账单页,返回里不给金额 - 第三层顶层杂项:
id(这次调用的编号,排障时报给它最有用)、model(实际用的模型)、created(时间戳)
六、top-p 我留着没写结论
最后是 --top-p。帮助文本只有一句 "Nucleus sampling threshold"。我跑了 0.01 和 0.9 各两次,finish_reason 都是 stop,看不出行为差异,不构成证据。所以这篇只给帮助文本口径:它和 temperature 都管采样随机性,具体分工以官方文档为准,我不编实验结论。
七、记下来的六条,和这篇没写的
- 要复现别靠
--temperature 0,它三次都不一样 - 判断截断看
finish_reason == length,不看句子通不通 - 脚本里要读 usage / finish_reason 就别开
--stream - 思考默认开、没有关的开关;
--thinking-budget不是精确阀门 reasoning_content是思考不是答案;reasoning_tokens是明细不加计- 排障带上返回里的
id
没写的:第一次调用怎么跑通(另一篇);花费与额度(控制台账单页与额度页,我这边的控制台会话过期了,查不了也不编数字);工具调用那条路和另一套 API 调法(另有包讲过);多模型对比(不在第一周的范围)。
这几个参数都有 Key 就能试,API Key 在密钥管理页签创建,地域选北京。想自己走一遍的话,CLI 安装页在这,一条 npm 命令的事;也可以先去百炼首页看看平台侧长什么样。这篇全部实验只要一个 Key 和几十次小调用。
会变的:模型默认行为、参数口径。重跑一遍就有当天读数,结论以你那次为准,别抄我的快照。

 浙公网安备 33010602011771号