
bl knowledge 的两套 ID,和两个我没敢横着比的分数
最近在给一个 agent 补知识,才发现百炼这边给了两条路:bl memory 往记忆节点里写,bl knowledge 建库让它检索。CLI 就是命令行工具,不开网页,在终端敲一行字让平台干活,百炼那个叫 bl。我是在 GitHub 上翻阿里云百炼的仓库时看到这两组命令的。
起因是 2026-10-03 Hacker News 上一个 391 分的帖子,标题挺冲:"agent 不需要记忆,它们需要文档",评论吵了三百多层。那帖已经出了热点窗口,我不拿它当当期热点,只当个语境:这两条路在我这儿都是现成的,同一个问题各问一遍比看评论快。
读数都是 2026-10-13 我在自己电脑上敲的,bl 2.1.0。别人工作空间里的库名和 ID 我一律匿名化,自己造的记忆节点用完就删。会变的读数我都带了日期,别抄我的快照。
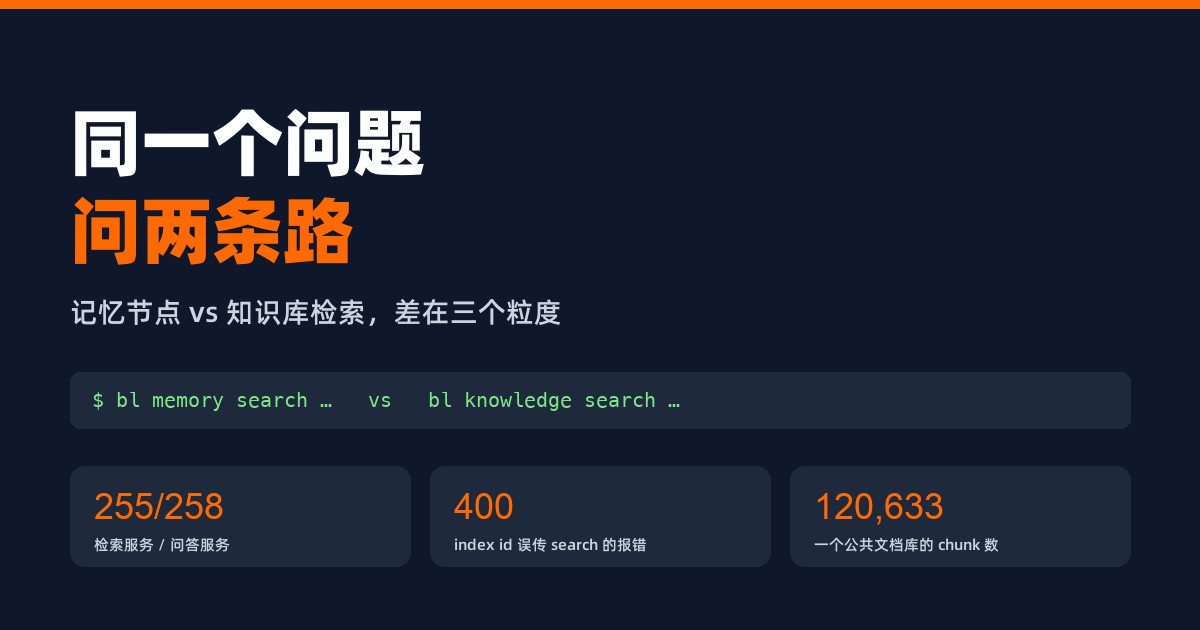
这篇只想记两件事:文档臂有两套 ID,混用会报一个很像服务端故障的 400;两臂各给了一个分数,看着能比,其实不能。
一、库一个 ID,检索服务另一个 ID
文档臂的入口是两层。第一层是知识库本身:
bl knowledge list
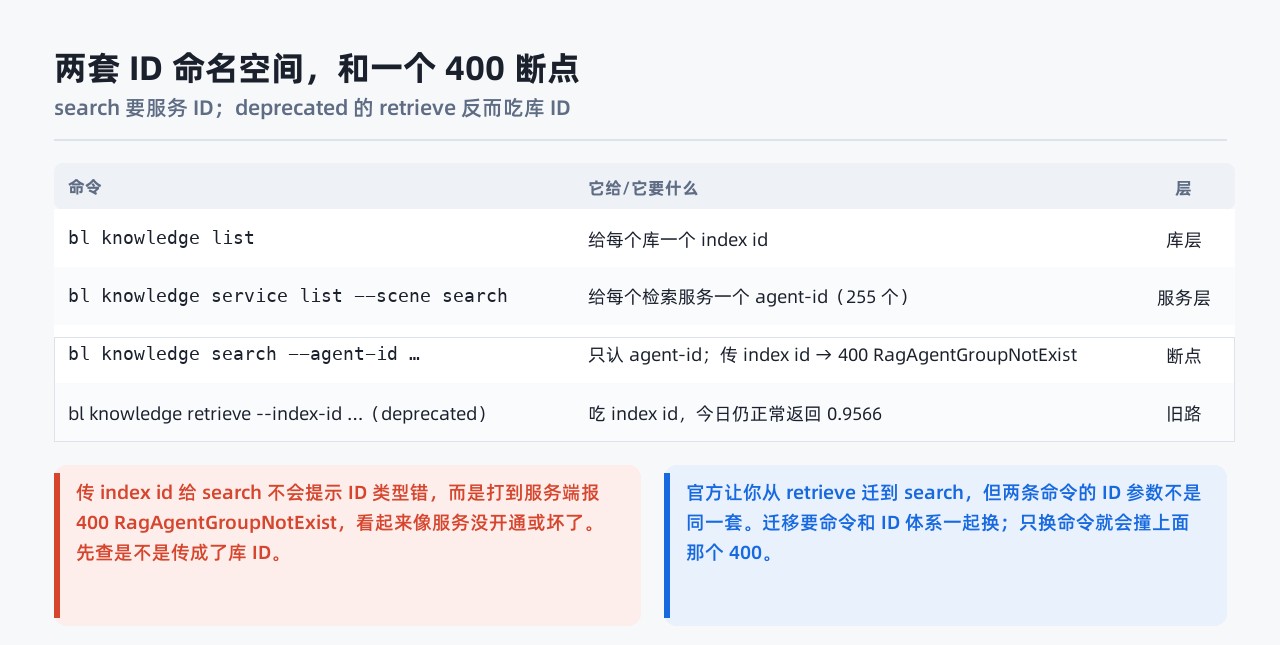
它给每个库一个 index ID。第二层是检索服务,库要包一层服务才能被查:
bl knowledge service list --scene search
我这边工作空间里有 255 个检索服务、258 个问答服务,问答恒比检索多 3 个,两天前是 254/257,也差 3。这条命令末尾自己会打印一句提示:拿上面的 agent_id 去喂 knowledge search。
坑就在这句提示里。bl knowledge search 的参数叫 --agent-id,我把第一层拿到的 index ID 传了进去,它不提示我 ID 类型不对,直接打到服务端:
Error:       Agent application not found.
Status:      HTTP 400 (RagAgentGroupNotExist)
400 加"找不到应用",看着像服务没开通或者坏了,其实是值域错了:这个参数只认服务 ID。换成服务 ID,同一个查询 1.4 秒返回,头两条相关度都是 0.9277(文档臂自己的量表,第四节会说为什么不能跟记忆臂横着比),每条带文档名、标题、正文片段和来源 URL,命中的是那个包着公开文档的检索服务里"服务端推送事件"那一节,连事件表格都原样回来了。
二、deprecated 的 retrieve 今天还能用,而且吃的是另一套 ID
更绕的是被取代的那条旧命令。帮助文本里 bl knowledge retrieve 标着 deprecated、让你改用 search,但它的参数恰恰是 --index-id,吃第一层的库 ID。我今天敲它照样正常返回,相关度 0.9566:
bl knowledge retrieve --index-id <库 ID> --query "会话事件流 SSE 服务端推送哪些事件"
所以官方推荐的升级路径不是平替。换命令的同时得换一套 ID,只把 retrieve 改成 search 的人,会撞上面那个 400,还会以为平台出故障了。
这两条查询都要 Key:API Key 在密钥管理页签创建,检索和列清单这几条有 Key 就能跑。
三、记忆臂那边:写进去、查得到、删得干净
记忆臂没有这个弯,它的隔离单位是 user-id。同一个工作空间里,不同 user-id 的记忆互不可见。我拿一个合成的标识查,返回 No memory nodes found,干净的空库:
bl memory list --user-id <合成标识>
先写一条进去,再问,再删掉复核:
bl memory add --user-id <合成标识> --content "用户偏好:周报用四段结构,一级条目不得增删。"
bl memory search --user-id <合成标识> --query "周报结构有什么要求"
bl memory delete --node-id <节点 ID> --user-id <合成标识>
bl memory list --user-id <合成标识>
add 返回一个 memory_node_id,search 命中、相关度 0.324(记忆臂自己的量表,跟文档臂那个数不是一回事,第四节细说)、节点类型 observation、状态 valid,delete 返回确认,list 回到 No memory nodes found,search 剩余 0 条。三步都成立,全程只碰我自己合成的那个 user-id。
有个细节我一开始没注意:search 命中的不是我写进去的那句原文,是一条被归纳过的观察节点。文档臂给带出处的原文块,能顺着 Source 去核;记忆臂给归纳结果。两条路都能答,答的形态不一样。
四、0.9277 和 0.324,我没敢横着比
看到两个分数,本能反应是比较谁更准。我忍住了。
这俩是两套量表上的数:0.9277 是 chunk 与查询的检索相似度,0.324 是记忆节点与查询的匹配分,算法和取值范围都不同。我这次只有一组对照,不做量表换算,也不据此说谁更准。要比,只能在同一臂内比不同查询的排序,或者干脆看答案能不能用。
这条我想写进团队规范:任何把两臂分数放同一张表里排序的做法,都是在比苹果和橘子。
五、十二万个块和一个节点
顺手往下翻了一层。查一个库的 chunk:
bl knowledge chunk list --index-id <库 ID> --page-size 3 --output json
我查的那个公共文档库返回 total 120,633。每个块的 metadata 里有块级健康位(_chunk_status 为 0、状态消息"成功")、所属文档 ID、文档名、来源 URL,还有一个"是否展示块内容"的开关位。改块用 bl knowledge chunk update,要同时给库 ID、块 ID、文档 ID 三个键,新内容限 10 到 6000 字。这条我只引了帮助文本里的参数签名,没有去动任何块。
文档臂可以逐块看健康、改内容、切可见、顺藤摸到源文档;记忆臂只有节点级的增改删查,一条记忆就是一个节点,要么在要么不在。这不是优劣,是分工:需要逐块治理的是资料,需要整条取舍的是关于某个用户的事实。
顺着这条分工,我把"什么时候用哪条"收成三行。跟某个用户走的东西进记忆臂,偏好、习惯、上次说到哪,写一条生效一条。团队共享、要版本化、要逐块治理的东西进文档臂,产品文档、规程、FAQ,包一层检索服务给所有 agent 查。两者不互斥,叠着用更常见:文档臂答"公司规定是什么",记忆臂答"这个人上次要求过什么"。
反过来也清楚。把团队规程塞进某个 user-id 的记忆里,别人查不到;把个人偏好灌进共享知识库,所有人都被它影响。隔离粒度选错,比选哪条路更致命。
六、记下来的六条,和这篇没写的部分
bl knowledge list拿库 ID,bl knowledge service list --scene search拿服务 ID,两套分开记- 喂
knowledge search只用服务 ID;报 400RagAgentGroupNotExist先查是不是传成了库 ID - 从 deprecated
retrieve迁移时,命令和 ID 体系一起换 - 记忆臂先确认 user-id 隔离符合预期,再写第一条;合成标识试跑最安全
- 两臂分数不进同一张排序表
- 文档臂开放检索前跑一次
chunk list看_chunk_status,坏块先修
几件如实说的事。建库、导入文档、建检索服务会真实写云资源,我只给控制台路径,不演示命令。用量和额度那几条命令走控制台会话,我的会话过期了,查不了,要看自己去控制台额度页,别信任何文章里的数字,包括这篇。记忆臂的画像 schema(profile)那条支线也没展开,跑通"把检索结果喂回模型"要发一次模型调用,是另一篇的事。
会变的:服务数、chunk 数、模型目录。想自己走一遍的话,CLI 安装页在这,一条 npm 命令的事;百炼首页在这,可以先看看平台侧长什么样。

 浙公网安备 33010602011771号