
我让模型报一个agent当天的价格,它 14 秒给了个精确到千分位的假数字
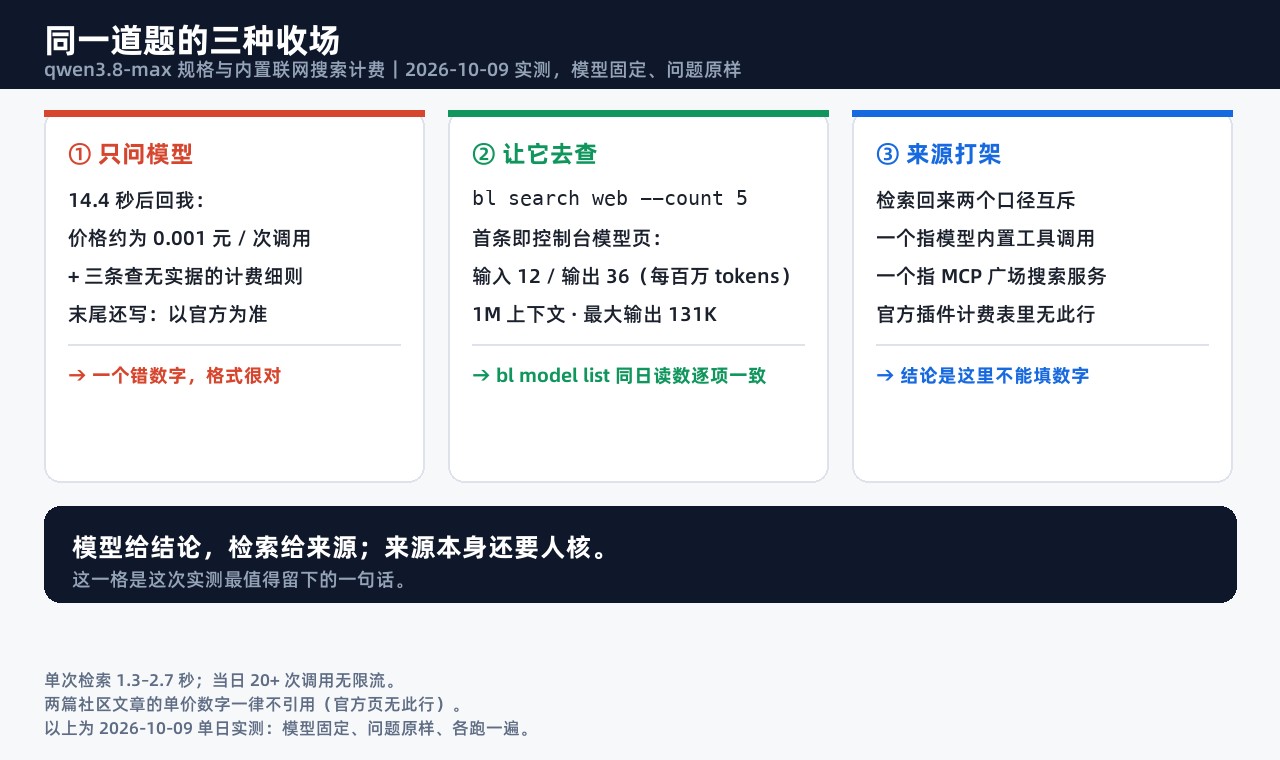
这篇算是一天的实践记录。起因很小:我在给一个 agent 算成本,需要百炼内置联网搜索工具按调用的价格。我按最省事的做法问模型,14.4 秒回我:
价格约为:0.001 元 / 次调用(即每 1000 次调用约 1 元)
后面跟了三条补充,只在模型真正触发搜索时计费、与 token 费用分别结算、价格可能调整以官方为准,连去哪核对都写好了。我抄进了表格,过了三分钟才回过味:它连"以官方为准"都说了,为什么数字敢给到小数点后三位?
于是我把这一整天花在另一条命令上:bl search web。下面按我踩的顺序记,坑都挺具体。
踩坑一:我原来把两件事混成一件
问模型和让模型去查,我一直当一个动作在用。我甚至问过"你知道就去查一下",它不会去查,它会用训练时记住的东西给你一个形状像答案的东西。那个 0.001 元就是这么来的:语气自信,精度可疑,免责句齐全。
bl search web 不回答问题,它只把网页的标题、摘要、URL 摆出来:
bl search web --query "阿里云百炼 qwen3.8-max 上下文窗口 价格" --count 5
第一条命中就是百炼控制台的模型页,摘要带着原文:
输入 12 元/每百万tokens 输出 36 元/每百万tokens
2026-09-01  1 M 上下文长度  128 K 最大输出长度
第三条是个社区文章,把整张价目表搬回来了:输入 ¥12/M、输出 ¥36/M、缓存命中输入 ¥1.5/M、显式缓存创建 ¥15/M、显式缓存命中 ¥1/M,还有一句"最大输入:991K 最大输出:131K"。
我本机装着 CLI,就再向平台直接要一次官方读数做交叉验证:
bl model list --model qwen3.8-max --output json
回来 contextWindow: 1000000、maxInputTokens: 991808、maxOutputTokens: 131072、输入 12、输出 36、缓存命中 1.5。检索命中的原文和本机读数逐项对上,包括那个 131072,我在两个来源里分别看到"128 K"(按 1024 进位)和"131K"(按 1000 进位)两种写法,是同一个数。
单次耗时 1.3 至 2.7 秒,一天跑了二十多次,没碰到限流。
踩坑二:检索回来的东西也会互相打架,这才是最有用的部分
把三组题各跑一遍,模型固定、问题原样:
| 题目 | 只问模型 | bl search web |
|---|---|---|
| qwen3.8-max 上下文窗口与价格 | 默认旗舰不带参数跑满 300 秒超时;把 --max-tokens 压到 800 才正常返回,答"我不能负责任地给出确切数字……为避免给你错误数字,我不能编造" |
首条即控制台模型页,摘要含 12/36 与 1M/128K;第三条含完整价目表;与 bl model list 同日读数逐项一致 |
| 内置联网搜索按调用多少钱 | 14.4 秒给出 0.001 元/次,外加三条查无实据的计费细则 | 命中两篇社区文章,两篇给的口径互相矛盾,而且说的不是同一件事 |
| 某个仓库现在多少 star | 快模型这次超时没回(--timeout 120) |
我改用 GitHub API 直读:当天两次读数 94,173 → 94,260 |
第二行我原本以为会是"检索就对了",结果两个来源互相矛盾。数字我不往这篇里抄,两篇都是社区二手口径;细看才发现它们说的压根不是一回事,一个指模型内置的工具调用,一个指 MCP 广场上的搜索服务。我再去官方帮助中心把内置插件计费表抓下来核对,那张表里没有 web_search 这一行,联网检索类记作 quark_search,计费写"限时免费,需申请开通";同表 code_interpreter 标的是"免费"。
所以这道题到今天我还是没有一个能写进方案的数字。但性质变了:模型给我一个错数字,检索给我三个来源,而三个来源告诉我这件事不能写。
第一行我也想替旗舰说一句公道话:它那次是拒答的,而且拒得很负责。真实情况是有时它会老实说不知道,有时给你一个假数字,你从语气上分不出来。既然分不出来,就别赌,先查。
顺带一句真实经历:我把同一个问题丢给我手上另一条通用搜索通道,它回我一屏楼盘售楼处和爆料站的 SEO 页。这条不打算做成对比营销,只是那天确实发生了这么回事。
踩坑三:--output json 解析不到 pages
动线我最后定成两步:
bl search web --query "阿里云百炼 qwen3.8-max 上下文窗口 价格" --count 5 --output json > evidence.json
bl text chat --system "只依据下面给你的材料回答,材料里没有的就说不知道,并列出你查过的 URL。" --message "$Q
【材料】
$(cat evidence.json)"
--system 那句是关键。不加,模型会拿材料当引子继续发挥;加了,返回的每个数字都能追溯到一条 URL。
坑在中间那步:--output json 给你的不是能直接取 pages 的数组,它是 MCP 工具的信封:
{"content":[{"type":"text","text":"<这里再嵌一层 JSON 字符串>"}],"isError":false}
内层解开才是 {"pages":[...],"request_id":"...","tools":[...],"status":0},page 的字段是 snippet / hostname / hostlogo / title / url。我第一版脚本按顶层取 pages,拿到空、不报错,我怀疑了十分钟检索服务。想省事就先用 text 态肉眼读,要脚本化再上 json 态。另外 hostname 有为空的情况,我这天控制台那条命中的 hostname 就是"无",展示来源时留 url 兜底。
踩坑四:--count 的帮助文本是错的
--help 写:
--count <n> Number of search results (default: 10)
我按十个的预期设计后面的读法,实测完全对不上:
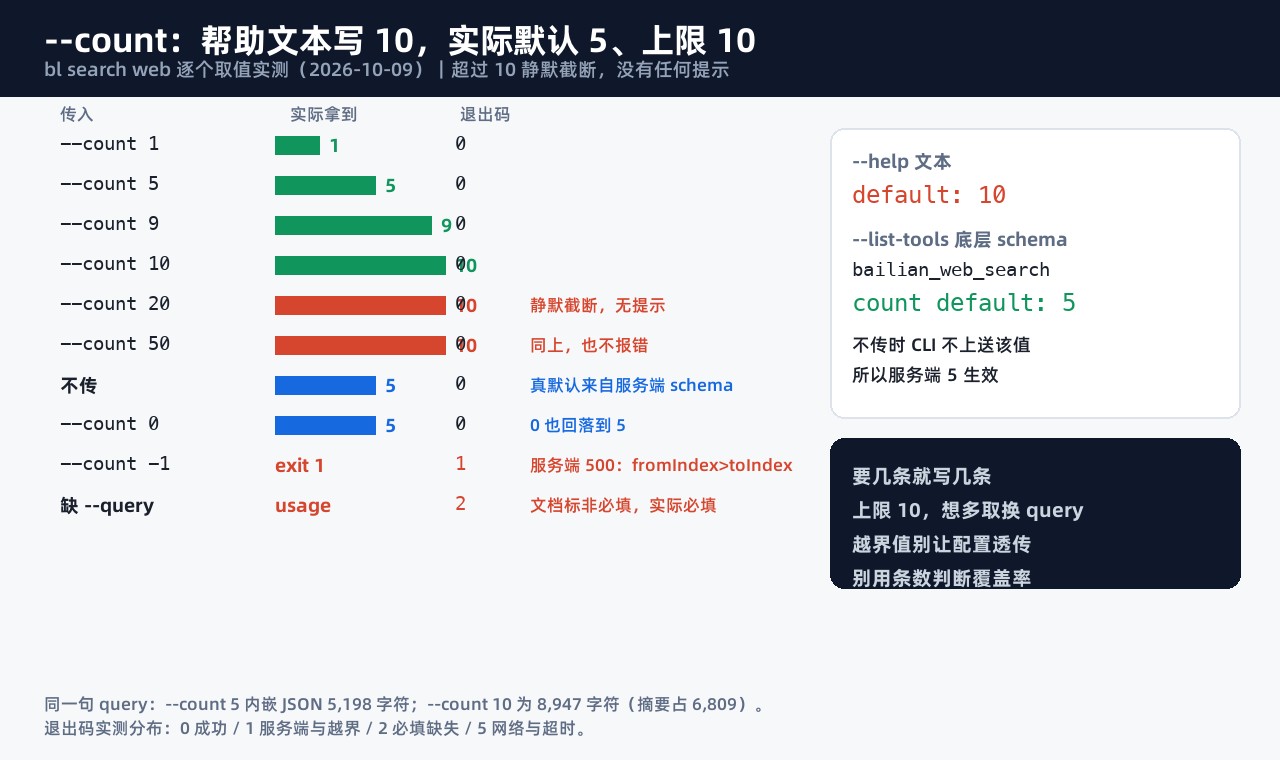
| 你传 | 退出码 | 实际拿到几条 |
|---|---|---|
| 不传 | 0 | 5 |
| 1 / 5 / 9 / 10 | 0 | 1 / 5 / 9 / 10 |
| 20 / 50 | 0 | 10(静默截断,没有提示) |
| 0 | 0 | 5 |
| -1 | 1 | 服务端 500,原文 IllegalArgumentException: fromIndex(0) > toIndex(-1) |
不传 --query |
2 | Missing required flag: --query |
真默认从哪来?这条命令自己会回答:
bl search web --list-tools
打出底层 MCP 工具 schema,工具名 bailian_web_search,入参 query(required)和 count(default: 5)。不传 --count 时 CLI 压根不上送这个值,最后服务端默认 5 生效,--help 那个 10 从没被执行。
三条我直接写进代码了:要几条就明确写几条;上限是 10,--count 50 只会安静给你 10 条,你会以为全网就这些;-1 会把服务端异常原样抛出来,别让这种值出现在参数里。还有一个方向相反的漂移:--query 在参考文档里标的是"非必填",实际不传直接 exit 2。
踩坑五:我差点把一个结论写错,是控制组救的
模型自带工具是另一条路,Responses API 挂 web_search:
bl text chat --api responses --model qwen3.8-max --tool '{"type":"web_search"}' --message "..."
我拿它当对照组时三种形态都不好:text 态只回一句"我来查一下阿里云百炼平台上该模型的官方规格与计费信息"就 exit 0,正文里没第二条;换 --output json 直接 exit 1,服务端 500,原文 local variable 'queries_list' referenced before assignment;按官方 skill 不写死模型再跑,超时退出。
超时的几次我用脚本自己计时,读到 900 多秒,而当时 --timeout 设的是 150、180。第一反应就是这个参数没用。幸好我换了壳层计时重测:脚本计时里混进了本机休眠,那几个数全部作废。再做一个控制组,把 base_url 指向不通地址,让它只能等到超时:
bl search web --query "probe" --base-url http://10.255.255.1 --timeout 5
bl text chat --api responses --model qwen3.8-flash --tool '{"type":"web_search"}' --timeout 60 --message "..."
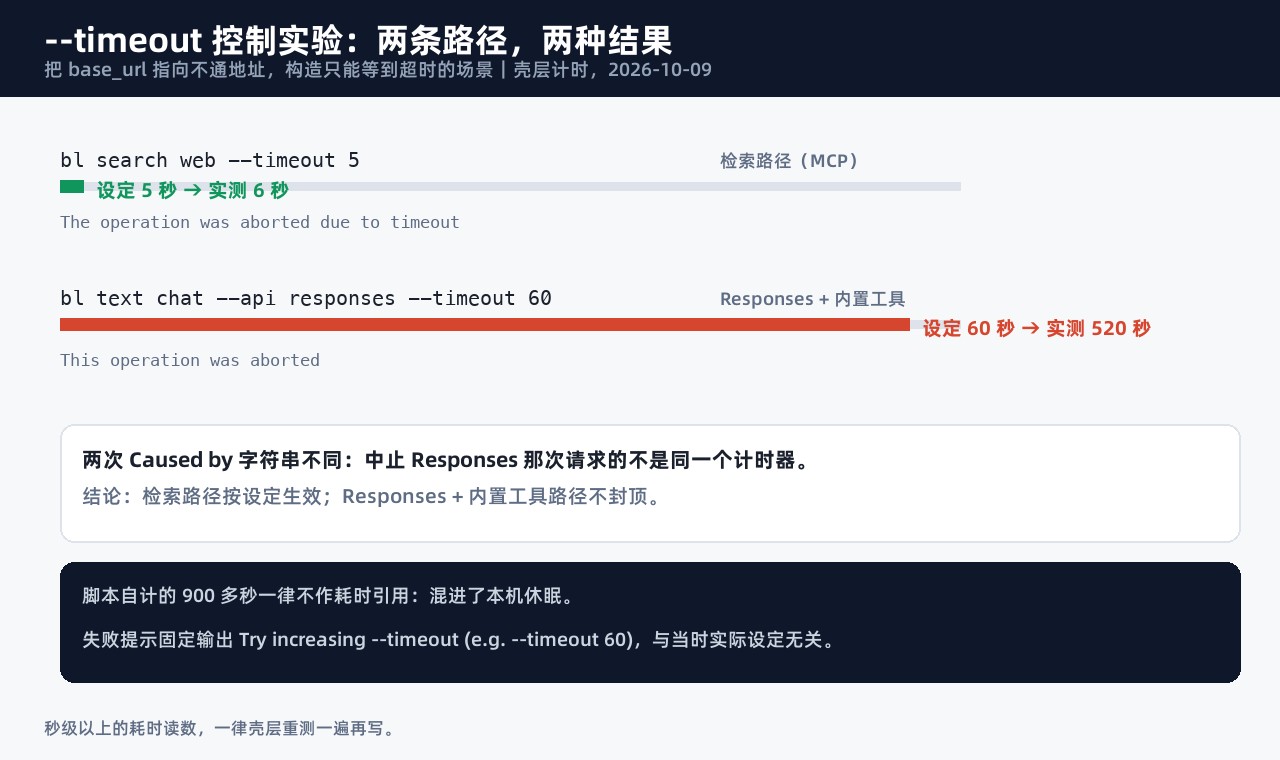
| 路径 | 设定 | 壳层实测 | 错误原因 |
|---|---|---|---|
bl search web |
--timeout 5 |
6 秒中止 | The operation was aborted due to timeout |
| Responses + 内置工具 | --timeout 60 |
520 秒中止 | This operation was aborted |
所以能写的结论比我原打算那句窄:--timeout 在 bl search web 这条路上按设定生效;在 Responses + 内置工具这条路上同一参数不封顶,而且中止它的不是那个计时器(两次 Caused by 不一样)。教训留一条给同样写测评选的人:秒级以上的耗时读数,一定要壳层重测一遍。
另外失败时 CLI 固定提示 Try increasing --timeout (e.g. --timeout 60),我那时设的就是 60 或更大,这句是硬编码的,看了别当真。
踩坑六:先确认自己是谁,再决定抄谁的命令
百炼在 2.1.0 里把联网搜索做成单独的路由 skill(bailian-web-search,随 bl skill init 装)。它只看一条无鉴权命令:
bl config show --output json
profile 名是不是 token-plan,base_url 的 host 是不是 token-plan.<region>.maas.aliyuncs.com,任一命中就是 Token Plan 身份,只能走模型原生工具。我这台 profile 是 image、host 是 dashscope.aliyuncs.com,两条都不沾,走 bl search web。Token Plan 的 key 是不允许调 bl search web 的,skill 里写得很硬。
我还多虑了一件事:以为要先去 MCP 广场点开通。查自己账号已开通的服务,过滤 search 只有 Brave_Search 一条,过滤 web 是零:
bl mcp list --name search
bl mcp list --name web
bailian_web_search 不在广场清单里,它由 DashScope 侧内置,API Key 直接可调。
哪些事我不再拿它做
要"每次都不漏"的别用。上限 10 条还静默截断,它就是"快速看一眼公开网页"。全量抓取是另一套工程:我同一天抓今日头条被 302 到反爬 JS 页,抓 CSDN 拿到 HTTP 521,难度自己体会。
私有知识走 bl knowledge。切块、可控、索引可查才是它干的活;search web 命中的是公开网页,同一句 query 明天就是另一批结果。我这里每个读数都标了"2026-10-09 实拉",就是为这件事。
上下文紧就别整包塞。同一句 query 各取一次:--count 5 时内嵌那段 JSON 是 5198 字符,--count 10 是 8947 字符(光摘要 6809 字),单条摘要长度完全不受你控制。我现在的做法是先取 5 条、肉眼筛掉水文、再决定喂哪几条回模型。
这一天改掉的三个习惯
- 凡是当天的数字,先检索再问。模型对"今天"没有记忆,只有训练截止日之前那套世界观,加上极强的表达自信。
- 检索完不止步。这次它给我两个互相打架的价格,逼我去翻官方页,才发现那张表里连这一行都没有。如果拿到来源就当真,我只是把编造的责任换了个人承担。
- 默认值一律实跑一遍再信。
--count的 10、参数表里的"非必填"、超时提示里的 60,三个都是跑出来的,不是读到的。
npm install -g bailian-cli
bl skill init
bl search web --query "阿里云百炼 qwen3.8-max 上下文窗口 价格" --count 5
我跑第一遍时那批来源里有一条命中官方文档。真正让我改习惯的不是那条,是另外两个价格互相矛盾的那两条。百炼首页:https://bailian.console.aliyun.com/?source_channel=hh_github

 浙公网安备 33010602011771号