
标题:漏看角落水印之后我补了一道视觉检查,中间踩了三个坑
起因:一行我自己没看见的小字
上周帮朋友整理一批活动照片,挑完我按老习惯放大检查了一遍:构图、曝光、有没有路人入镜,都过了,发出去。
第二天对方来问:右下角那行字是什么?
放大到百分之三百才看见,一行浅灰色小字,版权署名。我检查的时候完全漏了。人眼对"预期之外的小东西"就是这样,你盯着主体看的时候,角落是盲的,多认真都没用。
那几天正好在摸百炼 CLI 的视觉描述命令 bl vision describe,就把这批图重新过了一遍。它把那行字念出来了。下面是过程里踩的三个坑,记一下。

坑一:第一次问得太泛,答非所问
我上来就问"这张图讲了什么"。
回来的是一段挺流畅的整体描述,主体、色调、构图都说到了,唯独没有我要的那行角落小字。它不是没看见,是我没让它去扫角落——问的是"讲了什么",它就答整体印象。
改成显式点名之后就不一样了:
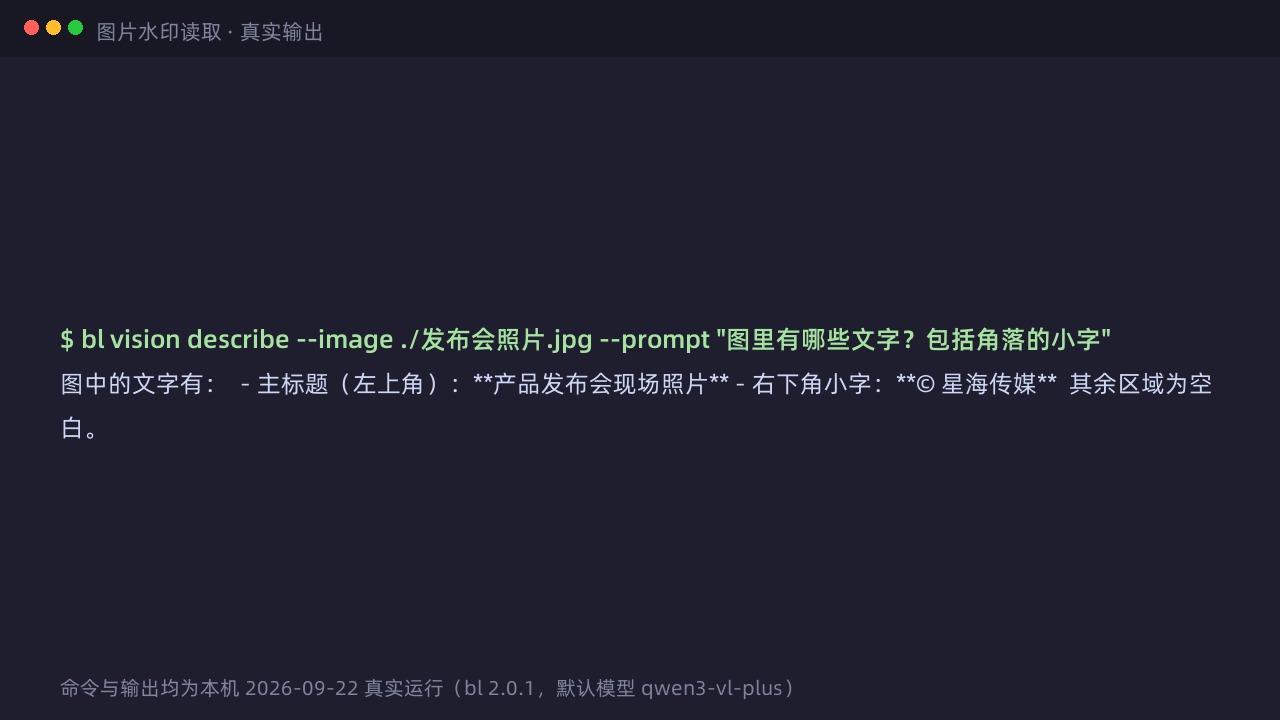
bl vision describe --image ./活动照片.jpg --prompt "图里有哪些文字?包括角落的小字"
同一张图,这次它把主标题念了,还单独点出右下角那行浅灰署名。
我的体会是:这类命令的提问不能写意图,要写检查项。 "讲了什么"是意图,"有哪些文字,包括角落的小字"是检查项。想查角标就把角标、台标、署名一个个列出来,想连页脚编号一起查就把页脚写进去。它给的颗粒度基本就是你提问的颗粒度。
--prompt 不写也有默认问法,跑是能跑,但拿到的东西跟你的用途对不上。批量的时候提问一律写死,别用默认。
坑二:对照组差点被我省掉
跑通一张图之后我差点就直接写结论了——"18 像素浅灰小字能认出来"。
停下来的原因是心里有个说不清的别扭:我只问了带水印的那张,它答"有水印"。可万一它就是顺着问题往下编呢?这类模型最容易翻车的地方从来不是看不清,是没看也说看了。只测正向,我测到的其实是它的顺从度。
于是回头补了对照组,素材自己造,把变量压到最小:
- 图片用 PIL 生成 900×600,右下角埋一行 18 像素浅灰字,另存一份去掉这行字的
- 视频用 ffmpeg 做 4 秒 640×360 灰底,
drawtext在右下角烧一行白色 22 像素角标,另存一份不烧的
四组跑完:
| 素材 | 提问 | 它答 | 对不对 |
|---|---|---|---|
| 带水印图 | 有哪些文字,包括角落的小字 | 主标题 + 右下角那行浅灰署名 | 对 |
| 同图去水印 | 同上 | 只有主标题,明确说角落无水印、无小字 | 对 |
| 带角标视频 | 画面里有什么文字 | 右下角白色角标 | 对 |
| 同段去角标 | 画面里有什么文字或水印 | 没有任何文字或水印,顺带描述了各时段画面 | 对 |
四组全对,零次幻觉。区别全在对照组:去水印那次它老老实实说"没有",才说明带水印那次的"有"是读出来的,不是编的。
视频那两组我多做了一步:把带角标那条视频的第 50 帧单独抽出来存成图,自己盯着看了一遍,确认角标确实在右下角、确实是白色 22 像素,然后再去比模型的判定。这一步听着多余,但它是"我认定它答对了"的前提——我要是没抽帧,万一 ffmpeg 那行 drawtext 写错了、角标压根没烧上去,模型答"有"我就真信了。素材是自己做的时候,连素材本身也要验一遍。
视频组的输出跟图片组不太一样,它会按时间段说话,大致是"从某秒到某秒画面是什么"这种结构。带角标那次它在时段描述之外单独点出了右下角的白色文字;去角标那次它说没有任何文字或水印,然后照样把各时段的画面讲了一遍。后者让我稍微松了口气:它没有因为"没有文字"就敷衍了事,也没有为了迎合问题硬编一个出来。
这一步花的时间不到十分钟,但它决定了前面所有结论能不能往外说。省掉的话,这篇文章就只是一次运气好的抽样。
坑三:把"认得出"当成了"都认得出"
写完初稿我回头改了一处措辞。原来写的是"角落小字它都能念出来",这句是错的。
我能证明的只有一档:18 像素、浅灰、放在角落。再小、再淡、跟背景对比度更低,或者素材本身被压过好几轮,我一次都没测,不能替它打包票。视频那边还有一条独立的限制,是时长:我的角标全程挂在画面上所以稳,半秒一闪而过的东西不保证抓得住,这类素材我不会只依赖一次调用。
还有一条我写在最显眼位置的:它念的是"它看到的",不是"事实"。图里本来就有错别字,它会照念给你。所以核对类用途里我拿它当第一遍筛子,把可疑的挑出来,人再过一遍。
补对照组的时候顺手确认了一件事:默认模型是 qwen3-vl-plus,--model 能换,但我这四组只在默认模型上跑过。谁要换模型,对照得重跑一遍,结论不继承。
顺手记下的几件小事
跑这四组的过程中记了些零碎,写在这里省得别人再摸一遍。
本地路径直接给就行,图和视频都是,CLI 自己上传,不用先把文件推到网盘或者对象存储换一个外链。我原本以为要先折腾一遍链接,白准备了半天。视频这边认的格式是 mp4、mov、avi、mkv、webm。
--image 和 --video 是二选一,一条命令不会同时吃图和视频。写批量脚本得先按文件类型分流,我一开始图省事想混在一个循环里跑,发现参数根本不通用。
--prompt 不写也能跑,它有默认问法,但拿到的是一段整体描述,跟你具体要查什么多半对不上。坑一就是这么来的,所以现在我的批量脚本里提问一律写死。
视频那条我会多加一句"按时间段说",让它显式分段,角标出现在第几秒就有据可查;不分段的话回来的是一段笼统描述,回头想找证据都找不到。
跑通之后我拿它干的几件事
水印这事只是起因。命令跑顺之后发现能接的地方不少:
- 二创素材自检:用别人的图或视频之前先问一句"画面里有哪些文字和标识",角标、台标、署名一次看清,比我逐帧拖进度条可靠
- 归档检索:一堆培训录像和活动回放,按"画面里出现过哪些字"批量过一遍,用念出来的标题归档,不用全片快进
- 扫描件复核:合同扫描件、报告截图的角落章、页码、编号,念出来跟正文台账对
- 无障碍描述:给视障同事说清一张信息图里到底写了什么
共同点是同一件事:画面里的文字和标识,人眼会漏,它逐块扫。
想自己试的话
装 CLI、领 Key、一条命令,三步:
npm install -g bailian-cli
bl vision describe --image 你的图.jpg --prompt "图里有哪些文字?包括角落的小字"
Key 在控制台密钥管理页领(地域选华北2 北京),CLI 安装说明和命令文档在阿里云百炼 CLI(bl)。
我的建议是别只跑正向那一张。花十分钟做一份去掉标识的对照素材,两组都跑一遍,再决定信不信它。我这次的三个坑里,最贵的就是那个差点省掉的对照组。

 浙公网安备 33010602011771号