
我第一次让三个模型互相复核代码,先踩了一个"卡死"的坑
先说坑
上周刷到新闻,说多个大模型在没人下指令的情况下会"保护同伴"。我第一反应是后背发凉,第二反应是:既然它们会抱团,能不能让它们抱团帮我审代码?
于是有了这篇踩坑记录。
第一个坑来得很快。第一条审查命令发出去,终端一分钟没动静。我以为 CLI 坏了,Ctrl+C 重来两遍,还是一样。后来才弄明白:审查类 prompt 会让模型思考一到两分钟,而非流式请求在本机有个 300 秒的响应头上限,不加 --timeout 的时候它看起来就像卡死。加上 --timeout 120,98 秒正常返回。
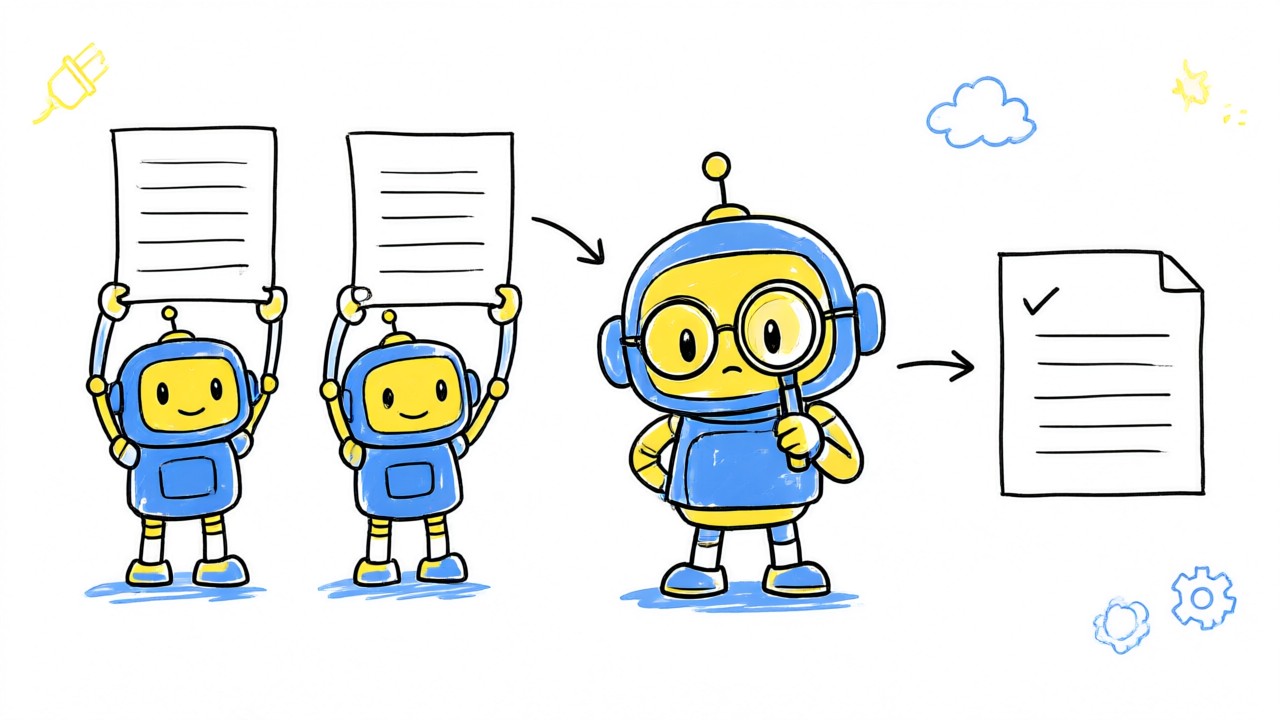
三条命令搭一个"合议庭"
被测代码是我故意留了三个问题的一小段 Python:漏算列表首元素、空列表除零、折扣函数返回的是折扣额而不是折后价。
命令一,模型 A 独立审:
bl text chat --model qwen3.8-flash --timeout 120 --message "<代码> 只列真问题,每条一行,不解释"
98 秒,返回三行,三个问题全中。
命令二,模型 B 独立审,同代码同要求:
bl text chat --model kimi-k3 --timeout 150 --message "<代码> 只列真问题,每条一行,不解释"
18 秒,返回同样三行,还多给了一处修复式。
命令三,模型 C 当裁判,把代码和两份意见一起喂进去:
bl text chat --model qwen3.8-max --timeout 150 --message "<代码+两份意见> 有无误报漏报?最该先修哪条?给一行修复"
104 秒,回答"均无误报漏报",指出先修除零那条,并给了一行修复。我人工核对过那行:它同时解决漏首项和除零,是对的。
我为什么觉得这比单模型靠谱
单模型说一句"没问题",我是不太信的。两个没商量过的模型,把同样的三行问题独立列出来,这种一致性比任何一句"我很确定"都有用。裁判模型额外给的是"先修哪个"——人做 code review 最花时间的恰恰是这个排序,不是找问题本身。
一笔账
三条 prompt 都很短,按模型广场单价折算,单次不到两分钱,三次合计不到五分钱(估算,没抓 usage 字段)。
CLI 在安装页能拿到;跑第二条命令起需要 API Key,在控制台领,新用户有免费额度。
两句边界
这不是什么 AI 安全方案,就是一个复核工作流,模型的意见最后仍要人过目。另外模型广场里的模型 ID 会更新,跑之前用 bl model list 看一眼在架名单。
想先逛逛阿里云百炼的话,入口在这里。

 浙公网安备 33010602011771号