
我用命令行写小说的第一晚:heredoc 加了引号,AI 给我写了一篇穿书文
记录一下昨晚的翻车和后来的跑通。起因是知乎那个"真的可以用 AI 写小说吗"的问题,高赞答主给了三步:扒爆款骨架、精准 Prompt 填肉、人工改三处。他没写工具,我把它落在阿里云百炼的命令行 bl 上。
翻车:大纲没喂进去
第一步是让模型只出 100 字大纲。我图省事,在 shell 里用带引号的 heredoc 组消息文件:
bl text chat --model qwen3.8-flash --system "你是有6年知乎短篇经验的作者:口语化、快节奏、300字内出现核心冲突。" --messages-file - <<'EOF'
[{"role":"user","content":"按以下大纲写开头800字:\n$(cat outline.txt)"}]
EOF
问题就出在引号上:heredoc 加了引号,$(cat outline.txt) 不展开,模型收到的是字面量 $(cat outline.txt)。它没报错,也没问我,自己编了一个题材——婚礼、穿书、恶毒女配、海边死去,跟我给的"裁员男卖亡妻钢琴"毫无关系。7537 个输出 token,写得还挺顺。
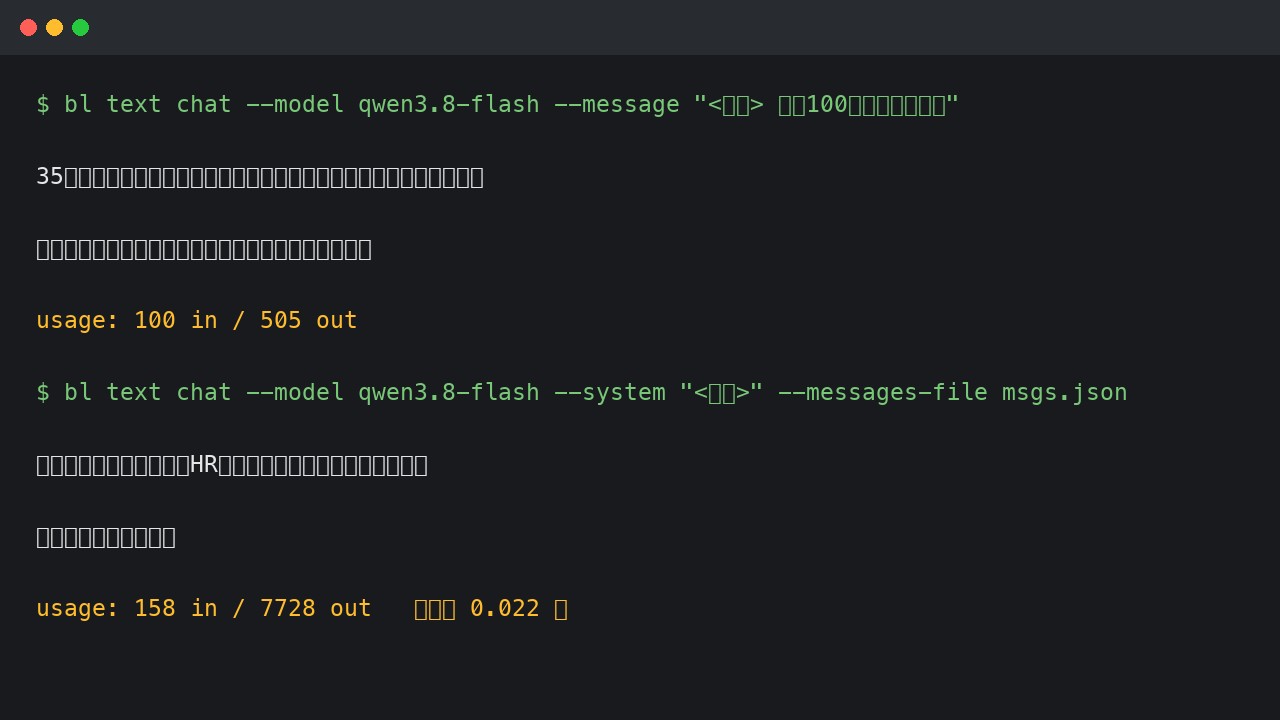
这就是这类工具的现实:它不校验你的输入是不是你想要的。改用 python 组装消息 JSON 之后,同一条命令返回的开头是:
三十五岁生日,我被裁。HR说降本增效,大龄单身男最没用。
我抱着纸箱,去卖琴。
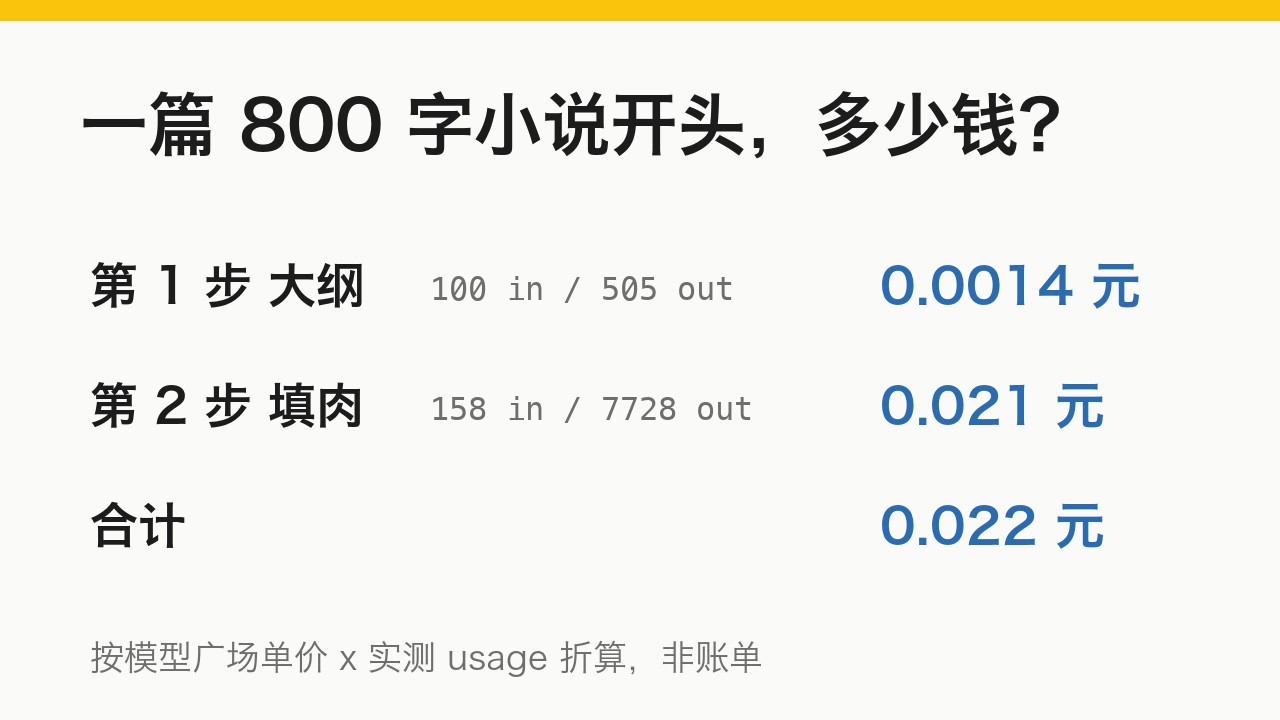
798 字,158 token 输入、7728 token 输出,第一段就是冲突。这一步折算约 0.021 元;加上前面出大纲那步的 100/505 token(约 0.0014 元),一个 800 字开头合计约 0.022 元,按模型广场单价乘实测 usage 折算,不是账单。
第二处坑:改稿别交给思考型模型
高赞流程的第三步是人工改三处:开头钩子、核心反转逻辑、结尾情绪落点。我想偷懒让 AI 改,喂整篇给 qwen3.8-max,两次都在两分多钟超时空返回;换 flash 喂 600 字也超时。长输入加思考型模型,命令行非流式调用就是慢。于是按答主说的自己改:换更狠的第一句、给录音反转补一环、把结尾从抽象词改成具体动作。改完确实紧了不少。
三条我抄来的边界
答主自述写短篇六年、半年稿费超过之前两年总和、纯小白徒弟第 10 天拿到 700 块。这些是他的自述,不是平台口径。能当结论用的是另外三句:平台拒的是纯 AI 生成的流水账,不是 AI 辅助创作;社区口径是最好的模型超五万字必崩;稿费数字别照抄,千字 30 到 150 是市场价波动区间,不是承诺。
CLI 在安装页,跑填肉那步需要 API Key,在控制台领,额度以控制台页面为准。想先逛逛的话入口在这里。
两分钱跑通一遍流程,再决定要不要谈灵魂。这话是答主说的,我同意。

 浙公网安备 33010602011771号