Jev 发布三天就被开源了:33 毫秒做一次判断的 Laya,值不值得进生产?
2026 年 9 月 15 日到 9 月 24 日,九天里发生了三件事:TypeSafe AI 发布闭源决策模型 Jev;Convai Innovations 开源了对标的 Laya;1Panel 把 Laya 封装成 Laya Server 上架应用商店。
这三件事单独看都是新闻,串起来看是一条完整的产业信号:"判断"正在从"生成"里被剥离出来,成为一层独立的基础设施。 这篇文章把这条链路从头拆到尾。
一、先说 Jev:它是从哪来的,想解决什么问题
要看懂 Laya,得先看懂它要替代的那个东西。
Jev 出自 TypeSafe AI。 创始人 Diogo Almeida 是前 OpenAI 研究员,也是 RLHF(ChatGPT 背后那套"人类反馈强化学习")的共同发明者之一。他离开 OpenAI 两年后创立了 TypeSafe AI,公司已完成 4000 万美元种子轮融资。
他反复问的一个问题是:模型在对话上超越人类已经好几年了,那么自动化到底在哪里?
他自己的回答是:我们一直用最贵、最慢、最不确定的工具,去干最廉价、最需要确定性的活。路由一张工单、判断一条评论该不该拦、核对一张发票的字段——这些事情的答案从来不是一个段落,而是一个选项、一个分数、一个是或否。但今天的通行做法是:把整段文本发给前沿大模型,让它"按 JSON 格式输出",然后祈祷它这次不要多写一句解释、不要漏一个括号。
2026 年 9 月 15 日,TypeSafe AI 发布了 System One Models 这一新的模型类别,第一个成员就是 Jev。 这次发布的热度相当直观:
- 发布帖在 Hacker News 冲到 1715 分;
- 上线 36 小时内清掉了 14 万人的等候名单;
- 9 月 20 日官方宣布彻底取消 waitlist,新用户送 $5 额度(约合 1.2 亿 token);
- 定价 $0.042 / 百万输入 token,输出 token 免费——因为它的输出根本不是 token,没法按 token 计费;
- 端到端响应 70–500 ms,官方称比同形状任务上的前沿模型快 40–200 倍。
名字来自 19 世纪经济学家 William Stanley Jevons 和"杰文斯悖论":当一种资源的使用效率提升,它的总消耗量反而会上升。TypeSafe 的赌注很明确——当单次判断的成本趋近于零,判断的用量会暴涨,从而把机器智能塞进远比现在多的软件里。
为什么叫"System One"
名字取自 Daniel Kahneman 的双系统理论:System 1 是快速、直觉的判断;System 2 是缓慢、审慎的推理。
Chat 模型和推理模型都在追 System 2——一步一步想。Jev 做的是 System 1: 像一个熟练的客服扫一眼工单就知道该转给谁,一两秒内给出的那种判断。它不解释、不展开、不写理由,只给结论和把握程度。
它怎么干活:一次调用,一批判断
调用形态被压缩成两个概念:
- state:一段上下文。可以是一封邮件、一条工单、一条告警记录、一段 JSON,甚至是数组;
- questions:一组你事先定义好类型的问题。
模型一次前向传播(single forward pass)把整批问题全部算完,然后返回带概率的答案。没有 token 逐个采样,没有 JSON 需要修复,也没有"模型自作主张加了一句说明"的可能。
它的全部表达能力由三种原语构成:
它能干什么:三种原语,就是它的全部表达能力
| 原语 | 作用 | 返回 | 典型用法 |
|---|---|---|---|
choice |
从离散选项里挑一个 | 选中的选项 + 每个选项的概率分布 + 置信度 | 这个工单归 billing / technical / sales? |
score |
在固定等级上打分 | 一个数值(如 1.4 / 2.0)+ 分布 + 置信度 | 客户愤怒程度 0–2 打几分? |
noul |
是非判断 | 校准后的 P(true) | 这条消息是否要求退款? |
一次请求可以带多个问题(1Panel 的 Laya Server 限制为 1–50 个),全部在一次前向传播内并行算完——这是延迟能压到几十毫秒的根本原因。Jev 还支持最多 255 个选项的单选,选项更多时会改用"先打分、再选择"的两阶段方式处理。
关键一:它把"答案空间"提前锁死了
传统做法是在输出之后做校验:模型生成一段文本 → 解析 JSON → 失败重试 → 字段类型不对再修一遍。
Jev 的做法是在调用之前就把答案空间固定:程序声明"我要问什么、允许答什么",模型只负责在约束内填概率。由此得到两个结果:
- 它不可能返回错误的类型或畸形结构——这是构造性保证(by construction),不是"训练出来的好习惯";
- 但它依然可以判错:把 billing 判成 technical,把 0.9 的置信度给了一个错误答案,都在正常范围内。
一句话:它保证的是"答案合法",不是"答案正确"。 The Register 对 Jev 的点评很准确:这算不上公平的比较,因为它的输出根本不是自然语言——而且这并不排除答案错误的可能。
这也是它和 Outlines、XGrammar、Instructor 这类结构化输出工具的根本区别:那些工具约束的是生成出来的 token,Jev 干脆取消了生成这一步。
关键二:置信度才是"判断能进生产"的前提
一个判断值不值得交给机器,取决于你能不能知道它有多确定。
Jev 和 Laya 都用 RLCD(Reinforcement Learning for Calibrated Decisions) 训练:奖励函数是一个严格 proper scoring rule——只有当模型诚实地报告自己的概率时,期望奖励才最大。翻译成人话:
如果模型说"我有 0.9 的把握",那么在统计学上,它就应该大约每十次错一次。
校准到这个程度,置信度才是一个可以用来设阈值的数字,而不是一个 vibe。于是你的代码可以写成:
if conf >= 0.85:
    route_automatically(dept)      # 高置信度:自动执行
else:
    escalate_to_human(dept)        # 低置信度:转人工,或升级到大模型
"自动化处理大多数 + 阈值兜底少数",才是决策模型真正的产品形态。 它不承诺全自动,它承诺的是用一个你事先调过的阈值,把大部分低风险判断自动处理掉,把剩下的少数交给人和大模型。
所以,Jev 到底解决了什么
把上面三节合起来看,它一次性动了四层:
| 层面 | 改变了什么 | 效果 |
|---|---|---|
| 接口层 | 把"要判断什么"变成结构化声明,答案空间提前锁死 | 不再有解析失败和格式错乱 |
| 性能层 | 不做自回归生成,一次前向算完整批问题 | 从秒级降到几十毫秒 |
| 成本层 | 输出不按 token 计费,单价 $0.042/百万输入 | 判断便宜到可以随手加进业务链路 |
| 可靠性层 | 置信度经过校准 | 可以用阈值切分"自动处理"与"转人工" |
但它是闭源的:只能调 API,数据要出网,早期还要排队等额度。这个缺口存在了三天。
二、Laya:三天后,有人把这条路开源了
Laya 由 Convai Innovations 于 2026 年 9 月 18 日发布——距 Jev 发布只隔了三天。Apache 2.0 许可,权重、代码、训练数据全部公开,GitHub star 在发布后一周内冲到 24.7k,Hacker News 560 分。
它的定位毫不含糊:同一条技术路线上的开源对手。接口设计几乎一比一对应,自托管服务还刻意兼容了 Jev 的线协议——意思很明确,直接替换就行。
它发布了三个 checkpoint:
| Checkpoint | 基座 | 参数量 | 上下文 | 语言 | 说明 |
|---|---|---|---|---|---|
laya |
ModernBERT-large | 421M | 512 tokens | 英文 | 基础版 |
laya-multilingual |
mmBERT-base | 322M | 1024 tokens | 100+ 语言 | 中文场景用这个 |
laya-typed-decisions |
ModernBERT-large | 421M | 512 tokens | 英文 | 在四个合成工作流上微调:客服、发票处理、安全事件、Agent trace 观测 |
安装只需一行,权重首次使用时从 Hugging Face 拉取:
pip install laya # 另有 [serve] [mcp] [langchain] [onnx] [fast] 等可选扩展
Router:不让你操心选哪个 checkpoint
from laya import Router
router = Router()
router.predict(state, questions)                    # 自动按语种选
router.predict(state, questions, model="typed-decisions")
router.predict(state, questions, lang="de")         # 也可以显式指定
Router 懒加载 checkpoint,非英文输入自动路由到多语言版本,并且会解释自己的选择。生产环境可以用 preload=True 预加载、限制常驻数量,或全部卸载。
内置 presets:开箱即用的四类判断
router(模型路由)、guard(提示词护栏)、moderation(内容审核)、triage(工单分诊)。CLI 里直接可用:
laya "My payment failed twice" --preset triage
注意:只做路由判断时不会下载 checkpoint,所以这一条命令是毫秒级返回的。
速度到底多快
| 场景 | 数值 | 说明 |
|---|---|---|
| T4 GPU,单请求 p50 | 32.8 ms | 多语言 checkpoint,厂商自测 |
| T4 GPU,421M 英文版 | 约 39.5 ms | 厂商自测 |
| CPU | 193–464 ms | 官方 Router preload 测量 |
| Apple M5 Pro | 中位 15.3 ms | 社区报告,对照组云端 Jev 为 298.1 ms |
| 批量 10 个问题 | 约 7 ms / 问题 | 一次前向摊销 |
这些数字全部来自项目方或社区自测,目前没有第三方在同一条件下复现过,阅读时请打个折。 但即便打折,几十毫秒量级 vs 大模型几百毫秒到数秒量级,差距是结构性的,不是优化出来的。
三、Laya vs Jev:一张表,和三个必须澄清的点
先上对比表。
| 维度 | Jev(TypeSafe AI) | Laya(Convai Innovations) |
|---|---|---|
| 发布时间 | 2026-09-15 | 2026-09-18(晚 3 天) |
| 开源性 | 闭源,仅 API | Apache 2.0,权重/代码/数据全公开 |
| 部署形态 | 云端 API | 本地 / 离线 / CPU / Apple 芯片 / GPU |
| 定价 | $0.042 / 百万输入 token,输出免费 | 自托管 $0 |
| 延迟 p50 | 236–276 ms | 32.8 ms(约 7.8x) |
| typed-decisions 准确率 | Jev 1.13.0:0.727 | Laya 微调版:0.766 |
| Brier score | — | 0.062(项目方称为 Jev 的 2.4x 优势) |
| 高基数分类 | 更强(Banking77:0.870) | 更弱(0.425,超过 20 类明显下滑) |
| 选项基数上限 | 255 | 无官方上限,但高基数表现弱 |
| 可审计 / 可微调 | 黑盒,不可 | 可自行审计、微调、改造 |
| 数据隐私 | 上传第三方服务器 | 数据完全不出域 |
| 接口兼容 | — | 刻意兼容 Jev 线协议,改 Base URL 即可替换 |
澄清一:0.766 这个数字,不是你开箱能拿到的
这是最容易被误读的一点,Laya 的 model card 自己写得很直白:
- 零样本 typed-decisions 准确率:0.362(多语言版 0.352)
- 随机基线 0.318,多数类基线 0.461——也就是说零样本的 Laya 连"永远猜最多那一类"都不如
- 那个 0.766,属于在该基准自己的训练集上微调过的 checkpoint
原话是:"Laya is a fast base to specialise, not a zero-shot decision engine."(Laya 是一个可快速特化的底座,不是一个开箱即用的零样本决策引擎。)
同理,校准也是开箱不可信的:逐题型重拟合一个温度参数后,平均 ECE 从 0.466 降到 0.081。不做这一步,置信度数字不能拿来设阈值。
澄清二:"晚三天"不等于"抄了三天"
网上流传的"Laya 比 Jev 晚三天发布"是事实,但据此推断"三天复刻"是错的。项目方公开的说法是:其论文工作早于 Jev 发布约一年半,发布日期的先后不反映真实研发时间。(此为项目方说法,未见第三方核实,读者自行判断。)
澄清三:Jev 的真实成本优势,取决于弃权率
这条比参数对比重要得多,来自第三方在 Jev 发布后五天内的独立测算:
- TypeSafe 宣传的 444.6x,是对着当时最贵的 Claude Opus 5 比出来的,不是平均值;
- 五家第三方实测的成本优势分别是 8.6x、45x、58x、274x、约 580x,跨度两个数量级;
- 更关键的是弃权率(abstain rate):在一条真实生产队列上,Jev 弃权率约 30%,每一次弃权都要升级到被它替代的那个大模型。于是 76x 的优势被稀释成 3.2x。
数学上很干净:成本优势的上限 = 1 / 弃权率。无论单价多便宜,只要有 30% 的判断要回退给大模型,整体最多省 3.3 倍。
这条规律对 Laya 同样成立——自托管只省掉了单价,不省掉弃权。所以真正决定 ROI 的,从来不是"一次判断多少钱",而是"你自己的数据能把弃权率压到多少"。这也直接指向下一节。
四、价值:它改变的不是某一次调用,而是三层结构
第一层:成本结构——把最贵的工具从最廉价的活上撤下来
分类、路由、打分这类活,目前在绝大多数系统里是用最贵的工具(前沿 LLM)干的。Jev 官方的四个 workflow eval 显示,Jev 以 67.8% 的一致率、约 $0.0004 / 0.4 秒完成,而 GPT-5.6 Sol 是 74.1% / $0.0836 / 23.3 秒,Claude Opus 5 是 73.1% / $0.1761 / 37.8 秒。
质量略降 6 个点,成本和延迟降两个数量级。 这就是这笔交易的形状——它不是一个"更好的模型",而是一个"便宜到可以随便用"的判断层。
关键在于:便宜之后,很多原本"算了太贵不做了"的判断就变得可做。这正是 Jev 名字的来源——经济学家 William Stanley Jevons 与杰文斯悖论:当一种资源的使用效率提高,它的总消耗量反而会上升。 TypeSafe 的赌注是:当单次判断的成本趋近于零,判断的用量会暴涨,从而把机器智能塞进远比现在多的软件里。
第二层:部署形态——判断层可以放在数据不出域的地方
闭源 API 意味着每一条待判断的文本(客服工单、合同、病历、告警记录)都要出网。对小团队这可能无所谓,对金融、医疗、法务、政企,这一条经常是一票否决。
Laya 自托管后,判断这一层完全在内网闭环:不出网、不计费、不排队、不受供应商限流影响。 322M 参数的多语言版,CPU 就能跑。
第三层:架构位置——LLM 负责思考,决策模型负责判断
这是最有长期价值的一点。一个健康的 Agent 或 AI 应用栈,应该是分层的:
用户请求
   ↓
决策层(Laya / Jev):几十毫秒,判断"这是什么类型的问题"、"风险高不高"、"要不要拦"
   ↓
执行层(大模型 / 业务代码):只在需要生成、推理、创作时才被调用
   ↓
复核层(决策模型):验证上一步的输出是否合规、是否需要重试
Laya 内置的 presets 里,router(模型路由)、guard(提示词护栏)、moderation(内容审核)三个,正是为这个分层准备的。
五、应用场景:一份带边界的清单
✅ 适合上
| 场景 | 为什么合适 |
|---|---|
| 工单 / 邮件自动分派 | choice 原语直接对应"归哪个部门",低基数,置信度可阈值化,低置信度转人工 |
| 垃圾邮件 / 广告 / 钓鱼检测 | 二元判断,高频,项目方给出的微调后示例数据在 98%–99% 量级(厂商自测) |
| 提示词注入与护栏审核 | 每个请求都要过,延迟预算极紧;用大模型做这件事本身就是浪费 |
| 客服情绪 / 优先级打分 | score 原语天然适配,输出可直接进入排序逻辑 |
| 发票 / 表单结构化校验 | 字段多、判断杂,一次请求带几十个问题并行算完 |
| Agent trace 观测 | 判断一步 trace 是否异常、是否需要重试,比让 LLM 复盘便宜得多 |
| LLM 输出的自动复核 | 用便宜的模型给贵的模型"批改作业" |
❌ 不适合上
| 场景 | 为什么不合适 |
|---|---|
| 开箱即用做零样本分类 | 零样本 0.362,接近随机,低于多数类基线 0.461 |
| 类别数超过 20 | Banking77 上只有 0.425,高基数明显崩 |
| 需要输出理由或自然语言 | 它根本不生成文本 |
| 聊天、算术、日期比较 | 明确超出能力范围 |
| 非英文场景且不打算微调 | 多语言版在 MASSIVE Intent(51 语言)macro 平均只有 0.227——100+ 语言买的是"能覆盖",不是"判得准" |
| 置信度开箱即用 | ECE 0.466,必须先逐题型拟合温度 |
一句话:把它当成"微调底座",而不是"现成产品"。 项目方自己也这么说。
六、实战:用 Laya Server 给 1Panel AI 网关做智能路由
前面都是"为什么",这一节是"怎么做"。
6.0 Laya Server 是什么:给 Laya 模型套一层可运维管理的壳
Laya 本身是个 Python 库,要用它得写代码。Laya Server(1Panel-dev/laya-server,2026-09-23 开源,09-24 上架 1Panel 应用商店)干的事就是把它变成一个开箱即用的服务:
/v1/systemone接口,兼容 Jev 线协议——已有 Jev 客户端改 Base URL 即可切换,三类问题可批量一次调用;- 镜像内置 multilingual 模型——拉下来就能跑,不用另外下载权重;
- 网页管理控制台——管理 API Key、在线 Playground 调试、查看用量统计,界面支持简体中文、English、繁體中文;
- 技术栈:FastAPI + SQLite 后端,React + Vite + TypeScript + shadcn/ui 前端;
- 安全设计:管理员口令用 Argon2id 存储,登录有限流与 CSRF 防护,API Key 只存 SHA-256 摘要;密钥只完整显示一次,泄露后在控制台点"撤销"重建即可,不需要动上游凭据。
顺带一提,Laya 的开源生态在发布一周内就已经长起来了:laya-mlx(Apple Silicon 原生 MLX 运行时,7–14 ms,6.4k star)、receptron/laya(Node.js / TypeScript 调用)、ollaya(Rust,本地拉取并服务多种决策模型)、alvarobartt/sys1(Rust 实现的 System One 兼容 API),以及官方自带的 MCP 服务器(pip install "laya[mcp]",Claude Desktop / Cursor 可直接把 typed decision 当工具调用:laya_predict、laya_route、laya_preset、laya_status)。
一个有生命力的开源项目,看它的第三方运行时长得有多快,比看 star 数更准。
6.1 为什么这个组合值得做:两种路由模式
1Panel AI 网关的智能路由提供了两种路由模式,可以在同一页切换:
| 路由模式 | 判定引擎 | 额外依赖 |
|---|---|---|
| 本地/向量 | Embedding 语义相似度 + 规则兜底 | 需单独部署 Embedding 服务 |
| 模型决策(Jev) | 由外部决策服务返回 typed decision(这里就是 Laya) | 一个 laya-server 容器 |
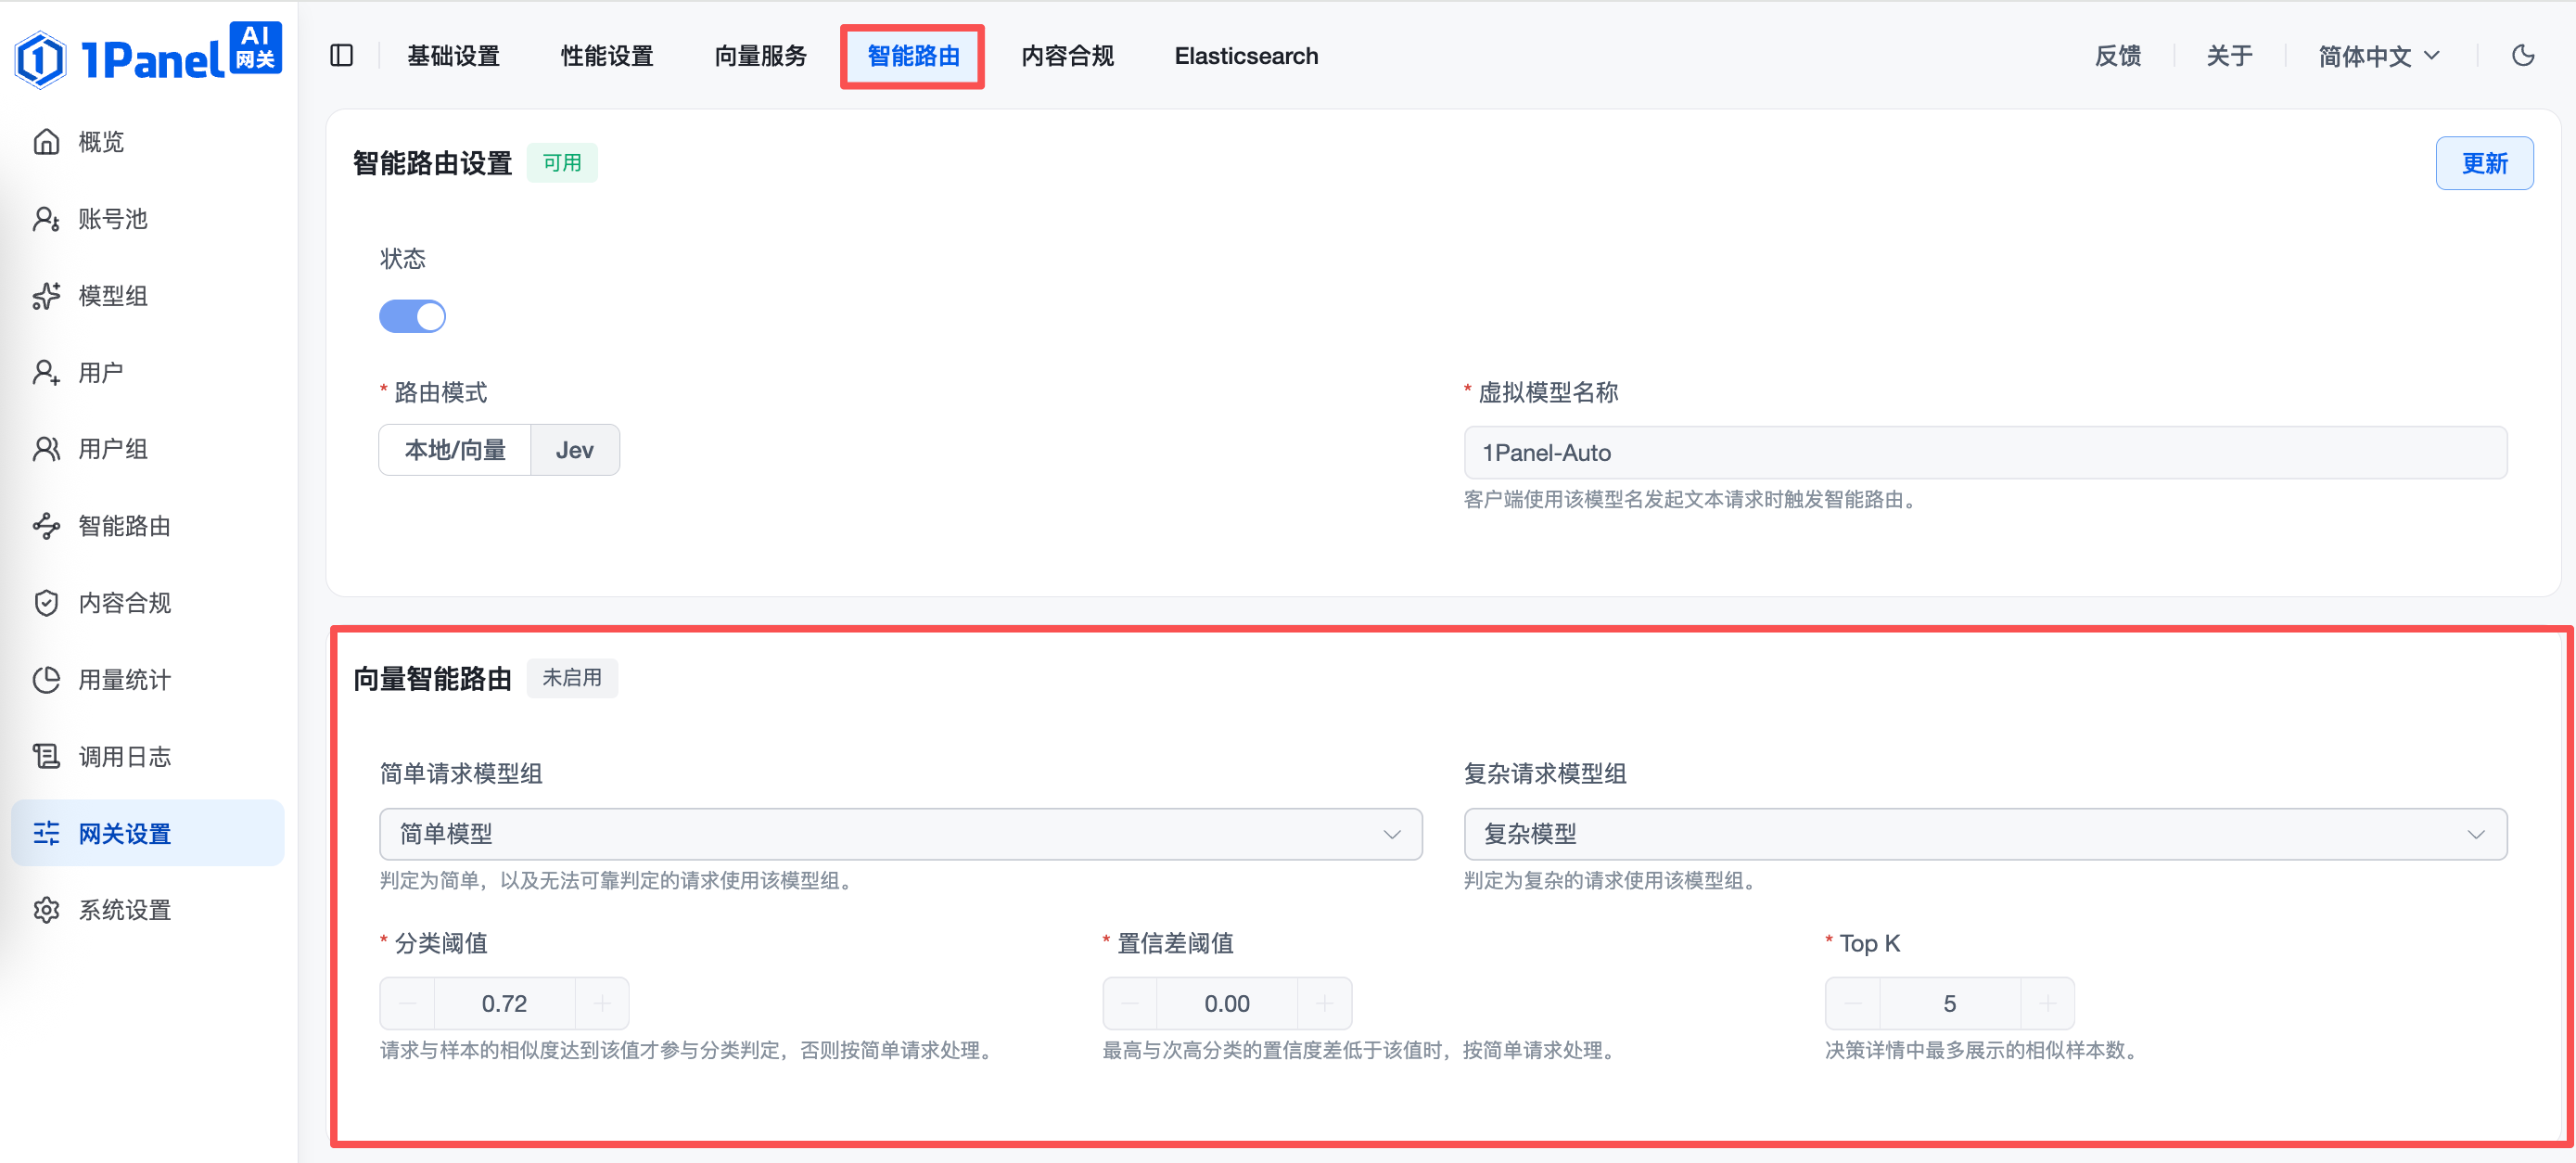
选中"模型决策"(即 Jev 模式)后,下方整块"向量智能路由"参数会置为未启用;上方的虚拟模型名称默认是 1Panel-Auto(可配置),只有客户端用这个模型名发起请求时才会触发智能路由——用其他模型名请求时,网关按普通链路直接转发。
先看传统的向量模式,它的判定链路是:
- 用 Embedding 模型把用户输入向量化;
- 与预置的"简单样本 / 复杂样本"算相似度;
- 最高相似度 ≥ 路由阈值(如 0.72)就采纳该样本标签,否则走规则兜底(问题长度、关键词、多步表达等)。
样本库长这样——188 条样本,每条挂着一个 1024 维向量:
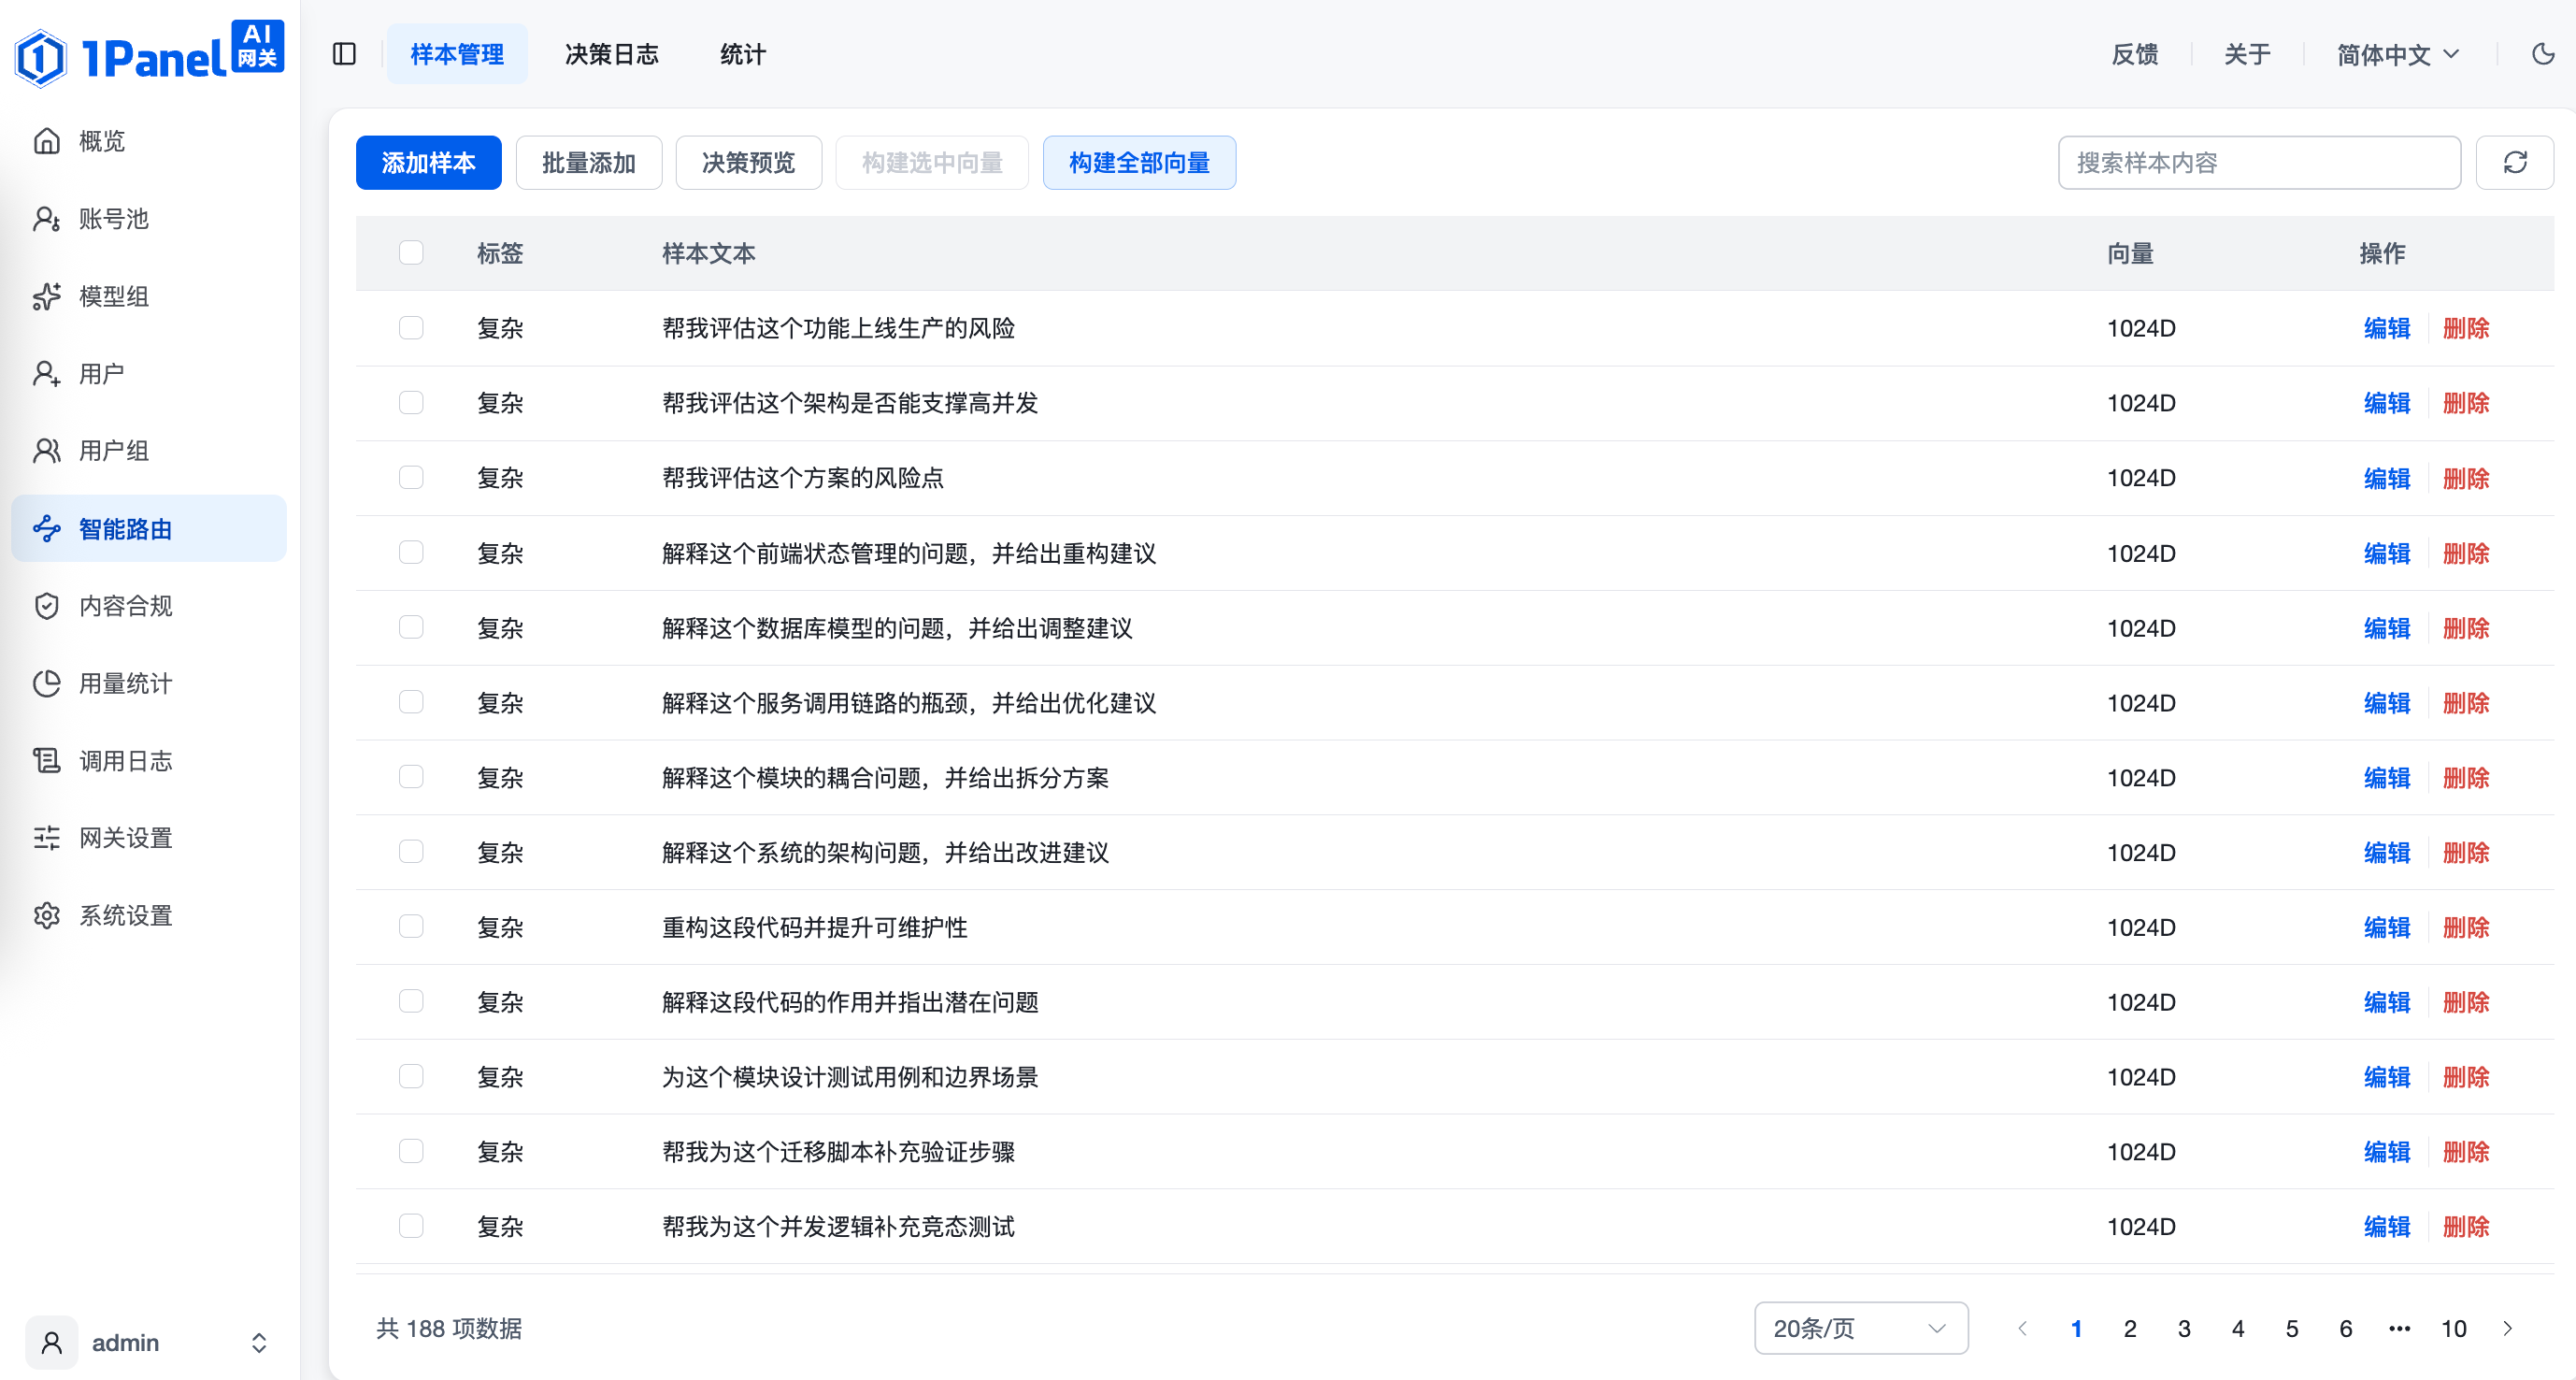
这套机制能跑,但有几处实打实的摩擦:
- 要额外部署一个 Embedding 服务(官方文档的示例是下载 Qwen3-Embedding-0.6B-GGUF,再用 llama.cpp 起一个服务);
- 要维护样本库:188 条只是一个起点,每冒出一类新请求就要补样本;而且每次改 Embedding 地址、模型或阈值 / TopK,都必须回样本页重建向量(图中"构建选中向量 / 构建全部向量"两个按钮就是干这个的);
- 判定结果本质上是二选一,想扩到三个以上的模型组并不自然。
用 Laya 做决策器,这几处摩擦基本消失:
| 维度 | Embedding 相似度路由 | Laya 决策服务路由 |
|---|---|---|
| 外部依赖 | 需额外部署 Embedding 模型与服务 | 一个 laya-server 容器,镜像已内置 multilingual 模型 |
| 配置方式 | 标注样本 + 调阈值 / TopK | 用自然语言写"适用说明 / 排除说明" |
| 样本维护 | 改配置后需重建向量 | 无向量,改完即生效 |
| 判定输出 | 简单 / 复杂二分类 + 相似度 | 多目标 choice + 置信度,可扩展到 N 个模型组 |
| 决策耗时 | Embedding 推理 + 相似度检索 | 实测 356 ms ~ 2.8 s(CPU 部署) |
| 失败处理 | 规则兜底 | 显式配置兜底模型组 |
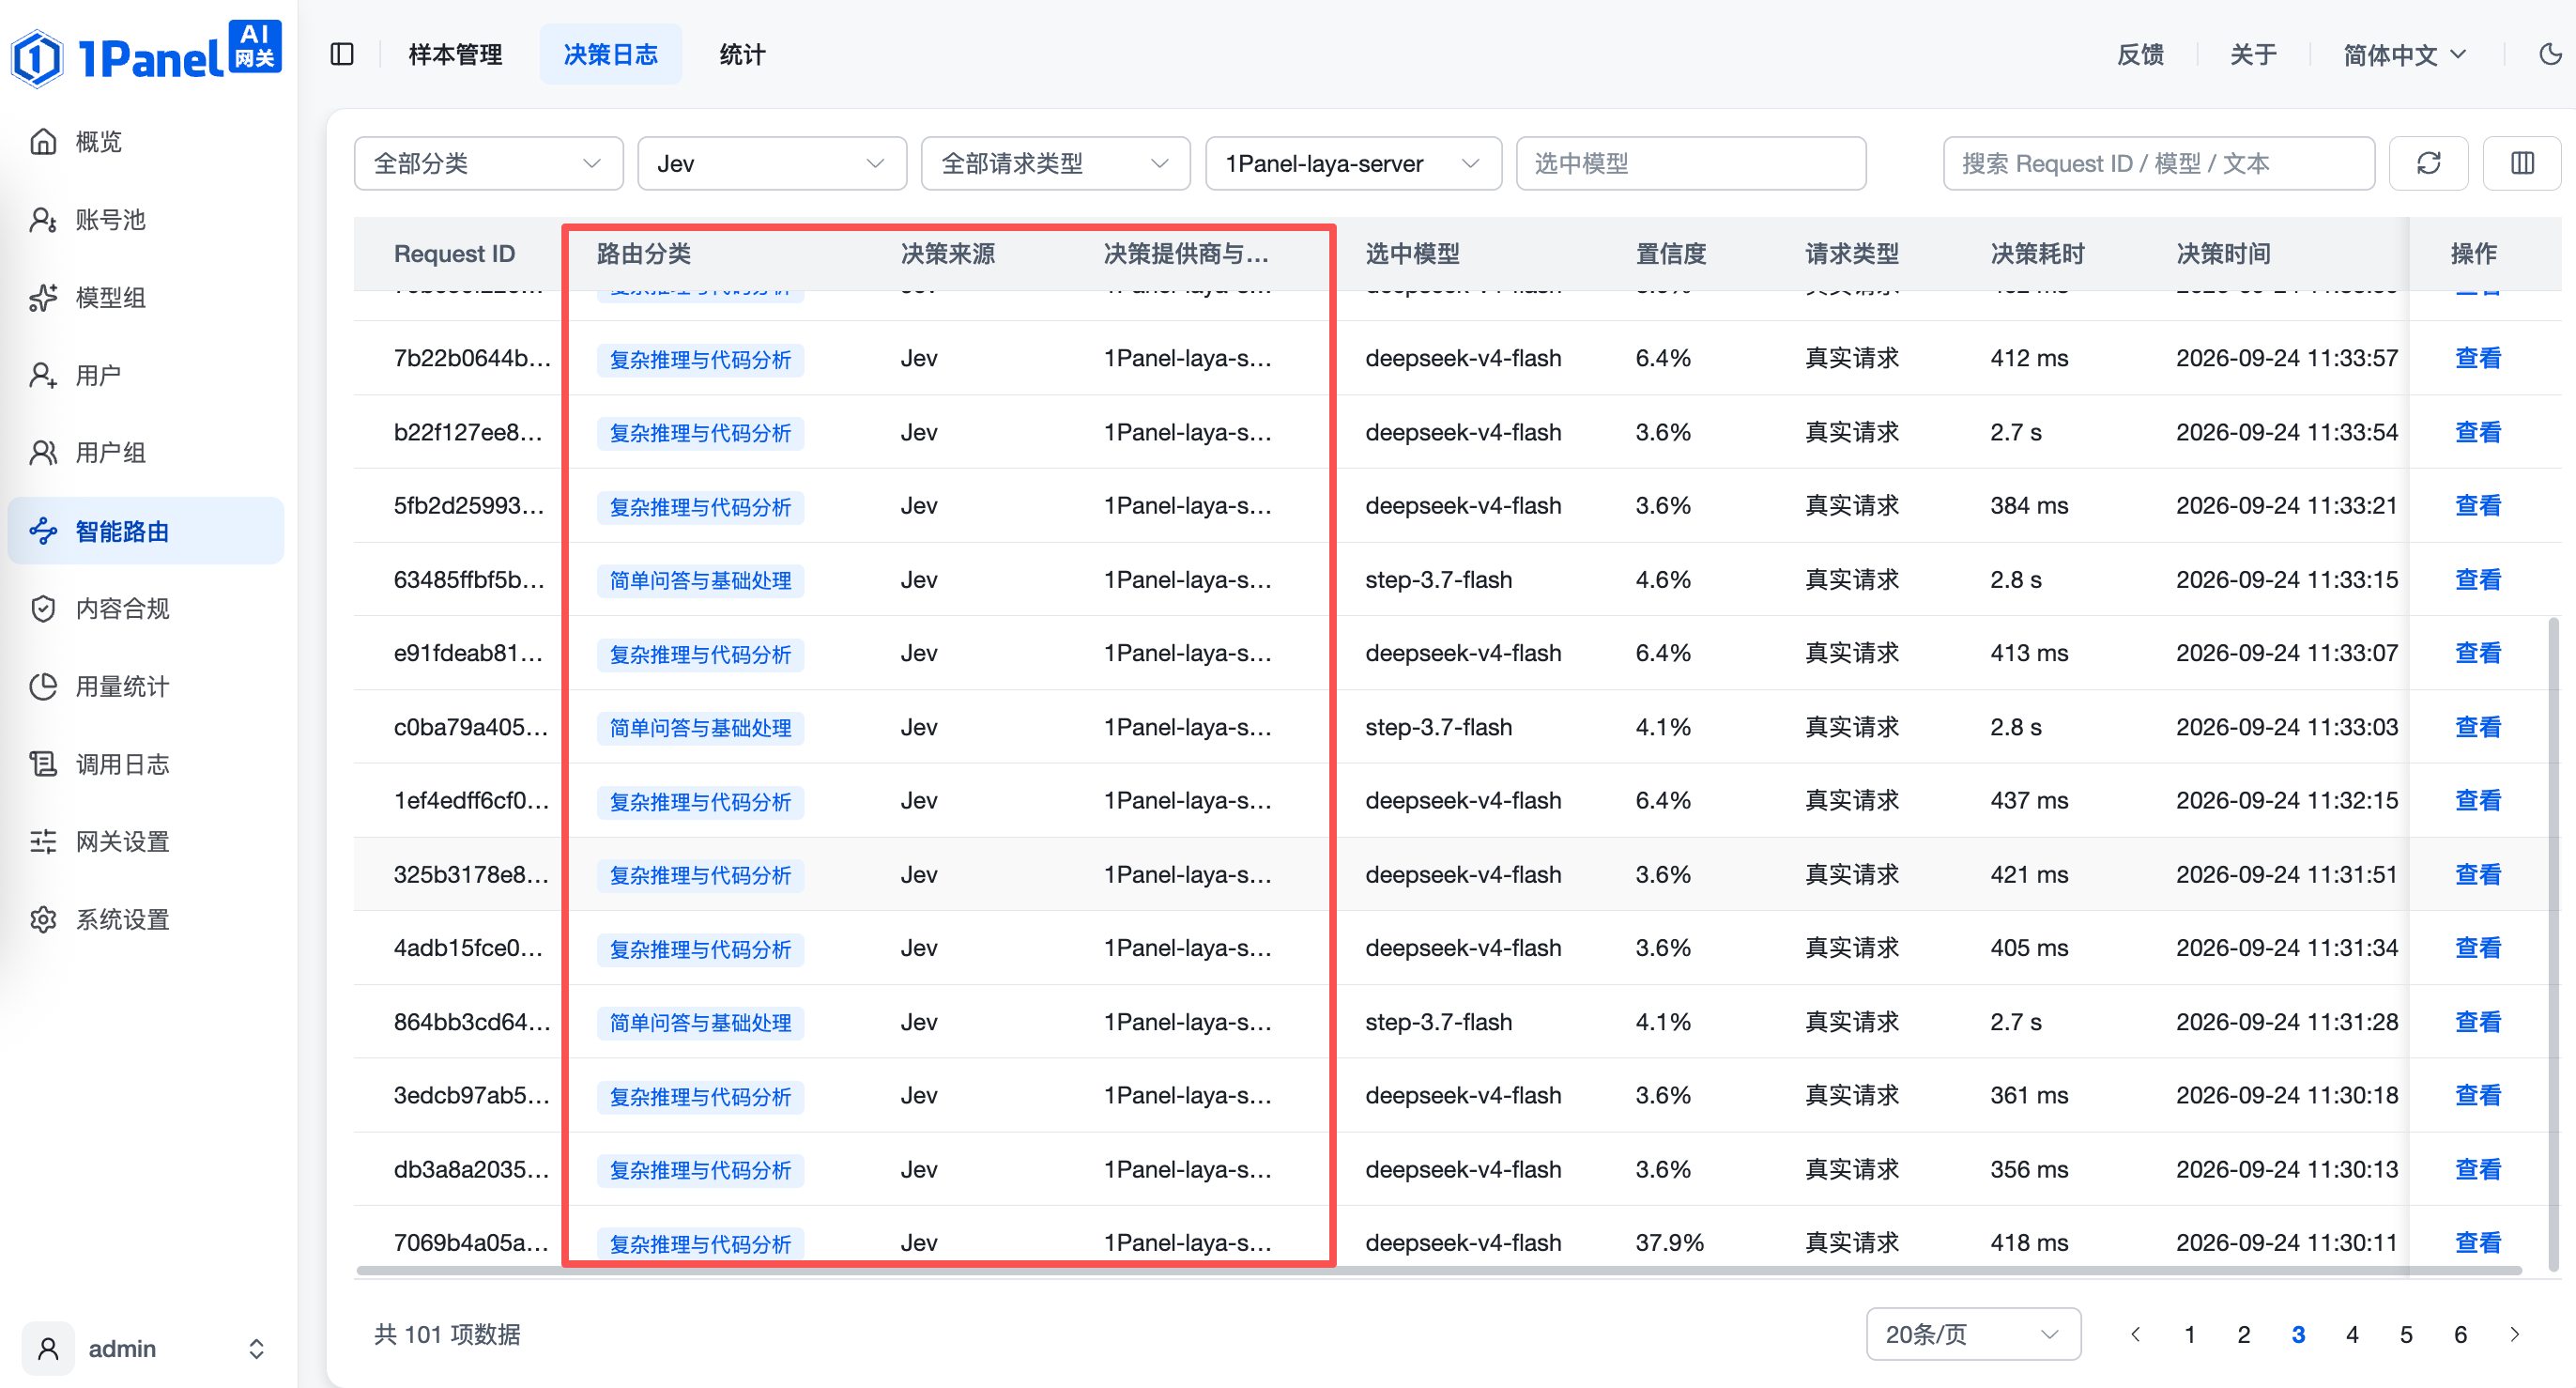
这份决策日志把整条链路都摊开了:左半部分是 Laya 的判定结果(路由分类、决策来源 Jev、决策提供商 1Panel-laya-server),右半部分是最终落到哪个模型、置信度多少、这次决策本身花了多久。图里有三个数字值得留意——101 条决策记录的耗时落在 356–437 ms 和 2.7–2.8 s 两个区间,远高于 T4 上 32.8 ms 的基准,CPU 部署时这是每一次请求都要付的成本;置信度大多只有 3.6%–6.4%,正好印证了前面"必须重拟合温度"那条;但分流本身是准的,简单请求稳定落到 step-3.7-flash、复杂请求稳定落到 deepseek-v4-flash,两个路由目标没有串台。
版本说明:「本地/向量」与「模型决策」(Jev)两种路由模式在 AI 网关当前版本中并存,可随时切回。向量模式的能力没有被移除——它仍然是纯本地、零外部依赖场景下的首选。
6.2 第一步:装 Laya Server
方式一:1Panel 应用商店(推荐)
1Panel → 应用商店 → 搜索 "Laya" → 安装 Laya Server(当前版本 0.1.0)。
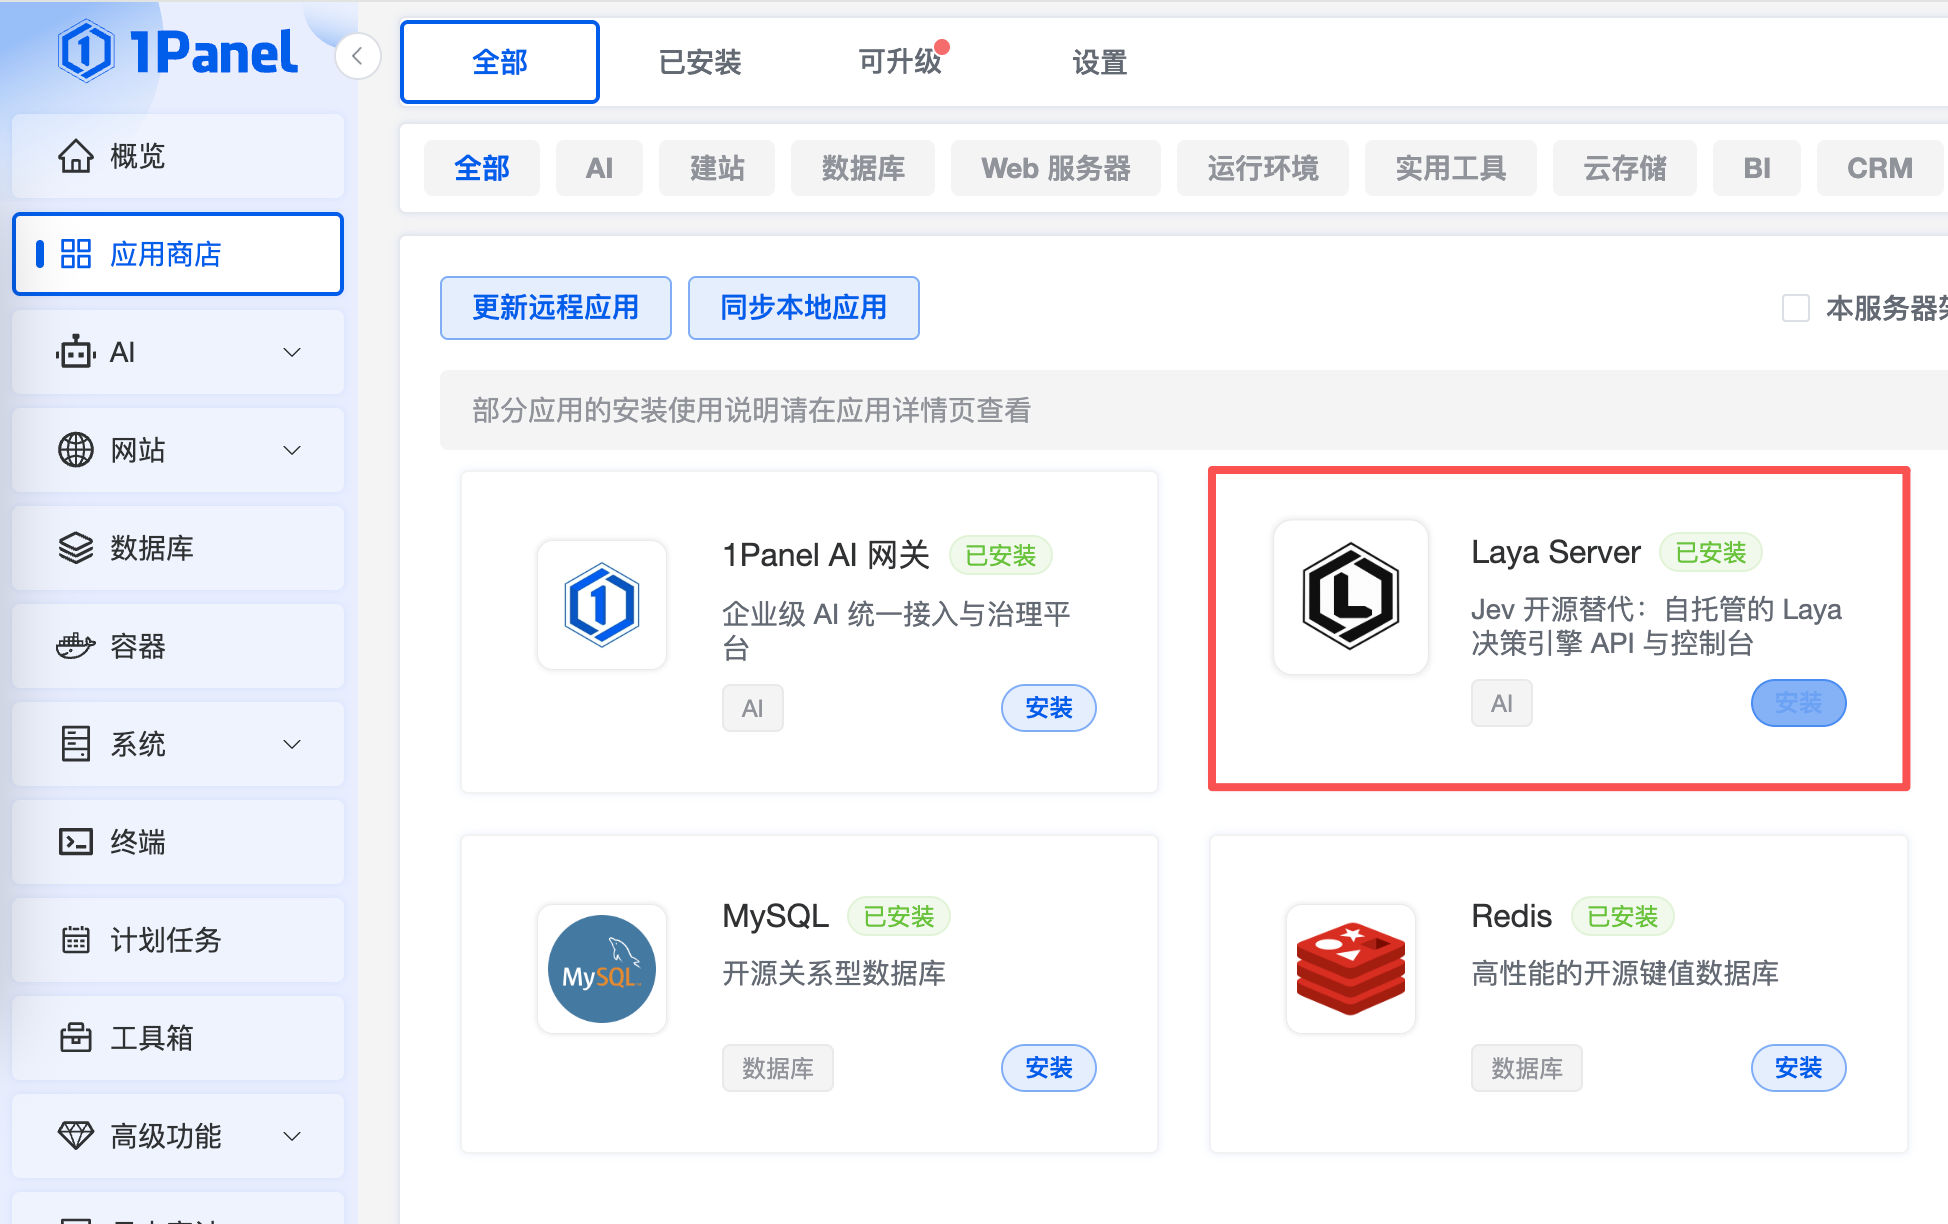
| 配置项 | 示例值 |
|---|---|
| 名称 | laya-server |
| 版本 | 0.1.0 |
| Web UI 端口 | 8080(外网映射端口按实际情况,如 20000) |
| 管理员用户名 | admin |
| 管理员密码 | 至少 10 位的强密码 |
无需 GPU,CPU 即可运行;镜像已内置 multilingual 模型,装完不用再下载权重。
方式二:Docker 独立部署
docker run -d --name laya-server --init --restart unless-stopped \
  -p 8080:8080 \
  -v laya-data:/data \
  -e LAYA_ADMIN_USERNAME=admin \
  -e LAYA_ADMIN_PASSWORD='your-strong-password' \
  1panel/laya-server:latest
安全提示:8080 端口建议只放内网可信环境;要对外提供服务,在 1Panel「网站」里建一个反向代理并开启 HTTPS。
6.3 第二步:拿 API Key
浏览器打开 http://服务器IP:端口,用 admin 登录(右上角可切换简体中文 / English / 繁體中文)。
左侧菜单 API Keys → 创建密钥 → 填个名字(如"AI 网关")→ 创建。
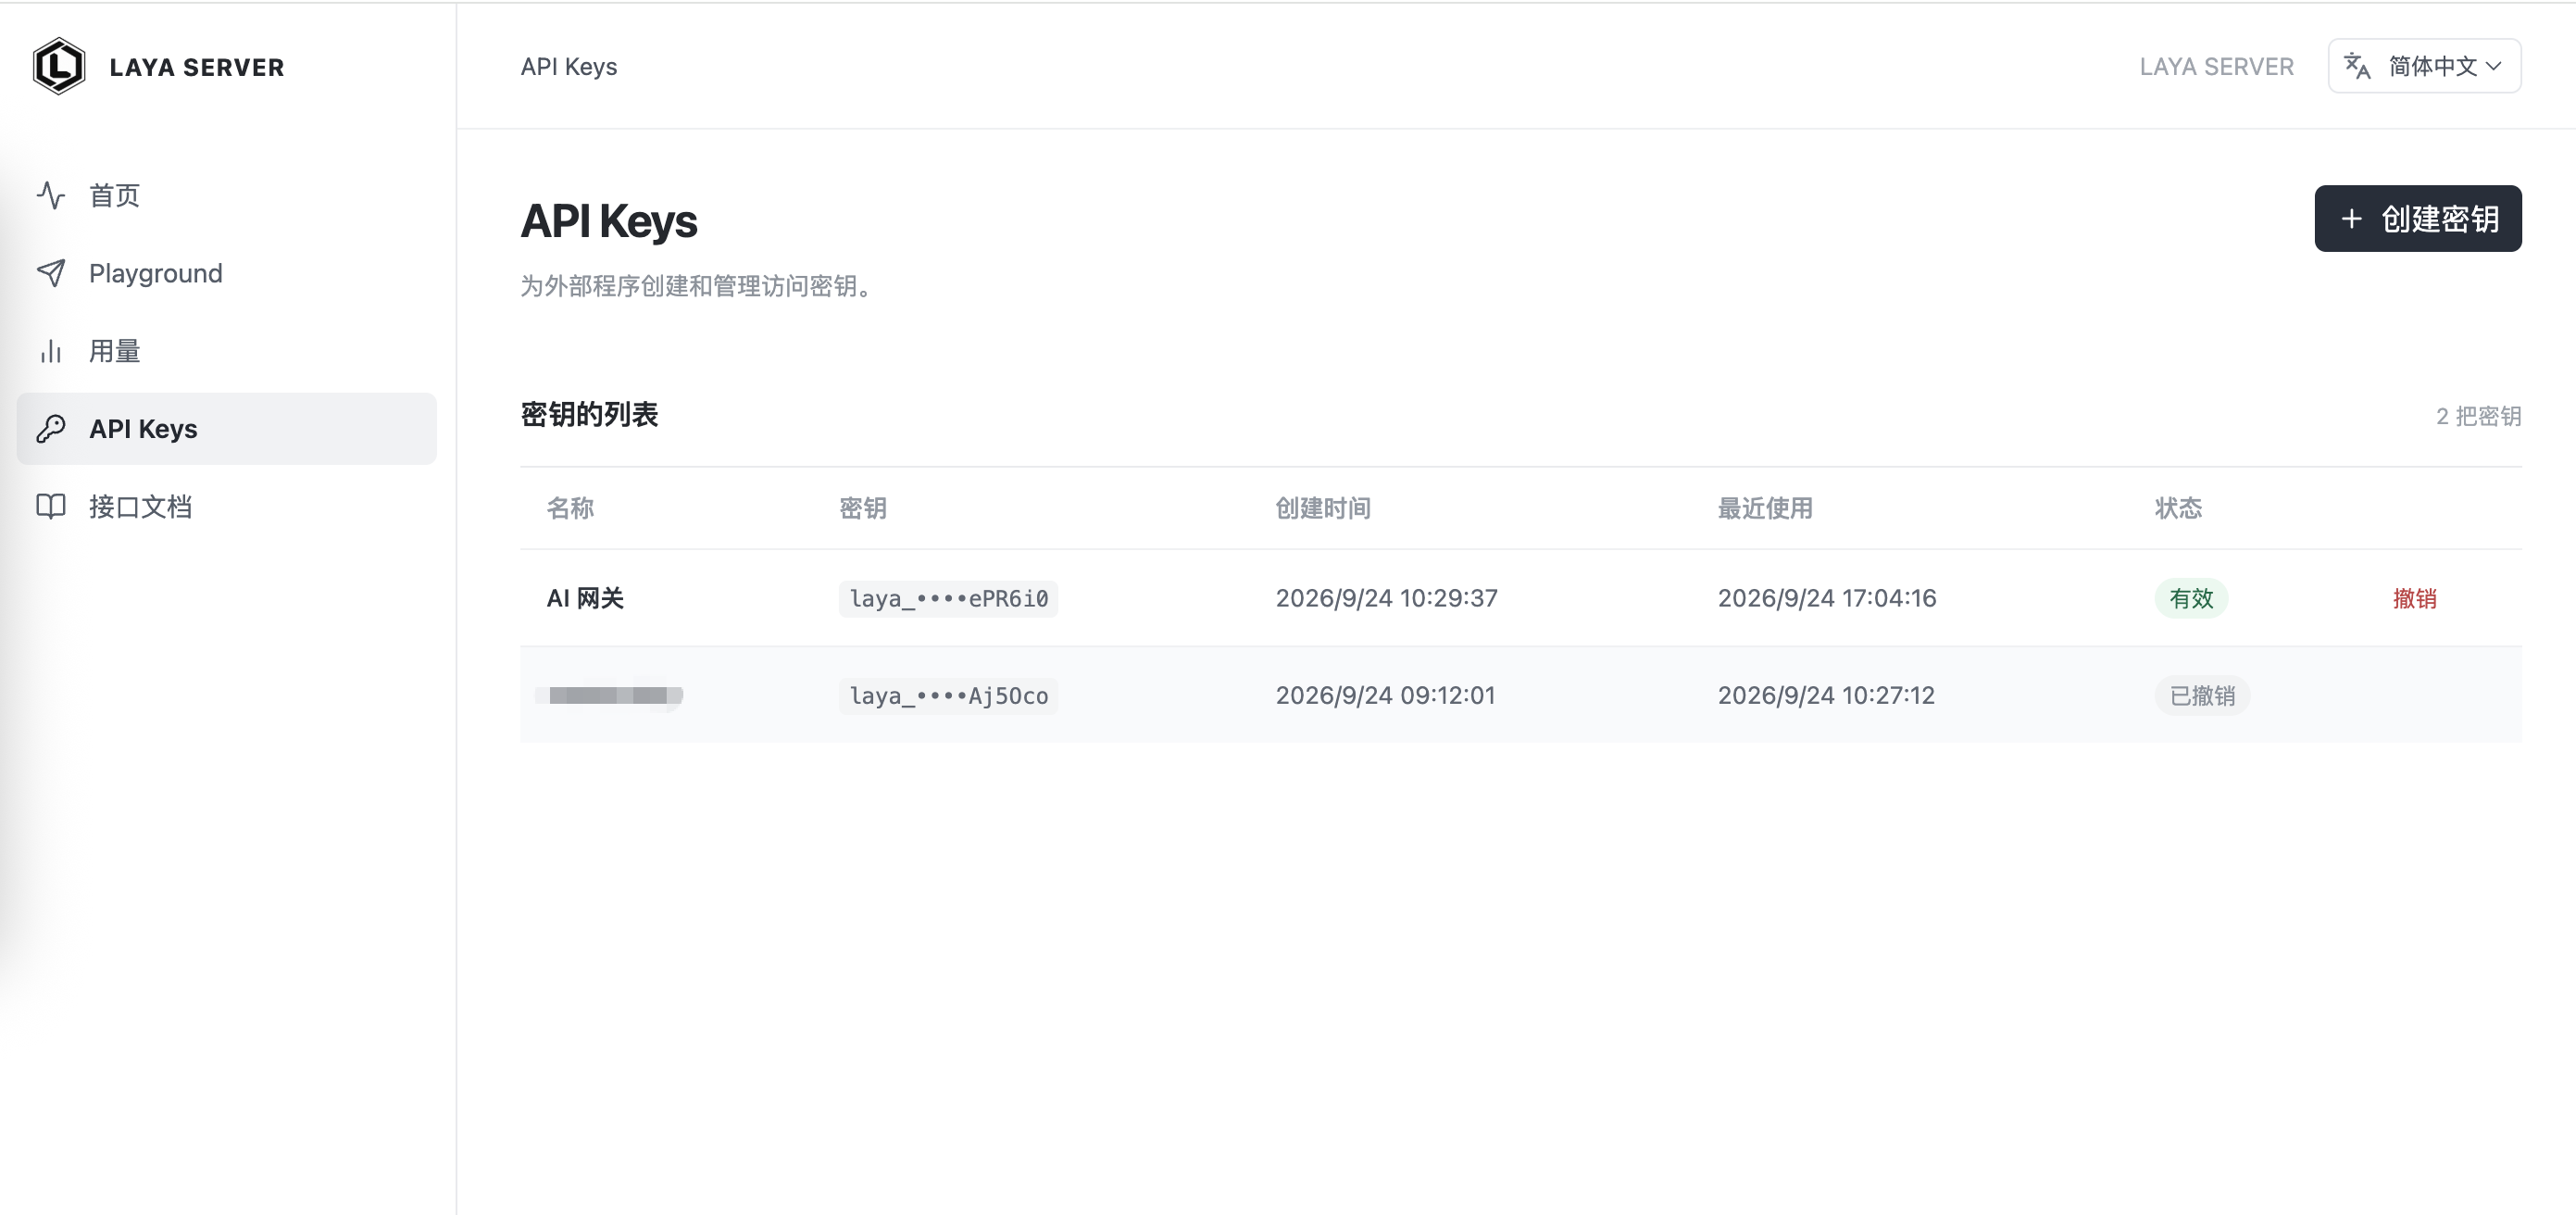
建完的列表长这样:名称、掩码后的密钥、创建时间、最近使用时间、状态一目了然——"有效"的密钥右侧可以直接点"撤销"。
四个注意点:
- 完整密钥只显示一次,之后只能看到掩码,务必当场复制保存;
- 按用途给密钥命名。 截图里那把叫「AI 网关」的密钥就是专门配给网关用的——一把密钥一个用途,出问题只撤销这一把,其他调用不受影响。这也是它比"所有系统共用一把主密钥"更安全的地方;
- 服务端只保存 SHA-256 摘要,泄露了就在列表里撤销重建,不需要动上游主密钥;
- 想先验证再写代码,用左侧 Playground:填 state、加问题(选 choice / score / noul、填选项或等级、写判断说明)、Model 选
auto或multilingual,点"运行推理"即可看到 answers 与 usage。左侧还有「接口文档」页,可以直接查/v1/systemone的完整参数与状态码。
6.4 第三步:到 AI 网关里把智能路由切到 Jev 模式
进 AI → AI 网关 → 网关设置 → 智能路由,把「路由模式」从 本地/向量 切成 模型决策(也就是 Jev 模式),然后填三样东西:刚部署好的 Laya Server 服务地址、刚才创建的 API Key,以及 Laya 判断失败时要调用的兜底模型组。
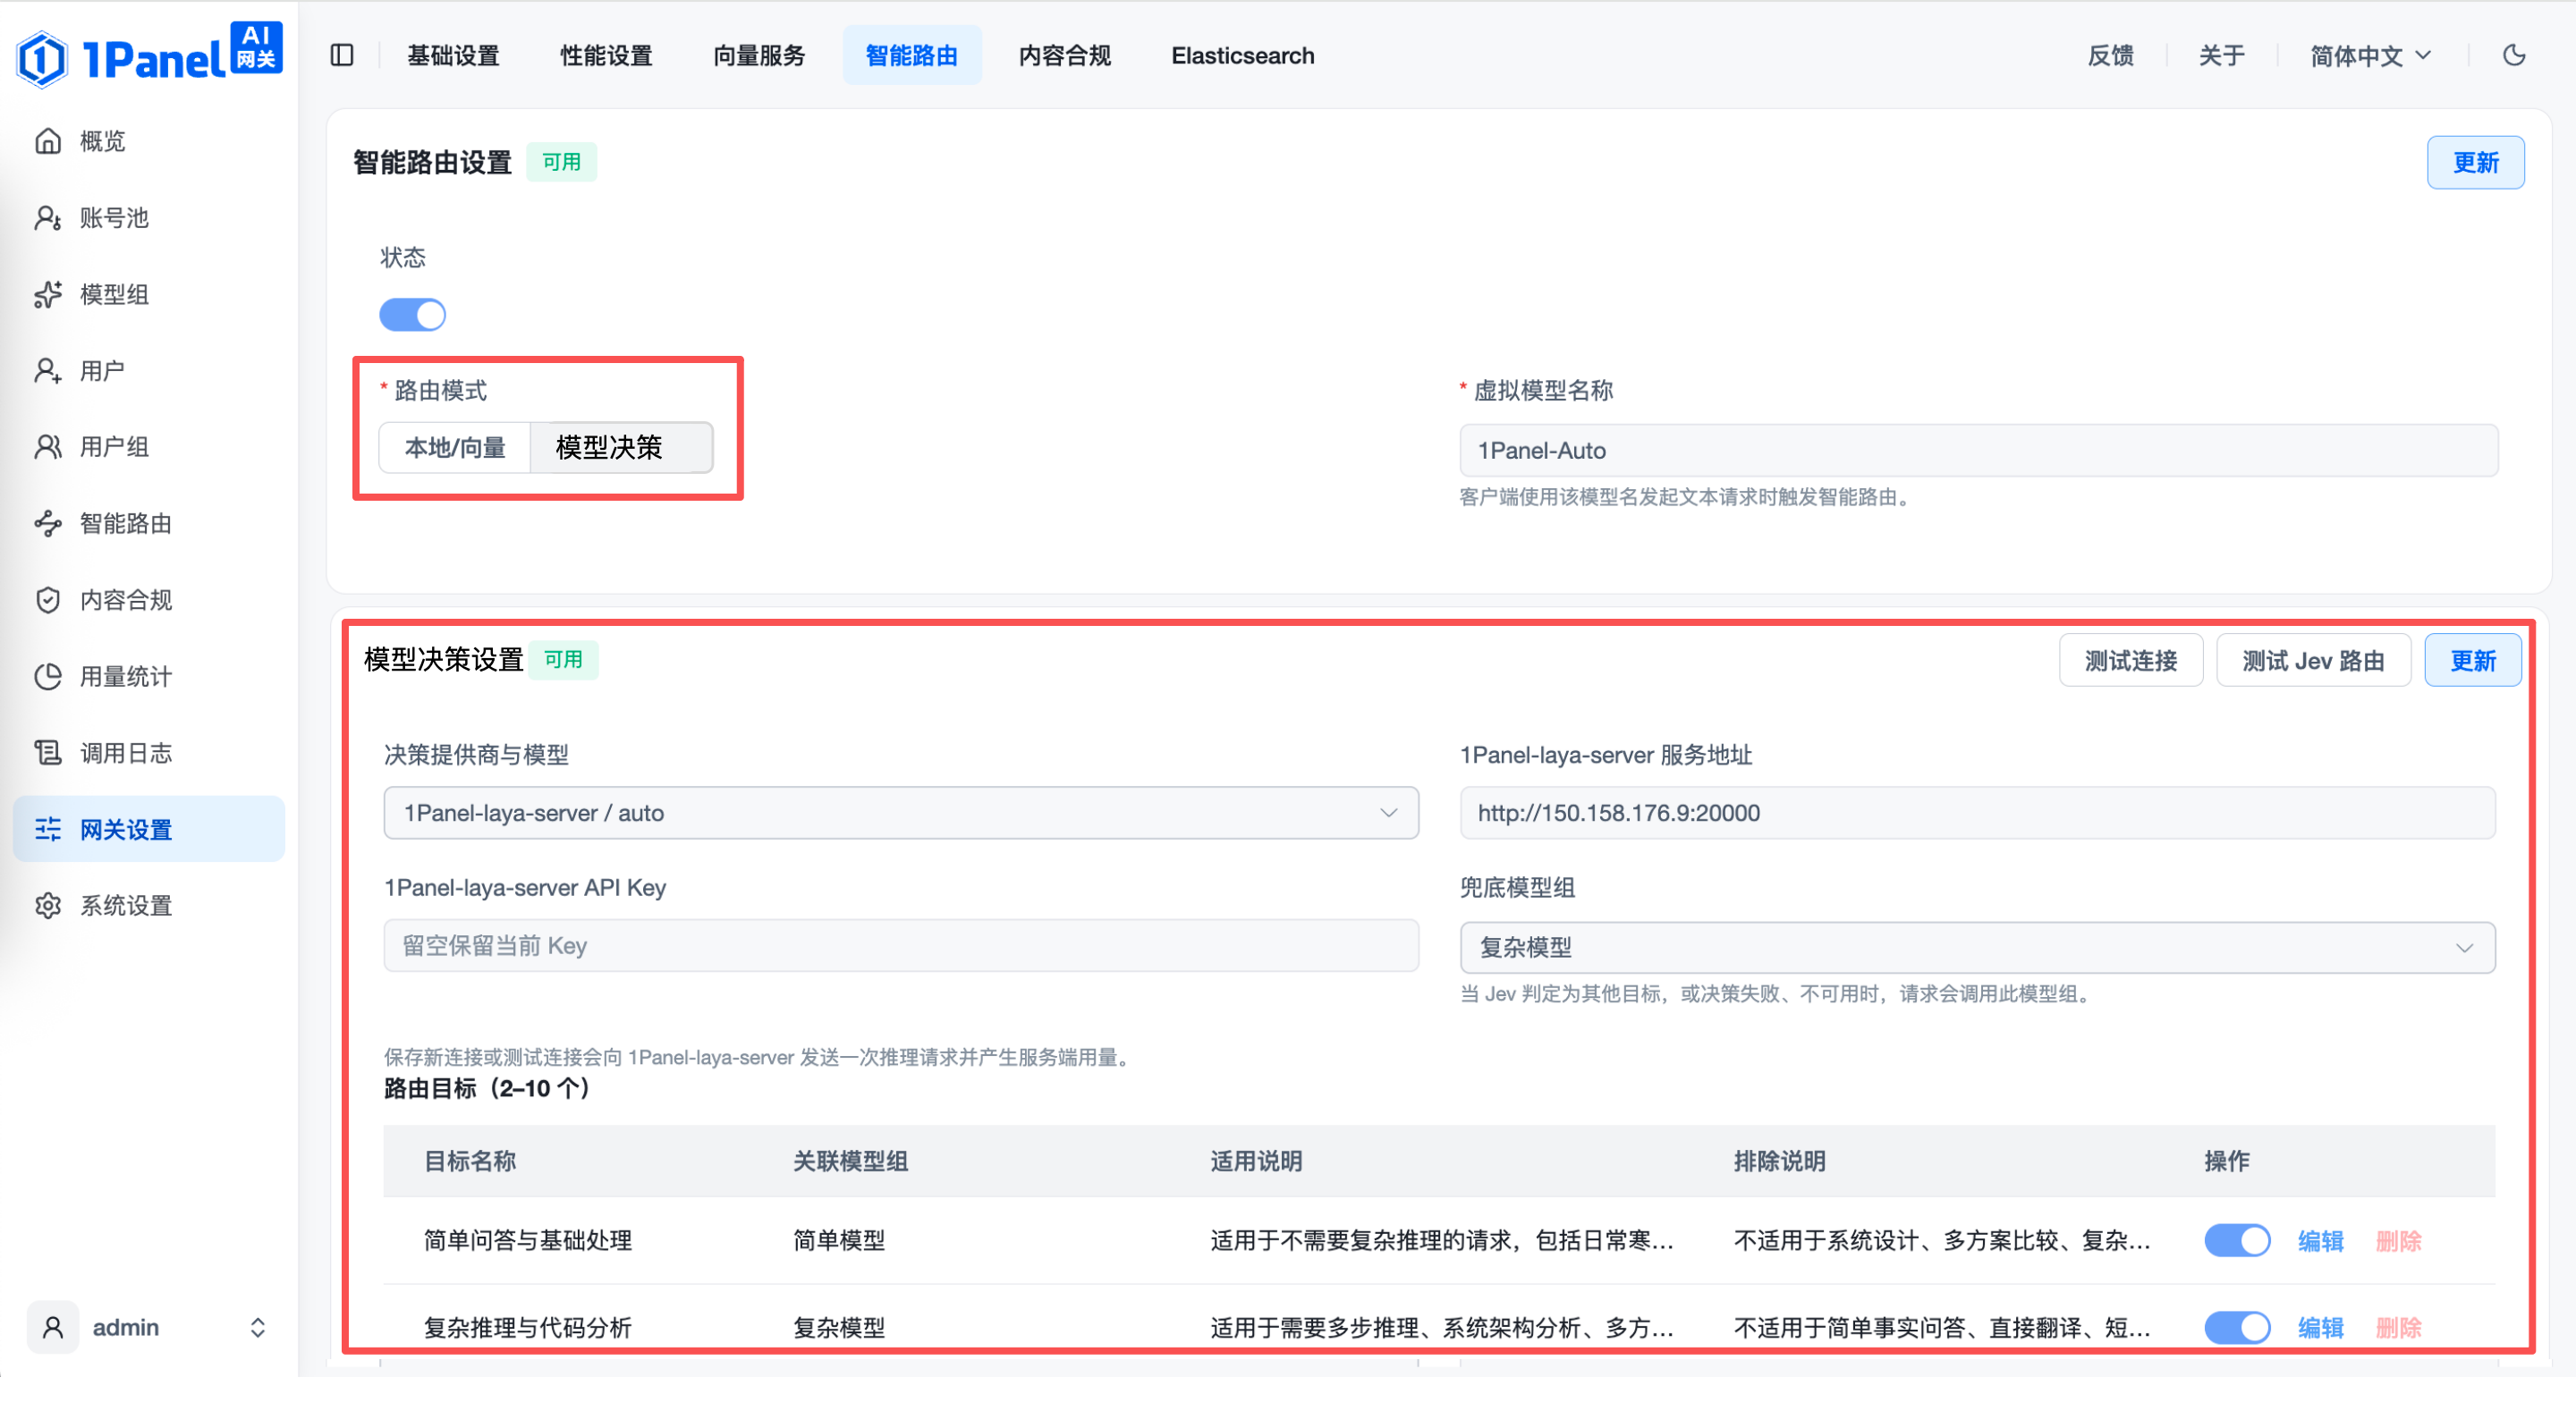
对应到界面上的「模型决策设置」区块:
| 配置项 | 示例值 | 说明 |
|---|---|---|
| 决策提供商与模型 | 1Panel-laya-server / auto |
auto 让 Laya 按输入语言自动选择 checkpoint |
| 1Panel-laya-server 服务地址 | http://150.158.176.9:20000 |
换成你自己的 laya-server 地址 |
| 1Panel-laya-server API Key | 上一步创建的密钥 | 输入框提示"留空保留当前 Key",密钥只在保存时提交 |
| 兜底模型组 | 复杂模型 | Jev 判为其他目标、或决策失败 / 不可用时调用该模型组 |
填完先点 「测试连接」(会真的往 laya-server 发一次推理请求,并产生服务端用量),再点 「测试 Jev 路由」验证整条链路,最后点「更新」保存。
然后是路由目标(界面限制 2–10 个)——每个目标给一个名字、关联一个模型组、写清适用说明与排除说明:
| 目标名称 | 关联模型组 | 适用说明 | 排除说明 |
|---|---|---|---|
| 简单问答与基础处理 | 简单模型 | 适用于不需要复杂推理的请求,包括事实问答、简单翻译等 | 不适用于系统设计、多方案比较、代码分析 |
| 复杂推理与代码分析 | 复杂模型 | 适用于需要多步推理、系统架构分析、代码编写与调试 | 不适用于简单事实问答、直接翻译 |
这里有个关键的设计细节:适用说明和排除说明不是注释,它们是喂给 Laya 的 criteria。也就是说,路由规则是用自然语言写的,改一行字就能调整路由行为,不需要重新标注样本、不需要重建向量、不需要重新部署模型。这是决策模型路由相对 Embedding 路由最大的工程优势。
一个命名上的小提醒:这个路由模式在界面上的名字随版本变过——早期显示为
Jev,现在显示为模型决策(下方区块标题一直是「模型决策设置」,右上角还带一个「测试 Jev 路由」按钮),指的是同一个东西。切换"模型决策"后,原来的「向量智能路由」整块会置为未启用。
6.5 完整工作流
1. 用户向 AI 网关发起请求(model=1Panel-Auto)
                ↓
2. 网关把「用户请求内容 + 路由目标列表」组装成 state 与 questions
   发给 laya-server 的 /v1/systemone
                ↓
3. Laya 单次前向传播,返回:该请求应归属哪个路由目标 + 置信度
                ↓
4. 网关按目标关联的模型组,把请求转发给对应模型
                ↓
5. Laya 决策失败 / 超时 / 置信度过低 → 走兜底模型组
两个具体例子:
- 用户问"帮我写个 Python 爬虫" → Laya 比对目标说明,判定为代码分析类 → 路由到复杂模型;
- 用户问"北京明天天气怎么样" → 判定为简单事实问答 → 路由到简单模型,又快又省。
6.6 它在网关整体能力里的位置
把 Laya 放进 1Panel AI 网关的六大能力里看,它不只是"智能路由的另一种实现":
| 网关能力 | Laya 能做什么 |
|---|---|
| 统一接入与模型代理 | 决策服务本身也是一个被统一纳管的后端 |
| 席位与权限管理 | 不同用户组可以绑定不同的路由目标与兜底策略 |
| 智能路由 | 核心落点:由决策服务决定这个问题该谁回答 |
| 负载与并发控制 | 决策层独立于模型账号池,不占用上游模型的并发与配额 |
| 内容合规 | 可用 guard / moderation preset 做每请求护栏,替代一次 LLM 调用 |
| 用量分析 | 决策日志可与网关调用日志对齐,用于复盘路由准确率 |
说白了:Laya 在网关里不是替代大模型,而是站在大模型前面的智能门卫。
6.7 上线前必须注意的五件事
- 别零样本上生产。 0.362 接近随机,实用能力全部来自微调。准备好自己的标注数据,先在 Playground 里跑一批真实样本看基线。
- 置信度要先校准。 逐题型拟合温度参数,把 ECE 从 0.466 压下来,否则
conf >= 0.85这种阈值没有意义。 - 路由目标别超过 20 个。 高基数是 Laya 的明确短板(Banking77 上 0.425)。两到五个目标最稳。
- 延迟要按自己的环境重新评估。 官方 GPU 基准是 32.8 ms,但实测落在 356 ms – 2.8 s。这个开销每次请求都要付,必须计入整体 P99;对延迟敏感的场景建议换 GPU,或对决策结果做缓存。
- 兜底必须配。 决策失败、超时、置信度不足,都要有明确的降级路径,不能让路由成为新的单点故障。
七、冷静的结论
该期待什么:一个 Apache 2.0、几亿参数、CPU 可跑、可以自己微调审计的判断层底座(GPU 上几十毫秒,CPU 上是几百毫秒到秒级的现实成本)。它把"分类/打分/是非"这类活的单价打到了接近于零,并且——这是闭源方案给不了的——让这一层可以完全跑在你的数据边界内。
不该期待什么:开箱即用的零样本分类器。也不要指望它在 20 类以上、或需要解释输出、或中文不微调的场景里表现好。
一句大实话:Laya 的所有基准数字都是开发者自测,微调用的 25,000 条数据在业界属于"精悍但不宽裕",零样本准确率和多语言 macro 平均(0.227)都不好看。它真正的价值兑现路径只有一条——你带着自己的标注数据去微调它。
按这个预期去看,它的性价比非常突出:不需要付 token 费、不需要出网、不需要等排期,一条 pip install laya 或一个 Docker 命令就能开始验证。而如果你已经在用 1Panel AI 网关管着一堆模型账号和 API Key,那么 Laya Server 又能把"哪个请求该给哪个模型"这件事,变成一段用中文就能改的配置。
这大概就是开源在这条赛道上最实在的意义:先把摩擦全部抹平,再让产品力说话。

 浙公网安备 33010602011771号