
Python基础
Python 的创始人为吉多·范罗苏姆(Guido van Rossum),在 1989 年荷兰的圣诞节期间,吉多·范罗苏姆为了在阿姆斯特丹打发时间,决心开发一个新的脚本解释程序,作为 ABC 语言的一种继承。
最新的 TIOBE排行榜,Python 赶超 PHP 占据第三, Python 崇尚优美、清晰、简单,是一个优秀并广泛使用的语言。
Python的应用
Python 可以应用于众多领域,如:数据分析、组件集成、网络服务、图像处理、数值计算和科学计算等众多领域。
Python目前主要应用领域
- 云计算: 典型应用OpenStack
- WEB开发: 众多优秀的WEB框架,众多大型网站均为 Python 开发,Youtube,Dropbox,豆瓣;典型的WEB框架: Django、Flask
- 人工智能、科学运算: 典型库 NumPy,SciPy,Matplotlib,Enthought librarys,pandas
- 系统运维: 运维人员必备技能,主要模块: os、sys等
- 金融
- 图形GUI: PyQT, WxPython,TkInter
Python 程序的运行过程
Python和Java一样,也是一门基于虚拟机的语言
当我们在命令行中输入 python hello.py 时,其实是激活了 Python 的 “解释器”,告诉 “解释器”:你要开始工作了。可是在“解释”之前,其实执行的第一项工作和 Java 一样,是编译。
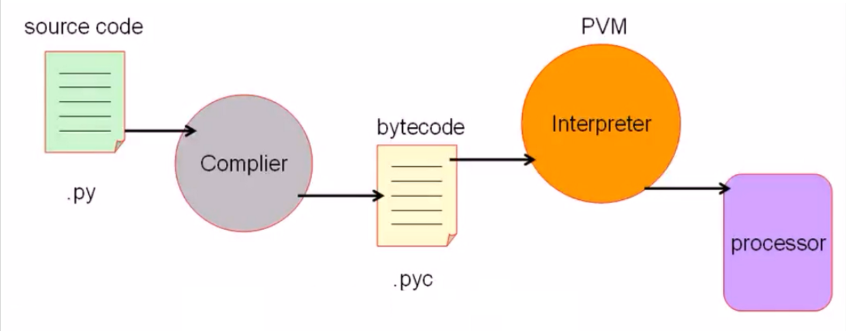
PyCodeObject和pyc文件
当 Python 程序运行时,编译的结果则是保存在位于内存中的 PyCodeObject (Python编译器真正编译成的结果)中,当 Python 程序运行结束时,Python 解释器则将 PyCodeObject 写回到 pyc 文件中。
当 python 程序第二次运行时,首先程序会在硬盘中寻找 pyc 文件,如果找到则直接载入,否则就重复上图的过程。
所以我们应该这样来定位 PyCodeObject 和 pyc 文件,我们说 pyc 文件其实是 PyCodeObject 的一种持久化保存方式。
第一个Python程序
对于大多数程序语言来说,第一个程序当然是hello world了,它有两种实现方法;
- 交互式解释器
直接在命令行中运行python 即可进入Python交互解释器
# python
Python 3.7.0 (default, May 20 2017, 15:03:03)
[GCC 4.8.5 20150623 (Red Hat 4.8.5-39)] on linux
Type "help", "copyright", "credits" or "license" for more information.
>>> print("hello world")
hello world
>>>
- Python程序文件
交互模式下的程序执行完成后难以再次运行,将编写的程序保存至文件(.py结尾)则很方便地多次运行。Python 的此类包含了一系列预先写好的语句程序文件称作 “ 模块 ”。能够直接运行的模块文件通常称作脚本(即程序的顶层文件)
#!/usr/bin/python3
print("hello world")
第1行为注释。在 Python 中,注释以 # 开始,作用范围为该行。第2行为空行,Python 会忽视空行,但空行通常有助于将大块代码分割,以便于阅读。第3行为 Python 代码,其中调用了 print() 函数
在UNIX上,当某程序在控制台中被引用时,该文件的头两个字节先被读入。如果这两个字节是ASCII字符 #! , shell 就会认为该文件将要由解释器执行,并且该文件的首行指定了要使用哪个解释器。该行称为 shebang ( shell 执行)行,如果存在,就必须为可执行文件的首行。shebang 行通常呈现为如下两种形式之一:
#!/usr/bin/python3
#!/usr/bin/env python3
如果是第一种形式,就会使用指定的解释器。如果是第二种形式, 就会使用在 shell 当前环境中发现的第一个 python 解释器。第二种形式具有更强的适应性,因为这种情况考虑了 Python 解释器位于 /usr/bin 之外(比如,安装在 /usr/local/bin 或 $HOME 等目录之下)的可能性。
将以上代码保存在 hello.py 文件中并使用 python 命令执行该脚本文件。
python3 hello.py
hello world
流程控制语句
if判断语句
语法格式
if boolean_expression 1:
    suite1
elif boolean一expression2:
    suite2
elif boolean_expressionN:
    suiteN
else_suite
循环语句
- 有限循环: 有次数限制的循环
- 无限循环: 即死循环
- 流程控制
- continue: 结束本次循环,继续下一次循环
- break: 跳出当前的循环
- for循环只能是有限循环,while 循环可以是有限循环也可以是无限循环
while语句
while循环用于执行0次或多次某个代码块,循环执行结果取决于While循环中布尔表达式的状态
语法格式
while boolean_expression:
    suite
只有当布尔表达式的值为False时,才会结束循环,如果条件一直为True,那就是一个死循环
while True:
    suite
break
结束当前的循环,不支持接收参数。在死循环中,也可以通过设置一定的条件来结束循环
例如: 从1输出到10,但是当输出到 5 时不再执行循环
#!/usr/bin/env python3
# -*- coding: utf-8 -*-

num = 1
while num <= 10:
    print("当前数字是:",num)
    if num == 5:
        break
    num = num + 1
    print("现在数字变成了:",num)
continue
结束本次循环,进行下一次循环
例如:输出1-100之间的所有奇数
#!/usr/bin/env python3
# -*- coding: utf-8 -*-

num = 0
while num < 100:
    num = num + 1
    if num % 2 == 0:
        continue
    print(num)
while中的else
while循环中的 else 语句比较特殊,这里的else语句只有在while正常结束的时候才会被执行
# while循环结构
while 判断条件:
    执行语句……
else:
    执行语句……
for语句
Python 的 for 循环语句重用了关键字 in ,与 while 循环类似,for 循环也支持 break 语句与 continue 语句,也包含可选的 else 分支
语法格式
for VAR in sequence:
	print(VAR)
例如:
for i in range(10):
    print(i)
九九乘法表
for r in range(1,10):
    for c in range(1,10):
        if c <= r:
            print('%s x %s = %-2s' %(c,r, c * r),end=' ')
    print()
### 输出
1 x 1 = 1
1 x 2 = 2  2 x 2 = 4
1 x 3 = 3  2 x 3 = 6  3 x 3 = 9
1 x 4 = 4  2 x 4 = 8  3 x 4 = 12 4 x 4 = 16
1 x 5 = 5  2 x 5 = 10 3 x 5 = 15 4 x 5 = 20 5 x 5 = 25
1 x 6 = 6  2 x 6 = 12 3 x 6 = 18 4 x 6 = 24 5 x 6 = 30 6 x 6 = 36
1 x 7 = 7  2 x 7 = 14 3 x 7 = 21 4 x 7 = 28 5 x 7 = 35 6 x 7 = 42 7 x 7 = 49
1 x 8 = 8  2 x 8 = 16 3 x 8 = 24 4 x 8 = 32 5 x 8 = 40 6 x 8 = 48 7 x 8 = 56 8 x 8 = 64
1 x 9 = 9  2 x 9 = 18 3 x 9 = 27 4 x 9 = 36 5 x 9 = 45 6 x 9 = 54 7 x 9 = 63 8 x 9 = 72 9 x 9 = 81
数据类型
整型(Integral )
Python提供了两种内置的 Integral 类型,即 int 与 bool 。整数与布尔型值都是固定的,但由于Python提供了增强的赋值操作符,使得这一约束极少导致实际问题。在布尔表达式中, 0 与 False 表示 False ,其他任意整数与 true 都表示 true 。在数字表达式中,True表示1,False表示0。这意味着有些看起来很怪异的表达式也是有效的。 例如可以使用表达式 i += True 来对整型变量 i 进行递增操作,当然最自然的方法还是 i+=1
整数(Int)
整数的大小只受限于机器的内存大小,因此包含几百个数字的整数可以很容易地创建与操纵。默认情况下整数采用的是十进制,但在方便的时候也可以使用其他进制
>>> 14600926   #十进制
14600926
>>> 0b110111101100101011011110  #二进制
14600926
>>>  0o67545336  # 八进制
14600926
>>>  0xDECADE    # 十六进制

二进制数以0b引导,八进制数以0o引导,十六进制数则以0x引导,大写字母也可以使用
相关操作
| 语法 | 描述 |
|---|---|
x + y |
将数x与数y相加 |
x - y |
从x减去y |
x * y |
将x与y相乘 |
x / y |
用x除以y ,产生一个浮点值(若x或y是一个复数就产生一个复数) |
x // y |
用x除以y ,舍弃小数部分,结果总为整数,参见round() |
x % y |
用 x 除以 y ,取模(余数) |
x ** y |
计算x的y次幂,参见pow() |
-x |
对x取负数,若x为0不做任何操作,否则改变其符号 |
+x |
不做任何操作,有时候用于澄清代码 |
abs(x) |
返回x的绝对值 |
divmod() |
以二元组的形式返回x除以y所得的商和余数(两个整数) |
pow(x,y) |
计算x的y次幂,与操作符 ** 相同 |
pow(x,y,z) |
(x**y)%z 的另一种写法 |
round(x,n) |
返回浮点数x四舍五入后的整数(或给定n将浮点数转换为小数点后有n位) |
布尔型
有两个内置的布尔型对象:True 与 False。布尔数据类型也可以当作函数进行调用——不指定参数时将返回 False,给定的是布尔型参数时,会返回该参数的一个拷贝,给定的是其他类型的参数时,则会尝试将其转换为布尔数据类型。所有内置的数据类型与标准库提供的数据类型都可以转换为一个布尔型值,为自定义数据类型提供布尔型转换也很容易。下面给出了两个布尔型赋值操作以及两个布尔表达式:
>>> t = True
>>> f = False
>>> t and f
False
>>> t and True
True
浮点型
浮点数也就是小数,之所以称为浮点数,是因为按照科学记数法表示时,一个浮点数的小数点位置是可变的,比如,1.23x10^9 和 12.3x10^8 是完全相等的。浮点数可以用数学写法,如 1.23,3.14,-9.01,等等。但是对于很大或很小的浮点数,就必须用科学计数法表示,把 10 用 e 替代,1.23x10^9 就是 1.23e9,或者 12.3e8,0.000012 可以写成 1.2e-5 等等。
整数和浮点数在计算机内部存储的方式是不同的,整数运算永远是精确的(除法也是精确的),而浮点数运算则可能会有四舍五入的误差。
浮点数有完整的支持;整数和浮点数的混合计算中,整数会被转换为浮点数。
字符串
Python 字符串不可以被更改,它们是不可变的 。
字符串是由引号创建的,可以使单引号也可以是双引号,但是字符串两端的引号必须相同。还可以使用三引号
如果需要在引号包含的字符串中使用引号,再要使用的引号和创建字符串的引号不相同时可以直接使用,否则必须转义
相关操作
连接
字符串可以由 + 操作符连接(粘到一起),可以由 * 表示重复
遍历
>>> name = "jason"
>>> for char in name:
    	print(char)
j
a
s
o
n
索引&切片
可以把Python的字符串理解为单独字符的数组,字符串的索引是从0开始的。
name = "jason"
name[0]
'j'
name[1:3]
'as'

index=0表示字符串的第一个字符
[index:index+2]表示第index个字符到index+1的字符组成的字符串
改变字符串
由于Python中的字符串是不可变的,所以下面这种方式是不允许的
s = "hello"
s[0] = "H"
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'str' object does not support item assignment
在Python中改变字符串有以下两种方式
- 直接用大写的'H'通过
+与原来的字符串切片的子字符串组成新的字符串
  s = "hello"
  s = 'H' + s[1:]
  s
  'Hello'
- 直接扫描原字符串,把小写的'h'替换为'H',得到新的字符串
  s = "hello"
  s = s.replace('h','H')
  s
  'Hello'
字符串格式化
通常,我们使用一个字符串作为模板,模板中会有格式符。这些格式符为后续真实值预留位置,以呈现出真实值应该呈现的格式。字符串的格式化,通常会用在程序的输出、logging 等场景。
比如我们有一个任务,给定一个用户的 userid,要去数据库中查询该用户的一些信息,并返回。而如果数据库中没有此人的信息,我们通常会记录下来,这样有利于往后的日志分析,或者是线上 bug 的调试等等。
print('no data available for person with id: {}, name: {}'.format(id, name))
其中的 string.format(),就是所谓的格式化函数;而大括号{}就是所谓的格式符,用来为后面的真实值——变量 name 预留位置。如果id = '123'、name='jason',那么输出便是:
no data available for person with id: 123,name: jason
注意: string.format()是最新的字符串格式化函数,在之前的Python中字符串格式化通常用%来表示,还拿上面的例子来说,用%格式化字符串就可以写为
print('no data available for person with id: %s, name: %s' %(id,name))
其他常见函数
string.strip(str): 表示去掉首尾的 str 字符串;
string.lstrip(str):表示只去掉开头的 str 字符串;
string.rstrip(str):表示只去掉尾部的 str 字符串。
string.count(str,start,end):返回字符串 s 中(或在 s 的 start:end 切片中)字符串 t 出现的次数
列表
列表是有序的序列而且是可变对象,它包含了0个或多个对象引用。
列表操作符
| 表达式 | 结果 | 描述 |
|---|---|---|
[1, 2, 3] + [4, 5, 6] |
[1, 2, 3, 4, 5, 6] | 两个列表进行组合 |
[‘Hi!’] * 4 |
[‘Hi!’, ‘Hi!’, ‘Hi!’, ‘Hi!’] | 元素复制 |
3 in [1, 2, 3] |
True | 成员比较 |
| for x in [1, 2, 3]: print x | 1 2 3 | 迭代 |
列表常用的方法
| 方法 | 描述 |
|---|---|
| L.append(x) | 将元素 x 追加到列表 L 的尾部 |
| L.count(x) | 返回元素 x 在列表 L 中出现的次数 |
| L.extend(m) 或 L+=m | 将 iterable 对象m的元素和 L 进行连接 |
| L.index(x, start, end) | 返回数据项x在列表 L 中(或L的start,end分片中)最左边出现的索引位置,否则会产生—个ValueError异常 |
| L.insert(i, x) | 在索引位置 i 处将元素 x 插入列表 L |
| L.pop() | 返回并移除列表 L 最右边的元素 |
| L.pop(i) | 返回并移除L中索引位置 i 处的元素 |
| L.remove(x) | 从list L中移除最左边出现的元素 x,如果找不到 x 就产生ValueError异常 |
| L.reverse() | 对列表 L 进行反转 |
| L.sort(…) | 对列表 L 进行排序,与内置的 sorted() 函数一样,这一方法可以接受可选的 key 与 reverse 参数 |
元组
元组是有序序列,其中包含0个或多个对象引用。元组被称为只读列表,即数据可以被查询但不能被修改,所以列表的切片操作同样适用于元组。
元组的创建方式是(),元素写在括号内,多个元素之间使用,分隔。元组还可以通过tuple()函数创建
tup1 = ()  #创建一个空元祖
tup2 = (1,) #创建只有一个元素的元组,元素末尾要加','
元组只提供了两种方法:t.count(x) ,返回对象 x 在元组中出现的次数;t.index(x) ,返回对象在元组 t 中出现的最左边位置——元组中不包含 x 时则产生ValueError异常。
字典
字典是一系列由键(key)和值(value)配对组成的元素的集合;相比于列表和元组,字典的性能更优,特别是对于查找、添加和删除操作,字典都能在常数时间复杂度内完成。
字典的创建
字典可以使用{}来创建 ,也可以使用dict()函数来创建
d1 = {'name': 'jason', 'age': 20, 'gender': 'male'}
d2 = dict({'name': 'jason', 'age': 20, 'gender': 'male'})
d3 = dict([('name', 'jason'), ('age', 20), ('gender', 'male')])
d4 = dict(name='jason', age=20, gender='male')
d1 == d2 == d3 ==d4
True
字典操作方法
| 语法 | 表述 |
|---|---|
| d.clear() | 将字典d清空 |
| d.copy() | 返回字典d的浅拷贝 |
| d.fromkeys(s,v) | 返回一个字典,该字典的键为序列s的项,值为None或v(r如果给定了参数v) |
| d.get(k) | 返回字典d中键k对应的值,如果k不在d中就返回None |
| d.get(k,v) | 返回字典d中键k对应的值,如果k不在d中就返回预设值v |
| d.items() | 返回字典d中所有 键-值 对的视图 |
| d.keys() | 返回字典d中所有的键的视图 |
| d.values() | 返回字典d中所有值的视图 |
| d.pop(k) | 移除键为k的项并返回键k对应的值,如果k不在d中就产生KeyError异常 |
| d.pop(k,v) | 移除键为k的项并返回键k对应的值,如果k不在d中就返回预设值v |
| d.popitem() | 随机移除并返回字典d中的任意一个 键-值 对,如果d为空就产生KeyError异常 |
| d.setdefault(k,v) | 与d.get()类似,不同之处在于,如果键k不在d中就插入一个键为k的新值,其值为None或预设值v(如果给定了参数v) |
| d.update(a) | 如果a中的键-值 对不存在d中就添加到d,如果a中的键在d中,就将a中的键对应的值替换掉d中键对应的值。a可以是字典,也可以是关键字参数 |
字典的遍历
字典的 itmes 指的是键值对,在遍历的时候存在一个转换过程,因此如果数据量大的情况下效率比较低,不建议采用这种方法迭代,而建议使用 for k in dic: 的方法遍历。
d1 = {'name': 'jason', 'age': 20, 'gender': 'male'}

for k in d1:
    print(k,d1[k])

for items in d1.items():
    print(items)

for k,v in d1.items():
    print(k,v)
集合
集合是一个无序的,不重复的数据组合,它的主要作用是去重,把一个列表变成集合,就自动去重了:
Python 提供了两种内置的集合类型:可变的 set 类型,固定的 frozenset 类型。
- 可变集合(set): 可添加和删除元素,非可哈希的,不能用作字典的键,也不能做其他集合的元素。
- 不可变集合(frozenset)
集合的相关操作
集合的创建
s1 = {1, 2, 3}
s2 = set([1, 2, 3])
s1 == s2
True
访问
集合本质上属于一个哈希表,所以它不支持索引操作,要想访问结合中的元素只能使用循环遍历,或者使用in、not in来判断集合中是否含有元素
s1 = set(1,2,3)
1 in s1
True
10 in s1
False

for i in s1:
    print(i)

1
2
3
更新
s = {1, 2, 3}
s.add(4) # 增加元素4到集合
s
{1, 2, 3, 4}
s.remove(4) # 从集合中删除元素4
s
{1, 2, 3}
函数
函数是指将一组语句的集合通过一个名字(函数名)封装起来,要想执行这个函数,只需调用其函数名即可。
函数的特性:
- 减少重复代码,提高应用的模块性和代码的重复利用率,用来实现单一,或相关联功能。
- 可扩展性:方便修改,更容易扩展代码的功能。
- 保持代码的一致性,修改函数功能之后所有调用函数的地方都会随之修改
函数的定义及使用
在Python中函数的可以使用def关键字来定义,一般格式如下:
def 函数名(参数列表):
    函数体


def hello():
    print("hello")

hello()  调用函数
函数参数
任何传入参数和自变量必须放在圆括号中间,圆括号之间可以用于定义参数。
形参和实参
形参指的是形式参数,不是实际存在,是虚拟变量。在定义函数和函数体的时候使用形参,目的是在函数调用时接收实参(实参个数,类型应与实参一一对应)。
实参是指实际参数,调用函数时传给函数的参数,可以是常量,变量,表达式,函数,传给形参。
形参和实参的区别是,形参是虚拟的,不占用内存空间,形参变量只有在被调用时才分配内存单元,实参是一个变量,占用内存空间,数据传送单向,实参传给形参,不能形参传给实参。
位置参数
位置参数也叫必备参数,是必须要传给函数的参数,并且在传参时必须以正确的顺序传入函数,调用时的数量必须和函数声明时的一样。
def f1(name,age):
    print("I'm name: {},I'm age: {} years old".format(name,age))

f1("jason",20)
I'm name: jason,I'm age: 20 years old
关键字参数
关键字参数和函数调用关系紧密,函数调用使用关键字参数来确定传入的参数值。使用关键字参数允许函数调用时参数的顺序与声明时不一致,因为 Python 解释器能够用参数名匹配参数值。
def f1(name,age):
    print("I'm name: {},I'm age: {} years old".format(name,age))

f1(name="jason",age=20)
I'm name: jason,I'm age: 20 years old
默认参数
默认参数也叫缺省参数,同时也是关键字参数,调用函数时缺省参数的值如果没有传入,则被认为是默认值。默认参数常用于多数情况下对象的值是固定的情况
def f2(name,age,gender='male'):
    print("Name: {}".format(name))
    print("Age: {}".format(age))
    print("gender: {}".format(gender))

f2("jason",20)
Name: jason
Age: 20
gender: male
f2("Tom",20,"female")
Name: Tom
Age: 20
gender: female
不定长参数
有时候可能需要一个函数能处理比当初声明时更多的参数,这些参数就叫不定长参数,也叫动态参数。动态参数和位置参数、关键字参数不同,声明时不会命名。例如下面的加法器,能且仅能接收三个参数,并求出和:
def add(x,y,z):
    print(x + y + z)

add(1,2,3)
6
如果在变量名前面加了星号 * ,则变量会以元组的形式存放所有 未命名 的变量参数,例如:
def add(*args):
    print("args: ",args)
    result = 0
    for i in args:
        result += i
    print("result: ",result)

add(1,2,3,4,5,6,7,8,9,10)

args:  (1, 2, 3, 4, 5, 6, 7, 8, 9, 10)
result:  55
而如果在变量名前面加了 ** , 则变量会以字典的形式存放 有命名 的变量参数,例如:
def f2(*args,**kwargs):
    print("args: ",args)
    print("kwargs:",kwargs)
    for i in kwargs:
        print("%s : %s" %(i,kwargs[i]))


f2("jason",20,'male',job='IT',weight='170')

args:  ('jason', 20, 'male')
kwargs: {'job': 'IT', 'weight': '170'}
job : IT
weight : 170
注意:
-
按照规范,定义函数时默认参数应该放在位置参数之后。
-
定义函数时应该
*args放左边,**kwargs放右边 -
调用函数进行传参时,关键字参数应该放在位置(必备)参数之后
-
如果函数接收的是
**kwargs,那么单纯地传入字典会被识别为位置参数,必须打散才能被接收。例如def func(**kwargs): print("kwargs:",kwargs) #错误的调用: func({'Name':'jason'}) """ Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: func() takes 0 positional arguments but 1 was given """ #正确的写法如下: func(**{'name':'jason'}) kwargs: {'name': 'jason'}
函数返回值
要想获取函数的执行结果,就可以用 return 语句把结果返回
注意
- 函数在执行过程中只要遇到
return语句,就会停止执行并返回结果,也可以理解为return语句代表着函数的结束。 - 如果未在函数中指定
return,那这个函数的返回值为None return可以接收多个对象,此时 Python 会将多个对象封装成一个元组,并将这个元组对象返回
#!/usr/bin/env python3
# -*- coding: utf-8 -*-

def get_os_release(path='/etc/redhat-release'):
    with open(path,'rt',encoding='utf-8') as fr:
        return fr.readline().strip()


x = get_os_release()
y = get_os_release('/etc/issue')

print(x)
print(y)

CentOS Linux release 7.3.1804 (Core)
\S
作用域
作用域就是作用范围,按照生效范围可以分为两类:
- 全局作用域:在整个文件的任意位置都能被引用、全局有效
- 局部作用域:只能在局部范围内生效
使用 globals() 和 locals() 方法则会以字典类型返回当前位置的全局变量和局部变量:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
# 全局调用
print(globals())
print(locals())

def func():
    a = 12
    b = 20
    # 局部调用
    print(locals())
    print(globals())

func()
作用域的产生
在 Python 中只有模块(module),类(class)以及函数(def、lambda)才会引入新的作用域,其它的代码块(如 if、try、for 等)是不会引入新的作用域的,如下代码中 if 并没有引入一个新的作用域,x 仍处在当前作用域中,后面代码可以使用:
if 2 > 1:
    x = 1
print(x)  # 1
但是函数 def、class、lambda 会引入新的作用域:
def test():
    x = 2
print(x) # NameError: name 'x' is not defined
变量修改的问题
x = 6

def f():
    print(x)
    x = 5

f()

"""
UnboundLocalError: local variable 'x' referenced before assignment
"""
上述代码出现错误的原因在于 print(x) 时,解释器会先在局部作用区域找到变量 x 。这是因为在进行函数调用( f2())之前,其前面的代码包括函数都会先加载到内存,因此执行到 print(x) 会先在局部区域找到 x = 5 ,但 x 的使用出现在 x 的声明前了,所以报错。
x = 6


def f2():
    x += 1


f2()

'''
UnboundLocalError: local variable 'x' referenced before assignment
'''
x += 1 即 x = x + 1 是先加再赋值,解释器会在局部作用域找,会找到 x += 1 (函数已经加载到内存),但 x 的加法运算出现在赋值前了,所以报错。
global和nonlocal关键字
当内部作用域想修改外部作用域的变量时,就要用到 global 和 nonlocal 关键字了,当修改的变量是在全局作用域(global 作用域)上的,就要使用 global 先声明一下。例如:
count = 10
def outer():
    global count
    print(count)
    count = 100
    print(count)
outer()

"""
10
100
"""
关键字 global 声明的变量必须在全局作用域上,不能应用在嵌套作用域上,当要修改嵌套作用域)中的变量时就需要 nonlocal 关键字了
def outer():
    count = 10

    def inner():
        nonlocal count
        count = 20
        print(count)

    inner()
    print(count)

"""
20
20
"""

 浙公网安备 33010602011771号