
多线程进阶:JUC并发编程
多线程进阶:JUC并发编程
1、回顾线程的六种状态
   public enum State {
        NEW, //新建
        RUNNABLE,//运行
        BLOCKED,//堵塞
        WAITING//等待
        TIMED_WAITING,//超时等待(限时等待)
        TERMINATED;//终止
    }
-
NEW:一个尚未启动的线程的状态。也称之为初始状态、开始状态。
-
RUNNABLE:一个可以运行的线程的状态,可以运行是指这个线程已经在JVM中运行了,但是有可能正在等待其他的系统资源。也称之为就绪状态、可运行状态。
-
BLOCKED:一个线程因为等待监视锁而被阻塞的状态。也称之为阻塞状态。
-
WAITING:一个正在等待的线程的状态。也称之为等待状态。造成线程等待的原因有三种,分别是调用Object.wait()、join()以及LockSupport.park()方法。处于等待状态的线程,正在等待其他线程去执行一个特定的操作。例如:因为wait()而等待的线程正在等待另一个线程去调用notify()或notifyAll();一个因为join()而等待的线程正在等待另一个线程结束。
-
TIMED_WAITING:一个在限定时间内等待的线程的状态。也称之为限时等待状态。造成线程限时等待状态的原因有五种,分别是:Thread.sleep(long)、Object.wait(long)、join(long)、LockSupport.parkNanos(obj,long)和LockSupport.parkUntil(obj,long)。
-
TERMINATED:一个完全运行完成的线程的状态。也称之为终止状态、结束状态。
wait/sleep的区别
-
来自不同的类
wait=>object
sleep=>thread 一般使用TimeUnit实现睡眠
-
关于锁的释放
wait会释放锁,sleep不会释放锁
-
使用范围不同
wait必须在同步代码块中使用
sleep任何时间都可以使用
2、locks包
Lock锁
Lock 实现提供了比使用 synchronized 方法和语句可以获得的更广泛的锁定操作。它们允许更灵活的结构,可能具有完全不同的属性,并且可能支持多个关联的 Condition 对象。
synchronized和lock区别
- Synchronized内置的Java关键字,Lock是一个Java锁
- Synchronized无法判断获取锁的状态,Lock 可以判断是否获取到了锁
- Synchronized会自动释放锁,lock必须要手动释放锁!如果不释放锁,死锁
- Synchronized 线程1(获得锁,阻塞)、线程2(等待,傻傻的等) ;Lock锁就不一定会等待下去;
- Synchronized可重入锁,不可以中断的,非公平;Lock,可重入锁,可以判断锁,非公平(可以自己设置)6、Synchronized适合锁少量的代码同步问题,Lock适合锁大量的同步代码!
 class X {
  private final ReentrantLock lock = new ReentrantLock(); //创建一个lock锁对象

  public void m() {
   lock.lock(); // 手动上锁
   try {
    // ... method body
   } finally {
    lock.unlock();//手动解锁
   }
  }
 }
//除了实现 Lock 接口之外,此类还定义了一些 public 和 protected 方法来检查锁的状态。其中一些方法仅对检测和监控有用。
//此类的序列化与内置锁的行为方式相同:反序列化的锁处于解锁状态,而不管其在序列化时的状态如何。
//这个锁最多支持同一个线程递归锁2147483647个。尝试超过此限制会导致 Error 从锁定方法中抛出。
公平锁:非常的公平,不允许出现线程插队的现象,只遵循先来后到
非公平锁:不公平,会出现线程插队的现象。 3h 3s,那个执行时间为3s的线程会插到3h线程的前面去
synchronized也是默认实现非公平锁的
生产者消费者简单实现 (sychronized)
public class Test01 {
    public static void main(String[] args) {
        Data data = new Data();
        new Thread(()->{
            try {
                for (int i = 0; i < 10; i++) {
                    data.incrment();
                }
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        },"A").start();
        new Thread(()->{
            try {
                for (int i = 0; i < 10; i++) {
                    data.decrment();
                }
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        },"B").start();

    }
}

class Data {
    private Integer number=0;
    public synchronized void incrment() throws InterruptedException {
//        if(number!=0){
//            this.wait();
//        }
        while(number!=0){
            this.wait();
        }
        number++;
        System.out.println(Thread.currentThread().getName()+"-->"+number);
        this.notifyAll();
    }
    public synchronized void decrment() throws InterruptedException {
//        if(number==0){
//            this.wait();
//        }
        while(number==0){
            this.wait();
        }
        number--;
        System.out.println(Thread.currentThread().getName()+"-->"+number);
        this.notifyAll();
    }
}
注意:这段代码this.wait是使用if判断的,只会判断一次,这可能造成一个虚假唤醒的问题,当线程变多时,假如唤醒了incrment里面等待的进程,同一时间会有多个线程被唤醒就会执行number++,导致number的数值出现错误
官方回答:推荐的等待方法是在对 wait 的调用周围的 while 循环中检查正在等待的条件,如下例所示。除其他外,这种方法避免了可能由虚假唤醒引起的问题。
lock实现
condition
import java.util.concurrent.locks.Condition;
import java.util.concurrent.locks.Lock;
import java.util.concurrent.locks.ReentrantLock;

public class Test01 {
    public static void main(String[] args) {
        Data data = new Data();
        new Thread(()->{
            try {
                for (int i = 0; i < 10; i++) {
                    data.incrment();
                }
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        },"A").start();
        new Thread(()->{
            try {
                for (int i = 0; i < 10; i++) {
                    data.decrment();
                }
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        },"B").start();

    }
}

class Data {
    private Integer number=0;
    private  Lock lock=new ReentrantLock();
    private Condition condition = lock.newCondition();

    public synchronized void incrment() throws InterruptedException {
        while(number!=0){
            condition.await();
        }
        number++;
        System.out.println(Thread.currentThread().getName()+"-->"+number);
       condition.signalAll();
    }
    public synchronized void decrment() throws InterruptedException {
        while(number==0){
            condition.await();
        }
        number--;
        System.out.println(Thread.currentThread().getName()+"-->"+number);
        condition.signalAll();
    }
}
同时使用lock锁也可以实现一个精准唤醒的情况,lock可以生成多个监视器,condition1.condition2……,同时使用signal()唤醒相应的线程。
AQS(AbstractQueuedSynchronizer)
方法介绍AbstractQueuedSynchronizer - Java17中文文档 - API参考文档 - 全栈行动派 (qzxdp.cn)
AQS有两个非常重要的组成部分:
-
state :用于表现的同步状态(是否可以获得锁)
private volatile int state;使用Volatile修饰是为了保持state可见性,当某个线程改变了state的值后,其他的线程也会知道。
可以操作state的方法主要有
getState()、setState()和compareAndSetState()对state进行修改和访问。 -
CLH(三个人名缩写)双向队列,其中的node(节点)
其中还有几个常量表示状态.从图中可以看出来node节点是可以实现两种类型的锁的。
waitStatus:当前节点状态,该字段共有5种取值:
CANCELLED = 1。节点引用线程由于等待超时或被打断时的状态。SIGNAL = -1。后继节点线程需要被唤醒时的当前节点状态。当队列中加入后继节点被挂起(block)时,其前驱节点会被设置为SIGNAL状态,表示该节点需要被唤醒。CONDITION = -2。当节点线程进入condition队列时的状态。(见ConditionObject)PROPAGATE = -3。仅在释放共享锁releaseShared时对头节点使用。(见共享锁分析)0。节点初始化时的状态。
public class Mutex extends AbstractQueuedSynchronizer {

    @Override
    public boolean tryAcquire(int arg) {
        return compareAndSetState(0, 1);
    }

    @Override
    public boolean tryRelease(int arg) {
        return compareAndSetState(1, 0);
    }

    public static void main(String[] args) {
        final Mutex mutex = new Mutex();

        new Thread(() -> {
            System.out.println("thread1 acquire mutex");
            mutex.acquire(1); //以独占模式获取锁,忽略中断。
            // 获取资源后sleep保持
            try {
                TimeUnit.SECONDS.sleep(5);
            } catch(InterruptedException ignore) {

            }
            mutex.release(1);//释放锁
            System.out.println("thread1 release mutex");
        }).start();

        new Thread(() -> {
            // 保证线程2在线程1启动后执行
            try {
                TimeUnit.SECONDS.sleep(1);
            } catch(InterruptedException ignore) {

            }
            // 等待线程1 sleep结束释放资源
            mutex.acquire(1);
            System.out.println("thread2 acquire mutex");
            mutex.release(1);
        }).start()
    }
}
acquire()的源码实现acquire实现默认为非公平锁。
    public final void acquire(int arg) {
        if (!tryAcquire(arg)  //尝试去获取锁,这个方法是我们自己重写的。
            &&acquireQueued(addWaiter(Node.EXCLUSIVE), arg))  //有&&作用下,只有在前面获取锁失败时才会执行,从名字可以看出与队列有关。
            //中断处理: 如阻塞线程被打断
            selfInterrupt();
    }
 //自己重写的tryAcquire方法,其中arg参数可以自己定义作用。
  @Override
    public boolean tryAcquire(int arg) {
        return compareAndSetState(0, 1);
    }
//添加Node里面封装的Thread锁的类型
//addWaiter将线程包装为独占节点,尾插式加入到队列中,如队列为空,则会添加一个空的头节点。值得注意的是addWaiter中的enq方法
    private Node addWaiter(Node mode) {
        Node node = new Node(Thread.currentThread(), mode);
        // Try the fast path of enq; backup to full enq on failure
        Node pred = tail;
        if (pred != null) {
            node.prev = pred;
            if (compareAndSetTail(pred, node)) {
                pred.next = node;
                return node;
            }
        }
        enq(node);
        return node;
    }
//通过CAS+自旋的方式处理尾节点添加冲突。
    private Node enq(final Node node) {
        for (;;) {
            Node t = tail;
            if (t == null) { // Must initialize
                //创建一个空节点作为头指针
                if (compareAndSetHead(new Node()))
                    tail = head;
            } else {
                node.prev = t;
                if (compareAndSetTail(t, node)) {
                    t.next = node;
                    return t;
                }
            }
        }
    }

//将线程包装为Node添加到队列中阻塞等待
final boolean acquireQueued(final Node node, int arg) {
        boolean failed = true;
        try {
            boolean interrupted = false;
            for (;;) {    //使用自旋锁,让线程一直去获取锁知道成功
                final Node p = node.predecessor(); //获得该节点的前驱
                if (p == head && tryAcquire(arg)) { //尝试获取锁
                    setHead(node);
                    p.next = null; // help GC
                    failed = false;
                    return interrupted;
                }
                if (shouldParkAfterFailedAcquire(p, node) &&
                    parkAndCheckInterrupt()) //将其前驱节点标志为SIGNAL状态(表示其需要被unpark唤醒)后,则通过park进入阻塞状态。
                    interrupted = true;
            }
        } finally {
            if (failed)
                cancelAcquire(node);
        }
    }
共享锁分析
acquireShared & releaseShared
public final void acquireShared(int arg) {
    // 负数表示获取共享锁失败,不同于tryAcquire的bool返回,同样也是在实体类中重写
    if (tryAcquireShared(arg) < 0)
        doAcquireShared(arg);
}
//和acquireQueued相似
private void doAcquireShared(int arg) {
    final Node node = addWaiter(Node.SHARED);
    boolean failed = true;
    try {
        boolean interrupted = false;
        for (;;) {
            final Node p = node.predecessor();
            if (p == head) {
                int r = tryAcquireShared(arg);
                if (r >= 0) {
                    setHeadAndPropagate(node, r);
                    p.next = null; // help GC
                    if (interrupted)
                        selfInterrupt();
                    failed = false;
                    return;
                }
            }
            if (shouldParkAfterFailedAcquire(p, node) &&
                parkAndCheckInterrupt())
                interrupted = true;
        }
    } finally {
        if (failed)
            cancelAcquire(node);
    }
}

public final boolean releaseShared(int arg) {
    if (tryReleaseShared(arg)) {
        doReleaseShared();
        return true;
    }
    return false;
}
ConditionObject
AQS中Node除了组成阻塞队列外,还在ConditionObject中得到应用,ConditionObject的核心定义为:
public class ConditionObject implements Condition, java.io.Serializable {
    ...
    private transient Node firstWaiter;
    private transient Node lastWaiter;
    ...
}
ConditionObject通过Node也构成了一个FIFO的队列,那么ConditionObject为AQS提供了怎样的功能呢?
public interface Condition {
    ...
    void await() throws InterruptedException;
    void signal();
    void signalAll();
    ...
}
3、深刻理解锁
1、Timeunit
这是一个枚举类,也是位于 java.util.concurrent包下:
public enum TimeUnit {
    /**
     * Time unit representing one thousandth of a microsecond
     */
    NANOSECONDS {
        public long toNanos(long d)   { return d; }
        public long toMicros(long d)  { return d/(C1/C0); }
        public long toMillis(long d)  { return d/(C2/C0); }
        public long toSeconds(long d) { return d/(C3/C0); }
        public long toMinutes(long d) { return d/(C4/C0); }
        public long toHours(long d)   { return d/(C5/C0); }
        public long toDays(long d)    { return d/(C6/C0); }
        public long convert(long d, TimeUnit u) { return u.toNanos(d); }
        int excessNanos(long d, long m) { return (int)(d - (m*C2)); }
    },
可以看到时间单位有很多的,比如 DAY、SECONDS、MINUTES等,我们可以直接将其作为时间单位,比如我们要让一个线程等待1秒钟,可以像下面这样编写:
public static void main(String[] args) throws InterruptedException {
    Lock testLock = new ReentrantLock();
    new Thread(() -> {
        testLock.lock();
        try {
            System.out.println("等待是否未超时:"+testLock.newCondition().await(1, TimeUnit.SECONDS));
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        testLock.unlock();
    }).start();
}
当然,Lock类的tryLock方法也是支持使用时间单位的,各位可以自行进行测试。TimeUnit除了可以作为时间单位表示以外,还可以在不同单位之间相互转换:
public static void main(String[] args) throws InterruptedException {
    System.out.println("60秒 = "+TimeUnit.SECONDS.toMinutes(60) +"分钟");
    System.out.println("365天 = "+TimeUnit.DAYS.toSeconds(365) +" 秒");
}
也可以更加便捷地使用对象的 wait()方法:
public static void main(String[] args) throws InterruptedException {
    synchronized (Main.class) {
        System.out.println("开始等待");
        TimeUnit.SECONDS.timedWait(Main.class, 3);   //直接等待3秒
        System.out.println("等待结束");
    }
}
我们也可以直接使用它来进行休眠操作:
public static void main(String[] args) throws InterruptedException {
    TimeUnit.SECONDS.sleep(1);  //休眠1秒钟
}
2、了解锁的对象
sychronized锁的对象时方法的调用者,所以下面的运行过程时incrment在是decrment,因为线程sleep时不会释放锁导致data对象一直被锁,所以在线程A睡眠时,线程仍然是decrment还是无法获得锁
public class Test01 {
    public static void main(String[] args) throws InterruptedException {
        Data data = new Data();
        new Thread(()->{
            try {
                    data.incrment();
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        },"A").start();
        TimeUnit.SECONDS.sleep(4);
        new Thread(()->{
            try {
                data.decrment();
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        },"B").start();

    }
}
class Data {
    public synchronized void incrment() throws InterruptedException {
        TimeUnit.SECONDS.sleep(4);
        System.out.println("incrment被调用");
    }
    public synchronized void decrment() throws InterruptedException {
        System.out.println("decrment被调用");
    }
}
当同步方法加上static变成一个静态的方法,这时候锁的对象是class对象,class是全局唯一的,
相当于普通的synchronized的方法锁的是this对象
静态的synchronized方法是锁的class对象。如果判断那个结果先执行时,只需要判断是否锁的对象是同一个对象
4、集合类不安全
1、List
java.util.ConcurrentModificationException 并发修改异常
导致原因是因为 if (modCount != expectedModCount)modCount表示是修改的次数expectedModCount表示是预计修改的次数,即是modCount的值在初始化迭代器之后就会将modCount的值赋值给expectedModCount,在checkForComodification方法调用之前,有进来一个线程执行了add()操作导致modCount++最后出现异常
//java.util.ConcurrentModificationException   并发修改异常
public class Test02 {
    public static void main(String[] args) {
        List<String> list=new ArrayList<>();
        for (int i = 1; i <=10; i++) {
             new Thread(()->{
                 try {
                     TimeUnit.SECONDS.sleep(2);
                 } catch (InterruptedException e) {
                     e.printStackTrace();
                 }
                 list.add(UUID.randomUUID().toString().substring(0,5));
                 System.out.println(list);
             },String.valueOf(i)).start();
        }
    }
}
解决在并发场景下为了避免不出现并发修改异常 即不要使用ArrayList在这个不安全的集合了
- 使用Vector
List<String> list=new Vector<>();
为什么可以Vector可以解决呢?
分析一下:异常产生的原因是因为多个线程执行add()操作之后导致了modCount值和expectedModCountbu不等,所以只需要保证add()操作和checkForComodification方法只能有一个线程执行 即对其进行上锁,
Vector的add方法:
public synchronized boolean add(E e) {
    modCount++;
    ensureCapacityHelper(elementCount + 1);
    elementData[elementCount++] = e;
    return true;
}
Vector的checkForComodification方法
public E next() {
    synchronized (Vector.this) {
        checkForComodification();
        int i = cursor;
        if (i >= elementCount)
            throw new NoSuchElementException();
        cursor = i + 1;
        return elementData(lastRet = i);
    }
}
在使用迭代器的时候Iterator必须要加锁使用
2、使用Collection.synchronized(new ArrayList<>())来达到同步
add()方法
public boolean add(E e) {
    synchronized (mutex) {return c.add(e);}
}
注意不一定是任何情况下都安全
 public Iterator<E> iterator() {
            return c.iterator(); // Must be manually synched by user!
        }
在使用迭代器的时候Iterator必须要加锁使用
3、使用 new CopyOnWriterArrayList<>();
CopyOnWrite写入时复制,称为Cow 计算机程序设计领域的一种优化策略;在JUC包下
public boolean add(E e) {
    final ReentrantLock lock = this.lock;
    lock.lock();
    try {
        Object[] elements = getArray();
        int len = elements.length;
        Object[] newElements = Arrays.copyOf(elements, len + 1);
        newElements[len] = e;
        setArray(newElements);
        return true;
    } finally {
        lock.unlock();
    }
}
注意:这个方法是使用lock锁不是使用sychronized,synchronized的性能会比较慢
2、Set
与List一摸一样
HashSet的底层就是HashMap
public HashSet() {
    map = new HashMap<>();
}
add()
public boolean add(E e) {
    return map.put(e, PRESENT)==null;
}
1、使用Collection.synchronized(new hashSet<>())
2、new CopyOnWriterSet<>()
3、Map
一样
1、使用 new CopyOnWriterMap<>();
2、使用ConcurrentHashMap<>();
研究ConcurrentHashMap<>()原理
5、Callable
实现线程的第三种方式
与前两种方法的不同点是,callable的执行方法不是run方法,而是call方法,并且call是可以返回值(T泛型),并且需要抛出异常
@FunctionalInterface这是一个函数式接口,既是可以lambda表达式
@FunctionalInterface
public interface Callable<V> {
    /**
     * Computes a result, or throws an exception if unable to do so.
     *
     * @return computed result
     * @throws Exception if unable to compute a result
     */
    V call() throws Exception;
}
那如何使用new Thread().start 启动callable呢?
Future模式的核心思想是能够让主线程将原来需要同步等待的这段时间用来做其他的事情。(因为可以异步获得执行结果,所以不用一直同步等待去获得执行结果)类型AJAX
import java.util.concurrent.*;

public class AsyncExample {
    public static void main(String[] args) throws InterruptedException, ExecutionException {
        long start = System.currentTimeMillis();
        ExecutorService executor = Executors.newSingleThreadExecutor();
        Future<Integer> future = executor.submit(new Callable<Integer>() {
            @Override
            public Integer call() throws Exception {
                // 模拟耗时操作
               TimeUnit.SECONDS.sleep(2);
                return 42;
            }
        });
        long end = System.currentTimeMillis();
        // 获取异步任务的结果,如果任务还没有完成,会阻塞当前线程直到任务完成为止
        Integer result = future.get();
        System.out.println("执行时间"+(end-start)+"ms");
        System.out.println("异步任务的结果是:" + result);

        executor.shutdown();
    }
}
运行结果:
    执行时间6ms
    异步任务的结果是:42
官方:FutureTask 可用于包装 Callable 或 Runnable 对象。因为 FutureTask 实现了 Runnable ,所以 FutureTask 可以提交给 Executor 执行
| FutureTask(Callable |
创建一个 FutureTask ,它将在运行时执行给定的 Callable |
|---|---|
import java.util.*;
import java.util.concurrent.*;

//java.util.ConcurrentModificationException   并发修改异常
public class Test02 {
    public static void main(String[] args) throws ExecutionException, InterruptedException {
        Thread01 thread=new Thread01();
        FutureTask futureTask = new FutureTask(thread);//适配类
        new Thread(futureTask).start(); //启动线程
        Object o = futureTask.get();// 获得返回值
        System.out.println(o);
    }
}
class Thread01 implements Callable<String >{

    @Override
    public String call() throws Exception {
        return "hello";
    }
}
lamdba表达式的实现
Callable<Integer> callableObj = () -> { return 2*3; };
6、三大常见辅助类
1、CountDownLacth
一个减法计数器
CountDownLatch 使用给定的 count 进行初始化。 await 方法会阻塞,直到当前计数由于调用 countDown() 方法而变为零,之后所有等待的线程都会被释放,并且任何后续的 await 调用都会立即返回。这是一种一次性现象——无法重置计数。如果您需要重置计数的版本,请考虑使用 CyclicBarrier 。
构造方法:
public CountDownLatch(int count) {
    if (count < 0) throw new IllegalArgumentException("count < 0");
    this.sync = new Sync(count);
}
public class CountDownlatchTest {
    public static void main(String[] args) throws InterruptedException {
        CountDownLatch countDownLatch = new CountDownLatch(6);//初始化一个房间里面有几个
        for (int i = 0; i <6 ; i++) {
            new Thread(()-> {
                countDownLatch.countDown();//每次出来一个
            }
            ).start();
        }
        countDownLatch.await();//等待所有的人都出去之后,在执行
    }
}
2、CyclicBarrier
一个加法计数器
| 构造方法 | 描述 |
|---|---|
| CyclicBarrier(int parties) | 创建一个新的 CyclicBarrier,它将在给定数量的参与方(线程)等待时触发,并且在障碍触发时不执行预定义的操作。 |
| CyclicBarrier(int parties, Runnable barrierAction) | 创建一个新的 CyclicBarrier,当给定数量的参与方(线程)等待它时,它将触发,并在触发障碍时执行给定的障碍操作,由进入障碍的最后一个线程执行。 |
await 方法等待Barrier屏障数到达指定的数再会向下执行,如果线程数不都的话,那么这个程序就会一直的等待这里。或者是执行构造指定的线程。
3、Semaphore(信号量)
我们在操作系统里面学过信号量机制,信号量主要功能是实现线程之间的互斥访问。执行PV操作实现互斥
官方:计数信号量。从概念上讲,信号量维护一组许可。如果有必要,每个 acquire() 都会阻塞,直到获得许可,然后再获取许可。每个 release() 添加一个许可,可能会释放一个阻塞的获取者。但是,没有使用实际的许可对象; Semaphore 只是保持可用数量的计数并相应地采取行动。
acquire(),相当于P操作,对信号量执行减一操作。
release(),相当于V操作,对信号量执行加一操作。
7、ReadWriteLock对写锁
ReadWriteLock 维护一对关联的 locks ,一个用于只读操作,一个用于写入。读锁 可以由多个读取器线程同时持有,只要没有写入器。 写锁 是排他性的,只能有一个线程执行。
/***
 *  独占锁(写锁),就是只允许一个线程进行操作
 *  共享锁(读锁),允许多个线程进行操作
 *  读-读  可以共存
 *  读-写  不可共存
 *  写-写  不可共存
 */
public class ReadWriteLockTest {
    public static void main(String[] args) {
        MyCacheLock myCacheLock = new MyCacheLock();
        for (int i = 1; i <= 20; i++) {
            final int t = i;
            new Thread(() -> {
                myCacheLock.Write(t + "", t + "");
            }).start();
        }
        for (int i = 1; i <= 20; i++) {
            final int t = i;
            new Thread(() -> {
                myCacheLock.Read(t + "");
            }).start();
        }
    }
}
class MyCacheLock {
    //volatile是为了保证原子性操作
    private volatile Map<String, String> map = new HashMap<>();
    private ReadWriteLock readWriteLock = new ReentrantReadWriteLock();

    public void Write(String key, String value) {
        readWriteLock.writeLock().lock();
        try {
            map.put(key, value);
            System.out.println(Thread.currentThread().getName() + "写入");
            System.out.println(Thread.currentThread().getName() + "写入完成");
        } catch (Exception e) {
            e.printStackTrace();
        }
        readWriteLock.writeLock().unlock();
    }

    public void Read(String key) {
        readWriteLock.readLock().lock();
        try {
            String s = map.get(key);
            System.out.println(s + "读出成功");
            readWriteLock.readLock().unlock();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
8、堵塞队列
什么情况下队列会堵塞?
- 当添加元素时,队列已经满了,导致元素无法加入队列
- 当队列为空时,需要从队列种取出元素。
BlockingQueue
官方文档 :
public interface BlockingQueue<E> extends Queue <E>
该类是一个接口
四大API
| 操作 | 抛出异常 | 不抛出异常 | 等待 | 超时等待 |
|---|---|---|---|---|
| 插入 | add(e) | offer(e) | put(e) | offer(e,time,TimeUnit) |
| 删除 | remove() | poll() | take() | poll(time,TimeUnit) |
| 检查队首的元素 | element() | peek() | —— | —— |
BlockingQueue 实现主要用于生产者-消费者队列,但还支持 Collection 接口
BlockingQueue 实现是线程安全的。所有排队方法都使用内部锁或其他形式的并发控制以原子方式实现其效果。然而,bulk 集合操作addAll、containsAll、retainAll 和removeAll 必须以原子方式执行,除非在实现中另有说明。因此,例如,在仅添加 c 中的一些元素后, addAll(c) 可能会失败(抛出异常)。
同步队列SynchronizedQueue
没有容量,只能是一个进一个出。同步队列没有任何内部容量,甚至没有一个容量。您不能在同步队列中peek,因为元素仅在您尝试删除它时才存在;你不能插入一个元素(使用任何方法),除非另一个线程试图删除它;你不能迭代,因为没有什么可以迭代的。
BlockingDeque双端队列
顾名思义:双端队列的两端都是可以操作值的
Deque 还支持阻塞操作,在检索元素时等待双端队列变为非空,并在存储元素时等待双端队列中的空间可用
BlockingDeque 方法总结:
头:
| 操作 | 抛出异常 | 不抛出异常 | 等待 | 超时等待 |
|---|---|---|---|---|
| 插入 | addFirst(e) |
offerFirst(e) |
putFirst(e) |
offerFirst(e, time, unit) |
| 删除 | removeFirst() |
pollFirst() |
takeFirst() |
pollFirst(time, unit) |
| 检查队首元素 | getFirst() |
peekFirst() |
—— | —— |
尾巴:
| 操作 | 抛出异常 | 不抛出异常 | 等待 | 超时等待 |
|---|---|---|---|---|
| 插入 | addLast(e) |
offerLast(e) |
putLast(e) |
offerLast(e, time, unit) |
| 删除 | removeLast() |
pollLast() |
takeLast() |
pollLast(time, unit) |
| 检查队尾元素 | getLast() |
peekLast() |
—— | —— |
9、线程池(重点)
什么是池技术?
池技术,我们在JDBC的时候应该就已经遇到了。JDBC连接池,
所谓的池的技术就是,在先前就已经创建好了资源,如果有需要什么资源的,那就是从一个池塘里面去取,用完之后还回到池塘里面,
优点:
- 降低资源消耗。
- 提高效率,减少了创建和消耗的步骤
- 方便管理
总结:线程复用,可以控制最大并发数,易于管理。
如何创建线程池?
使用Executors创建线程池
-
创建一个线程池
使用Executors.newSingleThreadExecutor()单个线程
public static ExecutorService newSingleThreadExecutor() {
    return new FinalizableDelegatedExecutorService
        (new ThreadPoolExecutor(1, 1,
                                0L, TimeUnit.MILLISECONDS,
                                new LinkedBlockingQueue<Runnable>()));
}
import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; public class ThreadPoolTest { public static void main(String[] args) { ExecutorService ThreadPool = Executors.newSingleThreadExecutor(); //创建一个单线程的线程池 try { for (int i = 1; i <=10; i++) { //使用线程池里面的线程 ThreadPool.execute(()->{ System.out.println(Thread.currentThread().getName()+"执行完成"); }); } } catch (Exception e) { e.printStackTrace(); }finally{ //程序结束关闭线程 ThreadPool.shutdown(); } } }
执行结果:可以看到线程的名称都是一样的,所以该线程吃里面只存在一个线程。
pool-1-thread-1执行完成
pool-1-thread-1执行完成
pool-1-thread-1执行完成
pool-1-thread-1执行完成
pool-1-thread-1执行完成
pool-1-thread-1执行完成
pool-1-thread-1执行完成
pool-1-thread-1执行完成
pool-1-thread-1执行完成
pool-1-thread-1执行完成
-
创建一个指定数目线程池
使用ExecutorService ThreadPool = Executors.newFixedThreadPool(5); //创建指定数目的线程池
newFixedThreadPool(int) 源代码:
    public static ExecutorService newFixedThreadPool(int nThreads) {
        return new ThreadPoolExecutor(nThreads, nThreads,
                                      0L, TimeUnit.MILLISECONDS,
                                      new LinkedBlockingQueue<Runnable>());
    }
执行结果:看到线程名称最大只有到5
pool-1-thread-3执行完成 pool-1-thread-1执行完成 pool-1-thread-5执行完成 pool-1-thread-2执行完成 pool-1-thread-4执行完成 pool-1-thread-2执行完成 pool-1-thread-5执行完成 pool-1-thread-1执行完成 pool-1-thread-3执行完成 pool-1-thread-4执行完成 -
创建一个可以伸缩的线程池(可以根据线程数的多少和处理时间来动态的变换线程的多少)
使用ExecutorService ThreadPool = Executors.newCachedThreadPool(); //可以伸缩的线程池
newCachedThreadPool()源代码:
public static ExecutorService newCachedThreadPool() {
    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                  60L, TimeUnit.SECONDS,
                                  new SynchronousQueue<Runnable>());
}
ThreadPoolExecutor
使用new ThreadPoolExecutor方式创建
我们其实可以观察到其实使用Executors创建的线程池的三个方法下面的底层都是使用的ThreadPoolExecutor方法进行创建的。我们想知道如何使用ThreadPoolExecutor创建线程就必须知道它的构造器参数的意思
ThreadPoolExecutor七大参数说明
public ThreadPoolExecutor(int corePoolSize,   //核心线程数(就是会存在的线程最少数量)
                          int maximumPoolSize, //最大线程数
                          long keepAliveTime,  //超时时间,当这个时间没有线程了之后,就会释放一些线程
                          TimeUnit unit,   //时间单位
                          BlockingQueue<Runnable> workQueue, //堵塞队列,相当于一个缓冲区
                          ThreadFactory threadFactory, //线程工厂
                          RejectedExecutionHandler handler   //拒绝处理的措施,未执行的线程数大于了缓冲区和最大线程数量之和之后会穿法的机制) {
    this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue,
         Executors.defaultThreadFactory(), handler);
}
创建实例
ThreadPoolExecutor ThreadPool = new ThreadPoolExecutor(2,
        5,
        3,
        TimeUnit.SECONDS,
        new LinkedBlockingDeque<Runnable>(3),
        Executors.defaultThreadFactory(),
        new ThreadPoolExecutor.DiscardPolicy()
        );
狂神老师指出的银行业务,方便理解七大参数的意义:
Core:指的是今天上班固定的两个柜台
Max:是最大数量的柜台
keepAliveTime:经过多长指定时间之后,没有人办理业务时,3,4,5柜台就会重新的关闭
BlockingQueue:相当于休息区的座位。
RejectedExectionHandler:当休息区和柜台办理都满了之后,如果继续和客人的话就会触发。
RejectedExectionHandler四大拒绝策略
默认的拒绝策略: new AbortPolicy(); 当线程数量超过了BlockingQueue的数量+Max的数量之后就会抛出RejectedExecutionException
        public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
            throw new RejectedExecutionException("Task " + r.toString() +
                                                 " rejected from " +
                                                 e.toString());
        }
使用DiscardPolicy策略:不会抛出异常。
public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
}
使用DiscardOldestPolicy策略:会尝试和最早的竞争一下,如果最早的执行完了,就会立即执行,否则抛弃掉这个不会抛出异常
public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
    if (!e.isShutdown()) {
        e.getQueue().poll();
        e.execute(r);
    }
使用CallerRunsPolicy策略:会将其返回到原来的调用者
public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
    if (!e.isShutdown()) {
        r.run();
    }
}
小结和拓展
最大线程池数到底应该如何确定?
-
CPU密集型:CPU时几核的就将其定义成几,这个时候CPU利用率最大
如何获取CPU的核数
Runtime.getRuntime().availableProcessors();//获取CPU的核数一般一个核心对应了一个线程,而intel开发出了超线程技术,1个核心能够做到2个线程计算,而6个核心则能够做到12个线程,
-
IO密集型:判断程序中十分消耗IO的线程 ,一般设置的值是2倍
10、四大函数式接口
函数式接口注解@FunctionalInterface,并且只有唯一一个方法
举个栗子:
@FunctionalInterface
public interface Runnable {
    /**
     * When an object implementing interface <code>Runnable</code> is used
     * to create a thread, starting the thread causes the object's
     * <code>run</code> method to be called in that separately executing
     * thread.
     * <p>
     * The general contract of the method <code>run</code> is that it may
     * take any action whatsoever.
     *
     * @see     java.lang.Thread#run()
     */
    public abstract void run();
}
Function函数式接口
Function源码:
注意:Function需要接收两个泛型,接收一个T类型的参数,返回一个R类型的值
@FunctionalInterface
public interface Function<T, R> {

    /**
     * Applies this function to the given argument.
     *
     * @param t the function argument
     * @return the function result
     */
    R apply(T t);
    }
public class FunctionTest {
    public static void main(String[] args) {
        //使用Function的lamdba表达式
        Function<String,String> function=(str)->{
              return str;
        };
        System.out.println(function.apply("123"));
    }
}
断定式接口
Predicate只有一个test方法,并且接收一个泛型参数,返回值为boolean值,一样可以使用lamdba表达式来简化
@FunctionalInterface
public interface Predicate<T> {

    /**
     * Evaluates this predicate on the given argument.
     *
     * @param t the input argument
     * @return {@code true} if the input argument matches the predicate,
     * otherwise {@code false}
     */
    boolean test(T t);
}
消费型接口 Consumer
没有返回值
@FunctionalInterface
public interface Consumer<T> {

    /**
     * Performs this operation on the given argument.
     *
     * @param t the input argument
     */
    void accept(T t);
    }
供给型接口Supplier
只有返回值
@FunctionalInterface
public interface Supplier<T> {

    /**
     * Gets a result.
     *
     * @return a result
     */
    T get();
}
11、Stream流式计算
什么是流式计算
stream jdk在线文档java.util.stream - Java17中文文档 - API参考文档 - 全栈行动派 (qzxdp.cn)
综合实例:
题目描述,使用Stream流式计算
-
id必须是偶数
-
年龄必须大于23岁
-
用户名转为大写字母
-
用户名的字母倒着排序
-
只输出一个用户
public class FunctionTest {
    public static void main(String[] args) {
          User u1=new User(1, "a",21);
          User u2=new User(2, "b",22);
          User u3=new User(3, "c",23);
          User u4=new User(4, "d",24);
          User u5=new User(5, "e",25);
          //集合用来存储元素
        List<User> list = Arrays.asList(u1,u2,u3,u4,u5);
        // 计算交给Stream流
        list.stream()
                .filter((u)->{return u.getId()%2==0;})
                .filter((u)->{return u.getAge()>=23;})
                .map((u)->{return u.getName().toUpperCase();})
                .sorted((uu1,uu2)->{return uu1.compareTo(uu2);})
                .limit(1)
                .forEach(System.out::println);
    }
}
filter(Predicate<? super T> predicate) 返回一个流,该流由与给定谓词匹配的此流的元素组成。 map(Function<? super T,? extends R> mapper) 返回一个流,该流由将给定函数应用于此流的元素的结果组成。
12、Forkjoin详解
Java 1.7 引入了一种新的并发框架—— Fork/Join Framework,主要用于实现“分而治之”的算法,特别是分治之后递归调用的函数。
ForkJoin框架的本质是一个用于并行执行任务的框架,能够把一个大任务分割成若干个小任务,最终汇总每个小任务结果后得到任务的计算结果
Forkjoin特点:工作窃取
工作窃取算法
假如我们需要做一个比较大的任务,我们可以把这个任务分割为若干互不依赖的子任务,为了减少线程间的竞争,于是把这些子任务分别放到不同的队列里,并为每个队列创建一个单独的线程来执行队列里的任务,线程和队列一一对应,比如A线程负责处理A队列里的任务。但是有的线程会先把自己队列里的任务干完,而其他线程对应的队列里还有任务等待处理。干完活的线程与其等着,不如去帮其他线程干活,于是它就去其他线程的队列里窃取一个任务来执行。而在这时它们会访问同一个队列,所以为了减少窃取任务线程和被窃取任务线程之间的竞争,通常会使用双端队列,被窃取任务线程永远从双端队列的头部拿任务执行,而窃取任务的线程永远从双端队列的尾部拿任务执行。
【高并发】什么是ForkJoin?看这一篇就够了!-阿里云开发者社区 (aliyun.com)
ForkjoinPool任务执行方式总结:
| 来自非分叉/加入客户的呼叫 | 从 fork/join 计算中调用 | |
|---|---|---|
| 安排异步执行 | execute(ForkJoinTask) |
ForkJoinTask.fork() |
| 等待并获得结果 | invoke(ForkJoinTask) |
ForkJoinTask.invoke() |
| 安排exec并获得Future | submit(ForkJoinTask) |
ForkJoinTask.fork() (ForkJoinTasks are 期货) |
如何使用ForkJoin?
-
从上面的表格可以看出要么参数是ForkJoinTask,要么就是ForkJoinTask里面的静态方法,所以我们需要区理解ForkJoinTask是什么
ForkJoinTask是一个类似线程的实体,比普通线程轻得多。以一些使用限制为代价,大量任务和子任务可能由 ForkJoinPool 中的少量实际线程托管。这就表明了ForkJoin的使用,其实和线程的使用差不多。使用池子来使用 -
观看官方文档发现ForkJoinTask还有CountedCompleter(计数完成器)
,RecursiveAction(递归事件),RecursiveTask(递归任务)三个子类分别都有相应的列子1、RecursiveAction:无返回值的任务。
2、RecursiveTask:有返回值的任务。
3、CountedCompleter:完成任务后将触发其他任务。
举个栗子:RecursiveTask,官方列子,很像递归
class Fibonacci extends RecursiveTask<Integer> {
  final int n;
  Fibonacci(int n) { this.n = n; }
  protected Integer compute() {
   if (n <= 1)
    return n;
   Fibonacci f1 = new Fibonacci(n - 1);
   f1.fork();
   Fibonacci f2 = new Fibonacci(n - 2);
   return f2.compute() + f1.join();
  }
 }
求和,1~10_0000_0000;RecursiveTask感觉还是递归的思想。其中的limit是可以继续调优的
public class ForkJoinTest extends RecursiveTask<Long> {
    private Long start;
    private Long end;
    private Long limit=1000L;
    private Long sum=0L;

    public ForkJoinTest(Long start, Long end) {
        this.start = start;
        this.end = end;
    }

    @Override
    protected Long compute() {
        //任务量小时
        if(end-start<limit){
            for (Long i = start;  i <=end; i++) {
                sum+=i;
            }
        }else{
            //大任务量,将一个大任务分成功多个小的任务
            Long mid=(start+end)>>1;
            ForkJoinTask forkJoinTest1 = new ForkJoinTest(start,mid);
            ForkJoinTask forkJoinTest2 = new ForkJoinTest(mid+1,end);
            forkJoinTest1.fork();//将任务提交到队列中
            forkJoinTest2.fork();
            Long join1 = (Long) forkJoinTest1.join();
            Long join2 = (Long) forkJoinTest2.join();
            sum+=(join1+join2);
        }
        return sum;
    }

    public static void main(String[] args) {
        ForkJoinPool pool=new ForkJoinPool();
        ForkJoinTest test=new ForkJoinTest(1L,10_0000_0000L);
        ForkJoinTask<Long> submit = pool.submit(test);
        System.out.println(submit.join());
    }
}
使用debug可以观察到开启了多个ForkJoin来进行计算
拓展:使用Stream流式并行计算来提高效率
效率是使用暴力的几十倍。
LongStream.rangeClosed(0L,10_0000_0000L).parallel().reduce(0,Long::sum);
13、JMM
什么时JMM?
JMM就是Java内存模型(java memory model)。因为在不同的硬件生产商和不同的操作系统下,内存的访问有一定的差异,所以会造成相同的代码运行在不同的系统上会出现各种问题。所以java内存模型(JMM)屏蔽掉各种硬件和操作系统的内存访问差异,以实现让java程序在各种平台下都能达到一致的并发效果。本质是不存在的,只是一种概念和约定
关于JMM的一些同步约定
- 在线程解锁之前,线程必须将共享变量立即的刷回主存
- 在线程加锁之前,必须要读取主存中的最新值。
- 加锁和解锁必须要是同一把锁
图解JMM八种内存交互操作
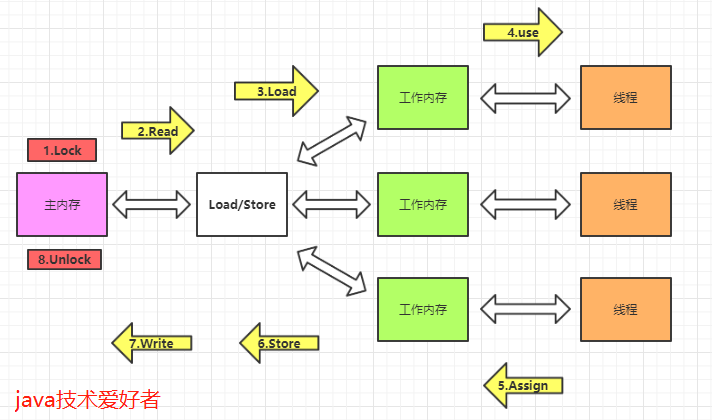
- lock(锁定),作用于主内存中的变量,把变量标识为线程独占的状态。
- read(读取),作用于主内存的变量,把变量的值从主内存传输到线程的工作内存中,以便下一步的load操作使用。
- load(加载),作用于工作内存的变量,把read操作主存的变量放入到工作内存的变量副本中。
- use(使用),作用于工作内存的变量,把工作内存中的变量传输到执行引擎,每当虚拟机遇到一个需要使用到变量的值的字节码指令时将会执行这个操作。
- assign(赋值),作用于工作内存的变量,它把一个从执行引擎中接受到的值赋值给工作内存的变量副本中,每当虚拟机遇到一个给变量赋值的字节码指令时将会执行这个操作。
- store(存储),作用于工作内存的变量,它把一个从工作内存中一个变量的值传送到主内存中,以便后续的write使用。
- write(写入):作用于主内存中的变量,它把store操作从工作内存中得到的变量的值放入主内存的变量中。
- unlock(解锁):作用于主内存的变量,它把一个处于锁定状态的变量释放出来,释放后的变量才可以被其他线程锁定。
我再补充一下JMM对8种内存交互操作制定的规则吧:
- 不允许read、load、store、write操作之一单独出现,也就是read操作后必须load,store操作后必须write。
- 不允许线程丢弃他最近的assign操作,即工作内存中的变量数据改变了之后,必须告知主存。
- 不允许线程将没有assign的数据从工作内存同步到主内存。
- 一个新的变量必须在主内存中诞生,不允许工作内存直接使用一个未被初始化的变量。就是对变量实施use、store操作之前,必须经过load和assign操作。
- 一个变量同一时间只能有一个线程对其进行lock操作。多次lock之后,必须执行相同次数unlock才可以解锁。
- 如果对一个变量进行lock操作,会清空所有工作内存中此变量的值。在执行引擎使用这个变量前,必须重新load或assign操作初始化变量的值。
- 如果一个变量没有被lock,就不能对其进行unlock操作。也不能unlock一个被其他线程锁住的变量。
- 一个线程对一个变量进行unlock操作之前,必须先把此变量同步回主内存。
更加直观的理解八大交互操作和可能存在的线程问题
问题指出:当线程A频繁的去判断num的,导致没有机会去读取主存中的最新值。当线程B将num=1时,并在解锁之前将最新的值刷回到主存。这是就会导致线程A里面的值仍然是num=0。出现了线程的工作内存于主存的数据不一致。
举个栗子:如下,现在程序中有两个线程,一个是new Thread,一个是main线程,当main线程将num的值改为1时,正常情况是new Thread线程应该会立即停止。但实际是线程new thread并没有停止。说明了产生了,线程new Thread工作内存的num的值还饿米有发生改变。出现了线程工作内存和主存的数据不一致的情况。
import java.util.concurrent.TimeUnit;

public class JMMTest {
    private static static  int num=0;
    public static void main(String[] args) {
        new Thread(()->{
            while(num==0){

            }
        }).start();
        try {
            TimeUnit.SECONDS.sleep(5);//保证线程new Thread已经开始执行了
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        num=1;
        System.out.println(num);
    }
}
Volatile关键字
Volatile的三大特征
- 保证可见性
- 不保证原子性
- 禁止指令重排序
保持可见性
可见性:可见性指当一个线程修改共享变量的值,其他线程能够立即知道被修改了。上面出现的问题原因是因为线程new Thread线程对主存不具有可见性,所以在主存的值发生改变时,线程new Thread不知道主存里面的值已经改变了。
解决这问题:使用Volatile关键字
import java.util.concurrent.TimeUnit;

public class JMMTest {
    private volatile static  int num=0;
    public static void main(String[] args) {
        new Thread(()->{
            while(num==0){

            }
        }).start();
        try {
            TimeUnit.SECONDS.sleep(5);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        num=1;
        System.out.println(num);
    }
}
不保证原子性
原子性:是不可以被打断的和被分割的,要么成功要么错误。
验证这一特点可以使用多线程对num++。因为num++不是一个原子性的操作。最后结果与期待值进行比较。
import java.util.concurrent.TimeUnit;
import java.util.concurrent.atomic.AtomicInteger;

public class JMMTest {
    private   static  volatile int  num=0;
    public  static  void run(){
            num++;
    }
    public static void main(String[] args) {
        for (int i = 1; i <=10; i++) {
            new Thread(()->{
                for (int j = 0; j <2000; j++) {
                    run();
                }
            }).start();
        }
        while(Thread.activeCount()>2){
            Thread.yield();
        }
        System.out.println(num);
    }
}
我们通过javap -c Object.class命令将Object.class类进行反编译,我们可以看到num++在底层是实现了三步的。
在不是使用lock和sychronized的情况下我们如何将其保持原子性?
在JUC里面有一个神奇的类Atomic原子类,
官方介绍:
支持对单个变量进行无锁线程安全编程的小型类工具包。每个类还为该类型提供适当的实用方法。例如,类 AtomicLong 和 AtomicInteger 提供原子增量方法。
import java.util.concurrent.TimeUnit;
import java.util.concurrent.atomic.AtomicInteger;

public class JMMTest {
    private  static volatile AtomicInteger  num=new AtomicInteger();
    public  static  void run(){
            num.getAndIncrement();
    }
    public static void main(String[] args) {
        for (int i = 1; i <=10; i++) {
            new Thread(()->{
                for (int j = 0; j <2000; j++) {
                    run();
                }
            }).start();
        }
        while(Thread.activeCount()>2){
            Thread.yield();
        }
        System.out.println(num);
    }
}
禁止指令重排
计算机在执行程序时,为了提高性能,编译器和处理器常常会做指令排重,一般分为以下三种:

处理器在进行指令重排序时必须考虑指令之间的数据依赖性
比如:
int x=1;1
int y=2;2
x=x+10;3
y=x+x;4
重排可能产生的结果:1234 ,1324,1243,2134,这些重排方式都不影响结果
不可能出现4321的情况,这就是数据依赖性导致。
上面时单线程的情况。
多线程环境中线程交替执行,由于编译器指令重排的存在,两个线程使用的变量能否保证一致性是无法确认的,结果无法预测。可能会导致结果的错误。

Volatile是如何禁止指令重排的呢?
先了解下概念,内存屏障(Memory Barrier)又称内存栅栏,是一个CPU指令,它的作用有两个:
-
保证特定操作执行的顺序性
-
保证某些变量的内存可见性(利用该特性实现volatile内存可见性)
volatile实现禁止指令重排优化底层原理:
由于编译器和处理器都能执行指令重排优化。如果在指令间插入一条Memory Barrier则会告诉编译器和CPU,不管什么指令都不能和这条Memory Barrier指令重排,也就是说通过插入内存屏障,就能禁止在内存屏障前后的指令执行重排优化。内存屏障另外一个作用就是强制刷出各种CPU的缓存数据,因此任何CPU上的线程都能读取到这些数据的最新版本。
原文链接:https://blog.csdn.net/qq_41765712/article/details/105633173
Volatile主要使用场景单例模式
单例模式
什么式单例模式
这种模式涉及到一个单一的类,该类负责创建自己的对象(将构造器私有),同时确保只有单个对象被创建。这个类提供了一种访问其唯一的对象的方式,可以直接访问,不需要实例化该类的对象。
注意:
- 1、单例类只能有一个实例。
- 2、单例类必须自己创建自己的唯一实例。
- 3、单例类必须给所有其他对象提供这一实例。
饿汉式
顾名思义该形式很饿所以一开始就将实例对象创建好了。
public class SingleObject {

   //创建 SingleObject 的一个对象
   private static SingleObject instance = new SingleObject();

   //让构造函数为 private,这样该类就不会被实例化
   private SingleObject(){}

   //获取唯一可用的对象
   public static SingleObject getInstance(){
      return instance;
   }

   public void showMessage(){
      System.out.println("Hello World!");
   }
}
存在的弊端:可能会浪费内存,如果这个类里面的变量有多个并且很占内存,当程序启动时这些成员变量就会创建成功,占据大量内存。
懒汉式
基本的懒汉式
描述:这种方式是最基本的实现方式,这种实现最大的问题就是不支持多线程。因为没有加锁 synchronized,所以严格意义上它并不算单例模式。
public class Singleton {
    private static Singleton instance;
    private Singleton (){}
    //当需要的时候创建。
    public static Singleton getInstance() {
        if (instance == null) {
            instance = new Singleton();
        }
        return instance;
    }
}
加锁了的懒汉式
描述:这种方式具备很好的 lazy loading,能够在多线程中很好的工作,但是,效率很低,99% 情况下不需要同步。
优点:第一次调用才初始化,避免内存浪费。
缺点:必须加锁 synchronized 才能保证单例,但加锁会影响效率。
public class Singleton {
    private static Singleton instance;
    private Singleton (){}
    public static synchronized Singleton getInstance() {
        if (instance == null) {
            instance = new Singleton();
        }
        return instance;
    }
}
DCL懒汉式(双检锁/双重校验锁)
描述:这种方式采用双锁机制,安全且在多线程情况下能保持高性能。
public class Singleton {
    private volatile static Singleton singleton;
    private Singleton (){}
    public static Singleton getSingleton() {
    if (singleton == null) {
        synchronized (Singleton.class) {
            if (singleton == null) {
                singleton = new Singleton();
            }
        }
    }
    return singleton;
    }
}
注意:这里的singleton对象是加了Volatile,因为singleton=new Singleton();不是一个原子性操作,主要分为3步来实现
-
给 singleton 分配内存
-
调用 Singleton 的构造函数来初始化成员变量,形成实例
-
将singleton对象指向分配的内存空间(执行完这步 singleton才是非 null 了)
这就又可能会发生指令重排,造成了132顺序,如果是这个顺序的话,就会出现线程A已经执行了3,准备执行2之前,有一个线程来执行getSingleton()方法,判断singleton是否等于NULL,这是线程A已经执行了3,singleton就不为NULL,于是线程B就返回singleton,造成线程B并获取到singleton的实列对象。
但是上面的方法并不是安全的,我们知道反射下面没有private.如果我们通过反射机制直接使用静态方法来创建的话,是可以破坏单列模式的。
原子类(Atomic)
原子类为什么可以保持原子性呢?
AtomicInteger.getAndIncrement方法源码,
public final int getAndIncrement() {
    return unsafe.getAndAddInt(this, valueOffset, 1);
}
注意:里面有一个unsafe类,unsafe类的大部门方法都是native本地方法,由于java不能操控底层,但是java可以调用C++来操作底层。
总结:unsafe是java为了操作底层的‘后门’,通过unsafe类来操作内存,实现原子性操作。
unsafe里面的getAndAddInt()方法
public final int getAndIncrement() {
    return unsafe.getAndAddInt(this, valueOffset, 1);
}
public final int getAndAddInt(Object var1, long var2, int var4) {
        int var5;
        do {
            var5 = this.getIntVolatile(var1, var2);
        } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4)); //使用自旋锁,保持线程安全,当存在一个线程执行是

        return var5;
    }
compareAndSwapInt(CAS)参数介绍:
(1)object:就是将要修改的值的对象.
(2)offect:对象在内存中偏移量为offset处的值,就是要修改的数据的值在内存中的偏移量,
结合object + offect找到要修改的值.
(3)expect:期望内存中的值,就是拿这个值和 object + offect值进行比较;如果相同则修改,返回true,否则返回false,等下次修改.
(4)update:如果上一步对比相等,则将这个值赋值给 object + offect值,然后返回true。
getAndAddInt方法是如何保证线程安全的
 do {
            var5 = this.getIntVolatile(var1, var2);
        } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4));
使用自旋锁,如果某个线程在执行过程中的值已经被其他的值改变了,在执行CompareAndSwapInt(CAS)就会返回false,这个线程也就会一直的在do{}while里面循环执行,知道执行成功。
CAS导致自旋消耗
多个线程争夺同一个资源时,如果自旋一直不成功,将会一直占用CPU。
解决方法:破坏掉for死循环,当超过一定时间或者一定次数时,return退出。JDK8新增的LongAddr,和ConcurrentHashMap类似的方法。当多个线程竞争时,将粒度变小,将一个变量拆分为多个变量,达到多个线程访问多个资源的效果,最后再调用sum把它合起来。
理解CAS
CAS(Compare-and-Swap),即比较并替换,是一种实现并发算法时常用到的技术,Java并发包中的很多类都使用了CAS技术。
我们先了解java层面的CAS(CompareAndSet)
这个方法是调用更加底层的CAS
    public final boolean compareAndSet(V expect, V update) {
        //参数介绍:
        //expect  是期望的值
        //uodate  更新的值
       //当调用对象的值和expect的值相等时,就会将对象的值更新为update的值
        return unsafe.compareAndSwapObject(this, valueOffset, expect, update);
    }
    public final native boolean compareAndSwapObject(Object var1, long var2, Object var4, Object var5);
//是一个unsafe类下面的native方法。
//最终保证原子性是通过,硬件层面的指令,comxchg完成的。如果是多核的情况下,就会上锁。LOCK_IF_MP(mutil Processors)
ABA问题
ABA问题,可以简单的理解成为(狸猫换太子)
线程在执行之前,线程B将原来的主存里面的值修改了,并且又将值该回去。
举个例子:
你ATM1向小李转账100,这是ATM1由于某些问题卡住了,当你使用ATM2转账时,ATM2很快就成功了。当小明又给了100之后,ATM1恢复正常,ATM1比较结果还是100,就会发生转账,结果转账成功,你的钱就没有了。
解决ABA问题
ABA问题的关键是因为当值发生改变时我们无法知道他是否已经被修改。我们应该很容易的想到可以用标识来记录数据有没有被改变,类似于乐观锁。当版本号不相等时就知道数据是已经发生了改变的。
Atomic原子类中提供了同样作用的方法:原子引用
在AtomicStampedReference 类里面compareAndSet方法
    public boolean compareAndSet(V   expectedReference,  //期望值
                                 V   newReference,   //更新值
                                 int expectedStamp,  //期望的时间戳(版本号)
                                 int newStamp) {     //新的时间戳(版本号)
        Pair<V> current = pair;
        return
            expectedReference == current.reference &&
            expectedStamp == current.stamp &&
            ((newReference == current.reference &&
              newStamp == current.stamp) ||
             casPair(current, Pair.of(newReference, newStamp)));
    }
AtomicStampedReference 类方法总结
可以通过getStamp()和CompareAndSet()方法联合使用,实现乐观锁的效果。
锁
可重入锁
可重入锁,也叫做 递归锁,从名字上理解,字面意思就是再进入的锁,重入性是指任意线程在获取到锁之后能够再次获取该锁而不会被锁阻塞,首先他需要具备两个条件:
- 线程再次获取锁:所需要去识别获取锁的线程是否为当前占据锁的线程,如果是,则再次获取成功
- 锁的最终释放:线程重复n次获取了锁,随后在第n次释放该锁后,其它线程能够获取到该锁。锁的最终释放要求锁对于获取进行计数自增,计数表示当前线程被重复获取的次数,而被释放时,计数自减,当计数为0时表示锁已经成功释放。
java中的可重入锁:ReentrantLock 全部方法ReentrantLock - Java17中文文档 - API参考文档 - 全栈行动派 (qzxdp.cn)
Sychronized也是可以重入的
public static void main(String[] args) throws InterruptedException {
    ReentrantLock lock = new ReentrantLock();
    lock.lock();
    lock.lock();   //连续加锁2次
    new Thread(() -> {
        System.out.println("线程2想要获取锁");
        lock.lock();
        System.out.println("线程2成功获取到锁");
    }).start();
    lock.unlock();
    System.out.println("线程1释放了一次锁");
    TimeUnit.SECONDS.sleep(1);
    lock.unlock();
    System.out.println("线程1再次释放了一次锁");  //释放两次后其他线程才能加锁
}
总结
ReentrantLock 是java中非常重要的一个并发工具,相比于java原生的 synchronized 有着更好的性能,学习 ReentrantLock ,我们主要需要了解它,公平锁 和 非公平锁 的实现,以及重入锁的获取与释放的流程,还有最重要的就是要了解AQS(AbstractQueuedSynchronizer),这是实现重入锁的基础,ReentrantLock 是一个比较轻量级的锁,而且使用面向对象的思想去实现了锁的功能,比原来的synchronized 关键字更加好理解。
ReentrantLock底层使用CAS和AQS
ReentrantLock非公平锁的实现
final void lock() {
    if (compareAndSetState(0, 1))  //尝试获取锁
        setExclusiveOwnerThread(Thread.currentThread());
    else
        acquire(1);
}
//获取到获得锁的线程
protected final void setExclusiveOwnerThread(Thread thread) {
    exclusiveOwnerThread = thread;
}
//由于可重入锁,当线程第二次需要获得锁时
//尝试获取锁
protected final boolean tryAcquire(int acquires) {
            return nonfairTryAcquire(acquires);
}

final boolean nonfairTryAcquire(int acquires) {
    final Thread current = Thread.currentThread();
    int c = getState();  //所得该锁对象state(就是已经由多少锁了)
    if (c == 0) {  //如果原来的锁已经释放锁了,就直接上锁
        if (compareAndSetState(0, acquires)) {
            setExclusiveOwnerThread(current);
            return true;
        }
    }
    else if (current == getExclusiveOwnerThread()) {  //通过本线程与上锁线程比较是否是同一线程
        int nextc = c + acquires;  //将state数值加1
        if (nextc < 0) // overflow
            throw new Error("Maximum lock count exceeded");
        setState(nextc);
        return true;
    }
    return false;
}
ReentrantLock公平锁的实现,也是大同小异
final void lock() {
    acquire(1);
}
protected final boolean tryAcquire(int acquires) {
    final Thread current = Thread.currentThread();
    int c = getState();
    if (c == 0) {
        if (!hasQueuedPredecessors() &&
            compareAndSetState(0, acquires)) {
            setExclusiveOwnerThread(current);
            return true;
        }
    }
    else if (current == getExclusiveOwnerThread()) {
        int nextc = c + acquires;
        if (nextc < 0)
            throw new Error("Maximum lock count exceeded");
        setState(nextc);
        return true;
    }
    return false;
}
}
自旋锁
什么是自旋锁
自旋锁的定义:当一个线程尝试去获取某一把锁的时候,如果这个锁此时已经被别人获取(占用),那么此线程就无法获取到这把锁,该线程将会等待,间隔一段时间后会再次尝试获取。这种采用循环加锁 -> 等待的机制被称为自旋锁(spinlock)。
import java.util.concurrent.TimeUnit;
import java.util.concurrent.atomic.AtomicReference;
import java.util.concurrent.locks.Lock;
import java.util.concurrent.locks.ReentrantLock;

public class spinlock {
  static   AtomicReference<Thread>atomicReference = new AtomicReference();
    public static void main(String[] args) {
        Lock lock=new ReentrantLock();
        new Thread(()->{
            mylock();
            try {
                TimeUnit.SECONDS.sleep(2);
            } catch (Exception e) {
                e.printStackTrace();
            } finally {
                myunlock();
            }
        },"A").start();

        new Thread(()->{
            mylock();
            try {

            } catch (Exception e) {
                e.printStackTrace();
            } finally {
                myunlock();
            }
        },"B").start();
    }
    public static void mylock(){
        Thread thread=Thread.currentThread();
        System.out.println(thread.getName()+"加锁");
        while(!atomicReference.compareAndSet(null,thread)){
        }
    }
    public static void myunlock(){
        Thread thread=Thread.currentThread();
        System.out.println(thread.getName()+"解锁");
        atomicReference.compareAndSet(thread,null);
    }
}
死锁的排查
简单理解死锁:就是两个线程之间相互的去争夺对方的资源。
import java.util.concurrent.TimeUnit;

public class deallock {
    public static void main(String[] args) throws InterruptedException {
        String LockA="lockA";
        String LockB="lockB";
        new Thread(()->{ new Test(LockA,LockB).deal(); }).start();
        new Thread(()->{ new Test(LockB,LockA).deal(); }).start();
    }
}
class Test{
    private String lockA;
    private String lockB;

    public Test(String lockA, String lockB) {
        this.lockA = lockA;
        this.lockB = lockB;
    }
    public void deal(){
        synchronized (lockA){
            System.out.println(lockA+"想要获取"+lockB+"的锁");
            synchronized (lockB){
            }
        }
    }
}
排查方式
-
可以查看日志文件
-
查看进程的堆栈信息
使用jsp -l指令查看还活着的线程
使用jstack +进程号就可以查看信息

 浙公网安备 33010602011771号