

Kafka 权威指南 笔记
看了下 Kafka 做了一些随笔的笔记。先看了第一、三、四、五、十一章,后续章节还会慢慢补上。
第一章 初识 :生产者和消费者
生产者:
一个消息会被发布到一个特定主题上。生产者默认吧消息均衡分不到主题的所有分区上,并不关心特定消息会被写到那个分区。
某些情况下,生产者会把消息直接写到指定分区。是通过消息键和分区器来实现,分区器为键为键生成一个散列值,并将其映射到指定的分区上。这样可保证同一个键的消息会被写到同一个分区上。
消费者:
消费者订阅一个或多个主题,并按照消息生成的顺序读取他们。
消费者通过检查消息的偏移量来区分已经读取过的消息。
偏移量 是另一种元数据,一个不断递增的整数值,在创建消息时,Kafka 把它添加到消息里。
在给定分区里,消息偏移量都是唯一的,消费者把每个分区最后读取的消息偏移量保存在 Zookeeper 或 kafka上,如果消费者关闭或重启,它的读取状态不会丢失。[ 这也是为什么 消费者宕机后,能够从宕机前的位置继续读取数据。 ]
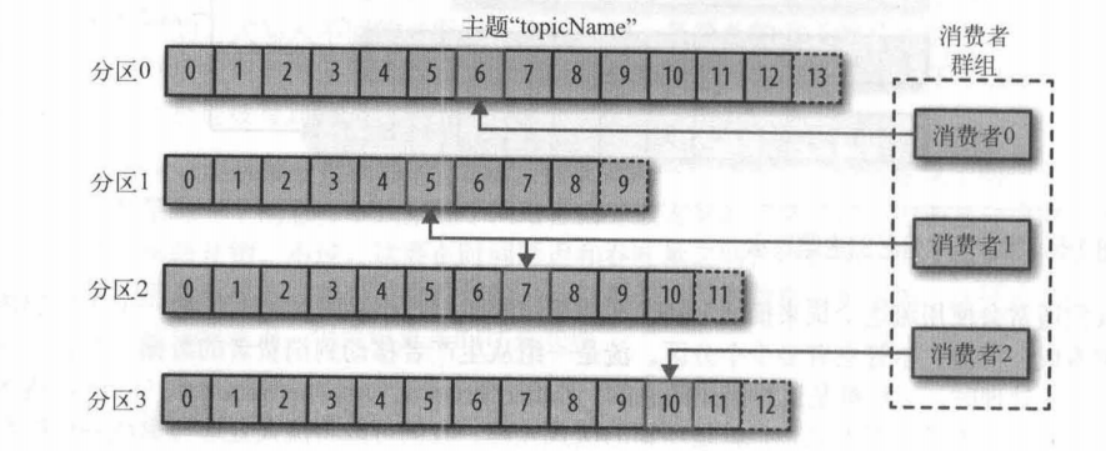
多消费者 ,消费者是消费者群组的一部分,多个消费者共通读取一个主题。群组保证每个分区智能被一个消费者使用。消费者与分区之间的映射通常被称为消费者对分区的所有权关系。
broker 和集群
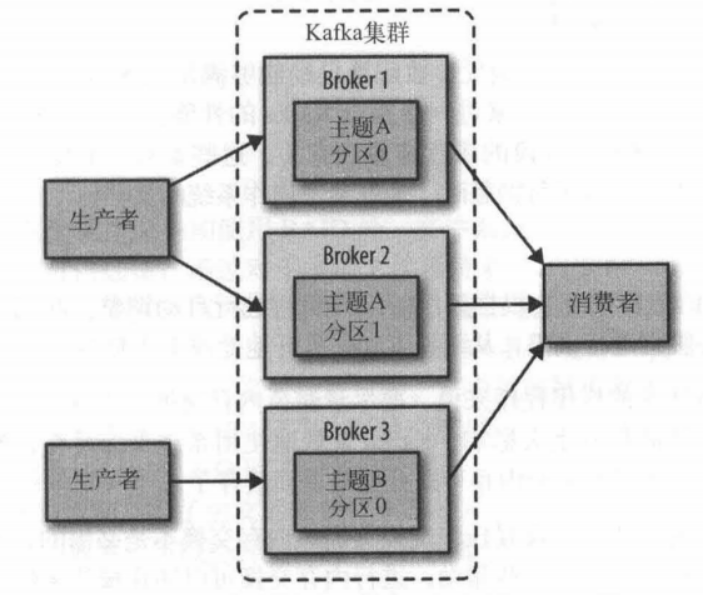
一个独立的 kafka 服务器被称为 broker。
broker 接收来自生产者的消息,为消息设置偏移量,并提交消息到磁盘保存。broker 为消费者提供服务,对读取分区的请求作出相应,返回已经提交到磁盘上的消息。
根据特定硬件及其性能特性,单个 broker 可以轻松处理数千个分区以及每秒百万级的消息量。
broker 是集群的组成部分。每个集群都有一个 broker 充当集群控制器的角色(自动从集群的活跃成员中选举出来)。
保留消息(在一定期限内)是kafka 一个重要特性。kafka默认消息保留策略 是 :默认 7天,或 默认 1G 。当消息达到这些上限时,旧消息就会过期并被删除。主题可以配置自己的保留策略,可以将消息保留到不再使用他们为止。
多集群
三点原因: 最好使用多个集群
数据类型分离
安全需求隔离
多数据中心(灾难恢复)
如果使用多个数据中心,就需要在它们之间复制消息。这样应用程序可以访问到多个站点的用户活动信息。 kafka 的消息复制机制智能在单个集群里进行,不能再多个集群之间进行。
Kafka 提供了一个叫做 MirrorMaker的工具,可以实现集群间的消息复制。
为什么选择 Kafka
多个生产者
Kafka 可以无缝支持多个生产者,不管客户端在使用单个主题还是多个主题。
多个消费者
Kafka 支持多个消费者从一个单独的消息流上读取数据,且消息之间互不影响。(这与其他队列系统不同,其他队列系统的消息一旦被一个客户端读取,其他客户端就无法读取它。另外,多个消费者可以组成一个群组,他们共享一个消息流,并保证整个群组对每个给定的消息只处理一次。)
基于磁盘的数据存储
Kafka 允许消费者非实时地读取消息,归功于 kafka的数据保留特性。
消费者可以在进行应用程序维护时离线一小段时间,无需担心消息丢失或者拥塞在生产者端。
伸缩性
Kafka 从一开始被设计成一个具有灵活伸缩性的系统。开发阶段可以先使用单个 broker,再扩展到包含3个broker的小型开发集群...,一个包含多个broker的集群,即使个别broker 失效,仍然可以持续为客户提供服务。
高性能
通过横向扩展生产者、消费者 和 broker, kafka 可以处理巨大的消息流。在处理大量数据的同时,它能保证亚秒级的消息延迟。
数据生态系统
Kafka 为数据生态系统带来了循环系统,它在基础设施的各个组件之间传递消息,为所有客户端提供一直的接口。
使用场景:
活动跟踪
传递消息
默认配置
broker 配置
Kafka 发送包里自带配置样本可以安装单机服务,并不能满足大多数安装场景的要求。
主题配置
主题吞吐量 / 消费者吞吐量 = 分区个数
num.partitions : 默认把分区大小限制在 25 GB 以内,可以得到比较理想的效果。
log.retention.ms : 数据被保留时间。默认为 168小时(一周),还有 log.retention.hours、log.retention.minutes
log.retention.bytes : 通过保留消息字节数来判断消息是否过期。例:一个包含8个分区的主题,并且 log.retention.bytes 设置为 1GB , 那么这个主题最多可以保留8GB的数据。
log.segment.bytes : 当日志片段大小达到 log.segment.bytes 指定的上线(默认 1G)时,当前日志片段就会被关闭,一个新的日志片段被打开。
log.segment.ms : 控制日志片段关闭时间
message.max.bytes : broker 通过设置message.max.bytes 参数来限制单个消息的大小。默认值是 1 000 000 ,也就是 1M。如果生产者发送消息超过这个值,消息不会被接收,broker 还会返回 错误信息。
硬件性能
(磁盘吞吐量 和 容量、内存、网络、CPU )
Kafka 集群
简单kafka集群图:
需要多少 broker ?
1、需要多少磁盘空间来保留数据,以及单个 broker 有多少空间可用。
如果 整个集群需要保留 10TB 数据,每个broker 可以存储 2TB,至少需要 5 个 broker。如果启用了数据复制,至少还需要一倍的空间(取决于复制系数是多少)。
2、集群处理请求的能力。与网络接口处理客户端流量能力有关。
broker 配置
要把一个 broker 加入集群,需要配置两个参数。
1、所有 broker 都必须配置相同的 zookeeper.connect ,指定了用于保存元数据的 Zookeeper 群组和路径。
2、每个 broker 都必须为 broker.id 参数设置唯一的值。如果 两个 broker 使用相同的broker.id,那么第二个 broker 就无法启动。
生产环境注意
垃圾回收器选项
Java 7 有 G1 垃圾回收器,.
MaxGcPauseMillis: 指定每次垃圾回收默认的停顿时间。值不固定,默认 200ms。
InitiatingHeapOccupancyPercent: 指定了G1启动新一轮垃圾回收之前可以使用的堆内存百分比,默认 45。即 堆内存使用率到达 45% 前,G1不会启动垃圾回收。这个百分比包括 新生代 和 老年代的内存。
(例:如果一台服务器有 64GB内存,并且使用 5GB 堆内存来运行 Kafka,
参考配置:MaxGcPauseMillis : 20ms;
InitiatingHeapOccupancyPercent : 35 ;
)
kafka 启动脚本没有启用 G1回收器,使用了 Paraller New 和 CMS 垃圾回收器。
数据中心布局
把集群的 broker 安装在不同机架上,不能让他们共享可能出现单点故障的基础设施。
共享zookeeper
Kafka 使用 zookeeper 来保存 broker、主题和分区的元数据信息。
Kafka 消费者 和 zookeeper
kafka 0.9.0.0 版本前,除 broker 外,消费者会使用 zookeeper 来保存一些信息,
kafka 0.9.0.0 版本后,kafka 引入了一个新的消费者接口,允许 broker 直接维护这些信息。
kafka 对 zookeeper 的延迟和超时比较敏感。
第三章: 生产者
概览
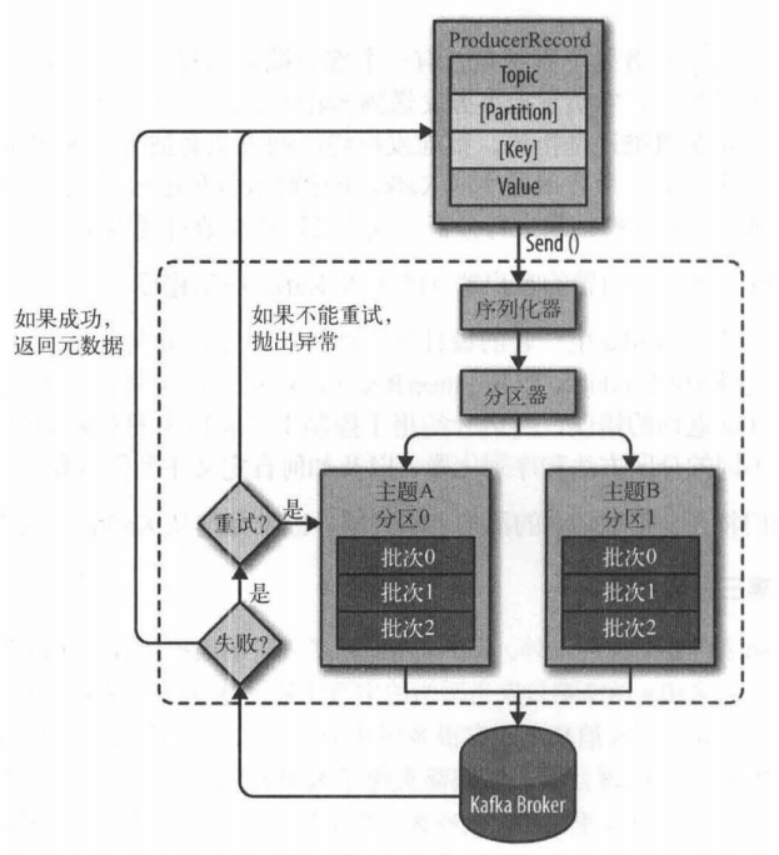
Kafka 发送消息主要步骤,从创建一个 ProducerRecord 对象开始,对象需要包含目标主题和要发送的内容。还可以指定键或分区。
发送 ProducerRecord 对象时,生产者先把键和值对象序列化成字节数组,这样才可在网络上传输。
数据传给分区器。如指定了分区,分区器直接把指定分区返回。如未指定,分区器会根据 ProducerRecord 对象的键来选择一个分区。
分区后,生产者知道往哪个分区发送信息,这条信息被添加到一个记录批次里,这个批次所有消息会被发送到相同的主题和分区上。有独立线程负责把这些记录批次发送到相应 broker 上。
服务器收到消息会返回一个相应。如果消息成功写入 Kafka ,就返回一个包含了 主题、分区信息、分区里偏移量 的 RecordMetaData 对象。写入失败,返回错误。生产者收到错误后会尝试重新发送,几次后还失败,就返回错误信息。
创建生产者
kafka写消息,先要创建生产者对象,并设置一些属性。有三个必选属性:
bootstrap.servers :broker 地址清单,格式为 host:port 。清单中不用包含所有 broker地址,生产者会从给定的broker里查找到其他broker信息。建议至少两个,一旦其中一个宕机,生产者仍能连接到集群上。
key.serializer : broker 接收的消息都是字节数组,生产者需要知道如何把这些java对象转换成字节数组。key.serializer 必须被设置为一个实现了 Serializer 接口的类。Kafka客户端默认提供了 ByteArraySerializer、StringSerializer、IntegerSerializer。
value.serializer :与 key.serializer 一样,value.serializer 指定类会将值序列化。
实例化生产者对象后,发送消息主要有三种方式:
发送并忘记 : 消息发给服务器,不关心是否正常到达。kafka高可用,生产者会自动尝试重发。有时会丢失一些消息。
同步发送 :send() 方法发送消息,返回 Futrue 对象,调用 get() 方法等待。
kafkaProducer 一般会发生两类错误。
1:可重试错误,可通过重发消息解决。例:连接错误、无主(no leader)错误。kafka 可以配置成自动重试,如果多次重试后仍无法解决,程序会受到一个重试异常。
2、另类错误,无法通过重试解决。例:“消息太大” 异常,不进行重试,一直抛出异常
异步发送 : send() 方法发送消息,指定一个回调函数,服务器在返回响应时调用该函数。
生产者配置
acks : 指定了必须要有多少个分区副本收到消息,生产者才会认为消息写入时成功的。
acks = 0 :生产者在成功写入消息前不会等待任何来自服务器的响应。
可以以网络能够支持的最大速度发送消息,从而达到很高的吞吐量。
acks = 1 : 只要集群首领节点收到消息,生产者就会收到一个来自服务器的成功响应。
吞吐量取决于使用的是同步发送还是异步发送。
acks = all :只有当所有参与复制的节点全部收到消息时,生产者才会收到一个来自服务器的成功响应。模式最安全。延迟最高。
buffer.memory : 设置生产者内存缓冲区大小。缓冲要发送到服务器的消息。(0.9.0.0 版本替换为 max.block.ms)
compression.type :默认情况,消息发送时不会被压缩。该参数可以设置为 snappy、gzip、lz4。指定了消息发送给 broker之前使用哪种压缩算法。
snappy 压缩占用较少CPU,提供较好性能和压缩比。比较关注 性能和网络带宽可用。
gzip 占用较多CPU,如果网络带宽比较有限 可用。
retries :生产者可以重发消息的次数。默认:生产者每次重试之间等待 100ms( 可以通过 retry.backoff.ms 参数来改变这个时间间隔 ),建议设置 总的重试时间比kafka集群从崩溃中恢复的时间长。一般情况,生产者会自动进行重试,代码中可不处理 可重试错误,只处理 不可重试错误 或 重试次数超出上限的情况。
batch.size :当有多个消息需要被发送到同一个分区时,生产者会把他们放在同一个批次里。该参数指定了一个批次可以使用的内存大小,按照字节数计算。
批次填满即发送,半满或一条消息也可能被发送。批次大小设置很大,不会造成延迟,只会占用更多内存。设置太小,生产者需要更频繁地发送消息,会增加一些额外的开销。
linger.ms :指定了生产者在发送批次之前等待更多消息加入批次的时间。
把 linger.ms 设置成比 0 大的数,虽然会增加延迟,但也会提升吞吐量。
client.id :可以是任意字符串,服务器用它来识别消息来源,还可以用在日志和配额指标里。
max.in.flight.requests.per.connection :指定了生产者在收到服务器响应之前可以发送多少个消息。值越高,占用越多内存,提升吞吐量。设为 1 ,可以保证消息是按照发送的顺序写入服务器的,即使发送了重试。
timeout.ms 、 request.timeout.ms 、metadata.fetch.timeout.ms :
request.timeout.ms : 生产者在发送数据时等待服务器返回响应的时间。
metadata.fetch.timeout.ms :生产者在获取元数据时等待服务器返回响应的时间。如果等待响应超时,生产者要么重试发送数据,要么返回一个错误。
timeout.ms : 指定了broker 等待同步副本返回消息确认的时间,与 asks 的配置相匹配。如果指定时间内没有收到同步副本的确认,那么broker 就会返回一个错误。
max.block.ms :指定了调用 send() 方法或使用 partitionsFor() 方法获取元数据时生产者的阻塞时间。当 生产者发送缓冲区满 或 没有可用元数据时,方法会阻塞。阻塞时间达到 max.block.ms 时,生产者会抛出超时异常。
max.request.size :用于控制生产者发送的请求大小。指 单个消息最大值 或 单个请求所有消息总大小。
注: broker 对可接收的消息最大值也有自己限制(message.max.bytes),两边最好匹配。避免生产者发送的消息被 broker 拒绝。
receive.buffer.bytes 和 send.buffer.bytes :分别指定 TCP socket 接收和发送数据包的缓冲区大小。值为 -1,就使用操作系统的默认值。如果 生产者或消费者 与 broker 处于不同的数据中心,那么可以适当增大这些值,因为跨数据中心的网络一般都有比较高的延迟和比较低的带宽。
注: 顺序保证。kafka 可以保证同一个分区里的消息是有序的。
例:如果把 retries 设为 非零整数,把 max.in.flight.requests.per.connection 设为比 1 大的数。
如果第一批次消息写入失败,第二批次成功,broker重写第一批次。如此时第一批次写入成功,那么两个批次的顺序就反过来了。
如果 retries 为非零整数,把 max.in.flight.requests.per.connection 设为 1,这样生产者发送第一批消息时,就不会有其他消息发送给 broker。这样会严重哦影响生产者的吞吐量,只有在对消息顺序有严格要求情况才这么做。
序列化器
已有序列化器和反序列化器 , 不如 JSON、Avro、Thrift、Protobuf
Apache Avro 序列化: 一种与编程语言无关的序列化格式。
注:写入数据和读取数据的 schema 必须是相互兼容的。
分区
ProducerRecord 对象包含目标主题、键、值。Kafka 消息是一个个键值对,ProducerRecord 对象 的键可以设置为默认的 null。
键有两个用途:可以作为消息的附加信息,也可以决定消息该被写到主题的那个分区。拥有相同键的消息将被写入用一个分区。
第四章: 消费者
消费者和消费者群组
kafka 消费者 从属于消费者群组。一个群组里的消费者订阅的是同一个主题,每个消费者接收主题一部分分区的消息。
例: kafka 有 4个分区,如果只要 1 个消费者- 一个消费者收到4个分区的消息。
如果有两个消费者,每个消费者收到两个分区的消息。
如果有4个消费者,每个消费者收到1个分区的消息。
如果有 5 个消费者,有4个消费者可以收到消息,多出来的消费者会闲置,不会收到消息。
多个消费者群组订阅相同的主题,群组互不影响。
消费者群组和分区再均衡
群组的消费者共同读取主题的分区。一个新的消费者 加入群组时,他读取的是原本由其他消费者读取的消息。当某一消费者被关闭或发生崩溃,它就离开群组,原本由它读取的分区将由群组里的其他消费者读取。
在主题发送变化时,比如管理员添加了新的分区,会发生分区重分配。
分区的所有权从一个消费者转移到另一个消费者,这样的行为被称为 再均衡
在 再均衡期间,消费者无法读取消息,造成整个群组一小段时间的不可用。
当分区被重新分配给另一个消费者时,消费者当前的读取状态会丢失,他还需要去刷新缓存,在它重新恢复状态之前,会拖慢应用程序。
消费者通过向被指派为 群组协调器 的 broker(不同群组可以有不同的协调器) 发送心跳 来维持和群组的从属关系 和 对分区的所有权关系。消费者会在轮询消息 或提交偏移量时发送心跳。
如果消费者停止发送心跳时间过长,会话过期,群组协调器认为它死亡,就会触发一次再均衡。
如果一个消费者崩溃,停止读取消息,群组协调器会等待几秒钟,确认它死亡了才会触发再均衡。这几秒内,死掉的消费者不会读取分区里的消息。在清理消费者时,消费者会通知协调器它将要离开群组,协调器会立即出发一次再均衡,尽量降低处理停顿。
创建 Kafka 消费者
3个必要属性: bootstrap.servers 、key.deserializer、value.deserializer
bootstrap.servers : kafka 集群的连接字符串。(与KfakaProducer 中用途一样)
key.deserializer 和 value.deserializer 与生产者的 serializer 定义也类似
group.id 非必须。 指定了kafkaConsumer 属于哪一个消费者群组。
订阅主题
subscribe() 方法
consumer.subscribe(Collections.singletonList("customerCountries"));
也可以在 subscribe() 方法时传入一个正则表达式。正则表达式可以匹配多个主题,如果有人创建了新主题,且主题名字与正则表达式匹配,会立即触发一次再均衡,消费者就可以读取新添加的主题。
例:订阅所有与 test 相关的主题,可以 consumer.subscribe(" test.* ");
轮询
消息轮询是消费者 API 核心,通过一个简单的轮询服务向服务器请求数据。
一旦消费者订阅了主题,轮询会处理所有的细节,包括群组协调、分区再均衡、发送心跳和获取数据。
轮询不止是获取数据 。在第一次调用新消费者的 poll() 方法时,它会查找 GroupCoordinator,然后加入群组,接收分配的分区。
线程安全 -- 同一群组里,无法让 一个线程运行多个消费者,也无法让多个线程安全的共享一个消费者。如果要在同一个消费者群组里运行多个消费者,需要让每个消费者运行在自己的线程里,最好把消费者逻辑封装在自己的对象里,然后使用Java 的 ExecutorService 启动多个线程,使每个消费者运行在自己的线程上。(参考 : https://www.confluent.io/blog/ )
消费者的配置
几个配置属性: bootstrap.servers 、group.id 、key.deserializer 、value.deserializer 。
几个重要属性:
fetch.min.bytes :消费者从服务器获取记录的最小字节数
fetch.max.wait.ms : broker 的等待时间,默认 500ms。
max.partition.fetch.bytes : 指定了服务器从每个分区里返回给消费者的最大字节数。默认 1MB,
session.timeout.ms :指定了消费者在被认为死亡之前可以与服务器断开连接的时间,默认 3s。
auto.offset.reset : 指定了消费者在读取一个没有偏移量的分区或者偏移量无效的情况下(因消费者长时间失效,包含偏移量的记录已经过时并被删除)该做何处理。默认是 latest (在偏移量无效的情况下,消费者将从最新的记录开始读取数据)。另一个值时 earliest,意为:在偏移量无效的情况下,消费者将从起始位置读取分区的记录。
enable.auto.commit :指定了 消费者是否自动提交偏移量,默认为 true
partition.assignment.strategy : 分区策略
client.id :可以是任意字符,broker 用它标识从客户端发送过来的消息,常被用在日志、度量指标和配额里。
max.poll.records :用于控制单次调用 call() 方法能够返回的记录数量。
receive.buffer.bytes 和 send.buffer.bytes :socket 在读写数据时用到的TCP 缓冲区也可以设置大小。如果值为 -1,即为操作系统的默认值。
提交和偏移量
每次调用 poll() 方法,它总是返回由生产者写入kafka 但还没有被消费者读取过的记录。
我们把更新分区当前位置的操作叫做提交。
消费者如何提交偏移量?
消费者往一个叫做 _consumer_offset 的特殊主题发送消息,消息里包含每个分区的偏移量。如果消费者一直处于运行状态,那么偏移量就没用。如果消费者发生崩溃或新消费者加入群组,触发在均衡。再均衡后消费者分到新分区,为了能继续之前工作,消费者需要读取每个分区最后一次提交的偏移量,然后从偏移量指定的地方继续处理。
如果提交的偏移量小于客户端处理的最后一个消息的偏移量,那么处于两个偏移量之间的消息就会被重复处理。
如果提交的偏移量大于客户端处理的最后一个消息的偏移量,那么助于两个偏移量之间的消息会丢失。
自动提交
最简单。enable.auto.commit = true,消费者自动把poll()方法接收到的最大偏移量提交上去。提交间隔由 auto.commit.interval.ms 控制,默认 5s。
这种方法无法避免因为再均衡导致的 重复处理消息。
提交当前偏移量
auto.commit.offset = false,让应用程序决定何时提交偏移量。使用 commitSync() 提交偏移量。
注: commitSync() 将会提交由 poll() 返回的最新偏移量,在处理完所有记录后要确保调用了 commitSync(),否则会有丢失消息的风险。如果发生再均衡,最近一批消息到发生再均衡之间的所有消息都将被重复处理。
异步提交
由于手动提交的不足:【在broke 对提交请求作出回应前,应用程序会一直阻塞,限制应用程序吞吐量。可通过降低提交频率来提升吞吐量。如果发生再均衡,会增加重复消息的数量。】
使用异步提交,只管发送提交请求,无需等待broker 响应。
重试异步提交 : 使用一个单调递增的序列号维护异步提交顺序,每次提交偏移量后或在回调里提交偏移量时递增序列号。重试前对比回调序列号和即将提交的偏移量是否相等,相等 - 没有新提交,可安全的进行重试,如果序列号比较大,说明有新提交已经发送,应该停止提交。
同步和异步组合提交
一般情况下,偶尔提交失败,不影响后续提交的成功。在关闭消费者或再均衡前的最后一次提交,需要确保能够提交成功。故:消费者关闭前会组合使用 commitAsync() 和 commitSync() 。
提交特定的偏移量
提交偏移量的频率和处理消息批次的频率是一样的。
消费者 API 允许调用 commitSync() 和 commitAsync() 方法时传入希望提交的分区和偏移量的 map。
再均衡监听器
从特定偏移量处开始处理记录
从分区起始位置开始读取消息: seekToBeginning(Collection<TopicPartition> tp)
从分区末尾位置开始读取消息: seekToEnd(Collection<TopicPartition> tp)
通过把偏移量和记录保存到同一个外部系统来实现单次语义,结合使用 ConsumerRebalanceListener 和 seek () 方法来确保能够及时保存偏移量,并保证消费者总是能够从正确的位置开始读取消息。
如何退出
确定要退出循环,通过另一个线程调用 consumer.wakeup() 方法。
如果循环运行在主线程,可以在 ShutdownHook 中调用该方法。
反序列化器
生产者需要用 序列化器 把对象转换成字节数组再发送给kafka。
消费者需要用 反序列化器 把从kafka接收到的字节数组转换成 java对象。
生成消息使用的序列化器 与 读取消息使用的反序列化器应该是一一对应的。
使用 Avro 和 schema 注册表进行序列化和反序列化的优势: AvroSerializer 可以保证写入主题的数据与主题的 schema 是兼容的。
注: 不建议使用自定义序列化器和自定义反序列化器。它使生产者和消费者紧紧耦合在一起。
独立消费者
一个消费者从一个主题的所有分区或某个特定分区读取数据。不需要消费者群组和再均衡,不需要订阅主题,取之 是 为自己分配分区。
一个消费者可以订阅主题(并加入消费者群组),或者为自己分配分区,但不能同时做这两件事。
第五章:深入Kafka
话题 : Kafka 如何进行复制;
Kafka 如何处理来自生产者和消费者的请求;
Kafka 的存储细节,比如文件格式 和 索引;
集群成员关系
kafka 使用 zookeeper 来维护 集群成员的信息。每个broker 都有一个唯一的标识符,标识符可在配置文件中指定,也可以自动生成。broker 启动时,通过创建临时节点把自己的id注册到 Zookeeper。kafka 组件订阅 Zookeeper 的 /broker/ids 路径(broker 在 zookeeper 上的注册路径),当有 broker 加入集群或退出集群时,这些组件就可以获得通知。
如要启动另一个具有相同 id 的 broker,会得到错误。因为 zookeeper 里已经有一个具有相同ID 的broker。
在 broker 停机、出现网络分区或长时间垃圾回收停顿时,broker 会从 zookeeper 上断开连接,broker 启动时创建的临时节点会自动从 zookeeper 上移除。监听 broker 列表的 kafka 组件会被告知该 broker 已移除。
关闭 broker 时,对应的节点也会消失,在完全关闭一个 broker之后,如果使用相同的 id 启动另一个全新的broker ,它会立即加入群组,并拥有与旧broker 相同的分区和主题。
控制器
控制器就是一个broker ,具有普通broker 功能外,还负责分区首领的选举。
集群里第一个启动的broker 通过在 zookeeper 里创建一个临时节点 / controller 让自己成为控制器。其他 broker 启动时也尝试创建这个节点,但会受到“节点已存在” 的异常。其他控制器节点上创建 zookeeper watch 对象,这样它们就可以受到这个节点的变更通知。这种方式可以确保集群里一次只有一个控制器存在。
如果控制器被关闭或者与zookeeper断开连接,zookeeper上临时节点消失。集群上其他 broker通过 watch对象得到通知,会尝试让自己成为新的控制器。第一个在 zookeeper里成功创建控制器节点的broker 会成为新的 控制器,其他节点收到“节点已存在”的异常,然后再新控制器节点上再次创建 watch 对象。
总之: Kafka 使用 zookeeper 的临时节点选举控制器,在节点加入集群或退出集群时通知控制器。控制器负责在节点加入或离开集群时进行分区首领选举。控制器使用 epoch 来避免 “脑裂”。“脑裂” 指连个节点同时认为自己是当前的控制器。
复制:
复制功能 是 kafka 架构核心。
kafka :一个分布式的 、 可分区的 、可复制的提交日志服务。
复制 是 关键 ,因为它可以在个别节点失效时仍能保证kafka 的可用性和持久性。
kafka 使用主题来组织数据,每个主题被分为若干个分区,每个分区有多个副本。副本被保存在 broker 上,每个 broker 可以保存成百上千个属于不同主题和分区的副本。
副本类型:
首领副本 : 每个分区都有一个首领副本。为保证数据一致性,所有生产者请求和消费者请求都会经过这个副本。
跟随者副本 :首领外副本都是跟随者副本。不处理来自客户端的请求,唯一任务是 从首领哪里复制消息,保持与首领一直的状态。如果首领崩溃,其中一个跟随者会被提升为新首领。
为了与首领保持同步,跟随者向首领发送获取数据的请求,请求信息里包含了跟随者想要获取消息的偏移量,偏移量总是有序的。
首领通过查看每个跟随者请求的最新偏移量,知道跟随者复制的进度。如果跟随者 10s 内没有请求任何消息,或 在请求消息,但 10s 内没有请求最新的数据,那么它就会被认为是不同步的。如果副本与首领不同步,首领失效时,它就不可能成为新首领。
持续请求得到的最新消息副本被称为同步的副本。
除当前首领外,每个分区都有一个 首选首领 - 创建主题时选定的首领。默认 kafka的 auto.leader.rebalance.enable = true 。它会检查首选首领 是不是当前首领,如果不是,并且该副本是同步的,那么就会触发首领选举,让首选首领称为当前首领。
处理请求
broker 大部分工作是处理客户端、分区副本 和控制器发送给分区首领的请求。
所有的请求消息都包含一个标准消息头:
Request type ( 即 API key)
Request version ( broker 可以处理不同版本的客户端请求,并根据客户端版本作出不同的响应。 )
Correlation ID 一个具有唯一性的数字,用于标识请求消息,同时也出现在响应消息和错误日志里。
Client ID 用于标识发送请求的客户端。
几种常见的请求类型
生产请求 : 生产者发送的请求,包含客户端要写入 broker 的消息。
包含首领副本的broker 在收到生产请求时,会对请求做一些验证。
1、发送数据的用户是否有主题写入权限
2、请求里包含的 acks 值是否有效(只允许出现 0、1、all )
3、如果 acks = all ,是否有足够多的同步副本保证消息已经安全被写入。
获取请求 : 在消费者和跟随者副本需要从 broker 读取消息时发送的请求。
首领收到请求时,先检查请求是否有效。
例:指定偏移量在分区上是否存在?如果客户端请求是已被删除的数据,或者请求的偏移量不存在,那么broker 将返回一个错误。如存在,broker 将按照客户端指定的数量上限从分区里读取消息,再把消息返回给客户端。
kafka 使用 零复制 技术向客户端发送消息。 即 : kafka 直接把消息从文件里发送到网络通道,不需要经过任何中间缓冲区。避免了字节复制,也不用管理内存缓冲区,从而获得更好的性能。
生产请求和获取请求都必须发送给分区的首领副本。
元数据请求 :用来获取 客户端该往哪里发送请求。元数据请求包含了客户端感兴趣的主题列表。服务端的响应消息里指明了这些主题所包含的分区、每个分区都有哪些副本,以及哪个副本是首领。元数据请求可以发送给任意一个 broker,因为所有 broker 都缓存了这些信息。
其他请求
物理存储
kafka 基本存储单元是分区。分区无法在多个 broker 间进行再细分,也无法在同一个broker的多个磁盘上再进行细分。
分区大小受到单个挂载点可用空间的限制。
分区分配 : 创建主题时,kafka 会决定如何在 broker 间分配分区。目标 -
在 broker 间平均地分布分区副本。
确保每个分区的每个副本分布在不同的broker 上。
如果为 broker 指定了机架信息,那么尽可能把每个分区的副本分配到不同机架的 broker 上。目的是 为了保证一个机架的不可用不会导致整体的分区不可用。
注意:磁盘空间。在为 broker 分配分区时并没有考虑可用空间和工作负载问题,但在将分区分配到磁盘上时会考虑分区数量,不过不考虑分区大小。
文件管理:保留数据 是kafka的一个基本特性。把分区分成若干个片段。默认情况下,每个片段包含 1GB 或一周的数据,以较小的那个为准。在broker 往分区写入数据时,如果达到片段上限,就关闭当前文件,并打开一个新文件。
当前正在写入的文件 叫 活跃片段。该片段永远不会被删除。
文件格式 : 我们把 kafka 的消息和偏移量保存在文件里。保存在磁盘上的数据格式与从生产者发送过来或者发送给消费者的消息格式是一样的。
除了键、值、偏移量。消息里还包含了消息大小、校验、消息格式版本号、压缩算法、时间戳。
如果生产者发送的是压缩过的消息,那么同一批次的消息会被压缩在一起,被当做 “包装消息” 进行发送。
索引 : 消费者可以从kafka 的任意可用偏移量位置开始读取消息。为了帮助 broker 更快地定位到指定的偏移量,kafka 为每个分区维护了一个索引。索引把偏移量映射到片段文件和偏移量在文件里的位置。
清理 :一般情况下,kafka 会根据设置的时间保留数据,把超过时效的旧数据删除掉。
清理的工作原理 :每个日志片段可以分为两个部分 -
干净的部分 - 消息之前被清理过,每个键只有一个对应的值,这个值是上一次清理时保留下来的。
污浊的部分 - 消息是在上一次清理之后写入的。
被删除的事件 : 为了彻底把一个键从系统里删除,应用程序必须发送一个包含该键且值为 null的消息。清理线程发现该消息,会先进性常规清理,只保留值为null的消息。该消息(被称为 墓碑消息)会被保留一段时间,时间长短可配置。消费者往数据库里复制 kafka 的数据时,看到墓碑消息,就知道应该要把相关用户信息从数据库里删除。
何时会清理出题 : 像 delete 策略不会删除当前活跃的片段一样,compact 策略也不会对当前片段进行清理。只有旧片段里的消息才会被清理。
第十一章:流式处理
什么是流式处理:
数据流 是无边界数据集的抽象表示。无边界意味着无限和持续增长。
例:信用卡交易、股票交易、包裹递送 等等
除没边界外,事件流模型的其他属性:
事件流是有序的
不可变的数据记录
事件流是可重播的
流式处理 指实时地处理一个或多个事件流。
对比:
请求 与 响应:延迟最小的一种范式,响应时间处于亚毫秒到毫秒之间,响应时间稳定。这种处理模式一般是阻塞的。 在数据库领域,这种范式是线上交易处理(OLTP)。
批处理:高延迟和高吞吐量。处理系统按照设定时间启动处理进程。在数据库领域,是 数据仓库(DWH) 或商业智能(BI) 系统
流处理:介于上两者之间的范式。
流 的定义不依赖任何一个特定的框架、API 或 特性。只要持续地从一个无边界的数据集读取数据,然后对它们进行处理并生成结果,那就是在进行流式处理。重点: 整个处理过程必须是持续的。
流式处理的一些概念
时间 : 最重要概念。一般包含的几个时间概念:
事件时间: 指 所追踪事件的发生时间和记录的创建时间。
日志追加时间: 指 时间保存到 broker 的时间
处理时间: 指 应用程序在收到事件之后要对其进行处理的时间。
注意: 时区问题。整个数据管道应该使用同一个时区。
状态: 事件 与 事件 之间的信息被称为 “状态”。包含的几种类型的状态:
本地状态或内部状态: 只能被单个应用程序实例访问。优点是 速度快,缺点是 受内存大小的限制。流式处理的很多设计模式都将数据拆分到多个子流,这样就可以使用有线的本地状态来处理它们。
外部状态: 使用外部的数据存储来维护,一般使用 Nosql 系统。优势是 没有大小的限制,缺点是 引入额外的系统会造成更大的延迟和复杂性。
流和表的二元性
流 是一系列事件,每个事件就是一个变更。
表 是记录的集合,包含了当前的状态,是多个变更所产生的结果。
将 流 转化为 表,需要 ”应用“ 流里所包含的所有变更,这也叫做流的 ”物化“
时间窗口
大部分针对流的操作都是基于时间窗口的。
窗口的大小 。
窗口移动的频率 :如果 ‘移动间隔’ 与窗口大小相等 为 “滚动窗口”; 如果 窗口随每条记录移动, 为 滑动窗口。
窗口的可更新时间多长。
流式处理的设计模式
单个事件处理:最基本模式。 可以使用一个生产者 和 一个消费者来实现。
使用本地状态:流式处理使用本地状态需要解决 内存使用、持久化、再均衡。
使用外部查找 - 流和表的连接。
流 与 流的连接 。
乱序的事件 : 识别乱序的事件,规定一个时间段用于重排乱序的事件,具有在一定时间段内重排乱序事件的能力。具备更新结果的能力。
重新处理 。

 浙公网安备 33010602011771号