实战指南:在完全分布式环境中部署与验证Hive on Spark集群
在大数据生态系统中,Hive作为经典的数据仓库工具,其与Spark计算引擎的结合(Hive on Spark)能够显著提升海量数据处理的性能。本文将深入探讨在一个由三台虚拟机(hadoop01~hadoop03)构成的完全分布式环境中,如何从零开始部署、启动并全面验证Hive on Spark集群的独立可用性。通过这份详细的实战教程,您将掌握从环境检查、服务启停到核心SQL功能验证的全流程操作,为构建稳定可靠的大数据平台打下坚实基础。
一、环境准备与前置条件检查
成功的测试始于周密的环境准备。在开始Hive on Spark的验证之前,必须确保所有底层依赖组件均处于健康状态。这类似于在部署像MongoDB或PostgreSQL这样的分布式数据库前,需要先确认网络和存储配置无误。
- 基础设施:确认3台虚拟机(hadoop01, hadoop02, hadoop03)已正常启动并显示登录界面。建议每台虚拟机分配100GB-200GB硬盘空间,以满足大数据处理的基本需求。
- 依赖服务状态:这是最关键的一步。Hive on Spark的正常运行依赖于一个完整的大数据栈:
- Hadoop (HDFS+YARN):执行
start-all.sh启动,并通过jps命令验证NameNode、DataNode、ResourceManager等核心进程是否存在。 - ZooKeeper:执行
zk start启动,使用zkServer.sh status确认集群中有一台Leader和两台Follower。 - Spark集群:执行
start-spark.sh启动。 - MySQL:执行
systemctl status mysqld检查Hive元数据库服务是否运行。这是Hive的“大脑”,其重要性不亚于Redis对于缓存系统或MySQL对于传统业务的核心地位。
- Hadoop (HDFS+YARN):执行
所有操作建议使用统一的普通用户账号(如原文中的“hertz”)在管理节点hadoop01上执行,以确保环境一致性。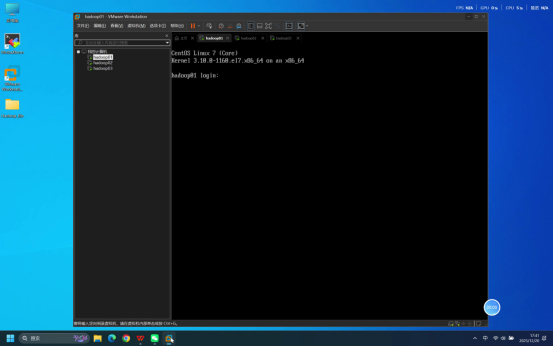 上图展示了虚拟机成功启动后的登录界面状态。
二、建立远程连接与集群登录
使用专业的远程连接工具(如MobaXterm)能够极大提升运维效率。分别建立到三台虚拟机的SSH连接,输入对应的IP地址。在连接成功后,依次使用指定账号密码登录。
 连接建立成功的界面如图所示。
 登录成功后,终端提示符应清晰显示用户及主机名,例如
[hertz@hadoop01 ~]$,这标志着我们已成功进入集群操作环境。
三、Hive服务启动与状态监控
在确认所有前置服务就绪后,便可以启动Hive服务。通常,集群中会提供封装好的脚本以简化操作。
- 启动服务:在hadoop01节点执行
hive-all.sh start。这个脚本通常会一键启动两个核心服务:Hive Metastore(管理元数据)和HiveServer2(提供JDBC/ODBC接口)。 - 状态验证:服务启动需要一定时间。立即执行
hive-all.sh status可能会看到服务状态为“not running”,这是正常的。等待30秒到1分钟后再次检查,状态应变为“running”。
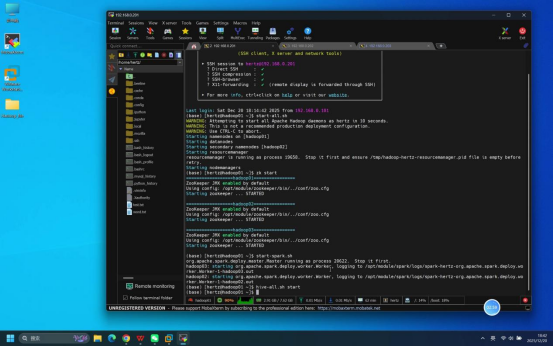 服务启动命令的执行过程。
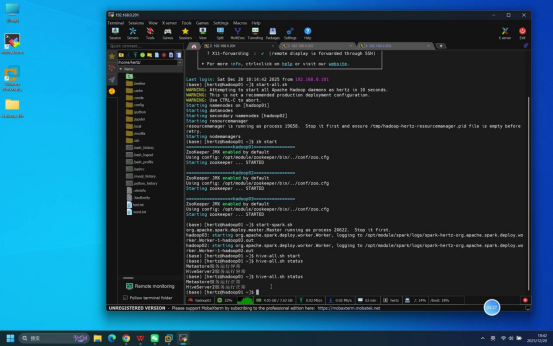 服务状态从“异常”到“正常”的转变过程,是服务启动完成的明确标志。 如果Hive服务始终无法启动,请优先检查MySQL元数据库服务是否正常运行,这往往是问题的根源。
四、多客户端连接与核心功能验证
Hive服务启动后,需要通过不同的客户端进行连接测试,以验证其访问的灵活性。这类似于测试一个数据库优化后的新接口是否兼容各种客户端。
- Hive CLI(旧版客户端)验证:
在终端直接输入
hive命令进入交互界面。执行show databases;查看数据库列表,成功列出默认的“default”数据库后,输入exit;退出。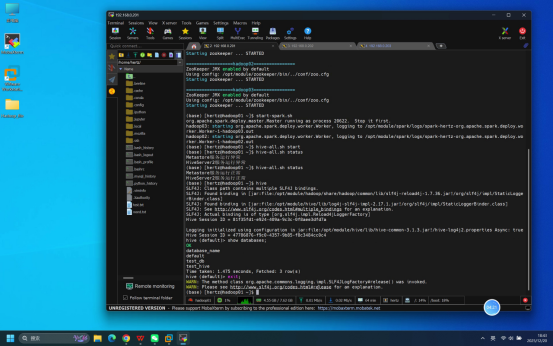
- Beeline(新版JDBC客户端)验证:
执行
beeline启动工具,然后输入连接命令:!connect jdbc:hive2://hadoop01:10000。按提示输入用户名和密码(均为hertz)。连接成功后,提示符会变为JDBC连接地址格式。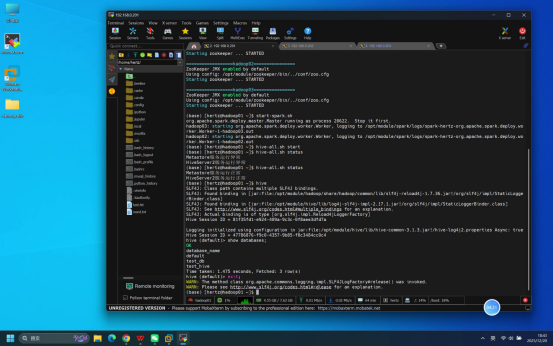
五、SQL功能实战与Spark引擎测试
连接建立的最终目的是执行计算。以下是在Beeline中验证Hive on Spark核心功能的完整SQL流程,充分体现了其数据定义与操作能力:
-- 1. 显式设置执行引擎为Spark
set hive.execution.engine=spark;
-- 2. 创建测试数据库
create database test_my_hive;
-- 3. 切换至测试库
use test_my_hive;
-- 4. 创建一张简单的测试表
create table test_my_table(id int, name string)
row format delimited
fields terminated by ',';
-- 5. 插入测试数据
insert into test_my_table values(1, 'hive'), (2, 'spark');
-- 6. 查询验证数据
select * from test_my_table;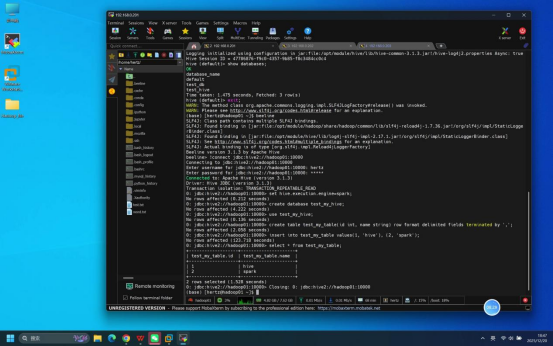 执行上述SQL后,预期将准确返回两行数据:
(1, 'hive') 和 (2, 'spark')。这证明了从元数据管理(建库建表)到数据计算(插入查询)的整个链路在Spark引擎上运行正常。⚠️ 注意:在完全分布式环境下,insert 操作会触发Spark作业提交到YARN上执行,可以通过YARN的Web UI监控作业执行情况。
六、服务优雅停止与资源清理
测试验证完毕后,应按照顺序优雅地停止服务,释放集群资源。这是一个好习惯,正如在生产环境中维护MySQL或Redis集群一样。
- 首先,在Beeline界面按
Ctrl+C退出客户端。 - 然后,在hadoop01节点执行
hive-all.sh stop停止Hive服务。 - 最后,如果无需使用其他组件,可按顺序停止依赖服务:
stop-spark.sh->stop-all.sh(Hadoop) ->zk stop(ZooKeeper)。
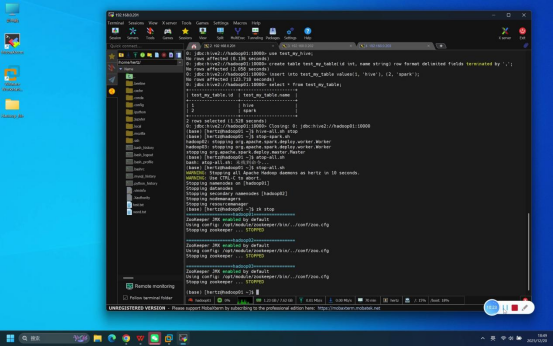 观察服务停止命令的输出日志,确认无错误信息。✅ 至此,一个完整的Hive on Spark集群独立可用性验证闭环就完成了。
通过以上六个步骤的系统性验证,我们不仅确认了Hive on Spark集群在完全分布式环境中的可用性,更实践了一套标准的大数据服务测试流程。从环境依赖管理、服务生命周期控制到多客户端访问及核心引擎的功能测试,每一步都至关重要。掌握这套方法,能够为您日后部署和运维更复杂的大数据组件(如不同版本的Hive与Spark调优)积累宝贵的实战经验,是实现高效数据库优化与稳定数据服务的基础。


 浙公网安备 33010602011771号