
可能没什么用的CSP-S模板整理(
前言
本文是一篇总结性的复习模板的文章,有一些分类。
顺序与洛谷模板赛相同,故不附超链接。
文章中的“不建议”仅仅是笔者主观考虑,可能因个人习惯而异
笔者真的很菜很菜,可能会有纰漏,欢迎指出文章错误
同时注意到笔者码风极差,仅仅作为参考。
杂项
快速读入
int read(){
    int r=0,w=1;char ch=getchar_unlocked();
    while(ch<'0'||ch>'9'){if(ch=='-')w=-1;ch=getchar_unlocked();}
    while(ch>='0'&&ch<='9')r=r*10+(ch-'0'),ch=getchar_unlocked();
    return r*w;
}
主要原理是 \(getchar (getchar\_unlocked)\) 的读入比 \(scanf\) 和 \(cin\) 都要更快。
用快读输出用 \(scanf\)。
快读和流同步优化的 \(cincout\) 是冲突的,而且不建议 \(cincout\) 和快读同用。
题外话:流同步优化的 \(cincout\) 非常神秘,不建议交互题使用。
数列离散化
const int N=2e5+4;
int n,a[N],b[N];
void sol(){
    cin>>n;for(int i=1;i<=n;i++)cin>>a[i],b[i]=a[i];
    sort(b+1,b+n+1);int m=unique(b+1,b+n+1)-b-1;
    for(int i=1;i<=n;i++)a[i]=lower_bound(b+1,b+m+1,a[i])-b;
    for(int i=1;i<=n;i++)cout<<a[i]<<' ';cout<<'\n';
}
最大的作用是在保持数组内相对大小关系不变的情况下把值域缩减到 n 的量级。
数据结构常用。
字符串
我绝对不会告诉你 AC 自动机是 NOI 级算法
不过之后的 NOIP 模板里就会有这个的。
那去年 S 组 T3 是啥原来可以用 Trie 做吗
字符串哈希
const int N=10005,B=131,mod=1e9+7;
int get(char c){
    if(c>='a' && c<='z')return c-'a';
    if(c>='A' && c<='Z')return c-'A'+26;
    return c-'0'+52;
}
int a[N],n;
void sol(){
    cin>>n;for(int i=1;i<=n;i++){
        string s;cin>>s;
        for(char c:s)a[i]=(a[i]*B+get(c))%mod;
    }sort(a+1,a+n+1);
    int ans=0;for(int i=1;i<=n;i++)if(a[i]!=a[i-1])ans++;
    cout<<ans<<'\n';
}
用来判断两个字符串是否相同,通过进制的方式变为整数。
哈希其实很有可能冲突,以防万一自己备一些大模数。(懒的话可以自然溢出)
字典树 / Trie
const int N=3e6+5;
int idx,n,q,sn[N][63],siz[N];
int get(char c){
	if(c>='a' && c<='z')return c-'a';
	if(c>='A' && c<='Z')return c-'A'+26;
	return c-'0'+52;
}
void insert(string s){
	int now=0;
	for(char c:s){
		if(!sn[now][get(c)])sn[now][get(c)]=++idx;
		now=sn[now][get(c)],siz[now]++;
	}
}
int fd(string s){
	int now=0;
	for(char c:s){
		if(!sn[now][get(c)])return 0;
		now=sn[now][get(c)];
	}return siz[now];
}
void sol(){
	for(int i=0;i<=idx;i++)for(int j=0;j<62;j++)sn[i][j]=siz[i]=0;
	idx=0;cin>>n>>q;string s;
	while(n--)cin>>s,insert(s);
	while(q--)cin>>s,cout<<fd(s)<<'\n';
}
把字符串放到树上,以便于处理或者维护一些东西。
具有直观的树形结构,插入时直接拓展即可。
动态开点,并且应当将数组大小开到字符串长度之和,意味着它的时间和空间 复杂度都是 \(O (字符串长度和)\) 。
KMP
const int N=3e6+5;
string s,t;int nxt[N];
void sol(){
    cin>>s>>t;s=t+'#'+s;int m=t.size(),n=s.size();s=' '+s;
    for(int i=2,j=0;i<=n;i++){
        while(j && s[i]!=s[j+1])j=nxt[j];
        if(s[j+1]==s[i])j++;nxt[i]=j;
    }
    for(int i=m+2;i<=n;i++)if(nxt[i]==m)cout<<i-m*2<<'\n';
    for(int i=1;i<=m;i++)cout<<nxt[i]<<' ';cout<<'\n';
}
利用“失配”的思想,对于每个位置快速得到最长公共前后缀的长度。
用来做单模匹配也非常好用,将两个字符串中间加上特殊字符拼接后,跑一遍 \(KMP\),那么找到 \(nxt\) 数组值为模式串长度的地方就是匹配到的结尾处。
Manacher
#include<bits/stdc++.h>
using namespace std;
using ll=long long;
using pi=pair<int,int>;
const ll inf=0x3f3f3f3f3f3f3f3fll;
const double eps=1e-7;
template<typename A>using vc=vector<A>;
#define pb push_back
template<class T>inline void mkx(T &x,T y){if(x<y)x=y;}
template<class T>inline void mkn(T &x,T y){if(x>y)x=y;}
const int N=2.2e7+5;
string s;int p[N];
void sol(){
    string ss;cin>>ss;s=" |";for(char c:ss)s+=c,s+='|';
    int n=s.size()-1,ans=0;
    for(int i=1,r=0,mid=0;i<=n;i++){
        if(i<=r)p[i]=min(p[mid*2-i],r-i+1);
        while(s[i-p[i]]==s[i+p[i]])p[i]++;
        if(p[i]+i>r)r=p[i]+i-1,mid=i;
        mkx(ans,p[i]-1);
    }cout<<ans<<'\n';
}
signed main(){
    ios::sync_with_stdio(false);cin.tie(0);
    int T=1;//cin>>T;
    while(T--)sol();
    return 0;
}
马拉车用来求解单字符串中回文相关问题
这个算法还是蛮巧妙的
代码中,\(p\) 数组指以 \(i\) 为对称中心,最长回文串的半径
最巧妙的地方在于一个性质:在一个极大回文串中,令其对称中心为 mid,那么对于一个位置 \(i\) 而言,令其关于 \(mid\) 的对称点为 \(j\),可以从 \(p [j]\) 去拓展 \(p [i]\)。
也就是说,拓展 \(i\) 时,我们不必从 \(i-1\) 和 \(i+1\) 开始拓展,可以预先确定一部分回文串。正因此,其复杂度是线性的。
数据结构
单调队列 / 滑动窗口/单调栈
const int N=1e6+5;
int n,k,a[N],q[N];
void sol(){
    cin>>n>>k;for(int i=1;i<=n;i++)cin>>a[i];
    int hd=1,tl=0;
    for(int i=1;i<=n;i++){
        while(hd<=tl && q[hd]<=i-k)hd++;
        while(hd<=tl && a[q[tl]]>=a[i])tl--;
        q[++tl]=i;if(i>=k)cout<<a[q[hd]]<<' ';
    }cout<<'\n';hd=1,tl=0;
    for(int i=1;i<=n;i++){
        while(hd<=tl && q[hd]<=i-k)hd++;
        while(hd<=tl && a[q[tl]]<=a[i])tl--;
        q[++tl]=i;if(i>=k)cout<<a[q[hd]]<<' ';
    }cout<<'\n';
}
单调队列可以用\(deque\) ,但是由于常数缘故,静态队列的写法可能更不错一些。
具体地,队列中的值满足单调性,且队列中存的是下标方便 \(hd\) 的更新。
更新是非常好理解的,\(hd\) 掉出区间就去掉,\(tl\) 和新的值不满足单调性就去掉。
单调栈模板和其思路及实现方式如出一辙,不另开一节,代码如下:
const int N=3e6+5;
int n,a[N],b[N],st[N],tp;
void sol(){
    cin>>n;for(int i=1;i<=n;i++)cin>>a[i];
    for(int i=n;i;i--){
        while(tp&&a[st[tp]]<=a[i])tp--;
        b[i]=st[tp];st[++tp]=i;
    }for(int i=1;i<=n;i++)cout<<b[i]<<' ';cout<<'\n';
}
是不是要更短一点,因为栈不需要维护"\(hd\)"。
树状数组
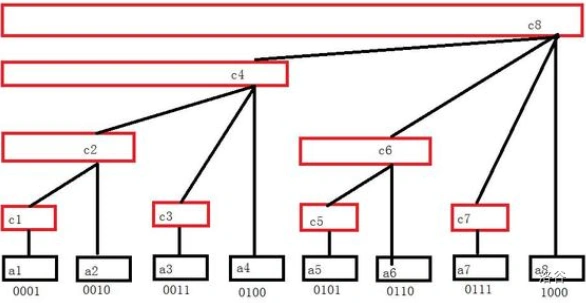
作为一个码量逆天常数小的小巧数据结构,虽然它没有线段树那么强的拓展性,维护的东西也很有限,但是帮助依旧很大。
个人认为它的底层逻辑,也就是和二进制相关的部分是最难理解的。
被修改的区间要拆成 \(log\) 大小的段,但是不能像线段树一样,需要所有前缀拆分成的不同段只有 \(log\) 个。同时又要具有易于写在代码中的区间变换关系。
\(i\) 的上一级管理是 \(i+lowbit(i)\),前一级是 \(i-lowbit(i)\)。
这样就可以做到单点修改和前缀查询了。(能不能区间查询要看情况)
const int N=5e5+5;
int n,m,t[N];
void ad(int x,int d){for(;x<=n;x+=x&(-x))t[x]+=d;}
int qy(int x){int r=0;for(;x;x-=x&(-x))r+=t[x];return r;}
线段树
线段树具有易于理解的分治结构,可以维护很多具有区间合并性的东西。
一道非常好的例题就是线段树2,需要处理好乘法和加法的懒标记,以及下传的优先级关系(先乘再加)。
const int N=2e5+5;
#define int long long
int n,q,mod;
int t[N<<2],ad[N<<2],ml[N<<2];
#define mid (l+r>>1)
void pu(int p){t[p]=(t[p<<1]+t[p<<1|1])%mod;}
void pd(int p,int l,int r){
    if(ml[p]!=1){
        ml[p<<1]=(ml[p<<1]*ml[p])%mod,ml[p<<1|1]=(ml[p<<1|1]*ml[p])%mod;
        ad[p<<1]=(ad[p<<1]*ml[p])%mod,ad[p<<1|1]=(ad[p<<1|1]*ml[p])%mod;
        t[p<<1]=(t[p<<1]*ml[p])%mod,t[p<<1|1]=(t[p<<1|1]*ml[p])%mod;ml[p]=1;
    }if(ad[p]){
        ad[p<<1]=(ad[p<<1]+ad[p])%mod,ad[p<<1|1]=(ad[p<<1|1]+ad[p])%mod;
        t[p<<1]=(t[p<<1]+(mid-l+1)*ad[p]%mod)%mod,t[p<<1|1]=(t[p<<1|1]+(r-mid)*ad[p]%mod)%mod;
        ad[p]=0;
    }
}
void mul(int p,int l,int r,int ql,int qr,int x){
    if(ql<=l && r<=qr){ad[p]=(ad[p]*x)%mod,ml[p]=(ml[p]*x)%mod;t[p]=(t[p]*x)%mod;return ;}
    pd(p,l,r);if(ql<=mid)mul(p<<1,l,mid,ql,qr,x);
    if(qr>mid)mul(p<<1|1,mid+1,r,ql,qr,x);pu(p);
}
void add(int p,int l,int r,int ql,int qr,int x){
    if(ql<=l && r<=qr){ad[p]=(ad[p]+x)%mod;t[p]=(t[p]+(r-l+1)*x%mod)%mod;return ;}
    pd(p,l,r);if(ql<=mid)add(p<<1,l,mid,ql,qr,x);
    if(qr>mid)add(p<<1|1,mid+1,r,ql,qr,x);pu(p);
}
int qry(int p,int l,int r,int ql,int qr){
    if(ql<=l && r<=qr)return t[p];
    int ret=0;pd(p,l,r);
    if(ql<=mid)ret=(ret+qry(p<<1,l,mid,ql,qr))%mod;
    if(qr>mid)ret=(ret+qry(p<<1|1,mid+1,r,ql,qr))%mod;
    pu(p);return ret;
}
动态开点
由正常线段树而来,发现一段区间会被拆成 \(log\) 段。
这启示我们,当维护范围过大时,真正有用的区间只有 \(n log n\) 段,因此在用这个点的时候开就可以做到更优的空间复杂度。
线段树1.5:一开始的东西就是等差数列求和,不用管,后面就是模板。
代码:
const int N=1e5+2;
#define int unsigned long long
int n,m,a[N*120],idx,lc[N*120],rc[N*120],lzy[N*120],rt;
void pd(int x,int l,int r,int mid){
	if(lzy[x]){
		if(!lc[x])lc[x]=++idx;if(!rc[x])rc[x]=++idx;
		a[lc[x]]+=(mid-l+1)*lzy[x];a[rc[x]]+=(r-mid)*lzy[x];
		lzy[lc[x]]+=lzy[x];lzy[rc[x]]+=lzy[x];lzy[x]=0;
	}
}
void update(int &x,int l,int r,int ql,int qr,int k){
	if(!x)x=++idx;
	if(ql<=l&&r<=qr){a[x]+=(r-l+1)*k;lzy[x]+=k;return;}
	int mid=(l+r)>>1;pd(x,l,r,mid);
	if(ql<=mid)update(lc[x],l,mid,ql,qr,k);
	if(qr>mid)update(rc[x],mid+1,r,ql,qr,k);
	a[x]=a[lc[x]]+a[rc[x]];
}
int query(int x,int l,int r,int ql,int qr){
	if(ql<=l&&r<=qr)return a[x];
	int mid=(l+r)>>1,ans=0;pd(x,l,r,mid);
	if(ql<=mid)ans+=query(lc[x],l,mid,ql,qr);
	if(qr>mid)ans+=query(rc[x],mid+1,r,ql,qr);return ans;
}
void sol(){
    cin>>n>>m;while(m--){
		int op,l,r,k;cin>>op>>l>>r;
		if(op==1)cin>>k,update(rt,1,n,l,r,k);
		else cout<<query(rt,1,n,l,r)+(l+r)*(r-l+1)/2<<'\n';
	}
}
矩形面积并
矩形的面积并直接做难以处理,情况繁多。首先,应当想到将矩形的两条对边拆出来,一个为正,一个为负。
这样,把所有平行的对边按照另外一维的坐标排序,矩形的面积并就转换为了所有 [相邻两条边之间的距离 乘上 前一条边处理结束后,此时有边覆盖,即权值大于0的地方的数量] 的总和。
于是得到数据结构题:区间加,全局查询大于0点数。可以拿线段树来做。
细节还是挺多的,涉及到离散化以及转回来。同时,注意\(pushup\)的及时更新。
#include<bits/stdc++.h>
using namespace std;
using ll=long long;
using pi=pair<int,int>;
const ll inf=0x3f3f3f3f3f3f3f3fll;
const double eps=1e-7;
template<typename A>using vc=vector<A>;
#define pb push_back
template<class T>inline void mkx(T &x,T y){if(x<y)x=y;}
template<class T>inline void mkn(T &x,T y){if(x>y)x=y;}
const int N=1e6+5;
#define int long long
int n,ls[N];struct nd{int y1,y2,x,op;}a[N];
bool cmp(nd x,nd y){return x.x<y.x;}
int t[N],s[N];
void pu(int p,int l,int r){
    if(s[p])return ;
    if(l!=r)t[p]=t[p<<1]+t[p<<1|1];else t[p]=0;
}
void add(int p,int l,int r,int ql,int qr,int x){
    if(ql<=l && r<=qr){
        s[p]+=x;if(s[p])t[p]=ls[r+1]-ls[l];else t[p]=0;
        pu(p,l,r);return ;
    }int mid=l+r>>1;
    if(ql<=mid)add(p<<1,l,mid,ql,qr,x);
    if(qr>mid)add(p<<1|1,mid+1,r,ql,qr,x);pu(p,l,r);
}
void sol(){
    cin>>n;for(int i=1;i<=n;i++){
        int x1,y1,x2,y2;cin>>x1>>y1>>x2>>y2;
        a[2*i-1]={y1,y2,x1,1};a[2*i]={y1,y2,x2,-1};
        ls[2*i-1]=y1,ls[i*2]=y2;
    }sort(a+1,a+2*n+1,cmp);sort(ls+1,ls+2*n+1);
    int tot=unique(ls+1,ls+2*n+1)-ls-1,ans=0;
    for(int i=1;i<2*n;i++){
        int l=lower_bound(ls+1,ls+tot+1,a[i].y1)-ls,r=lower_bound(ls+1,ls+tot+1,a[i].y2)-ls;
        if(l<r)add(1,1,tot-1,l,r-1,a[i].op);ans+=t[1]*(a[i+1].x-a[i].x);
    }cout<<ans<<'\n';
}
signed main(){
    ios::sync_with_stdio(false);cin.tie(0);
    int T=1;//cin>>T;
    while(T--)sol();
    return 0;
}
静态二维数点
说白了就是可以离线,而且数据范围不小,不用去想在线的主席树了。(
按照\(x\)排序询问,每次增加时添加上一个\(x\)到这个\(x\)的位置,(单点修改),然后对于此次查询,已经满足权值的关系,只需要区间查询和就可以,树状数组就能做。
代码:
const int N=2e6+5;
struct nd{int l,r,x,id;}q[N];int ans[N];
bool cmp(nd x,nd y){return x.x<y.x;}
int n,m,a[N];int t[N];vc<int>p[N];
void add(int x,int d){for(;x<=2e6;x+=x&(-x))t[x]+=d;}
int qry(int x){int r=0;for(;x;x-=x&(-x))r+=t[x];return r;}
void sol(){
    cin>>n>>m;for(int i=1;i<=n;i++)cin>>a[i],p[a[i]].pb(i);
    for(int i=1;i<=m;i++)cin>>q[i].l>>q[i].r>>q[i].x,q[i].id=i;
    sort(q+1,q+m+1,cmp);
    for(int i=1,j=1;i<=m;i++){
        while(j<=q[i].x){for(int x:p[j])add(x,1);j++;}
        ans[q[i].id]=qry(q[i].r)-qry(q[i].l-1);
    }for(int i=1;i<=m;i++)cout<<ans[i]<<'\n';
}
图论
LCA
const int N=1e6+5;
int n,m,s,fa[N][20],dep[N];vc<int>g[N];
void dfs(int x,int f){
    dep[x]=dep[f]+1;fa[x][0]=f;
    for(int i=1;i<=19;i++)fa[x][i]=fa[fa[x][i-1]][i-1];
    for(int y:g[x])if(y!=f)dfs(y,x);
}
int LCA(int x,int y){
    if(dep[x]>dep[y])swap(x,y);
    for(int i=19;i>=0;i--)if(dep[fa[y][i]]>=dep[x])y=fa[y][i];
    if(x==y)return x;
    for(int i=19;i>=0;i--)if(fa[x][i]!=fa[y][i])x=fa[x][i],y=fa[y][i];
    return fa[x][0];
}
void sol(){
    cin>>n>>m>>s;for(int i=1,u,v;i<n;i++)cin>>u>>v,g[v].pb(u),g[u].pb(v);
    dfs(s,0);while(m--){int x,y;cin>>x>>y;cout<<LCA(x,y)<<'\n';}
}
这是倍增的求法,二进制向上跳 \(2^x\) 级父亲即可。
最小生成树
const int N=2e5+5;
struct nd{int u,v,w;}e[N];int n,m,fa[N];
bool cmp(nd x,nd y){return x.w<y.w;}
int fd(int x){while(x!=fa[x])x=fa[x]=fa[fa[x]];return x;}
void sol(){
    cin>>n>>m;for(int i=1;i<=m;i++)cin>>e[i].u>>e[i].v>>e[i].w;
    int ans=0,ret=0;for(int i=1;i<=n;i++)fa[i]=i;sort(e+1,e+m+1,cmp);
    for(int i=1;i<=m;i++){
        int fu=fd(e[i].u),fv=fd(e[i].v);if(fu==fv)continue;fa[fu]=fv;
        ret++,ans+=e[i].w;if(ret==n-1)break;
    }if(ret==n-1)cout<<ans<<'\n';else cout<<"orz\n";
}
这是\(Kruskal\)的写法,排序后贪心,并查集判断联通性。
单源最短路
\(SPFA\) 大抵有点死了,好像只有判断负环会用。\(dij\) 不必多说,非常经典的模板,代码:
const int N=2e5+5;
int n,m,s;vc<pi>g[N];int d[N],v[N];struct nd{int x,d;};
bool operator <(nd x,nd y){return x.d>y.d;}priority_queue<nd>q;
void sol(){
    cin>>n>>m>>s;for(int i=1;i<=n;i++)d[i]=inf;d[s]=0;q.push({s,0});
    for(int i=1,u,v,w;i<=m;i++)cin>>u>>v>>w,g[u].pb({v,w});
    while(q.size()){
        auto [x,qqq]=q.top();q.pop();if(v[x])continue;v[x]=1;
        for(auto [y,w]:g[x])if(d[x]+w<d[y]&&!v[y])d[y]=d[x]+w,q.push({y,d[y]});
    }for(int i=1;i<=n;i++)cout<<d[i]<<' ';cout<<'\n';
}
拓扑排序
这个更水,BFS时拆边即可,很好写。
vc<int>g[N];int n,d[N];
void sol(){
    cin>>n;for(int i=1;i<=n;i++){int x;cin>>x;while(x)d[x]++,g[i].pb(x),cin>>x;}
    queue<int>q;for(int i=1;i<=n;i++)if(!d[i])q.push(i),cout<<i<<' ';
    while(q.size()){
        int x=q.front();q.pop();
        for(int y:g[x])if(--d[y]==0)q.push(y),cout<<y<<' ';
    }
}
差分约束
差分约束算是一个不等式系统,将给出的不等式条件移项,得到了\(x_c≤x_c+y\),可以看成最短路中更新每个节点 \(dis\) 的\(d[v]≤d[u]+w\)。
所以就是写最短路,注意有负环,所以不能用\(dij\)。由于数据范围,\(Bellman-Ford\)也是可以的,且更好写,故使用。
const int N=1e4+5;
struct edge{int x,y,z;}a[N];
int dis[N],n,m;
bool BF(){
	for(int i=1;i<=n;i++)dis[i]=1e9;dis[1]=0;
	for(int t=1;t<=n;t++)for(int i=1;i<=m;i++)mkn(dis[a[i].y],dis[a[i].x]+a[i].z);
	for(int i=1;i<=m;i++)if(dis[a[i].x]+a[i].z<dis[a[i].y])return false;
	return true;
}
void sol(){
    cin>>n>>m;for(int i=1;i<=m;i++)cin>>a[i].y>>a[i].x>>a[i].z;
	if(BF())for(int i=1;i<=n;i++) cout<<dis[i]<<' ';else cout<<"NO";
}
欧拉路径
需要判断 + 找出有向图的欧拉路径。
还有一点要注意的是本题需要按照字典序输出。直接用set即可。
欧拉路径其实只是\(dfs\),主要是判断是否存在细节很多:
图中恰好存在 1 个点出度比入度多 1(这个点即为 起点 S),1 个点入度比出度多 1(这个点即为 终点 T),其余节点出度=入度。
#include <bits/stdc++.h>
using namespace std;
const int N=1e5+10;
int ru[N],chu[N],n,m;
stack<int>s;
int delet[N];
vector<int>a[N];
void dfs(int u){
    for(int i=delet[u];i<a[u].size();i=delet[u]){
        delet[u]=i+1;
        dfs(a[u][i]);
    }
    s.push(u);
}
int main(){
    cin>>n>>m;
    for(int i=1;i<=m;i++){
    	int u,v;
        cin>>u>>v;
        a[u].push_back(v);
        chu[u]++,ru[v]++;
    }
    for(int i=1;i<=n;i++)sort(a[i].begin(),a[i].end());
    int st=1;
    bool flag=true;
    int sum1=0,sum2=0;
    for(int i=1;i<=n;i++){
        if(chu[i]!=ru[i])flag=false;
        if(chu[i]-ru[i]>1){
            cout<<"No";
            return 0;
        }
        if(chu[i]-ru[i]==1)st=i,sum1++;
        if(ru[i]-chu[i]==1)sum2++;
    }
    if(!(flag==true||(sum1==sum2)&&sum1==1)){
        cout<<"No";
        return 0;
    }
    dfs(st);
    while(s.size()){
        cout<<s.top()<<" ";
        s.pop();
    }
    return 0;
}
缩点
因为一个环上的点可以随便互相到达,那也就是说一个环相当于一个点。
所以用\(tarjan\)缩把强联通分量缩成点,然后拓扑排序跑最长路DP即可
\(tarjan\) 中,若\(x\)自己的时间戳和搜索树子树内最小时间戳相等,那不就是返祖边吗,所以直接判环并缩点。
#include<bits/stdc++.h>
using namespace std;
const int N=1e4+10,M=1e5+10;
int n,m,a[N],u[M],v[M];
vector<int>g[N],G[N];
int dfn[N],low[N],cnt,stk[N],top,belong[N];
int ins[N];
int in[N],dp[N],ans;
void tarjan(int u){
	dfn[u]=low[u]=++cnt;
	stk[++top]=u;
	ins[u]=true;
	for(int i:g[u]){
		if(!dfn[i]){
			tarjan(i);
			low[u]=min(low[u],low[i]);
		}
		else if(ins[i])low[u]=min(low[u],dfn[i]);
	}
	if(dfn[u]==low[u]){
		do{
			ins[stk[top]]=0;
			belong[stk[top]]=u;
			if(stk[top]!=u)a[u]+=a[stk[top]];
		}while(stk[top--]!=u);
	}
}
int main(){
	cin>>n>>m;
	for(int i=1;i<=n;i++)cin>>a[i];
	for(int i=1;i<=m;i++){
		cin>>u[i]>>v[i];
		g[u[i]].push_back(v[i]);
	}
	for(int i=1;i<=n;i++)if(!dfn[i])tarjan(i);
	for(int i=1;i<=m;i++){
		int x=belong[u[i]],y=belong[v[i]];
		if(x!=y){
			G[x].push_back(y);
			in[y]++;
		}
	}
	queue<int>q;
	for(int i=1;i<=n;i++)
		if(i==belong[i]&&!in[i]){
			q.push(i);
			dp[i]=a[i];
		}
	while(q.size()){
		int s=q.front();
		q.pop();
		for(int i:G[s]){
			dp[i]=max(dp[i],dp[s]+a[i]);
			--in[i];
			if(in[i]==0)q.push(i);
		}
	}
	for(int i=1;i<=n;i++)ans=max(ans,dp[i]);
	cout<<ans;
	return 0;
}
割点
割点的判定法则:\(dfn[x]<=low[y]\) 其中\(x\)是当前点,\(y\)是它相邻的一个点。所以直接\(tarjan\)即可。意思是搜索树子树中没有点能够回到\(x\)的祖先,那么断开\(x\)就会成为割点。
代码只是和上面部分的\(tarjan\)有一点区别。
const int N=2e5+5;
vc<int>G[N];int n,m,low[N],dfn[N],cut[N],tim,rt,ans;
void tarjan(int x){
	low[x]=dfn[x]=++tim;int num=0;
	for(int y:G[x]){
		if(dfn[y])mkn(low[x],dfn[y]);
		else{
			tarjan(y);mkn(low[x],low[y]);
			if(dfn[x]<=low[y]){num++;if(x!=rt||num>=2)if(cut[x]==0)cut[x]=1,ans++;}
		}
	}
}
void sol(){
    cin>>n>>m;for(int i=1,u,v;i<=m;i++)cin>>u>>v,G[u].pb(v),G[v].pb(u);
	for(int i=1;i<=n;i++)if(dfn[i]==0){rt=i;tarjan(i);}
	cout<<ans<<'\n';for(int i=1;i<=n;i++)if(cut[i]==1)cout<<i<<' ';
}
数论
数论是我学最差的一个东西,S组的数论是最近才补的 ,还是数据结构好啊
逆元
在\(mod\)意义下,除法只能用逆元来做。比较简便的方法是快速幂。
引入费马小定理:
若 \(p\) 是素数,\(a\) 是整数,则\(a^p \equiv a \pmod p.\)
特别地,若 \(p\nmid a\),则\(a^{p-1}\equiv 1 \pmod p.\)
所以得到\(a^{p-2}\equiv a \pmod p.\)
这不就是逆元吗,所以快速幂就可以。
模板题要求一串数,推式子发现有递推关系,见代码。
int a[N],n,p;
void sol(){
	cin>>n>>p;a[1]=1;cout<<"1\n";
	for(int i=2;i<=n;i++)a[i]=(p-p/i)*a[p%i]%p,cout<<a[i]<<'\n';
}
中国剩余定理(CRT)
定理
设 \(m_1,m_2,\dots,m_k\) 两两互素,即$ \gcd(m_i,m_j)=1\quad (i\neq j), $
则同余方程组$ \begin{cases}
x\equiv a_1\pmod{m_1}\
x\equiv a_2\pmod{m_2}\
\quad\vdots\
x\equiv a_k\pmod{m_k}
\end{cases} $
在模$ M=m_1m_2\cdots m_k $意义下有唯一解。
构造解法
令$ M_i=\frac{M}{m_i}. $
因为 \(m_1,\dots,m_k\) 两两互素,所以$ \gcd(M_i,m_i)=1. $
因此存在 \(t_i\),使得$ M_i t_i\equiv 1\pmod{m_i}. $
于是方程组的解为$ x\equiv \sum_{i=1}^{k} a_i M_i t_i \pmod M. $
即$ x\equiv a_1M_1t_1+a_2M_2t_2+\cdots+a_kM_kt_k\pmod M. $
代码使用拓展欧几里得求解。
ll exgcd(ll a,ll b,ll &x,ll &y){
	if(b==0){x=1;y=0;return a;}
	ll d=exgcd(b,a%b,y,x);
	y-=a/b*x;
	return d;
}
ll inv(ll a,ll m){
	ll x,y;exgcd(a,m,x,y);
	return (x%m+m)%m;
}
void sol(){
	int n;cin>>n;ll a[12],b[12];lll M=1;
	for(int i=0;i<n;i++)cin>>a[i]>>b[i],M*=a[i];
	lll ans=0;
	for(int i=0;i<n;i++){
		lll Mi=M/a[i];
		ll t=inv((ll)(Mi%a[i]),a[i]);
		ans=(ans+(lll)b[i]*Mi*t)%M;
	}
	cout<<(ll)ans<<"\n";
}
二元一次不定方程
本部分Markdown语法有AI辅助成分
这东西也太恶心了,学了好一会。推导过程还是挺长的。
题目
求解不定方程$$ax + by = c$$
求整数解 \((x, y)\)。设 \(d = \gcd(a, b)\)。
通解推导
有解条件:方程有整数解 当且仅当 \(d \mid c\)。
然后找特解:
用 \(exgcd\) 求出$$a x_0 + b y_0 = d$$
两边同乘 \(\dfrac{c}{d}\),得到一组特解:$$X = \frac{c}{d} x_0,Y = \frac{c}{d} y_0$$
用特解推导通解:
记$$A = \frac{a}{d}, B = \frac{b}{d}$$(此时 \(\gcd(A, B) = 1\)),则通解为
注意: \(x\) 随 \(k\) 增大,\(y\) 随 \(k\) 减小,二者单调性相反,这是后面判断的关键。
判定有无正整数解:
推导得:
- 若 \(k_{\text{low}} > k_{\text{high}}\):无正整数解 → 走「求 \(x_{\min}^{+}\)、\(y_{\min}^{+}\)」流程。
- 否则:有正整数解,\(k \in [k_{\text{low}}, k_{\text{high}}]\)。
情况1:有正整数解时求五个量
因为 \(x\) 随 \(k\) 增、\(y\) 随 \(k\) 减,所以:
解的数量 :\(k_{\text{hi}} - k_{\text{low}} + 1\)
\(x_{\min} = X + k_{\text{low}} B\)
\(y_{\text{min}} = Y - k_{\text{high}} A\)
\(x_{\text{max}} = X + k_{\text{high}} B\)
\(y_{\text{max}} = Y - k_{\text{low}} A\)
情况2:无正整数解时求两个最小值
终于写完了!!剩下的就是对着式子抄一遍,不放代码了。
矩阵快速幂
这个是非常简单的,矩阵乘法普及组内容,快速幂普及组内容,把快速幂的乘法换成矩阵的即可。优化\(DP\)常用的,而且放在\(DP\)时候细节不少。
struct mat{
	int a[105][105];
	mat(){memset(a,0,sizeof(a));}
}s,ans;
mat operator*(mat x,mat y){
	mat z;for(int i=1;i<=n;i++)for(int j=1;j<=n;j++)for(int k=1;k<=n;k++)
		z.a[i][j]=(z.a[i][j]+x.a[i][k]*y.a[k][j])%mod;return z;
}
void sol(){
	cin>>n>>k;for(int i=1;i<=n;i++)for(int j=1;j<=n;j++)cin>>s.a[i][j];
	for(int i=1;i<=n;i++)ans.a[i][i]=1;
	for(;k;k>>=1,s=s*s)if(k&1	)ans=ans*s;
	for(int i=1;i<=n;i++,cout<<'\n')for(int j=1;j<=n;j++)cout<<ans.a[i][j]<<' ';
}
高斯消元法
解线性方程组的一种方法,本质就是消元。
高斯-约旦消元法过程
依次从 \(1\) 行处理到第 \(n\) 行,当前行记为 \(r\)
- 选主元:依次枚举主元所在的列 \(col : 1 \to n\)
- 找主元最大的行,将当前行与其交换
- 将当前行除以主元,使主元变为 1。用当前行消去所有其他行(包括上面的行)的主元列元素,将第 \(r\) 行乘以 \(-\frac{a_{i,col}}{a_{r,col}}\),加入第 \(j\) 列中。
然后对每一列重复上述过程。
消元法结束后,就形成了一个对角矩阵,直接用常数除以系数就可以解出。
无解的情况也要判,就是系数为0但是常数不为0。还有自由元的情况,还有无数组解的情况,但是本题未判断。
代码按照上面写的。
double a[105][105];int n;
bool chk(){
	for(int i=1;i<=n;i++){
		int max=i;
		for(int j=i+1;j<=n;j++)if(fabs(a[max][i])<fabs(a[j][i]))max=j;
		if(fabs(a[max][i])<eps)return false;
		swap(a[i],a[max]);
		for(int j=1;j<=n;j++){
			if(j==i)continue;
			double ret=(a[j][i]/a[i][i]);
			for(int k=i;k<=n+1;k++)a[j][k]-=ret*a[i][k];
		}
	}
	return true;
}
void sol(){
	cin>>n;for(int i=1;i<=n;i++)for(int j=1;j<=n+1;j++)cin>>a[i][j];
	if(chk())for(int i=1;i<=n;i++)printf("%.2lf\n",a[i][n+1]/a[i][i]);
	else cout<<"No Solution\n";
}
结语
这东西终于写完了。算是一种归纳和整理,希望能对即将到来的CSPS起到帮助。NOIP的东西其实很大程度上和CSPS有重复,但是NOIP还是会另写的。

 浙公网安备 33010602011771号