
<四>网络之socket--并发编程
并发有:线程、进程、进程池、协程。(虽然自己写的概率较小,但概念必须了解)
知道线程、进程、进程池、协程常用 模块 的实现原理及Gevent库(同步或异步编程)的实现原理。
可以实现:异步非阻塞多线程或进程。
进程:程序的运行过程。父子执行都是无序的。数据不能共享
进程池:(能用进程池就用进程池pool,也可用proess)
线程:父子执行都是无序的。可以global共享全局变量。尽量用协程。
多进程占用的资源比多线程多,每个资源都会复制一份,而线程会共用一份;
携程:微线程。
轮循:一直判断直到结束。但效率很低
同步锁:
互斥锁:解决共享资源不会出问题,上锁的代码越少越好。
死锁和递归锁:
信号量:信号量用来控制线程并发数的,相当于同步锁,同时控制指定数量,加锁和解锁。(了解)
队列quest模块:一种数据结构,在线程中才有意义,数据是安全的。列表在多线程中是不安全 的。
并发:是指系统具有处理多个任务(动作)的能力
并行:是指系统具有同时处理多个任务(动作)的能力
并行是并发的子集。
同步event:有规律执行。。。。控制线程谁先执行(了解)
异步:不知道执行条件什么时候产生,不要专门等待,条件满足时再去执行,做完了再回来。
全局解释器锁GIL:无论你启多少个线程,你有多少个cpu, Python在执行的时候会淡定的在同一时刻只允许一个线程运行
目录
一、背景知识
一 基本知识
1 一个程序至少有一个进程,一个进程至少有一个线程.(进程可以理解成线程的容器)

2 进程在执行过程中拥有独立的内存单元,而多个线程共享内存,从而极大地提高了程序的运行效率。

3 线程在执行过程中与进程还是有区别的。每个独立的线程有一个程序运行的入口、顺序执行序列和
  程序的出口。但是线程不能够独立执行,必须依存在应用程序中,由应用程序提供多个线程执行控制。

4 进程是具有一定独立功能的程序关于某个数据集合上的一次运行活动,进程是系统进行资源分配和调
  度的一个独立单位.
  线程是进程的一个实体,是CPU调度和分派的基本单位,它是比进程更小的能独立运行的基本单位.线程
  自己基本上不拥有系统资源,只拥有一点在运行中必不可少的资源(如程序计数器,一组寄存器和栈)但是
  它可与同属一个进程的其他的线程共享进程所拥有的全部资源.
  一个线程可以创建和撤销另一个线程;同一个进程中的多个线程之间可以并发执行
二、 python并发编程之多线程
理论:http://www.cnblogs.com/linhaifeng/articles/7430082.html
链接:http://www.cnblogs.com/linhaifeng/articles/7428877.html
1)线程的两种调用方式
threading 模块建立在thread 模块之上。thread模块以低级、原始的方式来处理和控制线程,而threading 模块通过对thread进行二次封装,
提供了更方便的api来处理线程。
直接调用:

import threading
import time

def sayhi(num): #定义每个线程要运行的函数

    print("running on number:%s" %num)

    time.sleep(3)

if __name__ == '__main__':

    t1 = threading.Thread(target=sayhi,args=(1,)) #生成一个线程实例
    t2 = threading.Thread(target=sayhi,args=(2,)) #生成另一个线程实例

    t1.start() #启动线程
    t2.start() #启动另一个线程

    print(t1.getName()) #获取线程名
    print(t2.getName())
继承式调用:
import threading
import time


class MyThread(threading.Thread):
    def __init__(self,num):
        threading.Thread.__init__(self)
        self.num = num

    def run(self):#定义每个线程要运行的函数

        print("running on number:%s" %self.num)

        time.sleep(3)

if __name__ == '__main__':

    t1 = MyThread(1)
    t2 = MyThread(2)
    t1.start()
    t2.start()

    print("ending......")
2)threading.thread的实例方法
join&Daemon方法
import threading
from time import ctime,sleep
import time

def ListenMusic(name):

        print ("Begin listening to %s. %s" %(name,ctime()))
        sleep(3)
        print("end listening %s"%ctime())

def RecordBlog(title):

        print ("Begin recording the %s! %s" %(title,ctime()))
        sleep(5)
        print('end recording %s'%ctime())


threads = []


t1 = threading.Thread(target=ListenMusic,args=('水手',))
t2 = threading.Thread(target=RecordBlog,args=('python线程',))

threads.append(t1)
threads.append(t2)

if __name__ == '__main__':

    for t in threads:
        #t.setDaemon(True) #注意:一定在start之前设置
        t.start()
        # t.join()
    # t1.join()
    t1.setDaemon(True)

    #t2.join()########考虑这三种join位置下的结果?
    print ("all over %s" %ctime())
join():在子线程完成运行之前,这个子线程的父线程将一直被阻塞。没写哪个子进程就是最后一个。
setDaemon(True):
将线程声明为守护线程,必须在start() 方法调用之前设置, 这个方法基本和join是相反的。
不管子线程是否完成,都要和主线程一起退出,这时就可以 用setDaemon方法啦
其它方法
# run():  线程被cpu调度后自动执行线程对象的run方法
# start():启动线程活动。
# isAlive(): 返回线程是否活动的。
# getName(): 返回线程名。
# setName(): 设置线程名。

threading模块提供的一些方法:
# threading.currentThread(): 返回当前的线程变量。
# threading.enumerate(): 返回一个包含正在运行的线程的list。正在运行指线程启动后、结束前,不包括启动前和终止后的线程。
# threading.activeCount(): 返回正在运行的线程数量,与len(threading.enumerate())有相同的结果。
3) 同步锁(Lock)
R=threading.Lock()创建锁
R.acquire()加锁
R.release()开锁
import time
import threading

def addNum():
    global num #在每个线程中都获取这个全局变量
    #num-=1

    temp=num
    #print('--get num:',num )
    time.sleep(0.1)
    num =temp-1 #对此公共变量进行-1操作

num = 100  #设定一个共享变量
thread_list = []
for i in range(100):
    t = threading.Thread(target=addNum)
    t.start()
    thread_list.append(t)

for t in thread_list: #等待所有线程执行完毕
    t.join()

print('final num:', num )
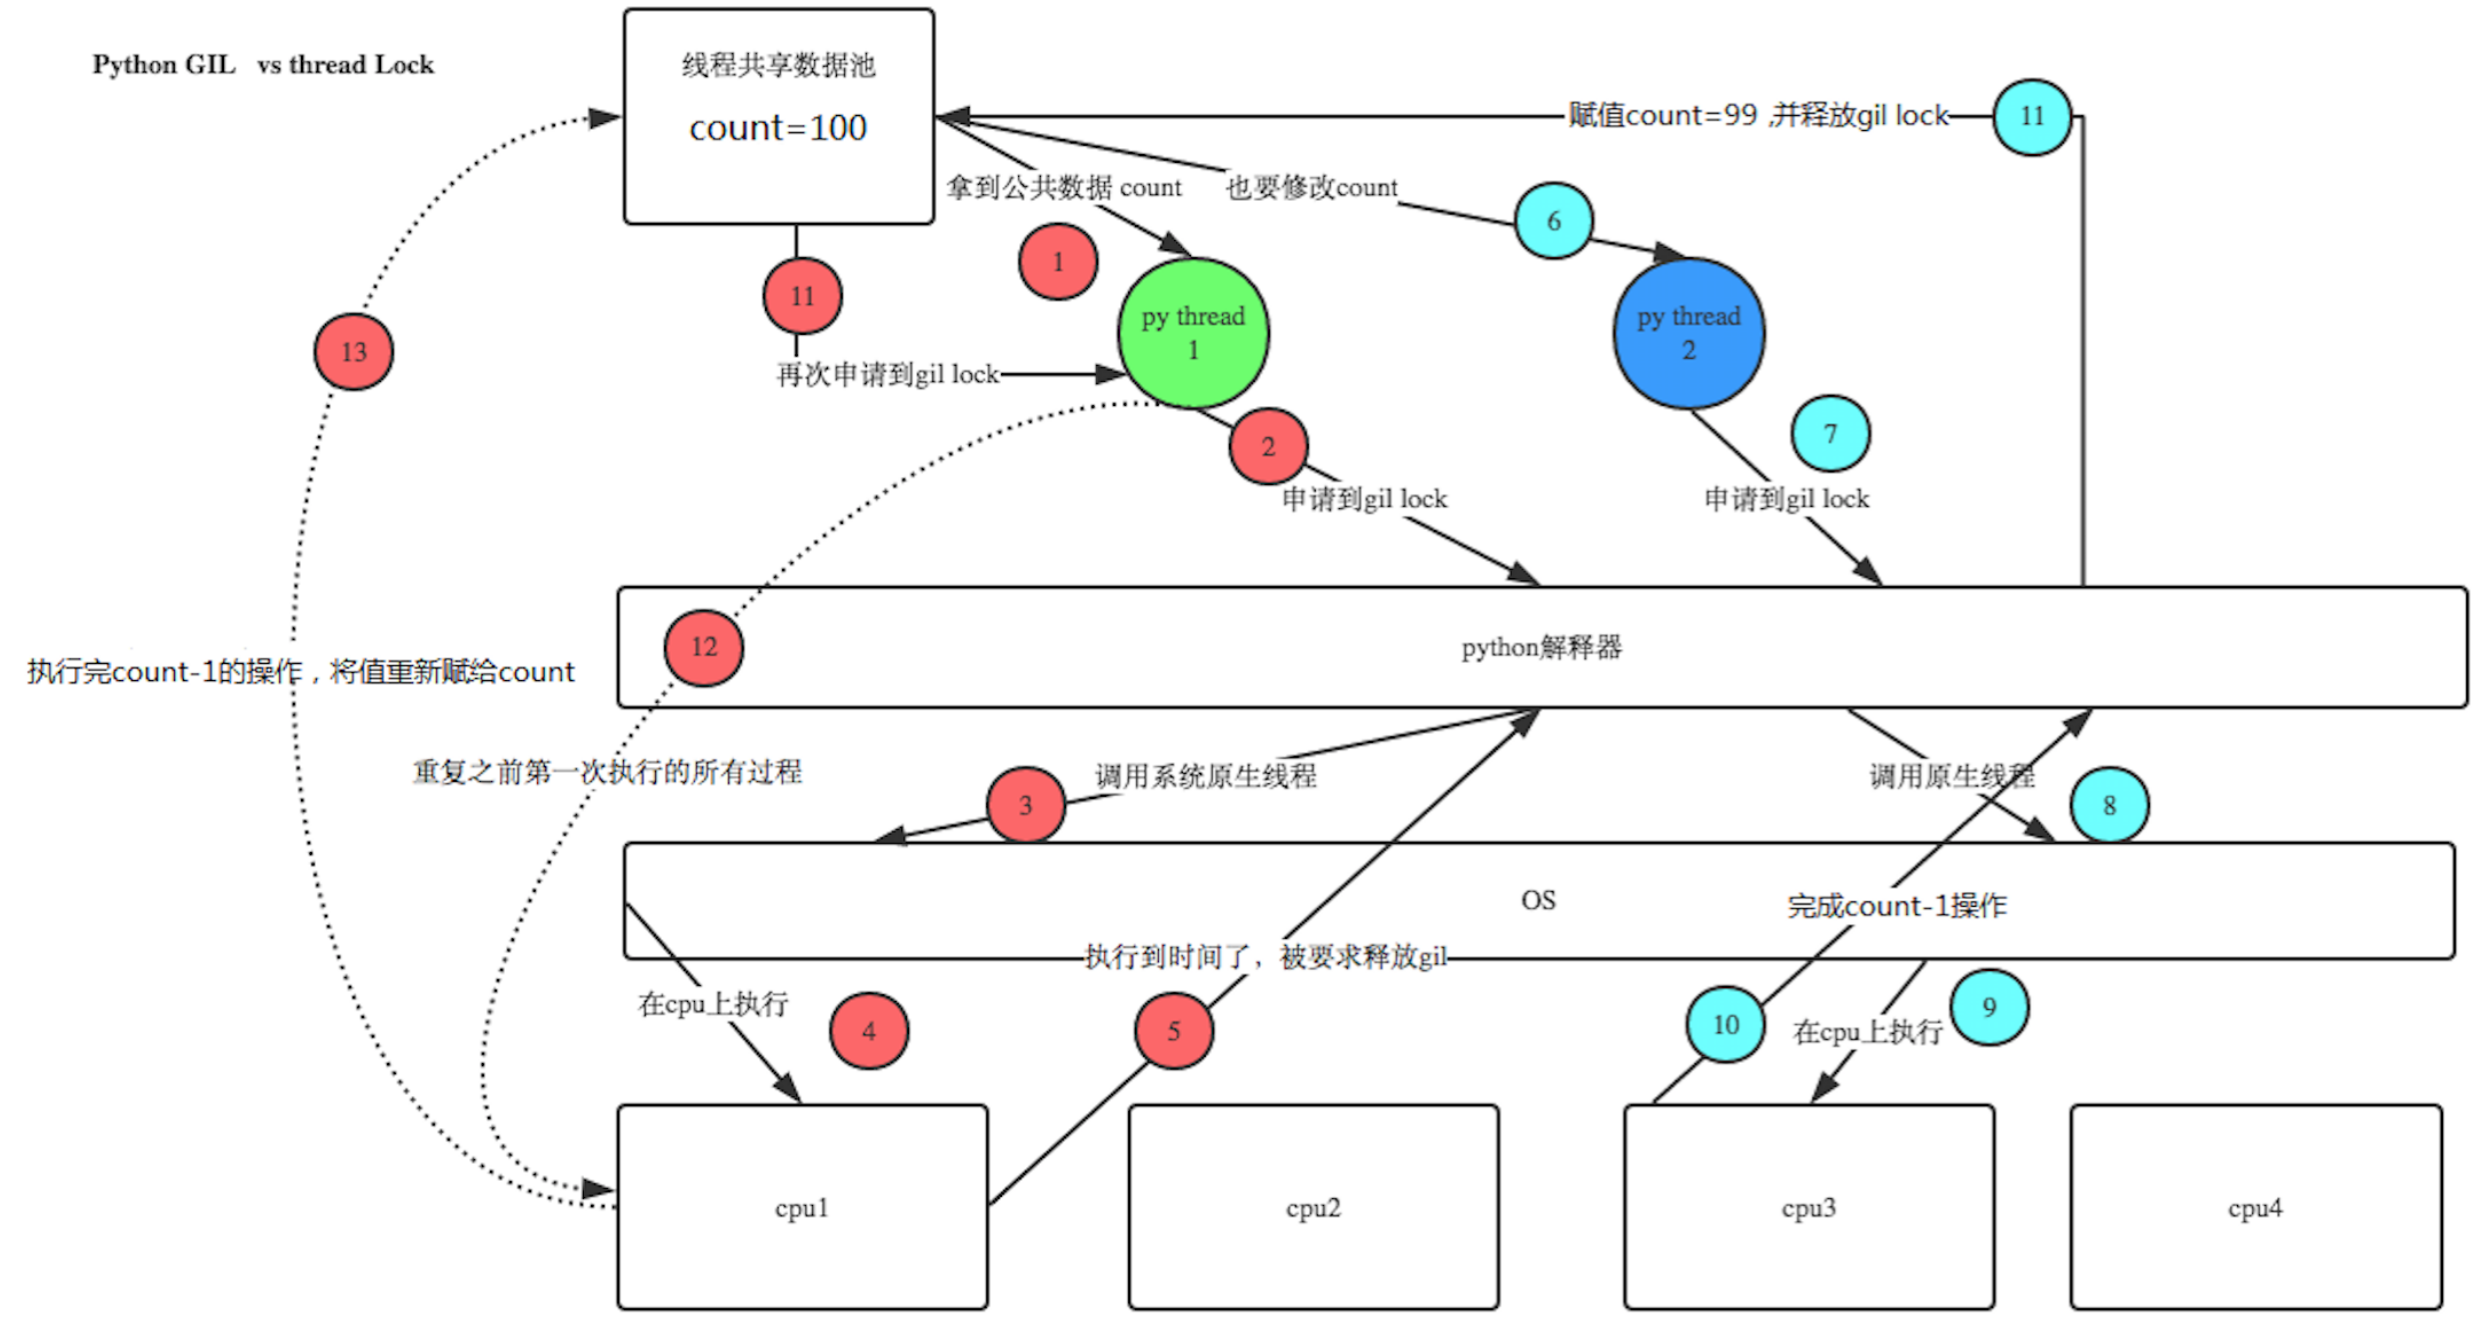
观察:time.sleep(0.1) /0.001/0.0000001 结果分别是多少?
多个线程都在同时操作同一个共享资源,所以造成了资源破坏,怎么办呢?(join会造成串行,失去所线程的意义)
我们可以通过同步锁来解决这种问题
|
1
2
3
4
5
6
7
8
9
10
|
R=threading.Lock()####def sub(): global num R.acquire() temp=num-1 time.sleep(0.1) num=temp R.release() |
4) 线程死锁和递归锁
在线程间共享多个资源的时候,如果两个线程分别占有一部分资源并且同时等待对方的资源,就会造成死锁,因为系统判断这部分资源都正在使用,所有这两个线程在无外力作用下将一直等待下去。下面是一个死锁的例子:
import threading,time

class myThread(threading.Thread):
    def doA(self):
        lockA.acquire()
        print(self.name,"gotlockA",time.ctime())
        time.sleep(3)
        lockB.acquire()
        print(self.name,"gotlockB",time.ctime())
        lockB.release()
        lockA.release()

    def doB(self):
        lockB.acquire()
        print(self.name,"gotlockB",time.ctime())
        time.sleep(2)
        lockA.acquire()
        print(self.name,"gotlockA",time.ctime())
        lockA.release()
        lockB.release()

    def run(self):
        self.doA()
        self.doB()
if __name__=="__main__":

    lockA=threading.Lock()
    lockB=threading.Lock()
    threads=[]
    for i in range(5):
        threads.append(myThread())
    for t in threads:
        t.start()
    for t in threads:
        t.join()#等待线程结束,后面再讲。
解决办法:使用递归锁,将
|
1
2
|
lockA=threading.Lock()lockB=threading.Lock()<br>#--------------<br>lock=threading.RLock() |
为了支持在同一线程中多次请求同一资源,python提供了“可重入锁”:threading.RLock。RLock内部维护着一个Lock和一个counter变量,counter记录了acquire的次数,从而使得资源可以被多次acquire。直到一个线程所有的acquire都被release,其他的线程才能获得资源。
应用
 View Code
同步条件(Event):控制线程谁先执行。
event = threading.Event()
event.isSet():返回event的状态值;

event.wait():如果 event.isSet()==False将阻塞线程;

event.set(): 设置event的状态值为True,所有阻塞池的线程激活进入就绪状态, 等待操作系统调度;

event.clear():恢复event的状态值为False。
import threading,time
class Boss(threading.Thread):
    def run(self):
        print("BOSS:今晚大家都要加班到22:00。")
        print(event.isSet())
        event.set()
        time.sleep(5)
        print("BOSS:<22:00>可以下班了。")
        print(event.isSet())
        event.set()
class Worker(threading.Thread):
    def run(self):
        event.wait()
        print("Worker:哎……命苦啊!")
        time.sleep(1)
        event.clear()
        event.wait()
        print("Worker:OhYeah!")
if __name__=="__main__":
    event=threading.Event()
    threads=[]
    for i in range(5):
        threads.append(Worker())
    threads.append(Boss())
    for t in threads:
        t.start()
    for t in threads:
        t.join()
5)信号量(Semaphore)相当于同步锁,同时控制指定数量,加锁和解锁。
信号量用来控制线程并发数的,BoundedSemaphore或Semaphore管理一个内置的计数 器,每当调用acquire()时-1,调用release()时+1。
计数器不能小于0,当计数器为 0时,acquire()将阻塞线程至同步锁定状态,直到其他线程调用release()。(类似于停车位的概念)
BoundedSemaphore与Semaphore的唯一区别在于前者将在调用release()时检查计数 器的值是否超过了计数器的初始值,如果超过了将抛出一个异常。
import threading,time
class myThread(threading.Thread):
    def run(self):
        if semaphore.acquire():
            print(self.name)
            time.sleep(5)
            semaphore.release()
if __name__=="__main__":
    semaphore=threading.Semaphore(5)
    thrs=[]
    for i in range(100):
        thrs.append(myThread())
    for t in thrs:
        t.start()
6)定时器,指定n秒后执行某操作
from threading import Timer


def hello():
    print("hello, world")

t = Timer(1, hello)
t.start()  # after 1 seconds, "hello, world" will be printed
7)多线程利器---队列(queue)数据是安全的
列表是不安全的数据结构


import threading,time

li=[1,2,3,4,5]

def pri():
    while li:
        a=li[-1]
        print(a)
        time.sleep(1)
        try:
            li.remove(a)
        except Exception as e:
            print('----',a,e)

t1=threading.Thread(target=pri,args=())
t1.start()
t2=threading.Thread(target=pri,args=())
t2.start()
思考:如何通过对列来完成上述功能?
queue列队类的方法
创建一个“队列”对象
import Queue
q = Queue.Queue(maxsize = 10)
Queue.Queue类即是一个队列的同步实现。队列长度可为无限或者有限。可通过Queue的构造函数的可选参数maxsize来设定队列长度。如果maxsize小于1就表示队列长度无限。

将一个值放入队列中
q.put(10)
调用队列对象的put()方法在队尾插入一个项目。put()有两个参数,第一个item为必需的,为插入项目的值;第二个block为可选参数,默认为
1。如果队列当前为空且block为1,put()方法就使调用线程暂停,直到空出一个数据单元。如果block为0,put方法将引发Full异常。队列放满后就卡住。

将一个值从队列中取出
q.get()
调用队列对象的get()方法从队头删除并返回一个项目。可选参数为block,默认为True。如果队列为空且block为True,
get()就使调用线程暂停,直至有项目可用。如果队列为空且block为False,队列将引发Empty异常。

Python Queue模块有三种队列及构造函数:
1、Python Queue模块的FIFO队列先进先出。   class queue.Queue(maxsize)
2、LIFO类似于堆,即先进后出。               class queue.LifoQueue(maxsize)
3、还有一种是优先级队列级别越低越先出来。        class queue.PriorityQueue(maxsize)

此包中的常用方法(q = Queue.Queue()):
q.qsize() 返回队列的大小
q.empty() 如果队列为空,返回True,反之False
q.full() 如果队列满了,返回True,反之False
q.full 与 maxsize 大小对应
q.get([block[, timeout]]) 获取队列,timeout等待时间
q.get_nowait() 相当q.get(False)
非阻塞 q.put(item) 写入队列,timeout等待时间
q.put_nowait(item) 相当q.put(item, False)
q.task_done() 在完成一项工作之后,q.task_done() 函数向任务已经完成的队列发送一个信号
q.join() 实际上意味着等到队列为空,再执行别的操作
other mode:
import queue

#先进后出

q=queue.LifoQueue()

q.put(34)
q.put(56)
q.put(12)

#优先级
# q=queue.PriorityQueue()
# q.put([5,100])
# q.put([7,200])
# q.put([3,"hello"])
# q.put([4,{"name":"alex"}])

while 1:

  data=q.get()
  print(data)
8)生产者消费者模型:
为什么要使用生产者和消费者模式:解耦
什么是生产者消费者模式
生产者消费者模式是通过一个容器来解决生产者和消费者的强耦合问题。生产者和消费者彼此之间不直接通讯,而通过阻塞队列来进行通讯,所以生产者生产完数据之后不用等待消费者处理,直接扔给阻塞队列,消费者不找生产者要数据,而是直接从阻塞队列里取,阻塞队列就相当于一个缓冲区,平衡了生产者和消费者的处理能力。
这就像,在餐厅,厨师做好菜,不需要直接和客户交流,而是交给前台,而客户去饭菜也不需要不找厨师,直接去前台领取即可,这也是一个结耦的过程。
import time,random
import queue,threading

q = queue.Queue()

def Producer(name):
  count = 0
  while count <10:
    print("making........")
    time.sleep(random.randrange(3))
    q.put(count)
    print('Producer %s has produced %s baozi..' %(name, count))
    count +=1
    #q.task_done()
    #q.join()
    print("ok......")
def Consumer(name):
  count = 0
  while count <10:
    time.sleep(random.randrange(4))
    if not q.empty():
        data = q.get()
        #q.task_done()
        #q.join()
        print(data)
        print('\033[32;1mConsumer %s has eat %s baozi...\033[0m' %(name, data))
    else:
        print("-----no baozi anymore----")
    count +=1

p1 = threading.Thread(target=Producer, args=('A',))
c1 = threading.Thread(target=Consumer, args=('B',))
# c2 = threading.Thread(target=Consumer, args=('C',))
# c3 = threading.Thread(target=Consumer, args=('D',))
p1.start()
c1.start()
# c2.start()
# c3.start()
三、 python并发编程之多进程
<多进程模块 multiprocessing>
multiprocessing>由于GIL的存在,python中的多线程其实并不是真正的多线程,如果想要充分地使用多核CPU的资源,在python中大部分情况需要使用多进程。
multiprocessing包是Python中的多进程管理包。与threading.Thread类似,它可以利用multiprocessing.Process对象来创建一个进程。该进程可以运行在Python程序内部编写的函数。该Process对象与Thread对象的用法相同,也有start(), run(), join()的方法。此外multiprocessing包中也有Lock/Event/Semaphore/Condition类 (这些对象可以像多线程那样,通过参数传递给各个进程),用以同步进程,其用法与threading包中的同名类一致。所以,multiprocessing的很大一部份与threading使用同一套API,只不过换到了多进程的情境。
1)进程的调用
调用方式1
from multiprocessing import Process
import time
def f(name):
    time.sleep(1)
    print('hello', name,time.ctime())

if __name__ == '__main__':
    p_list=[]
    for i in range(3):
        p = Process(target=f, args=('alvin',))
        p_list.append(p)
        p.start()
    for i in p_list:
        p.join()
    print('end')
调用方式2
from multiprocessing import Process
import time

class MyProcess(Process):
    def __init__(self):
        super(MyProcess, self).__init__()
        #self.name = name

    def run(self):
        time.sleep(1)
        print ('hello', self.name,time.ctime())


if __name__ == '__main__':
    p_list=[]
    for i in range(3):
        p = MyProcess()
        p.start()
        p_list.append(p)

    for p in p_list:
        p.join()

    print('end')
To show the individual process IDs involved, here is an expanded example:
from multiprocessing import Process
import os
import time
def info(title):

    print("title:",title)
    print('parent process:', os.getppid())
    print('process id:', os.getpid())

def f(name):
    info('function f')
    print('hello', name)

if __name__ == '__main__':
    info('main process line')
    time.sleep(1)
    print("------------------")
    p = Process(target=info, args=('yuan',))
    p.start()
    p.join()
2) Process类
构造方法:
Process([group [, target [, name [, args [, kwargs]]]]])

  group: 线程组,目前还没有实现,库引用中提示必须是None;
  target: 要执行的方法;
  name: 进程名;
  args/kwargs: 要传入方法的参数。

实例方法:

  is_alive():返回进程是否在运行。

  join([timeout]):阻塞当前上下文环境的进程程,直到调用此方法的进程终止或到达指定的timeout(可选参数)。

  start():进程准备就绪,等待CPU调度

  run():strat()调用run方法,如果实例进程时未制定传入target,这star执行t默认run()方法。

  terminate():不管任务是否完成,立即停止工作进程

属性:

  daemon:和线程的setDeamon功能一样

  name:进程名字。

  pid:进程号。
View Code3) 进程间通讯
3.1 进程对列Queue,与线程的队列调用时有区别的。两个进程间的交互<multiprocessing .Queue>
from multiprocessing import Process, Queue
import queue

def f(q,n):
    #q.put([123, 456, 'hello'])
    q.put(n*n+1)
    print("son process",id(q))

if __name__ == '__main__':
    q = Queue()  #try: q=queue.Queue()
    print("main process",id(q))

    for i in range(3):
        p = Process(target=f, args=(q,i))
        p.start()

    print(q.get())
    print(q.get())
    print(q.get())
3.2 管道
from multiprocessing import Process, Pipe

def f(conn):
    conn.send([12, {"name":"yuan"}, 'hello'])
    response=conn.recv()
    print("response",response)
    conn.close()
    print("q_ID2:",id(child_conn))

if __name__ == '__main__':

    parent_conn, child_conn = Pipe()
    print("q_ID1:",id(child_conn))
    p = Process(target=f, args=(child_conn,))
    p.start()
    print(parent_conn.recv())   # prints "[42, None, 'hello']"
    parent_conn.send("儿子你好!")
    p.join()
3.3 Managers数据共享
Queue和pipe只是实现了数据交互,并没实现数据共享,即一个进程去更改另一个进程的数据。
A manager object returned by Manager() controls a server process which holds Python objects and allows other processes to manipulate them using proxies.
A manager returned by Manager() will support types list, dict, Namespace, Lock, RLock, Semaphore, BoundedSemaphore, Condition, Event, Barrier, Queue, Value and Array. For example:
from multiprocessing import Process, Manager

def f(d, l,n):
    d[n] = '1'
    d['2'] = 2
    d[0.25] = None
    l.append(n)
    #print(l)

    print("son process:",id(d),id(l))

if __name__ == '__main__':

    with Manager() as manager:

        d = manager.dict()

        l = manager.list(range(5))

        print("main process:",id(d),id(l))

        p_list = []

        for i in range(10):
            p = Process(target=f, args=(d,l,i))
            p.start()
            p_list.append(p)

        for res in p_list:
            res.join()

        print(d)
        print(l)
4)进程同步
from multiprocessing import Process, Lock

def f(l, i):

    with l.acquire():
        print('hello world %s'%i)

if __name__ == '__main__':
    lock = Lock()

    for num in range(10):
        Process(target=f, args=(lock, num)).start()
五 进程池<from multiprocessing import Pool>数据是共享的
进程池内部维护一个进程序列,当使用时,则去进程池中获取一个进程,如果进程池序列中没有可供使用的进程,那么程序就会等待,直到进程池中有可用进程为止。
进程池中有两个方法:
- apply
- apply_async 异步时用
from  multiprocessing import Process,Pool
import time,os

def Foo(i):
    time.sleep(1)
    print(i)
    return i+100

def Bar(arg):

    print(os.getpid())
    print(os.getppid())
    print('logger:',arg)

pool = Pool(5)

Bar(1)
print("----------------")

for i in range(10):
    #pool.apply(func=Foo, args=(i,))
    #pool.apply_async(func=Foo, args=(i,))
    pool.apply_async(func=Foo, args=(i,),callback=Bar)  #回调函数callback,执行完foo返回一个值给回调函数的参数。主进程的事情,如打印日志
pool.close() pool.join() #与close顺序不能颠倒了 print('end')
<四 Python中的上下文管理器(contextlib模块)>
上下文管理器的任务是:代码块执行前准备,代码块执行后收拾
1 如何使用上下文管理器:
如何打开一个文件,并写入"hello world"
|
1
2
3
4
5
|
filename="my.txt"mode="w"f=open(filename,mode)f.write("hello world")f.close() |
当发生异常时(如磁盘写满),就没有机会执行第5行。当然,我们可以采用try-finally语句块进行包装:
|
1
2
3
4
5
|
writer=open(filename,mode)try: writer.write("hello world")finally: writer.close() |
当我们进行复杂的操作时,try-finally语句就会变得丑陋,采用with语句重写:
|
1
2
|
with open(filename,mode) as writer: writer.write("hello world") |
as指代了从open()函数返回的内容,并把它赋给了新值。with完成了try-finally的任务。
2 自定义上下文管理器
with语句的作用类似于try-finally,提供一种上下文机制。要应用with语句的类,其内部必须提供两个内置函数__enter__和__exit__。前者在主体代码执行前执行,后者在主体代码执行后执行。as后面的变量,是在__enter__函数中返回的。
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
|
class echo(): def output(self): print "hello world" def __enter__(self): print "enter" return self #可以返回任何希望返回的东西 def __exit__(self,exception_type,value,trackback): print "exit" if exception_type==ValueError: return True else: return Flase >>>with echo as e: e.output() 输出:enterhello worldexit |
完备的__exit__函数如下:
|
1
|
def __exit__(self,exc_type,exc_value,exc_tb) |
其中,exc_type:异常类型;exc_value:异常值;exc_tb:异常追踪信息
当__exit__返回True时,异常不传播
3 contextlib模块
contextlib模块的作用是提供更易用的上下文管理器,它是通过Generator实现的。contextlib中的contextmanager作为装饰器来提供一种针对函数级别的上下文管理机制,常用框架如下:
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
|
from contextlib import contextmanager@contextmanagerdef make_context(): print 'enter' try: yield "ok" except RuntimeError,err: print 'error',err finally: print 'exit' >>>with make_context() as value: print value 输出为: enter ok exit |
其中,yield写入try-finally中是为了保证异常安全(能处理异常)as后的变量的值是由yield返回。yield前面的语句可看作代码块执行前操作,yield之后的操作可以看作在__exit__函数中的操作。
以线程锁为例:
@contextlib.contextmanager
def loudLock():
    print 'Locking'
    lock.acquire()
    yield
    print 'Releasing'
    lock.release()

with loudLock():
    print 'Lock is locked: %s' % lock.locked()
    print 'Doing something that needs locking'

#Output:
#Locking
#Lock is locked: True
#Doing something that needs locking
#Releasing
4 contextlib.nested:减少嵌套
对于:
|
1
2
3
|
with open(filename,mode) as reader: with open(filename1,mode1) as writer: writer.write(reader.read()) |
可以通过contextlib.nested进行简化:
|
1
2
|
with contextlib.nested(open(filename,mode),open(filename1,mode1)) as (reader,writer): writer.write(reader.read()) |
在python 2.7及以后,被一种新的语法取代:
|
1
2
|
with open(filename,mode) as reader,open(filename1,mode1) as writer: writer.write(reader.read()) |
5 contextlib.closing()
file类直接支持上下文管理器API,但有些表示打开句柄的对象并不支持,如urllib.urlopen()返回的对象。还有些遗留类,使用close()方法而不支持上下文管理器API。为了确保关闭句柄,需要使用closing()为它创建一个上下文管理器(调用类的close方法)。
View Code四、协程
协程,又称微线程,纤程。英文名Coroutine。
优点1: 协程极高的执行效率。因为子程序切换不是线程切换,而是由程序自身控制,因此,没有线程切换的开销,和多线程比,线程数量越多,协程的性能优势就越明显。
优点2: 不需要多线程的锁机制,因为只有一个线程,也不存在同时写变量冲突,在协程中控制共享资源不加锁,只需要判断状态就好了,所以执行效率比多线程高很多。
因为协程是一个线程执行,那怎么利用多核CPU呢?最简单的方法是多进程+协程,既充分利用多核,又充分发挥协程的高效率,可获得极高的性能。
yield的简单实现
import time
import queue

def consumer(name):
    print("--->ready to eat baozi...")
    while True:
        new_baozi = yield
        print("[%s] is eating baozi %s" % (name,new_baozi))
        #time.sleep(1)

def producer():

    r = con.__next__()
    r = con2.__next__()
    n = 0
    while 1:
        time.sleep(1)
        print("\033[32;1m[producer]\033[0m is making baozi %s and %s" %(n,n+1) )
        con.send(n)
        con2.send(n+1)

        n +=2


if __name__ == '__main__':
    con = consumer("c1")
    con2 = consumer("c2")
    p = producer()
greenlet
greenlet是一个用C实现的协程模块,相比与python自带的yield,它可以使你在任意函数之间随意切换,而不需把这个函数先声明为generator
手动随意切换。
from greenlet import greenlet


def test1():
    print(12)
    gr2.switch()
    print(34)
    gr2.switch()


def test2():
    print(56)
    gr1.switch()
    print(78)


gr1 = greenlet(test1)
gr2 = greenlet(test2)
gr1.switch()
gevent自动切换
import gevent

import requests,time


start=time.time()

def f(url):
    print('GET: %s' % url)
    resp =requests.get(url)
    data = resp.text
    print('%d bytes received from %s.' % (len(data), url))

gevent.joinall([

        gevent.spawn(f, 'https://www.python.org/'),
        gevent.spawn(f, 'https://www.yahoo.com/'),
        gevent.spawn(f, 'https://www.baidu.com/'),
        gevent.spawn(f, 'https://www.sina.com.cn/'),

])

# f('https://www.python.org/')
#
# f('https://www.yahoo.com/')
#
# f('https://baidu.com/')
#
# f('https://www.sina.com.cn/')

print("cost time:",time.time()-start)
四 python并发编程之协程
链接:http://www.cnblogs.com/linhaifeng/articles/7429894.html
协程:是单线程下的并发,又称微线程,纤程。英文名Coroutine。一句话说明什么是线程:协程是一种用户态的轻量级线程,即协程是由用户程序自己控制调度的。、
需要强调的是:
#1. python的线程属于内核级别的,即由操作系统控制调度(如单线程遇到io或执行时间过长就会被迫交出cpu执行权限,切换其他线程运行)
#2. 单线程内开启协程,一旦遇到io,就会从应用程序级别(而非操作系统)控制切换,以此来提升效率(!!!非io操作的切换与效率无关)
对比操作系统控制线程的切换,用户在单线程内控制协程的切换
优点如下:
#1. 协程的切换开销更小,属于程序级别的切换,操作系统完全感知不到,因而更加轻量级
#2. 单线程内就可以实现并发的效果,最大限度地利用cpu
缺点如下:
#1. 协程的本质是单线程下,无法利用多核,可以是一个程序开启多个进程,每个进程内开启多个线程,每个线程内开启协程
#2. 协程指的是单个线程,因而一旦协程出现阻塞,将会阻塞整个线程
总结协程特点:
- 必须在只有一个单线程里实现并发
- 修改共享数据不需加锁
- 用户程序里自己保存多个控制流的上下文栈
- 附加:一个协程遇到IO操作自动切换到其它协程(如何实现检测IO,yield、greenlet都无法实现,就用到了gevent模块(select机制))
三 Greenlet
如果我们在单个线程内有20个任务,要想实现在多个任务之间切换,使用yield生成器的方式过于麻烦(需要先得到初始化一次的生成器,然后再调用send。。。非常麻烦),而使用greenlet模块可以非常简单地实现这20个任务直接的切换
#安装
pip3 install greenlet
from greenlet import greenlet

def eat(name):
    print('%s eat 1' %name)
    g2.switch('egon')
    print('%s eat 2' %name)
    g2.switch()
def play(name):
    print('%s play 1' %name)
    g1.switch()
    print('%s play 2' %name)

g1=greenlet(eat)
g2=greenlet(play)

g1.switch('egon')#可以在第一次switch时传入参数,以后都不需要
单纯的切换(在没有io的情况下或者没有重复开辟内存空间的操作),反而会降低程序的执行速度
greenlet只是提供了一种比generator更加便捷的切换方式,当切到一个任务执行时如果遇到io,那就原地阻塞,仍然是没有解决遇到IO自动切换来提升效率的问题。
单线程里的这20个任务的代码通常会既有计算操作又有阻塞操作,我们完全可以在执行任务1时遇到阻塞,就利用阻塞的时间去执行任务2。。。。如此,才能提高效率,这就用到了Gevent模块。
四 Gevent介绍
#安装
pip3 install gevent
Gevent 是一个第三方库,可以轻松通过gevent实现并发同步或异步编程,在gevent中用到的主要模式是Greenlet, 它是以C扩展模块形式接入Python的轻量级协程。 Greenlet全部运行在主程序操作系统进程的内部,但它们被协作式地调度。
#用法
g1=gevent.spawn(func,1,,2,3,x=4,y=5)创建一个协程对象g1,spawn括号内第一个参数是函数名,如eat,后面可以有多个参数,可以是位置实参或关键字实参,都是传给函数eat的

g2=gevent.spawn(func2)

g1.join() #等待g1结束

g2.join() #等待g2结束

#或者上述两步合作一步:gevent.joinall([g1,g2])

g1.value#拿到func1的返回值
遇到IO阻塞时会自动切换任务
import gevent
def eat(name):
    print('%s eat 1' %name)
    gevent.sleep(2)
    print('%s eat 2' %name)

def play(name):
    print('%s play 1' %name)
    gevent.sleep(1)
    print('%s play 2' %name)


g1=gevent.spawn(eat,'egon')
g2=gevent.spawn(play,name='egon')
g1.join()
g2.join()
#或者gevent.joinall([g1,g2])
print('主')
上例gevent.sleep(2)模拟的是gevent可以识别的io阻塞,
而time.sleep(2)或其他的阻塞,gevent是不能直接识别的需要用下面一行代码,打补丁,就可以识别了
from gevent import monkey;monkey.patch_all()必须放到被打补丁者的前面,如time,socket模块之前
或者我们干脆记忆成:要用gevent,需要将from gevent import monkey;monkey.patch_all()放到文件的开头
from gevent import monkey;monkey.patch_all()

import gevent
import time
def eat():
    print('eat food 1')
    time.sleep(2)
    print('eat food 2')

def play():
    print('play 1')
    time.sleep(1)
    print('play 2')

g1=gevent.spawn(eat)
g2=gevent.spawn(play_phone)
gevent.joinall([g1,g2])
print('主')
我们可以用threading.current_thread().getName()来查看每个g1和g2,查看的结果为DummyThread-n,即假线程
五 Gevent之同步与异步
from gevent import spawn,joinall,monkey;monkey.patch_all()

import time
def task(pid):
    """
    Some non-deterministic task
    """
    time.sleep(0.5)
    print('Task %s done' % pid)


def synchronous():
    for i in range(10):
        task(i)

def asynchronous():
    g_l=[spawn(task,i) for i in range(10)]
    joinall(g_l)

if __name__ == '__main__':
    print('Synchronous:')
    synchronous()

    print('Asynchronous:')
    asynchronous()
#上面程序的重要部分是将task函数封装到Greenlet内部线程的gevent.spawn。 初始化的greenlet列表存放在数组threads中,此数组被传给gevent.joinall 函数,后者阻塞当前流程,并执行所有给定的greenlet。执行流程只会在 所有greenlet执行完后才会继续向下走。
六 Gevent之应用举例一
from gevent import monkey;monkey.patch_all()
import gevent
import requests
import time

def get_page(url):
    print('GET: %s' %url)
    response=requests.get(url)
    if response.status_code == 200:
        print('%d bytes received from %s' %(len(response.text),url))


start_time=time.time()
gevent.joinall([
    gevent.spawn(get_page,'https://www.python.org/'),
    gevent.spawn(get_page,'https://www.yahoo.com/'),
    gevent.spawn(get_page,'https://github.com/'),
])
stop_time=time.time()
print('run time is %s' %(stop_time-start_time))
七 Gevent之应用举例二
通过gevent实现单线程下的socket并发(from gevent import monkey;monkey.patch_all()一定要放到导入socket模块之前,否则gevent无法识别socket的阻塞)
from gevent import monkey;monkey.patch_all()
from socket import *
import gevent

#如果不想用money.patch_all()打补丁,可以用gevent自带的socket
# from gevent import socket
# s=socket.socket()

def server(server_ip,port):
    s=socket(AF_INET,SOCK_STREAM)
    s.setsockopt(SOL_SOCKET,SO_REUSEADDR,1)
    s.bind((server_ip,port))
    s.listen(5)
    while True:
        conn,addr=s.accept()
        gevent.spawn(talk,conn,addr)

def talk(conn,addr):
    try:
        while True:
            res=conn.recv(1024)
            print('client %s:%s msg: %s' %(addr[0],addr[1],res))
            conn.send(res.upper())
    except Exception as e:
        print(e)
    finally:
        conn.close()

if __name__ == '__main__':
    server('127.0.0.1',8080)

服务端
#_*_coding:utf-8_*_
__author__ = 'Linhaifeng'

from socket import *

client=socket(AF_INET,SOCK_STREAM)
client.connect(('127.0.0.1',8080))


while True:
    msg=input('>>: ').strip()
    if not msg:continue

    client.send(msg.encode('utf-8'))
    msg=client.recv(1024)
    print(msg.decode('utf-8'))
from threading import Thread
from socket import *
import threading

def client(server_ip,port):
    c=socket(AF_INET,SOCK_STREAM) #套接字对象一定要加到函数内,即局部名称空间内,放在函数外则被所有线程共享,则大家公用一个套接字对象,那么客户端端口永远一样了
    c.connect((server_ip,port))

    count=0
    while True:
        c.send(('%s say hello %s' %(threading.current_thread().getName(),count)).encode('utf-8'))
        msg=c.recv(1024)
        print(msg.decode('utf-8'))
        count+=1
if __name__ == '__main__':
    for i in range(500):
        t=Thread(target=client,args=('127.0.0.1',8080))
        t.start()
五 python并发编程之IO模型
链接:http://www.cnblogs.com/linhaifeng/articles/7454717.html
六 补充:paramiko模块
1. 介绍:
paramiko是一个用于做远程控制的模块,使用该模块可以对远程服务器进行命令或文件操作,值得一说的是,fabric和ansible内部的远程管理就是使用的paramiko来现实。
2. 下载安装
pip3 install paramiko #在python3中
在python2中3. 使用
SSHClient
用于连接远程服务器并执行基本命令
基于用户名密码连接:
import paramiko

# 创建SSH对象
ssh = paramiko.SSHClient()
# 允许连接不在know_hosts文件中的主机
ssh.set_missing_host_key_policy(paramiko.AutoAddPolicy())
# 连接服务器
ssh.connect(hostname='120.92.84.249', port=22, username='root', password='xxx')

# 执行命令
stdin, stdout, stderr = ssh.exec_command('df')
# 获取命令结果
result = stdout.read()
print(result.decode('utf-8'))
# 关闭连接
ssh.close()
SSHClient 封装 Transport基于公钥密钥连接:
客户端文件名:id_rsa
服务端必须有文件名:authorized_keys(在用ssh-keygen时,必须制作一个authorized_keys,可以用ssh-copy-id来制作)
View Code SSHClient 封装 Transport 基于私钥字符串进行连接SFTPClient
用于连接远程服务器并执行上传下载
基于用户名密码上传下载
View Code基于公钥密钥上传下载
View Code Demo 七 作业
题目:简单主机批量管理工具
需求:
- 主机分组
- 主机信息配置文件用configparser解析
- 可批量执行命令、发送文件,结果实时返回,执行格式如下
- batch_run -h h1,h2,h3 -g web_clusters,db_servers -cmd "df -h"
- batch_scp -h h1,h2,h3 -g web_clusters,db_servers -action put -local test.py -remote /tmp/
- 主机用户名密码、端口可以不同
- 执行远程命令使用paramiko模块
- 批量命令需使用multiprocessing并发

 浙公网安备 33010602011771号