
DeepLearning-PyTorch
DeepLearning
深度学习的本质
-
深度学习的数学本质 : 通过组合一系列简单的、可微分的非线性函数,形成一个极深的复合函数,从而在高维空间中学习一个极度复杂的流形,用以逼近数据的内在规律(即概率分布或决策函数)。从数学上看,深度学习模型就是一个极其复杂的复合函数。
f(x)=f(L)(...f(2)(f(1)(x))...)f(x)=f(L)(...f(2)(f(1)(x))...)
-
深度学习的功能本质 : 将万物映射到向量空间,通过海量数据学习出这些向量之间纷繁复杂的几何与变换关系。而在使用时,它正是根据输入激活这些关系,去计算出我们想要的那个向量表达——无论它是一个分类概率、一段生成的文字,还是一张全新的图片。
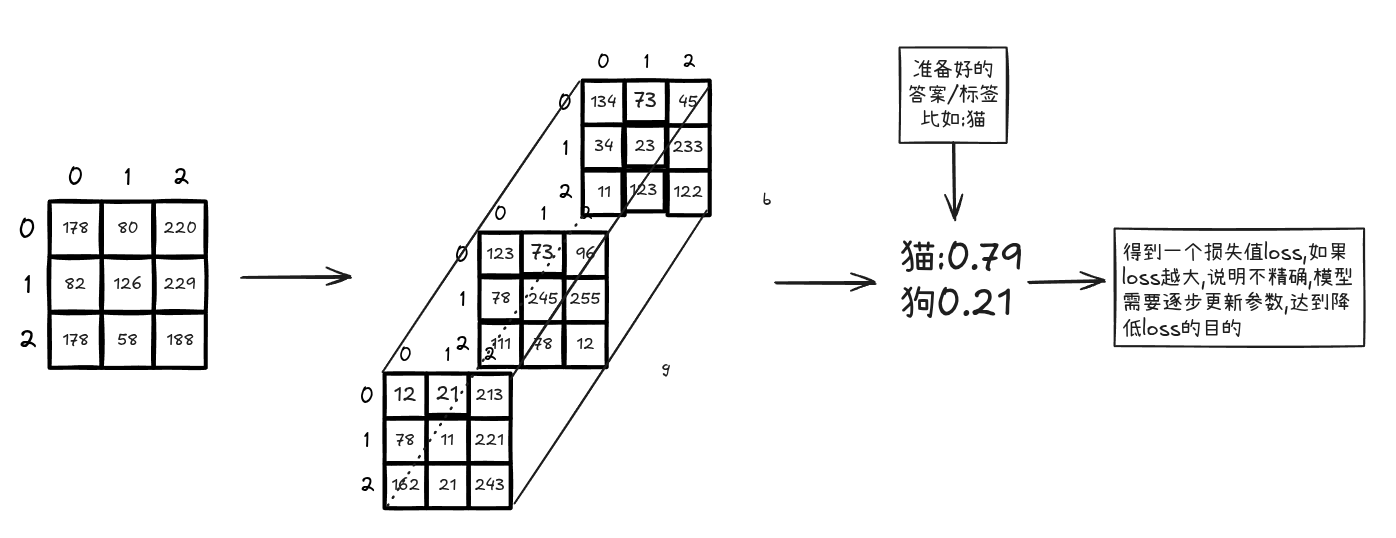
下面是一张图片的训练过程 :
- 模型看到的,是一排排从0到255的RGB数字。训练的起点是完全混乱的,它随机猜测,错误百出。
- 接着,通过计算预测和真实答案之间的误差,反向传播算法会精确地“问责”每一层网络:是谁的权重导致了错误?然后,优化器会朝着减小错误的方向,对所有参数进行微调。那些能提取出“尖耳朵”、“圆眼睛”这些猫狗关键特征的滤波器会被加强,而无效的滤波器会被削弱。
- 这样,在数百万张图片的反复纠错中,网络从一个像素盲人,渐渐磨砺成一个能看透图像本质的模式识别专家。
线性模型
引入
线性模型。它是一切现代深度学习的基础,理解了它,就拿到了进入复杂模型的钥匙。
线性模型,就是通过给每个输入特征分配一个“重要性权重”,然后加权求和,来做出预测。它假设输入和输出之间的关系是一条直线或一个平面。
线性模型最简单的公式你一定见过:
比如下面这个例子,加入学习1个小时,可以得到2分,2小小时可以得到4分,3个小时可以得到6分,那么4个小时可以得到多少分呢?
我们可以很清楚的知道,似乎是遵循线性关系,y和x之间是2倍关系,所以猜测4小时得分8分.
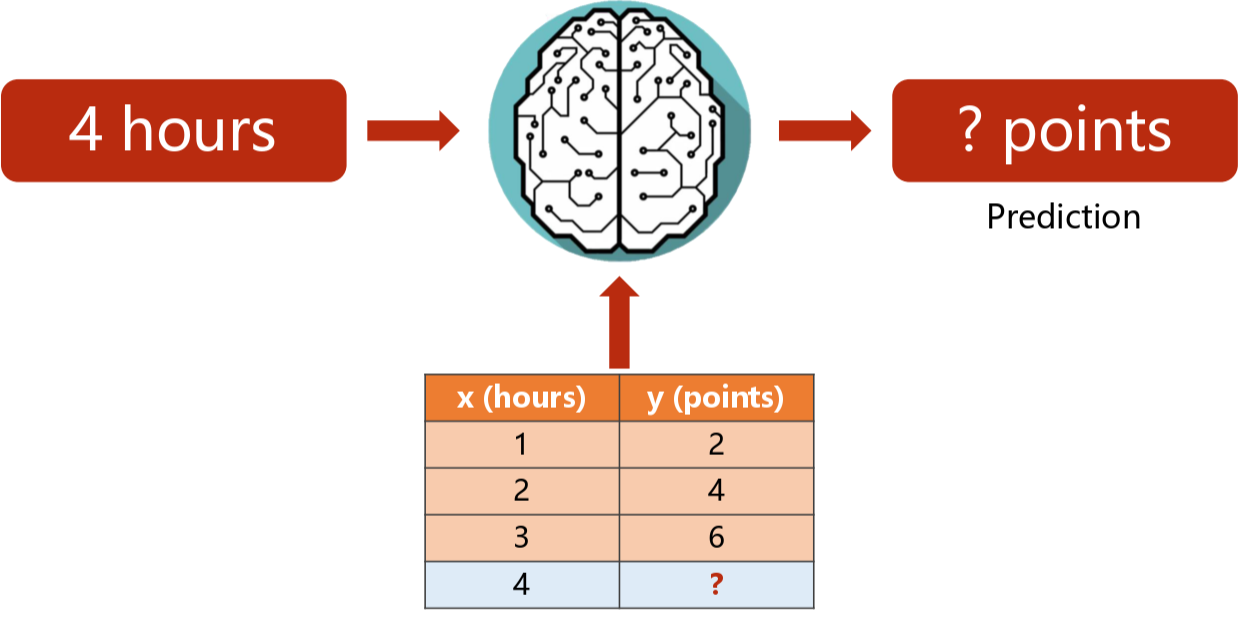
深度学习我们可以怎么做呢?
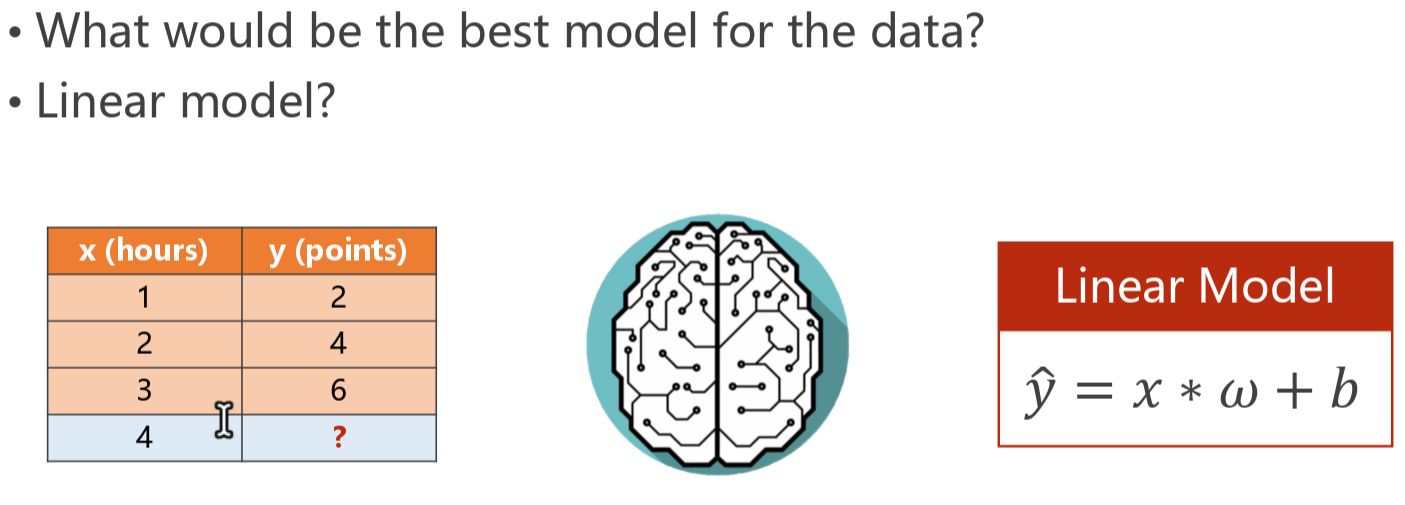
首先我们猜测可能是线性模型,y = x * w + b (不过我们在这里简化使用y = x * w )
然后计算机可以尝试不同的w+b组合得到不同的结果y.这时候将对应关系在坐标轴上画出,清晰的显示出了真实的结果和其他组合结果的差距.
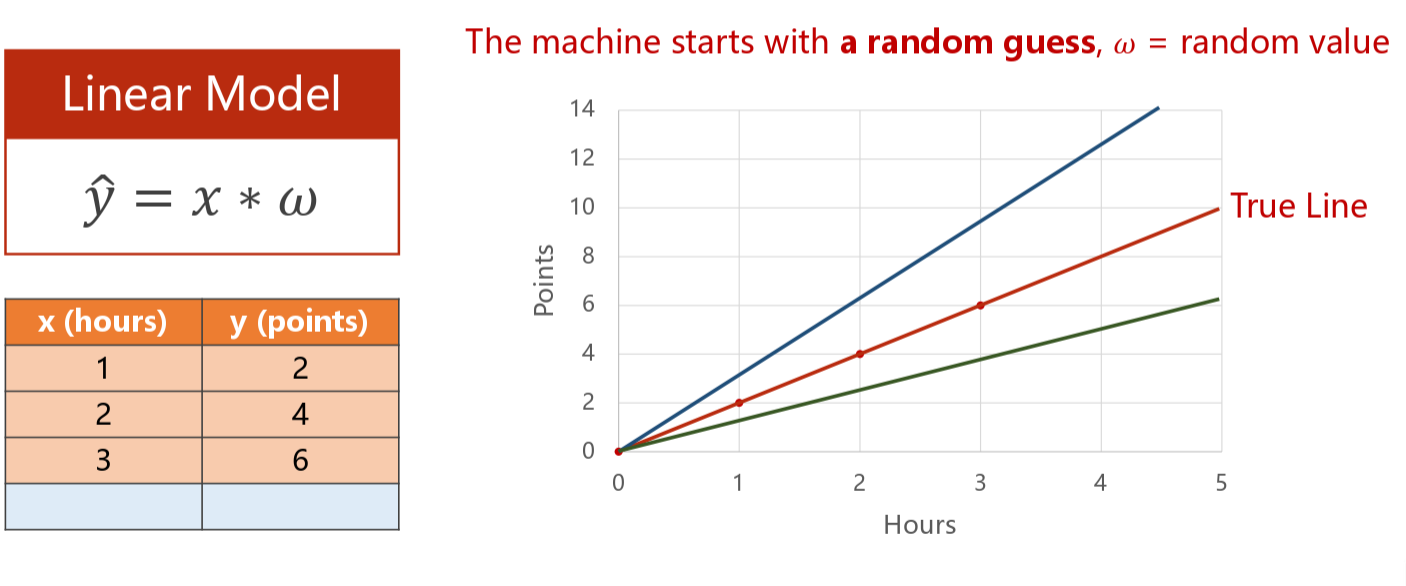
我们将真实的结果记为 y ,不同组合下的预测结果为 ŷ.
我们可以计算 ŷ 和实际的 y 之间的差值,用这个差值代表预测的距离.但是由于 ŷ可能大于也可能小于y,所以我们取用平方规避负号.
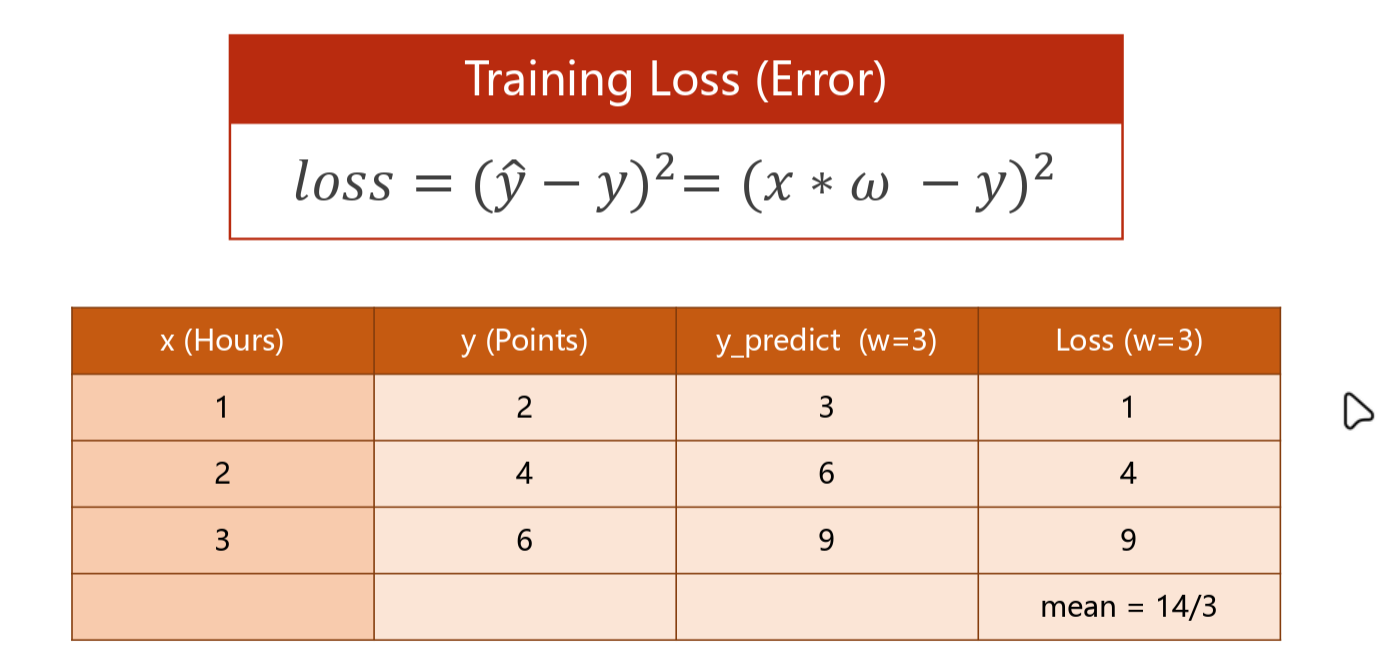
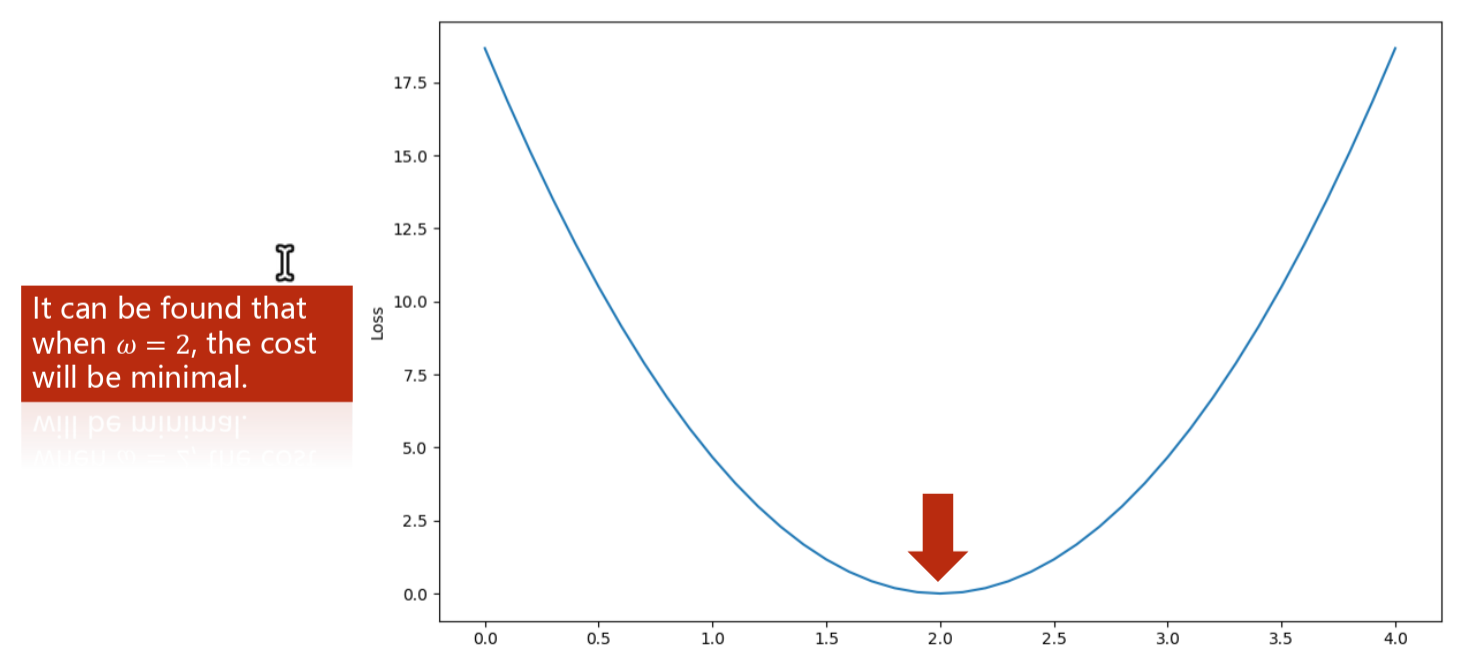
可以看到不同的w,对最终的这个距离影响不同.这个距离就是我们成为loss损失的值.考虑两者之间的相似性,要求两者之间的距离最短,也就是loss值越小.我们的目的就是找出使得整体loss值最小的组合.


计算机通过不同参数组合,发现当w取到2的时候,整体的loss最小,这时候认为该模型最好.

代码实现
接下来我们使用python代码完成:
import numpy as np
import matplotlib.pyplot as plt

x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]


def forward(x):
    return x*w


def loss(x, y):
    y_pred = forward(x)
    return (y_pred - y)**2


# 穷举法
w_list = []
mse_list = []
for w in np.arange(0.0, 4.1, 0.1):
    print("w=", w)
    l_sum = 0
    for x_val, y_val in zip(x_data, y_data):
        y_pred_val = forward(x_val)
        loss_val = loss(x_val, y_val)
        l_sum += loss_val
        print('\t', x_val, y_val, y_pred_val, loss_val)
    print('MSE=', l_sum/3)
    w_list.append(w)
    mse_list.append(l_sum/3)

plt.plot(w_list,mse_list)
plt.ylabel('Loss')
plt.xlabel('w')
plt.show()
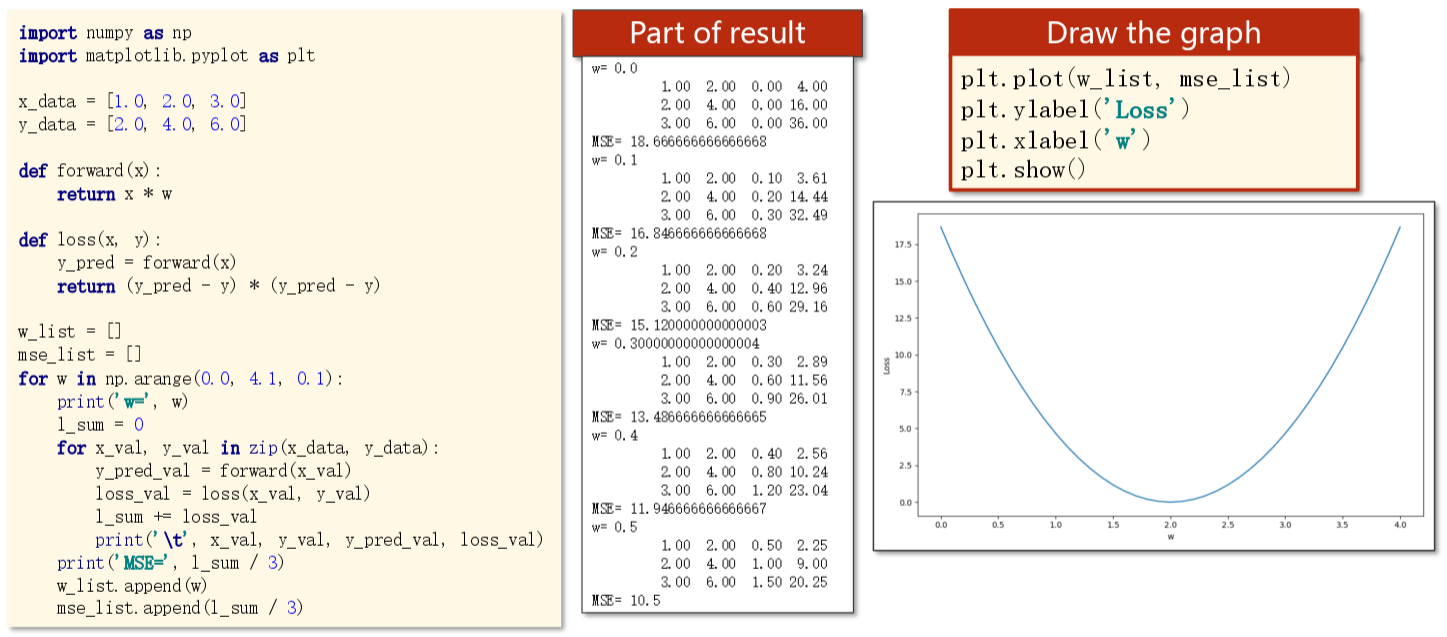
简单来说就是我们按照w 从0开始,每0,1一个间隔递增一直到4.0,我们计算每个不同的取值对最终的loss的影响,得出最后的loss值最小的参数w.
梯度下降
引入
线性模型的目标,是找到一组最佳的参数 w和 b,让预测误差最小。最“笨”也最直接的想法就是穷举:
- 怎么做:把 w从负无穷到正无穷,每隔 0.001 取一个值,比如 -10000.000, -9999.999... 把 b也这样。然后代入所有数据,把每一种组合的损失都算出来,最后挑出损失最小的那一组。
- 致命缺点:
- 维度灾难:如果只有一个参数 w,穷举或许可行。但现实中有成千上万个参数,组合数就是天文数字,穷举的运算量会瞬间击穿宇宙中所有计算机的算力。
- 精度矛盾:想要更精确的解,步长就得更小(比如0.0001),这又会让计算量呈指数级爆炸。
- 浪费算力:绝大多数被尝试的参数组合都错得离谱,比如 w=9999 这条直线,模型其实早就知道它不行,但穷举法还是会去算一遍。
结论就是:在高维参数空间中,穷举法是计算上完全不可行的死路。
既然不能地毯式搜索,就需要一种“有方向”的搜索策略。
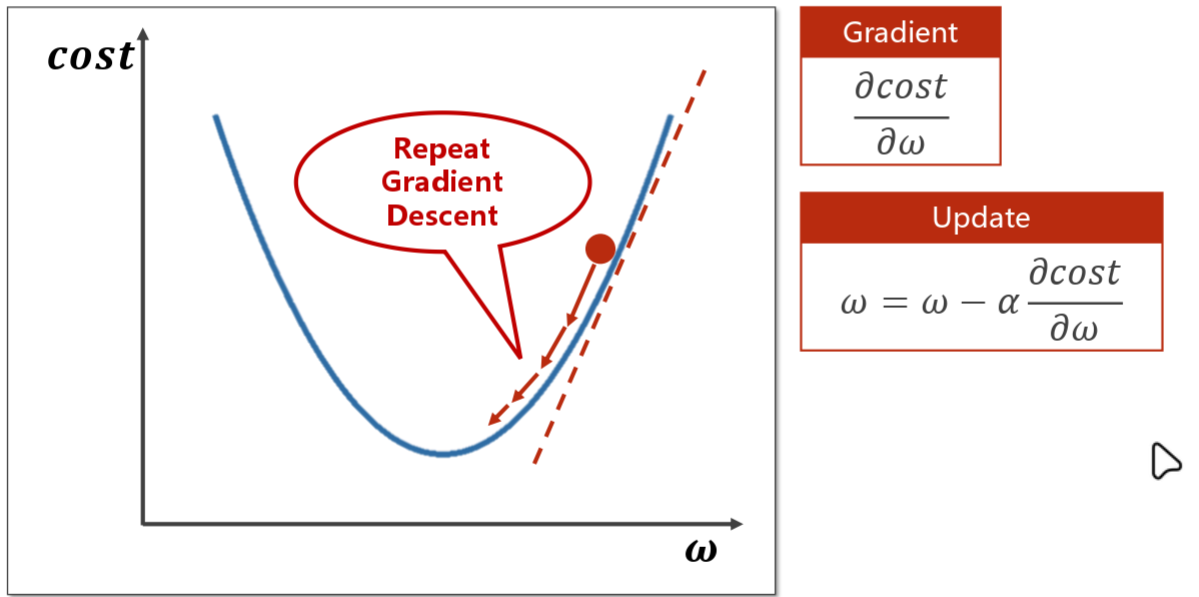
想象你被蒙着眼,站在一座连绵不绝的山脉(损失函数的地形图)的某处,任务是走到最低的谷底。你能感知到的,只有脚下的坡度。
所以,梯度下降的通俗理解就是:
- 感知坡度:原地转一圈,感受脚下哪个方向向下最陡,这个方向就是梯度的反方向。
- 迈出一小步:朝着这个最陡的下坡方向,小心翼翼地迈出一小步。
- 重复:在新的位置,重新感知坡度,再迈一小步。如此循环,直到走到一个无论往哪走都只会上坡的谷底。
在线性回归 y = w * x + b
- 随机初始化 w,b。
- 用全部数据算出当前预测的平均误差(损失函数 J)。
- 关键的“感知坡度”步:用微积分,算出损失 J关于 w和 b的偏导数。∂J / ∂w 告诉你,如果稍微增大 w,损失 J是会增大还是会减小。
- 迈步:如果导数是正的(增大w,损失增大),那你应该减小 w。更新公式就是:
- 用更新后的 w,b 回到第2步,不断循环,直到损失几乎不再下降。

代码实现
import matplotlib.pyplot as plt

# prepare the training set
x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]

# initial guess of weight
w = 1.0

# define the model linear model y = w*x
def forward(x):
    return x*w

#define the cost function MSE
def cost(xs, ys):
    cost = 0
    for x, y in zip(xs,ys):
        y_pred = forward(x)
        cost += (y_pred - y)**2
    return cost / len(xs)

# define the gradient function  gd
def gradient(xs,ys):
    grad = 0
    for x, y in zip(xs,ys):
        grad += 2*x*(x*w - y)
    return grad / len(xs)

epoch_list = []
cost_list = []
print('predict (before training)', 4, forward(4))
for epoch in range(100):
    cost_val = cost(x_data, y_data)
    grad_val = gradient(x_data, y_data)
    w-= 0.01 * grad_val  # 0.01 learning rate
    print('epoch:', epoch, 'w=', w, 'loss=', cost_val)
    epoch_list.append(epoch)
    cost_list.append(cost_val)

print('predict (after training)', 4, forward(4))
plt.plot(epoch_list,cost_list)
plt.ylabel('cost')
plt.xlabel('epoch')
plt.show()

SGD随机梯度下降
引入
上面聊得梯度下降实现实际上是全批量梯度下降,他有一个致命的效率问题:
- 每次都需要将全部数据都算一遍,求出平均梯度然后才更新一次参数.
为了解决这个问题,SGD出场了。SGD说:何必等全部数据?我只看一个样本,就敢更新参数。
- 它的做法:
- 把数据随机打乱。
- 拿出一个样本,算它的梯度。
- 立马用这个梯度更新参数。
- 再拿下一个样本,重复。
只看一个样本的副作用是,这个样本很可能是个奇葩(噪声数据),它指的路是完全错误的。这导致SGD的更新方向极度不稳定,损失函数的下降曲线像醉汉走路,剧烈震荡。
代码实现
import matplotlib.pyplot as plt

x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]

w = 1.0

def forward(x):
    return x*w

# calculate loss function
def loss(x, y):
    y_pred = forward(x)
    return (y_pred - y)**2

# define the gradient function  sgd
def gradient(x, y):
    return 2*x*(x*w - y)

epoch_list = []
loss_list = []
print('predict (before training)', 4, forward(4))
for epoch in range(100):
    for x,y in zip(x_data, y_data):
        grad = gradient(x,y)
        w = w - 0.01*grad    # update weight by every grad of sample of training set
        print("\tgrad:", x, y,grad)
        l = loss(x,y)
    print("progress:",epoch,"w=",w,"loss=",l)
    epoch_list.append(epoch)
    loss_list.append(l)

print('predict (after training)', 4, forward(4))
plt.plot(epoch_list,loss_list)
plt.ylabel('loss')
plt.xlabel('epoch')
plt.show()
反向传播
引入
梯度下降通过“感知坡度”来更新参数,但它留下一个极其关键的问题没有解决:这个“坡度”(梯度)到底该怎么算?
比如,当我们计算到最后loss发现太高了,我们需要调整这个参数w,怎么调整呢?如果模型较小,直接求导一步步求出最后loss选择最小的loss模型还行.
但在深度神经网络中,参数多达数百万,每一个都直接影响着经过数十层变换后的最终输出。这时,就需要反向传播了。

操作
核心思想:从"问路"到"追责".
第一步:正着走一趟(前向传播)
数据 xx 从输入层开始,逐层计算,经过隐藏层,最后得到预测输出 ŷ。同时,必须把每一层的中间计算结果(z 值和 a 值)全部记下来,存好。
x→f(1)→a(1)→f(2)→a(2)→...→ŷ
第二步:倒着走一趟(反向传播梯度)
从输出层的误差 J开始,反着来,一层一层地往前“追责”:
- 先算最终层的责任:算出最终输出 ŷ 离真实值 y有多远。比如直接求 ∂J / ∂ŷ。
- 巧用链式法则,逐层往前传:这是关键。要算第 L−1 层某个参数 w 的梯度,不必重新算一遍,而是可以把刚才算出的后面的梯度“传回来”,再乘上这一层内部的局部梯度。
这就像接力赛:每一层并不需要知道全局的误差是怎么造成的,它只需要从后面接过一个“责任信号”,乘上自己这里“输入对输出的影响”,就能算出自己该负多少责任,然后再把这个信号继续往前传。
整个过程,就是在网络的“计算图”上,将误差从输出端高效地反向传播到输入端,一次性算出所有参数的梯度。 其计算量和一次前向传播相当,比暴力展开求解快了无数倍。
一个例子:
假设网络最后一层做的是:净输入 z → 预测值 ŷ → 损失值 J。
-
目的:想知道某个权重 w对 J的影响,即 ∂J / ∂w。
-
拆解:w直接影响 z,z影响 ŷ,ŷ最终影响 J。
-
链式法则:

- ∂J / ∂w:损失对预测的导数,表示“误差有多大”。
- ∂ŷ / ∂z:激活函数的导数,表示“输出对净输入的敏感性”。
- ∂z / ∂w:这一层权重对净输入的直接影响,恰恰就是它前面的输入 a。
你看,这三个项都是局部的。第一项是从后面传过来的“信号”,后两项都是这一层内部的属性。就这样,每一层都只负责自己这一段的乘法运算,就可以把误差信号层层递进地传到网络的最前端。


代码实现
import torch
x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]

w = torch.tensor([1.0]) # w的初值为1.0
w.requires_grad = True # 需要计算梯度

def forward(x):
    return x*w  # w是一个Tensor


def loss(x, y):
    y_pred = forward(x)
    return (y_pred - y)**2

print("predict (before training)", 4, forward(4).item())

for epoch in range(100):
    for x, y in zip(x_data, y_data):
        l =loss(x,y) # l是一个张量,tensor主要是在建立计算图 forward, compute the loss
        l.backward() #  backward,compute grad for Tensor whose requires_grad set to True
        print('\tgrad:', x, y, w.grad.item())
        w.data = w.data - 0.01 * w.grad.data   # 权重更新时,注意grad也是一个tensor

        w.grad.data.zero_() # after update, remember set the grad to zero

    print('progress:', epoch, l.item()) # 取出loss使用l.item,不要直接使用l(l是tensor会构建计算图)

print("predict (after training)", 4, forward(4).item())

线性回归 ( Linear Regression )
引入
生活中充满了“给一个数,预测另一个数”的场景:
- 已知房子的面积、地段、房龄,预测它的价格。
- 已知广告投入金额,预测下个月的销量。
- 已知一个学生的学习时间,预测他的考试分数。
这类问题有个共同点:我们要预测的目标(房价、销量、分数)是一个连续的数值。这就是回归问题,而线性回归是解决它的第一个武器。
我们准备数据使用pytorch的tensor存放数据.
分别是 x_data 和真实值 y_data.

我们先定义模型LinearModel,继承自 torch.nn.Module.这个基类有我们进行训练的操作和属性.然后初始化我们的函数,定义前向传播的函数 ( 基类函数,子类覆写 ) forward.

然后是定义我们的损失器和优化器.
损失器用于计算最后的损失 loss,优化器用于迭代更新参数.
这里我们用的是MSELoss,也就是均方误差,就是之前用的
不过pytorch提供了 size_average 选项,是否求均值,如果是 True,那么累加所有loss然后求平均,否则不求平均,只看累加和.
优化器我们使用的是随即梯度下降.

然后定义循环开始训练:

整体示意:

代码实现
import torch
# prepare dataset
# x,y是矩阵,3行1列 也就是说总共有3个数据,每个数据只有1个特征
x_data = torch.tensor([[1.0], [2.0], [3.0]])
y_data = torch.tensor([[2.0], [4.0], [6.0]])

#design model using class
"""
our model class should be inherit from nn.Module, which is base class for all neural network modules.
member methods __init__() and forward() have to be implemented
class nn.linear contain two member Tensors: weight and bias
class nn.Linear has implemented the magic method __call__(),which enable the instance of the class can
be called just like a function.Normally the forward() will be called
"""
class LinearModel(torch.nn.Module):
    def __init__(self):
        super(LinearModel, self).__init__()
        # (1,1)是指输入x和输出y的特征维度,这里数据集中的x和y的特征都是1维的
        # 该线性层需要学习的参数是w和b  获取w/b的方式分别是~linear.weight/linear.bias
        self.linear = torch.nn.Linear(1, 1)

    def forward(self, x):
        y_pred = self.linear(x)
        return y_pred

model = LinearModel()

# construct loss and optimizer
# criterion = torch.nn.MSELoss(size_average = False)
criterion = torch.nn.MSELoss(reduction = 'sum')
optimizer = torch.optim.SGD(model.parameters(), lr = 0.01) # model.parameters()自动完成参数的初始化操作,这个地方我可能理解错了

# training cycle forward, backward, update
for epoch in range(100):
    y_pred = model(x_data) # forward:predict
    loss = criterion(y_pred, y_data) # forward: loss
    print(epoch, loss.item())

    optimizer.zero_grad() # the grad computer by .backward() will be accumulated. so before backward, remember set the grad to zero
    loss.backward() # backward: autograd,自动计算梯度
    optimizer.step() # update 参数,即更新w和b的值

print('w = ', model.linear.weight.item())
print('b = ', model.linear.bias.item())

x_test = torch.tensor([[4.0]])
y_test = model(x_test)
print('y_pred = ', y_test.data)
可以看到,随着多次迭代训练,loss逐步降低,最终结果趋近于真实结果8.

逻辑回归 ( Logistic Regression )
引入
我们知道,线性模型是做预测的利器:
这个 z可以是任何实数,正无穷到负无穷。用在预测房价、温度这类连续值上,非常自然。
但现实中大量问题需要判断“是/否”:
- 这封邮件是垃圾邮件吗?
- 这张图里有猫吗?
- 用户会点击这个广告吗?
如果你硬拿线性回归去解,算出一个 z=42 或 z=−17,要怎么解释?难道说 “这张图是42%的猫” 吗?这说不通。而且,真实的标签 y 只有0或1,而模型预测的是一个毫无边界的实数,两者的尺度完全不匹配。
所以,我们的核心需求是:把一个任意实数 z,映射成 0 到 1 之间的一个数,用它来代表概率。
Sigmoid 函数:那座关键的桥
满足这个需求的函数,就是 Sigmoid 函数,记作 σ(z)σ(z):
它的形状像一个拉长的 S:
- 当 z 趋向正无穷(比如 z=10 ),σ(z) 无限趋近于 1。
- 当 z 趋向负无穷(比如 z=−10 ),σ(z) 无限趋近于 0。
- 当 z=0 时,σ(0)=0.5 。
就这么简单。不管你输入什么数,Sigmoid 都能温柔地把它压缩到 (0, 1) 区间。线性回归的输出 z,经过它的巧手一捏,就有了概率的意义。

所以,逻辑回归(Logistic Regression)虽然名字中含有“回归”,但实际上是一个分类算法,主要用于解决二分类问题。
代码实现
import torch
# import torch.nn.functional as F

# prepare dataset
x_data = torch.Tensor([[1.0], [2.0], [3.0]])
y_data = torch.Tensor([[0], [0], [1]])

#design model using class
class LogisticRegressionModel(torch.nn.Module):
    def __init__(self):
        super(LogisticRegressionModel, self).__init__()
        self.linear = torch.nn.Linear(1,1)

    def forward(self, x):
        # y_pred = F.sigmoid(self.linear(x))
        y_pred = torch.sigmoid(self.linear(x))
        return y_pred
model = LogisticRegressionModel()

# construct loss and optimizer
# 默认情况下,loss会基于element平均,如果size_average=False的话,loss会被累加。
criterion = torch.nn.BCELoss(size_average = False)
optimizer = torch.optim.SGD(model.parameters(), lr = 0.01)

# training cycle forward, backward, update
for epoch in range(1000):
    y_pred = model(x_data)
    loss = criterion(y_pred, y_data)
    print(epoch, loss.item())

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

print('w = ', model.linear.weight.item())
print('b = ', model.linear.bias.item())

x_test = torch.Tensor([[4.0]])
y_test = model(x_test)
print('y_pred = ', y_test.data)
多维度输入 ( Multiple Dimension Input )
引入
之前聊的线性回归,默认只有一个特征 xx。预测房价,只看面积;预测分数,只看学习时间。这显然不符合现实。
现实世界的问题几乎都是多因素决定的。一套房子的价格,同时受面积、房龄、地段、楼层、有没有电梯等无数因素影响。如果每个因素都单独建一个单维模型,那就等于把这些因素的相互作用完全忽略了。
模型的形式从 y=wx+by=w**x+b 自然地扩展为:
万物皆向量:统一视角
多维输入最优雅的地方,是引入了向量化的思维。我们把所有特征看成一个整体:
整个模型就可以极其简洁地写为:
也就是权重向量和输入向量的点积,再加一个偏置。
这个形式,就是我们后来所有深度学习的基础——把一个样本抽象成一个特征向量,模型做的事就是对这个向量进行一系列变换


我们在pytorch的 Linear 模型中,可以传入输入输出维度,比如我们这里传入 ( 8,2 )代表,输入是 8 个维度,输出 1 个维度 .
但是仅仅一个线性模型有时候可能过于简单,我们可以将多个模型串起来:

但是无论多少个线性模型串起来,最后都是会被化简,实际上还是一个线性模型:
y = w1*w2*x + b'
但是一定要记住,下一个模型的输入维度等于上一个模型的输出维度.
为了能够学习到复杂的信息,我们可以在每个线性层后再加一个激活函数,引入非线性特征,防止模型变得简化.
定义模型如下:

代码实现
import numpy as np
import torch
import matplotlib.pyplot as plt

# prepare dataset
xy = np.loadtxt('diabetes.csv', delimiter=',', dtype=np.float32)
x_data = torch.from_numpy(xy[:, :-1]) # 第一个‘:’是指读取所有行,第二个‘:’是指从第一列开始,最后一列不要
print("input data.shape", x_data.shape)
y_data = torch.from_numpy(xy[:, [-1]]) # [-1] 最后得到的是个矩阵

# print(x_data.shape)
# design model using class


class Model(torch.nn.Module):
    def __init__(self):
        super(Model, self).__init__()
        self.linear1 = torch.nn.Linear(8, 6)
        self.linear2 = torch.nn.Linear(6, 4)
        self.linear3 = torch.nn.Linear(4, 2)
        self.linear4 = torch.nn.Linear(2, 1)
        self.sigmoid = torch.nn.Sigmoid()

    def forward(self, x):
        x = self.sigmoid(self.linear1(x))
        x = self.sigmoid(self.linear2(x))
        x = self.sigmoid(self.linear3(x)) # y hat
        x = self.sigmoid(self.linear4(x))  # y hat
        return x


model = Model()

# construct loss and optimizer
# criterion = torch.nn.BCELoss(size_average = True)
criterion = torch.nn.BCELoss(reduction='mean')
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)


# training cycle forward, backward, update
for epoch in range(1000000):
    y_pred = model(x_data)
    loss = criterion(y_pred, y_data)
    # print(epoch, loss.item())

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    if epoch%100000 == 99999:
        y_pred_label = torch.where(y_pred>=0.5,torch.tensor([1.0]),torch.tensor([0.0]))

        acc = torch.eq(y_pred_label, y_data).sum().item()/y_data.size(0)
        print("loss = ",loss.item(), "acc = ",acc)
Dataset And Dataloader
引入
当你已经有了模型架构(比如线性回归、逻辑回归),接下来就要解决一个实际问题:数据怎么高效地喂给模型?
训练深度学习模型时,数据量可能大到内存装不下(比如百万张图片)。同时,我们之前聊过,训练用的是小批量随机梯度下降,每次只取一小批(batch)数据。
这就带来几个需求:
- 统一管理:原始数据散落在文件夹里,需要一种统一的接口去访问。
- 按需加载:不用一次全读进内存,用到哪批再读哪批。
- 自动分批:能方便地把数据切成一个个 mini-batch。
- 随机打乱:每个 epoch 开始时能自动洗牌,这是 SGD 收敛好的关键。
手动写这些代码重复又枯燥,于是 PyTorch 等框架提供了标准化的工具。
Dataset 是一个抽象类,你只需要继承它,并实现两个核心方法:
__len__(self):返回数据集总共有多少条样本。这样框架就知道什么时候算“一个 epoch 跑完”。__getitem__(self, idx):给定一个索引idx,返回这一条样本的数据和标签。可以是图片、文本、向量,以及对应的真实值。
DataLoader 把 Dataset 包起来,提供批量化的数据流服务。你只需要告诉它:
dataset:用哪个数据集。batch_size:每批多少条(比如32)。shuffle:是否每个 epoch 打乱顺序。num_workers:开几个子进程并行加载数据。

pytorch还提供了常用的经典数据集,我们可以设置 download=True,root为数据集存放目录,就可以自动下载数据集使用.

代码实现
import torch
import numpy as np
from torch.utils.data import Dataset
from torch.utils.data import DataLoader
from sklearn.model_selection import train_test_split


# 读取原始数据,并划分训练集和测试集
raw_data = np.loadtxt('diabetes.csv', delimiter=',', dtype=np.float32)
X = raw_data[:, :-1]
y = raw_data[:, [-1]]
Xtrain, Xtest, Ytrain, Ytest = train_test_split(X,y,test_size=0.3)
Xtest = torch.from_numpy(Xtest)
Ytest = torch.from_numpy(Ytest)

# 将训练数据集进行批量处理
# prepare dataset

class DiabetesDataset(Dataset):
    def __init__(self, data,label):

        self.len = data.shape[0] # shape(多少行,多少列)
        self.x_data = torch.from_numpy(data)
        self.y_data = torch.from_numpy(label)

    def __getitem__(self, index):
        return self.x_data[index], self.y_data[index]

    def __len__(self):
        return self.len


train_dataset = DiabetesDataset(Xtrain,Ytrain)
train_loader = DataLoader(dataset=train_dataset, batch_size=32, shuffle=True, num_workers=0) #num_workers 多线程

# design model using class


class Model(torch.nn.Module):
    def __init__(self):
        super(Model, self).__init__()
        self.linear1 = torch.nn.Linear(8, 6)
        self.linear2 = torch.nn.Linear(6, 4)
        self.linear3 = torch.nn.Linear(4, 2)
        self.linear4 = torch.nn.Linear(2, 1)
        self.sigmoid = torch.nn.Sigmoid()

    def forward(self, x):
        x = self.sigmoid(self.linear1(x))
        x = self.sigmoid(self.linear2(x))
        x = self.sigmoid(self.linear3(x))
        x = self.sigmoid(self.linear4(x))
        return x


model = Model()

# construct loss and optimizer
criterion = torch.nn.BCELoss(reduction='mean')
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)


# training cycle forward, backward, update

def train(epoch):
    train_loss = 0.0
    count = 0
    for i, data in enumerate(train_loader, 0):
        inputs, labels = data
        y_pred = model(inputs)

        loss = criterion(y_pred, labels)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        train_loss += loss.item()
        count = i

    if epoch%2000 == 1999:
        print("train loss:", train_loss/count,end=',')


def test():
    with torch.no_grad():
        y_pred = model(Xtest)
        y_pred_label = torch.where(y_pred>=0.5,torch.tensor([1.0]),torch.tensor([0.0]))
        acc = torch.eq(y_pred_label, Ytest).sum().item() / Ytest.size(0)
        print("test acc:", acc)

if __name__ == '__main__':
    for epoch in range(50000):
        train(epoch)
        if epoch%2000==1999:
            test()
Softmax Classifier
引入
我们从逻辑回归自然往前走一步。逻辑回归虽好,但有个硬伤:它只能处理二分类(是猫/不是猫)。现实中我们经常要回答“这是猫、狗还是鸟?”这种多选一的问题。
这就是 Softmax 分类器的舞台。
回忆一下,逻辑回归的流程是:
- 算一个得分 z=wx+b
- 用 Sigmoid 把得分压成 0 到 1 的概率:P(是猫)=σ(z)
但如果有 10 个类别(比如手写数字 0-9),该怎么做?

一个朴素的想法是训练 10 个逻辑回归模型,每个模型只回答一个“是/不是”的问题。这有两个问题:一是训练和维护 10 个模型很麻烦;二是 10 个模型彼此独立,给出的 10 个概率加起来不一定等于 1。这会让人觉得,一张图有 80% 概率是 3,又有 70% 概率是 8,这在逻辑上是说不通的。
我们需要一种方法,一次算出所有类别的得分,然后把这些得分统一转换成一组合法的概率:每个概率都在 0 到 1 之间,并且全部加起来恰好等于 1。

分子:对当前类别的得分取指数 eziezi,这能保证结果一定是正数,并且放大高分与低分之间的差距。
分母:把所有类别的 ezjezj 全部加起来,作为统一的尺度。
这样就确保了:
- 每个值都在 (0, 1) 之间(因为正数除以一个比它更大的正数)。
- 所有值加起来等于 1(因为每个分子都除以了同一个总和)。
把逻辑回归和 Softmax 放在一起看,关系就很清楚:
- Sigmoid:单输入,单输出.
- Softmax:多输入,多输出。可以把 Softmax 看作是 Sigmoid 在多类别上的推广.


pytorch的CrossEntropyLoss()交叉熵损失内部就帮我们实现了Softmax.
我们这里实现使用上一节 MINIST 图片数据集,构建全连接神经网络,对图片进行数字预测.
代码实现
import torch
from torchvision import transforms
from torchvision import datasets
from torch.utils.data import DataLoader
import torch.nn.functional as F
import torch.optim as optim

# prepare dataset

batch_size = 64
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))]) # 归一化,均值和方差

train_dataset = datasets.MNIST(root='../dataset/mnist/', train=True, download=True, transform=transform)
train_loader = DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
test_dataset = datasets.MNIST(root='../dataset/mnist/', train=False, download=True, transform=transform)
test_loader = DataLoader(test_dataset, shuffle=False, batch_size=batch_size)

# design model using class


class Net(torch.nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.l1 = torch.nn.Linear(784, 512)
        self.l2 = torch.nn.Linear(512, 256)
        self.l3 = torch.nn.Linear(256, 128)
        self.l4 = torch.nn.Linear(128, 64)
        self.l5 = torch.nn.Linear(64, 10)

    def forward(self, x):
        x = x.view(-1, 784)  # -1其实就是自动获取mini_batch
        x = F.relu(self.l1(x))
        x = F.relu(self.l2(x))
        x = F.relu(self.l3(x))
        x = F.relu(self.l4(x))
        return self.l5(x)  # 最后一层不做激活,不进行非线性变换


model = Net()

# construct loss and optimizer
criterion = torch.nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.5)

# training cycle forward, backward, update


def train(epoch):
    running_loss = 0.0
    for batch_idx, data in enumerate(train_loader, 0):
        # 获得一个批次的数据和标签
        inputs, target = data
        optimizer.zero_grad()
        # 获得模型预测结果(64, 10)
        outputs = model(inputs)
        # 交叉熵代价函数outputs(64,10),target(64)
        loss = criterion(outputs, target)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        if batch_idx % 300 == 299:
            print('[%d, %5d] loss: %.3f' % (epoch+1, batch_idx+1, running_loss/300))
            running_loss = 0.0


def test():
    correct = 0
    total = 0
    with torch.no_grad():
        for data in test_loader:
            images, labels = data
            outputs = model(images)
            _, predicted = torch.max(outputs.data, dim=1) # dim = 1 列是第0个维度,行是第1个维度
            total += labels.size(0)
            correct += (predicted == labels).sum().item() # 张量之间的比较运算
    print('accuracy on test set: %d %% ' % (100*correct/total))


if __name__ == '__main__':
    for epoch in range(10):
        train(epoch)
        test()

CNN 卷积神经网络
引入
概念
回顾我们上一节使用了全连接的神经网络.
默认每个特征都有明确的含义,比如房价的“面积”、“房龄”。但图像是一整块像素矩阵。
如果硬把一张 224x224x3 的图片喂给全连接层:
- 参数爆炸:第一层一个神经元就有 224×224×3 = 15万个权重。要是这一层有1000个神经元,那就是1.5亿个参数,直接爆显存。
- 丢失空间结构:图片被强行拉直成一个长向量,相邻像素之间的上下左右关系,一瞬间全没了。模型根本不知道“猫耳朵是在猫脸上面的”,对它来说所有像素都是平等的一维数据。
- 位置死板:一只猫从图片左边移到右边,对全连接层来说是完全不同的两组输入。它学不会“耳朵就该在脸上面”这种位置不变的知识。
简单说,全连接层天生就不擅长理解“空间”。


卷积的核心思想:滑动窗口
卷积运算为解决这个问题而生。它的设计灵感直接模仿了动物的视觉皮层——不是把整个画面尽收眼底,而是用一个小窗口,从左到右、从上到下滑动,每次只看窗口里的那一小块。
这个小窗口叫卷积核或滤波器。它是一个小矩阵,比如 3x3 或 5x5。窗口滑过图像的每一个位置,和那一小块像素做点积运算,输出的结果就构成了特征图上的一个点。
这个简单的滑动操作,本质上是在图像上扫描一个特定的模式:
- 一个卷积核专门检测垂直边缘:扫到猫耳朵的竖线时,数值会飙高;扫到天空的平坦区域时,数值接近零。
- 另一个卷积核专门检测某种颜色纹理:扫到猫毛时激活,扫到光滑桌面时沉默。
一张图输入,经过一个卷积核,就输出一张“该模式在哪里出现”的特征图。用多个卷积核,就能同时检测边缘、颜色、纹理等多个模式。


....一直滑到最后一个

当前演示的是只有一个通道的时候的效果.
下面是当有三个通道,比如RGB三个颜色通道,每个通道都要和卷积核进行操作,得到最后的结果在进行相加


可以看到,通过卷积操作之后,3个维度的通道的结果被"压缩"到了1个维度,实现了降维.
两大特性
卷积操作带来了两个极其优雅的特性:
1. 局部连接
每个神经元只和输入的一个小窗口相连,而不是整张图。一个 3x3 的卷积核只有 9 个参数。假设我们用了 64 个卷积核,第一层总参数才 3×3×3×64 = 1728 个。对比之前全连接层的 1.5 亿,小了近十万倍。
2. 权重共享
一个卷积核在图像的左上角、右下角、所有位置都共用同一套权重。这带来了一个深刻的好处:如果一个卷积核学会了在左上角识别“猫耳朵”,那它在右下角发现同样的耳朵形状时,一样能认出来。模型天然就具备了平移不变性——无论猫在图片的哪里,都能认出这是猫。
padding
有个问题,当我们使用3x3的卷积核进行卷积之后,结果的宽高就会降低2.比如5x5的图片,在3x3的卷积核卷积操作之后,变成了3x3的结果.
有时候我们想要保持输出的尺寸和原尺寸一直,就可以采用padding填充.
比如5x5的图片进行padding=1的填充之后,变成了7x7,再经过卷积操作之后还是5x5:

stride步长
默认我们的卷积核滑动的时候,按照步长为1滑动.我们也可以按照制定指定步长滑动.


有一个公式可以直接求出经过不同的padding和stride卷积之后的尺寸.
其中 W是Input的边长,K是卷积核的边长


代码实现
import torch
from torchvision import transforms
from torchvision import datasets
from torch.utils.data import DataLoader
import torch.nn.functional as F
import torch.optim as optim
import matplotlib.pyplot as plt

# prepare dataset

batch_size = 64
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))])

train_dataset = datasets.MNIST(root='../dataset/mnist/', train=True, download=True, transform=transform)
train_loader = DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
test_dataset = datasets.MNIST(root='../dataset/mnist/', train=False, download=True, transform=transform)
test_loader = DataLoader(test_dataset, shuffle=False, batch_size=batch_size)

# design model using class


class Net(torch.nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = torch.nn.Conv2d(1, 10, kernel_size=5)
        self.conv2 = torch.nn.Conv2d(10, 20, kernel_size=5)
        self.pooling = torch.nn.MaxPool2d(2)
        self.fc = torch.nn.Linear(320, 10)


    def forward(self, x):
        # flatten data from (n,1,28,28) to (n, 784)

        batch_size = x.size(0)
        x = F.relu(self.pooling(self.conv1(x)))
        x = F.relu(self.pooling(self.conv2(x)))
        x = x.view(batch_size, -1) # -1 此处自动算出的是320
        # print("x.shape",x.shape)
        x = self.fc(x)

        return x


model = Net()
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)

# construct loss and optimizer
criterion = torch.nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.5)

# training cycle forward, backward, update


def train(epoch):
    running_loss = 0.0
    for batch_idx, data in enumerate(train_loader, 0):
        inputs, target = data
        inputs, target = inputs.to(device), target.to(device)
        optimizer.zero_grad()

        outputs = model(inputs)
        loss = criterion(outputs, target)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        if batch_idx % 300 == 299:
            print('[%d, %5d] loss: %.3f' % (epoch+1, batch_idx+1, running_loss/300))
            running_loss = 0.0


def test():
    correct = 0
    total = 0
    with torch.no_grad():
        for data in test_loader:
            images, labels = data
            images, labels = images.to(device), labels.to(device)
            outputs = model(images)
            _, predicted = torch.max(outputs.data, dim=1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    print('accuracy on test set: %d %% ' % (100*correct/total))
    return correct/total


if __name__ == '__main__':
    epoch_list = []
    acc_list = []

    for epoch in range(10):
        train(epoch)
        acc = test()
        epoch_list.append(epoch)
        acc_list.append(acc)

    plt.plot(epoch_list,acc_list)
    plt.ylabel('accuracy')
    plt.xlabel('epoch')
    plt.show()

Advanced CNN
引入
GoogLeNet
GoogLeNet,它是在 CNN 基础上一次非常重要的进化,核心贡献是一个精巧的结构——Inception。
在 GoogLeNet 出现之前,大家提升网络性能的方式很粗暴:拼命堆叠更多的卷积层(比如 VGG 网络)。这条路很快就撞上了三堵墙:
- 参数爆炸:层越深,参数越多,计算量扛不住。
- 梯度消失:太深的网络让反向传播的信号越来越弱,根本训不动。
- 单一感受野:每层只能固定用一种尺寸的卷积核(比如全是 3x3)。但现实中的物体尺度差异极大,一张图里,猫可能占据整个画面,也可能只是角落里的一个小点。你根本不知道该用多大的卷积核去捕捉它最合适。
GoogLeNet 的核心思想就是:既然不知道哪个尺寸最好,那就在同一层里,把多个尺寸的卷积核全用上,让网络自己学着选。

Inception
这就是 Inception 模块的设计,它在一个层里并行地放了四条路径,每条路径用不同的方式看输入:
- 路径1:1x1 卷积。看最细粒度的局部信息。
- 路径2:3x3 卷积。看中等范围的特征。
- 路径3:5x5 卷积。看更大范围的特征。
- 路径4:3x3 最大池化。不学新参数,纯粹提取最显著的信息。
最后,把这四条路径的输出在通道维度上拼接起来,融合成一张巨大的、多尺度的特征图。
这就像在同一层里,同时用放大镜、标准镜和广角镜去看图像,然后综合所有视角的信息。物体无论大小,总有一个分支能抓到它。

1x1卷积核
这里有个1x1卷积操作,那么1x1卷积有什么用呢?
一个 1×11×1 的卷积核(也称为 Network in Network 或 Pointwise Convolution)在卷积神经网络中非常基础且极其重要。它虽然“看”不到空间上的关联(因为它只覆盖一个像素点),但它能够非常高效地在通道维度(深度)上进行操作。
它的主要作用有以下四个核心点:
-
- 改变通道数
我们知道,输出的通道数和卷积核的个数是相关的,每次卷机操作使用了多少卷积核,就会输出多少通道.
比如比如输入是 28×28×19228×28×192(192个通道),使用 32 个 1×11×1 卷积核,输出就变成了 28×28×3228×28×32。这在像 GoogleNet (Inception) 或 ResNet 中用于减少计算量。
也可以反向操作,把浅层特征映射到高维空间,例如将 64 通道变为 256 通道,常用于网络深层捕捉更丰富的特征。
-
- 实现跨通道信息交互
1×1 卷积不查看像素周围的邻居(不像 3×33×3 或 5×55×5 看周围一圈),它只看当前位置在深度方向(所有通道)上的所有值。
它像是在对每个像素点(每个空间位置)的所有通道信息进行全连接层的操作,实现了不同通道之间的信息融合和组合。例如:将“红色通道”和“边缘通道”的特征融合。
-
- 引入非线性
在进行 1×11×1 卷积之后,通常会紧跟着一个激活函数(如 ReLU)。
一个普通的 3×33×3 卷积层后加 ReLU,虽然也有了非线性,但 1×11×1 允许你在不改变空间分辨率(图片大小不变)的情况下,增加更多的非线性层,提升网络对复杂函数的拟合能力。
-
- 显著降低计算量(瓶颈结构 Bottleneck)
举个例子:
假设输入是 256256 通道,目标是进行一组 3×33×3 卷积输出 256256 通道。-
直接做 3×33×3 卷积:
计算量 = H×W×(3×3×256)×256H×W×(3×3×256)×256 (约 589,824×H×W589,824×H×W) -
使用 1×11×1 降维后再做 3×33×3(瓶颈设计):
- 先用 1×1 降到 64 通道:
H x W x ( 1 x 1 x 256 ) x 64 - 再用 3×3 处理这 64 通道:
H x W x ( 3 x 3 x 64) x 64 - 最后用 1×1 恢复回 256 通道:
H x W x ( 1 x 1 x 64 ) x 256
对比结果:
- 直接做:约 589k 次乘加运算
- 瓶颈设计:约 69k 次乘加运算
运算量下降了 8.5 倍,而网络效果几乎不受影响!

ResidualNet (残差块)
Inception 模块用“多路并行”让网络变宽,但它并没有解决一个更深层的矛盾——网络堆得太深之后,反而训不动了,效果还变差。
按直觉,网络越深,能力越强。但实验却打了脸:一个 56 层的网络,在训练集和测试集上的表现,都比 20 层的版本更差。
注意,这不是过拟合(过拟合是训练集上表现好,测试集差)。这是连训练集都搞不定,说明深网络根本就没学好。
理论上,56 层网络应该至少不比 20 层差——因为你可以让多出来的 36 层什么都不做,直接原样复制第 20 层的结果就行。但现实是,堆叠的非线性层太多,让“原样传递”这个简单任务变得极其困难。反向传播时,梯度经过层层衰减,传到前面几层时已经接近于零,权重根本无法有效更新。
所以,问题的症结在于:网络太深,导致“学出恒等映射”这件事本身变得很难。
Residual Block 是 ResNet(残差网络) 的核心组件,由何恺明等人在2015年提出,主要用于解决深层神经网络中的梯度消失和退化问题。
ResNet 的解决方案极其简单而深刻:既然网络自己学不会“原样传递”,那我就强制给它一条近路。
# 传统网络
output = F(x)  # 直接学习目标映射

# 残差网络
output = F(x) + x  # 学习残差 + 恒等映射(跳跃连接)


它最宝贵的遗产在于证明:深度不再是瓶颈。 在这之前,网络深度卡在 20 层左右;有了残差连接后,100 层、200 层甚至 1000 层的网络都可以稳定训练。
更深层的影响是这种“抄近路”的思想,它已经超越了卷积网络本身。后来的 Transformer 架构,也到处是残差连接的身影。它成了一个通用的设计原则:当你想堆很深的网络时,一定要给信号和梯度留一条畅通无阻的高速路。
代码实现
- Inception
import torch
import torch.nn as nn
from torchvision import transforms
from torchvision import datasets
from torch.utils.data import DataLoader
import torch.nn.functional as F
import torch.optim as optim

# prepare dataset

batch_size = 64
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))]) # 归一化,均值和方差

train_dataset = datasets.MNIST(root='../dataset/mnist/', train=True, download=True, transform=transform)
train_loader = DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
test_dataset = datasets.MNIST(root='../dataset/mnist/', train=False, download=True, transform=transform)
test_loader = DataLoader(test_dataset, shuffle=False, batch_size=batch_size)

# design model using class
class InceptionA(nn.Module):
    def __init__(self, in_channels):
        super(InceptionA, self).__init__()
        self.branch1x1 = nn.Conv2d(in_channels, 16, kernel_size=1)

        self.branch5x5_1 = nn.Conv2d(in_channels, 16, kernel_size=1)
        self.branch5x5_2 = nn.Conv2d(16, 24, kernel_size=5, padding=2)

        self.branch3x3_1 = nn.Conv2d(in_channels, 16, kernel_size=1)
        self.branch3x3_2 = nn.Conv2d(16, 24, kernel_size=3, padding=1)
        self.branch3x3_3 = nn.Conv2d(24, 24, kernel_size=3, padding=1)

        self.branch_pool = nn.Conv2d(in_channels, 24, kernel_size=1)

    def forward(self, x):
        branch1x1 = self.branch1x1(x)

        branch5x5 = self.branch5x5_1(x)
        branch5x5 = self.branch5x5_2(branch5x5)

        branch3x3 = self.branch3x3_1(x)
        branch3x3 = self.branch3x3_2(branch3x3)
        branch3x3 = self.branch3x3_3(branch3x3)

        branch_pool = F.avg_pool2d(x, kernel_size=3, stride=1, padding=1)
        branch_pool = self.branch_pool(branch_pool)

        outputs = [branch1x1, branch5x5, branch3x3, branch_pool]
        return torch.cat(outputs, dim=1) # b,c,w,h  c对应的是dim=1

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(1, 10, kernel_size=5)
        self.conv2 = nn.Conv2d(88, 20, kernel_size=5) # 88 = 24x3 + 16

        self.incep1 = InceptionA(in_channels=10) # 与conv1 中的10对应
        self.incep2 = InceptionA(in_channels=20) # 与conv2 中的20对应

        self.mp = nn.MaxPool2d(2)
        self.fc = nn.Linear(1408, 10)


    def forward(self, x):
        in_size = x.size(0)
        x = F.relu(self.mp(self.conv1(x)))
        x = self.incep1(x)
        x = F.relu(self.mp(self.conv2(x)))
        x = self.incep2(x)
        x = x.view(in_size, -1)
        x = self.fc(x)

        return x

model = Net()

# construct loss and optimizer
criterion = torch.nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.5)

# training cycle forward, backward, update


def train(epoch):
    running_loss = 0.0
    for batch_idx, data in enumerate(train_loader, 0):
        inputs, target = data
        optimizer.zero_grad()

        outputs = model(inputs)
        loss = criterion(outputs, target)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        if batch_idx % 300 == 299:
            print('[%d, %5d] loss: %.3f' % (epoch+1, batch_idx+1, running_loss/300))
            running_loss = 0.0


def test():
    correct = 0
    total = 0
    with torch.no_grad():
        for data in test_loader:
            images, labels = data
            outputs = model(images)
            _, predicted = torch.max(outputs.data, dim=1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    print('accuracy on test set: %d %% ' % (100*correct/total))


if __name__ == '__main__':
    for epoch in range(10):
        train(epoch)
        test()

- Residual Net(残差块)
import torch
import torch.nn as nn
from torchvision import transforms
from torchvision import datasets
from torch.utils.data import DataLoader
import torch.nn.functional as F
import torch.optim as optim

# prepare dataset

batch_size = 64
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))]) # 归一化,均值和方差

train_dataset = datasets.MNIST(root='../dataset/mnist/', train=True, download=True, transform=transform)
train_loader = DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
test_dataset = datasets.MNIST(root='../dataset/mnist/', train=False, download=True, transform=transform)
test_loader = DataLoader(test_dataset, shuffle=False, batch_size=batch_size)

# design model using class
class ResidualBlock(nn.Module):
    def __init__(self, channels):
        super(ResidualBlock, self).__init__()
        self.channels = channels
        self.conv1 = nn.Conv2d(channels, channels, kernel_size=3, padding=1)
        self.conv2 = nn.Conv2d(channels, channels, kernel_size=3, padding=1)

    def forward(self, x):
        y = F.relu(self.conv1(x))
        y = self.conv2(y)
        return F.relu(x + y)

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(1, 16, kernel_size=5)
        self.conv2 = nn.Conv2d(16, 32, kernel_size=5) # 88 = 24x3 + 16

        self.rblock1 = ResidualBlock(16)
        self.rblock2 = ResidualBlock(32)

        self.mp = nn.MaxPool2d(2)
        self.fc = nn.Linear(512, 10) # 暂时不知道1408咋能自动出来的


    def forward(self, x):
        in_size = x.size(0)

        x = self.mp(F.relu(self.conv1(x)))
        x = self.rblock1(x)
        x = self.mp(F.relu(self.conv2(x)))
        x = self.rblock2(x)

        x = x.view(in_size, -1)
        x = self.fc(x)
        return x

model = Net()

# construct loss and optimizer
criterion = torch.nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.5)

# training cycle forward, backward, update


def train(epoch):
    running_loss = 0.0
    for batch_idx, data in enumerate(train_loader, 0):
        inputs, target = data
        optimizer.zero_grad()

        outputs = model(inputs)
        loss = criterion(outputs, target)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        if batch_idx % 300 == 299:
            print('[%d, %5d] loss: %.3f' % (epoch+1, batch_idx+1, running_loss/300))
            running_loss = 0.0


def test():
    correct = 0
    total = 0
    with torch.no_grad():
        for data in test_loader:
            images, labels = data
            outputs = model(images)
            _, predicted = torch.max(outputs.data, dim=1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    print('accuracy on test set: %d %% ' % (100*correct/total))


if __name__ == '__main__':
    for epoch in range(10):
        train(epoch)
        test()

RNN ( 循环神经网络 )
引入
序列数据
从线性模型到CNN,都有一个默认的假设:输入和输入之间是独立的。前一秒的输入和后一秒的输入,模型认为它们毫无关系。
但现实中大量问题并非如此。一句话里的词是前后关联的,股票价格是随时间演变的,视频里每一帧都依赖前一帧。要处理这种序列数据,就需要循环神经网络出场。
序列数据有两个特点,前馈网络完全没法处理:
- 长度不固定:一个句子可以是3个词,也可以是30个词。CNN接受的输入尺寸是固定的。
- 位置间有依赖:“我把苹果吃了”和“我把苹果扔了”,同一个“苹果”,但整个句子靠最后一个词决定它是食物还是垃圾。模型必须能“记住”前面出现过什么。
所以需要一种网络,它能维护一个贯穿始终的“记忆状态”,随着序列推进不断更新这个记忆,并用它来做预测。
RNN核心思想
RNN的做法出奇地简单。它只有一个计算单元,然后把这个单元在时间上展开。
在每一个时刻 t:
-
接收当前输入 xt ,比如当前这个词的向量。
-
也接收上一个时刻传下来的隐藏状态 ht−1 ,这里面装着之前所有输入的“记忆”。
-
把这两者拼起来,经过一个线性变换和非线性激活,得到当前时刻的隐藏状态 ht :

-
ht 既传给下一层做预测,也传给下一个时刻的自己。
参数共享是RNN的精髓。这套权重 Wxh,Whh,bWxh,W**hh,b 在每个时间步都完全一样。这意味着无论序列有多长,模型用同一套逻辑去处理。它在第5个词学会的语法规则,同样适用于第50个词。参数量不随序列长度增长。
根据输入和输出的序列长度,RNN有四种常见形态,对应不同任务:
- 多对一:输入一个序列,输出单个结果。比如情感分析,读完整句话,输出“正面/负面”。
- 一对多:输入单个起点,输出一个序列。比如看图说话,给一张图片特征,生成描述文字。
- 多对多(同步):输入和输出等长。比如给句子每个词标注词性,或者视频每一帧分类。
- 多对多(异步):也就是Seq2Seq。先用一个编码器把整个输入序列压缩成一个上下文向量,另一个解码器再把它展开成输出序列。机器翻译、摘要生成就属于这类。


Embedding嵌入层
我们一路从 CNN、RNN 聊过来,那些网络处理的是已经向量化的数据。但文字、单词、类别这些离散的符号,是怎么变成向量的?这就是 Embedding 要解决的问题。
最直接的想法,是把每个词变成一个独热向量。比如词典里有10万个词,“猫”是第1个词,它的向量就是 [1, 0, 0, ..., 0](1后面跟99999个0)。
这个方案有三个致命问题:
- 维度灾难:词典多大,向量就多长。10万词的词典,每个词都是10万维的稀疏向量。
- 语义为零:任何两个不同的词,向量之间的余弦相似度永远是0。“猫”和“小猫”,在这个空间里和“猫”与“哈士奇”一样远,完全没有近义概念。
- 无法计算:这种超高维稀疏向量喂给网络,参数会直接爆炸,什么都学不出来。
Embedding 的做法很简单:不要用词典大小来定义向量维度,而是人为规定一个较小的、稠密的维度 d(比如128、256或768维)。然后,让模型自己去学习每个词在这个d维空间里应该落在哪个位置。
它本质上就是一个查表操作。假设词典大小是 V,Embedding 维度是 d,模型就维护一张 V × d 的大表。这张表的每一行,就是一个词的向量表示。输入一个词的索引,输出它对应的那一行稠密向量。
一开始,表里的数值是随机初始化的。这些随机向量没有任何意义。但随着模型在任务上训练,反向传播会把梯度传回 Embedding 层,更新这张表。慢慢地,语义相近的词,它们的向量就会被拉到一起;语义无关的词,就会被推开。训练结束时,这张表就成了一个有组织的语义空间。
一句话总结:Embedding 的本质,就是把高维稀疏的离散符号,映射到低维稠密的连续向量空间,并在这个空间里让语义关系体现为几何距离。它是所有处理离散符号的神经网络的第一层,也是深度学习理解人类世界的入口。


pytorch实现
pytorch提供了两种方式.
第一种:提供了RNNCell,需要我们自定义模型,手动控制使用RNNCell,手写循环也
第二种:提供了RNN模型,避免了手写循环,方便使用.
示例:
- RNNCell

- RNN

代码实现
- RNN
import torch

input_size = 4
hidden_size = 4
batch_size = 1
num_layers = 2
seq_len = 5
embedding_size = 10
num_class = 4
idx2char = ["e", "h", "l", "o"]
x_data = [[1, 0, 2, 2, 3]]  # (batch,seq_len)
y_data = [3, 1, 2, 3, 2]  # (batch * seq_len)

one_hot_loopup = [
    [1, 0, 0, 0],
    [0, 1, 0, 0],
    [0, 0, 1, 0],
    [0, 0, 0, 1],
]

inputs = torch.LongTensor(x_data)
labels = torch.LongTensor(y_data)


class Model(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.emb = torch.nn.Embedding(input_size, embedding_size)
        self.rnn = torch.nn.RNN(
            embedding_size, hidden_size, num_layers, batch_first=True
        )
        self.fc = torch.nn.Linear(hidden_size, num_class)

    def forward(self, x):
        hidden = torch.zeros(num_layers, x.size(0), hidden_size)
        x = self.emb(x)
        x, _ = self.rnn(x, hidden)
        x = self.fc(x)
        return x.view(-1, num_class)


net = Model()
criterion = torch.nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(net.parameters(), lr=0.05)

times = 15
for epoch in range(times):
    optimizer.zero_grad()
    outputs = net(inputs)
    loss = criterion(outputs, labels)
    loss.backward()
    optimizer.step()

    _, idx = outputs.max(dim=1)
    idx = idx.data.numpy()
    print("Predicted:", "".join([idx2char[x] for x in idx]), end="")
    print(",Epoch [%d]/%d,loss=%.4f" % (epoch + 1, times, loss.item()))

Advanced RNN
引入
RNN Classifier
之前分别了解了 RNN 和 Softmax 分类器,RNN Classifier 就是把它们俩拼在一起,用来解决序列分类问题的模型。
有些任务,输入是一个序列,但输出只需要一个结论。
- 情感分析:输入一句评论“这部电影简直浪费时间”,输出“负面”。
- 文本分类:输入一条新闻标题,输出它属于“体育”、“科技”还是“娱乐”。
- 序列异常检测:输入一段传感器读数序列,输出“正常”还是“故障”。
核心特点是:输入长度可变,但输出是固定的某一个类别。 这就是 RNN Classifier 的用武之地。
核心
部件1:RNN 编码器
输入是一个词索引序列 [x1,x2,...,xT][x1,x2,...,x**T],经过 Embedding 层转成向量序列,然后被 RNN 逐时间步处理。
关键点在于:序列分类不关心每个时刻的输出,只关心读完整个序列之后,最后的那个隐藏状态 hT*h**T*。这个 hTh**T 理论上凝结了整句话从第一个词到最后一个词的全部语义,相当于把变长的句子压缩成了一个固定大小的向量。这个向量就是整句话的“语义表示”。
部件2:分类器头
把 RNN 最后时刻的隐藏状态 hTh**T,送进一个线性层 + Softmax:
- hTh**T 的形状是
[batch, hidden_size] - 线性层把它映射到
[batch, num_classes] - Softmax 转成每个类别的概率
- 取最大概率的类别作为最终预测
示例:
以一个情感二分类任务为例,输入句子“我 很 喜欢”:
- Embedding:
我、很、喜欢分别查表,得到三个稠密向量。 - RNN 逐步处理:
- t=1t=1:输入“我”的向量,初始隐藏状态 h0h0(全零向量),RNN 输出 h1h1。
- t=2t=2:输入“很”的向量,和 h1h1,RNN 输出 h2h2。
- t=3t=3:输入“喜欢”的向量,和 h2h2,RNN 输出 h3h3。这是最后一个隐藏状态。
- 分类头:h3h3 送入线性层,输出两个得分(正面/负面),Softmax 转成概率,比如
[正面: 0.92, 负面: 0.08]。
怎么训练?
和之前所有分类器一样,用的是交叉熵损失。
- 模型预测:
[正面: 0.92, 负面: 0.08] - 真实标签:
正面→ one-hot 向量[1, 0] - 交叉熵计算两个分布之间的差距
- 反向传播把梯度从分类头一路传回 RNN 的每一个时间步,更新 Embedding 表、RNN 的权重矩阵、以及分类头的权重
Bi-direction
RNN Classifier,有一个容易被忽略但很致命的盲点:它的隐藏状态 ht ,只看到了“过去”,完全不知道“未来”会发生什么。
在处理“这个苹果很新鲜,我把它吃了”和“这个芯片很先进,我把它吃了”这两个句子时,单向 RNN 读到“我把它”的时候,对“苹果”和“芯片”的理解还是一样的。只有读完最后一个词“吃”,它才知道前面那个东西是食物。但此时,关于“苹果”和“芯片”的早期信息,在单向 RNN 里已经被压缩和稀释了几十步,没那么清晰了。
只看上文,不看下文,理解是片面的。 这就是双向 RNN 要解决的问题。
双向 RNN 的做法很直接:既然是上下文不够,那就跑两遍。不仅从句首往句尾读,也从句尾往句首读。
- 前向 RNN:从 x1 到 xT 顺序读,产出前向隐藏状态序列 h1→,h2→,..., hT .它编码“每个词在它左侧的上下文”。
- 反向 RNN:从 xT 到 x1 倒着读,产出反向隐藏状态序列 h1←,h2←,...,hT .它编码“每个词在它右侧的上下文”。
然后,对于每个时刻 t,把两个方向的隐藏状态拼接起来:
这个拼接后的 ht 就是这个词的完整上下文表示:它既看到了左邻右舍,也看到了上文下文。拿它去做分类、序列标注等任务,效果会好得多。
以“这个苹果很新鲜,我把它吃了”为例,关注“苹果”这个词:
- 前向 RNN 读到“苹果”时,只看到了“这个”,提供的信息很有限。
- 反向 RNN 倒着读,先看到“吃了”,再看到“把它”,最后才到“苹果”。此时反向 RNN 给“苹果”带来的信息里,包含了“它被吃了”这个关键线索。
两者拼接,模型终于明白:这是一个食物。相比之下,单向 RNN 只能从“这个”和一点点远距离传来的残存信号里去猜,准确性自然低很多。

实验
这一节的内容是根据名字猜测属于那个国家.


代码实现
import csv
import torch
from torch.utils.data import DataLoader
from torch.utils.data import Dataset
import time


class NameDataset(Dataset):
    def __init__(self, is_train_set=True):
        filename = (
            "dataset/names_train.csv" if is_train_set else "dataset/names_test.csv"
        )
        with open(filename, "rt") as f:
            reader = csv.reader(f)
            rows = list(reader)

        self.names = [row[0] for row in rows]
        self.len = len(rows)
        self.contries = [row[1] for row in rows]
        self.country_list = list(sorted(set(self.contries)))
        self.country_dict = self.getCnuntryDict()
        self.contry_num = len(self.country_list)

    def __getitem__(self, index):
        return self.names[index], self.country_dict[self.contries[index]]

    def __len__(self):
        return self.len

    def getCnuntryDict(self):
        country_dict = dict()
        for idx, country_name in enumerate(self.country_list):
            country_dict[country_name] = idx
        return country_dict

    def idx2country(self, index):
        return self.country_list[index]

    def getCountryNum(self):
        return self.contry_num


HIDDEN_SIZE = 100
BATCH_SIZE = 256
N_LAYER = 2
N_EPOCH = 100
N_CHARS = 128
N_EPOCHS = 20  # 训练轮数
USE_GPU = torch.cuda.is_available()

train_set = NameDataset(True)
train_loader = DataLoader(train_set, batch_size=BATCH_SIZE, shuffle=True)
test_set = NameDataset(False)
test_loader = DataLoader(test_set, batch_size=BATCH_SIZE, shuffle=False)

N_COUNTRY = train_set.getCountryNum()  # 输出维度
# N_CHARS = 128


class RNNClassifier(torch.nn.Module):
    def __init__(
        self, input_size, hidden_size, output_size, n_layer=1, bidirectional=True
    ):
        super().__init__()
        self.hidden_size = hidden_size
        self.n_layers = n_layer
        self.n_directional = 2 if bidirectional else 1

        self.embedding = torch.nn.Embedding(input_size, hidden_size)
        self.gru = torch.nn.GRU(
            hidden_size, hidden_size, n_layer, bidirectional=bidirectional
        )
        self.fc = torch.nn.Linear(hidden_size * self.n_directional, output_size)

    def _init_hidden(self, batch_size):
        hidden = torch.zeros(
            self.n_layers * self.n_directional, batch_size, self.hidden_size
        )
        return create_tensor(hidden)

    def forward(self, input, seq_len):
        input = input.t()  # 矩阵的转置
        batch_size = input.size(1)

        hidden = self._init_hidden(batch_size)
        embedding = self.embedding(input)

        gru_input = torch.nn.utils.rnn.pack_padded_sequence(embedding, seq_len.cpu())

        output, hidden = self.gru(gru_input, hidden)
        if self.n_directional == 2:
            hidden_cat = torch.cat([hidden[-1], hidden[-2]], dim=1)
        else:
            hidden_cat = hidden[-1]

        fc_output = self.fc(hidden_cat)
        return fc_output


def name2list(name):
    arr = [ord(c) for c in name]
    return arr, len(arr)


def create_tensor(tensor):
    if USE_GPU:
        device = torch.device("cuda:0")
        tensor = tensor.to(device)

    return tensor


def make_tensor(names, countries):
    # sequence_and_lengths = [name2list(name) for name in names]
    # name_sequences = [sl[0] for sl in sequence_and_lengths]
    # seq_lengths = torch.LongTensor([sl[1] for sl in sequence_and_lengths])

    name_sequences, seq_lengths_list = zip(*(name2list(name) for name in names))
    seq_lengths = torch.LongTensor(list(seq_lengths_list))
    countries = countries.long()  # ?

    # S*B形状,高度是S,宽度是B
    seq_tensor = torch.zeros(len(name_sequences), seq_lengths.max()).long()
    for idx, (seq, seq_len) in enumerate(zip(name_sequences, seq_lengths)):
        seq_tensor[idx, :seq_len] = torch.LongTensor(seq)

    seq_lengths, perm_idx = seq_lengths.sort(dim=0, descending=True)
    seq_tensor = seq_tensor[perm_idx]
    countries = countries[perm_idx]

    return (
        create_tensor(seq_tensor),
        create_tensor(seq_lengths),
        create_tensor(countries),
    )


def time_since(since):
    now = time.time()
    s = now - since
    m = int(s // 60)
    s -= m * 60
    return f"{m}m {s:.0f}s"


# model = RNNClassifier(INPUT)
def train_model():
    total_loss = 0
    for i, (names, countries) in enumerate(train_loader, 1):
        inputs, seq_lengths, target = make_tensor(names, countries)
        output = classifier(inputs, seq_lengths)
        loss = criterion(output, target)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        total_loss += loss.item()
        if i % 10 == 0:
            print(f"[{time_since(start)}] Epoch {epoch} ", end="")
            print(f"[{i * len(inputs)}/{len(train_set)}] ", end="")
            print(f"loss={total_loss / (i * len(inputs))}")
    return total_loss


def test_model():
    correct = 0
    total = len(test_set)
    print("evaluating trained model...")
    with torch.no_grad():
        for i, (names, countries) in enumerate(test_loader):
            inputs, seq_lengths, target = make_tensor(names, countries)
            output = classifier(inputs, seq_lengths)
            pred = output.max(dim=1, keepdim=True)[1]
            correct += pred.eq(target.view_as(pred)).sum().item()

        percent = "%.2f" % (100 * correct / total)
        print(f"Test set : Accuracy {correct/total} {percent} %")

    return correct / total


# 创建模型、优化器和损失函数
classifier = RNNClassifier(
    N_CHARS, HIDDEN_SIZE, N_COUNTRY, n_layer=N_LAYER, bidirectional=True
)
classifier = create_tensor(classifier)

criterion = torch.nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(classifier.parameters(), lr=0.001)


# 训练和测试流程
if __name__ == "__main__":
    start = time.time()
    print("Training for %d epochs..." % N_EPOCHS)

    best_accuracy = 0
    for epoch in range(1, N_EPOCHS + 1):
        print(f"\nEpoch {epoch}")

        # 训练
        classifier.train()
        train_model()

        # 测试
        classifier.eval()
        accuracy = test_model()

        # 保存最佳模型
        if accuracy > best_accuracy:
            best_accuracy = accuracy
            torch.save(classifier.state_dict(), "best_rnn_classifier.pth")
            print(f"Best model saved with accuracy: {accuracy*100:.2f}%")

    print(f"\nTraining finished. Best accuracy: {best_accuracy*100:.2f}%")


 浙公网安备 33010602011771号