
pymysql与sqlalchemy
pymysql
import pymysql  #pymysql是基于mysql的事务实现的
connect = pymysql.connect(host='127.0.0.1',port=3306,user='root',passwd='MSQroot:123',db='text_database')
cursor = connect.cursor(cursor=pymysql.cursors.DictCursor) #创建游标对象
# sql_statement = r'-- insert into test_table (name,age) values ("ablx",18),("小秦",20),("job",19)'

'''查询数据'''
sql_statement = input('mysql>')
cursor.execute(sql_statement)
# one = cursor.fetchone()  #查询一行
# many = cursor.fetchmany(3)  #查询n行
all = cursor.fetchall()  #查询所有数据

'''光标移动'''
# cursor.scroll(-2,mode='relative')  #负数向上,正数向下
# cursor.scroll(-2,mode='absolute')

'''更改获取数据结果的数据类型,默认是元祖。'''
# connect.cursor(cursor=pymysql.cursors.DictCursor)

print(all)
connect.commit() #提交
cursor.close() #关闭游标
connect.close() #关闭连接

'''mysql的事务'''
# try:
#     cursor.execute('insert  into test_table2 (name,maney) values ("alex",20000),("job",10000)')
#     connect.commit()
#     cursor.execute('update test_table set maney=maney+200 where name="alex"')
#     raise Exception #模拟异常
#     cursor.execute('update test_table set maney=maney-200 where name="job"')
#     connect.commit()
#     cursor.close()
#     connect.close()
# except Exception:
#     connect.rollback() #撤销上一次connect.commit()后到此为止的sql语句。
#     connect.commit()
sqlalchemy
SQLAlchemy是一个基于Python的ORM框架。该框架是建立在DB-API之上,使用关系对象映射进行数据库操作。
简而言之就是,将类和对象转换成SQL,然后使用数据API执行SQL并获取执行结果。
补充:什么是DB-API ? 是Python的数据库接口规范。
在没有DB-API之前,各数据库之间的应用接口非常混乱,实现各不相同,项目需要更换数据库的时候,需要做大量的修改,非常不方便,DB-API就是为了解决这样的问题。
连接数据库
SQLAlchemy 本身无法操作数据库,其必须依赖遵循DB-API规范的三方模块,
Dialect 用于和数据API进行交互,根据配置的不同调用不同数据库API,从而实现数据库的操作。
# MySQL-PYthon
mysql+mysqldb://<user>:<password>@<host>[:<port>]/<dbname>

#pymysql
mysql+pymysql://<username>:<password>@<host>/<dbname>[?<options>]

# MySQL-Connector
mysql+mysqlconnector://<user>:<password>@<host>[:<port>]/<dbname>

# cx_Oracle
oracle+cx_oracle://user:pass@host:port/dbname[?key=value&key=value...]

# 更多
# http://docs.sqlalchemy.org/en/latest/dialects/index.html

'''连接数据库'''
engine = create_engine(
    "mysql+pymysql://root:root1234@127.0.0.1:3306/code_record?charset=utf8",
    max_overflow=0,  # 超过连接池大小外最多创建的连接数
    pool_size=5,  # 连接池大小
    pool_timeout=30,  # 连接池中没有线程最多等待时间,否则报错
    pool_recycle=-1,  # 多久之后对连接池中的连接进行回收(重置)-1不回收
)
执行原生SQL
from sqlalchemy import create_engine

engine = create_engine(
    "mysql+pymysql://root:root1234@127.0.0.1:3306/code_record?charset=utf8",
    max_overflow=0,  # 超过连接池大小外最多创建的连接数
    pool_size=5,  # 连接池大小
    pool_timeout=30,  # 连接池中没有线程最多等待时间,否则报错
    pool_recycle=-1,  # 多久之后对连接池中的连接进行回收(重置)-1不回收
)


def test():
    conn = engine.raw_connection()
    cursor = conn.cursor()
    cursor.execute("select * from Course") #执行原生sql语句
    result = cursor.fetchall()
    print(result)
    cursor.close()
    conn.close()


if __name__ == '__main__':
    test()
# ((1, '生物', 1), (2, '体育', 2), (3, '物理', 1))

raw_connection

raw_connection
from sqlalchemy import create_engine
engine = create_engine(
    "mysql+pymysql://root:root1234@127.0.0.1:3306/code_record?charset=utf8",
    max_overflow=0,
    pool_size=5,
)

def test():
    conn = engine.contextual_connect()
    with conn:
        cur = conn.execute(
            "select * from Course"
        )
        result = cur.fetchall()
        print(result)


if __name__ == '__main__':
    test()
# [(1, '生物', 1), (2, '体育', 2), (3, '物理', 1)]

contextual_connect

contextual_connect
from sqlalchemy import create_engine
engine = create_engine(
    "mysql+pymysql://root:root1234@127.0.0.1:3306/code_record?charset=utf8",
    max_overflow=0,
    pool_size=5,
)

def test():
    cur = engine.execute("select * from Course")
    result = cur.fetchall()
    print(result)
    cur.close()

if __name__ == '__main__':
    test()
# [(1, '生物', 1), (2, '体育', 2), (3, '物理', 1)]

engine.execute

engine.execute
ORM操作
单表的创建
# 单表的创建  app.py
from sqlalchemy import create_engine
from sqlalchemy.ext.declarative import declarative_base
from sqlalchemy import Column, Integer, String, DateTime
from sqlalchemy import Index, UniqueConstraint
import datetime
# sqlalchemy要依赖pysysql,用户名,密码,ip,端口号,数据库名字,编码方式
ENGINE = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/database111?charset=utf8",)

Base = declarative_base()


class UserInfo(Base):
    __tablename__ = "user_info"  # 表的名字就叫user_info

    id = Column(Integer, primary_key=True, autoincrement=True)  # 整数,默认主键,自增
    name = Column(String(32), index=True, nullable=False)  # 字符串
    extra = Column(String(32), unique=True)  # 字符串
def create_db():  # 创建表
    Base.metadata.create_all(ENGINE)  # 就是将继承的Base的类的所有的表都创建,创建到ENGINE数据库,就上上面那个mysql+pymysql数据库


def drop_db():  # 删除表
    Base.metadata.drop_all(ENGINE)


if __name__ == '__main__':
    create_db()
单表的增加数据
# ad.py
import app
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, scoped_session

# 创建连接
ENGINE = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/db111?charset=utf8",)
Session = sessionmaker(bind=ENGINE)
# 每次执行数据库操作的时候,都需要创建一个session,就会开辟内存空间放这个session
session = Session()

# 单条数据增加
obj1 = app.UserInfo(name="xiaoming", extra="bangbangbang")  # 先实例化一个对象,这样就拿到一个对象
obj2 = app.UserInfo(name="xiaojun", extra="bangbang")  # 先实例化一个对象,这样就拿到一个对象

session.add(obj1)  # 把这两个对象传给session了
session.add(obj2)  # 把这俩对象放内存了
session.commit()  # 就把这个数据提交到数据库了

session.close()  # 关闭连接
基于SQLAlchemy操作原生SQL
from sqlalchemy import create_engine

engine = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/db111?charset=utf8")
cur = engine.execute('select * from user_info')  # 执行原生sql
result = cur.fetchall()  # 拿到所有的数据

print(result)
# 打印结果 [(5, 'xiaoming', 'bangbangbang'), (6, 'xiaojun', 'bangbang')]
一对多和多对多表的创建
# 一对多和对对多表的创建
# app1.py

from sqlalchemy import create_engine
from sqlalchemy.ext.declarative import declarative_base
from sqlalchemy import Column, Integer, String, DateTime, ForeignKey
from sqlalchemy import Index, UniqueConstraint
import datetime
# sqlalchemy要依赖pysysql,用户名,密码,ip,端口号,数据库名字,编码方式
ENGINE = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/db111?charset=utf8",)

Base = declarative_base()

# 创建班级表
class Classes(Base):
    __tablename__ = "classes"
    id = Column(Integer, primary_key=True, autoincrement=True)  # 整数,默认主键,自增
    name = Column(String(32), nullable=False, unique=True)

# 创建学生表
class Student(Base):
    __tablename__ = "student"
    id = Column(Integer, primary_key=True, autoincrement=True)  # 整数,默认主键,自增
    username = Column(String(32), nullable=False, unique=True)  # 字符串,不能为空,唯一
    password = Column(String(64), nullable=False)  # 字符串,不能为空,可以不唯一
    ctime = Column(DateTime, default=datetime.datetime.now)  # 注意这里的new不加括号,如果加了括号,时间一直都是这个程序的启动时间
    class_id = Column(Integer, ForeignKey("classes.id"))  # 外键关联,要关联它的别名,关联id

# 创建爱好表
class Hobby(Base):
    __tablename__ = 'hobby'
    id = Column(Integer, primary_key=True)  # 整数,默认主键
    caption = Column(String(50), default='篮球')  # 字符串,默认值是篮球

# 创建学生表和爱好表的多对多关系表,第三张表
class Student2Hobby(Base):  # 要创建多对多关系,需要自己创建第三张表
    __tablename__ = 'student2hobby'
    id = Column(Integer, primary_key=True, autoincrement=True)
    student_id = Column(Integer, ForeignKey('student.id'))  # 外键关联关系
    hobby_id = Column(Integer, ForeignKey('hobby.id'))  # 外键关联关系

    __table_args__ = (
        UniqueConstraint('student_id', 'hobby_id', name='uix_student_id_hobby_id'),  # 创建联合唯一索引
        # Index('ix_student_id_hobby_id', 'student_id', 'hobby_id')  # 普通的联合索引,不约束唯一
    )

def create_db():
    Base.metadata.create_all(ENGINE)  # 就是将继承的Base的类的所有的表都创建,创建到ENGINE数据库,就上上面那个mysql+pymysql数据库

if __name__ == '__main__':
    create_db()
多条数据增加
# ad1.py
import app1
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, scoped_session

# 创建连接
ENGINE = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/db111?charset=utf8",)
Session = sessionmaker(bind=ENGINE)
# 每次执行数据库操作的时候,都需要创建一个session,就会开辟内存空间放这个session
session = Session()

# 多条数据增加
objs = [
    app1.Classes(name="1班"),
    app1.Classes(name="2班"),
    app1.Classes(name="3班"),
    app1.Classes(name="4班"),
    app1.Classes(name="5班")
]
session.add_all(objs)  # 把这两个对象传给session了
session.commit()  # 就把这个数据提交到数据库了

session.close()  # 关闭连接
查询表数据
# index1.py
import app1
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, scoped_session

# 创建连接
ENGINE = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/db111?charset=utf8",)
Session = sessionmaker(bind=ENGINE)
# 每次执行数据库操作的时候,都需要创建一个session,就会开辟内存空间放这个session
session = Session()

# 查询表数据
result = session.query(app1.Classes).all()
print(result)  # 打印出的是一个对象列表
for item in result:
    print(item.id, item.name)

session.close()  # 关闭连接
删除表数据
# del.py
import app1
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, scoped_session

# 创建连接
ENGINE = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/db111?charset=utf8",)
Session = sessionmaker(bind=ENGINE)
# 每次执行数据库操作的时候,都需要创建一个session,就会开辟内存空间放这个session
session = Session()  # 将操作提交到数据库

# 查询表数据
session.query(app1.Classes).filter(app1.Classes.id > 2).delete()  # 删除id>2的班级
session.commit()

session.close()  # 关闭连接
修改表数据
import app1
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, scoped_session

# 创建连接
ENGINE = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/db111?charset=utf8",)
Session = sessionmaker(bind=ENGINE)
# 每次执行数据库操作的时候,都需要创建一个session,就会开辟内存空间放这个session
session = Session()

# 修改表数据# session.query(app1.Classes).filter_by(id=1).update({app1.Classes.name: "Ming"})  # 修改成Ming
# session.query(app1.Classes).filter_by(id=2).update({"name": "jun"})  # 修改成jun
# session.query(app1.Classes).filter_by(id=3).update({"name": app1.Classes.name + "~"}, synchronize_session=False)  # 后面加上
# synchronize_session="evaluate" 默认值进行数字加减
session.commit()

session.close()  # 关闭连接
常用的条件查询
import app1
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, scoped_session

# 创建连接
ENGINE = create_engine("mysql+pymysql://root:123456@127.0.0.1:3306/db111?charset=utf8",)
Session = sessionmaker(bind=ENGINE)
# 每次执行数据库操作的时候,都需要创建一个session,就会开辟内存空间放这个session
session = Session()


# 条件查询
# ret1 = session.query(app1.Classes).filter_by(id=1).first()
# print(ret1.id, ret1.name)
# ret2 = session.query(app1.Classes).filter(app1.Classes.id > 4, app1.Classes.name == "7班").first()
# print(ret2.id, ret2.name)
# ret3 = session.query(app1.Classes).filter(app1.Classes.id.between(1, 10)).all()  # 范围内
# for i in ret3:
#     print(i.id)
# ret4 = session.query(app1.Classes).filter(app1.Classes.id.in_([1, 2, 6, 10])).all()  # id在这个列表里面
# for k in ret4:
#     print(k.name)
# from sqlalchemy import and_, or_
# ret5 = session.query(app1.Classes).filter(and_(app1.Classes.id > 3, app1.Classes.name == "6班")).first()  # 两个条件都要满足
# print(ret5.name)
# ret6 = session.query(app1.Classes).filter(or_(app1.Classes.id > 3, app1.Classes.name == "没有这个名字")).first()  # 只需要满足一个条件
# print(ret6.name)
# ret7 = session.query(app1.Classes).filter(or_(
#     app.Classes.id > 1,
#     and_(app1.Classes.id > 3, app1.Classes.name == "8班")
# )).all()
# for g in ret7:
#     print(g.name)

# 通配符
# ret8 = session.query(app1.Classes).filter(app1.Classes.name.like("%班")).all()
# print(ret8)
# ret9 = session.query(app1.Classes).filter(app1.Classes.name.like("班%")).all()

# 限制

# ret10 = session.query(app1.Classes).filter(app1.Classes.name.like("%班")).all()[1:10]
# for l in ret10:
#     print(l.name)
# # 排序

# ret11 = session.query(app1.Classes).order_by(app1.Classes.id.desc()).all()  # 倒序
# for r in ret11:
#     print(r.name)
# ret12 = session.query(app1.Classes).order_by(app1.Classes.id.asc()).all()  # 正序
# for a in ret12:
#     print(a.name)

# 分组
# ret13 = session.query(app1.Classes.name).group_by(app1.Classes.name).all()
# print(ret13)
# for x in ret13:
#     print(x.name)

# 聚合函数
# from sqlalchemy.sql import func
# ret14 = session.query(
#     func.max(app1.Classes.id),
#     func.sum(app1.Classes.id),
#     func.min(app1.Classes.id)
# ).group_by(app1.Classes.name).having(func.max(app1.Classes.id > 1)).all()
# print(ret14)

# 连表
# ret15 = session.query(app1.Student, app1.Classes).filter(app1.Student.class_id == app1.Classes.id).all()
# for m in ret15:
#     print(m[0].username)
# print(ret15) 得到一个列表套元组 元组里是两个对象
# ret16 = session.query(app1.Student).join(app1.Classes).all()
# print(ret16[2].username)  # 得到列表里面是前一个表的对象
# 相当于inner join

# for i in ret16:
#     print(i[0].username, i[1].username)
# ret17 = session.query(Hobby).join(UserInfo, isouter=True).all()
# ret17_1 = session.query(UserInfo).join(Hobby, isouter=True).all()
# ret18 = session.query(Hobby).outerjoin(UserInfo).all()
# ret18_1 = session.query(UserInfo).outerjoin(Hobby).all()
# 相当于left join


# print(ret17)
# print(ret17_1)
# print(ret18)
# print(ret18_1)

session.commit()
session.close()  # 关闭连接
基于relationship的FK
# 基于relationship的FK外键
# 添加
user_obj = UserInfo(name="提莫", hobby=Hobby(title="种蘑菇"))
session.add(user_obj)

hobby = Hobby(title="弹奏一曲")
hobby.user = [UserInfo(name="琴女"), UserInfo(name="妹纸")]
session.add(hobby)
session.commit()

# 基于relationship的正向查询
user_obj_1 = session.query(UserInfo).first()
print(user_obj_1.name)
print(user_obj_1.hobby.title)

# 基于relationship的反向查询
hb = session.query(Hobby).first()
print(hb.title)
for i in hb.user:
    print(i.name)

session.close()
基于relationship的M2M多对多
# 添加
book_obj = Book(title="Python源码剖析")
tag_obj = Tag(title="Python")
b2t = Book2Tag(book_id=book_obj.id, tag_id=tag_obj.id)
session.add_all([
    book_obj,
    tag_obj,
    b2t,
])
session.commit()

#  上面有坑哦~~~~
book = Book(title="测试")
book.tags = [Tag(title="测试标签1"), Tag(title="测试标签2")]
session.add(book)
session.commit()

tag = Tag(title="LOL")
tag.books = [Book(title="大龙刷新时间"), Book(title="小龙刷新时间")]
session.add(tag)
session.commit()

# 基于relationship的正向查询
book_obj = session.query(Book).filter_by(id=4).first()
print(book_obj.title)
print(book_obj.tags)
# 基于relationship的反向查询
tag_obj = session.query(Tag).first()
print(tag_obj.title)
print(tag_obj.books)
创建一个博客应用所需要的数据表
# coding: utf-8

import random
from faker import Factory #faker 是用来生成虚假数据的库。

from sqlalchemy import create_engine, Table
from sqlalchemy.ext.declarative import declarative_base
from sqlalchemy import ForeignKey
from sqlalchemy import Column, String, Integer, Text
from sqlalchemy.orm import sessionmaker, relationship


engine = create_engine('mysql+pymysql://root@localhost:3306/blog?charset=utf8')
Base = declarative_base()


class User(Base):

    __tablename__ = 'users' #用 __tablename__ 指定在 MySQL 中表的名字

    '''每一个 Column 代表数据库中的一列,在 Colunm中,指定该列的一些配置。第一个字段代表类的数据类型,上面我们使用 String, Integer 俩个最常用的类型,
    其他常用的包括:Text、Boolean、SmallInteger、DateTime。nullable=False 代表这一列不可以为空,index=True 表示在该列创建索引。'''
    id = Column(Integer, primary_key=True)
    username = Column(String(64), nullable=False, index=True)
    password = Column(String(64), nullable=False)
    email = Column(String(64), nullable=False, index=True)
    articles = relationship('Article', backref='author')
    userinfo = relationship('UserInfo', backref='user', uselist=False)

    def __repr__(self):
        return '%s(%r)' % (self.__class__.__name__, self.username)


class UserInfo(Base):

    __tablename__ = 'userinfos'

    id = Column(Integer, primary_key=True)
    name = Column(String(64))
    qq = Column(String(11))
    phone = Column(String(11))
    link = Column(String(64))
    user_id = Column(Integer, ForeignKey('users.id'))


class Article(Base):
    '''对于一个普通的博客应用来说,用户和文章显然是一个一对多的关系,一篇文章属于一个用户,一个用户可以写很多篇文章。'''

    __tablename__ = 'articles'

    id = Column(Integer, primary_key=True)
    title = Column(String(255), nullable=False, index=True)
    content = Column(Text)
    user_id = Column(Integer, ForeignKey('users.id')) #每篇文章有一个外键指向 users 表中的主键 id
    cate_id = Column(Integer, ForeignKey('categories.id'))
    tags = relationship('Tag', secondary='article_tag', backref='articles')

    def __repr__(self):
        return '%s(%r)' % (self.__class__.__name__, self.title)


class Category(Base):

    __tablename__ = 'categories'

    id = Column(Integer, primary_key=True)
    name = Column(String(64), nullable=False, index=True)
    articles = relationship('Article', backref='category')

    def __repr__(self):
        return '%s(%r)' % (self.__class__.__name__, self.name)


article_tag = Table(
    'article_tag', Base.metadata,
    Column('article_id', Integer, ForeignKey('articles.id')),
    Column('tag_id', Integer, ForeignKey('tags.id'))
)


class Tag(Base):

    __tablename__ = 'tags'

    id = Column(Integer, primary_key=True)
    name = Column(String(64), nullable=False, index=True)

    def __repr__(self):
        return '%s(%r)' % (self.__class__.__name__, self.name)


if __name__ == '__main__':
    Base.metadata.create_all(engine) #上面的表已经描述好了,在文件末尾使用下面的命令在我们连接的数据库中创建对应的表

    faker = Factory.create()
    Session = sessionmaker(bind=engine)
    session = Session()

    faker_users = [User(
        username=faker.name(),
        password=faker.word(),
        email=faker.email(),
    ) for i in range(10)]
    session.add_all(faker_users)

    faker_categories = [Category(name=faker.word()) for i in range(5)]
    session.add_all(faker_categories)

    faker_tags= [Tag(name=faker.word()) for i in range(20)]
    session.add_all(faker_tags)

    for i in range(100):
        article = Article(
            title=faker.sentence(),
            content=' '.join(faker.sentences(nb=random.randint(10, 20))),
            author=random.choice(faker_users),
            category=random.choice(faker_categories)
        )
        for tag in random.sample(faker_tags, random.randint(2, 5)):
            article.tags.append(tag)
        session.add(article)

    session.commit()
原文链接:https://www.cnblogs.com/mrchige/p/6389588.html
一、安装
Sqlite3是Python3标准库不需要另外安装,只需要安装SQLAlchemy即可。本文sqlalchemy版本为1.2.12
pip install sqlalchemy
二、ORM操作
除了第一步创建引擎时连接URL不一样,其他操作其他mysql等数据库和sqlite都是差不多的。
2.1 创建数据库连接格式说明
sqlite创建数据库连接就是创建数据库,而其他mysql等应该是需要数据库已存在才能创建数据库连接;建立数据库连接本文中有时会称为建立数据库引擎。
2.1.1 sqlite创建数据库连接
以相对路径形式,在当前目录下创建数据库格式如下:
# sqlite://<nohostname>/<path>
# where <path> is relative:
engine = create_engine('sqlite:///foo.db')
以绝对路径形式创建数据库,格式如下:
#Unix/Mac - 4 initial slashes in total
engine = create_engine('sqlite:////absolute/path/to/foo.db')
#Windows
engine = create_engine('sqlite:///C:\\path\\to\\foo.db')
#Windows alternative using raw string
engine = create_engine(r'sqlite:///C:\path\to\foo.db')
sqlite可以创建内存数据库(其他数据库不可以),格式如下:
# format 1
engine = create_engine('sqlite://')
# format 2
engine = create_engine('sqlite:///:memory:', echo=True)
2.1.2 其他数据库创建数据库连接
PostgreSQL:
# default
engine = create_engine('postgresql://scott:tiger@localhost/mydatabase')
# psycopg2
engine = create_engine('postgresql+psycopg2://scott:tiger@localhost/mydatabase')
# pg8000
engine = create_engine('postgresql+pg8000://scott:tiger@localhost/mydatabase')
MySQL:

# default
engine = create_engine('mysql://scott:tiger@localhost/foo')
# mysql-python
engine = create_engine('mysql+mysqldb://scott:tiger@localhost/foo')
# MySQL-connector-python
engine = create_engine('mysql+mysqlconnector://scott:tiger@localhost/foo')
# OurSQL
engine = create_engine('mysql+oursql://scott:tiger@localhost/foo')
Oracle:
engine = create_engine('oracle://scott:tiger@127.0.0.1:1521/sidname')

engine = create_engine('oracle+cx_oracle://scott:tiger@tnsname')
MSSQL:
# pyodbc
engine = create_engine('mssql+pyodbc://scott:tiger@mydsn')
# pymssql
engine = create_engine('mssql+pymssql://scott:tiger@hostname:port/dbname')
2.2 创建数据库连接
我们以在当前目录下创建foo.db为例,后续各步同使用此数据库。
在create_engine中我们多加了两样东西,一个是echo=Ture,一个是check_same_thread=False。
echo=Ture----echo默认为False,表示不打印执行的SQL语句等较详细的执行信息,改为Ture表示让其打印。
check_same_thread=False----sqlite默认建立的对象只能让建立该对象的线程使用,而sqlalchemy是多线程的所以我们需要指定check_same_thread=False来让建立的对象任意线程都可使用。否则不时就会报错:sqlalchemy.exc.ProgrammingError: (sqlite3.ProgrammingError) SQLite objects created in a thread can only be used in that same thread. The object was created in thread id 35608 and this is thread id 34024. [SQL: 'SELECT users.id AS users_id, users.name AS users_name, users.fullname AS users_fullname, users.password AS users_password \nFROM users \nWHERE users.name = ?\n LIMIT ? OFFSET ?'] [parameters: [{}]] (Background on this error at: http://sqlalche.me/e/f405)
from sqlalchemy import create_engine

engine = create_engine('sqlite:///foo.db?check_same_thread=False', echo=True)

2.3 定义映射
先建立基本映射类,后边真正的映射类都要继承它
from sqlalchemy.ext.declarative import declarative_base
Base = declarative_base()

然后创建真正的映射类,我们这里以一下User映射类为例,我们设置它映射到users表。
首先要明确,ORM中一般情况下表是不需要先存在的反而为了类与表对应无误借助通过映射类来创建;当然表已戏存在了也无可以,在下一小结中你可以自己决定如果表存在时要如何操作是重新创建还是使用已有表,但使用已有表你需要确保和类的变量名与表的各字段名要对得上。
from sqlalchemy import Column, Integer, String

# 定义映射类User,其继承上一步创建的Base
class User(Base):
    # 指定本类映射到users表
    __tablename__ = 'users'
    # 如果有多个类指向同一张表,那么在后边的类需要把extend_existing设为True,表示在已有列基础上进行扩展
    # 或者换句话说,sqlalchemy允许类是表的字集
    # __table_args__ = {'extend_existing': True}
    # 如果表在同一个数据库服务(datebase)的不同数据库中(schema),可使用schema参数进一步指定数据库
    # __table_args__ = {'schema': 'test_database'}

    # 各变量名一定要与表的各字段名一样,因为相同的名字是他们之间的唯一关联关系
    # 从语法上说,各变量类型和表的类型可以不完全一致,如表字段是String(64),但我就定义成String(32)
    # 但为了避免造成不必要的错误,变量的类型和其对应的表的字段的类型还是要相一致
    # sqlalchemy强制要求必须要有主键字段不然会报错,如果要映射一张已存在且没有主键的表,那么可行的做法是将所有字段都设为primary_key=True
    # 不要看随便将一个非主键字段设为primary_key,然后似乎就没报错就能使用了,sqlalchemy在接收到查询结果后还会自己根据主键进行一次去重
    # 指定id映射到id字段; id字段为整型,为主键,自动增长(其实整型主键默认就自动增长)
    id = Column(Integer, primary_key=True, autoincrement=True)
    # 指定name映射到name字段; name字段为字符串类形,
    name = Column(String(20))
    fullname = Column(String(32))
    password = Column(String(32))

    # __repr__方法用于输出该类的对象被print()时输出的字符串,如果不想写可以不写
    def __repr__(self):
        return "<User(name='%s', fullname='%s', password='%s')>" % (
                   self.name, self.fullname, self.password)
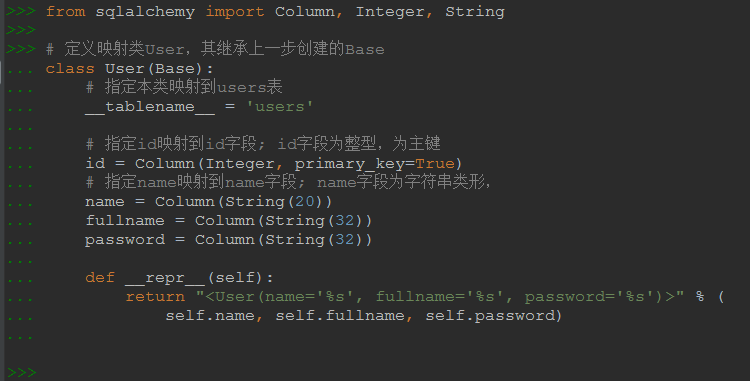
在上面的定义我__tablename__属性是写死的,但有时我们可能想通过外部给类传递表名,此时可以通过以下变通的方法来实现:
def get_dynamic_table_name_class(table_name):
    # 定义一个内部类
    class TestModel(Base):
        # 给表名赋值
        __tablename__ = table_name
        __table_args__ = {'extend_existing': True}

        username = Column(String(32), primary_key=True)
        password = Column(String(32))
    # 把动态设置表名的类返回去
    return TestModel
2.4 创建数据表
# 查看映射对应的表
User.__table__

# 创建数据表。一方面通过engine来连接数据库,另一方面根据哪些类继承了Base来决定创建哪些表
# checkfirst=True,表示创建表前先检查该表是否存在,如同名表已存在则不再创建。其实默认就是True
Base.metadata.create_all(engine, checkfirst=True)

# 上边的写法会在engine对应的数据库中创建所有继承Base的类对应的表,但很多时候很多只是用来则试的或是其他库的
# 此时可以通过tables参数指定方式,指示仅创建哪些表
# Base.metadata.create_all(engine,tables=[Base.metadata.tables['users']],checkfirst=True)
# 在项目中由于model经常在别的文件定义,没主动加载时上边的写法可能写导致报错,可使用下边这种更明确的写法
# User.__table__.create(engine, checkfirst=True)

# 另外我们说这一步的作用是创建表,当我们已经确定表已经在数据库中存在时,我完可以跳过这一步
# 针对已存放有关键数据的表,或大家共用的表,直接不写这创建代码更让人心里踏实

从上边的讨论可以知道,我们可以定义model然后根据model来创建数据表(当然也可以不创建),那可不可以反过来根据已有的表来自动生成model代码呢,答案是可以的,使用sqlacodegen。
sqlacodegen安装操作如下:
# 如果网络通,直接pip安装
pip install sqlacodegen

# 如果网络不通,先在网络通的机器上使用pip下载sqlacodegen及期依赖包
pip download sqlacodegen
# 上传到真正要安装的机器后再用pip安装,依赖包也会自动安装。版本可能会变化改成自己具体的包名
pip install sqlacodegen-2.1.0-py2.py3-none-any.whl
sqlacodegen生成model操作如下:
# linux应该被安装在/usr/local/bin/sqlacodegen
# mysql+pymysql示例
# 可使用--tables指定要生成model的表,不指定时为所有表都生成model
# 可使用--outfile指定代码输出到的文件,不指定时输出到stdout
# 注意只有当表有主键时sqlacodegen才生成如下的class,不然会使用旧的生成Table()类实例的形式
# 更多说明可使用-h参看
sqlacodegen mysql+pymysql://user:password@localhost/dbname [--tables table_name1,table_name2] [--outfile model.py]
如我的一个示例操作如下,成功为指定表生成model:

2.5 建立会话
增查改删(CRUD)操作需要使用session进行操作
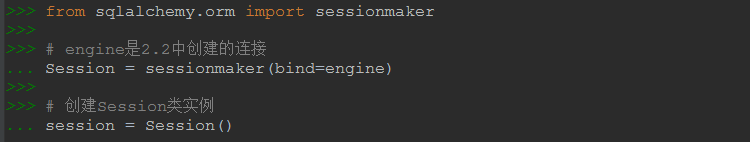
from sqlalchemy.orm import sessionmaker

# engine是2.2中创建的连接
Session = sessionmaker(bind=engine)

# 创建Session类实例
session = Session()
2.6 增(向users表中插入记录)
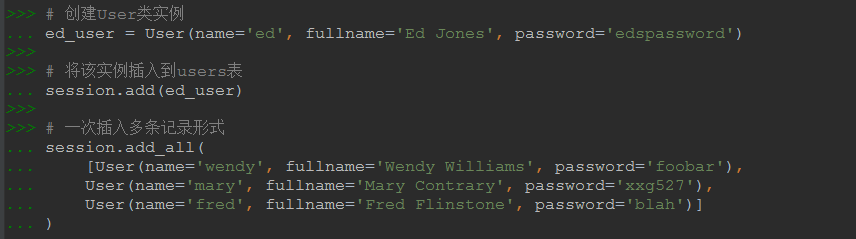
# 创建User类实例
ed_user = User(name='ed', fullname='Ed Jones', password='edspassword')

# 将该实例插入到users表
session.add(ed_user)

# 一次插入多条记录形式
session.add_all(
    [User(name='wendy', fullname='Wendy Williams', password='foobar'),
    User(name='mary', fullname='Mary Contrary', password='xxg527'),
    User(name='fred', fullname='Fred Flinstone', password='blah')]
)

# 当前更改只是在session中,需要使用commit确认更改才会写入数据库
session.commit()
2.7 查(查询users表中的记录)
2.7.1 查实现
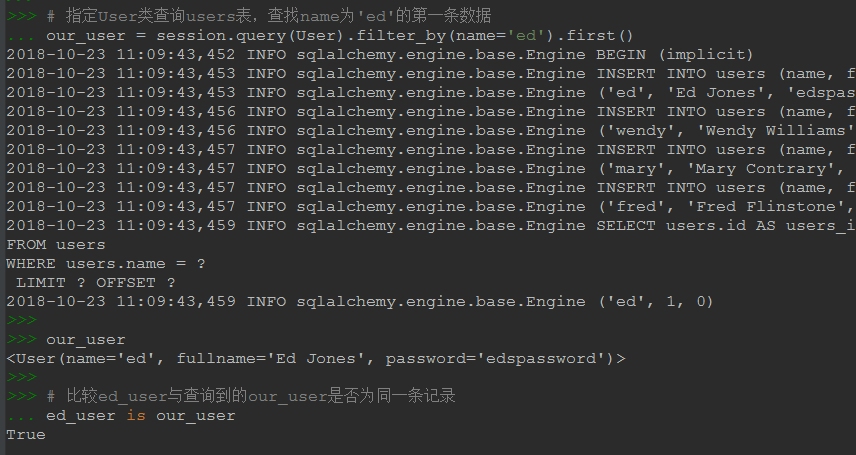
query将转成select xxx from xxx部分,filter/filter_by将转成where部分,limit/order by/group by分别对应limit()/order_by()/group_by()方法。这句话非常的重要,理解后你将大量减少sql这么写那在sqlalchemy该怎么写的疑惑。
filter_by相当于where部分,外另可用filter。他们的区别是filter_by参数写法类似sql形式,filter参数为python形式。
更多匹配写法见:https://docs.sqlalchemy.org/en/13/orm/tutorial.html#common-filter-operators
our_user = session.query(User).filter_by(name='ed').first()

our_user

# 比较ed_user与查询到的our_user是否为同一条记录
ed_user is our_user

# 只获取指定字段
# 但要注意如果只获取部分字段,那么返回的就是元组而不是对象了
# session.query(User.name).filter_by(name='ed').all()
# like查询
# session.query(User).filter(User.name.like("ed%")).all()
# 正则查询
# session.query(User).filter(User.name.op("regexp")("^ed")).all()
# 统计数量
# session.query(User).filter(User.name.like("ed%")).count()
# 调用数据库内置函数
# 以count()为例,都是直接func.func_name()这种格式,func_name与数据库内的写法保持一致
# from sqlalchemy import func
# session.query(func.count(User3.name)).one()
# 字段名为字符串形式
# column_name = "name"
# session.query(User).filter(User3.__table__.columns[column_name].like("ed%")).all()
# 获取执行的sql语句
# 获取记录数的方法有all()/one()/first()等几个方法,如果没加这些方法,得到的只是一个将要执行的sql对象,并没真正提交执行
# from sqlalchemy.dialects import mysql
# sql_obj = session.query(User).filter_by(name='ed')
# sql_command = sql_obj.statement.compile(dialect=mysql.dialect(), compile_kwargs={"literal_binds": True})
# sql_result = sql_obj.all()
另外要注意该链接Common Filter Operators节中形如equals的query.filter(User.name == 'ed'),在真正使用时都得改成session.query(User).filter(User.name == 'ed')形式,不然只后看到报错“NameError: name 'query' is not defined”。
2.7.2 参数传递问题
我们上边的sql直接是our_user = session.query(User).filter_by(name='ed').first()形式,但到实际中时User部分和name=‘ed’这部分是通过参数传过来的,使用参数传递时就要注意以下两个问题。
首先,是参数不要使用引号括起来。比如如下形式是错误的(使用引号),将报错sqlalchemy.exc.OperationalError: (sqlite3.OperationalError) no such column
table_and_column_name = "User"
filter = "name='ed'"

our_user = session.query(table_and_column_name).filter_by(filter).first()
其次,对于有等号参数需要变换形式。如下去掉了引号,对table_and_column_name没问题,但filter = (name='ed')这种写法在python是不允许的
table_and_column_name = User
# 下面这条语句不符合语法
filter = (name='ed')

our_user = session.query(table_and_column_name).filter_by(filter).first()
对参数中带等号的这种形式,现在能想到的只有使用filter代替filter_by,即将sql语句中的=号转变为python语句中的==。正确写法如下:
table_and_column_name = User
filter = (User.name=='ed')

our_user = session.query(table_and_column_name).filter(filter).first()
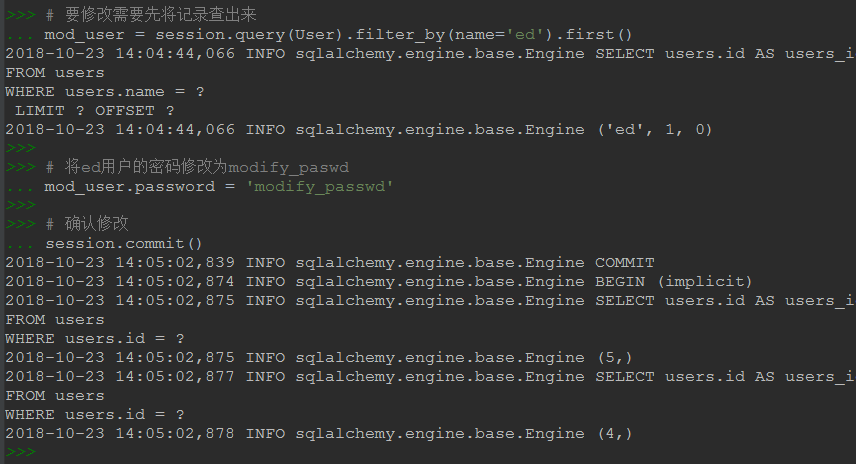
2.8 改(修改users表中的记录)
# 要修改需要先将记录查出来
mod_user = session.query(User).filter_by(name='ed').first()

# 将ed用户的密码修改为modify_paswd
mod_user.password = 'modify_passwd'

# 确认修改
session.commit()

# 但是上边的操作,先查询再修改相当于执行了两条语句,和我们印象中的update不一致
# 可直接使用下边的写法,传给服务端的就是update语句
# session.query(User).filter_by(name='ed').update({User.password: 'modify_passwd'})
# session.commit()
# 以同schema的一张表更新另一张表的写法
# 在跨表的update/delete等函数中synchronize_session=False一定要有不然报错
# session.query(User).filter_by(User.name=User1.name).update({User.password: User2.password}, synchronize_session=False)
# 以一schema的表更新另一schema的表的写法
# 写法与同一schema的一样,只是定义model时需要使用__table_args__ = {'schema': 'test_database'}等形式指定表对应的schema
2.9 删(删除users表中的记录)
# 要删除需要先将记录查出来
del_user = session.query(User).filter_by(name='ed').first()

# 打印一下,确认未删除前记录存在
del_user

# 将ed用户记录删除
session.delete(del_user)

# 确认删除
session.commit()

# 遍历查看,已无ed用户记录
for user in session.query(User):
    print(user)

# 但上边的写法,先查询再删除,相当于给mysql服务端发了两条语句,和我们印象中的delete语句不一致
# 可直接使用下边的写法,传给服务端的就是delete语句
# session.query(User).filter_by(name='ed').first().delete()

2.10 直接执行SQL语句
虽然使用框架规定形式可以在一定程度上解决各数据库的SQL差异,比如获取前两条记录各数据库形式如下。
# mssql/access
select top 2 * from table_name;

# mysql
select * from table_name limit 2;

# oracle
select * from table_name where rownum <= 2;
但框架存消除各数据库SQL差异的同时会引入各框架CRUD的差异,而开发人员往往就有一定的SQL基础,如果一个框架强制用户只能使用其规定的CRUD形式那反而增加用户的学习成本,这个框架注定不能成为成功的框架。直接地执行SQL而不是使用框架设定的CRUD虽然不是一种被鼓励的操作但也不应被视为一种见不得人的行为。
# 正常的SQL语句
sql = "select * from users"

# sqlalchemy使用execute方法直接执行SQL
records = session.execute(sql)
三、ORM的作用(20200313更新)
说实话在很长一段时间里,我总感觉直接写sql挺简单明了的,ORM一顿操作下来似乎还增加了工作量。百度了半天也没找到感觉能解释为什么那么多人推崇他的原因,请教一位做开发的同学。
他说在面象对象编程中我们常把一个对象定义成一个类,没有ORM时,从数据库读取数据要写代码把记录转成对象(如User.username = row[0][0])、向数据库插入数据要写代码把对象转成记录(如column_username=User.username),每次读/写都要转一次就很麻烦。另外多表关联的时候直接的sql拼接会显得很复杂,ORM的写法更直观(这点暂时还没切身感受)。
参考:
https://docs.sqlalchemy.org/en/latest/orm/tutorial.html
https://stackoverflow.com/questions/34675604/sqlacodegen-generates-mixed-models-and-tables

 浙公网安备 33010602011771号