
缓存一致性:先删缓存还是先更新库?3 种方案对比 + 实战

你写完 updateAmount(),先 UPDATE 主库还是先 DEL 缓存?这个问题在评审里被问住过的人不少。线上的表现更具体:用户改了余额,刷新页面还是旧数字,过几秒自己好了。这不是偶发玄学——本机实测里,读路径只要比写路径慢 1 毫秒,实验 A 的 40 轮就全部脏读;而没有任何人为对齐的自然并发,1500 轮里也撞出 63 次(4.2%)。很多人把「先删缓存还是先更新库」当成任选,或者靠「概率低」安慰自己。本文用一条统一场景把三条写路径的失效窗口画清楚,给你一个能落到代码里的判断:什么时候先更新库再删缓存就够,什么时候它根本兜不住,以及工业界真正在用的失效手段。
为什么是「删」缓存而不是「更新」缓存
动手比较顺序之前,先回答一个更根本的问题:缓存写操作本身,到底是 DEL 还是 SET 新值?
Facebook 在 NSDI'13 的《Scaling Memcache at Facebook》里把理由写绝了,原文只有一句:"We choose to delete cached data instead of updating it because deletes are idempotent." 删除是幂等的——缓存里有没有这个 key、是什么值,删一次和删一百次结果一样。而「更新」是覆盖,一旦两个写并发乱序,旧值会盖掉新值。
实验 D 把这件事复现出来了:两个并发写,A 写 100、B 写 200,A 的缓存写被人为拖后 40ms,结果主库最终是 B 的 200,缓存里留下的却是 A 的 100:
D 双写更新缓存(A 的缓存写拖后 40ms): 不一致 40/40
40/40,没有任何随机性。库是新的,缓存是旧的,这正是「更新缓存」的代价:更新会覆盖,删除只认有没有。所以下面所有方案,缓存写操作一律是 DEL,区别只在它和 UPDATE 主库的相对顺序。
三条写路径放在一起比:脏值能活多久
把三种顺序、以及「双写更新缓存」放到同一张图里,结论先放出来:它们都会留下脏值,但脏值的寿命完全不同。
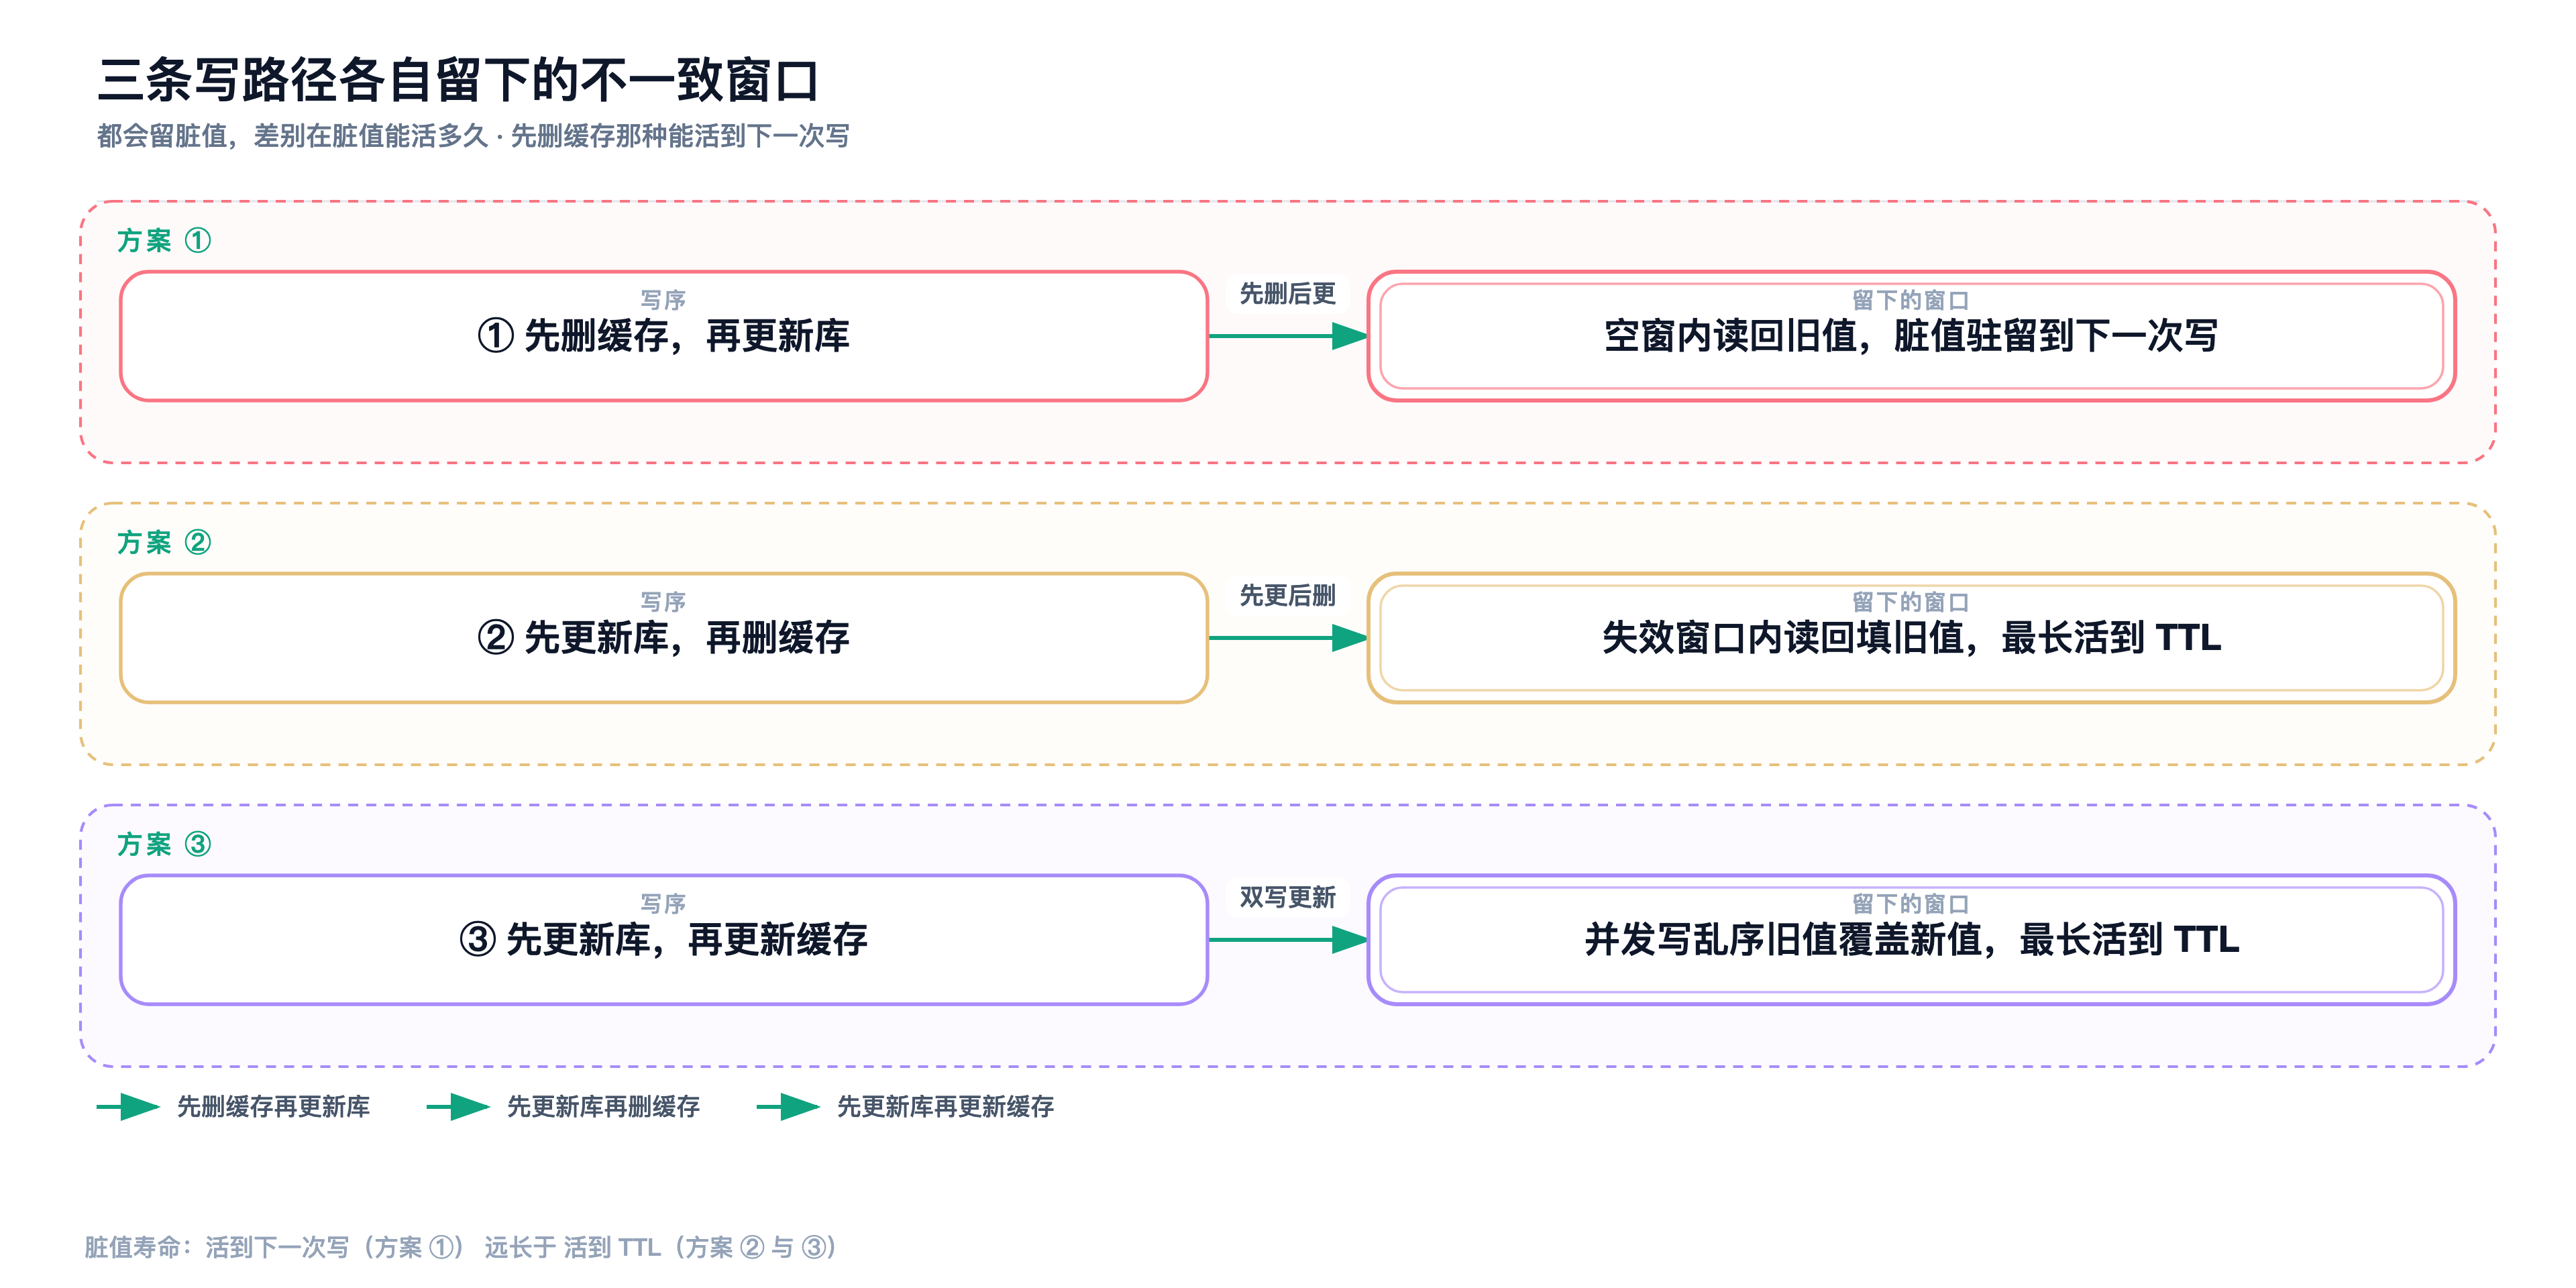
- 先删缓存、再更新库:脏值最长可以驻留到下一次写,而不是 TTL。
- 先更新库、再删缓存:脏值最长活到 TTL 到期。
- 双写更新缓存:并发写乱序,旧值覆盖新值,最长活到 TTL 到期(实验 D 里把 A 的缓存写拖后 40ms,40/40 全部留下旧值)。
「脏值能活多久」是后面判断的标尺——它能活到下一次写,就意味着两次写之间的所有读都是错的,比「活一个 TTL」严重一个量级。
方案一:先更新库、再删缓存(Cache-Aside 标准做法)
这是 Azure 官方 Cache-Aside 文档点名要求的顺序,原文:"Update the data store before removing the item from the cache." 它给的反例也直白:如果你先删缓存,客户端有一小段时间会在数据还没更新前读到一个旧值窗口,最终缓存里就是脏数据。
它的失效窗口长这样(缓存已失效、读请求未命中的前提下):
- 读请求
GET未命中,去查主库,拿到旧值 100 - 写线程把主库更新为 200
- 写线程删缓存——此时缓存里本就是空的,删了个寂寞
- 读线程把第 1 步拿到的旧值 100 回填进缓存
- 缓存 100 对着主库 200,脏值最长活到 TTL 到期
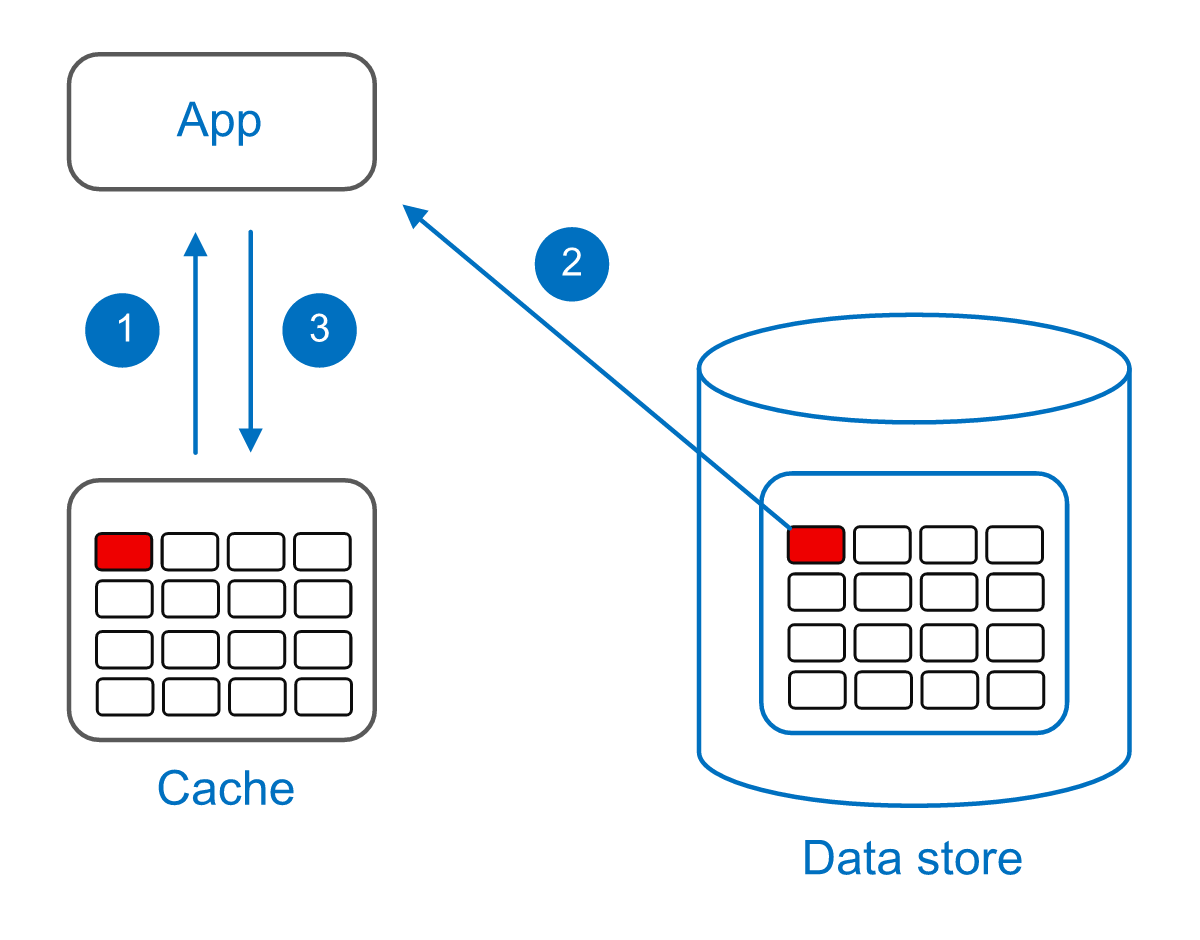
图源:Microsoft Azure Architecture Center《Cache-Aside pattern》,CC BY 4.0
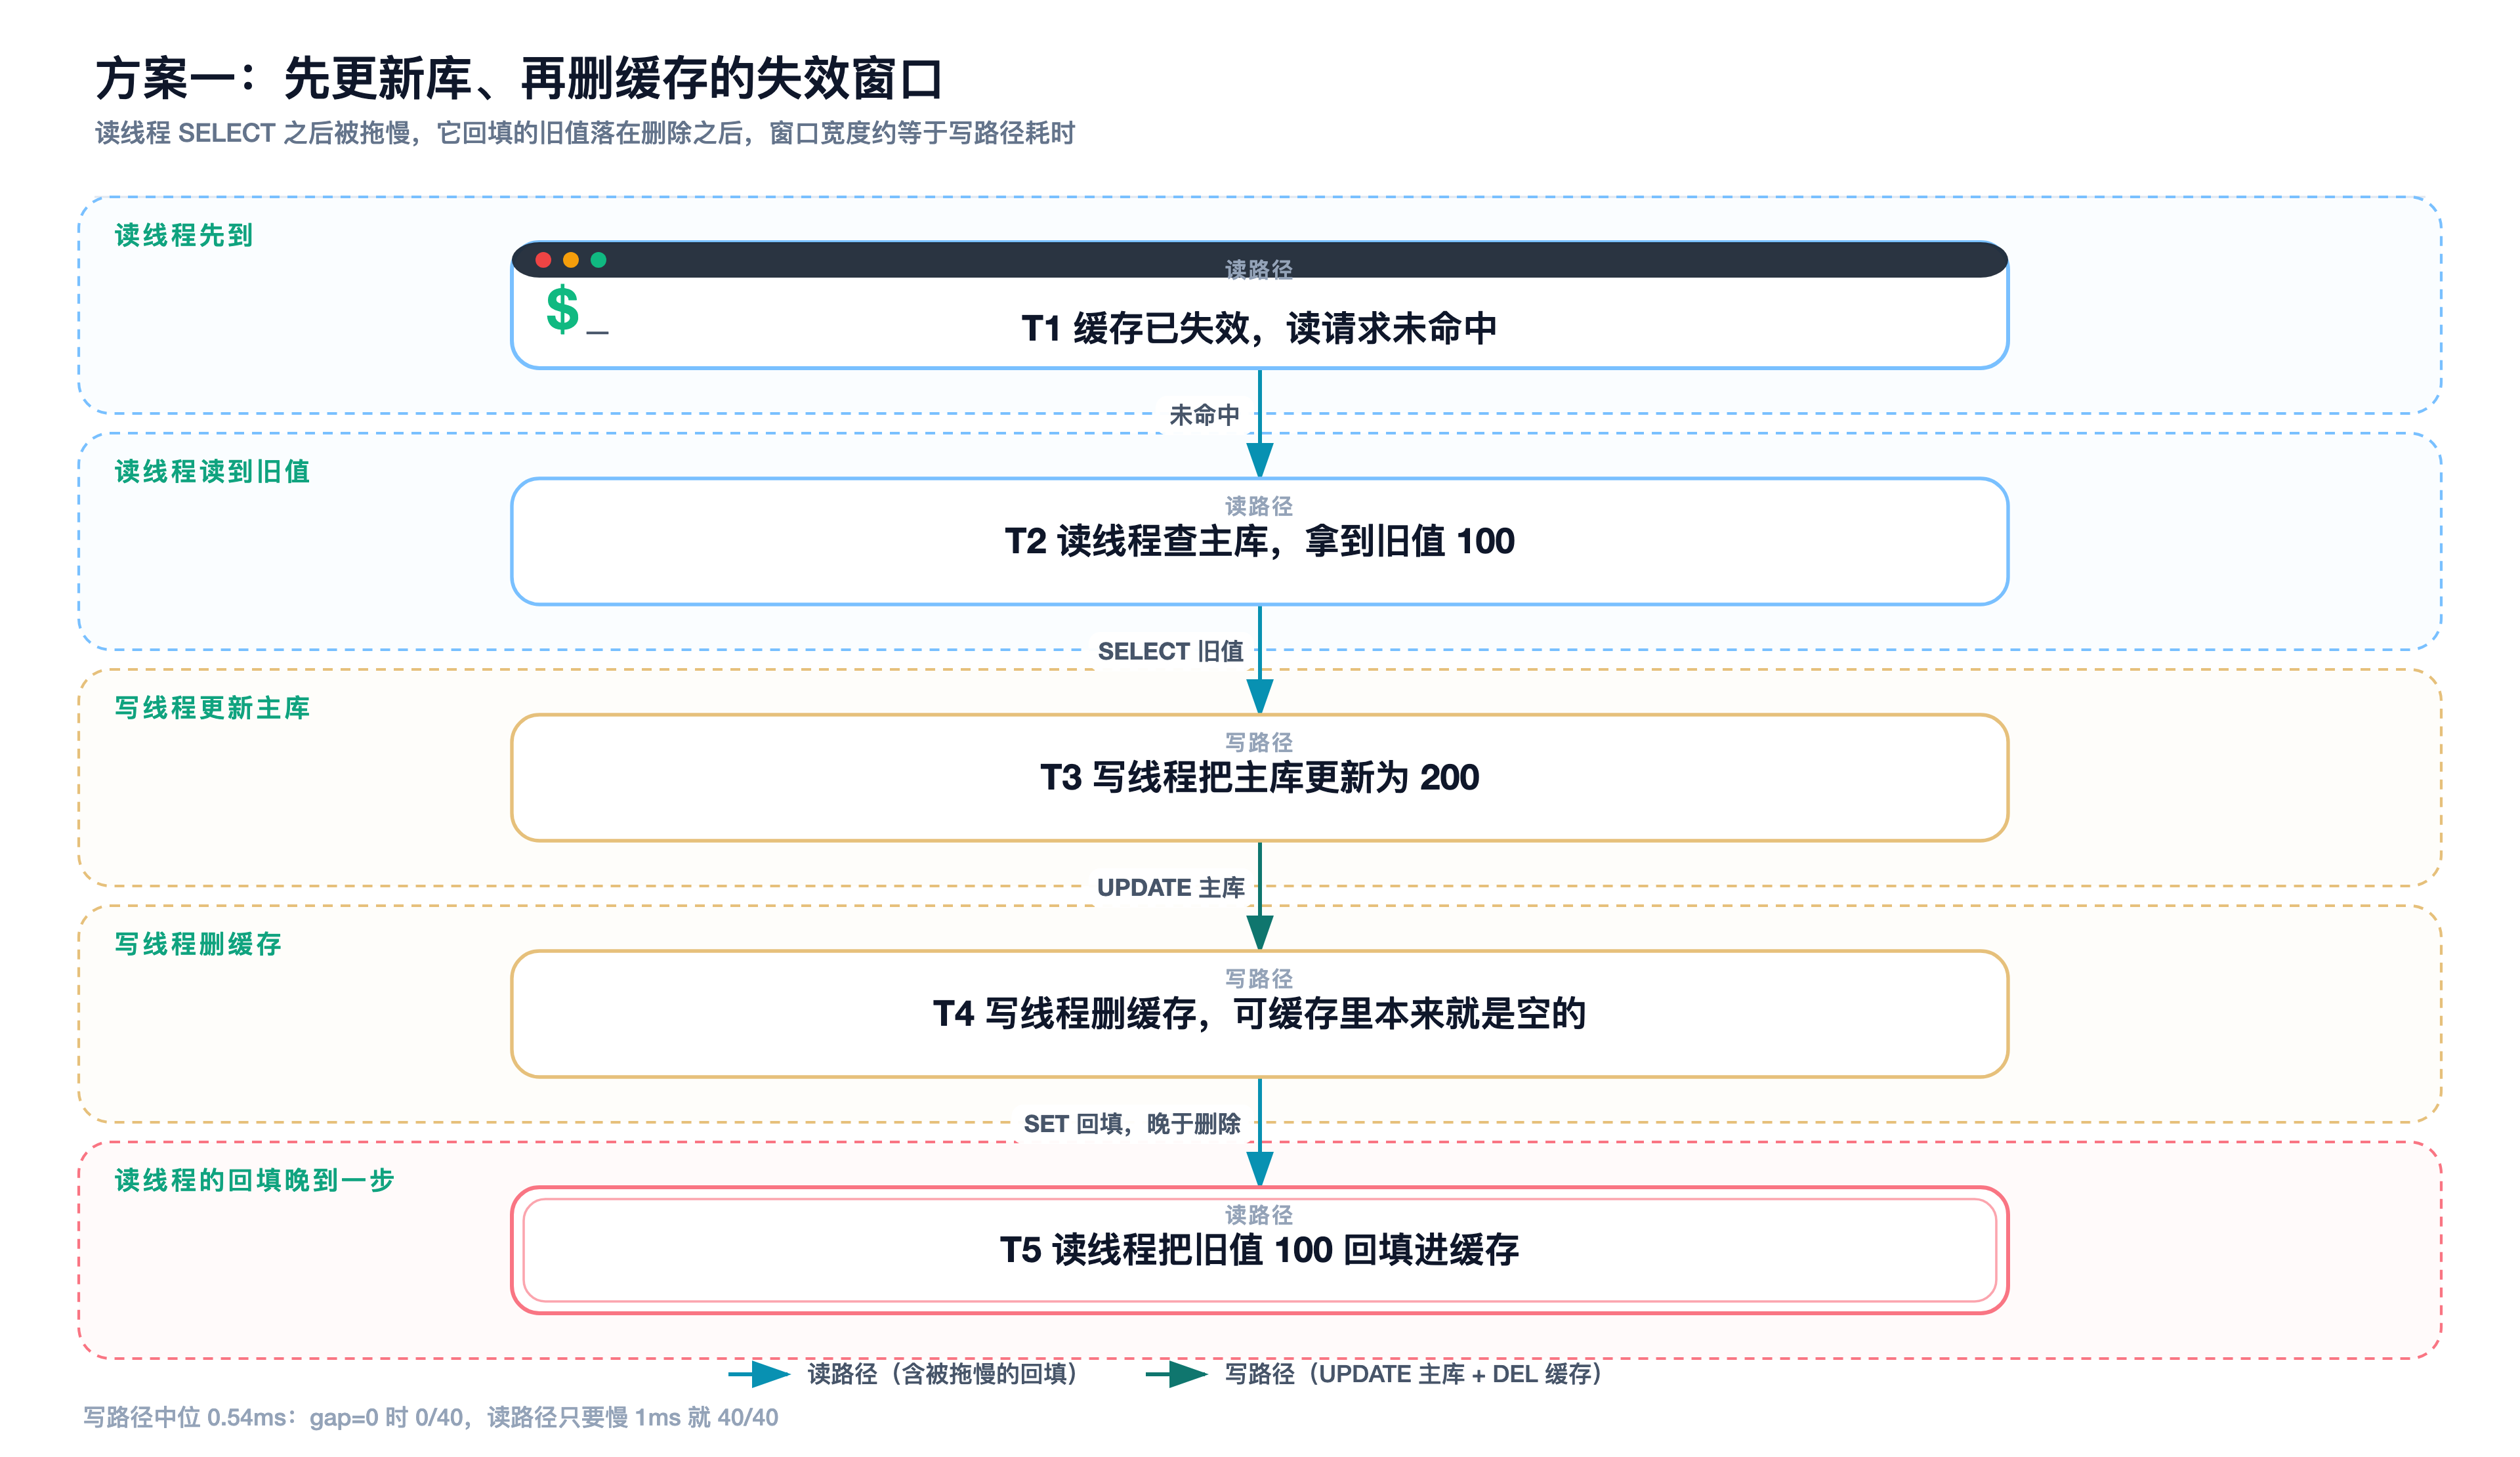
这个窗口不是概率问题,是一个宽度约等于写路径耗时的稳定缺口。本机量过写路径本身(UPDATE 主库 + DEL 缓存)的耗时:
写路径(UPDATE 主库 + DEL 缓存)单次耗时: 中位 0.54ms 最大 3.04ms
再扫读路径在 SELECT 之后被拖慢多少毫秒才回填,对照这个写路径耗时:
gap=  0ms -> 不一致  0/40
gap=  1ms -> 不一致 40/40
gap=  2ms -> 不一致 40/40
gap=  5ms -> 不一致 40/40
gap= 10ms -> 不一致 40/40
gap= 20ms -> 不一致 40/40
gap= 50ms -> 不一致 40/40
阈值正好卡在写路径自身耗时(0.54–3.04ms)附近。gap=0 时两边几乎同时落地,缓存里留下的还是新值,所以 0/40;只要读路径比写路径慢 1 毫秒,窗口就全开。它不是「理论上的小概率」,而是写路径跑完这一段时间里,任何慢一点的读都能钻进来。
纯自然竞争下不做任何对齐,也能撞出来:
A' 无任何对齐,自然并发: 不一致 63/1500 (4.2%)
1500 轮里 63 次,4.2%。这是本机观测值,依赖本机的 Redis/SQLite 往返耗时,不能外推到生产,但它说明「这个窗口概率很低、可以忽略」是靠不住的。
方案二:先删缓存、再更新库
这条顺序是中文社区里被讲得最多的「默认写法」,但它留下的脏值寿命最长。空窗时序:
- 写线程先删缓存
- 读请求未命中,查主库拿到旧值 100
- 读请求把旧值 100 写回缓存
- 写线程这才把主库更新为 200
- 缓存 100 对着主库 200,脏值驻留到下一次写
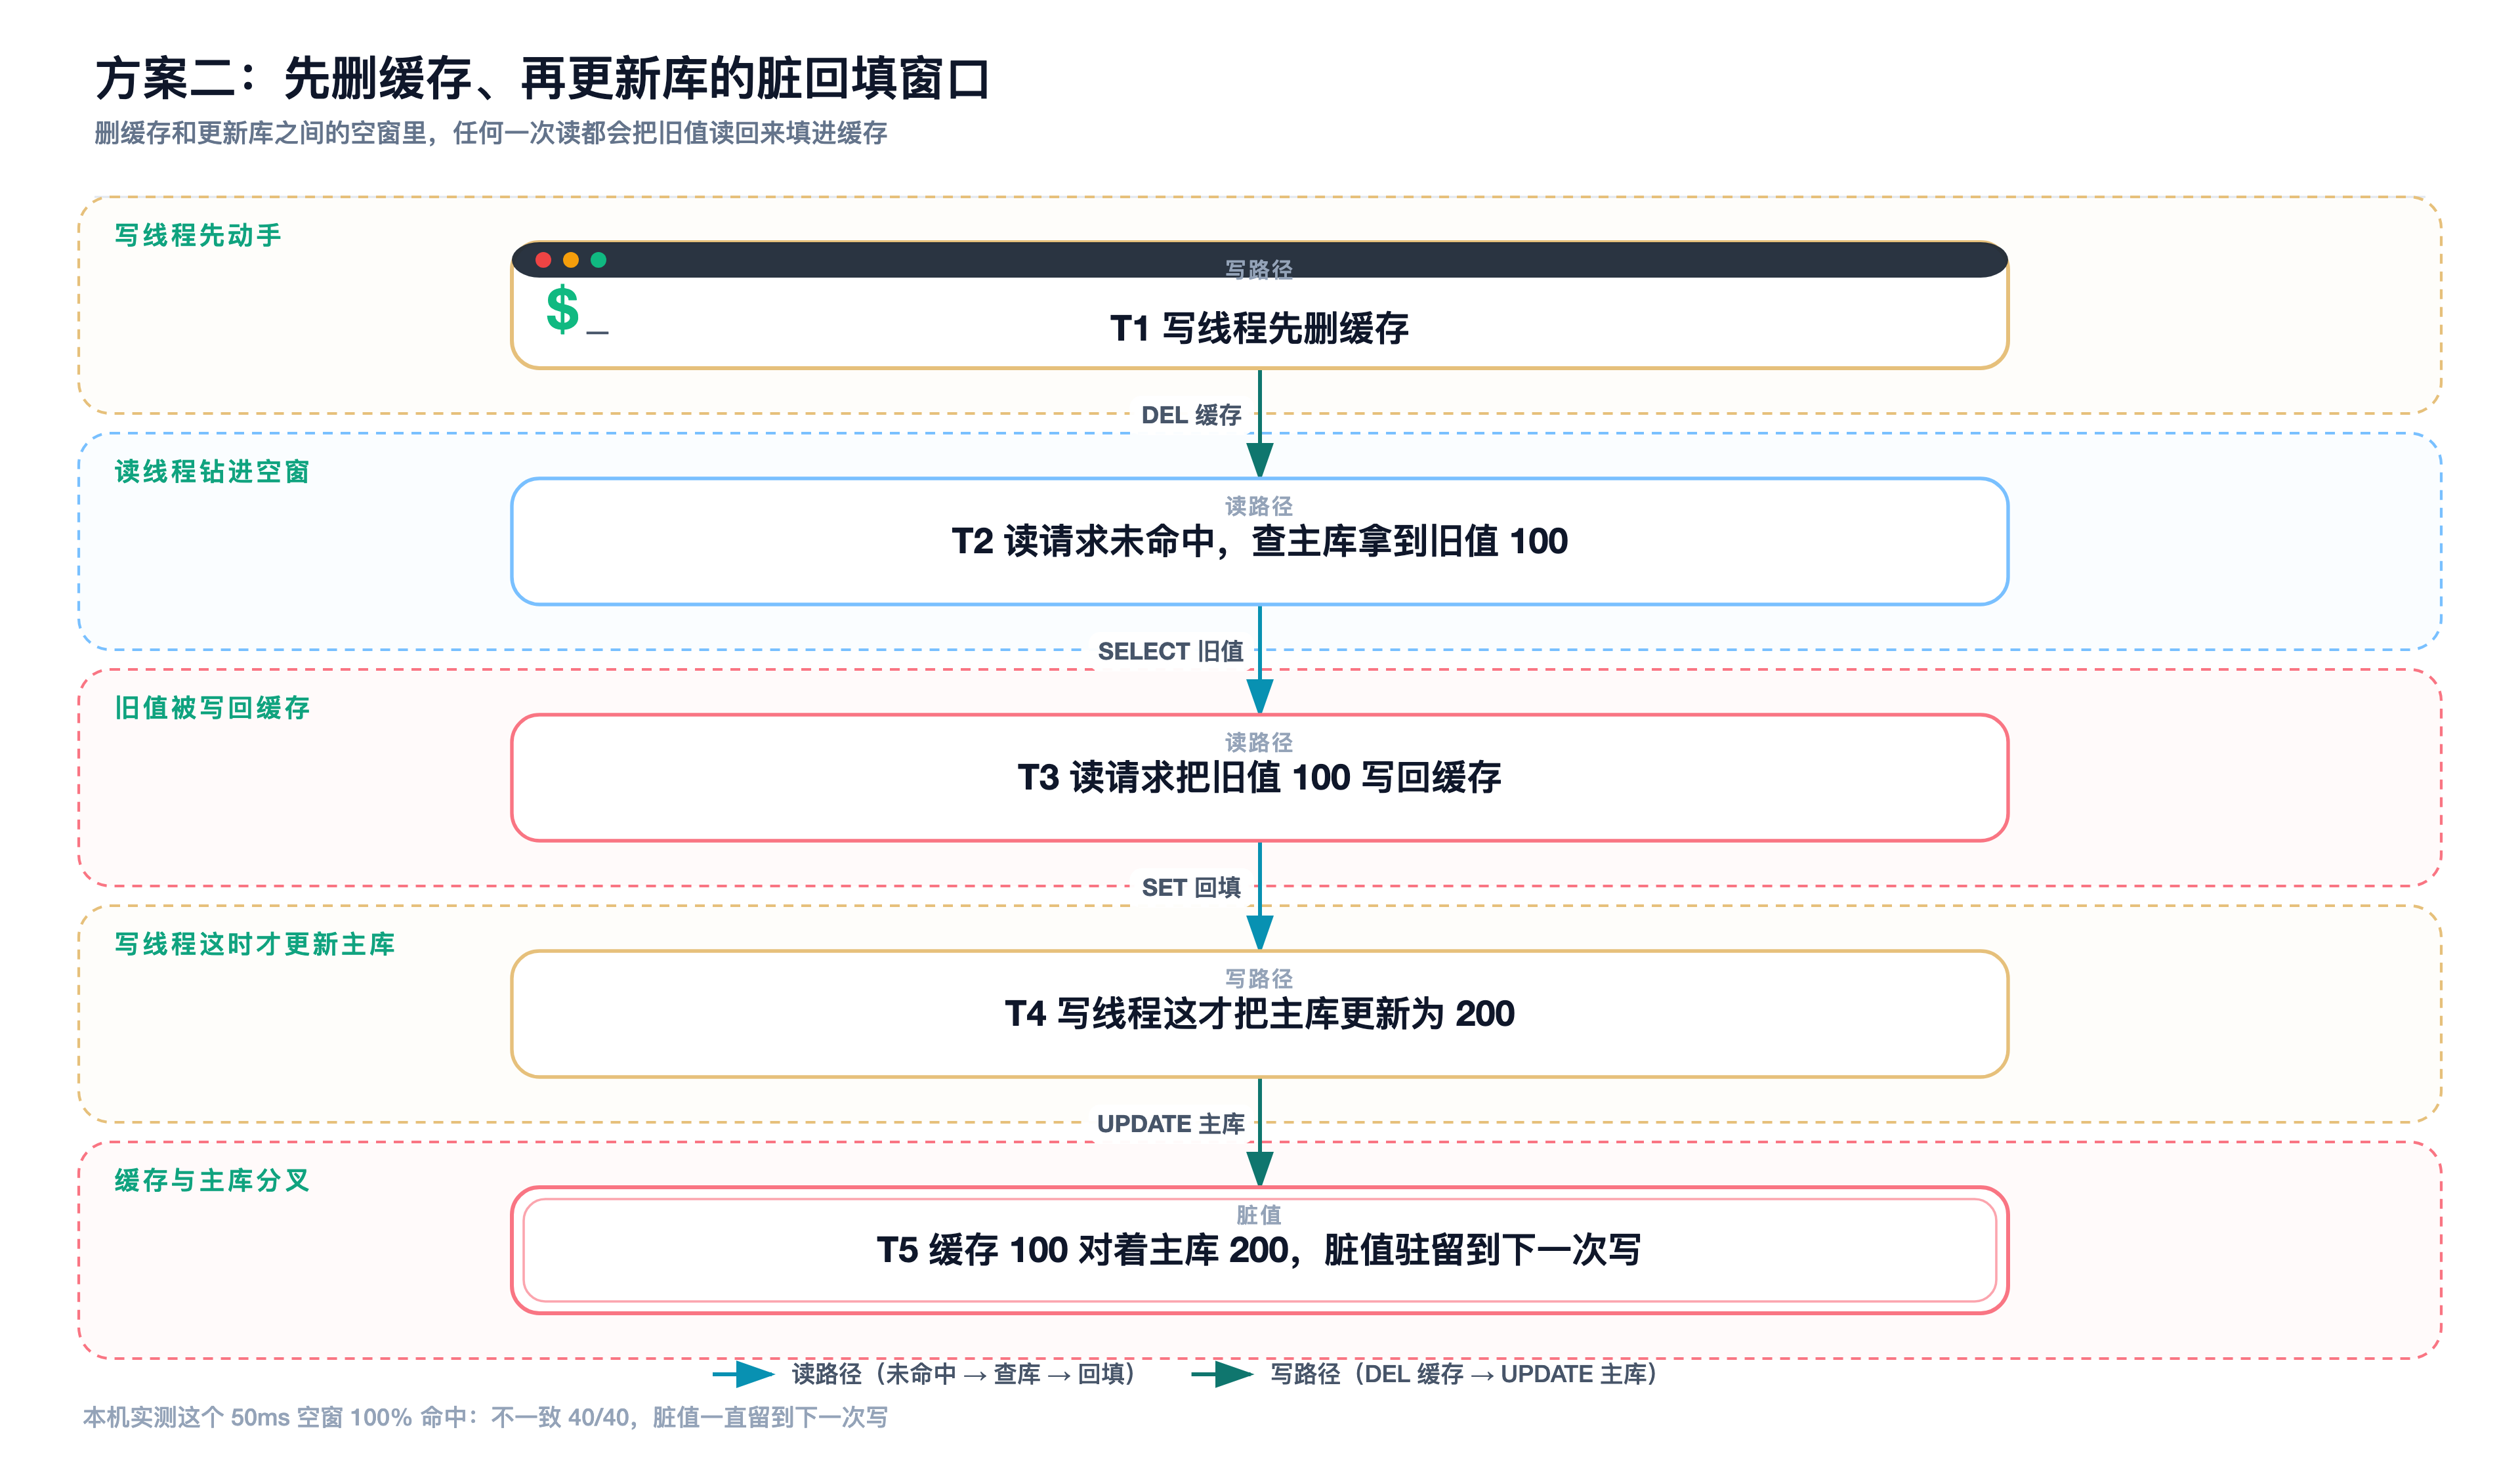
关键在第 5 步:缓存里的 100 不会因 TTL 自动消失,它会一直等到下一次写(下一次写又会走「删缓存」把它清掉,顺便回填新值)。主库已经是 200 了,缓存 100 在两次写之间对所有读都是错的。本机实测这个空窗 100% 命中:
B 先删缓存 -> 再更新库(空窗 50ms): 不一致 40/40
这是两条顺序里唯一「脏值可以长期驻留」的一种。方案一的脏值最多活一个 TTL,方案二能活到下一次写——这是两者最本质的差别,也是 Azure 和 Facebook 都选方案一的原因。
方案三:延迟双删
延迟双删想补的正是方案二的洞:先删缓存、再更新库、最后 sleep 一会儿再删一次,指望第二次删除能把方案二里被慢读回填的旧值清掉。
C 延迟双删 sleep=500ms、从库落后 2.0s:读路径回填耗时 vs 不一致数
    回填耗时= 100ms -> 不一致 0/8
    回填耗时= 200ms -> 不一致 0/8
    回填耗时= 300ms -> 不一致 0/8
    回填耗时= 400ms -> 不一致 0/8
    回填耗时= 500ms -> 不一致 0/8
    回填耗时= 600ms -> 不一致 8/8
    回填耗时= 800ms -> 不一致 8/8
    回填耗时=1200ms -> 不一致 8/8
阈值精确落在 sleep 时长上:500ms 及以内全部干净,600ms 及以上 8/8 全脏。
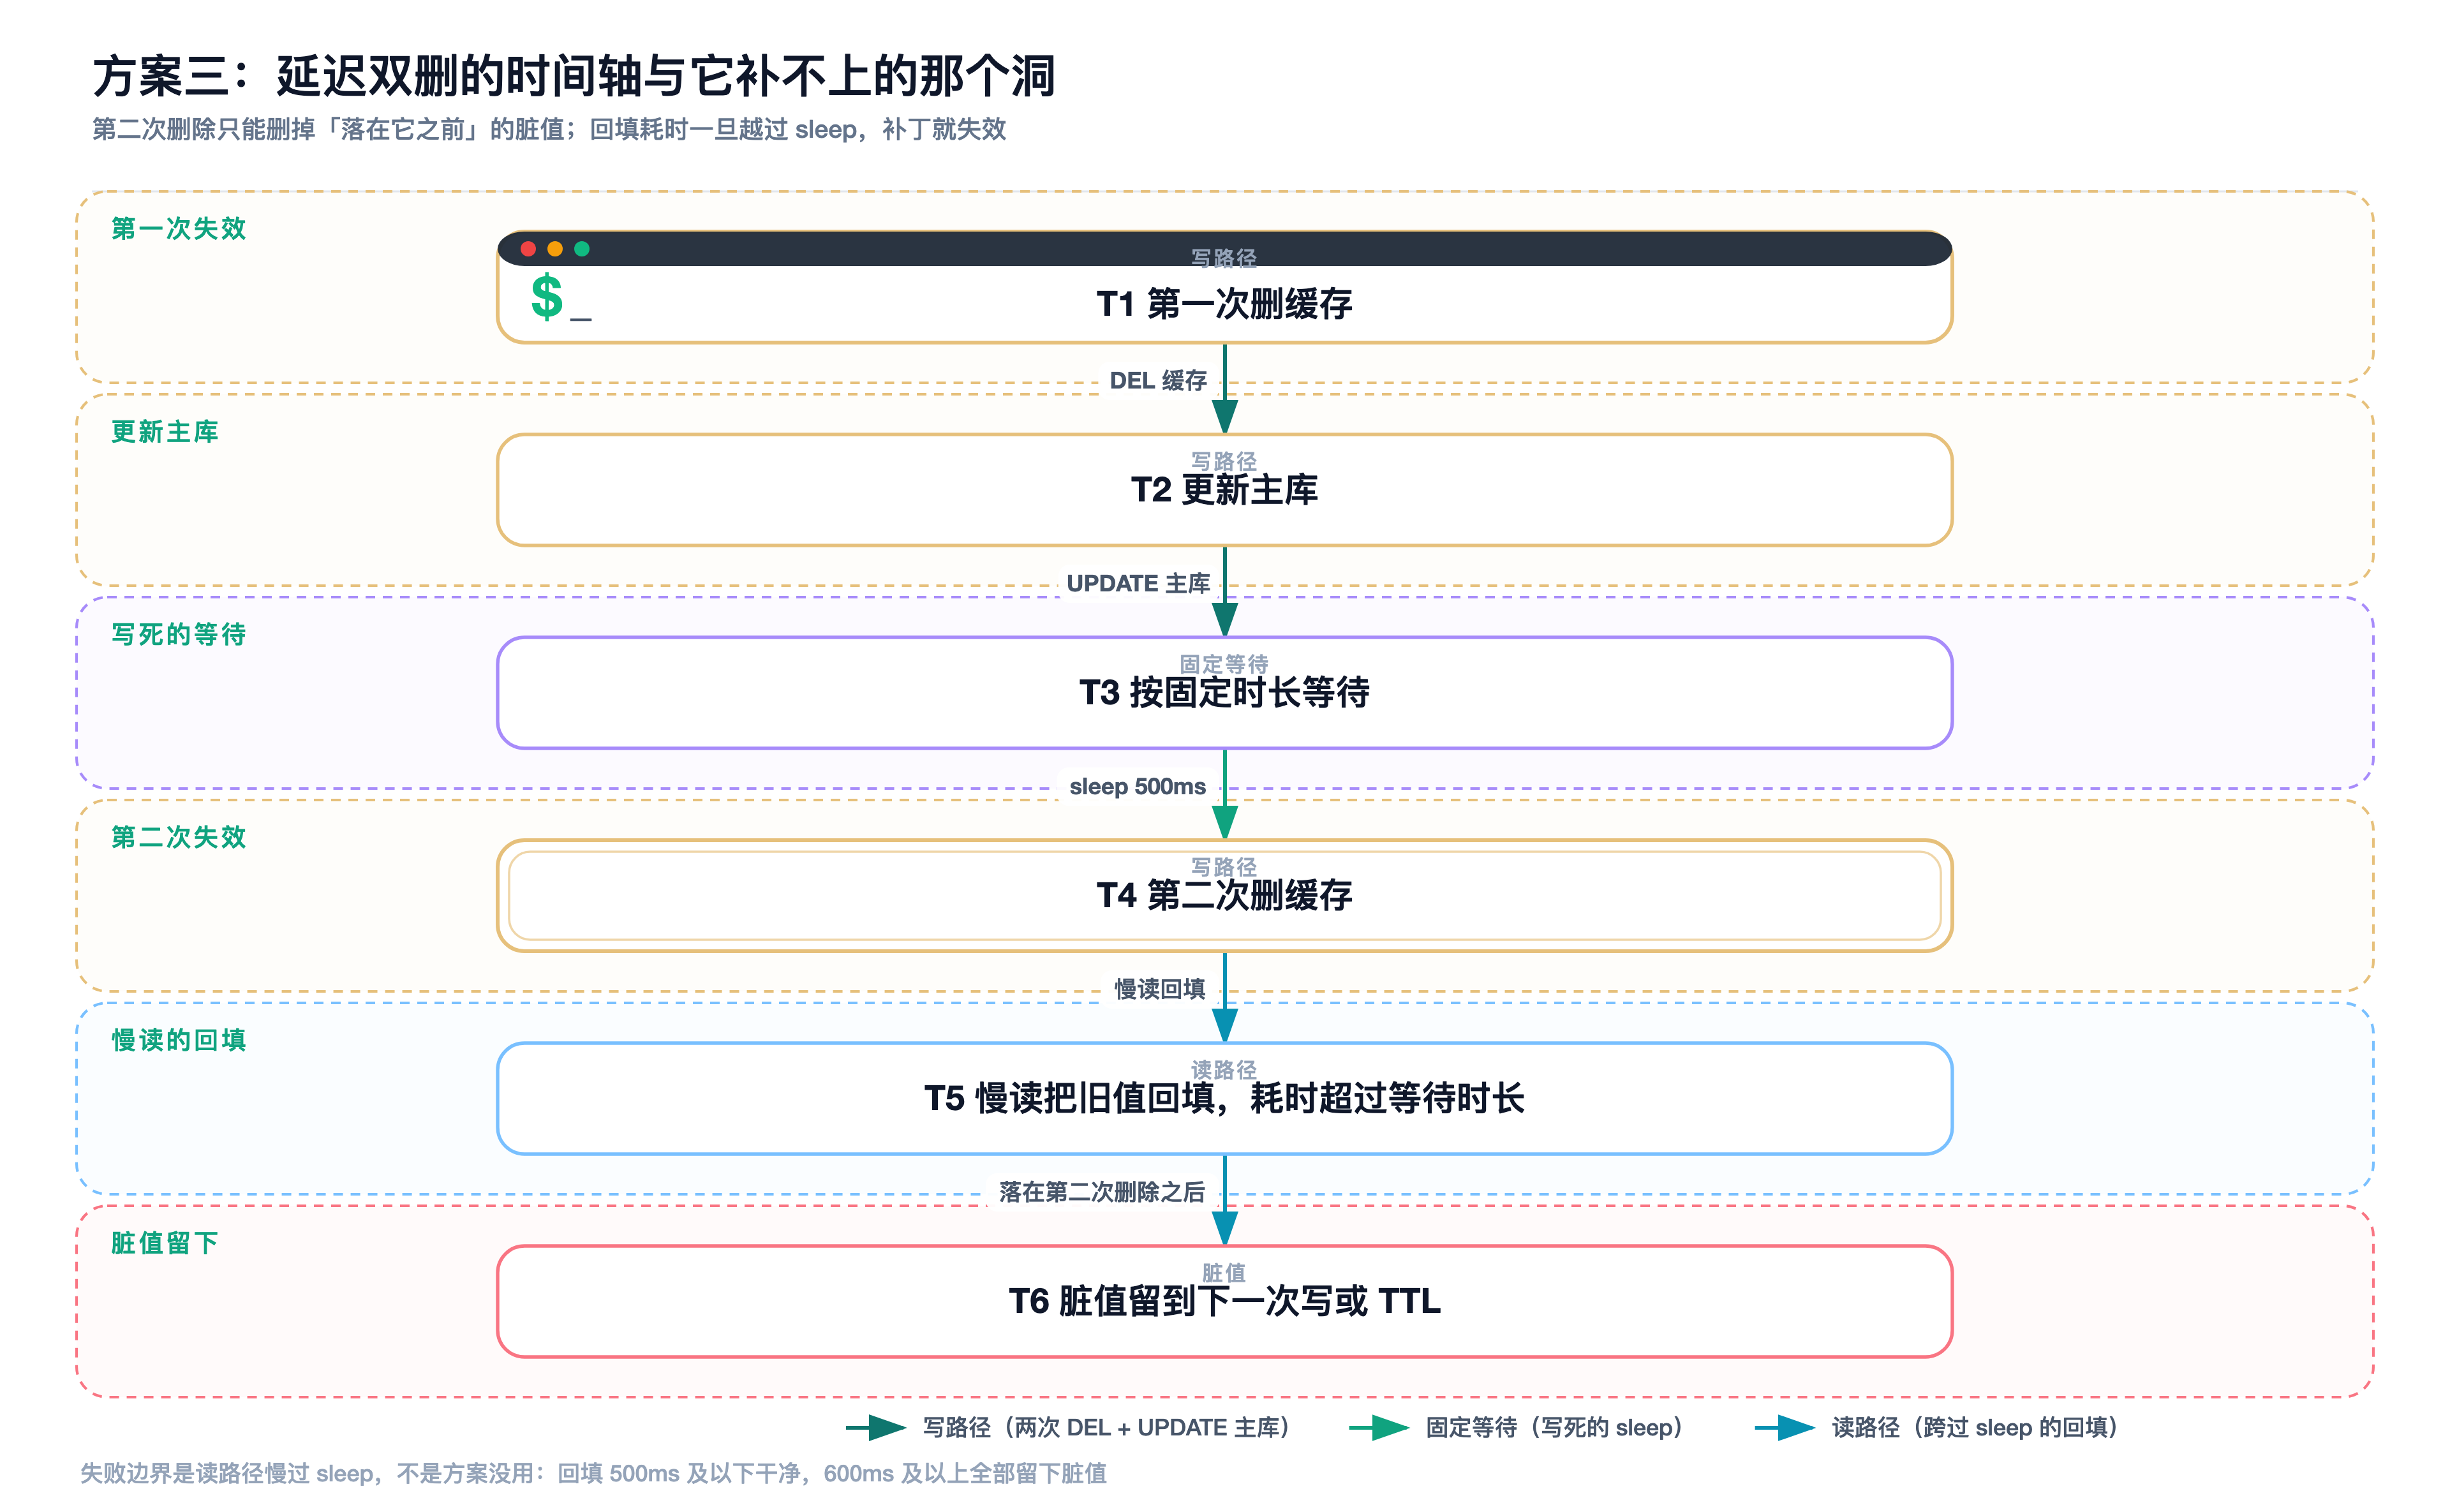
它的失败边界很清楚:读路径从查库到回填缓存的耗时,超过 sleep 时长,第二次删除就是在脏值落地之前白删一次。生产里这个耗时由网络抖动、GC、序列化、主从延迟共同决定,写死的 sleep 永远覆盖不住。除了这个边界,它还有四个工程缺陷:
- 休眠时长无法科学预估:sleep 设多少,取决于读路径耗时分布,而这在生产里是变量不是常量。
- 第二次删除没有可靠重试:业务线程 sleep 完发一次
DEL,失败了没有兜底,脏值照留。 - 侵入业务代码、占用调度资源:一次写变成「写 + sleep + 再写」,把本该在缓存侧的失效逻辑塞进业务线程。
- 极端主从延迟下旧值仍被二次写回:读走从库、从库落后,读到的就是旧值,再写回缓存,第二次删除也救不回。
所以延迟双删不是修复,是把不一致窗口往后推——只对「回填耗时 < sleep 时长」的读有效,不是一个可证明安全的方案。
双写(更新缓存)与官方的写穿透
回到开头那个判断:既然「删」是因为幂等,那「更新缓存」能不能靠版本号兜底?能,但得按 Azure 官方写穿透参考架构的规矩来,不是业务里随手 SET 新值。Azure 写穿透架构有三条硬规矩:
- 不承诺跨 Redis/SQL 原子事务:官方原话 "It doesn't provide atomic distributed transactions across SQL Database and Azure Managed Redis." 别指望一条事务同时写对两边。
- 同事务写 durable outbox + 幂等修复函数:SQL 事务里把「意图更新的缓存」写进一张持久化 outbox 表;如果 SQL 提交成功但 Redis 更新失败,outbox 条目留在那里,一个 repair function 之后补齐,且幂等。
- 缓存值带 rowversion / ETag:用 SQL 的 rowversion、版本号、时间戳或 ETag 标记缓存值,防止旧的修复/重试覆盖新的缓存条目。
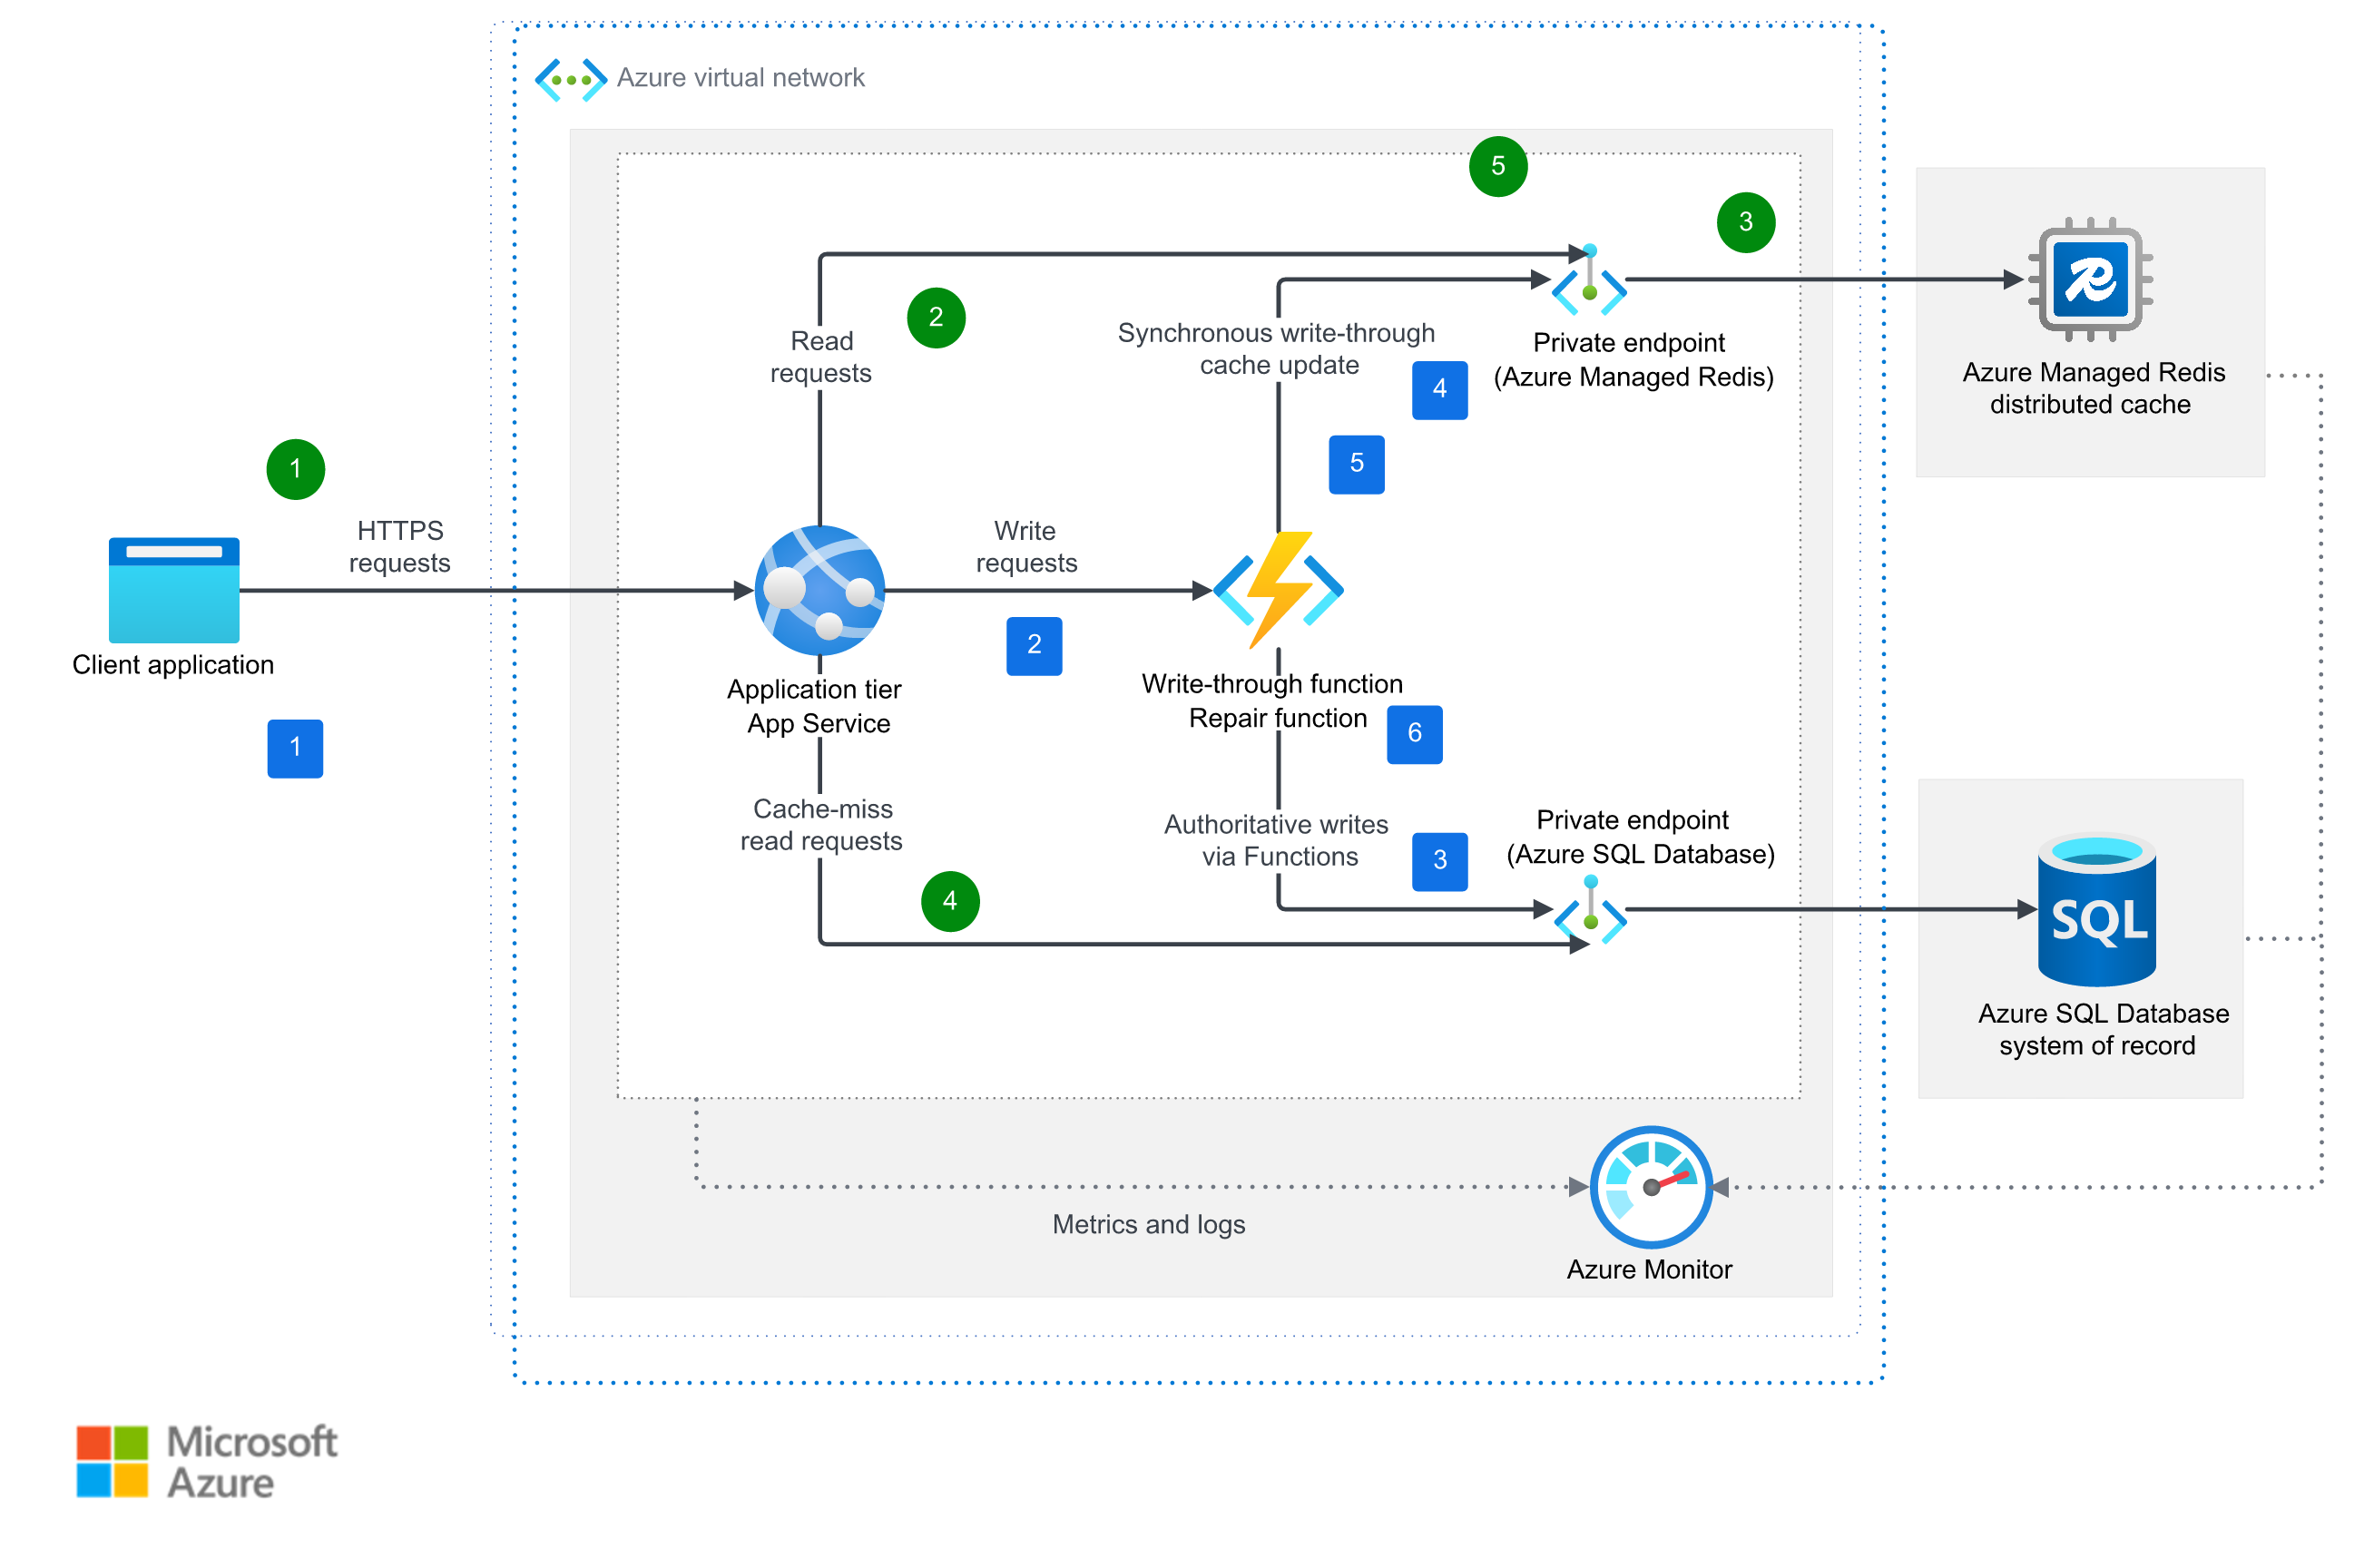
图源:Microsoft《Write-through caching with Azure Managed Redis and Azure SQL Database》,CC BY 4.0
大多数中文文章只讲「先更库再删缓存」,不提 outbox 修复这条兜底链。它解决的是方案二、方案三都绕不开的问题:Redis 更新失败怎么办。注意它的适用边界——Azure 明确只用于「读多写少、写后立刻要新值」的路径,且 TTL 仍要设,用来抵御部分失败、直连 SQL 的更新、部署 bug、漏删这些残留脏数据。
官方与工业界真正在做什么
把视角拉到 Facebook、Redis 官方这些真正跑大规模缓存的团队,他们做的事情有一条共同主线:把「失效」从业务代码里拿出来,做在缓存服务端或独立守护进程里。
Facebook 的失效守护进程叫 mcsqueal:部署在每台数据库上,扫描 MySQL 提交了的 SQL 语句,抽出其中的 delete,广播到同区域每个前端集群的 memcache。而且效率惊人——论文说只有 4% 的 delete 真的失效到了缓存(其余缓存里本来就没这个 key)。它不需要业务线程 sleep、不需要业务写两次删除,失效是 binlog 式的副作用。
为了挡「stale set」(并发 set 乱序把旧值写回),Facebook 用了 lease:一个绑定到具体 key 的 64-bit token,默认每 key 每 10 秒只发一次;客户端拿到 token 才能 set,验证失败就说明期间来过 delete,旧值不让写回。还有跨机房冷启动,memcached 的 delete 支持非零 hold-off 时间,默认冷集群的 delete 带 2 秒 hold-off——这 2 秒内拒绝 add,等价于「窗口内不接受回填」。
这一点要和延迟双删对照看:延迟双删想在业务线程里用 sleep + 再删一次模拟「窗口内别回填」,而 Facebook 把同一件事做在了缓存服务端(hold-off 拒绝 add)。服务端做,业务零侵入、不占调度资源、不依赖写死的 sleep;业务线程 sleep,四项工程缺陷一个都不少。
Redis 6+ 也给了服务端方案:client-side caching(服务端辅助的客户端缓存)。Redis 服务端记住每个连接读过哪些 key,key 被修改或淘汰时,向开了 tracking 的连接推一条失效消息,客户端收到后必须删掉本地缓存。两个义务要写进代码:连接断了必须清空本地缓存(否则这条连接会长期服务脏数据),以及失效消息丢了要有重建机制。
实战:本机可复现的最小实验
环境(本机实测,非生产数据):
- redis-server 6.2.6,端口 6390,
--save '' --appendonly no(纯内存) - Python 3.13.12 + redis-py 8.1.0
- 数据库用两个 SQLite 文件模拟 MySQL 主从:
demo.db是主库,replica.db由后台线程按固定周期同步,充当「从库落后 N 秒」
本机没有 MySQL,从库延迟是用定时同步的 SQLite 副本模拟的;这些是本机观测值,不是生产数据。 要验证的自变量只是「从库落后多少」,这与真实主从延迟对读写交错次序的影响是同一件事。
一致性判定只有一条:缓存里存在一个值、且与主库不同,才算不一致;缓存为空不算(Cache-Aside 的正常结束状态就是缓存被删掉,下一次读会回填新值)。
延迟双删实验的核心代码,从 reproduce.py 里摘出来:
def writer():
    r.delete(KEY)                  # 第一次删
    deleted.set()
    time.sleep(0.01)
    db_set(200)                    # 更新主库(从库 lag_s 后才追平)
    time.sleep(sleep_ms / 1000.0)  # 固定等待
    r.delete(KEY)                  # 第二次删

def reader():
    deleted.wait()
    r.get(KEY)                     # 未命中
    out["read_value"] = db_get(REPLICA)   # 从库还是旧值
    time.sleep(cost_ms / 1000.0)
    r.set(KEY, out["read_value"], ex=TTL)  # 回填
判定函数只有几行:
def inconsistent(r):
    cached = r.get(KEY)
    authoritative = db_get(PRIMARY)
    if cached is None:
        return False
    return str(cached) != str(authoritative)
跑出来的真实输出块(节选):
写路径(UPDATE 主库 + DEL 缓存)单次耗时: 中位 0.54ms  最大 3.04ms
A 先更新库 -> 再删缓存:读路径 SELECT 后拖慢 gap_ms 再回填
    gap=  0ms -> 不一致  0/40
    gap=  1ms -> 不一致 40/40
    gap= 50ms -> 不一致 40/40
A' 无任何对齐,自然并发: 不一致 63/1500
B 先删缓存 -> 再更新库(空窗 50ms): 不一致 40/40
C 延迟双删 sleep=500ms、从库落后 2.0s:读路径回填耗时 vs 不一致数
    回填耗时= 500ms -> 不一致 0/8
    回填耗时= 600ms -> 不一致 8/8
D 双写更新缓存(A 的缓存写拖后 40ms): 不一致 40/40
TTL=3s 的 key 实测存活 3.00s
怎么读这些数字:gap=1ms 就 40/40,说明方案一的窗口约等于写路径耗时(0.54–3.04ms),慢 1ms 必中;63/1500 是没对齐时的自然命中率,4.2%,破了「概率低」的侥幸;500ms 干净 / 600ms 全脏 把延迟双删的边界钉在 sleep 时长上;40/40 两次出现,分别证明方案二(脏值驻留)和双写更新(旧值覆盖)的可复现;最后 TTL=3s 实测存活 3.00s 给唯一无条件生效的兜底一个实测锚点。
生产侧如果你用 Java/Spring,先更新库再删缓存的最小写路径长这样(示例代码,未执行,仅示意):
// 示例:Spring 写路径,先更新库再删缓存 + TTL。未执行,仅示意
@Transactional
public void updateAmount(long id, int amount) {
    accountMapper.updateAmount(id, amount); // ① 先更新 MySQL
    redisTemplate.delete(cacheKey(id));      // ② 再让缓存失效
}
缓存的 TTL 在 cacheKey(id) 的写入口配置(比如 3s),它是唯一不依赖任何链路的兜底,无论选哪条方案都不要省。
决策规则
把上面的证据落到选择上,按场景取:
- 能容忍最长一个 TTL 的旧值 → 先更新库、再删缓存 + TTL,不引入任何中间件。这是大多数读多写少业务的最优解。
- 写后要立刻读到新值、且读多写少 → 写穿透 + 同事务 outbox + 幂等修复,缓存值带版本号(ETag / rowversion)。用 Azure 的三条规矩兜底 Redis 更新失败。
- 不能容忍任何脏读(余额、库存、状态机) → 不要在这个读路径上放缓存,或者把读写串行化(分布式锁 / 单 key 串行队列)。一致性要求高到这一步,缓存的代价就不只是「偶尔旧值」。
- 已经有 MQ 或 CDC 基建 → 业务只写库,用 binlog 驱动的异步失效替换业务代码里的 delete。Facebook 2013 年就是这么做的(mcsqueal 扫 commit log 广播 DEL)。
- 无论选哪条,TTL 必须设——它是唯一不依赖任何链路的兜底,专门接住部分失败、直连 SQL 的更新、漏删这些残留。
最重要的边界收一句:方案一(先更新库再删缓存)的脏值最多活一个 TTL,方案二(先删缓存再更新库)的脏值能活到下一次写,两者差一个量级——所以凡是你见到的「先删缓存」写法,先问它能不能接受两次写之间的全部读都是错的。下一步最小行动:打开你项目里所有 updateXxx 之后跟 redisTemplate.opsForValue().set(...) 的地方,确认它走的是删缓存而不是更新缓存,再补上 TTL。
———
更多 Java/Go 架构干货 + AI 提效实战,关注「码哥跳动」持续更新。
觉得有收获,转发给你的技术同事 —— 一篇好文章值得被更多人看到。


 浙公网安备 33010602011771号