
AI 拆 PRD 不是甩手掌柜:三段 Prompt 链把任务树拆到能直接排期

需求评审通过了,下周一要开 Sprint Planning。我把一份 8 页 PRD 扔给 Claude 让它「帮我拆成 Jira 任务」。五分钟后回来:38 张卡,标题整齐,估点整齐,看上去挺像样。我随手点开一条「实现登录功能」——估点 5,依赖「无」。再点开「支付网关对接」——估点 8,依赖「无」。再翻回去看「数据库表结构设计」——估点 3,依赖「无」。
这就是问题:AI 默认给你的是「无依赖的扁平任务列表」,而真实研发是「带依赖的有向图」。把它扔进 Sprint 排期会的第一天下午,前端同学会发现后端 schema 还没出;DBA 会发现有人已经把代码合进 main 还没等他 review;Scrum Master 会发现「5 点」实际花了 12 个工时,burndown 曲线当场崩盘。
我之前那篇《技术方案怎么用 AI 写》解决的是「评审前怎么搭骨架」,这篇解决的是「评审通过后怎么把 PRD 拆到能直接排期」。链路打通后,PRD → 方案 → 任务清单 → 排期这条 AI 提效主轴才完整。
这篇不讲「AI 帮你拆任务多省时间」,给一条三段 Prompt 链(需求拆解器 → 估点与依赖修正器 → INVEST 审查器),配三道人审关卡,外加 3 个可逐字抄的模板、1 份真实 PRD 输入 → AI 输出对比、3 个 AI 拆任务的盲区与对应修正。模板工具无关,ChatGPT / Claude / 通义都能跑。走完这套流程,你带进排期会的任务清单是「带估点税、带依赖图、每张卡都过 INVEST 6 维审查」的产物。
先划边界:AI 负责让任务「多而齐」,你负责让任务「少而准」
任务拆解的瓶颈不是「拆」是「拆完能不能排」。把 PRD 拉成 30 条结构化任务,AI 能干得很好;让每条任务的估点可信、依赖显式、质量过 INVEST 6 维审查,AI 干不了——这三条都需要项目上下文和工程判断。
2026 年 1 月发在 Journal of Intelligent Information Systems 上的一项研究把这件事量化得很清楚:传统 Story Points 在 LLM 辅助开发里,解释力只有 72% 左右,剩下 28% 的 variance 来自「验证税」——读代码、验证、重写、Review。换句话说,传统估点假设「写代码是瓶颈」,但 AI 时代「读和验证代码」才是瓶颈。一条 AI 估 3 点的任务,实际开发 + 让 AI 重写 2 遍 + 自己 review 1 遍 + 修边角 bug,往往要 8 个工时。
这意味着,AI 拆任务最容易翻车的地方不在「拆得不够细」,而在三件事:估点没把验证税算进去、依赖只看到 import 看不到 runtime 耦合、INVEST 拆分没人审就进了 Sprint。每一条都有具体的翻车姿势,对应具体的修正策略——后面讲。先把全流程摆出来。
工作流总览:三段 Prompt 链,卡三道人审关
最常见的误用是一个巨型 Prompt 打过去:「这是我的 PRD,帮我拆成 Jira 任务,每条估点、标依赖、写验收标准」。出来的东西工整漂亮,然后你把任务卡贴上墙——前端同学看着「调通支付接口(估点 5)」问「schema 在哪」、DBA 看着「建支付表(估点 3)」问「谁 review」、Scrum Master 看 burndown 当场裂开。
我的做法是把「PRD 到 Sprint」拆成三段,每段只干一件事,每段产出过一道人审关才放行。三段之间的边界是真实的瓶颈:拆解器解决「能不能拆出够细」,修正器解决「估点和依赖对不对」,审查器解决「能不能进 Sprint」。
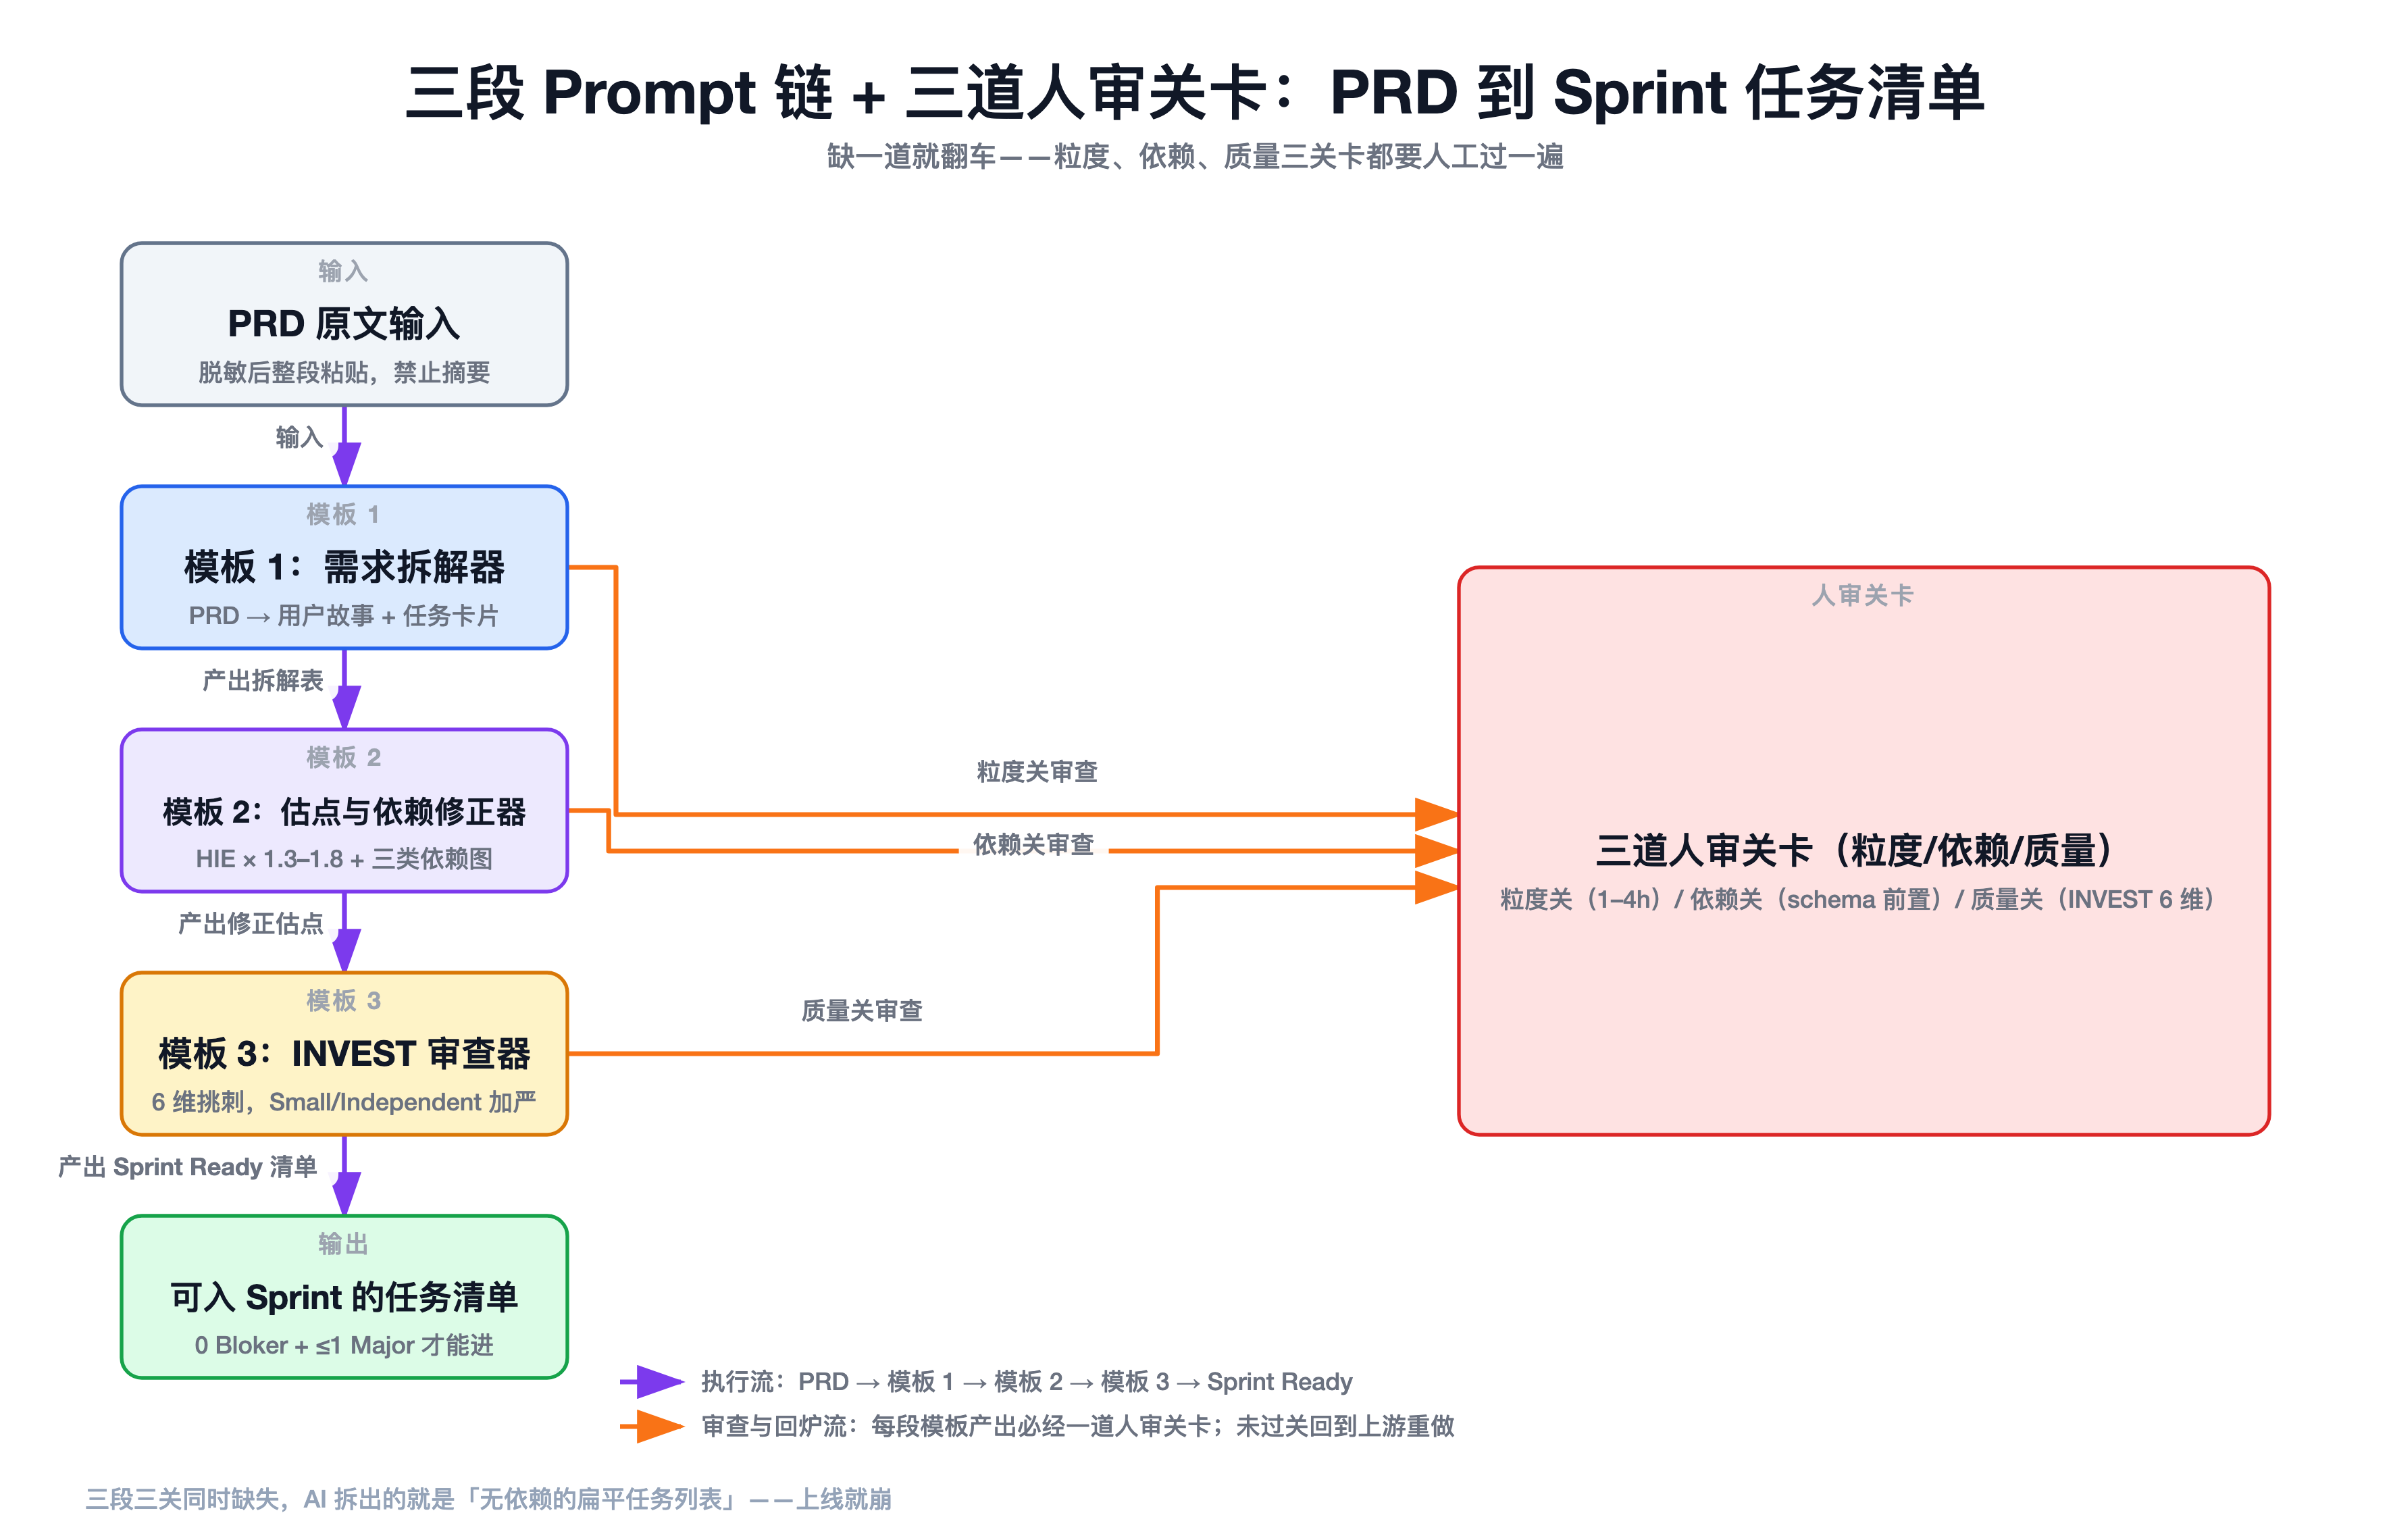
第一段,需求拆解器:把 PRD 原文喂进去,按 INVEST 6 维强制拆解成用户故事 + 任务卡片。人审关 ①(粒度关):任何任务 > 4 小时或 < 1 小时必须回炉重拆。
第二段,估点与依赖修正器:把拆解结果喂回去,要求 AI 显式列「验证/重写/Review 三步骤」并按 HIE 模型 × 1.3–1.8 修正估点;同时把依赖按 schema / interface / infrastructure 三类显式建图。人审关 ②(依赖关):schema 依赖未前置 = Bloker;infrastructure 任务未单独成卡 = Bloker。
第三段,INVEST 审查器:让 AI 扮演最严苛的 Scrum Master + Tech Lead,按 INVEST 6 维给每张卡打分,挑出 Bloker / Major / Minor 三级问题。人审关 ③(质量关):任何 Bloker 未清零,任务不进 Sprint。
两个回炉通路要有:粒度关没过,回去重新喂模板 1(不是补一两条,是整套重拆);依赖或质量关没过,回到对应模板补完再走。
模板 1:需求拆解器——把 PRD 拉成「故事 + 任务」两级
拆不下去,十次有八次不是 prompt 没写好,是 PRD 没读懂。第一步千万别让 AI「帮我拆任务」,让它当「结构化拆解员」,按 INVEST 6 维强制产出两级产物:用户故事(独立可交付的功能单元)和任务卡片(故事下面的具体动作)。
你是资深 Scrum Master,我手上有一份 PRD,下周一开 Sprint Planning。
请你当我的「需求拆解器」:不要给技术方案、不要写代码,只做 PRD 结构化拆解。

【输入材料:PRD 原文】
<<<
(这里完整粘贴 PRD。涉密内容先脱敏:
 替换真实服务名、表名、字段名、接口路径、数字量级)
>>>

【背景信息】
- 业务背景:(一句话说清楚做什么、给谁、解决什么问题)
- 团队技术栈:(例如 Java + Spring Cloud + MySQL + Redis + Kafka)
- Sprint 周期:(例如 2 周)
- 团队速度:(例如历史 30 点/人/周)

【强制输出格式:两级产物】
一、用户故事表(每条按 INVEST 6 维写,字段留空的标「待补」)
| Story ID | 标题 | 角色 | 我想要... 以便... | 独立? | 可协商? | 有价值? | 可估点? | 够小? | 可测试? |
注:6 维里有任一项「否」,必须当场重写这条故事

二、任务卡片表(每个故事拆 3-8 条任务)
| Task ID | 所属 Story | 任务名 | 估点(人时) | 优先级 P0/P1/P2 | 验收标准(Given/When/Then)| 依赖类型 schema/interface/infrastructure/无 | 依赖对象 |
注:所有估点必须按 1-4 小时粒度

【硬性约束】
- 不允许编造 PRD 里没有的功能点;信息不足就写「待补」
- 任务粒度不在 1-4 小时之间的,必须当场重拆
- 不允许给技术选型建议,那是方案阶段的事
- 用户故事少于 3 条 = 你没认真读 PRD,重读再来
- 任务卡总数不要超过 30 条,超过说明你没合并
用法有两个要点。第一,「依赖类型」三栏是这套模板的灵魂:schema 必须是数据库表/字段/索引创建类任务、interface 是 API 契约/类型定义类任务、infrastructure 是配置中心/缓存预热/部署脚本类任务。AI 默认会把所有依赖写成「无」,这三栏是逼它显式分类的钩子。第二,INVEST 6 维是「即时质检」,不是「后续审查」——某条故事只要有一维不达标,必须当场重写;不要堆到后面让 INVEST 审查器兜底,那时改起来更贵。
真实示例:PRD 输入 vs AI 输出
我拿一个通用业务场景(订单系统的「拼团功能」)做对比,所有内容都是示例场景,不是我司真实数据。
输入 PRD 摘要(示例场景,约 200 字):
需求:订单系统新增「拼团」功能。用户可发起拼团、邀请好友参团、达到人数成团、拼团失败自动退款。
范围:仅微信小程序端;不支持团长免单;不支持跨团合并。
非功能:拼团有效期 24 小时;并发 1000 团/分钟。
AI 一次性「帮我拆任务」输出(坏拆分示例):
| Task | 估点 | 依赖 |
|---|---|---|
| 实现拼团功能 | 13 | 无 |
| 实现拼团支付 | 8 | 无 |
| 实现拼团退款 | 5 | 无 |
| 测试拼团 | 5 | 无 |
问题一眼可见:每条都「无依赖」、粒度全超 4 小时上限、没有任何 schema/interface/infrastructure 拆出。
走模板 1 后的输出(好拆分示例,节选):
| Story ID | 标题 | 投资可估可小可测试 |
|----------|------|---------|-----|-----|
| US-001 | 团长发起拼团 | ✅✅✅✅✅✅ |
| Task ID | 所属 | 任务名 | 估点 | 依赖类型 | 依赖对象 | 验收(节选) |
|---|---|---|---|---|---|---|
| T-001 | US-001 | 建拼团主表 t_group_buy(schema) | 3h | schema | 无 | migration 可在空库执行 |
| T-002 | US-001 | 建拼团成员表 t_group_member(schema) | 2h | schema | T-001 | 同上 |
| T-003 | US-001 | 定义拼团状态机常量(interface) | 1h | interface | T-001 | 状态枚举含 PENDING/SUCCESS/EXPIRED |
| T-004 | US-001 | 团长开团 API(interface) | 3h | interface | T-001, T-003 | POST /api/v1/group/create 返回团 ID |
| T-005 | US-001 | 微信分享链接生成(infra) | 2h | infrastructure | 无 | 二维码含团 ID 和签名 |
差别是结构性的:好拆分把所有依赖显式分类,schema 任务全部排在最前面,每条都在 1–4 小时区间,验收标准具体到 Given/When/Then。坏拆分是 AI 默认的「无脑摊平」。
模板 2:估点与依赖修正器——把验证税算进估点,把依赖建成有向图
模板 1 的估点还是「乐观估点」,实际开发至少要叠上验证税。模板 2 要解决两件事:让估点反映真实 effort,让依赖显式分类并按方向建图。
你是资深 Tech Lead,请扮演「估点与依赖修正器」。
输入是上一轮「需求拆解器」产出的任务卡片表,
你要做两件事:修正估点 + 建依赖图。

【输入:模板 1 的任务卡片表】
<<<
(完整粘贴模板 1 的输出)
>>>

【背景信息】
- 团队历史速度:(例如「过去 3 个 sprint 数据:1 点 ≈ 2.5 实际工时」)
- 本次任务的 AI 协作预期:(例如「会用 Cursor 写 60% 代码、需要人工 review + 重写 1-2 轮」)

【输出 1:估点修正表】
| Task ID | 原估点(人时) | 验证/重写/Review 步骤 | 验证税系数 | 修正估点(人时)| 估点置信度 |
|---------|--------------|----------------------|------------|---------------|------------|
注:
- 验证税系数参考区间 1.3-1.8:常规 CRUD 取 1.3,新接口/新表取 1.5,复杂算法/性能优化取 1.8
- 修正估点 = 原估点 × 验证税系数(向上取整到 0.5h)
- 估点置信度 = 高(>4h 已分过 task)/中(3-4h)/低(<3h 但接口未稳)

【输出 2:依赖有向图】
按 schema / interface / infrastructure 三类分别列出:
- schema 依赖:哪些任务必须先建表/字段
- interface 依赖:哪些任务的 API/类型契约先定
- infrastructure 依赖:哪些配置/部署/缓存预热必须先做

输出格式:
| Task ID | 依赖类型 | 依赖对象 Task ID | 依赖性质(强/弱)| 备注 |
| 强依赖 = 不完成则任务无法开始;弱依赖 = 可以并行但需协调

【硬性约束】
- 不允许「无依赖」= 0 行;任何任务都有至少一类依赖
- schema 任务必须排在最前面(编号最小)
- infrastructure 任务必须单独成卡,不得隐藏在某个 interface 任务里
- 修正估点超过 16h 的任务必须 Spike 拆分(不是平均分,是按风险维度切)
用法两个关键。第一,验证税系数不是死数——它来自你们团队过去 3 个 sprint 的「计划点 vs 实际小时」之比;2024-2025 跨 50,000+ 故事的对照研究表明,AI 估点本身 ±20% 准确率 67%,叠加「AI 重写 + 人工 review」的验证活动后,AI + 团队组合才能到 74%。这 7 个百分点的差就是验证税的来源。第二,schema / interface / infrastructure 三栏是这次模板的核心增量——AI 默认会把所有依赖写成「等后端」,三栏是逼它看到「等数据库建表」「等 API 契约」「等配置下发」这些隐性等待。
模板 3:INVEST 审查器——按 6 维挑刺,过关才能进 Sprint
模板 2 解决了估点和依赖,模板 3 解决最后一道:为什么 AI 拆出的「合理任务」进了 Sprint 还是会崩? 因为 INVEST 拆分没人审。2026 年 DeepQuali 项目和 CIbSE 2026 上 GPT-5.1 的 INVEST 工业研究都表明:LLM 作为 INVEST 评审员与专家一致性达 85-90%,但在 Small 和 Independent 两个维度更保守(甚至误判合格)——而这两个维度恰恰是 sprint 翻车的高发区。
你是最严苛的 Scrum Master + Tech Lead + QA,请扮演「INVEST 审查器」。
输入是模板 2 修正后的任务卡片表,你要按 INVEST 6 维逐条挑刺。

【输入:模板 2 产出的任务卡片表 + 估点修正表 + 依赖图】
<<<
(完整粘贴)
>>>

【输出:INVEST 审查报告】
| Task ID | I | N | V | E | S | T | 问题分级 | 修改建议 |
|---------|---|---|---|---|---|---|----------|----------|
- I = Independent(独立):是否不依赖其他未完成任务
- N = Negotiable(可协商):细节是否留了实现讨论空间
- V = Valuable(有价值):是否对用户/业务有可见价值
- E = Estimable(可估点):修正估点后是否有合理数字
- S = Small(够小):是否在 1-4 小时区间
- T = Testable(可测试):验收标准是否可独立验证

【问题分级】
- Bloker(阻断):任何一维严重不达标,本条任务**禁止进 Sprint**
- Major(重大):建议本 sprint 不接,留作下个 sprint 重拆
- Minor(次要):可进 sprint,但需在 DoR 上加备注

【硬性约束】
- Small 维度从严:修正估点 > 4h 一律 Bloker
- Independent 维度从严:依赖链 > 3 层一律 Major
- Testable 维度从严:验收标准不含 Given/When/Then 一律 Major
- 报告末尾输出「Sprint Ready 任务清单」:仅含 0 Bloker + ≤1 Major 的任务
用法两个关键。第一,Small 和 Independent 两条必须从严——这是 2026 年研究明确指出的「LLM 容易误判」的两个维度,宁可错杀。第二,审查器不是替代人工,是为人工准备弹药——AI 给出 Bloker/Major/Minor 清单后,开发负责人花 15 分钟扫一遍,决定哪些立即改、哪些下次 sprint 重拆。这是真正花时间的环节。
AI 拆任务的三大盲区:每条都有具体翻车姿势
把上面三段模板拉通看,AI 拆任务最容易翻车的不是「拆得不够好」,而是三个被默认行为掩盖的盲区。每个盲区都来自一项公开发表的研究或工程实践,不是凭空说的。
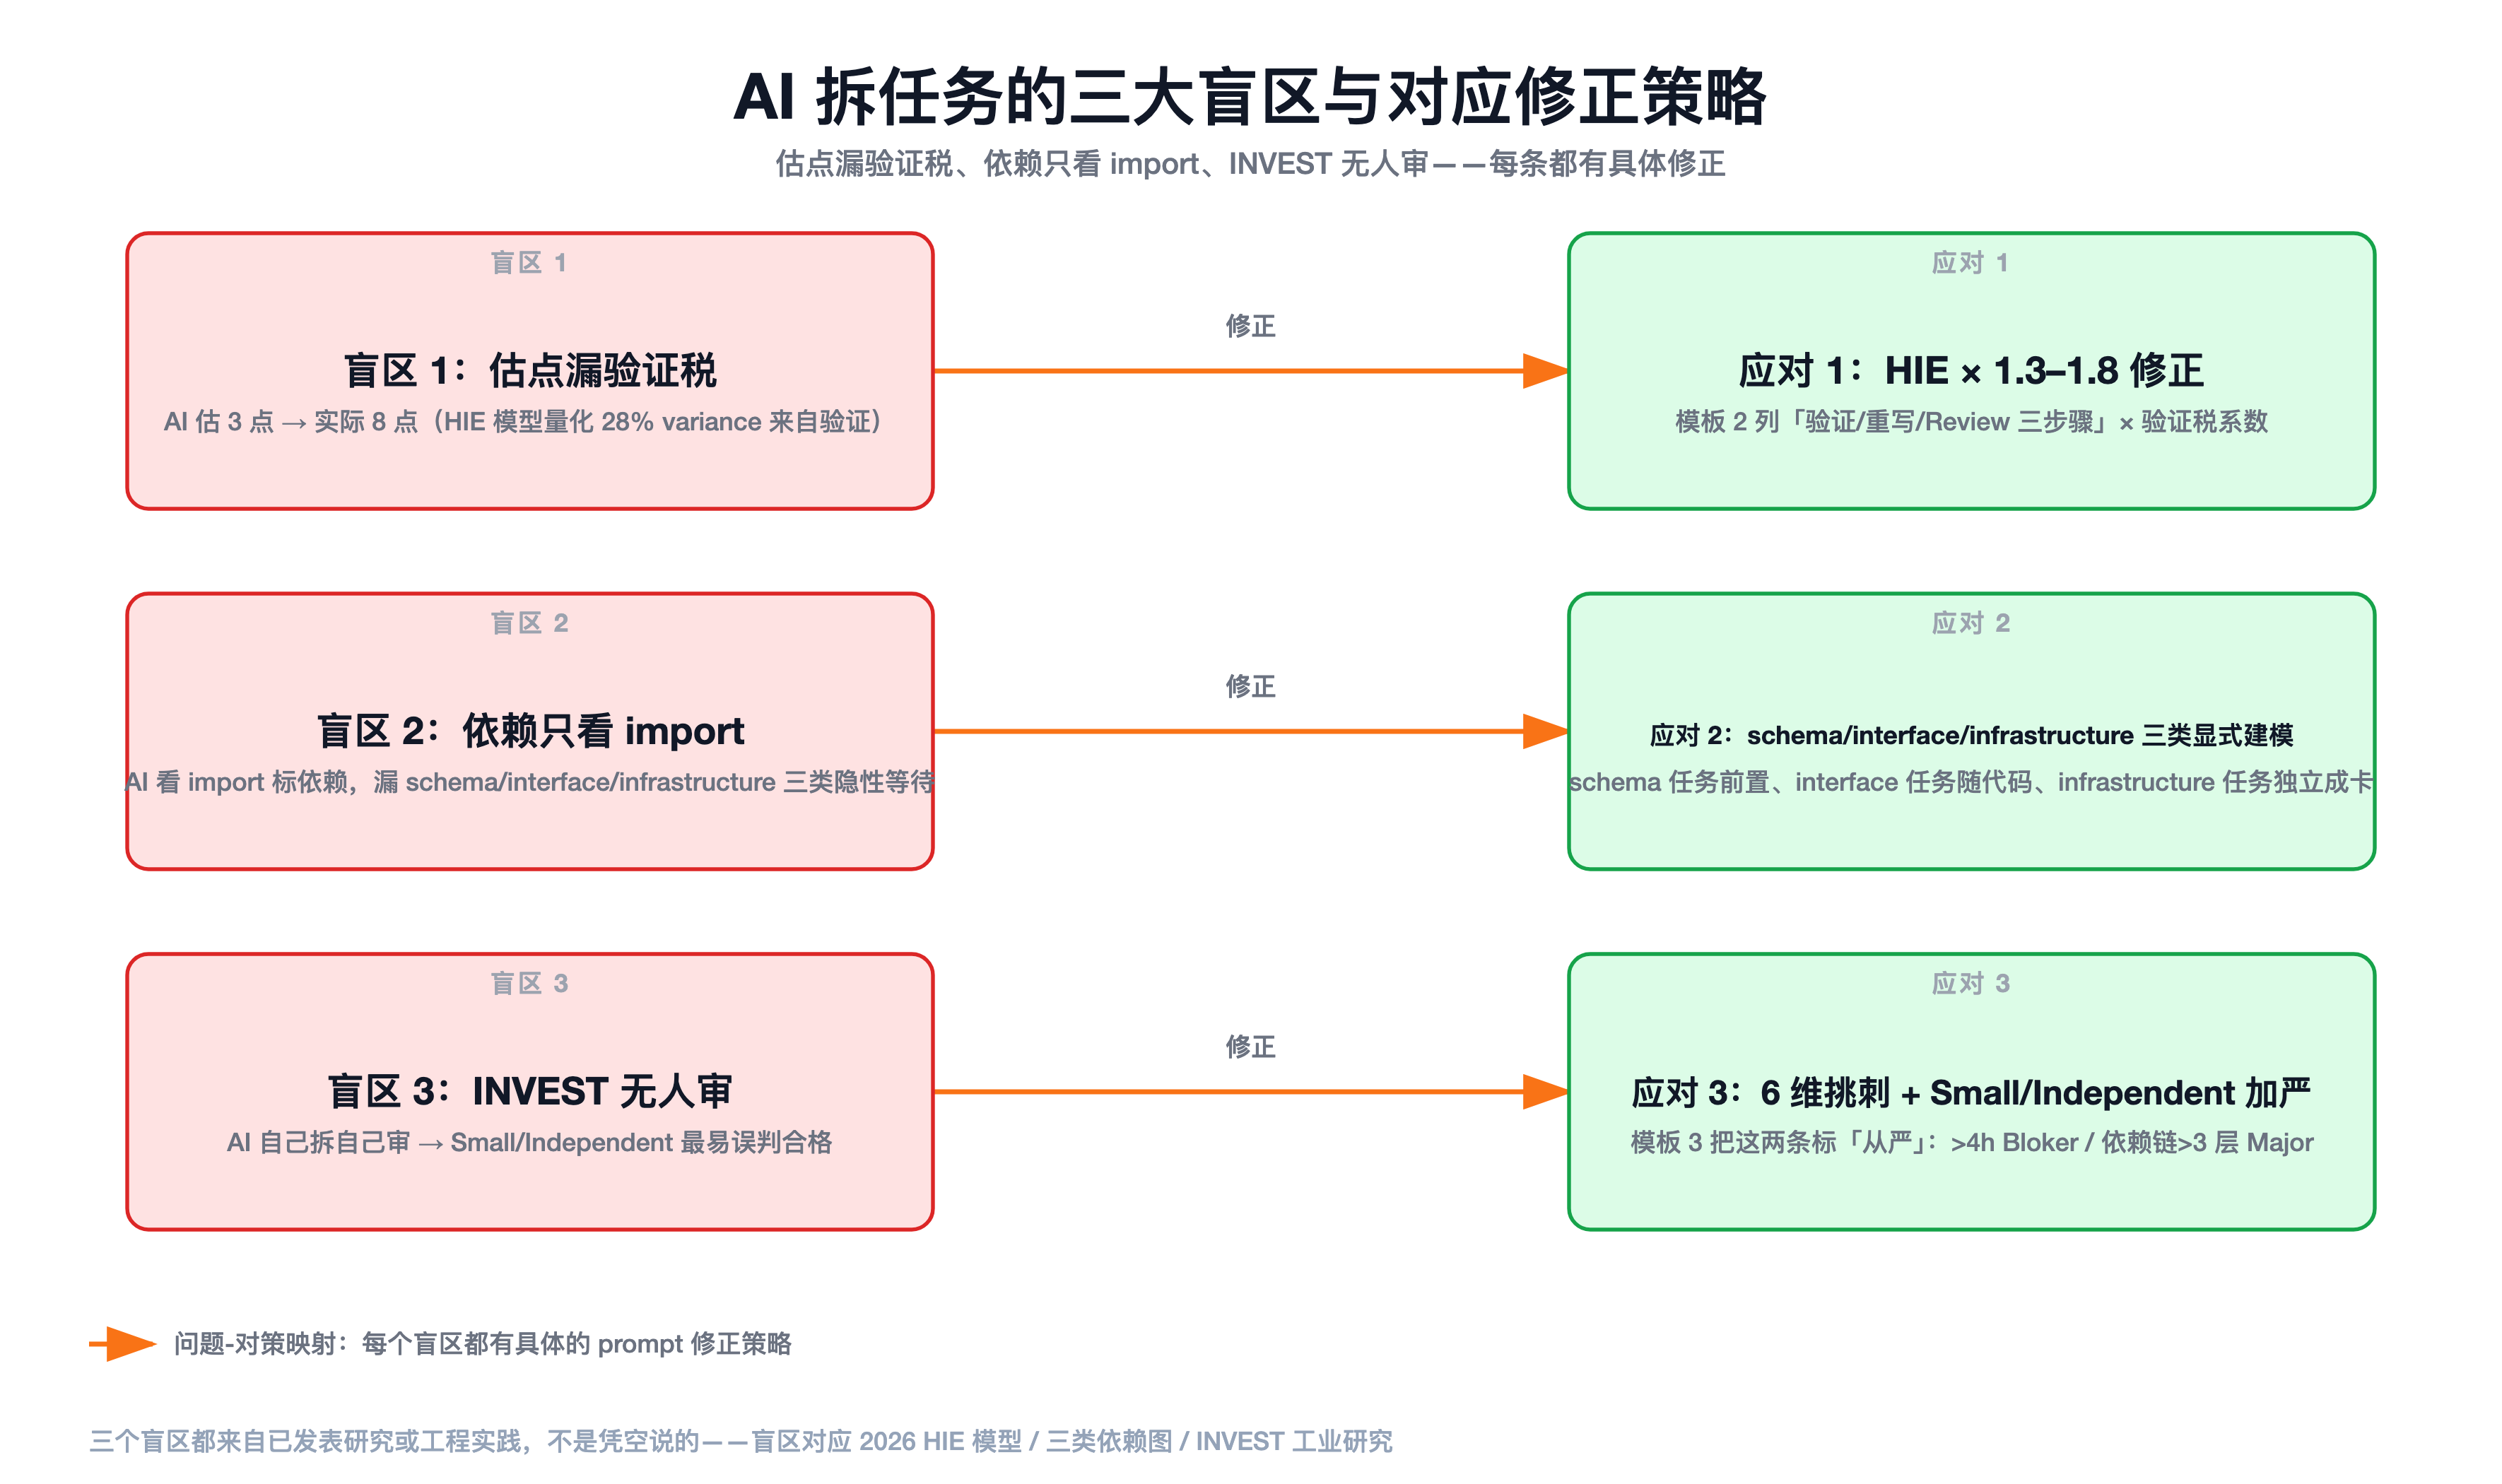
盲区 1:估点漏「验证税」
翻车姿势:AI 给「实现登录 API」估 3 点,实际开发 + 调试 + 让 AI 重写 3 遍 + 自己 review + 修边角 bug = 8 点。机制:2026 年 HIE(Hybrid Intelligence Effort)模型量化得很清楚——LLM 辅助开发里,验证/手动修正/prompt iteration 这三类「人机协作努力」占大头,传统 Story Points 只解释 72% 的 variance。应对:模板 2 的验证税系数(1.3–1.8)就是把这个缺口补上。
盲区 2:依赖只看 import,不看 runtime 耦合
翻车姿势:AI 看到 import { UserService } 就标「依赖 UserService」,但漏了 UserService 的 DB 表还没建、配置中心还没下发连接串、缓存预热脚本还没部署。机制:依赖分 schema / interface / infrastructure 三类,AI 静态读代码常漏后两类——这两类恰恰是上线前最容易阻塞的。应对:模板 2 强制三栏显式分类,schema 任务前置,infrastructure 任务独立成卡。
盲区 3:INVEST 拆分无人审,「小」和「独立」被默认为合格
翻车姿势:AI 把「实现支付」拆成「实现支付宝」「实现微信支付」「实现银联」三张卡,每张 13 点,看上去 Small 实际是 Epic 切片。机制:DeepQuali 研究与 GPT-5.1 INVEST 工业研究都显示,LLM 作为 INVEST 评审员与专家一致,但在 Small 和 Independent 两维度更保守——这意味着 AI 自己拆自己审时,最容易放过这两条。应对:模板 3 把这两条标为「从严」,修正估点 > 4h 一律 Bloker,依赖链 > 3 层一律 Major。
失败边界:什么时候这套方法不灵
不是所有场景都适合这套三段 Prompt 链。下面 7 种边界是亲历或公开案例的复盘。
- 大 PRD(> 5000 字)一次喂给 AI:上下文失焦,幻觉率飙升。V2EX 上有人踩过坑,最终结论是「分段切片 + 每段单独跑模板 1」。我的做法:按模块/用户故事切片,每片 ≤ 3000 字,片间用「衔接依赖表」串联。
- 机密 PRD 直接贴公网模型:未脱敏的 PRD 含表名/字段/接口/数字量级 = 数据泄露。脱敏是底线(替换真实服务名、字段名、把数字量级改成「约 X 量级」),公司有内部模型用内部的。
- AI 估点 100% 信任:2024-2025 跨 50,000+ 故事的研究表明,AI 估点 ±20% 准确率 67%,全新特性只有 41%——AI 没见过的功能类型基本靠猜。模板 2 的验证税和置信度两栏是必须的人审钩子。
- 任务清单能替代方案文档:Jeff Patton 2014 年那本《User Story Mapping》讲得很清楚,map 是「用户旅程 + 任务位置 + release 切片」的三维结构;没有 map 的 backlog 是「context-free mulch」。任务清单必须挂到 map 上,否则 AI 执行时不知道自己在做 walking skeleton 还是 fragment。
- 拆分越细越好:1-4 小时是甜区。拆到 30 分钟粒度反而不可估——沟通成本超过实际工时。
- 拆分完直接发 Jira:模板 3 的审查报告是 Bloker/Major/Minor,不是「通过」。任何 Bloker 未清零的任务不要进 Sprint。
- 「AI + 团队」估点不如纯 AI 或纯团队:研究里 AI + 团队组合 74% 准确率是统计意义上的,不是每个团队每个 sprint 都适用。你们团队如果过去 3 个 sprint 的「计划点 vs 实际小时」比值稳定,可以省去 AI 估点这步;如果不稳定,AI 估点 + 人工修正比纯团队估点更稳。
方案 → 任务的闭环
上一篇《技术方案怎么用 AI 写》交付的是「方案文档骨架 + ADR 对比 + 三道人审关」。这篇是它的下游:方案评审通过 → 模板 1 接收方案文档作为输入 → 模板 2 修正估点依赖 → 模板 3 审查 INVEST → 进 Sprint。
反向也成立:模板 3 审查器挑出的「修正估点 > 4h 的任务」往往就是方案文档遗漏的细节,反向修订方案——这就是 PRD → 方案 → 任务的完整闭环。
如果你公司没有专门的需求评审流程,这套三段 Prompt 链同样适用,只是模板 1 的输入要从「PRD 原文」换成「需求评审纪要或聊天记录脱敏稿」。骨架不变,输入替换。
———
🔧 文中用到的完整 Prompt
以上我分享了 3 个最核心的模板,完整版 12 条 prompt 合集(覆盖 PRD 拆解 · INVEST 审查 · 估点修正 · 依赖图 · Sprint DoR 模板 · 重拆规则 · 跨段衔接 · 公网/私网脱敏清单)已整理好。
回复「prompt」即可获取,持续更新。
———
如果这篇对你有帮助,转发给你的程序员朋友 —— 大家都在摸索 AI 提效,你的分享可能帮他省很多时间。


 浙公网安备 33010602011771号