
DeepSeek 视觉 API 刚上线:单张图 0.001 元,Agent 终于能看图

你昨天还在给 Agent 接 OCR 服务,今天 DeepSeek 直接把眼睛递到你手里了。
2026 年 8 月 21 日,DeepSeek 在 API 平台上线了实验性多模态视觉模型 deepseek-v4-flash-vision-exp。一句话讲清楚,开发者第一次能用自己的 API Key,把图片塞进 DeepSeek 的上下文,让模型看、再让 Agent 接着干活。
先泼盆冷水,免得你白高兴。
这不是 DeepSeek 第一次「识图」。网页和 App 端的「识图模式」早在 2026 年 4 月底灰度、6 月全量上线了。今天开放的是开发者 API,你能在代码里传图,而不是在对话框里传图。
另一个坑更隐蔽,模型名带 exp,是实验版本,不是 V4-Flash 的正式多模态版。别拿它当生产稳定版梭哈。
文本没掉,多模态直接跃升
光看「能看图」没意思,得看加了视觉后文本能力掉没掉。官方给的答案是,纯文本 Agent、推理、世界知识,和 V4-Flash 正式版持平,加视觉没有牺牲老本行。
再看多模态 Agent 能力,官方定位是「接近 Opus-4.8」。拉几组能对比的数字,来源都是 DeepSeek 官方 benchmark 表。
- ApexBench(Pass@1),vision-exp 36.5,V4-Flash-0731 只有 26.2(标注忽略多模态),Opus-4.8 是 39.4。视觉一加,直接从 26 蹦到 36。
- Agents' Last Exam,vision-exp 27.3,比 Opus-4.8 的 25.7 还高一点。
- ZeroBench(Pass@5),vision-exp 35.0,Opus-4.8 是 34.0,反超。
- Chartography,vision-exp 64.3,Opus-4.8 65.0,几乎贴脸。
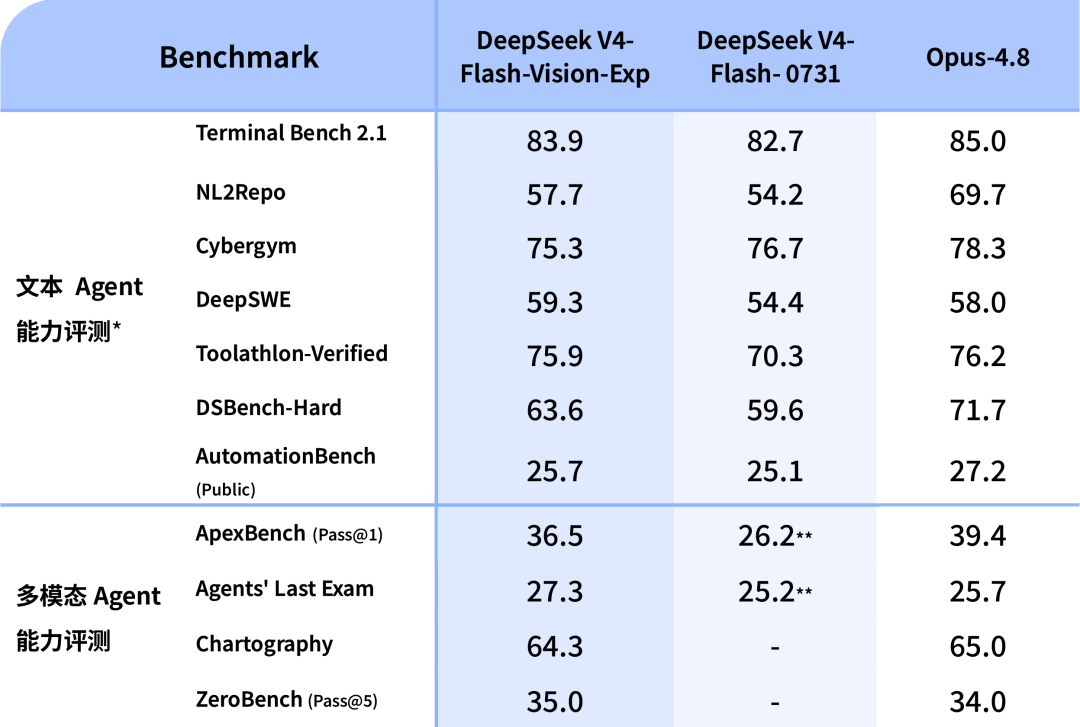
剩下那一串 Agent 评测也都在 25 到 84 的区间,Terminal Bench 2.1 是 83.9,NL2Repo 57.7,Cybergym 75.3,DeepSWE 59.3,Toolathlon-Verified 75.9,DSBench-Hard 63.6,AutomationBench(Public)25.7(来源,DeepSeek API Docs Updates)。
结论很清楚,它补齐的是「Agent 能看图」这块拼图,不是给你做个图片问答玩具。对做后端的我们来说,这才是今天这条消息真正值钱的地方。
三行核心改动,把图塞进现有工作流
如果你是 OpenAI SDK 用户,几乎不用改架构,只换 model 参数。下面这段能直接跑,依赖 openai==1.55.0。
# requirements.txt: openai==1.55.0
import base64
import os
from openai import OpenAI

# DeepSeek 兼容 OpenAI 格式,只换 base_url 和 model
client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

# 读图并 base64 编码(支持 JPEG/PNG/GIF/WebP)
with open("error_screenshot.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")

# 图片只能放在 user message,图文混排成一个 content 数组
resp = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "这是一次构建失败的截图,帮我定位报错根因并给出修复步骤。"},
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64}"}},
        ],
    }],
)
print(resp.choices[0].message.content)
注意两点。图片只能放在 user message 里,塞进 system 或 assistant 会直接返 400。detail 参数支持 low(缩到 512×512)/ high / original / auto,默认 auto,按你想要的画质和成本权衡。
同一张图要反复用?上 Files API
每次 base64 内联,图都要跟着请求体走,单请求体上限 48 MiB、单图最大 32 MiB。如果你的 Agent 要在多轮里反复引用同一张设计稿或同一张报错图,用 Files API 上传一次拿 file_id,后面只传 id。
# 上传一次,拿 file_id 反复引用,省带宽
with open("dashboard.png", "rb") as f:
    upload = client.files.create(file=f, purpose="user_data")
file_id = upload.id

resp = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "解释这张监控大盘的异常波动,并给出排查方向。"},
            # 官方格式:用 file 内容块引用 file_id
            {"type": "file", "file_id": file_id},
        ],
    }],
)
关键点,Files API 上传和引用本身不收费,但模型处理图片的 token 照样计费。它省的是带宽和重复编码,不是 token。单图最大 64 MiB,比内联的 32 MiB 宽松一倍。
三种传图方式怎么选
| 方式 | 适合场景 | 限制 | 成本注意 |
|---|---|---|---|
| base64 内联 | 本地小图、一次性请求 | 单图 ≤ 32 MiB,请求体 ≤ 48 MiB | 图片占请求体,大图片增加延迟 |
| 外部 URL | 图片已托管在 CDN/图床 | URL ≤ 8192 字符,下载限时 60 秒 | DeepSeek 侧下载,不占用请求体 |
| Files API | 同一张图反复用、大图 | 单图 ≤ 64 MiB,总存储 25 GiB | 上传/引用免费,token 照计 |
核心建议,单次分析用小图直接 base64;团队协作或 Agent 多轮复用同一份设计稿/监控图,优先 Files API。
多少钱?单张图最高也就 0.001 元
图片按 token 计费,最多算 384 tokens(官方 resize 后约 800×800 等效)。定价和 V4-Flash 一致,per 1M tokens。
- 输入缓存命中,$0.007(非峰)/ $0.014(峰)
- 缓存未命中,$0.22(非峰)/ $0.44(峰)
- 输出,$0.66 / $1.32
峰值时段是 UTC 01:00–04:00、06:00–10:00。最坏情况,峰值加缓存未命中,单张图,384 × $0.44 / 1,000,000 ≈ $0.000169,按汇率 7.2 算约 ¥0.0012,不到两厘。平时非峰加缓存命中还能再砍一个数量级。
举个实务的数。一个每天处理 1000 张报错截图的排障 Agent,按峰值最坏单价算,图片成本约 1000 × ¥0.0012 = ¥1.2/天,月成本不到 40 块。这还没算文本 token,但视觉这部分基本可以忽略不计。对比你自维护一套 OCR 服务的机器和运维钱,原生视觉几乎白送。
为什么图片最多只算 384 token
你可能会问,DeepSeek 明明能把图缩到 512 或保留原尺寸,为什么计费上限卡在 384 token。这其实是个成本和能力的取舍,不是技术做不到。
视觉理解大多数时候不需要像素级精度。看明白 UI 布局、图表趋势、报错红字,低分辨率就够用。官方把图 resize 到约 800×800 等效再编码,既压住了 token 成本,也避免一张长截图把上下文窗口撑爆,挤掉真正要处理的文本和工具调用。
反例就摆在眼前。早年没有原生视觉 API 时,工程师得先接 OCR 服务抽出文字,再自己拼 prompt 喂给文本模型。这套链路脆弱,表格一歪、字体一花,OCR 就漏字,模型跟着瞎猜。现在模型自己看图,那层胶水代码可以直接删了。
真能用在哪?官方三个 demo 已经说明问题
DeepSeek 自己放出的三个 Agent 场景,全是把视觉理解嵌进多轮工具调用,不是单轮问答。
- 西藏自驾游 PPT,丢一堆旅行截图,Agent 自己整理行程、出可演示的 PPT。
- Harness 官网二次创作,把官网截图喂进去,模型读懂结构后重构页面。
- 黏土怪物前端 Demo,看一张参考图,直接产出带动态特效的前端代码。
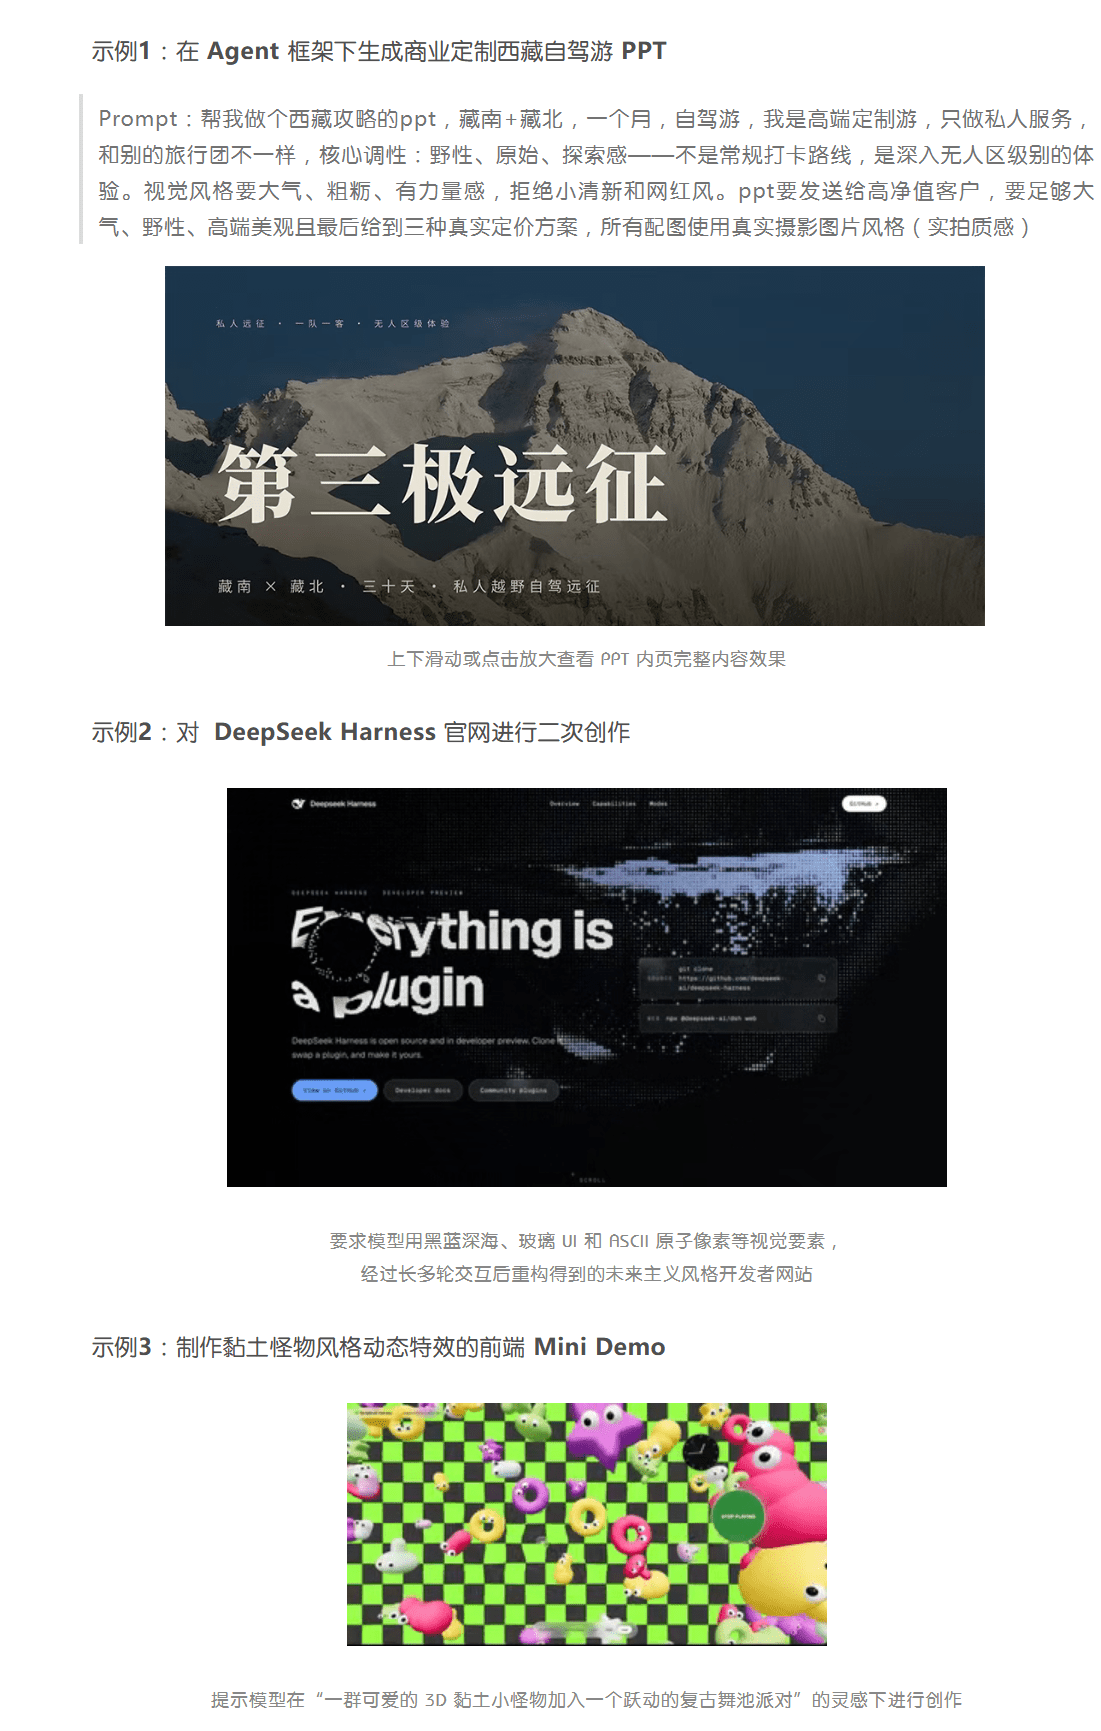
对后端和 Agent 开发者最实在的一点,你不用再自己写「截图 → OCR → 拼 prompt → LLM」那层胶水代码了。UI、图表、报错截图,模型能看懂,然后接着调你的工具。同天更新的 DeepSeek Harness v0.1.1 也接上了这个模型,工具链算是闭环了。
反过来看,如果还是老办法,你得先 OCR 抽文字再拼 prompt,表格一歪模型就瞎猜,报错截图里的红字还可能被漏掉。原生视觉把这一步直接吞掉了,Agent 拿到的就是「看懂了」的结果,而不是一段可能出错的文本中转。
对后端 / Agent 开发者,这事到底改变了什么
说白了,以前想让 Agent 处理视觉输入,你得自己当中间商。截图落库、调 OCR、清洗文本、拼进 prompt、再让文本模型决策。每一步都可能在生产环境半夜把你叫醒修。
现在模型原生看图,这个中间商被取消了。Agent 的工作流变成,把图直接丢进 user message,模型看懂后继续调你的工具。西藏 PPT、网页重构、前端 Demo 这三个官方 demo 全是这个套路,没有一个是单轮图片问答。
顺着这个想,这会催生一批「能看屏幕的 Agent」。排障 Agent 看报错截图、数据 Agent 看报表、运维 Agent 看监控大盘。这类场景过去因为缺原生视觉,做出来都半残,现在门槛塌了。
常见问题
Q1:这是正式版吗,能直接上生产吗?
命名带 exp,实验版。官方没给 SLA,建议先在内部流程或非关键链路试,别梭哈。
Q2:和网页、App 的识图模式有什么区别?
识图模式是 4 月底灰度、6 月全量的 C 端能力;今天是开发者 API,能在代码里传图、接进 Agent 工作流。
Q3:图片支持哪些格式和大小?
JPEG、PNG、GIF、WebP。内联单图 ≤ 32 MiB、请求体 ≤ 48 MiB、单请求最多 600 张;Files API 单图 ≤ 64 MiB。
Q4:用 Anthropic SDK 也能调吗?
能。官方支持 Chat Completions、Anthropic Messages、Responses API 三种入口,Anthropic 格式直接传 image 块即可。
Q5:看图免费吗?
不免费。Files API 上传和引用不收接口费,但模型推理时图片 token(最多 384)照常计费。
参考资料
- DeepSeek 官方 API Docs / Updates,模型发布、11 项 benchmark、定价页
- DeepSeek 官方 Vision guide,三种传图方式、限额、detail 参数
- 公开报道,DeepSeek Harness v0.1.1 同日更新支持该模型
我的判断很直接,DeepSeek 这次补齐的不是「能看图」的噱头,是「Agent 能看图」的生产拼图。对每天跟截图、报表、UI 打交道的后端来说,那层 OCR 胶水代码可以开始拆了。
想第一时间试,把上面那段 OpenAI SDK 代码里的 model 换成 deepseek-v4-flash-vision-exp、配好 API Key 就能跑。下篇我打算写「如何用 Files API 加多轮工具调用,搭一个能看报错截图的排障 Agent」,感兴趣的关注一下,别错过。
下期写什么你定,想看我用 Files API 实搭一个「看报错截图排障」的 Agent,还是横向对比 Gemini、Claude 视觉 API 的成本?留言区告诉我。身边有同事还在用 OCR 服务接 LLM 的,这篇直接甩给他,省得他下周还在调那层胶水。顺手点个「在看」,让更多被 API 账单和胶水代码折磨的工程师看到。
🔧 文中用到的完整调用模板
以上我分享了最核心的接入代码,完整版(含 Files API 上传示例、Anthropic 格式对照、detail 参数选型表)已整理好。

回复「vision」即可获取,持续更新。
如果这篇帮你省了时间,转发给你的程序员朋友——大家都在摸索 Agent 提效,你的分享可能帮他少写一层胶水代码。

 浙公网安备 33010602011771号