
30K Star 神器,给 Claude Code 装上代码地图,Token 中位数省 65 倍

上周我让 Claude Code 改一个支付回调的 bug。
它先 grep 了一遍 payment,读出 12 个文件。然后发现回调逻辑在 OrderService 里,又顺着 import 读了 8 个。改完跑测试挂了,因为它漏看了一个被继承的基类方法。接着它把整个 service/ 目录都读了进来。
等它终于改对,我看了一眼 token 用量,单次会话烧掉 18 万 input token。问题改对了,但我心里在滴血。
这不是 Claude 不够聪明,是它没有「地图」。它像一个被蒙着眼塞进陌生城市的快递员,只能挨家挨户敲门问路。
今天要聊的 code-review-graph,就是给 AI 配一副 GPS。GitHub 30,608 stars,2,787 forks,MIT 协议,项目创建于 2026 年 2 月 26 日,半年冲到 30K star。最新版本 v2.3.7,2026 年 7 月 18 日发布。
它的口号很直接,Stop burning tokens. Start reviewing smarter.
我实测了一周,把安装、使用、原理、benchmark 猫腻、适用边界全摸了一遍。这篇不做 README 翻译,只讲我真正跑过之后的判断。
它到底解决什么问题
先说结论,code-review-graph 不是又一个 RAG 代码搜索工具。
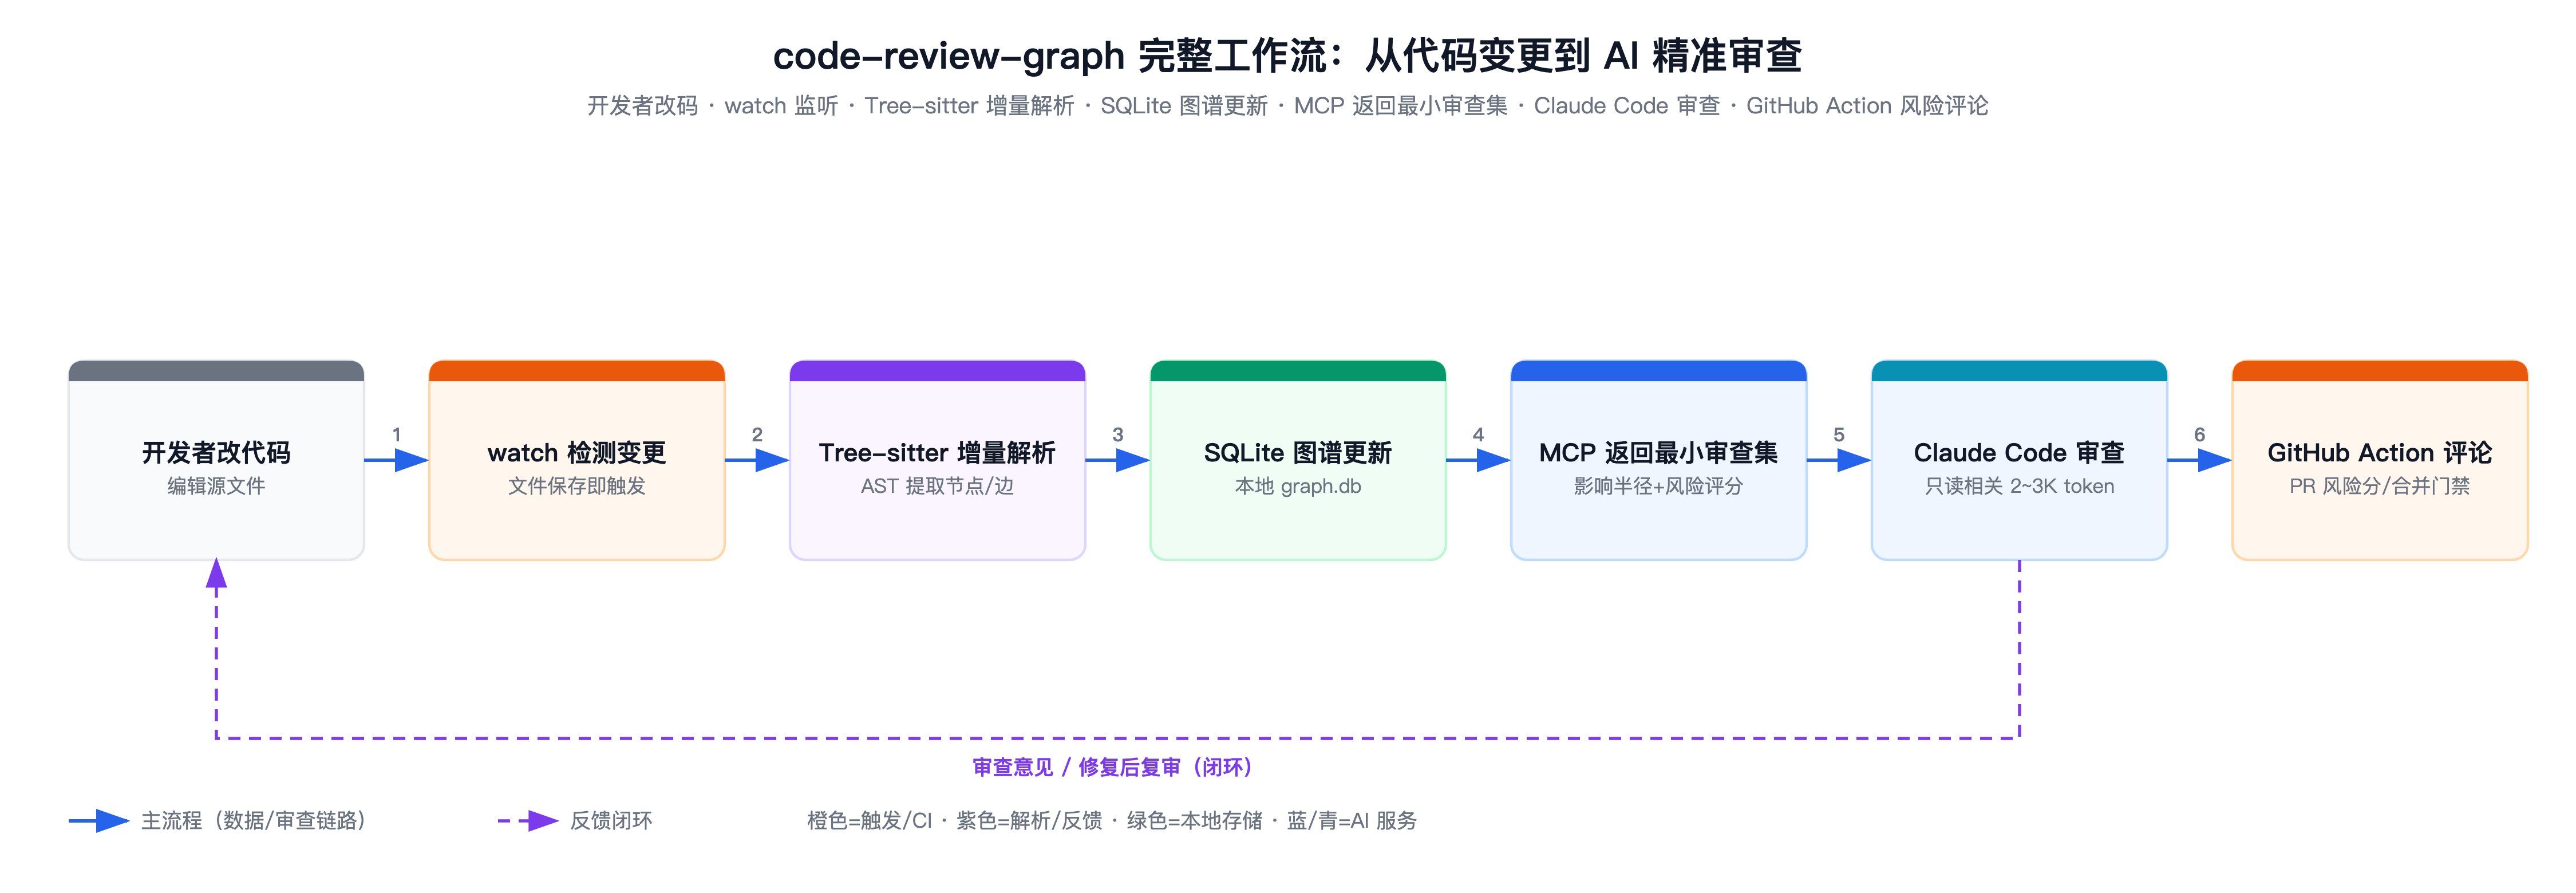
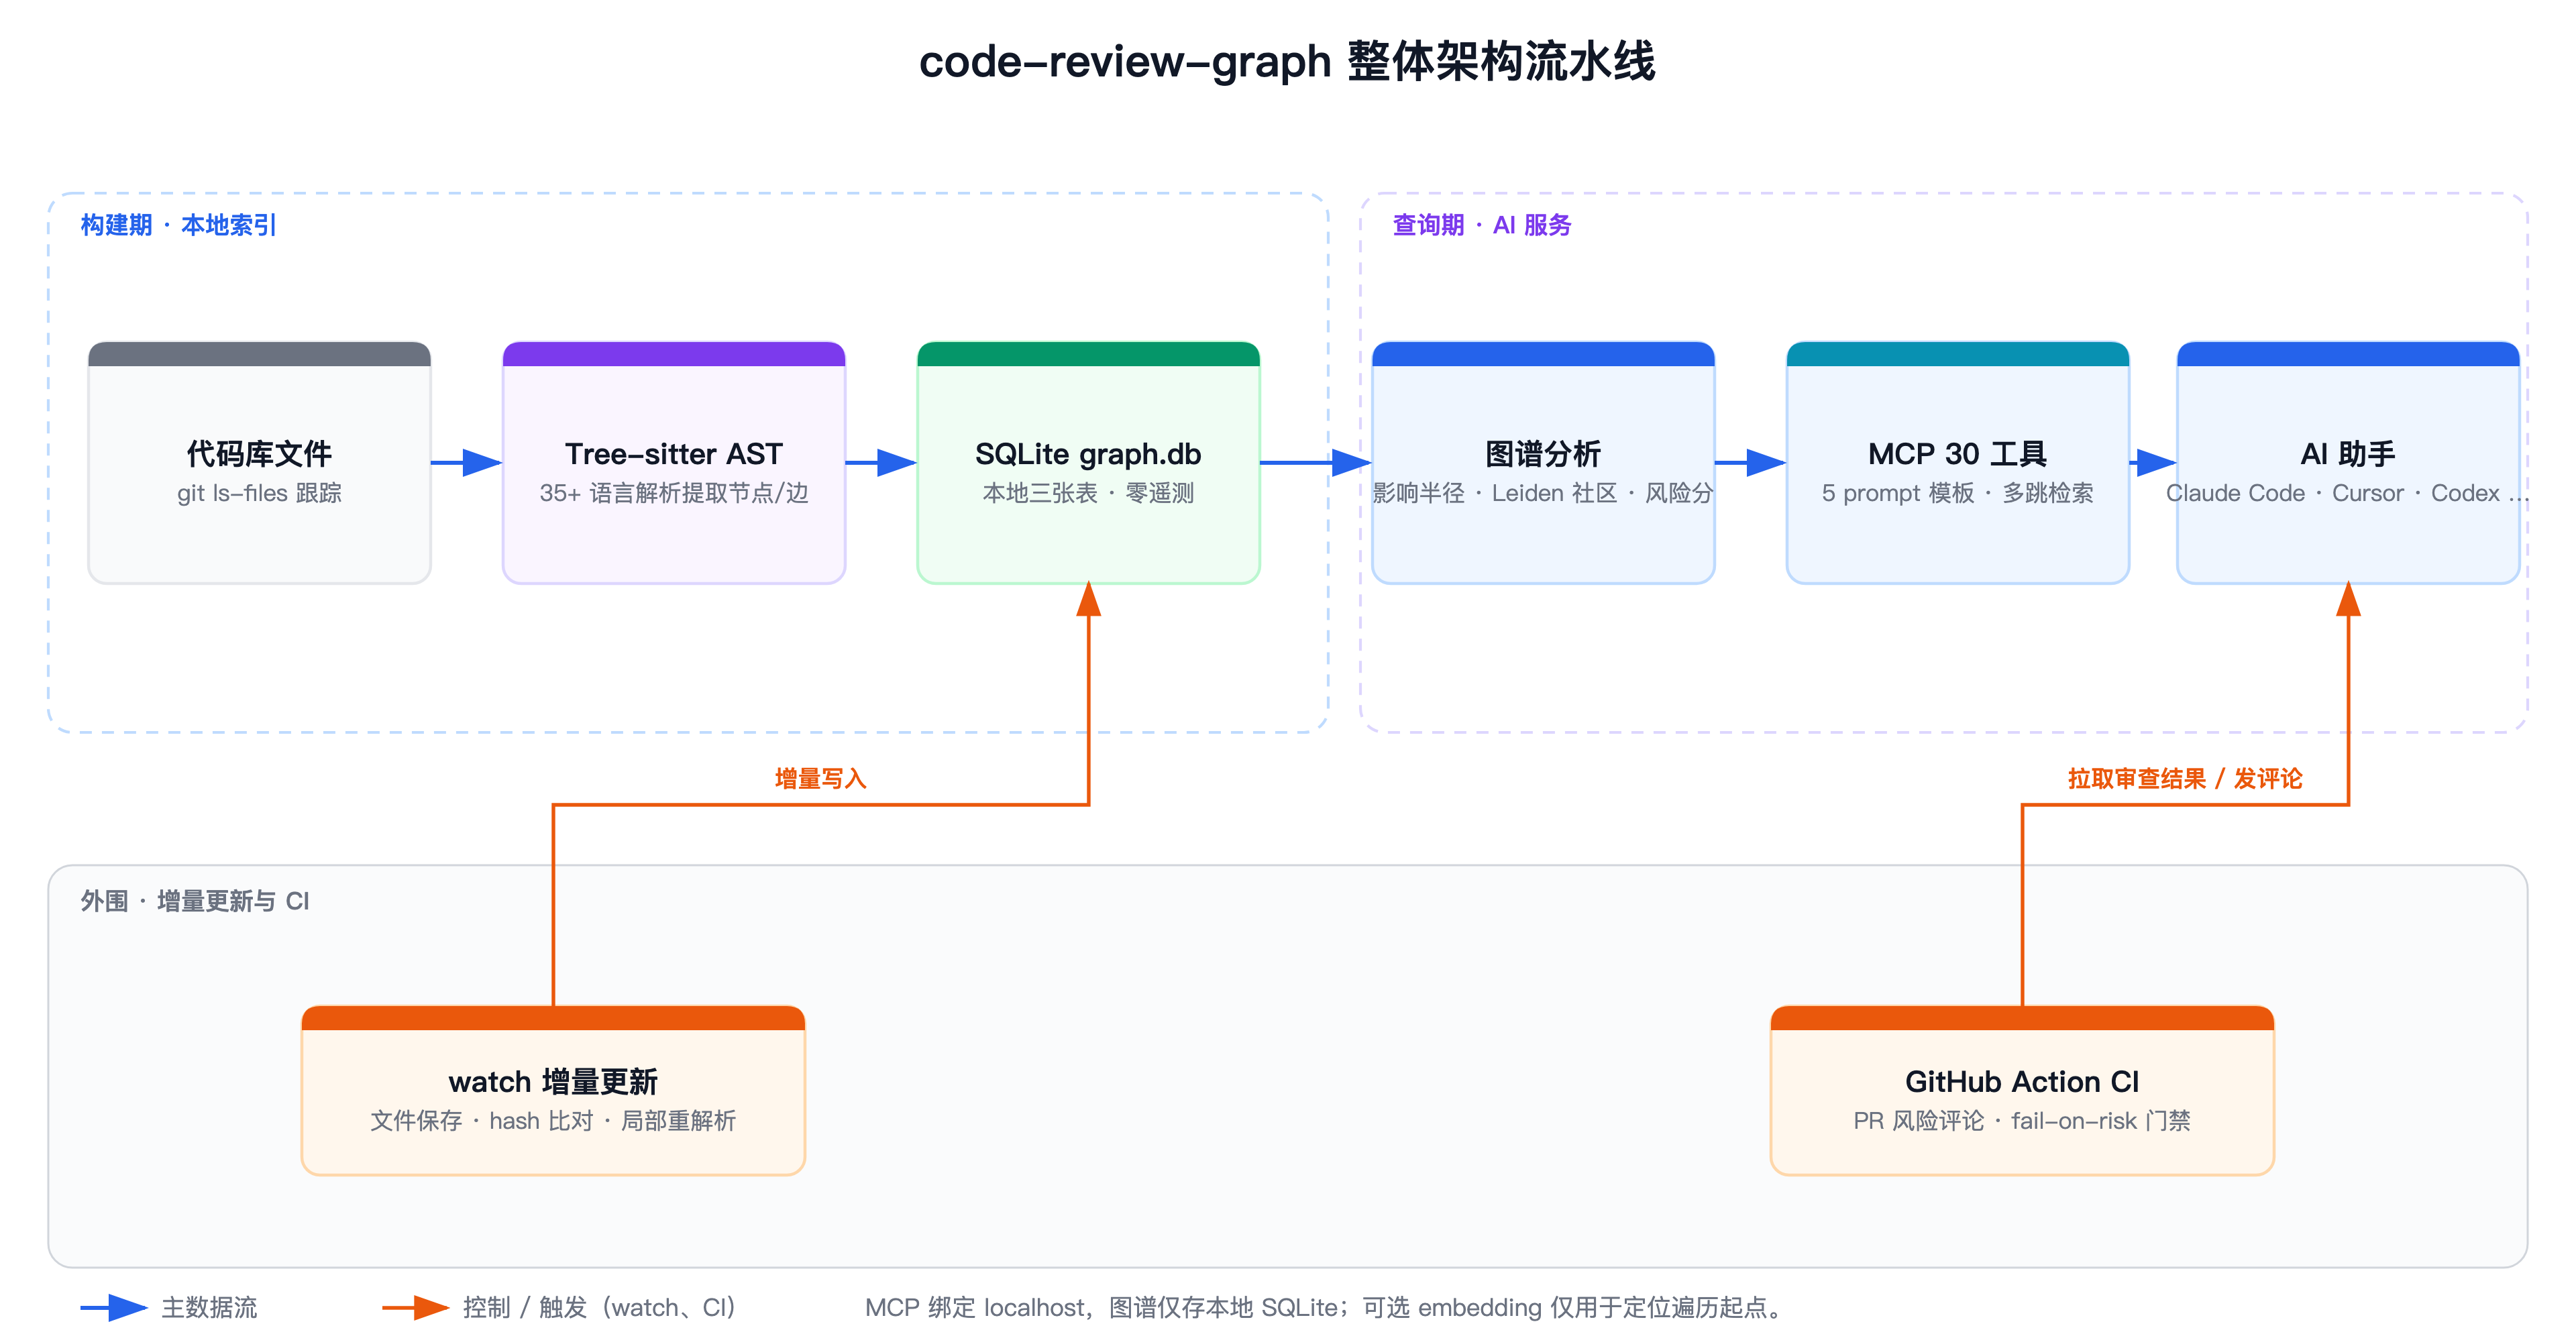
它做的事情是,用 Tree-sitter 把你的代码库解析成一张「结构图谱」,节点是函数、类、文件,边是调用、导入、继承、测试覆盖关系。这张图存在本地 SQLite 里。AI 通过 MCP 协议按需查询,比如「这个函数被谁调用了」「改了这个文件会波及哪些测试」,而不是把整个文件塞进 context。
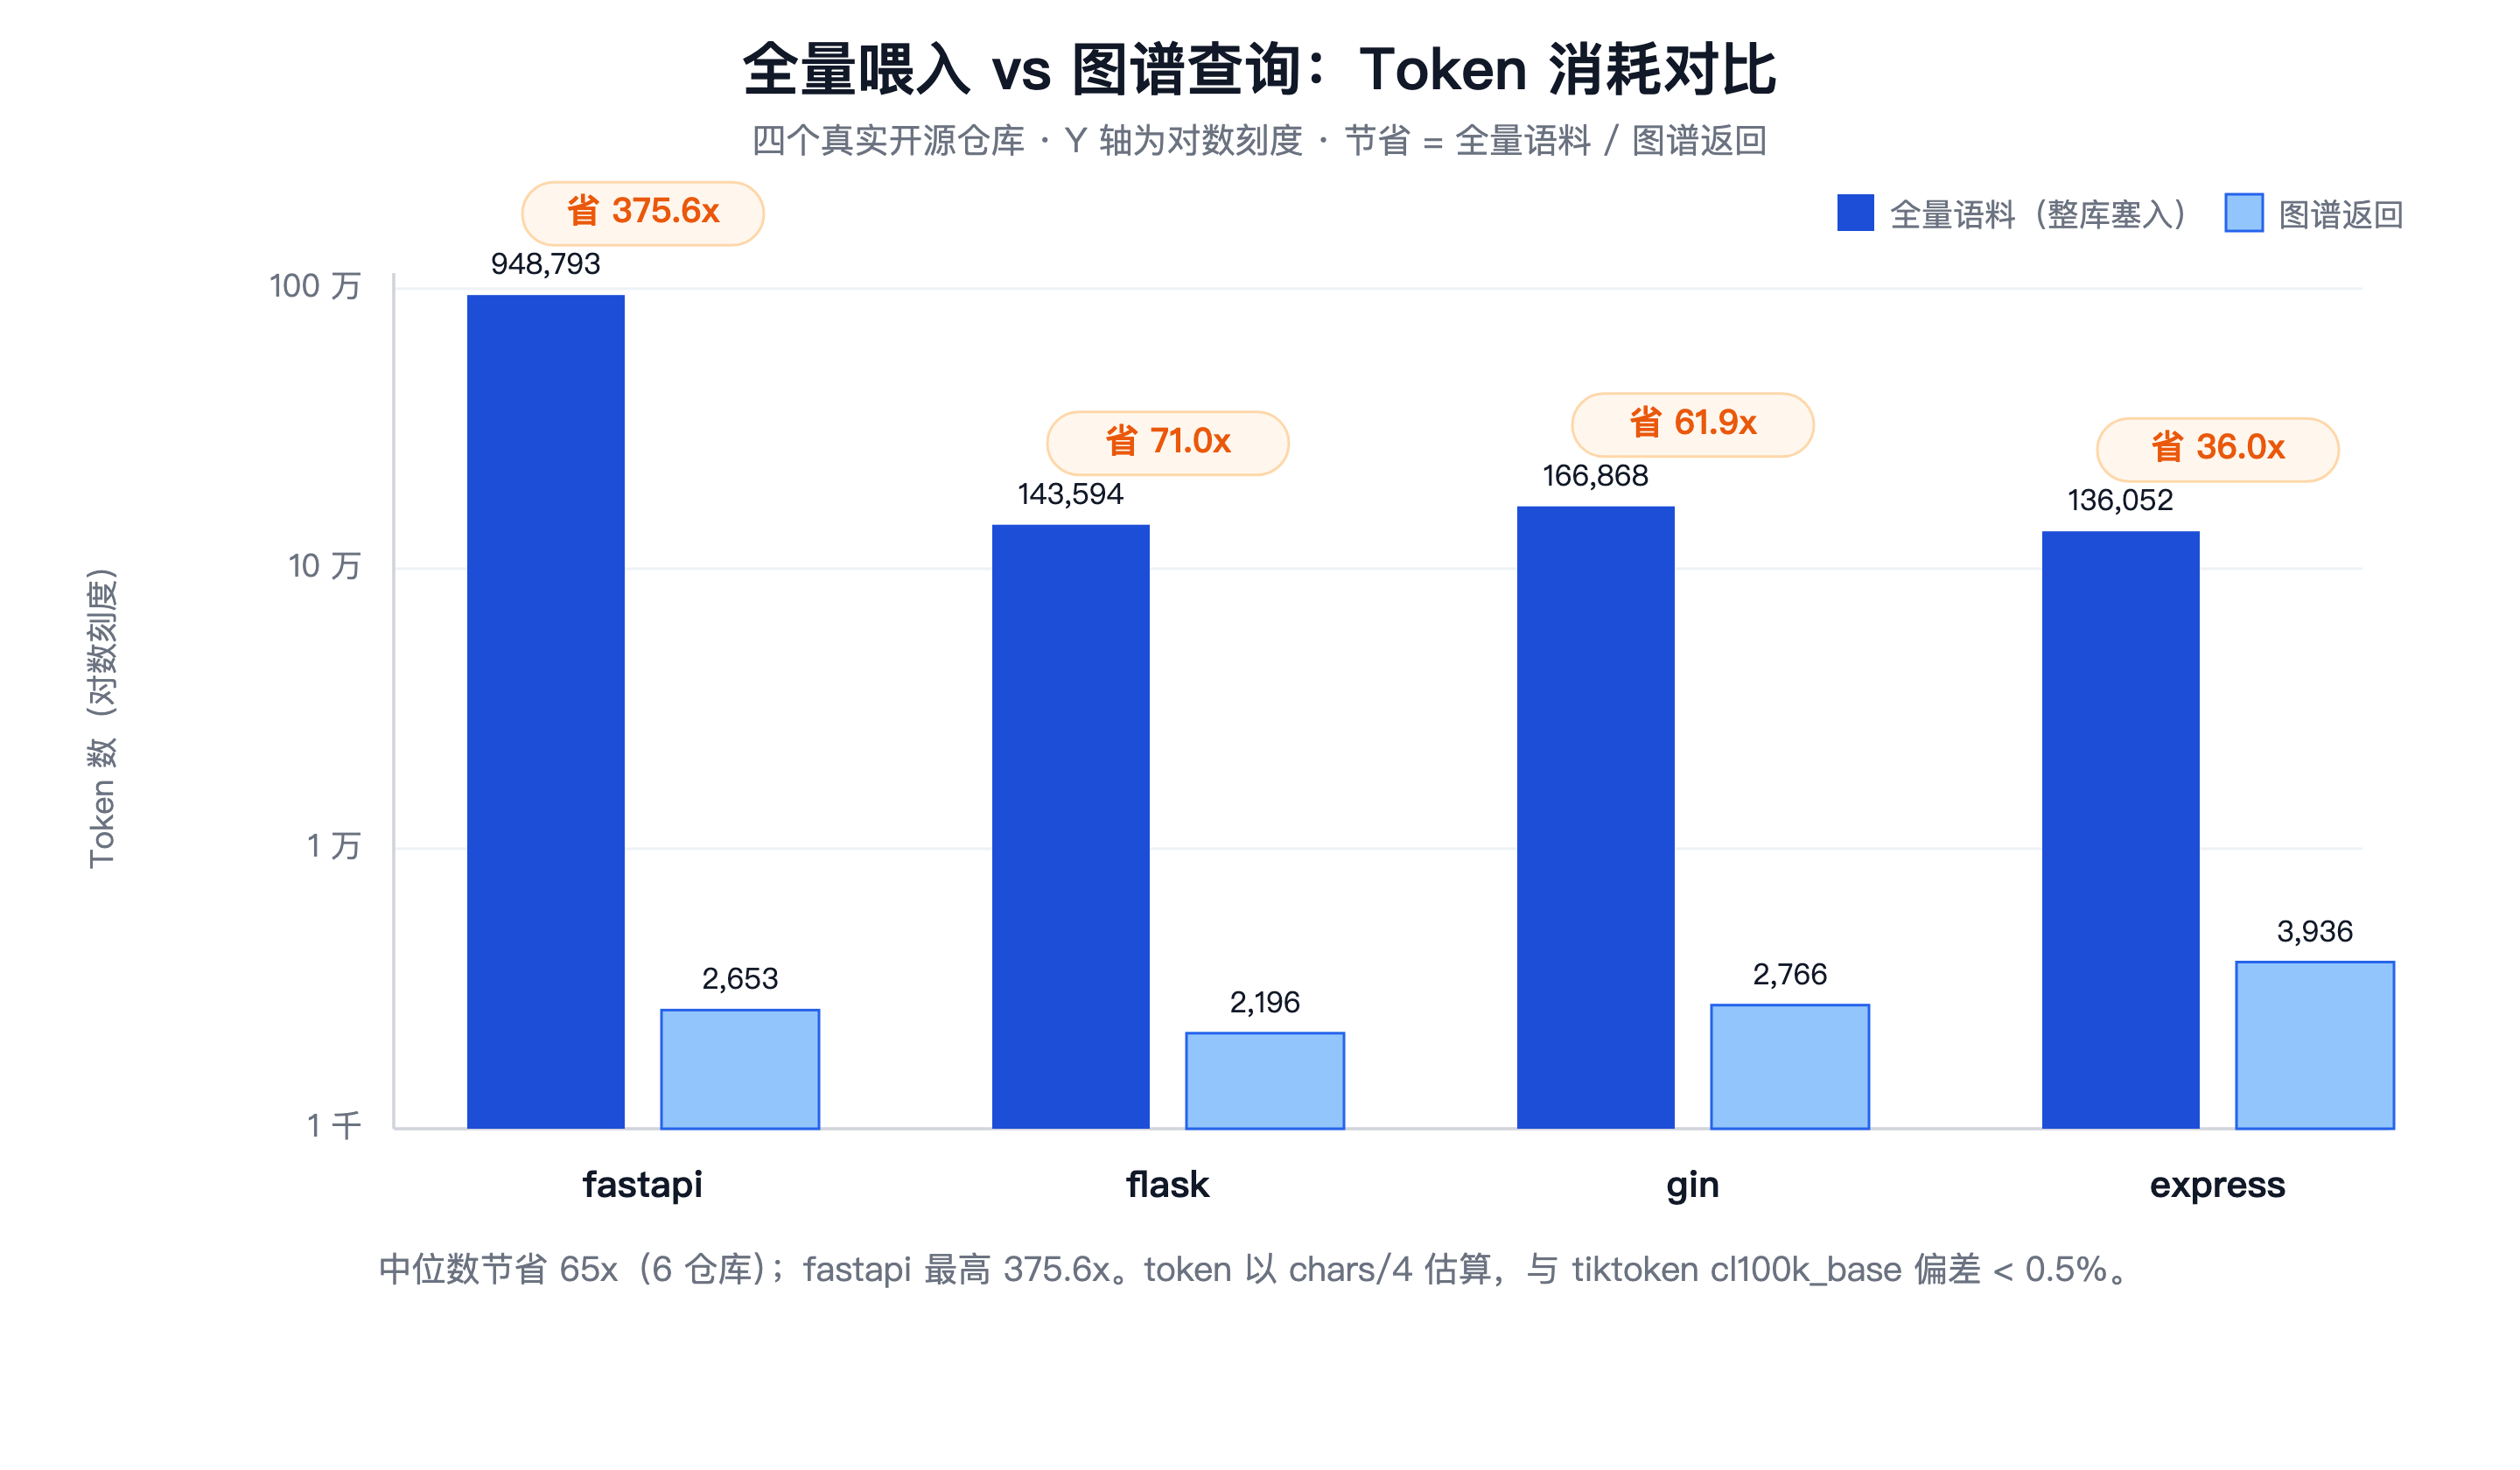
官方在 6 个真实仓库上跑了基准测试,中位数 token 减少 65 倍,范围从 36 倍到 376 倍。
我知道你看到这个数字第一反应是「吹的吧」。我也是。所以后面会专门拆 benchmark 是怎么测的,baseline 是什么,哪些地方有水分。
但先让它跑起来。
手把手实战
环境准备
需要 Python 3.10 或更高版本。我用 uvx 跑,不污染全局环境。你也可以用 pipx,效果一样。
# 方式一,uvx,推荐,零安装
uvx code-review-graph --version

# 方式二,pipx
pipx install code-review-graph

# 方式三,pip 全局装
pip install code-review-graph
如果要用语义搜索功能,需要额外装 embeddings 扩展。
pip install "code-review-graph[embeddings]"
默认不带 embedding 是刻意的,因为本地模型首次使用会从 HuggingFace 下载,几百兆,不是每个人都需要。
安装到 Claude Code
一条命令自动检测平台并写入 MCP 配置。
code-review-graph install --platform claude-code
它支持 14 个以上的平台,Claude Code、Cursor、Codex、Windsurf、Zed、Continue、OpenCode、Antigravity、Gemini CLI、Qwen、Kiro、Qoder、Copilot、CodeBuddy。装完要重启编辑器,MCP 服务才会拉起。
MCP 绑定的是 localhost,数据全在本地,零遥测。这一点对代码隐私敏感的团队很重要,后面原理部分还会讲。
构建图谱
进到你的项目根目录,执行。
code-review-graph build
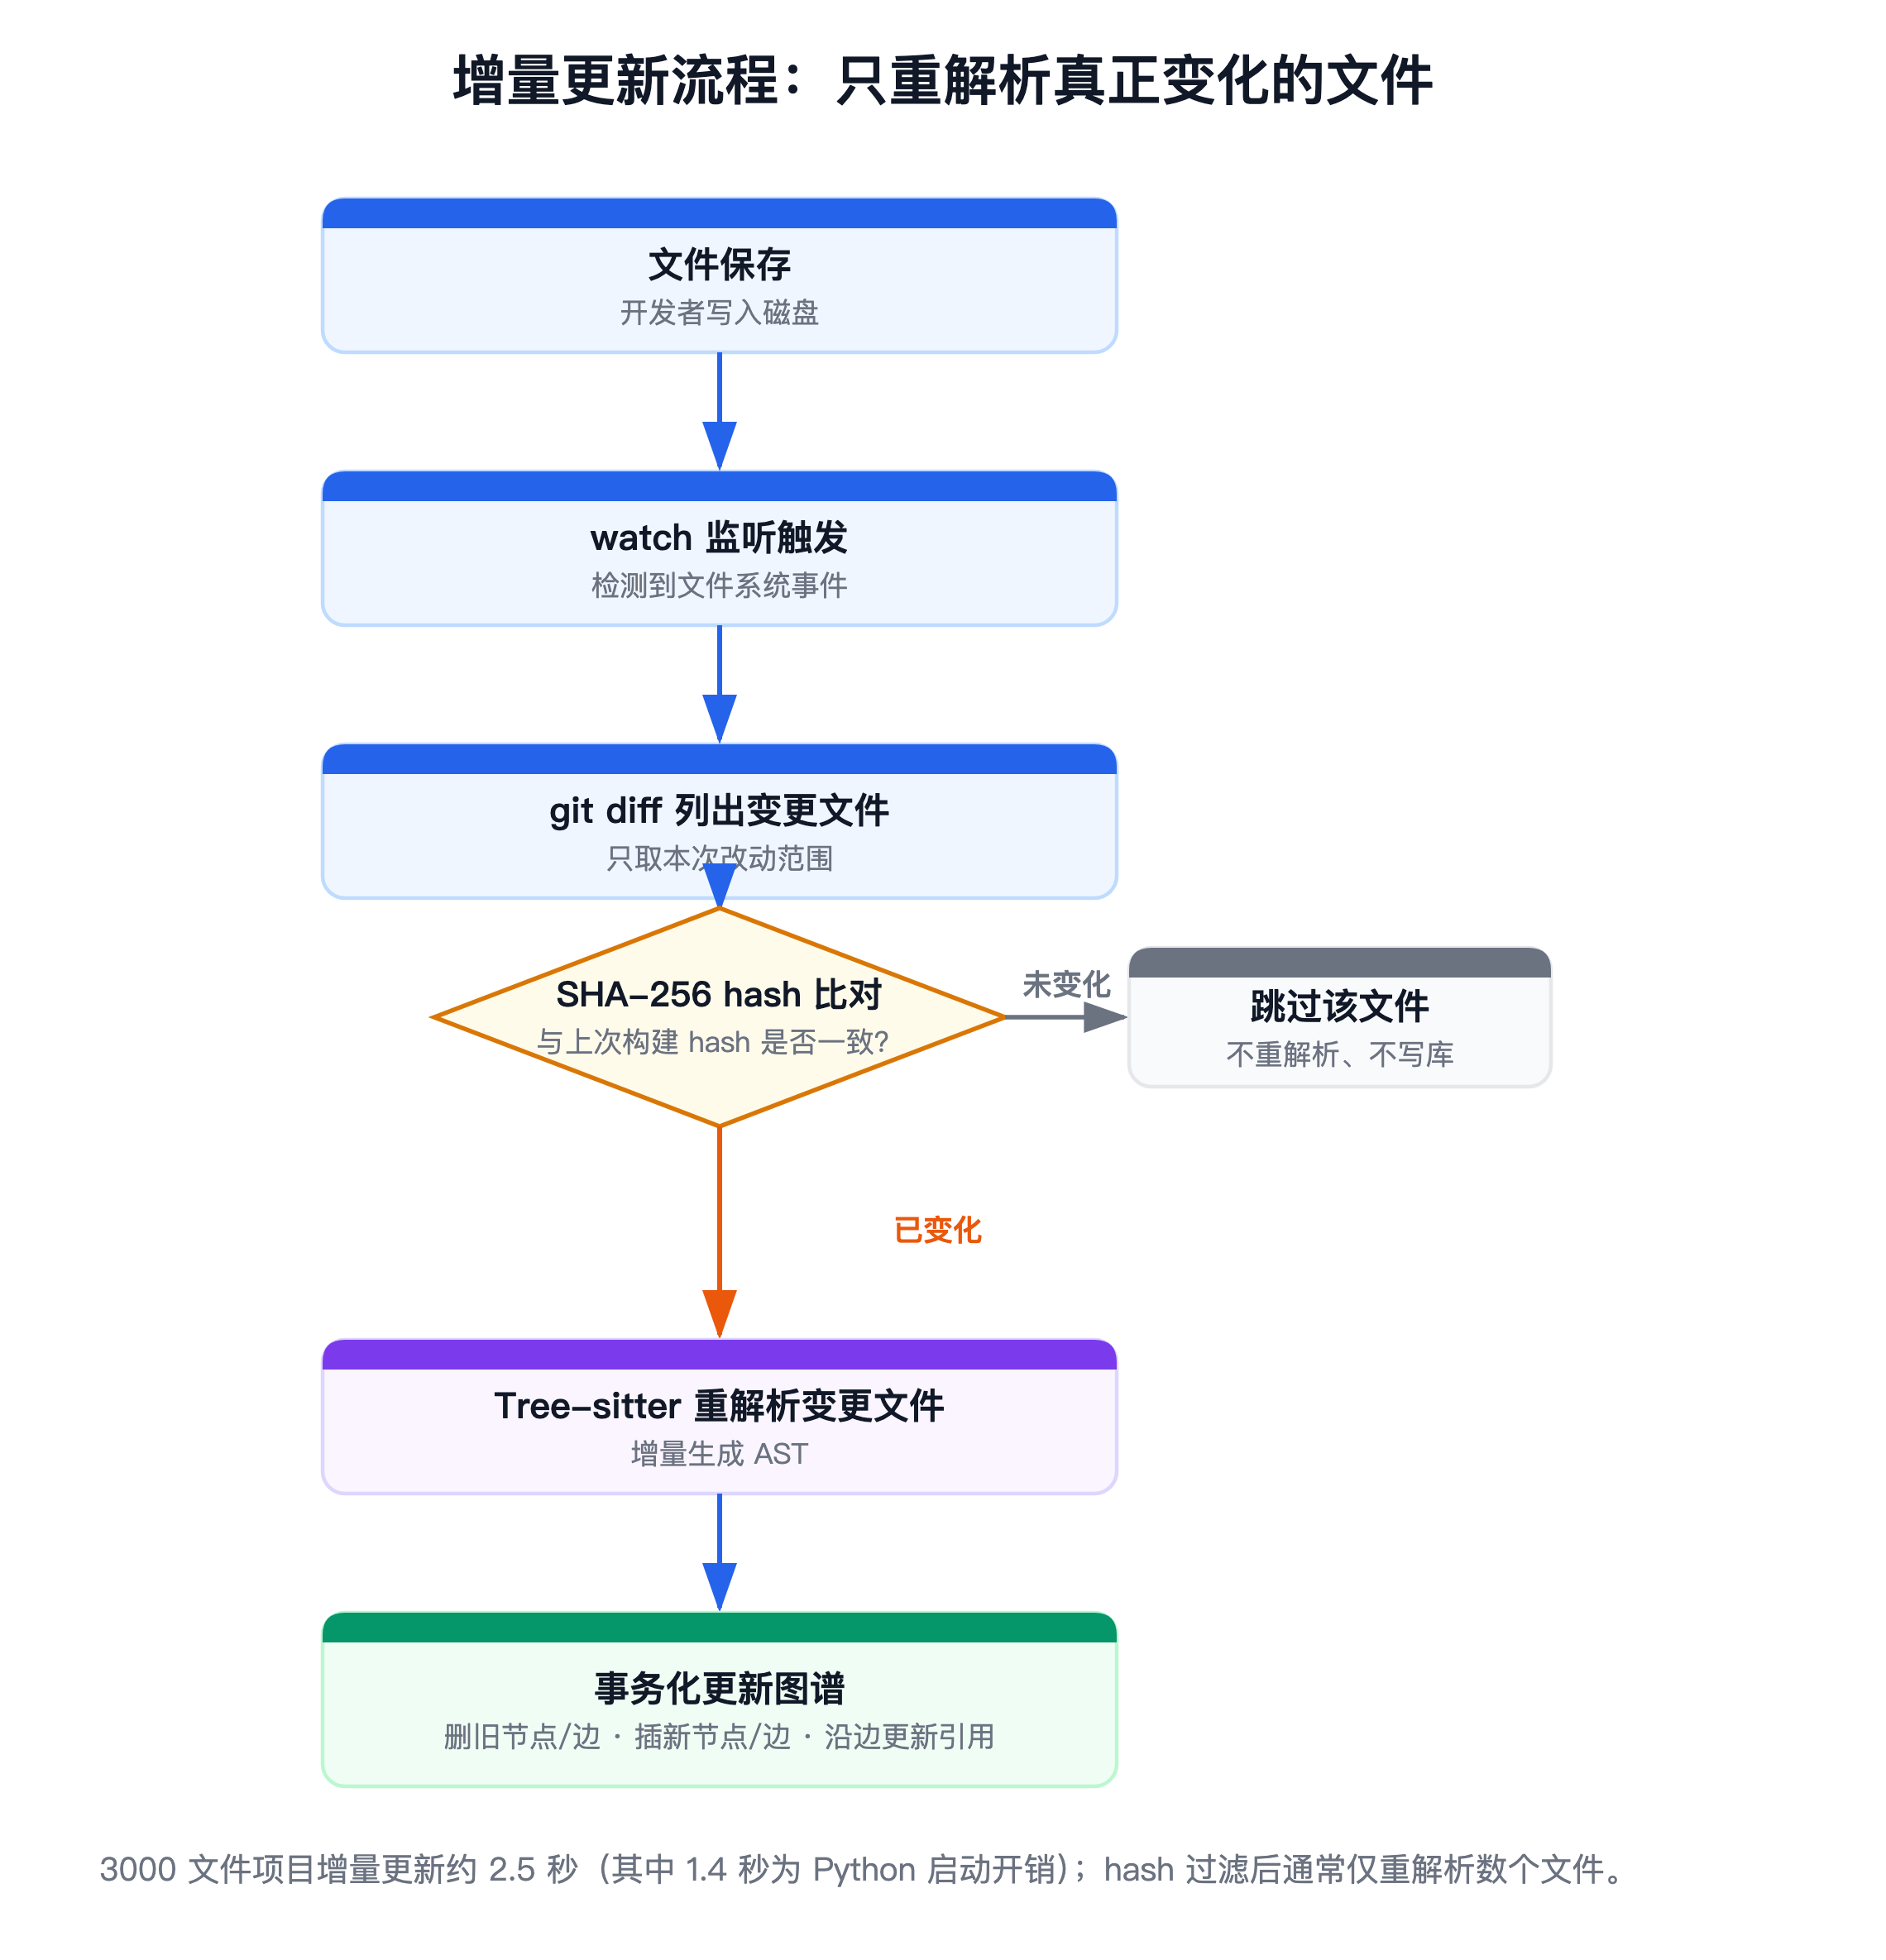
它会用 git ls-files 列出所有被 git 跟踪的文件,gitignore 的自动跳过。500 个文件的项目首次构建大约 10 秒。3000 个文件的项目增量更新大约 2.5 秒,其中 1.4 秒是 Python 进程启动开销。
构建完你会发现项目根目录多了一个 .code-review-graph/ 文件夹,里面是 graph.db,就是那张三张表撑起来的 SQLite 图谱。记得把它加进 .gitignore。
在 Claude Code 里用
重启 Claude Code 后,你会多出一组斜杠命令。
/code-review-graph:build-graph
/code-review-graph:review-delta
/code-review-graph:review-pr
review-delta 是我用得最多的。它会检测你当前工作区相对 git 的改动,沿着图的边追踪影响半径,然后告诉 AI「只看这些文件就够了」。
我改完一个函数,直接在 Claude Code 里敲 /code-review-graph:review-delta,它返回的不是整个 diff,而是一份结构化的审查简报,包含,
- 变更了哪些节点
- 这些节点被哪些上游调用
- 哪些测试覆盖了这些节点
- 一个 0 到 100 的风险评分
- 建议的最小审查文件集
整个过程 AI 读入的 token 从「整个仓库」降到「两三千 token 的结构化摘要」。
Token Savings 面板
detect-changes --brief 命令会输出一个 Token Savings 面板,长这样。
Files changed: 3
Nodes impacted: 47
Review set: 8 files (2,840 tokens)
Full corpus: 142,356 tokens
Savings: 50.1x
这里的 token 估算是用 chars/4 算的。我一开始担心这个估算不准,专门翻了 REPRODUCING.md,官方用 222 个文件做了校准,chars/4 跟 tiktoken cl100k_base 的偏差在正 0.5% 以内。也就是说它稍微高估一点点节省,但偏差可以忽略。
watch 模式
开发时不想每次手动 build,可以开监听。
code-review-graph watch
文件保存时它自动增量更新。增量靠 SHA-256 hash 比对,只重新解析内容真正变化的文件,然后沿边更新受影响的节点关系。实际体验几乎无感。
visualize 交互式图谱
code-review-graph visualize
它会起一个本地 web 服务,在浏览器里画出交互式的依赖图谱。你可以点节点看上下游,可以按社区着色,可以看到哪些是 hub 节点,哪些是 bridge 节点。这个功能对 onboarding 新同事或者理解遗留系统特别有用,比在 IDE 里点「find usages」一个个看直观太多。
.code-review-graphignore
有些目录你不想索引,比如生成的代码、migrations、前端构建产物。在项目根目录建一个 .code-review-graphignore,语法跟 gitignore 一样。
**/generated/**
**/migrations/versions/**
frontend/dist/
GitHub Action 集成
它还提供了 GitHub Action,可以在 PR 上自动发风险评分评论,甚至可以设置 fail-on-risk 作为合并门禁。
name: Code Review Graph
on: [pull_request]
jobs:
  review:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - uses: tirth8205/code-review-graph-action@v2
        with:
          fail-on-risk: 70
          github-token: ${{ secrets.GITHUB_TOKEN }}
风险分超过 70 就阻止合并。这个分数不是拍脑袋的,它综合了变更节点的 hub 程度、影响半径内的测试覆盖率、以及边的置信度。
Benchmark 数字怎么来的
好,到了最关键的部分,65 倍这个数字能不能信。
官方在 6 个真实开源仓库上测的,我把原始数据拉出来。
| 仓库 | 全量语料 token | 图谱返回 token | 节省倍数 |
|---|---|---|---|
| fastapi | 948,793 | 2,653 | 375.6 倍 |
| flask | 143,594 | 2,196 | 71.0 倍 |
| code-review-graph 自身 | 208,821 | 3,190 | 68.1 倍 |
| gin | 166,868 | 2,766 | 61.9 倍 |
| httpx | 142,356 | 2,661 | 60.6 倍 |
| express | 136,052 | 3,936 | 36.0 倍 |
中位数 65 倍。fastapi 那个 375.6 倍是极端案例,因为 fastapi 的 __init__.py 和 applications.py 集中导出了大量符号,全量喂入时这些文件反复出现在 context 里,而图谱只返回真正相关的调用链。
但这里有个你必须知道的 caveat。
baseline 是「全量语料」,也就是把整个仓库所有源码文本都塞给 AI。这不是一个聪明的 baseline。现实中一个有经验的 Claude Code 用户会用 grep、glob、find references 来缩小范围,不会真的把 fastapi 全部 94 万 token 塞进去。所以 65 倍是跟「最粗暴的做法」比,不是跟「熟练工程师手动筛选」比。
这一点官方没有藏着掖着,写在 REPRODUCING.md 里了,但它不在 README 的显眼位置。我的判断是,即便跟聪明的 grep 策略比,图谱依然有明显优势,因为 grep 只能做文本匹配,它不知道调用关系和继承链。但优势肯定没有 65 倍那么夸张,我自己体感在 5 到 15 倍之间,取决于代码库的耦合度。
再看准确性数据。影响分析的 F1 是 0.69,precision 0.546,recall 1.0。recall 1.0 看起来完美,但 ground truth 是从同一张图导出来的,属于循环论证,这个数字不能当真。真正诚实的 co-change 模式,对比 git 历史中实际共同修改的文件,目前预测为 0,官方自己标了「还不可用」。
多跳检索基准是 0.909 分,测的是 11 个手工任务跨 6 个仓库,这个数据相对可信,因为它测的是「沿图的边遍历能不能找到正确答案」,不依赖循环论证。
所以我的结论是,token 节省的方向是对的,数量级可信,但别把 375 倍当成你每天都能看到的数字。中位数 65 倍是跟全量喂入比的乐观值。
原理拆解
Tree-sitter 解析出节点和边
核心是 Tree-sitter,一个增量解析库,GitHub 自己的 Atom 编辑器当年搞出来的,现在几乎是所有代码结构分析工具的事实标准。
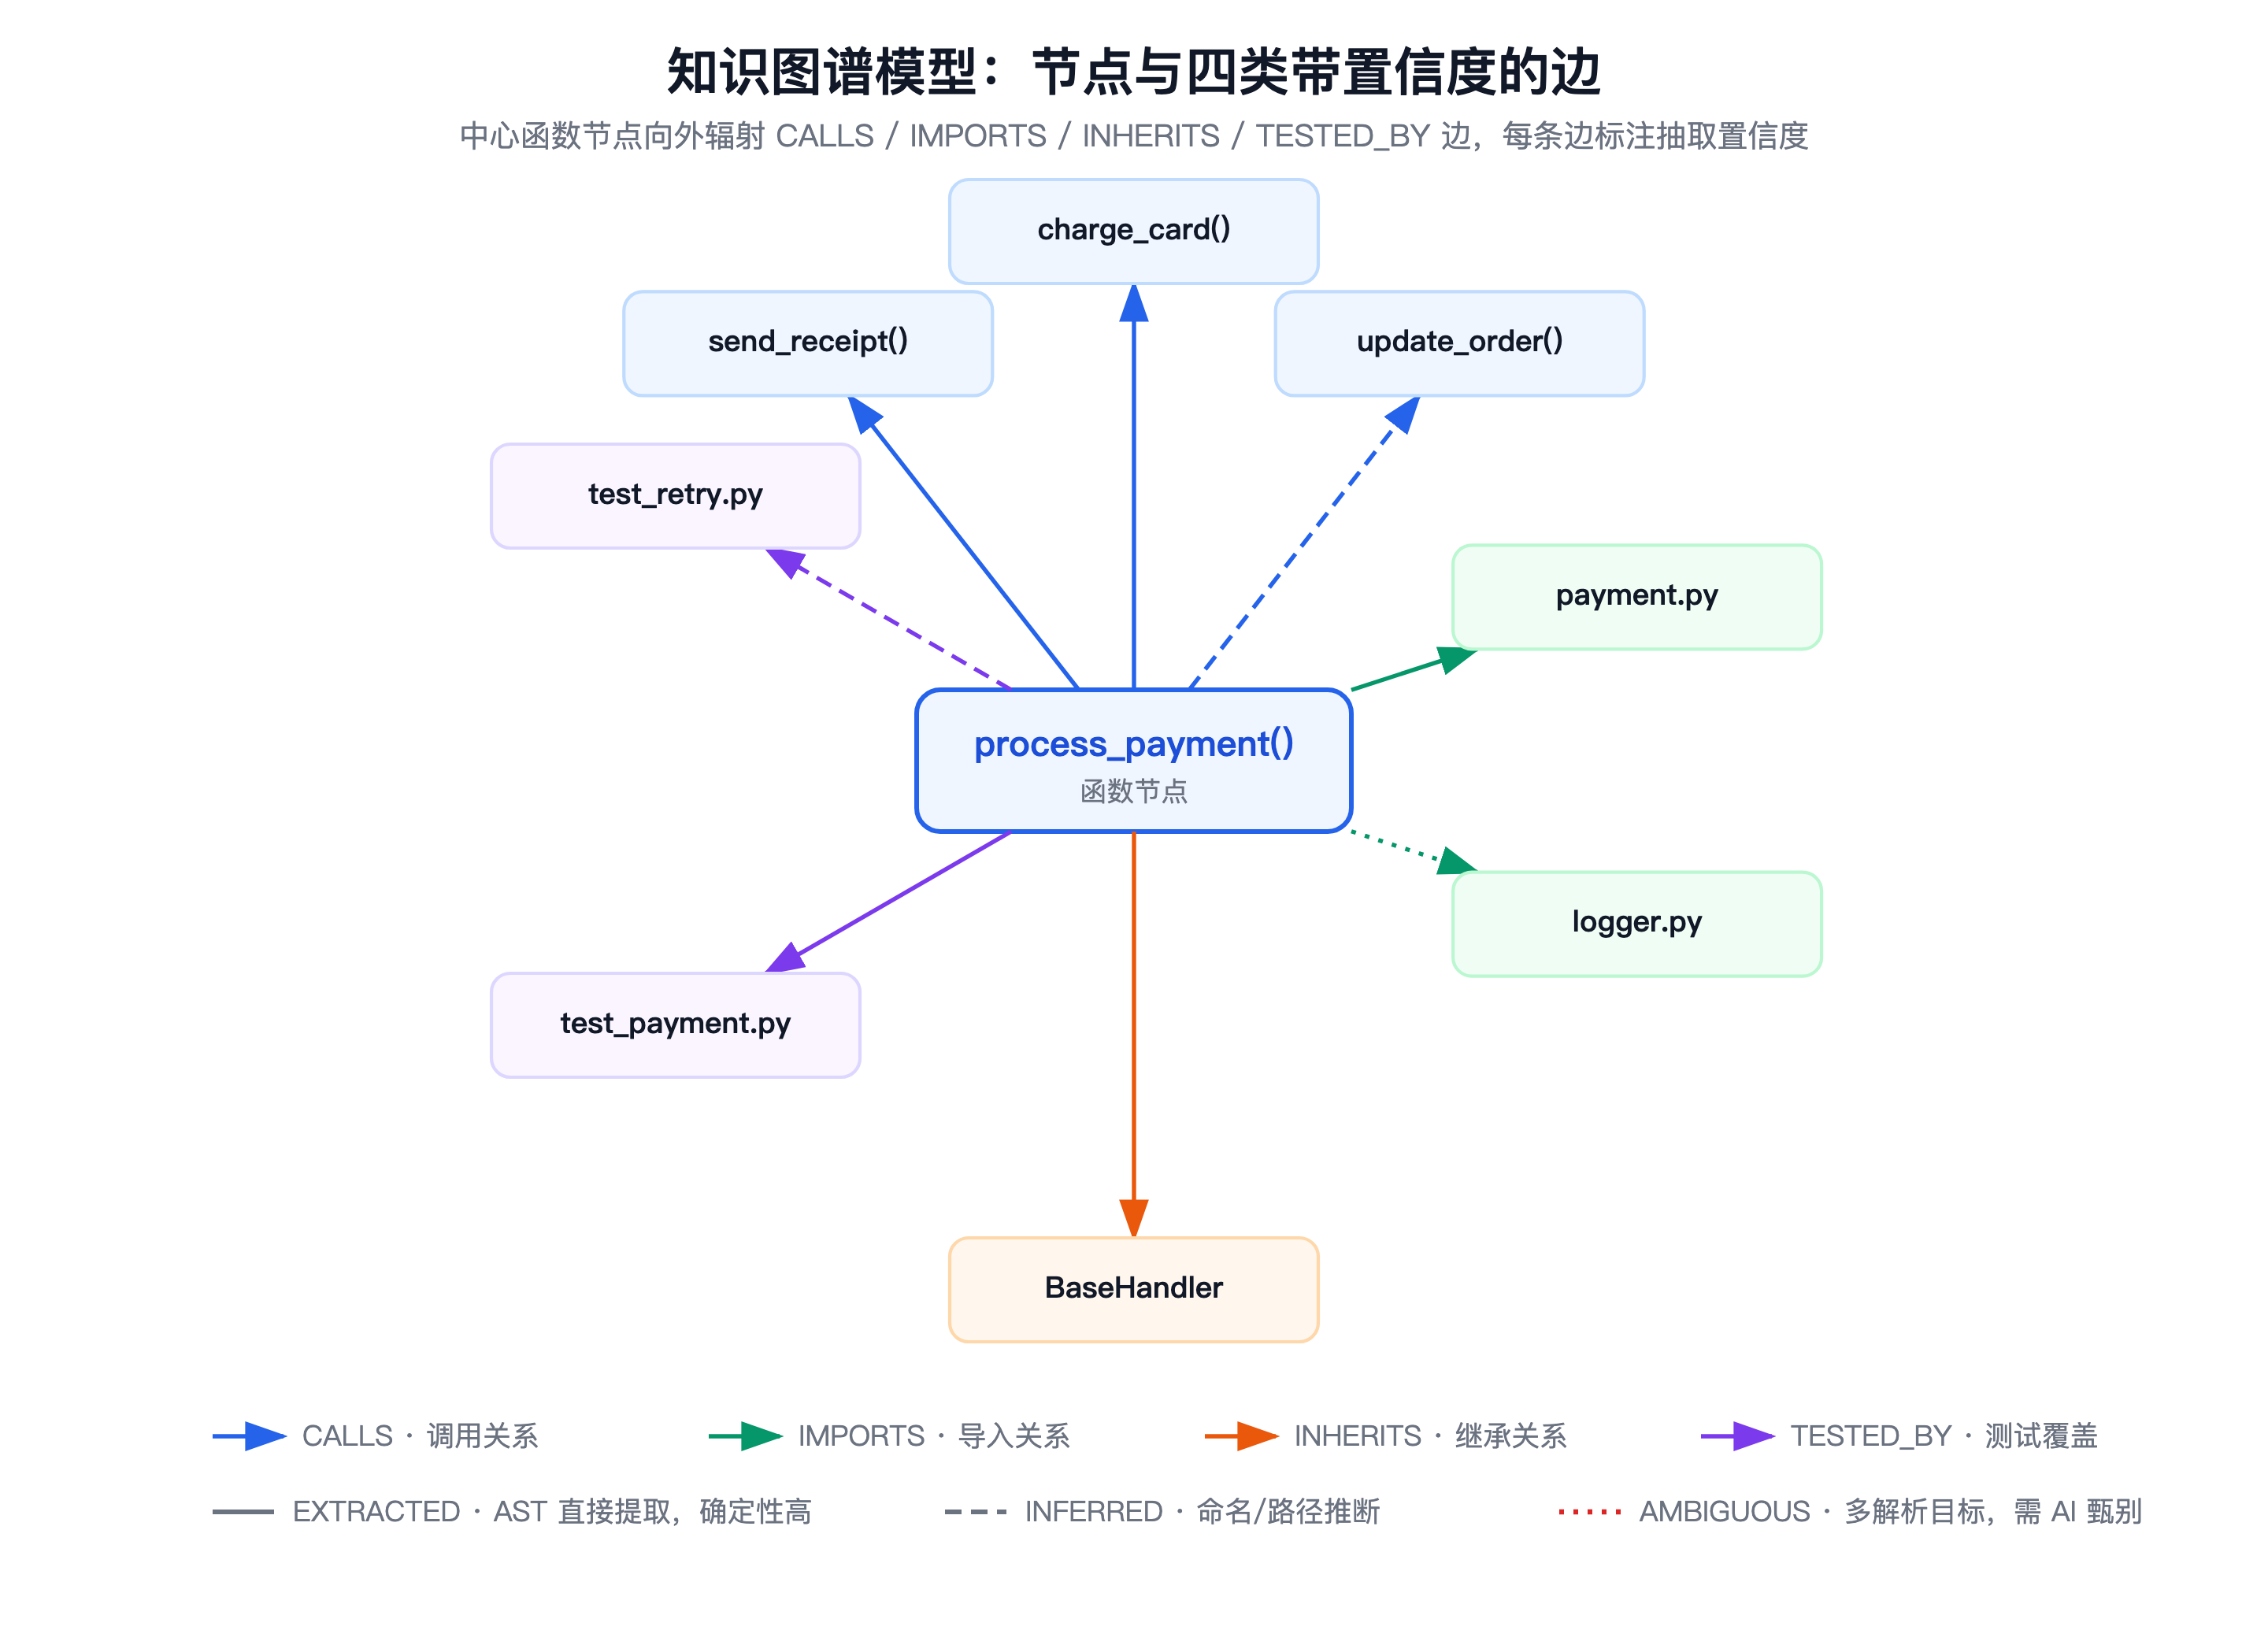
它把每个文件解析成 AST,抽象语法树,然后从中提取,
- 节点,函数定义、类定义、方法、导入声明、文件本身
- 边,
CALLS,函数 A 调用了函数 B;IMPORTS,文件 A 导入了文件 B;INHERITS,类 A 继承自类 B;TESTED_BY,函数 A 被测试文件 T 覆盖
每条边还带一个置信度标签,EXTRACTED 表示从 AST 直接提取的,确定性高;INFERRED 表示通过命名约定或导入路径推断的;AMBIGUOUS 表示有多个可能的解析目标。AI 拿到这些标签可以判断哪些关系值得信任。
为什么不用 LSP
你可能会问,LSP,Language Server Protocol,不是也能做这些事情吗,find references、go to definition,都是编译器前端做精确类型推导出来的。
区别在于精度和广度的取舍。
LSP 精确但重。每个语言一个 daemon,Python 要起 pyright,Go 要起 gopls,Java 要起 jdtls,吃内存吃 CPU。而且 LSP 的引用列表是「100% 精确或 nothing」,对于动态语言或者 monkey patch 的场景经常直接罢工。
Tree-sitter 是启发式的 AST 解析,不做类型推导,一个进程覆盖 35 种以上语言,Python、JavaScript、TypeScript、Go、Rust、Java、C/C++、C#、Ruby、Kotlin、Swift、PHP、Scala、Solidity、Dart,一直到 Zig、Nix、Verilog、Terraform、Vue SFC、Jupyter notebook。它不保证 100% 精确,但它保证「不会漏掉可能受影响的文件」。
Code review 场景要的恰恰是后者。你宁愿多看两个文件,也不想漏掉一个导致线上事故。这是工程上的务实取舍。
影响半径分析
这是整个工具最核心的算法。
你改了一个函数,它做的事情是,
- 找到变更文件对应的图节点
- 沿
CALLS和IMPORTS边反向遍历,找到所有依赖这个节点的上游 - 沿
TESTED_BY边找到覆盖这些节点的测试 - 对遍历到的节点按距离和边置信度加权
- 输出一个最小但充分的审查文件集
这个过程叫 blast radius analysis,爆炸半径分析。传统的静态分析工具也做类似的事情,但它们通常输出几百个文件让你自己筛。CRG 的不同在于它把结果裁剪到 AI context window 能舒服处理的体量,通常是两三千 token。
增量更新
首次全量构建后,每次更新只做三步。
- 用
git diff拿到变更文件列表 - 对每个文件算 SHA-256 hash,跟上一次的 hash 比对
- 只重新解析 hash 变化的文件,删除旧节点和边,插入新的,然后沿边更新引用关系
MCP 协议,30 个工具
AI 不是拿到整张图,而是通过 MCP 工具按需查询。CRG 暴露了 30 个 MCP 工具和 5 个 prompt 模板。
工具包括查询节点详情、找调用者、找被调用者、影响半径分析、搜索符号、获取社区结构、获取 hub 节点、获取风险评分等等。5 个 prompt 模板是 review、architecture、debug、onboard、pre-merge,对应不同的审查场景。
关键设计是,AI 决定查什么,图返回什么。AI 不会一次性拿到全部数据,而是像查数据库一样,先查一个节点,根据结果决定下一步沿哪条边走。这就是多跳检索,也是它比 RAG 强的地方。
为什么它不是 RAG
这是最多人误解的点。
RAG,检索增强生成,把代码切成文本块做向量化,查询时用余弦相似度找最接近的块。它回答的问题是「哪些文本里提到了 X」。
CRG 存的是 AST 解析出的结构边,回答的问题是「谁调用了 X」「X 的子类有哪些」「改了 X 哪些测试会挂」。
embedding 在 CRG 里只是可选的辅助,用来找到遍历的起始节点。一旦起始节点确定,后续完全沿真实的结构边走,不涉及向量相似度。
打个比方,RAG 像在书里搜关键词,CRG 像看目录和交叉引用。搜关键词能找到提到的地方,但目录能告诉你「这一章影响了哪三章」。
官方在多跳检索任务上拿了 0.909 分,而纯 RAG 方案在这类需要沿关系链推理的任务上普遍表现差,因为向量相似度不传递,A 跟 B 相似,B 跟 C 相似,不代表 A 跟 C 有结构关系。
Leiden 社区检测和风险评分
图谱还跑了 Leiden 社区检测算法,把高度互连的节点聚成社区,这对应代码里的模块或子系统。hub 节点是被大量其他节点依赖的节点,改它们风险高。bridge 节点是连接两个社区的节点,改它们可能产生跨模块影响。
风险评分综合了这几个因素,变更节点的 hub 程度,影响半径内的节点数量,边的置信度,社区跨越数,测试覆盖率。输出一个 0 到 100 的分数,给人类 reviewer 和 CI 门禁一个快速判断依据。
跟其他工具怎么选
我在之前的 073 篇文章里对比过 sense、codegraph、CodeGraph 三个工具。这次加上 CRG,再补两个常被拿来比的。
Serena,走的是 LSP 路线,语义精确,但每个语言要起 language server,重,资源占用高。适合需要精确重命名、类型推导的场景。CRG 走 Tree-sitter 路线,轻量,语言覆盖广,适合 review 和影响分析这种「宁滥勿缺」的场景。
repomix,做的是把整个仓库打包成一个大文本文件喂给 AI。它解决的是「怎么把代码塞给 AI」,CRG 解决的是「该把哪些代码塞给 AI」。两者可以配合,repomix 打包的同时用 CRG 筛选文件。
claude-context 类 RAG 工具,做向量检索,适合「找哪里提到了某个概念」的模糊查询。CRG 适合「找这个函数被谁调用了」的结构化查询。一个找文本,一个找关系。
sense / codegraph,073 篇聊过,sense 偏向 IDE 内的实时可视化,codegraph 偏向生成静态架构图。CRG 是唯一一个深度集成 MCP、以「给 AI 消费」为第一目标的图谱工具,它输出的不是给人看的图,而是给 AI 读的结构化 JSON。
简单的选择建议,
- 代码库超过 500 个文件,AI 经常读太多无关代码,上 CRG
- 需要精确的类型感知重构,用 Serena
- 只是想把仓库一次性喂给 AI 做总结,repomix 够用
- 想找「哪里提到了 XXX」的模糊搜索,RAG 类工具更直接
什么时候不该用
这篇文章不是软文,有些场景 CRG 反而帮倒忙。
小项目别装。 几百个文件以下的项目,AI 本来就能把相关代码读进 context。CRG 的结构元数据本身有开销,小改动时 graph response 可能比原始 diff 还大。官方文档明确写了这个限制。
琐碎改动别用。 改个文案、调个 CSS、加个日志,直接让 AI 看 diff 就行,绕一圈查图谱纯属浪费。
JavaScript 和 Go 的流检测目前较弱。 官方 benchmark 里 JS/Go 的数据流检测 recall 只有 33%,意味着三分之二的数据流关系会漏掉。这两个语言的动态分发和接口隐式实现让 Tree-sitter 级别的启发式分析很吃力。如果你的核心诉求是追踪 JS 或 Go 的数据流,目前要降低预期。
搜索功能本身不强。 符号搜索的 MRR 只有 0.35,Mean Reciprocal Rank,一个衡量搜索结果质量的指标,0.35 意味着正确结果平均出现在第三个位置左右。它不是搜索引擎,别指望它当 Sourcegraph 用。它的强项是找到起点之后沿边遍历,不是找到起点本身。
co-change 预测还不可用。 就是「改了这个文件,历史上通常还会一起改哪些文件」,这个功能基于 git 历史挖掘,目前预测准确率为 0,官方自己标了 experimental。别用它做决策。
FAQ
Q,它会把我的代码传到云端吗。
不会。图谱存在本地 SQLite,MCP 绑定 localhost,零遥测,不发任何网络请求。唯一的网络行为是可选的 embedding 模型从 HuggingFace 下载,下载完也全本地跑。
Q,支持私有仓库和 monorepo 吗。
支持。它只看 git ls-files,不关心仓库在哪。monorepo 可以在根目录 build,也可以在子包目录分别 build。大 monorepo 建议分模块建图,避免单张图过大。
Q,跟 Claude Code 内置的代码搜索有什么区别。
Claude Code 内置的是 glob 和 grep,基于文件名和文本匹配。CRG 给的是结构关系,「谁调用了这个函数」「这个类被谁继承了」「改了这个文件影响哪些测试」,grep 答不了这些问题。两者是互补的,不是替代关系。
Q,构建图谱会不会很慢。
500 文件首次约 10 秒,3000 文件增量约 2.5 秒,其中 1.4 秒是 Python 启动。日常开发开 watch 模式,文件保存自动更新,体感是秒级。
Q,30 个 MCP 工具会不会让 AI 选择困难。
实际不会。AI 通过工具描述选择,而且大部分场景用的是 review-delta 和 review-pr 这两个封装好的 prompt 模板,不需要手动挑工具。30 个工具是给高级场景用的,比如调试某个函数时手动沿调用链查。
写在最后
我用了一周,最大的感受不是「省了多少 token」,而是 review 质量确实变了。
以前 Claude Code review 代码时,它只会看你给它的 diff,最多 grep 一下相关引用。现在它会顺着图查,「你改了这个函数,但它的子类重写了这个方法,你没改」「这个函数被三个上游调用,其中一个没处理你新加的错误码」。这种 review 是以前做不到的,不是因为模型变聪明了,是因为它终于有了地图。
Token 经济学里有个常被忽略的点,context window 越大,越有人觉得「全塞进去就行」。但大 context 有两个隐性成本,一是钱,input token 按用量计费,二是质量,lost in the middle 效应,模型对 context 中间位置的信息关注度显著下降。把 94 万 token 塞给模型,效果未必好过精准的 2600 token。
code-review-graph 证明了这件事。它不是让 AI 更聪明,是让 AI 少走弯路。
项目地址 github.com/tirth8205/code-review-graph,MIT 协议,自己拿去跑。
🔧 文中用到的完整 Prompt
以上我分享了最核心的几条,完整版合集(共 42 条,涵盖 Code Review · 重构 · 单测生成 · 架构设计 · AI Agent 调教)已整理好。

回复「prompt」即可获取,持续更新。
如果这篇对你有帮助,转发给你的程序员朋友 — 大家都在摸索 AI 提效,你的分享可能帮他省很多时间。

 浙公网安备 33010602011771号