
KMP入门
KMP 算法学习笔记
KMP 算法由唐纳德·克努斯(Donald E. Knuth)、詹姆斯·莫里斯(James H. Morris)和维克托·普拉特(Victor R. Pratt)共同提出,三人姓氏首字母均为 K、M、P,因此该算法被称为 KMP 算法。
KMP 算法,我们通常用来字符串比较,可以在线性的时间内判断模式串 \(S\) 在文本串 \(T\) 中出现的次数。
比如说在 \(ABABABC\) 里寻找 \(ABABC\) 的数量。
如果是打暴力,那么就需要 \(O(nm)\) 的时间复杂度。如果使用 KMP 就可以优化成 \(O(n+m)\) 的,虽然这个时间复杂度和哈希的一模一样,但是 KMP 还有其它的用途。
算法思想
我们在比较的时候会使用两个指针 \(i,j\),分别表示当 \(ABABABC\) 匹配到 \(i\) 时,\(ABABC\) 匹配到了 \(j\)。
暴力很简单,我们会先枚举起点,再一个字一个字的比较两个字符串来更新 \(i,j\)。当 \(S_i \ne T_j\) 的时候,我们称之为失配,也就是失去匹配。那么上面的两个字符串的第一次失配下标很明显的就是 \(4\),则 \(0\) 到 \(3\) 的位置都是匹配成功的,也就是说 \(S\) 和 \(T\) 两个字符串 \(0\) 到 \(3\) 的字符都一样。这是我们想要优化,只能让这个 \(i\) 继续往前走,不让它回头。想让它继续走的办法也很简单,就是调整 \(j\),找到另一处可以匹配的地方。很明显在这组数据中我们要把 \(j\) 调整为 \(2\),因为 \(0\) 到 \(1\) 的字符串是 \(AB\),刚好和 \(S\) 匹配,所以我们可以继续匹配。如果再失配,就再调整。此次操作如下图:
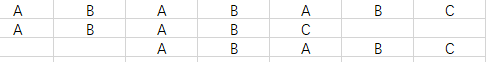
容易发现,\(AB\) 既是 \(ABAB\) 的前缀,又是 \(ABAB\) 的后缀,我们称之为前后缀,同时它又是最长的一个,所以是最长公共前后缀。而我们的 KMP 有刚好是跳到这个公共前后缀,才能让 \(i\) 继续往前,还得是最长的前后缀,才能保证不会有遗漏的答案。因为 \(T\) 字符串的前 \(j\) 个字符已经和 \(S\) 匹配成功了,而 \(T\) 的前缀又和后缀相同,所以 \(T\) 的前缀也一定可以和 \(S\) 匹配成功。那么我们把这个最长公共前后缀存储到一个 \(nxt\) 数组里,则一旦 \(i\) 和 \(j\) 失配,就让 \(j\) 跳到 \(nxt_j\)。完全匹配,也让 \(j\) 跳到 \(nxt_j\),进行下一轮匹配。我们的 KMP 也就完成了。
模板
代码
#include<bits/stdc++.h>
using namespace std;
string s1,s2;
int n,m;
int nxt[1000005];
void init(){
	nxt[0]=-1;
	int i=0,j=-1;
	while(i<m){
		if(j==-1 || s2[i]==s2[j]){
			i++;j++;
			nxt[i]=j;
		}else{
			j=nxt[j];
		}
	}
	return;
}
void gsum(){
	int i=0,j=0;
	while(i<n){
		if(j==m-1 && s1[i]==s2[j]){
			cout<<i-j+1<<"\n";
			j=nxt[j];
		}
		if(j==-1 || s1[i]==s2[j]){
			i++;j++;
		}else{
			j=nxt[j];
		}
	}
	return;
}
signed main(){
	ios::sync_with_stdio(false);
	cin.tie(0);cout.tie(0);
	cin>>s1>>s2;
	n=s1.size();m=s2.size();
	init();
	gsum();
	for(int i=1;i<=m;i++){
		cout<<nxt[i]<<' ';
	}
	return 0;
}
P4824 [USACO15FEB] Censoring S
这道题类似消消乐,每当 \(S\) 中出现 \(T\) 都会消除,这样也就会产生连锁反应,因为删除了一个 \(T\),从而使得新产生了一个 \(T\),就比如说样例就很典型。
那肯定和普通的 KMP 有一定的区别。
考虑到删除操作,我们用一个栈来记录匹配的情况,每次匹配成功就记录下来,如果完全匹配了,就回到上一次失配的地方,也就是删除掉栈最后面 \(|T|\) 个元素,其他地方照常写即可。最后按顺序输出栈中的下标。
代码
#include<bits/stdc++.h>
using namespace std;
string s,t;
int n,m;
int nxt[1000005];
int tt[1000005];
int top;
int q[1000005];
void init(){
	nxt[0]=-1;
	int i=0,j=-1;
	while(i<m){
		if(j==-1 || t[i]==t[j]){
			i++;j++;
			nxt[i]=j;
		}else{
			j=nxt[j];
		}
	}
	return;
}
void gsum(){
	int i=0,j=0;
	while(i<n){
		if(j==-1 || s[i]==t[j]){
			tt[i]=j+1;
			q[++top]=i;
			i++;j++;
		}else{
			j=nxt[j];
		}
		if(j==m){
			top=top-m;//删除栈中元素
			j=tt[q[top]];
		}
	}
	return;
}
signed main(){
	ios::sync_with_stdio(false);
	cin.tie(0);cout.tie(0);
	cin>>s>>t;
	n=s.size();
	m=t.size();
	init();
	gsum();
	for(int i=1;i<=top;i++){
		cout<<s[q[i]];
	}
	return 0;
}
HDU - 1358
在这题中需要用到 KMP 的一个很重要的性质,最重要的一个性质。字符串 \(S\) 前 \(i\) 个字符的循环节的长度为 \(i-nxt_i\)。
那么有了这一神奇性质的帮助,这题相信已经难不住你,只需要枚举 \(2\) 到 \(n\) 即可,然后判断循环节是否是 \(i\) 的因数,并且循环次数大于 \(1\)。
代码
#include<bits/stdc++.h>
using namespace std;
int n;
string s;
int nxt[1000005];
void init(){
	nxt[0]=-1;
	int i=0,j=-1;
	while(i<n){
		if(j==-1 || s[i]==s[j]){
			i++;j++;
			nxt[i]=j;
		}else{
			j=nxt[j];
		}
	}
	return;
}
signed main(){
	ios::sync_with_stdio(false);
	cin.tie(0);cout.tie(0);
	int tot=1;
	while(1){
		cin>>n;
		if(n==0){
			break;
		}
		cin>>s;
		cout<<"Test case #"<<tot++<<"\n";
		for(int i=1;i<=n;i++){
			nxt[i]=0;
		}
		init();
		for(int i=2;i<=n;i++){
			if(i%(i-nxt[i])==0 && i/(i-nxt[i])>1){
				cout<<i<<' '<<i/(i-nxt[i])<<"\n";
			}
		}
		cout<<"\n";
	}
	return 0;
}

 浙公网安备 33010602011771号