
模型层相关
模型层

单表操作
Django自带的sqlite3数据库对日期格式不是很敏感,处理的时候容易出错。
注册时间记录
class User(models.Model):
    name = models.CharField(max_length=32, verbose_name='姓名')
    age = models.IntegerField(verbose_name='年龄')
    register_time = models.DateField(verbose_name='注册时间')  # 年月日
    """
        - DateField
        - DateTimeField
            - 两个重要的参数
                - auto_now:每次操作数据的时候,该字段会自动将当前时间更新
                - auto_now_add:在创建数据的时候会自动将当前创建的时间记录下来,之后只要不人为的修改时间就不会变
    """
测试脚本书写格式
"""
	- 测试环境的准备 去manage.py中拷贝前四行代码
	- 然后自己写两行
		- import django
		  django.setup()

	- 脚本代码无论是写在应用下的tests.py还是自己单独开设py文件都可以
"""

import os
import sys

if __name__ == "__main__":
    os.environ.setdefault("DJANGO_SETTINGS_MODULE", "day64.settings")
    import django
    django.setup()

    # 所有的代码只有等待环境加载完毕才能进行书写
    from app01 import models

    models.User.objects.all()
单表增删改查
# 增
1.create()
2.对象.save()

# 查
1.all()  # 查询所有
2.filter()  # 筛选条件  没有查询到则返回None
3.get()  # 筛选条件  条件不存在则报错  不推荐使用

# 改
1.update()  # 实际上是QuerySet封装的批量更新方法
2.对象.save()

# 删
1.delete()  # QuerySet封装的批量删除方法
2.对象.delete()  # 对象中封装好的方法
注意:
在实际的项目中,数据不会直接删除,会在数据里添加一个字段进行标记。
# 增
import datetime
now_time = datetime.datetime.now()
user_obj = models.User(name='张三', age='18', register_time=now_time)  # 获取对象
user_obj.save()  # 保存

# 删
"""方式1"""
res = models.User.objects.filter(pk=2).delete()
print(res)  # 返回当前sql语句所影响的行数
"""
        - pk会自动查找当前表的主键字段,指代的就是当前表的主键字段
        - 用了pk就不需要知道当前表的主键字段名称是什么,提高效率
    """

"""方式2"""
user_obj = models.User.objects.filter(pk=3).first()
user_obj.delete()

# 改
"""方式1"""
models.User.objects.filter(pk=1).update(name='李四')

"""方式2"""
user_obj = models.User.objects.get(pk=1)
    print(user_obj)
    """
        User object
        - get方法直接返回当前的数据对象
        - 但是不推荐使用,一旦数据不存在,则会报错
    """
    user_obj.name = '王五'
    user_obj.save()

# 查
query_set = models.User.objects.all()
print(query_set.first().name)
必知必会查询13条
"""常用的查询方式"""
1.all()  # 查询所有数据
2.filter()  # 过滤查询  查询不到返回None
3.get()  # 直接获取数据  查询不到报错
4.values()  # 获取指定字段的对应数据 返回的结果是一个queryset对象(列表套字典形式)
5.values_list()  # 获取指定字段对应的数据 返回的结果是一个queryset对象(列表套元组形式)
6.count()  # 统计查询出来的数据的个数
7.first()  # 拿取queryset里面第一个元素
# 1.all()  查询所有数据

# 2.filter()     带有过滤条件的查询  查询不到数据不会报错  会返回None

# 3.get()        直接拿数据对象 但是条件不存在直接报错

# 4.first()      拿queryset里面第一个元素
# res = models.User.objects.all().first()
# print(res)


# 5.last()
# res = models.User.objects.all().last()
# print(res)

"""重要内容"""
# 6.values()  可以指定获取的数据字段  select name,age from ...     列表套字典
# res = models.User.objects.values('name','age')  # <QuerySet [{'name': 'jason', 'age': 18}, {'name': 'egonPPP', 'age': 84}]>
# print(res)


# 7.values_list()  列表套元组
# res = models.User.objects.values_list('name','age')  # <QuerySet [('jason', 18), ('egonPPP', 84)]>
# print(res)
"""
查看内部封装的sql语句
上述查看sql语句的方式  只能用于queryset对象
只有queryset对象才能够点击query查看内部的sql语句
"""

# ******************************************

# 8.distinct()  去重
# res = models.User.objects.values('name','age').distinct()  # 获取name和age字段数据并去重  一定不能包含主键信息
# print(res)
"""
    去重一定要是一模一样的数据
    如果带有主键那么肯定不一样 你在往后的查询中一定不要忽略主键

"""

# 9.order_by()
# res = models.User.objects.order_by('age')  # 默认升序
# res = models.User.objects.order_by('-age')  # 降序
# print(res)

# 10.reverse()  反转  前提是数据已经排过序了  order_by()
# res = models.User.objects.all()
# res1 = models.User.objects.order_by('age').reverse()
# print(res,res1)

# 11.count()  统计当前数据的个数
# res = models.User.objects.count()
# print(res)

# 12.exclude()  排除在外
# res = models.User.objects.exclude(name='张三')  获取不包含 张三 的字段数据
# print(res)

# 13.exists()  基本用不到因为数据本身就自带布尔值  返回的是布尔值
# res = models.User.objects.filter(pk=10).exists()
# print(res)
ORM内部的SQL语句的查看
# 方式1
res = models.User.objects.values_list('name','age')  # <QuerySet [('jason', 18), ('egonPPP', 84)]>
print(res.query)

# queryset对象才能够点击query查看内部的sql语句

# 方式2:所有的sql语句都能查看
# 去配置文件中进行配置即可
LOGGING = {
    'version': 1,
    'disable_existing_loggers': False,
    'handlers': {
        'console':{
            'level':'DEBUG',
            'class':'logging.StreamHandler',
        },
    },
    'loggers': {
        'django.db.backends': {
            'handlers': ['console'],
            'propagate': True,
            'level':'DEBUG',
        },
    }
}
双下划线查询
1.__gt  # 大于  greate than
2.__lt  # 小于  less than
3.__gte # 大于等于
4.__lte  # 小于等于
5.__in  # 成员运算
6.__range  # 范围查询  顾头也顾尾
7.__contains  # 模糊查询  默认区分大小写
8.__icontains  # 模糊查询 忽略大小写

# 只按照年份或者月份查询
9.create_time_year
10.create_time_month
# 1 年龄大于35岁的数据
# res = models.User.objects.filter(age__gt=35)  # greater than
# print(res)
# 2 年龄小于35岁的数据
# res = models.User.objects.filter(age__lt=35)  # less than
# print(res)
# 大于等于 小于等于
# res = models.User.objects.filter(age__gte=32)
# print(res)
# res = models.User.objects.filter(age__lte=32)
# print(res)

# 年龄是18 或者 32 或者40
# res = models.User.objects.filter(age__in=[18,32,40])  # in
# print(res)

# 年龄在18到40岁之间的  首尾都要
# res = models.User.objects.filter(age__range=[18,40])  # range  顾头也顾尾
# print(res)

# 查询出名字里面含有s的数据  模糊查询  sql中是like
# res = models.User.objects.filter(name__contains='s')  # contains -->包含
# print(res)
#
# 是否区分大小写  查询出名字里面含有p的数据  区分大小写
# res = models.User.objects.filter(name__contains='p')
# print(res)
# 忽略大小写
# res = models.User.objects.filter(name__icontains='p')  # icontains  i-->ignore
# print(res)

# res = models.User.objects.filter(name__startswith='j')
# res1 = models.User.objects.filter(name__endswith='j')
# print(res,res1)


# 查询出注册时间是 2020 1月
# res = models.User.objects.filter(register_time__month='1')
# res = models.User.objects.filter(register_time__year='2020')
一对多外键增删改查
from django.db import models

# Create your models here.


class Book(models.Model):
    title = models.CharField(max_length=32, verbose_name='书籍名称')
    price = models.DecimalField(max_digits=8, decimal_places=2, verbose_name='书籍价格')
    publish_date = models.DateField(auto_now_add=True, verbose_name='出版时间')

    """书籍和出版社是一对多的关系"""
    publish = models.ForeignKey(to='Publish')

    """书籍和作者是多对多的关系"""
    authors = models.ManyToManyField(to='Author')

class Publish(models.Model):
    name = models.CharField(max_length=32, verbose_name='出版社名称')
    addr = models.CharField(max_length=64, verbose_name='出版社地址')
    email = models.EmailField()  # 出版社邮箱地址  varchar(254)


class Author(models.Model):
    name = models.CharField(max_length=32, verbose_name='作者姓名')
    age = models.IntegerField()

    """作者和作者信息是一对一关系"""
    author_detail = models.OneToOneField(to='AuthorDetail')


class AuthorDetail(models.Model):
    phone = models.BigIntegerField(verbose_name='电话号码')  # 也可以使用CharField()
    addr = models.CharField(max_length=64, verbose_name='住址')
增
"""一对多外键增删改查"""
# 增
"""方式1:直接写实际字段---> id"""
models.Book.objects.create(title='三国演义', price=123.23, publish_id=1)

"""方式2:虚拟字段--->对象"""
publish_obj = models.Publish.objects.filter(pk=2).first()
models.Book.objects.create(title='红楼梦', price=666.66, publish=publish_obj)
删
# 删
models.Publish.objects.filter(pk=1).delete()  # 级联删除  删除出版社-->对应的书籍也删除
改
# 改
"""方式1:直接update方法"""
models.Book.objects.filter(pk=1).update(publish_id=2)  # 将主键为1的书籍对应的出版社改为2

"""方式2:对象方式"""
publish_obj = models.Publish.objects.filter(pk=1).first()
models.Book.objects.filter(pk=1).update(publish=publish_obj)  # 将主键为1的书籍的出版社改为1
多对多外键增删改查
增
"""多对多外键增删改查  --->   实际上是对第三章关系表的增删改查"""
# ****************************
book_obj = models.Book.objects.filter(pk=1).first()  # 先拿到主键为1的书籍的对象
# ****************************

# print(book_obj.authors)  # 就类似于你已经到了第三张关系表了

"""方式1:添加主键"""
book_obj.authors.add(1)  # 书籍主键为1的书籍添加主键为1的作者
book_obj.authors.add(2, 3)  # 书籍主键为1的书籍添加主键为2和3的作者

"""方式2:添加对象"""
author_obj1 = models.Author.objects.filter(pk=1).first()
author_obj2 = models.Author.objects.filter(pk=2).first()
author_obj3 = models.Author.objects.filter(pk=3).first()

book_obj.authors.add(author_obj1)
book_obj.authors.add(author_obj1, author_obj2,author_obj3)


"""
    add给第三张关系表添加数据
    括号内既可以传数字也可以传对象 并且都支持多个
"""
删
# 删
book_obj = models.Book.objects.filter(pk=1).first()  # 先拿到主键为1的书籍的对象
"""方式1:主键"""
book_obj.authors.remove(2)  # 删除author_id为2的数据

"""方式2:对象"""
author_obj1 = models.Author.objects.filter(pk=1).first()
author_obj3 = models.Author.objects.filter(pk=3).first()
book_obj.authors.remove(author_obj1, author_obj3)
"""
    remove
        括号内既可以传数字也可以传对象 并且都支持多个
    """
改
# 改
book_obj = models.Book.objects.filter(pk=1).first()  # 先拿到主键为1的书籍的对象
"""方式1:主键"""
book_obj.authors.set([1, 2])  # set必须传可迭代对象  将对应的作者主键改为1和2
# 有数据就不变 无数据就新增  也就是先删除再新增

"""方式2:对象"""
author_obj1 = models.Author.objects.filter(pk=1).first()
author_obj2 = models.Author.objects.filter(pk=2).first()
author_obj3 = models.Author.objects.filter(pk=3).first()
book_obj.authors.set([author_obj1, author_obj2, author_obj3])

"""
    set
        括号内必须传一个可迭代对象,该对象内既可以数字也可以对象 并且都支持多个
"""
清空
# 清空
# 在第三张关系表中清空某个书籍与作者的绑定关系
book_obj = models.Book.objects.filter(pk=1).first()  # 先拿到主键为1的书籍的对象
book_obj.authors.clear() # 清空主键为1的书籍的全部作者绑定关系

"""
    clear
        括号内不要加任何参数
"""
正反向概念
# 正向
外键字段在我手上那么,我查你就是正向

# 反向
外键字段如果不在手上,我查你就是反向

  book >>>外键字段在书那儿(正向)>>> publish
  publish	>>>外键字段在书那儿(反向)>>>book

  一对一和多对多正反向的判断也是如此

"""
正向查询按字段
反向查询按 表名 小写
				_set
				.all()
"""
多表操作
子查询(基于对象的跨表查询)
- 正向查询
正向查询按外键字段。
"""基于对象的跨表查询"""
# 1.查询书籍主键为1的出版社
book_obj = models.Book.objects.filter(pk=1).first()
"""正向查询按字段"""
publish = book_obj.publish  # 表中有publish外键字段   拿到的是对象
print(publish)
# 如果数据是多个  则publish.all() 进行数据展示
print(publish.name, publish.addr)


# 2.查询书籍主键为2的作者
book_obj = models.Book.objects.filter(pk=2).first()
"""书查作者-->正向"""
# res = book_obj.authors  # app01.Author.None 则表示ORM语句少一个.all()方法
res = book_obj.authors.all()  # <QuerySet [<Author: Author object>]>
print(res)


# 3.查询作者为王五的电话号码
author_obj = models.Author.objects.filter(name='王五').first()
res = author_obj.author_detail  # AuthorDetail object
print(res)
print(res.phone, res.addr)


"""
    在书写orm语句的时候跟写sql语句一样的
    不要企图一次性将orm语句写完 如果比较复杂 就写一点看一点

    正向什么时候需要加.all()
        当你的结果可能有多个的时候就需要加.all()
        如果是一个则直接拿到数据对象
            book_obj.publish
            book_obj.authors.all()
            author_obj.author_detail
"""
- 反向查询
反向查询按表名小写,有时候需要加_set或者.all()。
"""反向查询"""
# 4.查询是 东方出版社 出版的书籍
publish_obj = models.Publish.objects.filter(name='东方出版社').first()
"""出版社查书--->反向"""
# 反向查询按照 表名小写_set  如:查书 --> book.set
# res = publish_obj.book_set  # app01.Book.None
res = publish_obj.book_set.all()
print(res)


# 5.查询作者是 张三 写过的书籍
author_obj = models.Author.objects.filter(name='张三').first()
"""作者查书--->反向"""
# res = author_obj.book_set  # app01.Book.None
res = author_obj.book_set.all()  # <QuerySet [<Book: Book object>, <Book: Book object>, <Book: Book object>]>
print(res)
for book in res:
    print(book.title, book.price)
    """
            红楼梦 666.66
            三国演义 123.23
            论语 23.23
    """


# 6.查询手机号是 888 的作者姓名
author_detail_obj = models.AuthorDetail.objects.filter(phone=888).first()
res = author_detail_obj.author
print(res)  # Author object
print(res.name, res.age)  # 李四 100
基于对象反向查询方法
 """
    基于对象
        反向查询的时候
            当你的查询结果可以有多个的时候 就必须加_set.all()
            当你的结果只有一个的时候 不需要加_set.all()
"""
联表查询(基于双下划线的跨表查询)
"""MySQL联表操作"""
inner join  # 内连接  拼接共有数据
left join  # 左连接  全展示左表数据  右表无对应数据则显示null
right join  # 右连接  全展示右表数据 左表无对应数据则显示null
union  # 全连接  左右两表数据全部展示出来
"""基于双下划线的跨表查询"""
# 1.查询主键为1的出版社名称和书的名称
res = models.Book.objects.filter(pk=1).values('title', 'publish__name')  # title书的名称  publish__name出版社名称
print(res)  # <QuerySet [{'title': '三国演义', 'publish__name': '东方出版社'}]>
print(res.first().get('title'), res.first().get('publish__name'))  # 三国演义 东方出版社


# 2.查询 张三 的手机号
"""
        - author_detail  到这个表
            - author_detail__phone  要phone这个字段

"""
res = models.Author.objects.filter(name='张三').values('author_detail__phone', 'name')
print(res)  # <QuerySet [{'author_detail__phone': 123, 'name': '张三'}]>


# 3.查询书籍主键为1的作者姓名
"""正向"""
res = models.Book.objects.filter(pk=1).values('authors__name')
print(res)  # <QuerySet [{'authors__name': '张三'}]>

"""反向"""
res = models.Author.objects.filter(book__id=1).values('name')  # 反向表名小写
print(res)  # <QuerySet [{'name': '张三'}]>


# 4.查询书籍主键是1的作者的手机号
""" book ---> author ---> author_detail"""
res = models.Book.objects.filter(pk=1).values('authors__author_detail__phone')
print(res)  # <QuerySet [{'authors__author_detail__phone': 123}]>
print(res.first().get('authors__author_detail__phone'))  # 123
聚合查询(aggregate)
通常情况下都是配合分组一起使用的。
"""聚合查询:aggregate"""
"""
    聚合查询通常情况下都是配合分组进行使用的
        - 同数据库相关的模块基本上都在django.db.models中
        - 或者在django.db中
"""
from app01 import models
from django.db.models import Max, Min, Sum, Count, Avg

# 1.统计所有书籍的平均价格
avg_price = models.Book.objects.aggregate(Avg('price'))
print(avg_price)  # {'price__avg': 238.376}

# 2.将上述方法一次性全部展示
res = models.Book.objects.aggregate(Max('price'), Min('price'), Sum('price'), Count('pk'), Avg('price'))
print(res)
# {'price__max': Decimal('666.66'), 'price__min': Decimal('23.23'), 'price__sum': Decimal('1191.88'), 'pk__count': 5, 'price__avg': 238.376}
分组查询(annotate)
"""
    MySQL分组查询都有哪些特点
        分组之后默认只能获取到分组的依据 组内其他字段都无法直接获取了
            严格模式
                ONLY_FULL_GROUP_BY

"""
"""分组查询:annotate"""
from django.db.models import Max, Min, Sum, Count, Avg

# 1.统计每一本书的作者个数
# res = models.Book.objects.annotate()  # models后面点什么 就是按什么分组  这里是按照书分组
res = models.Book.objects.annotate(author_num=Count('authors')).values('title', 'author_num')  # 正向查询按字段
"""
    author_num是我们自己定义的字段 用来存储统计出来的每本书对应的作者个数
"""
print(res)
# <QuerySet [{'title': '三国演义', 'author_num': 1}, {'title': '红楼梦', 'author_num': 2}, {'title': '论语', 'author_num': 2}, {'title': '中庸', 'author_num': 1}, {'title': '老子', 'author_num': 2}]>
# 等价于以下代码
# res1 = models.Book.objects.annotate(author_num=Count('authors__id')).values('title','author_num')


# 2.统计每个出版社卖的最便宜的书的价格
"""按照出版社分组  获取书籍的价格最小的   反向查询  表名小写__price"""
res = models.Publish.objects.annotate(min_price=Min('book__price')).values('name', 'min_price')
print(res)  # <QuerySet [{'name': '东方出版社', 'min_price': Decimal('23.23')}, {'name': '北方出版社', 'min_price': Decimal('323.23')}]>


# 3.统计不止一个作者的图书
"""
        - 按照图书分组
            - 先按照图书分组,获取一本书对应的作者个数
            - filter过滤出作者个数>1的图书  __gt
    """
res = models.Book.objects.annotate(author_num = Count('authors')).filter(author_num__gt=1).values('title', 'author_num')
print(res)  # <QuerySet [{'title': '红楼梦', 'author_num': 2}, {'title': '论语', 'author_num': 2}, {'title': '老子', 'author_num': 2}]>

"""
   只要你的orm语句得出的结果还是一个queryset对象
   那么它就可以继续无限制的点queryset对象封装的方法

"""


# 4.查询每个作者出的书的总价格
"""
    - 按照作者分组
        - 作者查书-->反向  book__price 获取书的价格
    - 获取作者书籍的价格并计算总价
"""
res = models.Author.objects.annotate(sum_price=Sum('book__price')).values('name', 'sum_price')
print(res)
# <QuerySet [{'name': '张三', 'sum_price': Decimal('868.65')}, {'name': '李四', 'sum_price': Decimal('745.42')}, {'name': '王五', 'sum_price': Decimal('323.23')}]>
按照指定的字段进行分组
models.Book.objects.values('price').annotate()
进行分组查询报错,则需要修改数据库的严格模式。
F和Q查询
F查询
能够帮助你直接获取到表中某个字段对应的数据。
"""F查询"""
from app01 import models
from django.db.models import F
# 1.查询销量大于库存的书籍
res = models.Book.objects.filter(sales__gt=F('stock'))
print(res)
for book in res:
    print(book.title)  # 论语 中庸 老子

# 2.将所有书籍的价格提升100块
    """
    也就是所有书的价格基于原来书的价格增加100
    """
models.Book.objects.update(price=F('price') + 100)

# 3.将所有书的名称后面加上爆款两个字
    """
    在操作字符类型的数据的时候 F不能够直接做到字符串的拼接
    """
from django.db.models.functions import Concat  # 拼接模块
from django.db.models import Value

models.Book.objects.update(title=Concat(F('title'), Value('爆款')))
Q查询
"""Q查询"""
from app01 import models
from django.db.models import Q
# 1.查询销量大于100或者价格小于600的书籍
# res = models.Book.objects.filter(maichu__gt=100,price__lt=600)
"""filter括号内多个参数是and关系"""
res1 = models.Book.objects.filter(Q(maichu__gt=100),Q(price__lt=600)) # , 与
res2 = models.Book.objects.filter(Q(sales__gt=100)|Q(price__lt=600))  # | 或
res3 = models.Book.objects.filter(~Q(maichu__gt=100)|Q(price__lt=600)) # ~ 非
print(res2)
for book in res2:
    print(book.title, book.sales, book.price)
    """
        三国演义 800 323.23
        红楼梦 1000 866.66
        论语 2000 223.23
        中庸 800 523.23
        老子 1500 255.53
       """
# Q的高阶用法  能够将查询条件的左边也变成字符串的形式   用户能够指定其搜索形式
q = Q()
q.connector = 'or'  # 将默认的and改为or
"""
Q源码解析:
# Connection types
    AND = 'AND'
    OR = 'OR'
    default = AND
"""
q.children.append(('sales__gt', 100))
q.children.append(('price__lt', 600))
res = models.Book.objects.filter(q)  # 默认为and关系
print(res) # <QuerySet [<Book: Book object>, <Book: Book object>, <Book: Book object>, <Book: Book object>, <Book: Book object>]>
for book in res:
    print(book.title, book.sales, book.price)
Django中事务的开启
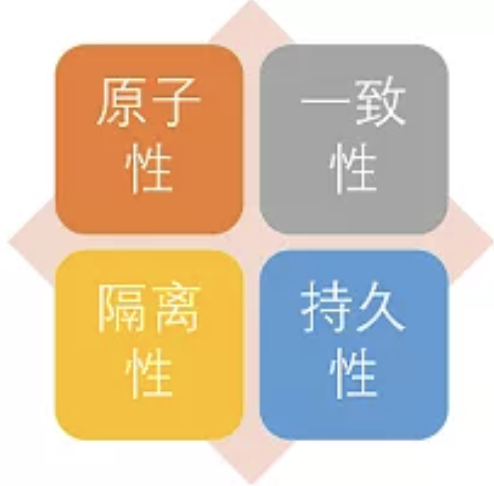
"""
事务
	ACID
		原子性
			不可分割的最小单位
		一致性
			跟原子性是相辅相成
		隔离性
			事务之间互相不干扰
		持久性
			事务一旦确认永久生效

	事务的回滚
		rollback
	事务的确认
		commit
"""
# 目前你只需要掌握Django中如何简单的开启事务
# 事务
    from django.db import transaction
    try:
        with transaction.atomic():
            # sql1
            # sql2
            ...
            # 在with代码块内书写的所有ORM操作都是属于同一个事务
    except Exception as e:
        print(e)
    print('执行其他操作')
ORM中常用字段及参数
AutoField()
主键字段 primary_key=True。
CharField
对应到数据库里面是varchar,verbose_name字段的注释,max_length长度。
IntegerField
对应数据库中的int。
BigIntegerField
对应数据库中的bigint。
DateField
日期字段,日期格式 YYYY-MM-DD,相当于Python中的datetime.date()实例。
DateTimeField
日期时间字段,格式 YYYY-MM-DD HH:MM[:ss[.uuuuuu]][TZ],相当于Python中的datetime.datetime()实例。
auto_now:每次修改数据的时候都会自动更新当前时间
auto_now_add:只在创建数据的时候记录创建时间,后续不会自动修改
EmailField()
字符串类型,Django Admin以及ModelForm中提供验证机制,相当于varcahr(254)。
TextField()
文本类型,用来存大段内容(文章、博客等大内容)。
FileField()
文件字段。
- 字符串,路径保存在数据库,文件上传到指定目录
        - 参数:
            upload_to = ""      上传文件的保存路径
            storage = None      存储组件,默认django.core.files.storage.FileSystemStorage

         - upload_to = "/data"
给该字段传一个文件对象,会自动将文件保存到/data目录下,
然后将文件路径保存到数据库中
  /data/a.txt
常用和非常用字段
 AutoField(Field)
        - int自增列,必须填入参数 primary_key=True

    BigAutoField(AutoField)
        - bigint自增列,必须填入参数 primary_key=True

        注:当model中如果没有自增列,则自动会创建一个列名为id的列
        from django.db import models

        class UserInfo(models.Model):
            # 自动创建一个列名为id的且为自增的整数列
            username = models.CharField(max_length=32)

        class Group(models.Model):
            # 自定义自增列
            nid = models.AutoField(primary_key=True)
            name = models.CharField(max_length=32)

    SmallIntegerField(IntegerField):
        - 小整数 -32768 ~ 32767

    PositiveSmallIntegerField(PositiveIntegerRelDbTypeMixin, IntegerField)
        - 正小整数 0 ~ 32767
    IntegerField(Field)
        - 整数列(有符号的) -2147483648 ~ 2147483647

    PositiveIntegerField(PositiveIntegerRelDbTypeMixin, IntegerField)
        - 正整数 0 ~ 2147483647

    BigIntegerField(IntegerField):
        - 长整型(有符号的) -9223372036854775808 ~ 9223372036854775807

    BooleanField(Field)
        - 布尔值类型

    NullBooleanField(Field):
        - 可以为空的布尔值

    CharField(Field)
        - 字符类型
        - 必须提供max_length参数, max_length表示字符长度

    TextField(Field)
        - 文本类型

    EmailField(CharField):
        - 字符串类型,Django Admin以及ModelForm中提供验证机制

    IPAddressField(Field)
        - 字符串类型,Django Admin以及ModelForm中提供验证 IPV4 机制

    GenericIPAddressField(Field)
        - 字符串类型,Django Admin以及ModelForm中提供验证 Ipv4和Ipv6
        - 参数:
            protocol,用于指定Ipv4或Ipv6, 'both',"ipv4","ipv6"
            unpack_ipv4, 如果指定为True,则输入::ffff:192.0.2.1时候,可解析为192.0.2.1,开启此功能,需要protocol="both"

    URLField(CharField)
        - 字符串类型,Django Admin以及ModelForm中提供验证 URL

    SlugField(CharField)
        - 字符串类型,Django Admin以及ModelForm中提供验证支持 字母、数字、下划线、连接符(减号)

    CommaSeparatedIntegerField(CharField)
        - 字符串类型,格式必须为逗号分割的数字

    UUIDField(Field)
        - 字符串类型,Django Admin以及ModelForm中提供对UUID格式的验证

    FilePathField(Field)
        - 字符串,Django Admin以及ModelForm中提供读取文件夹下文件的功能
        - 参数:
                path,                      文件夹路径
                match=None,                正则匹配
                recursive=False,           递归下面的文件夹
                allow_files=True,          允许文件
                allow_folders=False,       允许文件夹

    FileField(Field)
        - 字符串,路径保存在数据库,文件上传到指定目录
        - 参数:
            upload_to = ""      上传文件的保存路径
            storage = None      存储组件,默认django.core.files.storage.FileSystemStorage

    ImageField(FileField)
        - 字符串,路径保存在数据库,文件上传到指定目录
        - 参数:
            upload_to = ""      上传文件的保存路径
            storage = None      存储组件,默认django.core.files.storage.FileSystemStorage
            width_field=None,   上传图片的高度保存的数据库字段名(字符串)
            height_field=None   上传图片的宽度保存的数据库字段名(字符串)

    DateTimeField(DateField)
        - 日期+时间格式 YYYY-MM-DD HH:MM[:ss[.uuuuuu]][TZ]

    DateField(DateTimeCheckMixin, Field)
        - 日期格式      YYYY-MM-DD

    TimeField(DateTimeCheckMixin, Field)
        - 时间格式      HH:MM[:ss[.uuuuuu]]

    DurationField(Field)
        - 长整数,时间间隔,数据库中按照bigint存储,ORM中获取的值为datetime.timedelta类型

    FloatField(Field)
        - 浮点型

    DecimalField(Field)
        - 10进制小数
        - 参数:
            max_digits,小数总长度
            decimal_places,小数位长度

    BinaryField(Field)
        - 二进制类型
字段同数据库的对应关系
	'AutoField': 'integer AUTO_INCREMENT',
    'BigAutoField': 'bigint AUTO_INCREMENT',
    'BinaryField': 'longblob',
    'BooleanField': 'bool',
    'CharField': 'varchar(%(max_length)s)',
    'CommaSeparatedIntegerField': 'varchar(%(max_length)s)',
    'DateField': 'date',
    'DateTimeField': 'datetime',
    'DecimalField': 'numeric(%(max_digits)s, %(decimal_places)s)',
    'DurationField': 'bigint',
    'FileField': 'varchar(%(max_length)s)',
    'FilePathField': 'varchar(%(max_length)s)',
    'FloatField': 'double precision',
    'IntegerField': 'integer',
    'BigIntegerField': 'bigint',
    'IPAddressField': 'char(15)',
    'GenericIPAddressField': 'char(39)',
    'NullBooleanField': 'bool',
    'OneToOneField': 'integer',
    'PositiveIntegerField': 'integer UNSIGNED',
    'PositiveSmallIntegerField': 'smallint UNSIGNED',
    'SlugField': 'varchar(%(max_length)s)',
    'SmallIntegerField': 'smallint',
    'TextField': 'longtext',
    'TimeField': 'time',
    'UUIDField': 'char(32)',
自定义字段类型
# django除了给你提供了很多字段类型之外 还支持你自定义字段
class MyCharField(models.Field):
    def __init__(self,max_length,*args,**kwargs):
        self.max_length = max_length
        # 调用父类的init方法
        super().__init__(max_length=max_length,*args,**kwargs)  # 一定要是关键字的形式传入
        # __init__有默认的参数

    def db_type(self, connection):
        """
        返回真正的数据类型及各种约束条件
        :param connection:
        :return:
        """
        return 'char(%s)'%self.max_length

# 自定义字段使用
myfield = MyCharField(max_length=16,null=True)


# 外键字段及参数
unique=True
	ForeignKey(unique=True)   ===			OneToOneField()
  # 你在用前面字段创建一对一 orm会有一个提示信息 orm推荐你使用后者但是前者也能用

db_index
	如果db_index=True 则代表着为此字段设置索引
  (复习索引是什么)

to_field
	设置要关联的表的字段  默认不写关联的就是另外一张的主键字段

on_delete
	当删除关联表中的数据时,当前表与其关联的行的行为。
  """
  django2.X及以上版本 需要你自己指定外键字段的级联更新级联删除
  """
ORM字段及参数
# null
用于表示某个字段可以为空。

# unique
如果设置为unique=True 则该字段在此表中必须是唯一的。
ForeignKey(unique=True)   <--->	  OneToOneField()

# db_index
如果db_index=True 则代表着为此字段设置索引。

# default
为该字段设置默认值。
数据库查询优化
only与defer
select_related与prefetch_related

"""
orm语句的特点:
	惰性查询
		如果你仅仅只是书写了orm语句 在后面根本没有用到该语句所查询出来的参数
		那么orm会自动识别 直接不执行
"""
# only与defer
# res = models.Book.objects.all()
    # print(res)  # 要用数据了才会走数据库

    # 想要获取书籍表中所有数的名字
    # res = models.Book.objects.values('title')
    # for d in res:
    #     print(d.get('title'))
    # 你给我实现获取到的是一个数据对象 然后点title就能够拿到书名 并且没有其他字段
    # res = models.Book.objects.only('title')
    # res = models.Book.objects.all()
    # print(res)  # <QuerySet [<Book: 三国演义爆款>, <Book: 红楼梦爆款>, <Book: 论语爆款>, <Book: 聊斋爆款>, <Book: 老子爆款>]>
    # for i in res:
        # print(i.title)  # 点击only括号内的字段 不会走数据库
        # print(i.price)  # 点击only括号内没有的字段 会重新走数据库查询而all不需要走了

    res = models.Book.objects.defer('title')  # 对象除了没有title属性之外其他的都有
    for i in res:
        print(i.price)
    """
    defer与only刚好相反
        defer括号内放的字段不在查询出来的对象里面 查询该字段需要重新走数据
        而如果查询的是非括号内的字段 则不需要走数据库了

    """


# select_related与prefetch_related
# select_related与prefetch_related  跟跨表操作有关
    # res = models.Book.objects.all()
    # for i in res:
    #     print(i.publish.name)  # 每循环一次就要走一次数据库查询

    # res = models.Book.objects.select_related('authors')  # INNER JOIN
    """
    select_related内部直接先将book与publish连起来 然后一次性将大表里面的所有数据
    全部封装给查询出来的对象
        这个时候对象无论是点击book表的数据还是publish的数据都无需再走数据库查询了

    select_related括号内只能放外键字段    一对多 一对一
        多对多也不行

    """
    # for i in res:
    #     print(i.publish.name)  # 每循环一次就要走一次数据库查询

    res = models.Book.objects.prefetch_related('publish')  # 子查询
    """
    prefetch_related该方法内部其实就是子查询
        将子查询查询出来的所有结果也给你封装到对象中
        给你的感觉好像也是一次性搞定的
    """
    for i in res:
        print(i.publish.name)

 浙公网安备 33010602011771号