
python学习,知识点整理
变量、运算符与数据类型
1.注释
`#` 表示注释,作用于整行。
`''' '''` 或者 `""" """` 表示区间注释,在三引号之间的所有内容被注释
2.运算符
算数运算符:
| 操作符 | 名称 | 示例 |
|---|---|---|
+ |
加 | 1 + 1 |
- |
减 | 2 - 1 |
* |
乘 | 3 * 4 |
/ |
除 | 3 / 4 |
// |
整除(地板除) | 3 // 4 |
% |
取余 | 3 % 4 |
** |
幂 | 2 ** 3 |
比较运算符:
| 操作符 | 名称 | 示例 |
|---|---|---|
> |
大于 | 2 > 1 |
>= |
大于等于 | 2 >= 4 |
< |
小于 | 1 < 2 |
<= |
小于等于 | 5 <= 2 |
== |
等于 | 3 == 4 |
!= |
不等于 | 3 != 5 |
逻辑运算符:
| 操作符 | 名称 | 示例 |
|---|---|---|
and |
与 | (3 > 2) and (3 < 5) |
or |
或 | (1 > 3) or (9 < 2) |
not |
非 | not (2 > 1) |
位运算符:
| 操作符 | 名称 | 示例 |
|---|---|---|
~ |
按位取反 | ~4 |
& |
按位与 | 4 & 5 |
| | | 按位或 | | |
^ |
按位异或 | 4 ^ 5 |
<< |
左移 | 4 << 2 |
>> |
右移 | 4 >> 2 |
在python中:
按位的运算,都按位的运算,都是把参加运算的数的二进制形式进行运算。
1.与运算:A与B值均为1时,A、B与的运算结果才为1,否则为0 (运算符:&)
2.或运算:A或B值为1时,A、B或的运算结果才为1,否则为0 (运算符:|)
3.异或运算:A与B不同为1时,A、B的预算结果才为1,否则为0 (运算符:^)
4.按位翻转(按位取反):将内存中表示数字的2进制数取反0取1,1取0 (运算符:~)
三元运算符:
x, y = 4, 5
small = x if x < y else y
print(small) # 4
其他运算符:
| 操作符 | 名称 | 示例 |
|---|---|---|
in |
存在 | 'A' in ['A', 'B', 'C'] |
not in |
不存在 | 'h' not in ['A', 'B', 'C'] |
is |
是 | "hello" is "hello" |
not is |
不是 | "hello" is not "hello" |
注意:
- is, is not 对比的是两个变量的内存地址
- ==, != 对比的是两个变量的值
- 比较的两个变量,指向的都是地址不可变的类型(str等),那么is,is not 和 ==,!= 是完全等价的。
- 对比的两个变量,指向的是地址可变的类型(list,dict,tuple等),则两者是有区别的。
运算符的优先级:
| 运算符 | 描述 |
|---|---|
| ** | 指数(最高优先级) |
| ~+- | 按位翻转,一元加号和减号 |
| * / % // | 乘,除,取模和取整除) |
| + - | 加法减法 |
| >> << | 右移,左移运算符 |
| & | 位‘AND’ |
| ^| | 位运算符 |
| <=<>>= | 比较运算符 |
| <>==!= | 等于运算符 |
| =%=/=//=-=+==*= | 赋值运算符 |
| is is not | 身份运算符 |
| in not in | 成员运算符 |
| not and or | 逻辑运算符 |
3.变量和赋值
- 在使用变量之前,需要对其先赋值。
- 变量名可以包括字母、数字、下划线、但变量名不能以数字开头。
- Python 变量名是大小写敏感的,foo != Foo。
4.数据类型与转换
| 类型 | 名称 | 示例 |
|---|---|---|
| int | 整型 <class 'int'> |
-876, 10 |
| float | 浮点型<class 'float'> |
3.149, 11.11 |
| bool | 布尔型<class 'bool'> |
True, False |
Python 里面万物皆对象(object),整型也不例外,只要是对象,就有相应的属性 (attributes) 和方法(methods)。
a = 1031
print(a, type(a))
# 1031 <class 'int'>
有时候我们想保留浮点型的小数点后 n 位。可以用 decimal 包里的 Decimal 对象和 getcontext() 方法来实现。
import decimal
from decimal import Decimal
Python 里面有很多用途广泛的包 (package),用什么你就引进 (import) 什么。包也是对象,也可以用dir(decimal) 来看其属性和方法。
使 1/3 保留 4 位,用 getcontext().prec 来调整精度。
decimal.getcontext().prec = 4
c = Decimal(1) / Decimal(3)
print(c)

# 0.3333
当把布尔型变量用在数字运算中,用 1 和 0 代表 True 和 False。
可以用 bool(X) 来创建变量,其中 X 可以是
- 基本类型:整型、浮点型、布尔型
- 容器类型:字符串、元组、列表、字典和集合
确定bool(X) 的值是 True 还是 False,就看 X 是不是空,空的话就是 False,不空的话就是 True。
- 对于数值变量,
0,0.0都可认为是空的。 - 对于容器变量,里面没元素就是空的。
注:
type()不会认为子类是一种父类类型,不考虑继承关系。isinstance()会认为子类是一种父类类型,考虑继承关系。
如果要判断两个类型是否相同推荐使用 isinstance()。isinstance(a,int)
类型转换
- 转换为整型
int(x, base=10) - 转换为字符串
str(object='') - 转换为浮点型
float(x)
5.print()
print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False)
- 将对象以字符串表示的方式格式化输出到流文件对象file里。其中所有非关键字参数都按
str()方式进行转换为字符串输出; - 关键字参数
sep是实现分隔符,比如多个参数输出时想要输出中间的分隔字符; - 关键字参数
end是输出结束时的字符,默认是换行符\n; - 关键字参数
file是定义流输出的文件,可以是标准的系统输出sys.stdout,也可以重定义为别的文件; - 关键字参数
flush是立即把内容输出到流文件,不作缓存。
位运算
1. 原码、反码和补码
二进制有三种不同的表示形式:原码、反码和补码,计算机内部使用补码来表示。
2. 按位运算
按位非操作 ~
按位与操作 &
按位或操作 |
按位异或操作 ^ 只有两个对应位不同时才为 1
按位左移操作 <<
num << i 将num的二进制表示向左移动i位所得的值。
00 00 10 11 -> 11
11 << 3
---
01 01 10 00 -> 88
按位右移操作 >>
num >> i 将num的二进制表示向右移动i位所得的值。
00 00 10 11 -> 11
11 >> 2
---
00 00 00 10 -> 2
3. 利用位运算实现快速计算
通过 <<,>> 快速计算2的倍数问题。
n << 1 -> 计算 n*2
n >> 1 -> 计算 n/2,负奇数的运算不可用
n << m -> 计算 n*(2^m),即乘以 2 的 m 次方
n >> m -> 计算 n/(2^m),即除以 2 的 m 次方
1 << n -> 2^n
通过 a & (-a) 快速获取a的最后为 1 位置的整数。
注意:整数在内存中是以补码的形式存在的,输出自然也是按照补码输出。
- Python中
bin一个负数(十进制表示),输出的是它的原码的二进制表示加上个负号,巨坑。 - Python中的整型是补码形式存储的。
- Python中整型是不限制长度的不会超范围溢出。
所以为了获得负数(十进制表示)的补码,需要手动将其和十六进制数0xffffffff进行按位与操作,再交给bin()进行输出,得到的才是负数的补码表示。
条件语句
1.if语句
if expression:
    expr_true_suite
else:
    expr_false_suite
2.if-elif-else语句
if expression1:
    expr1_true_suite
elif expression2:
    expr2_true_suite
    .
    .
elif expressionN:
    exprN_true_suite
else:
    expr_false_suite
3.assert关键词
assert这个关键词我们称之为“断言”,当这个关键词后边的条件为 False 时,程序自动崩溃并抛出AssertionError的异常。
循环语句
1.while循环
while 布尔表达式:
    代码块
else:
    代码块
当while后写入一个非零整数时,视为真值,执行循环体;写入0时,视为假值,不执行循环体。也可以写入str、list或任何序列,长度非零则视为真值,执行循环体;否则视为假值,不执行循环体。
当while循环正常执行完的情况下,执行else输出,如果while循环中执行了跳出循环的语句,比如 break,将不执行else代码块的内容。(for-else同)
2.for循环
for 迭代变量 in 可迭代对象:
    代码块
3.range()函数
range([start,] stop[, step=1])
- 这个BIF(Built-in functions)有三个参数,其中用中括号括起来的两个表示这两个参数是可选的。
- 如果是一个数字,默认从零开始。
step=1表示第三个参数的默认值是1。range这个BIF的作用是生成一个从start参数的值开始到stop参数的值结束的数字序列,该序列包含start的值但不包含stop的值。
4.enumerate()函数
enumerate(sequence, [start=0])
- sequence:一个序列、迭代器或其他支持迭代对象。
- start:下标起始位置。
- 返回 enumerate(枚举) 对象
seasons = ['Spring', 'Summer', 'Fall', 'Winter']
lst = list(enumerate(seasons))
print(lst)
# [(0, 'Spring'), (1, 'Summer'), (2, 'Fall'), (3, 'Winter')]
lst = list(enumerate(seasons, start=1))  # 下标从 1 开始
print(lst)
# [(1, 'Spring'), (2, 'Summer'), (3, 'Fall'), (4, 'Winter')]
enumerate()与 for 循环的结合使用。
for i, a in enumerate(A)
    do something with a
用 enumerate(A) 不仅返回了 A 中的元素,还顺便给该元素i一个索引值 (默认从 0 开始)。此外,用 enumerate(A, j) 还可以确定索引起始值为 j。
5.pass语句
def a_func():
    pass
pass是空语句,不做任何操作,只起到占位的作用,其作用是为了保持程序结构的完整性。尽管pass语句不做任何操作,但如果暂时不确定要在一个位置放上什么样的代码,可以先放置一个pass语句,让代码可以正常运行。
6.推导式
列表推导式
[ expr for value in collection [if condition] ]
x = [[i, j] for i in range(0, 3) for j in range(0, 3)]
print(x)
# [[0, 0], [0, 1], [0, 2], [1, 0], [1, 1], [1, 2], [2, 0], [2, 1], [2, 2]]

x[0][0] = 10
print(x)
# [[10, 0], [0, 1], [0, 2], [1, 0], [1, 1], [1, 2], [2, 0], [2, 1], [2, 2]]
a = [(i, j) for i in range(0, 3) if i < 1 for j in range(0, 3) if j > 1]
print(a)

# [(0, 2)]
多看看就理解了。
元组推导式
( expr for value in collection [if condition] )
a = (x for x in range(10))
print(a)

# <generator object <genexpr> at 0x0000025BE511CC48>

print(tuple(a))

# (0, 1, 2, 3, 4, 5, 6, 7, 8, 9)
字典推导式
{ key_expr: value_expr for value in collection [if condition] }
b = {i: i % 2 == 0 for i in range(10) if i % 3 == 0}
print(b)
# {0: True, 3: False, 6: True, 9: False}
集合推导式
{ expr for value in collection [if condition] }
c = {i for i in [1, 2, 3, 4, 5, 5, 6, 4, 3, 2, 1]}
print(c)
# {1, 2, 3, 4, 5, 6}
其他
next(iterator[, default]) 本函数是返回迭代子下一个元素的值,主要通过调用__next__()方法来实现的。如果default参数有设置,当下一个元素不存在时,就返回default参数的值,否则抛出异常StopIteration。
e = (i for i in range(10))
print(e)
# <generator object <genexpr> at 0x0000007A0B8D01B0>

print(next(e))  # 0
print(next(e))  # 1

for each in e:
    print(each, end=' ')

# 2 3 4 5 6 7 8 9
异常处理
1.python标准异常总结
- BaseException:所有异常的 基类
- Exception:常规异常的 基类
- StandardError:所有的内建标准异常的基类
- ArithmeticError:所有数值计算异常的基类
- FloatingPointError:浮点计算异常
- OverflowError:数值运算超出最大限制
- ZeroDivisionError:除数为零
- AssertionError:断言语句(assert)失败
- AttributeError:尝试访问未知的对象属性
- EOFError:没有内建输入,到达EOF标记
- EnvironmentError:操作系统异常的基类
- IOError:输入/输出操作失败
- OSError:操作系统产生的异常(例如打开一个不存在的文件)
- WindowsError:系统调用失败
- ImportError:导入模块失败的时候
- KeyboardInterrupt:用户中断执行
- LookupError:无效数据查询的基类
- IndexError:索引超出序列的范围
- KeyError:字典中查找一个不存在的关键字
- MemoryError:内存溢出(可通过删除对象释放内存)
- NameError:尝试访问一个不存在的变量
- UnboundLocalError:访问未初始化的本地变量
- ReferenceError:弱引用试图访问已经垃圾回收了的对象
- RuntimeError:一般的运行时异常
- NotImplementedError:尚未实现的方法
- SyntaxError:语法错误导致的异常
- IndentationError:缩进错误导致的异常
- TabError:Tab和空格混用
- SystemError:一般的解释器系统异常
- TypeError:不同类型间的无效操作
- ValueError:传入无效的参数
- UnicodeError:Unicode相关的异常
- UnicodeDecodeError:Unicode解码时的异常
- UnicodeEncodeError:Unicode编码错误导致的异常
- UnicodeTranslateError:Unicode转换错误导致的异常

2.python标准警告总结
- Warning:警告的基类
- DeprecationWarning:关于被弃用的特征的警告
- FutureWarning:关于构造将来语义会有改变的警告
- UserWarning:用户代码生成的警告
- PendingDeprecationWarning:关于特性将会被废弃的警告
- RuntimeWarning:可疑的运行时行为(runtime behavior)的警告
- SyntaxWarning:可疑语法的警告
- ImportWarning:用于在导入模块过程中触发的警告
- UnicodeWarning:与Unicode相关的警告
- BytesWarning:与字节或字节码相关的警告
- ResourceWarning:与资源使用相关的警告
3.try-except 语句
try:
    检测范围
except Exception[as reason]:
    出现异常后的处理代码
finally:
    一定执行
else:

   如果没有异常执行这块代码
try 语句按照如下方式工作:
- 首先,执行
try子句(在关键字try和关键字except之间的语句) - 如果没有异常发生,忽略
except子句,try子句执行后结束。 - 如果在执行
try子句的过程中发生了异常,那么try子句余下的部分将被忽略。如果异常的类型和except之后的名称相符,那么对应的except子句将被执行。最后执行try - except语句之后的代码。 - 如果一个异常没有与任何的
except匹配,那么这个异常将会传递给上层的try中。
dict1 = {'a': 1, 'b': 2, 'v': 22}
try:
    x = dict1['y']
except LookupError:
    print('查询错误')
except KeyError:
    print('键错误')
else:
    print(x)

# 查询错误
try-except-else语句尝试查询不在dict中的键值对,从而引发了异常。这一异常准确地说应属于KeyError,但由于KeyError是LookupError的子类,且将LookupError置于KeyError之前,因此程序优先执行该except代码块。所以,使用多个except代码块时,必须坚持对其规范排序,要从最具针对性的异常到最通用的异常。
一个 except 子句可以同时处理多个异常,这些异常将被放在一个括号里成为一个元组。
try:
    s = 1 + '1'
    int("abc")
    f = open('test.txt')
    print(f.read())
    f.close()
except (OSError, TypeError, ValueError) as error:
    print('出错了!\n原因是:' + str(error))

# 出错了!
# 原因是:unsupported operand type(s) for +: 'int' and 'str'
注意:
如果一个异常在try子句里被抛出,而又没有任何的except把它截住,那么这个异常会在finally子句执行后被抛出。
else语句的存在必须以except语句的存在为前提,在没有except语句的try语句中使用else语句,会引发语法错误。
4.raise语句
Python 使用raise语句抛出一个指定的异常。
try:
    raise NameError('HiThere')
except NameError:
    print('An exception flew by!')

# An exception flew by!
列表
简单数据类型
- 整型
<class 'int'> - 浮点型
<class 'float'> - 布尔型
<class 'bool'>
容器数据类型
- 列表
<class 'list'> - 元组
<class 'tuple'> - 字典
<class 'dict'> - 集合
<class 'set'> - 字符串
<class 'str'>
[元素1, 元素2, ..., 元素n]
x = list(range(10))
print(x, type(x))
# [0, 1, 2, 3, 4, 5, 6, 7, 8, 9] <class 'list'>

x = list(range(1, 11, 2))
print(x, type(x))
# [1, 3, 5, 7, 9] <class 'list'>

x = list(range(10, 1, -2))
print(x, type(x))
# [10, 8, 6, 4, 2] <class 'list'>
由于list的元素可以是任何对象,因此列表中所保存的是对象的指针。即使保存一个简单的[1,2,3],也有3个指针和3个整数对象。
x = [a] * 4操作中,只是创建4个指向list的引用,所以一旦a改变,x中4个a也会随之改变。
列表不像元组,列表内容可更改 (mutable),因此附加 (append, extend)、插入 (insert)、删除 (remove, pop) 这些操作都可以用在它身上。
1.常用方法
list.append(obj) 在列表末尾添加新的对象,只接受一个参数,参数可以是任何数据类型,被追加的元素在 list 中保持着原结构类型。
x = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
x.append('Thursday')
print(x)
# ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday', 'Thursday']

print(len(x))  # 6

此元素如果是一个 list,那么这个 list 将作为一个整体进行追加

x = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
x.append(['Thursday', 'Sunday'])
print(x)
# ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday', ['Thursday', 'Sunday']]

print(len(x))  # 6
list.extend(seq) 在列表末尾一次性追加另一个序列中的多个值(用新列表扩展原来的列表)
x = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
x.extend(['Thursday', 'Sunday'])
print(x)
# ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday', 'Thursday', 'Sunday']

print(len(x))  # 7
list.insert(index, obj) 在编号 index 位置插入 obj。
x = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
x.insert(2, 'Sunday')
print(x)
# ['Monday', 'Tuesday', 'Sunday', 'Wednesday', 'Thursday', 'Friday']

print(len(x))  # 6
list.remove(obj) 移除列表中某个值的第一个匹配项
list.pop([index=-1]) 移除列表中的一个元素(默认最后一个元素),并且返回该元素的值
x = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
y = x.pop()
print(y)  # Friday

y = x.pop(0)
print(y)  # Monday

y = x.pop(-2)
print(y)  # Wednesday
print(x)  # ['Tuesday', 'Thursday']
remove 和 pop 都可以删除元素,前者是指定具体要删除的元素,后者是指定一个索引。
del var1[, var2 ……] 删除单个或多个对象。
x = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
del x[0:2]
print(x)  # ['Wednesday', 'Thursday', 'Friday']
如果你要从列表中删除一个元素,且不再以任何方式使用它,就使用del语句;如果你要在删除元素后还能继续使用它,就使用方法pop()。
切片的通用写法是 start : stop : step
含头不含尾
- 情况 1 - "start :"
- 以
step为 1 (默认) 从编号start往列表尾部切片。
- 情况 2 - ": stop"
- 以
step为 1 (默认) 从列表头部往编号stop切片。
- 情况 3 - "start : stop"
- 以
step为 1 (默认) 从编号start往编号stop切片。
- 情况 4 - "start : stop : step"
- 以具体的
step从编号start往编号stop切片。注意最后把step设为 -1,相当于将列表反向排列。
- 情况 5 - " : "
- 复制列表中的所有元素(浅拷贝)。
week = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
print(week[1:4:2])  # ['Tuesday', 'Thursday']
print(week[:4:2])  # ['Monday', 'Wednesday']
print(week[1::2])  # ['Tuesday', 'Thursday']
print(week[::-1])
# ['Friday', 'Thursday', 'Wednesday', 'Tuesday', 'Monday']
eek = ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
print(week[:])
# ['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday']
浅拷贝与深拷贝
list1 = [123, 456, 789, 213]
list2 = list1
list3 = list1[:]

print(list2)  # [123, 456, 789, 213]
print(list3)  # [123, 456, 789, 213]
list1.sort()
print(list2)  # [123, 213, 456, 789]
print(list3)  # [123, 456, 789, 213]

list1 = [[123, 456], [789, 213]]
list2 = list1
list3 = list1[:]
print(list2)  # [[123, 456], [789, 213]]
print(list3)  # [[123, 456], [789, 213]]
list1[0][0] = 111
print(list2)  # [[111, 456], [789, 213]]
print(list3)  # [[111, 456], [789, 213]]
2.常用操作符
- 等号操作符:
== - 连接操作符
+ - 重复操作符
* - 成员关系操作符
in、not in
「等号 ==」,只有成员、成员位置都相同时才返回True。
列表拼接有两种方式,用「加号 +」和「乘号 *」,前者首尾拼接,后者复制拼接。
【例子】
list1 = [123, 456]
list2 = [456, 123]
list3 = [123, 456]

print(list1 == list2)  # False
print(list1 == list3)  # True

list4 = list1 + list2  # extend()
print(list4)  # [123, 456, 456, 123]

list5 = list3 * 3
print(list5)  # [123, 456, 123, 456, 123, 456]

list3 *= 3
print(list3)  # [123, 456, 123, 456, 123, 456]

print(123 in list3)  # True
print(456 not in list3)  # False
3.列表的其他方法
list.count(obj) 统计某个元素在列表中出现的次数
list1 = [123, 456] * 3
print(list1)  # [123, 456, 123, 456, 123, 456]
num = list1.count(123)
print(num)  # 3
list.index(x[, start[, end]]) 从列表中找出某个值第一个匹配项的索引位置
list1 = [123, 456] * 5
print(list1)   #[123, 456, 123, 456, 123, 456, 123, 456, 123, 456]
print(list1.index(123))  # 0
print(list1.index(123, 1))  # 2
print(list1.index(123, 3, 7))  # 4
list.reverse() 反向列表中元素
x = [123, 456, 789]
x.reverse()
print(x)  # [789, 456, 123]
list.sort(key=None, reverse=False) 对原列表进行排序。
key-- 主要是用来进行比较的元素,只有一个参数,具体的函数的参数就是取自于可迭代对象中,指定可迭代对象中的一个元素来进行排序。reverse-- 排序规则,reverse = True降序,reverse = False升序(默认)。- 该方法没有返回值,但是会对列表的对象进行排序。
x = [123, 456, 789, 213]
x.sort()
print(x)
# [123, 213, 456, 789]

x.sort(reverse=True)
print(x)
# [789, 456, 213, 123]


# 获取列表的第二个元素
def takeSecond(elem):
    return elem[1]


#根据第二个元素进行排序
x = [(2, 2), (3, 4), (4, 1), (1, 3)]
x.sort(key=takeSecond)
print(x)
# [(4, 1), (2, 2), (1, 3), (3, 4)]
元组
「元组」定义语法为:(元素1, 元素2, ..., 元素n)
- Python 的元组与列表类似,不同之处在于tuple被创建后就不能对其进行修改,类似字符串。
- 元组使用小括号,列表使用方括号。
- 元组与列表类似,也用整数来对它进行索引 (indexing) 和切片 (slicing)。
t1 = (1, 10.31, 'python')
t2 = 1, 10.31, 'python'
print(t1, type(t1))
# (1, 10.31, 'python') <class 'tuple'>

print(t2, type(t2))
# (1, 10.31, 'python') <class 'tuple'>

tuple1 = (1, 2, 3, 4, 5, 6, 7, 8)
print(tuple1[1])  # 2
print(tuple1[5:])  # (6, 7, 8)
print(tuple1[:5])  # (1, 2, 3, 4, 5)
tuple2 = tuple1[:]
print(tuple2)  # (1, 2, 3, 4, 5, 6, 7, 8)
- 创建元组可以用小括号 (),也可以什么都不用,为了可读性,建议还是用 ()。
- 元组中只包含一个元素时,需要在元素后面添加逗号,否则括号会被当作运算符使用。
创建二维元组。
x = (1, 10.31, 'python'), ('data', 11)
print(x)
# ((1, 10.31, 'python'), ('data', 11))

print(x[0])
# (1, 10.31, 'python')
print(x[0][0], x[0][1], x[0][2])
# 1 10.31 python

print(x[0][0:2])
# (1, 10.31)
1.更新和删除一个元组
week = ('Monday', 'Tuesday', 'Thursday', 'Friday')
week = week[:2] + ('Wednesday',) + week[2:]
print(week)  # ('Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday')
元组有不可更改 (immutable) 的性质,因此不能直接给元组的元素赋值,但是只要元组中的元素可更改 (mutable),那么我们可以直接更改其元素,注意这跟赋值其元素不同。
t1 = (1, 2, 3, [4, 5, 6])
print(t1)  # (1, 2, 3, [4, 5, 6])

t1[3][0] = 9
print(t1)  # (1, 2, 3, [9, 5, 6])
2.元组相关的操作符
- 等号操作符:
== - 连接操作符
+ - 重复操作符
* - 成员关系操作符
in、not in
「等号 ==」,只有成员、成员位置都相同时才返回True。
元组拼接有两种方式,用「加号 +」和「乘号 *」,前者首尾拼接,后者复制拼接。
3.内置方法
元组大小和内容都不可更改,因此只有 count 和 index 两种方法。
t = (1, 10.31, 'python')
print(t.count('python'))  # 1
print(t.index(10.31))  # 1
count('python')是记录在元组t中该元素出现几次,显然是 1 次index(10.31)是找到该元素在元组t的索引,显然是 1
4.解压元组
t = (1, 10.31, ('OK', 'python'))
(a, b, (c, d)) = t
print(a, b, c, d)
# 1 10.31 OK python
如果你只想要元组其中几个元素,用通配符「*」,英文叫 wildcard,在计算机语言中代表一个或多个元素。下例就是把多个元素丢给了 `rest` 变量。
t = 1, 2, 3, 4, 5
a, b, *rest, c = t
print(a, b, c)  # 1 2 5
print(rest)  # [3, 4]
*号就是通配符,代表这个*号前后或者中间的所有连续的东西,比如*_代表_号前边所有东西,_*代表_号后边所有东西,_*_代表两个_号中间的所有东西
字符串
1.字符串的定义
- Python 中字符串被定义为引号之间的字符集合。
- Python 支持使用成对的 单引号 或 双引号。
- Python 的常用转义字符
| 转义字符 | 描述 |
|---|---|
\\ |
反斜杠符号 |
\' |
单引号 |
\" |
双引号 |
\n |
换行 |
\t |
横向制表符(TAB) |
\r |
回车 |
2.字符串的切片与拼接
- 类似于元组具有不可修改性
- 从 0 开始 (和 Java 一样)
- 切片通常写成
start:end这种形式,包括「start索引」对应的元素,不包括「end索引」对应的元素。 - 索引值可正可负,正索引从 0 开始,从左往右;负索引从 -1 开始,从右往左。使用负数索引时,会从最后一个元素开始计数。最后一个元素的位置编号是 -1。
str1 = 'I Love LsgoGroup'
print(str1[:6])  # I Love
print(str1[5])  # e
print(str1[:6] + " 插入的字符串 " + str1[6:])
# I Love 插入的字符串  LsgoGroup

s = 'Python'
print(s)  # Python
print(s[2:4])  # th
print(s[-5:-2])  # yth
print(s[2])  # t
print(s[-1])  # n
3.字符串的常用内置方法
capitalize() 将字符串的第一个字符转换为大写。
str2 = 'xiaoxie'
print(str2.capitalize())  # Xiaoxie
lower() 转换字符串中所有大写字符为小写。
upper() 转换字符串中的小写字母为大写。
swapcase() 将字符串中大写转换为小写,小写转换为大写。
count(str, beg= 0,end=len(string)) 返回str在 string 里面出现的次数,如果beg或者end指定则返回指定范围内str出现的次数。查找字符区分大小写。
endswith(suffix, beg=0, end=len(string)) 检查字符串是否以指定子字符串 suffix 结束,如果是,返回 True,否则返回 False。如果 beg 和 end 指定值,则在指定范围内检查。
startswith(substr, beg=0,end=len(string)) 检查字符串是否以指定子字符串 substr 开头,如果是,返回 True,否则返回 False。如果 beg 和 end 指定值,则在指定范围内检查。
find(str, beg=0, end=len(string)) 检测 str 是否包含在字符串中,如果指定范围 beg 和 end,则检查是否包含在指定范围内,如果包含,返回开始的索引值,否则返回 -1。
rfind(str, beg=0,end=len(string))类似于 find() 函数,不过是从右边开始查找。
isnumeric() 如果字符串中只包含数字字符,则返回 True,否则返回 False。
ljust(width[, fillchar])返回一个原字符串左对齐,并使用fillchar(默认空格)填充至长度width的新字符串。
rjust(width[, fillchar])返回一个原字符串右对齐,并使用fillchar(默认空格)填充至长度width的新字符串。
str4 = '1101'
print(str4.ljust(8, '0'))  # 11010000
print(str4.rjust(8, '0'))  # 00001101
lstrip([chars]) 截掉字符串左边的空格或指定字符。
rstrip([chars]) 删除字符串末尾的空格或指定字符。
strip([chars])在字符串上执行lstrip()和rstrip()。
str5 = ' I Love LsgoGroup '
print(str5.lstrip())  # 'I Love LsgoGroup '
print(str5.lstrip().strip('I'))  # ' Love LsgoGroup '
print(str5.rstrip())  # ' I Love LsgoGroup'
print(str5.strip())  # 'I Love LsgoGroup'
print(str5.strip().strip('p'))  # 'I Love LsgoGrou'
partition(sub) 找到子字符串sub,把字符串分为一个三元组(pre_sub,sub,fol_sub),如果字符串中不包含sub则返回('原字符串','','')。
rpartition(sub)类似于partition()方法,不过是从右边开始查找。
str5 = ' I Love LsgoGroup '
print(str5.strip().partition('o'))  # ('I L', 'o', 've LsgoGroup')
print(str5.strip().partition('m'))  # ('I Love LsgoGroup', '', '')
print(str5.strip().rpartition('o'))  # ('I Love LsgoGr', 'o', 'up')
replace(old, new [, max]) 把 将字符串中的old替换成new,如果max指定,则替换不超过max次。
str5 = ' I Love LsgoGroup '
print(str5.strip().replace('I', 'We'))  # We Love LsgoGroup
split(str="", num) 不带参数默认是以空格为分隔符切片字符串,如果num参数有设置,则仅分隔num个子字符串,返回切片后的子字符串拼接的列表。
splitlines([keepends]) 按照行('\r', '\r\n', \n')分隔,返回一个包含各行作为元素的列表,如果参数keepends为 False,不包含换行符,如果为 True,则保留换行符。
str6 = 'I \n Love \n LsgoGroup'
print(str6.splitlines())  # ['I ', ' Love ', ' LsgoGroup']
print(str6.splitlines(True))  # ['I \n', ' Love \n', ' LsgoGroup']
maketrans(intab, outtab) 创建字符映射的转换表,第一个参数是字符串,表示需要转换的字符,第二个参数也是字符串表示转换的目标。
translate(table, deletechars="")根据参数table给出的表,转换字符串的字符,要过滤掉的字符放到deletechars参数中。
str7 = 'this is string example....wow!!!'
intab = 'aeiou'
outtab = '12345'
trantab = str7.maketrans(intab, outtab)
print(trantab)  # {97: 49, 111: 52, 117: 53, 101: 50, 105: 51}
print(str7.translate(trantab))  # th3s 3s str3ng 2x1mpl2....w4w!!!
额,没看懂。
4.字符串格式化
format 格式化函数
str8 = "{0} Love {1}".format('I', 'Lsgogroup')  # 位置参数
print(str8)  # I Love Lsgogroup

str8 = "{a} Love {b}".format(a='I', b='Lsgogroup')  # 关键字参数
print(str8)  # I Love Lsgogroup

str8 = "{0} Love {b}".format('I', b='Lsgogroup')  # 位置参数要在关键字参数之前
print(str8)  # I Love Lsgogroup

str8 = '{0:.2f}{1}'.format(27.658, 'GB')  # 保留小数点后两位
print(str8)  # 27.66GB
- Python 字符串格式化符号
| 符 号 | 描述 |
|---|---|
| %c | 格式化字符及其ASCII码 |
| %s | 格式化字符串,用str()方法处理对象 |
| %r | 格式化字符串,用rper()方法处理对象 |
| %d | 格式化整数 |
| %o | 格式化无符号八进制数 |
| %x | 格式化无符号十六进制数 |
| %X | 格式化无符号十六进制数(大写) |
| %f | 格式化浮点数字,可指定小数点后的精度 |
| %e | 用科学计数法格式化浮点数 |
| %E | 作用同%e,用科学计数法格式化浮点数 |
| %g | 根据值的大小决定使用%f或%e |
| %G | 作用同%g,根据值的大小决定使用%f或%E |
格式化操作符辅助指令
| 符号 | 功能 |
|---|---|
m.n |
m 是显示的最小总宽度,n 是小数点后的位数(如果可用的话) |
- |
用作左对齐 |
+ |
在正数前面显示加号( + ) |
# |
在八进制数前面显示零('0'),在十六进制前面显示'0x'或者'0X'(取决于用的是'x'还是'X') |
0 |
显示的数字前面填充'0'而不是默认的空格 |
print('%5.1f' % 27.658)  # ' 27.7'
print('%.2e' % 27.658)  # 2.77e+01
print('%10d' % 10)  # '        10'
print('%-10d' % 10)  # '10        '
print('%+d' % 10)  # +10
print('%#o' % 10)  # 0o12
print('%#x' % 108)  # 0x6c
print('%010d' % 5)  # 0000000005
字典
1.可变类型与不可变类型
- 序列是以连续的整数为索引,与此不同的是,字典以"关键字"为索引,关键字可以是任意不可变类型,通常用字符串或数值。
- 字典是 Python 唯一的一个 映射类型,字符串、元组、列表属于序列类型。
那么如何快速判断一个数据类型 X 是不是可变类型的呢?两种方法:
- 麻烦方法:用
id(X)函数,对 X 进行某种操作,比较操作前后的id,如果不一样,则X不可变,如果一样,则X可变。 - 便捷方法:用
hash(X),只要不报错,证明X可被哈希,即不可变,反过来不可被哈希,即可变。
- 数值、字符和元组 都能被哈希,因此它们是不可变类型。
- 列表、集合、字典不能被哈希,因此它是可变类型。
2.字典的定义
字典 是无序的 键:值(key:value)对集合,键必须是互不相同的(在同一个字典之内)。
dict内部存放的顺序和key放入的顺序是没有关系的。dict查找和插入的速度极快,不会随着key的增加而增加,但是需要占用大量的内存。
字典 定义语法为 {元素1, 元素2, ..., 元素n}
- 其中每一个元素是一个「键值对」-- 键:值 (
key:value) - 关键点是「大括号 {}」,「逗号 ,」和「冒号 :」
- 大括号 -- 把所有元素绑在一起
- 逗号 -- 将每个键值对分开
- 冒号 -- 将键和值分开
3.创建和访问字典
dict() 创建一个空的字典。
通过key直接把数据放入字典中,但一个key只能对应一个value,多次对一个key放入 value,后面的值会把前面的值冲掉。
dic = dict()
dic['a'] = 1
dic['b'] = 2
dic['c'] = 3

print(dic)
# {'a': 1, 'b': 2, 'c': 3}

dic['a'] = 11
print(dic)
# {'a': 11, 'b': 2, 'c': 3}

dic['d'] = 4
print(dic)
# {'a': 11, 'b': 2, 'c': 3, 'd': 4}
4.字典的内置方法
dict.fromkeys(seq[, value]) 用于创建一个新字典,以序列 seq 中元素做字典的键,value 为字典所有键对应的初始值。
seq = ('name', 'age', 'sex')
dic1 = dict.fromkeys(seq)
print(dic1)
# {'name': None, 'age': None, 'sex': None}

dic2 = dict.fromkeys(seq, 10)
print(dic2)
# {'name': 10, 'age': 10, 'sex': 10}

dic3 = dict.fromkeys(seq, ('小马', '8', '男'))
print(dic3)
# {'name': ('小马', '8', '男'), 'age': ('小马', '8', '男'), 'sex': ('小马', '8', '男')}
dict.keys()返回一个可迭代对象,可以使用 list() 来转换为列表,列表为字典中的所有键。
dic = {'Name': 'lsgogroup', 'Age': 7}
print(dic.keys())  # dict_keys(['Name', 'Age'])
lst = list(dic.keys())  # 转换为列表
print(lst)  # ['Name', 'Age']
dict.values()返回一个迭代器,可以使用 list() 来转换为列表,列表为字典中的所有值。
dic = {'Sex': 'female', 'Age': 7, 'Name': 'Zara'}
print(dic.values())
# dict_values(['female', 7, 'Zara'])

print(list(dic.values()))
# [7, 'female', 'Zara']
dict.items()以列表返回可遍历的 (键, 值) 元组数组。
dic = {'Name': 'Lsgogroup', 'Age': 7}
print(dic.items())
# dict_items([('Name', 'Lsgogroup'), ('Age', 7)])

 print(tuple(dic.items()))
# (('Name', 'Lsgogroup'), ('Age', 7))

    print(list(dic.items()))
# [('Name', 'Lsgogroup'), ('Age', 7)]
dict.get(key, default=None) 返回指定键的值,如果值不在字典中返回默认值。
dic = {'Name': 'Lsgogroup', 'Age': 27}
print("Age 值为 : %s" % dic.get('Age'))  # Age 值为 : 27
print("Sex 值为 : %s" % dic.get('Sex', "NA"))  # Sex 值为 : NA
print(dic)  # {'Name': 'Lsgogroup', 'Age': 27}
dict.setdefault(key, default=None)和get()方法 类似, 如果键不存在于字典中,将会添加键并将值设为默认值。
key (not) in dict in 操作符用于判断键是否存在于字典中,如果键在字典 dict 里返回true,否则返回false。而not in操作符刚好相反,如果键在字典 dict 里返回false,否则返回true。
dict.pop(key[,default])删除字典给定键 key 所对应的值,返回值为被删除的值。key 值必须给出。若key不存在,则返回 default 值。
del dict[key] 删除字典给定键 key 所对应的值。
dic1 = {1: "a", 2: [1, 2]}
print(dic1.pop(1), dic1)  # a {2: [1, 2]}

# 设置默认值,必须添加,否则报错
print(dic1.pop(3, "nokey"), dic1)  # nokey {2: [1, 2]}

del dic1[2]
print(dic1)  # {}
dict.popitem()随机返回并删除字典中的一对键和值,如果字典已经为空,却调用了此方法,就报出KeyError异常。
dict.clear()用于删除字典内所有元素。
dict.copy()返回一个字典的浅复制。
深复制相对应与浅复制,浅复制是只有一层的对象复制,其他层都是引用。而深复制则是递归地进行复制,每一层都是对象复制。因此深复制会复制更多东西,占用更多内存,也比浅复制耗时。
dic1 = {'user': 'lsgogroup', 'num': [1, 2, 3]}

# 引用对象
dic2 = dic1
# 浅拷贝父对象(一级目录),子对象(二级目录)不拷贝,还是引用
dic3 = dic1.copy()

print(id(dic1))  # 148635574728
print(id(dic2))  # 148635574728
print(id(dic3))  # 148635574344

# 修改 data 数据
dic1['user'] = 'root'
dic1['num'].remove(1)

# 输出结果
print(dic1)  # {'user': 'root', 'num': [2, 3]}
print(dic2)  # {'user': 'root', 'num': [2, 3]}
print(dic3)  # {'user': 'runoob', 'num': [2, 3]}
dict.update(dict2)把字典参数 dict2 的 key:value对 更新到字典 dict 里。
dic = {'Name': 'Lsgogroup', 'Age': 7}
dic2 = {'Sex': 'female', 'Age': 8}
dic.update(dic2)
print(dic)
# {'Name': 'Lsgogroup', 'Age': 8, 'Sex': 'female'}
集合
Python 中set与dict类似,也是一组key的集合,但不存储value。由于key不能重复,所以,在set中,没有重复的key。
注意,key为不可变类型,即可哈希的值。
num = {}
print(type(num))  # <class 'dict'>
num = {1, 2, 3, 4}
print(type(num))  # <class 'set'>
1.集合的创建
- 先创建对象再加入元素。
- 在创建空集合的时候只能使用
s = set(),因为s = {}创建的是空字典。
basket = set()
basket.add('apple')
basket.add('banana')
print(basket)  # {'banana', 'apple'}
直接把一堆元素用花括号括起来{元素1, 元素2, ..., 元素n}。重复元素在set中会被自动被过滤。
使用set(value)工厂函数,把列表或元组转换成集合。
a = set('abracadabra')
print(a)
# {'a', 'c', 'd', 'b', 'r'}

b = set(("Google", "Lsgogroup", "Taobao", "Taobao"))
print(b)
# {'Google', 'Taobao', 'Lsgogroup'}

c = set(["Google", "Lsgogroup", "Taobao", "Google"])
print(c)
# {'Google', 'Taobao', 'Lsgogroup'}
由于 set 存储的是无序集合,所以我们不可以为集合创建索引或执行切片(slice)操作,也没有键(keys)可用来获取集合中元素的值,但是可以判断一个元素是否在集合中。
2.访问集合中的值
可以通过in或not in判断一个元素是否在集合中已经存在
s = set(['Google', 'Baidu', 'Taobao'])
print('Taobao' in s)  # True
print('Facebook' not in s)  # True
3.集合的内置方法
set.add(elmnt)用于给集合添加元素,如果添加的元素在集合中已存在,则不执行任何操作。
set.update(set)用于修改当前集合,可以添加新的元素或集合到当前集合中,如果添加的元素在集合中已存在,则该元素只会出现一次,重复的会忽略。
x = {"apple", "banana", "cherry"}
y = {"google", "baidu", "apple"}
x.update(y)
print(x)
# {'google', 'banana', 'baidu', 'apple', 'cherry'}

y.update(["lsgo", "dreamtech"])
print(y)
# {'google', 'baidu', 'lsgo', 'apple', 'dreamtech'}
set.remove(item) 用于移除集合中的指定元素。如果元素不存在,则会发生错误。
set.discard(value) 用于移除指定的集合元素。remove() 方法在移除一个不存在的元素时会发生错误,而 discard() 方法不会。
set.pop() 用于随机移除一个元素。
set.intersection(set1, set2) 返回两个集合的交集。
set1 & set2 返回两个集合的交集。
set.intersection_update(set1, set2) 交集,在原始的集合上移除不重叠的元素。
a = set('abracadabra')
b = set('alacazam')
print(a)  # {'c', 'a', 'r', 'd', 'b'}
print(b)  # {'c', 'a', 'z', 'm', 'l'}

c = a.intersection(b)
print(c)  # {'c', 'a'}
print(a & b)  # {'c', 'a'}
print(a)  # {'c', 'a', 'r', 'd', 'b'}

a.intersection_update(b)
print(a)  # {'c', 'a'}
set.union(set1, set2) 返回两个集合的并集。
set1 | set2 返回两个集合的并集。
a = set('abracadabra')
b = set('alacazam')
print(a)  # {'r', 'a', 'c', 'b', 'd'}
print(b)  # {'c', 'a', 'l', 'm', 'z'}

print(a | b)
# {'l', 'd', 'm', 'b', 'a', 'r', 'z', 'c'}

c = a.union(b)
print(c)
# {'c', 'a', 'd', 'm', 'r', 'b', 'z', 'l'}
set.difference(set) 返回集合的差集。
set1 - set2 返回集合的差集。
set.difference_update(set)集合的差集,直接在原来的集合中移除元素,没有返回值。

这样就好理解了。
a = set('abracadabra')
b = set('alacazam')
print(a)  # {'r', 'a', 'c', 'b', 'd'}
print(b)  # {'c', 'a', 'l', 'm', 'z'}

c = a.difference(b)
print(c)  # {'b', 'd', 'r'}
print(a - b)  # {'d', 'b', 'r'}

print(a)  # {'r', 'd', 'c', 'a', 'b'}
a.difference_update(b)
print(a)  # {'d', 'r', 'b'}
set.symmetric_difference(set)返回集合的异或。
set1 ^ set2 返回集合的异或。
set.symmetric_difference_update(set)移除当前集合中在另外一个指定集合相同的元素,并将另外一个指定集合中不同的元素插入到当前集合中。
一样的不要,只留不一样的。
a = set('abracadabra')
b = set('alacazam')
print(a)  # {'r', 'a', 'c', 'b', 'd'}
print(b)  # {'c', 'a', 'l', 'm', 'z'}

c = a.symmetric_difference(b)
print(c)  # {'m', 'r', 'l', 'b', 'z', 'd'}
print(a ^ b)  # {'m', 'r', 'l', 'b', 'z', 'd'}

print(a)  # {'r', 'd', 'c', 'a', 'b'}
a.symmetric_difference_update(b)
print(a)  # {'r', 'b', 'm', 'l', 'z', 'd'}
set.issubset(set)判断集合是不是被其他集合包含,如果是则返回 True,否则返回 False。
set1 <= set2判断集合是不是被其他集合包含,如果是则返回 True,否则返回 False。
set.issuperset(set)用于判断集合是不是包含其他集合,如果是则返回 True,否则返回 False。
set1 >= set2 判断集合是不是包含其他集合,如果是则返回 True,否则返回 False。
set.isdisjoint(set) 用于判断两个集合是不是不相交,如果是返回 True,否则返回 False。
x = {"f", "e", "d", "c", "b"}
y = {"a", "b", "c"}
z = x.isdisjoint(y)
print(z)  # False

x = {"f", "e", "d", "m", "g"}
y = {"a", "b", "c"}
z = x.isdisjoint(y)
print(z)  # True
4.集合的转换
se = set(range(4))
li = list(se)
tu = tuple(se)

print(se, type(se))  # {0, 1, 2, 3} <class 'set'>
print(li, type(li))  # [0, 1, 2, 3] <class 'list'>
print(tu, type(tu))  # (0, 1, 2, 3) <class 'tuple'>
5.不可变集合
frozenset([iterable])返回一个冻结的集合,冻结后集合不能再添加或删除任何元素。
a = frozenset(range(10))  # 生成一个新的不可变集合
print(a)
# frozenset({0, 1, 2, 3, 4, 5, 6, 7, 8, 9})

b = frozenset('lsgogroup')
print(b)
# frozenset({'g', 's', 'p', 'r', 'u', 'o', 'l'})
序列
1.针对序列的内置函数
list(sub) 把一个可迭代对象转换为列表。
tuple(sub) 把一个可迭代对象转换为元组。
str(obj) 把obj对象转换为字符串。
len(s) 返回对象(字符、列表、元组等)长度或元素个数。
max(sub)返回序列或者参数集合中的最大值
min(sub)返回序列或参数集合中的最小值
sum(iterable[, start=0]) 返回序列iterable与可选参数start的总和。 print(sum([1, 3, 5, 7, 9], 10)) # 35
sorted(iterable, key=None, reverse=False) 对所有可迭代的对象进行排序操作。
iterable-- 可迭代对象。key-- 主要是用来进行比较的元素,只有一个参数,具体的函数的参数就是取自于可迭代对象中,指定可迭代对象中的一个元素来进行排序。reverse-- 排序规则,reverse = True降序 ,reverse = False升序(默认)。- 返回重新排序的列表。
x = [-8, 99, 3, 7, 83]
print(sorted(x)) # [-8, 3, 7, 83, 99]
print(sorted(x, reverse=True)) # [99, 83, 7, 3, -8]

t = ({"age": 20, "name": "a"}, {"age": 25, "name": "b"}, {"age": 10, "name": "c"})
x = sorted(t, key=lambda a: a["age"])
print(x)
# [{'age': 10, 'name': 'c'}, {'age': 20, 'name': 'a'}, {'age': 25, 'name': 'b'}]

reversed(seq) 函数返回一个反转的迭代器。
seq-- 要转换的序列,可以是 tuple, string, list 或 range。
s = 'lsgogroup'
x = reversed(s)
print(type(x))  # <class 'reversed'>
print(x)  # <reversed object at 0x000002507E8EC2C8>
print(list(x))
# ['p', 'u', 'o', 'r', 'g', 'o', 'g', 's', 'l']

t = ('l', 's', 'g', 'o', 'g', 'r', 'o', 'u', 'p')
print(list(reversed(t)))
# ['p', 'u', 'o', 'r', 'g', 'o', 'g', 's', 'l']

r = range(5, 9)
print(list(reversed(r)))
# [8, 7, 6, 5]

x = [-8, 99, 3, 7, 83]
print(list(reversed(x)))
# [83, 7, 3, 99, -8]
enumerate(sequence, [start=0])用于将一个可遍历的数据对象(如列表、元组或字符串)组合为一个索引序列,同时列出数据和数据下标,一般用在 for 循环当中。
seasons = ['Spring', 'Summer', 'Fall', 'Winter']
a = list(enumerate(seasons))
print(a)
# [(0, 'Spring'), (1, 'Summer'), (2, 'Fall'), (3, 'Winter')]

b = list(enumerate(seasons, 1))
print(b)
# [(1, 'Spring'), (2, 'Summer'), (3, 'Fall'), (4, 'Winter')]

for i, element in a:
    print('{0},{1}'.format(i, element))
# 0,Spring
# 1,Summer
# 2,Fall
# 3,Winter
zip(iter1 [,iter2 [...]])
- 用于将可迭代的对象作为参数,将对象中对应的元素打包成一个个元组,然后返回由这些元组组成的对象,这样做的好处是节约了不少的内存。
- 我们可以使用
list()转换来输出列表。 - 如果各个迭代器的元素个数不一致,则返回列表长度与最短的对象相同,利用
*号操作符,可以将元组解压为列表。
a = [1, 2, 3]
b = [4, 5, 6]
c = [4, 5, 6, 7, 8]

zipped = zip(a, b)
print(zipped)  # <zip object at 0x000000C5D89EDD88>
print(list(zipped))  # [(1, 4), (2, 5), (3, 6)]
zipped = zip(a, c)
print(list(zipped))  # [(1, 4), (2, 5), (3, 6)]

a1, a2 = zip(*zip(a, b))
print(list(a1))  # [1, 2, 3]
print(list(a2))  # [4, 5, 6]
函数
1.函数定义
- 函数以
def关键词开头,后接函数名和圆括号()。 - 函数执行的代码以冒号起始,并且缩进。
- return [表达式] 结束函数,选择性地返回一个值给调用方。不带表达式的return相当于返回
None。
2.函数的调用
函数以def关键词开头,后接函数名和圆括号()。
函数执行的代码以冒号起始,并且缩进。
return [表达式] 结束函数,选择性地返回一个值给调用方。不带表达式的return相当于返回None。
def functionname (parameters):
       "函数_文档字符串"
        function_suite
        return [expression]
3.函数文档
def MyFirstFunction(name):
    "函数定义过程中name是形参"
    # 因为Ta只是一个形式,表示占据一个参数位置
    print('传递进来的{0}叫做实参,因为Ta是具体的参数值!'.format(name))


MyFirstFunction('老马的程序人生')
# 传递进来的老马的程序人生叫做实参,因为Ta是具体的参数值!

print(MyFirstFunction.__doc__)
# 函数定义过程中name是形参

help(MyFirstFunction)
# Help on function MyFirstFunction in module __main__:
# MyFirstFunction(name)
#    函数定义过程中name是形参
4.函数参数
- 位置参数 (positional argument)
- 默认参数 (default argument)
- 可变参数 (variable argument)
- 关键字参数 (keyword argument)
- 命名关键字参数 (name keyword argument)
- 参数组合
1. 位置参数
def functionname(arg1):
"函数_文档字符串"
function_suite
return [expression]
arg1- 位置参数 ,这些参数在调用函数 (call function) 时位置要固定。
2. 默认参数
def functionname(arg1, arg2=v):
"函数_文档字符串"
function_suite
return [expression]
arg2 = v- 默认参数 = 默认值,调用函数时,默认参数的值如果没有传入,则被认为是默认值。- 默认参数一定要放在位置参数 后面,不然程序会报错。
- Python 允许函数调用时参数的顺序与声明时不一致,因为 Python 解释器能够用参数名匹配参数值。
3. 可变参数
顾名思义,可变参数就是传入的参数个数是可变的,可以是 0, 1, 2 到任意个,是不定长的参数。
def functionname(arg1, arg2=v, *args):
"函数_文档字符串"
function_suite
return [expression]
*args- 可变参数,可以是从零个到任意个,自动组装成元组。- 加了星号(*)的变量名会存放所有未命名的变量参数。
def printinfo(arg1, *args):
    print(arg1)
    for var in args:
        print(var)


printinfo(10)  # 10
printinfo(70, 60, 50)
# 70
# 60
# 50
4. 关键字参数
def functionname(arg1, arg2=v, args, **kw):
"函数_文档字符串"
function_suite
return [expression]
**kw- 关键字参数,可以是从零个到任意个,自动组装成字典。
def printinfo(arg1, *args, **kwargs):
    print(arg1)
    print(args)
    print(kwargs)


printinfo(70, 60, 50)
# 70
# (60, 50)
# {}
printinfo(70, 60, 50, a=1, b=2)
# 70
# (60, 50)
# {'a': 1, 'b': 2}
- 可变参数允许传入零个到任意个参数,它们在函数调用时自动组装为一个元组 (tuple)。
- 关键字参数允许传入零个到任意个参数,它们在函数内部自动组装为一个字典 (dict)。
5. 命名关键字参数
def functionname(arg1, arg2=v, args, *, nkw, **kw):
"函数_文档字符串"
function_suite
return [expression]
*, nkw- 命名关键字参数,用户想要输入的关键字参数,定义方式是在nkw 前面加个分隔符*。- 如果要限制关键字参数的名字,就可以用「命名关键字参数」
- 使用命名关键字参数时,要特别注意不能缺少参数名。
def printinfo(arg1, *, nkw, **kwargs):
    print(arg1)
    print(nkw)
    print(kwargs)


printinfo(70, nkw=10, a=1, b=2)
# 70
# 10
# {'a': 1, 'b': 2}

printinfo(70, 10, a=1, b=2)
# TypeError: printinfo() takes 1 positional argument but 2 were given
没有写参数名nwk,因此 10 被当成「位置参数」,而原函数只有 1 个位置函数,现在调用了 2 个,因此程序会报错。
6. 参数组合
在 Python 中定义函数,可以用位置参数、默认参数、可变参数、命名关键字参数和关键字参数,这 5 种参数中的 4 个都可以一起使用,但是注意,参数定义的顺序必须是:
- 位置参数、默认参数、可变参数和关键字参数。
- 位置参数、默认参数、命名关键字参数和关键字参数。
要注意定义可变参数和关键字参数的语法:
*args是可变参数,args接收的是一个tuple**kw是关键字参数,kw接收的是一个dict
命名关键字参数是为了限制调用者可以传入的参数名,同时可以提供默认值。定义命名关键字参数不要忘了写分隔符 *,否则定义的是位置参数。
警告:虽然可以组合多达 5 种参数,但不要同时使用太多的组合,否则函数很难懂。
5.变量作用域
- Python 中,程序的变量并不是在哪个位置都可以访问的,访问权限决定于这个变量是在哪里赋值的。
- 定义在函数内部的变量拥有局部作用域,该变量称为局部变量。
- 定义在函数外部的变量拥有全局作用域,该变量称为全局变量。
- 局部变量只能在其被声明的函数内部访问,而全局变量可以在整个程序范围内访问。
- 当内部作用域想修改外部作用域的变量时,就要用到
global和nonlocal关键字了。
num = 1


def fun1():
    global num  # 需要使用 global 关键字声明
    print(num)  # 1
    num = 123
    print(num)  # 123


fun1()
print(num)  # 123
内嵌函数
def outer():
    print('outer函数在这被调用')

    def inner():
        print('inner函数在这被调用')

    inner()  # 该函数只能在outer函数内部被调用


outer()
# outer函数在这被调用
# inner函数在这被调用
闭包
- 是函数式编程的一个重要的语法结构,是一种特殊的内嵌函数。
- 如果在一个内部函数里对外层非全局作用域的变量进行引用,那么内部函数就被认为是闭包。
- 通过闭包可以访问外层非全局作用域的变量,这个作用域称为 闭包作用域。
def funX(x):
    def funY(y):
        return x * y

    return funY


i = funX(8)
print(type(i))  # <class 'function'>
print(i(5))  # 40
闭包的返回值通常是函数。
如果要修改闭包作用域中的变量则需要 nonlocal 关键字
def outer():
    num = 10

    def inner():
        nonlocal num  # nonlocal关键字声明
        num = 100
        print(num)

    inner()
    print(num)


outer()

# 100
# 100
递归
- 如果一个函数在内部调用自身本身,这个函数就是递归函数。
斐波那契数列 f(n)=f(n-1)+f(n-2), f(0)=0 f(1)=1
# 利用循环
i = 0
j = 1
lst = list([i, j])
for k in range(2, 11):
    k = i + j
    lst.append(k)
    i = j
    j = k
print(lst)
# [0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55]

# 利用递归
def recur_fibo(n):
    if n <= 1:
        return n
    return recur_fibo(n - 1) + recur_fibo(n - 2)


lst = list()
for k in range(11):
    lst.append(recur_fibo(k))
print(lst)
# [0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55]
Lambda表达式
匿名函数的定义
在 Python 里有两类函数:
- 第一类:用
def关键词定义的正规函数 - 第二类:用
lambda关键词定义的匿名函数
Python 使用 lambda 关键词来创建匿名函数,而非def关键词,它没有函数名,其语法结构如下:
lambda argument_list: expression
lambda- 定义匿名函数的关键词。argument_list- 函数参数,它们可以是位置参数、默认参数、关键字参数,和正规函数里的参数类型一样。:- 冒号,在函数参数和表达式中间要加个冒号。expression- 只是一个表达式,输入函数参数,输出一些值。
注意:
expression中没有 return 语句,因为 lambda 不需要它来返回,表达式本身结果就是返回值。- 匿名函数拥有自己的命名空间,且不能访问自己参数列表之外或全局命名空间里的参数。
匿名函数的应用
函数式编程 是指代码中每一块都是不可变的,都由纯函数的形式组成。这里的纯函数,是指函数本身相互独立、互不影响,对于相同的输入,总会有相同的输出,没有任何副作用。
匿名函数 常常应用于函数式编程的高阶函数 (high-order function)中,主要有两种形式:
- 参数是函数 (filter, map)
- 返回值是函数 (closure)
filter(function, iterable) 过滤序列,过滤掉不符合条件的元素,返回一个迭代器对象,如果要转换为列表,可以使用 list() 来转换。
odd = lambda x: x % 2 == 1
templist = filter(odd, [1, 2, 3, 4, 5, 6, 7, 8, 9])
print(list(templist))  # [1, 3, 5, 7, 9]
map(function, *iterables) 根据提供的函数对指定序列做映射。
m1 = map(lambda x: x ** 2, [1, 2, 3, 4, 5])
print(list(m1))
# [1, 4, 9, 16, 25]

m2 = map(lambda x, y: x + y, [1, 3, 5, 7, 9], [2, 4, 6, 8, 10])
print(list(m2))
# [3, 7, 11, 15, 19]
类与对象
对象=属性+方法
对象是类的实例。换句话说,类主要定义对象的结构,然后我们以类为模板创建对象。类不但包含方法定义,而且还包含所有实例共享的数据。
- 封装:信息隐蔽技术
我们可以使用关键字 class 定义 Python 类,关键字后面紧跟类的名称、分号和类的实现。
class Turtle:  # Python中的类名约定以大写字母开头
    """关于类的一个简单例子"""
    # 属性
    color = 'green'
    weight = 10
    legs = 4
    shell = True
    mouth = '大嘴'

    # 方法
    def climb(self):
        print('我正在很努力的向前爬...')

    def run(self):
        print('我正在飞快的向前跑...')

    def bite(self):
        print('咬死你咬死你!!')

    def eat(self):
        print('有得吃,真满足...')

    def sleep(self):
        print('困了,睡了,晚安,zzz')


tt = Turtle()
print(tt)
# <__main__.Turtle object at 0x0000007C32D67F98>

print(type(tt))
# <class '__main__.Turtle'>

print(tt.__class__)
# <class '__main__.Turtle'>

print(tt.__class__.__name__)
# Turtle

tt.climb()
# 我正在很努力的向前爬...

tt.run()
# 我正在飞快的向前跑...

tt.bite()
# 咬死你咬死你!!

# Python类也是对象。它们是type的实例
print(type(Turtle))
# <class 'type'>
- 继承:子类自动共享父类之间数据和方法的机制
- 多态:不同对象对同一方法响应不同的行动
self
Python 的 self 相当于 C++ 的 this 指针。
类的方法与普通的函数只有一个特别的区别 —— 它们必须有一个额外的第一个参数名称(对应于该实例,即该对象本身),按照惯例它的名称是 self。在调用方法时,我们无需明确提供与参数 self 相对应的参数。
python的魔法方法
如果你的对象实现了这些方法中的某一个,那么这个方法就会在特殊的情况下被 Python 所调用,而这一切都是自动发生的...
类有一个名为__init__(self[, param1, param2...])的魔法方法,该方法在类实例化时会自动调用。
公有和私有
在 Python 中定义私有变量只需要在变量名或函数名前加上“__”两个下划线,那么这个函数或变量就会为私有的了。
python明明有私有的定义方法就是在变量或者方法的面前加上双下滑线__,这个实际上是python的伪私有。只是一种程序员约定俗称的规定,加了就表示私有变量,但是你如果要在外部调用的话,还是可以调用的。
Python并没有真正的私有化支持,但可用下划线得到伪私有
(1)_xxx "单下划线 " 开始的成员变量叫做保护变量,意思是只有类对象(即类实例)和子类对象自己能访问到这些变量,需通过类提供的接口进行访问;不能用'from module import *'导入
(2)__xxx 类中的私有变量/方法名 (Python的函数也是对象,所以成员方法称为成员变量也行得通。)," 双下划线 " 开始的是私有成员,意思是只有类对象自己能访问,连子类对象也不能访问到这个数据。
(3)__xxx__ 系统定义名字,前后均有一个“双下划线” 代表python里特殊方法专用的标识,如 __init__() 代表类的构造函数。
class JustCounter:
    __secretCount = 0  # 私有变量
    publicCount = 0  # 公开变量

    def count(self):
        self.__secretCount += 1
        self.publicCount += 1
        print(self.__secretCount)


counter = JustCounter()
counter.count()  # 1
counter.count()  # 2
print(counter.publicCount)  # 2

# Python的私有为伪私有
print(counter._JustCounter__secretCount)  # 2
print(counter.__secretCount)
# AttributeError: 'JustCounter' object has no attribute '__secretCount'
继承
Python 同样支持类的继承,派生类的定义如下所示:
class DerivedClassName(BaseClassName):
statement-1
.
.
.
statement-N
BaseClassName(基类名)必须与派生类定义在一个作用域内。除了类,还可以用表达式,基类定义在另一个模块中时这一点非常有用:
class DerivedClassName(modname.BaseClassName):
statement-1
.
.
.
statement-N
如果子类中定义与父类同名的方法或属性,则会自动覆盖父类对应的方法或属性。
# 类定义
class people:
    # 定义基本属性
    name = ''
    age = 0
    # 定义私有属性,私有属性在类外部无法直接进行访问
    __weight = 0

    # 定义构造方法
    def __init__(self, n, a, w):
        self.name = n
        self.age = a
        self.__weight = w

    def speak(self):
        print("%s 说: 我 %d 岁。" % (self.name, self.age))


# 单继承示例
class student(people):
    grade = ''

    def __init__(self, n, a, w, g):
        # 调用父类的构函
      people.__init__(self, n, a, w)
        self.grade = g

    # 覆写父类的方法
    def speak(self):
        print("%s 说: 我 %d 岁了,我在读 %d 年级" % (self.name, self.age, self.grade))


s = student('小马的程序人生', 10, 60, 3)
s.speak()
# 小马的程序人生 说: 我 10 岁了,我在读 3 年级
如果上面的程序去掉:people.__init__(self, n, a, w),则输出:说: 我 0 岁了,我在读 3 年级,因为子类的构造方法把父类的构造方法覆盖了。
import random

class Fish:
    def __init__(self):
        self.x = random.randint(0, 10)
        self.y = random.randint(0, 10)

    def move(self):
        self.x -= 1
        print("我的位置", self.x, self.y)


class GoldFish(Fish):  # 金鱼
    pass


class Carp(Fish):  # 鲤鱼
    pass


class Salmon(Fish):  # 三文鱼
    pass


class Shark(Fish):  # 鲨鱼
    def __init__(self):
        self.hungry = True

    def eat(self):
        if self.hungry:
            print("吃货的梦想就是天天有得吃!")
            self.hungry = False
        else:
            print("太撑了,吃不下了!")
            self.hungry = True


g = GoldFish()
g.move()  # 我的位置 9 4
s = Shark()
s.eat() # 吃货的梦想就是天天有得吃!
s.move()
# AttributeError: 'Shark' object has no attribute 'x'
- 调用未绑定的父类方法
Fish.__init__(self)
- 使用super函数
super().__init__()
class Shark(Fish):  # 鲨鱼
    def __init__(self):
        super().__init__()
        self.hungry = True

    def eat(self):
        if self.hungry:
            print("吃货的梦想就是天天有得吃!")
            self.hungry = False
        else:
            print("太撑了,吃不下了!")
            self.hungry = True
Python 虽然支持多继承的形式,但我们一般不使用多继承,因为容易引起混乱。
class DerivedClassName(Base1, Base2, Base3):
statement-1
.
.
.
statement-N
需要注意圆括号中父类的顺序,若是父类中有相同的方法名,而在子类使用时未指定,Python 从左至右搜索,即方法在子类中未找到时,从左到右查找父类中是否包含方法。
# 类定义
class People:
    # 定义基本属性
    name = ''
    age = 0
    # 定义私有属性,私有属性在类外部无法直接进行访问
    __weight = 0

    # 定义构造方法
    def __init__(self, n, a, w):
        self.name = n
        self.age = a
        self.__weight = w

    def speak(self):
        print("%s 说: 我 %d 岁。" % (self.name, self.age))


# 单继承示例
class Student(People):
    grade = ''

    def __init__(self, n, a, w, g):
        # 调用父类的构函
        People.__init__(self, n, a, w)
        self.grade = g

    # 覆写父类的方法
    def speak(self):
        print("%s 说: 我 %d 岁了,我在读 %d 年级" % (self.name, self.age, self.grade))


# 另一个类,多重继承之前的准备
class Speaker:
    topic = ''
    name = ''

    def __init__(self, n, t):
        self.name = n
        self.topic = t

    def speak(self):
        print("我叫 %s,我是一个演说家,我演讲的主题是 %s" % (self.name, self.topic))


# 多重继承
class Sample01(Speaker, Student):
    a = ''

    def __init__(self, n, a, w, g, t):
        Student.__init__(self, n, a, w, g)
        Speaker.__init__(self, n, t)

# 方法名同,默认调用的是在括号中排前地父类的方法
test = Sample01("Tim", 25, 80, 4, "Python")
test.speak()
# 我叫 Tim,我是一个演说家,我演讲的主题是 Python

class Sample02(Student, Speaker):
    a = ''

    def __init__(self, n, a, w, g, t):
        Student.__init__(self, n, a, w, g)
        Speaker.__init__(self, n, t)

# 方法名同,默认调用的是在括号中排前地父类的方法
test = Sample02("Tim", 25, 80, 4, "Python")
test.speak()
# Tim 说: 我 25 岁了,我在读 4 年级
我叫 Tim,我是一个演说家,我演讲的主题是 Python
Tim 说: 我 25 岁了,我在读 4 年级
类、类对象和实例对象
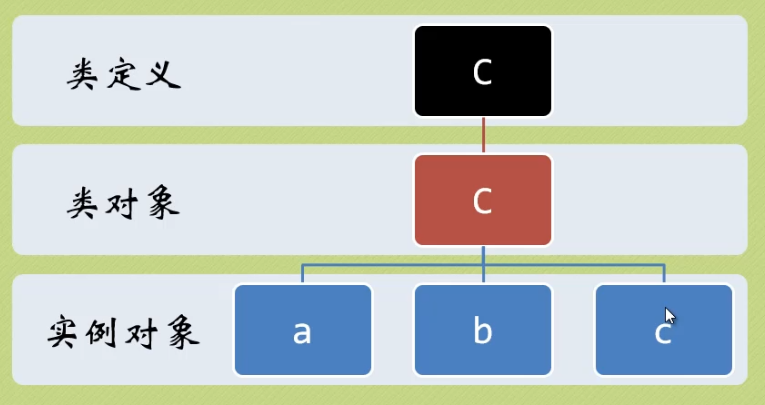
类对象和实例对象
类对象:创建一个类,其实也是一个对象也在内存开辟了一块空间,称为类对象,类对象只有一个。
class A(object):
pass
实例对象:就是通过实例化类创建的对象,称为实例对象,实例对象可以有多个。
类属性:类里面方法外面定义的变量称为类属性。类属性所属于类对象并且多个实例对象之间共享同一个类属性,说白了就是类属性所有的通过该类实例化的对象都能共享。
class A():
    a = 0  #类属性
    def __init__(self, xx):
        A.a = xx  #使用类属性可以通过 (类名.类属性)调用。
实例属性:实例属性和具体的某个实例对象有关系,并且一个实例对象和另外一个实例对象是不共享属性的,说白了实例属性只能在自己的对象里面使用,其他的对象不能直接使用,因为self是谁调用,它的值就属于该对象。
# 创建类对象
class Test(object):
    class_attr = 100  # 类属性

    def __init__(self):
        self.sl_attr = 100  # 实例属性

    def func(self):
        print('类对象.类属性的值:', Test.class_attr)  # 调用类属性
        print('self.类属性的值', self.class_attr)  # 相当于把类属性 变成实例属性
        print('self.实例属性的值', self.sl_attr)  # 调用实例属性


a = Test()
a.func()

# 类对象.类属性的值: 100
# self.类属性的值 100
# self.实例属性的值 100

b = Test()
b.func()

# 类对象.类属性的值: 100
# self.类属性的值 100
# self.实例属性的值 100

a.class_attr = 200
a.sl_attr = 200
a.func()

# 类对象.类属性的值: 100
# self.类属性的值 200
# self.实例属性的值 200

b.func()

# 类对象.类属性的值: 100
# self.类属性的值 100
# self.实例属性的值 100

Test.class_attr = 300
a.func()

# 类对象.类属性的值: 300
# self.类属性的值 200
# self.实例属性的值 200

b.func()
# 类对象.类属性的值: 300
# self.类属性的值 300
# self.实例属性的值 100
注意:属性与方法名相同,属性会覆盖方法。
绑定
Python 严格要求方法需要有实例才能被调用,这种限制其实就是 Python 所谓的绑定概念。
Python 对象的数据属性通常存储在名为.__ dict__的字典中,我们可以直接访问__dict__,或利用 Python 的内置函数vars()获取.__ dict__。
一些相关的内置函数(BIF)
issubclass(class, classinfo) 方法用于判断参数 class 是否是类型参数 classinfo 的子类。
- 一个类被认为是其自身的子类。
classinfo可以是类对象的元组,只要class是其中任何一个候选类的子类,则返回True。
isinstance(object, classinfo) 方法用于判断一个对象是否是一个已知的类型,类似type()。
type()不会认为子类是一种父类类型,不考虑继承关系。isinstance()会认为子类是一种父类类型,考虑继承关系。- 如果第一个参数不是对象,则永远返回
False。 - 如果第二个参数不是类或者由类对象组成的元组,会抛出一个
TypeError异常。
hasattr(object, name)用于判断对象是否包含对应的属性。
getattr(object, name[, default])用于返回一个对象属性值。
setattr(object, name, value)对应函数 getattr(),用于设置属性值,该属性不一定是存在的。
delattr(object, name)用于删除属性。
class property([fget[, fset[, fdel[, doc]]]])用于在新式类中返回属性值。
fget-- 获取属性值的函数fset-- 设置属性值的函数fdel-- 删除属性值函数doc-- 属性描述信息
魔法方法
魔法方法总是被双下划线包围,例如__init__。
魔法方法的“魔力”体现在它们总能够在适当的时候被自动调用。
魔法方法的第一个参数应为cls(类方法) 或者self(实例方法)。
cls:代表一个类的名称self:代表一个实例对象的名称
基本的魔法方法
__init__(self[, ...]) 构造器,当一个实例被创建的时候调用的初始化方法
__new__(cls[, ...]) 在一个对象实例化的时候所调用的第一个方法,在调用__init__初始化前,先调用__new__。
__new__至少要有一个参数cls,代表要实例化的类,此参数在实例化时由 Python 解释器自动提供,后面的参数直接传递给__init__。__new__对当前类进行了实例化,并将实例返回,传给__init__的self。但是,执行了__new__,并不一定会进入__init__,只有__new__返回了,当前类cls的实例,当前类的__init__才会进入。
- 若
__new__没有正确返回当前类cls的实例,那__init__是不会被调用的,即使是父类的实例也不行,将没有__init__被调用。
__new__方法主要是当你继承一些不可变的 class 时(比如int, str, tuple), 提供给你一个自定义这些类的实例化过程的途径。
__del__(self)析构器,当一个对象将要被系统回收之时调用的方法。
Python 采用自动引用计数(ARC)方式来回收对象所占用的空间,当程序中有一个变量引用该 Python 对象时,Python 会自动保证该对象引用计数为 1;当程序中有两个变量引用该 Python 对象时,Python 会自动保证该对象引用计数为 2,依此类推,如果一个对象的引用计数变成了 0,则说明程序中不再有变量引用该对象,表明程序不再需要该对象,因此 Python 就会回收该对象。
大部分时候,Python 的 ARC 都能准确、高效地回收系统中的每个对象。但如果系统中出现循环引用的情况,比如对象 a 持有一个实例变量引用对象 b,而对象 b 又持有一个实例变量引用对象 a,此时两个对象的引用计数都是 1,而实际上程序已经不再有变量引用它们,系统应该回收它们,此时 Python 的垃圾回收器就可能没那么快,要等专门的循环垃圾回收器(Cyclic Garbage Collector)来检测并回收这种引用循环。
__str__(self):
- 当你打印一个对象的时候,触发
__str__ - 当你使用
%s格式化的时候,触发__str__ str强转数据类型的时候,触发__str__
__repr__(self):
repr是str的备胎- 有
__str__的时候执行__str__,没有实现__str__的时候,执行__repr__ repr(obj)内置函数对应的结果是__repr__的返回值- 当你使用
%r格式化的时候 触发__repr__
__str__(self) 的返回结果可读性强。也就是说,__str__ 的意义是得到便于人们阅读的信息。
__repr__(self) 的返回结果应更准确。怎么说,__repr__ 存在的目的在于调试,便于开发者使用。
import datetime

today = datetime.date.today()
print(str(today))  # 2021-02-02
print(repr(today))  # datetime.date(2021, 02, 02)
print('%s' %today)  # 2021-02-02
print('%r' %today)  # datetime.date(2021, 02, 02)
算数运算符
类型工厂函数,指的是“不通过类而是通过函数来创建对象”。
__add__(self, other)定义加法的行为:+__sub__(self, other)定义减法的行为:-__mul__(self, other)定义乘法的行为:*__truediv__(self, other)定义真除法的行为:/__floordiv__(self, other)定义整数除法的行为://__mod__(self, other)定义取模算法的行为:%__divmod__(self, other)定义当被divmod()调用时的行为divmod(a, b)把除数和余数运算结果结合起来,返回一个包含商和余数的元组(a // b, a % b)。
print(divmod(7, 2))  # (3, 1)
print(divmod(8, 2))  # (4, 0)
__pow__(self, other[, module])定义当被power()调用或**运算时的行为__lshift__(self, other)定义按位左移位的行为:<<__rshift__(self, other)定义按位右移位的行为:>>__and__(self, other)定义按位与操作的行为:&__xor__(self, other)定义按位异或操作的行为:^__or__(self, other)定义按位或操作的行为:|
反算数运算符
反运算魔方方法,与算术运算符保持一一对应,不同之处就是反运算的魔法方法多了一个“r”。当文件左操作不支持相应的操作时被调用。
__radd__(self, other)定义加法的行为:+__rsub__(self, other)定义减法的行为:-__rmul__(self, other)定义乘法的行为:*__rtruediv__(self, other)定义真除法的行为:/__rfloordiv__(self, other)定义整数除法的行为://__rmod__(self, other)定义取模算法的行为:%__rdivmod__(self, other)定义当被 divmod() 调用时的行为__rpow__(self, other[, module])定义当被 power() 调用或**运算时的行为__rlshift__(self, other)定义按位左移位的行为:<<__rrshift__(self, other)定义按位右移位的行为:>>__rand__(self, other)定义按位与操作的行为:&__rxor__(self, other)定义按位异或操作的行为:^__ror__(self, other)定义按位或操作的行为:|
a + b
这里加数是a,被加数是b,因此是a主动,反运算就是如果a对象的__add__()方法没有实现或者不支持相应的操作,那么 Python 就会调用b的__radd__()方法。
详细可看此博客后面:https://blog.csdn.net/aka_happy/article/details/82255603
增量赋值运算符
__iadd__(self, other)定义赋值加法的行为:+=__isub__(self, other)定义赋值减法的行为:-=__imul__(self, other)定义赋值乘法的行为:*=__itruediv__(self, other)定义赋值真除法的行为:/=__ifloordiv__(self, other)定义赋值整数除法的行为://=__imod__(self, other)定义赋值取模算法的行为:%=__ipow__(self, other[, modulo])定义赋值幂运算的行为:**=__ilshift__(self, other)定义赋值按位左移位的行为:<<=__irshift__(self, other)定义赋值按位右移位的行为:>>=__iand__(self, other)定义赋值按位与操作的行为:&=__ixor__(self, other)定义赋值按位异或操作的行为:^=__ior__(self, other)定义赋值按位或操作的行为:|=
一元运算符
__neg__(self)定义正号的行为:+x__pos__(self)定义负号的行为:-x__abs__(self)定义当被abs()调用时的行为__invert__(self)定义按位求反的行为:~x
属性访问
__getattr__(self, name): 定义当用户试图获取一个不存在的属性时的行为。__getattribute__(self, name):定义当该类的属性被访问时的行为(先调用该方法,查看是否存在该属性,若不存在,接着去调用__getattr__)。__setattr__(self, name, value):定义当一个属性被设置时的行为。__delattr__(self, name):定义当一个属性被删除时的行为。
描述符
描述符就是将某种特殊类型的类的实例指派给另一个类的属性。
__get__(self, instance, owner)用于访问属性,它返回属性的值。__set__(self, instance, value)将在属性分配操作中调用,不返回任何内容。__del__(self, instance)控制删除操作,不返回任何内容。
定制序列
协议(Protocols)与其它编程语言中的接口很相似,它规定你哪些方法必须要定义。然而,在 Python 中的协议就显得不那么正式。事实上,在 Python 中,协议更像是一种指南。
容器类型的协议
- 如果说你希望定制的容器是不可变的话,你只需要定义
__len__()和__getitem__()方法。 - 如果你希望定制的容器是可变的话,除了
__len__()和__getitem__()方法,你还需要定义__setitem__()和__delitem__()两个方法。
__len__(self)定义当被len()调用时的行为(返回容器中元素的个数)。__getitem__(self, key)定义获取容器中元素的行为,相当于self[key]。__setitem__(self, key, value)定义设置容器中指定元素的行为,相当于self[key] = value。__delitem__(self, key)定义删除容器中指定元素的行为,相当于del self[key]。
迭代器
- 迭代是 Python 最强大的功能之一,是访问集合元素的一种方式。
- 迭代器是一个可以记住遍历的位置的对象。
- 迭代器对象从集合的第一个元素开始访问,直到所有的元素被访问完结束。
- 迭代器只能往前不会后退。
- 字符串,列表或元组对象都可用于创建迭代器:
- 迭代器有两个基本的方法:
iter()和next()。 iter(object)函数用来生成迭代器。next(iterator[, default])返回迭代器的下一个项目。iterator-- 可迭代对象default-- 可选,用于设置在没有下一个元素时返回该默认值,如果不设置,又没有下一个元素则会触发StopIteration异常。
把一个类作为一个迭代器使用需要在类中实现两个魔法方法 __iter__() 与 __next__() 。
__iter__(self)定义当迭代容器中的元素的行为,返回一个特殊的迭代器对象, 这个迭代器对象实现了__next__()方法并通过StopIteration异常标识迭代的完成。__next__()返回下一个迭代器对象。StopIteration异常用于标识迭代的完成,防止出现无限循环的情况,在__next__()方法中我们可以设置在完成指定循环次数后触发StopIteration异常来结束迭代。
生成器
- 在 Python 中,使用了
yield的函数被称为生成器(generator)。 - 跟普通函数不同的是,生成器是一个返回迭代器的函数,只能用于迭代操作,更简单点理解生成器就是一个迭代器。
- 在调用生成器运行的过程中,每次遇到
yield时函数会暂停并保存当前所有的运行信息,返回yield的值, 并在下一次执行next()方法时从当前位置继续运行。 - 调用一个生成器函数,返回的是一个迭代器对象
模块
什么是模块
命名空间

导入模块
if __name__ == '__main__'
datetime模块
datetime类


data类
time类
class time:
 def __init__(self, hour, minute, second, microsecond, tzinfo):
 pass
import datetime
t = datetime.time(12, 9, 23, 12980)
print(t) # 12:09:23.012980
print(type(t)) # <class 'datetime.time'>
timedelta类
class timedelta(SupportsAbs[timedelta]):
 def __init__(self, days, seconds, microseconds, milliseconds, minutes, hours, weeks,):
 pass
 def days(self):
 pass
 def total_seconds(self):
 pass
import datetime
td = datetime.timedelta(days=30)
print(td) # 30 days, 0:00:00
print(type(td)) # <class 'datetime.timedelta'>
print(datetime.date.today()) # 2020-07-01
print(datetime.date.today() + td) # 2020-07-31
dt1 = datetime.datetime(2020, 1, 31, 10, 10, 0)
dt2 = datetime.datetime(2019, 1, 31, 10, 10, 0)
td = dt1 - dt2
print(td) # 365 days, 0:00:00
print(type(td)) # <class 'datetime.timedelta'>
td1 = datetime.timedelta(days=30) # 30 days
td2 = datetime.timedelta(weeks=1) # 1 week
td = td1 - td2
print(td) # 23 days, 0:00:00
print(type(td)) # <class 'datetime.timedelta'>
文件与文件系统
打开文件


 浙公网安备 33010602011771号