
杂题瞎做(1)
图论
CF19E Fairy
瞎做的第一题。。。古早 *2900,是我没有想出来的捏,体感 *2400。
先说一下我的心路历程,先看联通的问题,对于联通块,发现有超过两个联通块不是二分图无解,然后全是二分图的话,也显然随便删,感性理解。接着看到二分图,于是考虑转化为没有奇环,所以显然的建 dfs 树,然后用树上差分打标记即可。之后手模样例发现这是错的,遂放弃。先说一下错误的点,你考虑一种显然的反例,就是一个偶环包着一个奇环,此时删除奇环上的树边没有意义。
后来就想到,既然枚举奇环贡献边很复杂,不如对于每条边都试着做做。一种显然的方法,分讨树边和非树边,然后删除非树边显然,当且仅当只有这一个非树边会造成奇环,否则啥用没有,树边的探讨,一个显然的想法是必然是各个奇环的交,但是只有这一个限制太弱了,接着就不会了。。。
经过提示,貌似会了。我们来换个角度看问题,奇环是不好想的,于是考虑用二分图判定的另一种形式——染色。我们先把 dfs 树先都染上色,对于奇环来讲就可以转化成非树边连了同色点。然后来用染色刻画一下断边这个操作,显然只断边不会解决连接同色的情况,也就是说我们断边的本质是把分出去的那个子树的全部颜色做了一次翻转。然后此时来思考,我的更强限制也就出现在,翻转这棵子树后,又有非树边构成同色,因此也就是对于一条可以删的树边,它不能出现在本来的连了异色的的边和树边锁构成的环里,否则就会把这条边变成连接同色的环。
于是这题做完了。
纯净版压行版:
#include<bits/stdc++.h>
using namespace std;
const int N=10005;
struct edge{
    int to,nxt,id;
}e[N<<1];
int hd[N],tot=1,col[N],d[N],f[N],sz[N],w[N],top[N],vis[N];
int c1[N],c2[N],sum,pos,ans[N],cnt;
void add(int u,int v,int id){
    e[++tot].to=v;
    e[tot].nxt=hd[u];
    e[tot].id=id;
    hd[u]=tot;
}
void dfs1(int u,int fa){
    vis[u]=1;
    sz[u]=1,d[u]=d[fa]+1,f[u]=fa;
    int mx=0,k=0;
    for (int i=hd[u];i;i=e[i].nxt){
        int v=e[i].to;
        if (!vis[v]){
            col[v]=col[u]^1;
            dfs1(v,u);
            sz[u]+=sz[v];
            if (sz[v]>mx)mx=sz[v],k=v;
        }
    }
    w[u]=k;
}
void dfs2(int u){
    if (!w[u])return;
    top[w[u]]=top[u];
    dfs2(w[u]);
    for (int i=hd[u];i;i=e[i].nxt){
        int v=e[i].to;
        if (f[v]!=u||v==w[u])continue;
        top[v]=v;
        dfs2(v);
    }
}
int lca(int u,int v){
    while (top[u]!=top[v]){
        if (d[top[u]]>d[top[v]])u=f[top[u]];
        else v=f[top[v]];
    }
    return (d[u]>d[v]?v:u);
}
void dfs3(int u,int pid){
    for (int i=hd[u];i;i=e[i].nxt){
        int v=e[i].to,id=e[i].id;
        if (id==pid)continue;
        if (d[v]==d[u]+1){
            dfs3(v,id);
            c1[u]+=c1[v];
            c2[u]+=c2[v];
        }
    }
    if (pid&&c1[u]==sum&&c2[u]==0)ans[++cnt]=pid;
}
int main(){
    ios::sync_with_stdio(0);cin.tie(0);
    int n,m;cin>>n>>m;
    for (int i=1;i<=m;++i){
        int u,v;cin>>u>>v;
        add(u,v,i),add(v,u,i);
    }
    for (int i=1;i<=n;++i)if (!vis[i]){
        col[i]=0;
        dfs1(i,0);
        top[i]=i;
        dfs2(i);
    }
    for (int u=1;u<=n;++u){
        for (int i=hd[u];i;i=e[i].nxt){
            int v=e[i].to,id=e[i].id;
            if (d[v]<d[u]&&f[u]!=v){
                if (col[u]==col[v]){
                    sum++;
                    pos=id;
                    c1[u]++,c1[v]++,c1[lca(u,v)]-=2;
                }
                else c2[u]++,c2[v]++,c2[lca(u,v)]-=2;
            }
        }
    }
    for (int i=1;i<=n;++i)if (d[i]==1)dfs3(i,0);
    if (!sum){
        cout<<m<<'\n';
        for (int i=1;i<=m;++i)cout<<i<<" ";
        return 0;
    }
    if (sum==1)ans[++cnt]=pos;
    sort(ans+1,ans+1+cnt);
    cout<<cnt<<'\n';
    for (int i=1;i<=cnt;++i)cout<<ans[i]<<" ";
}
额注释版
#include<bits/stdc++.h>
using namespace std;
const int N=10005;

// 前向星存图
struct edge{
    int to,nxt,id;   // id 是边的原始编号
}e[N<<1];
int hd[N],tot=1;     // tot=1 方便双向边配对(i^1 取反向边,虽然本题没用到)

// 树剖相关
int col[N];          // 染色 0/1
int d[N],f[N];       // 深度,父亲
int sz[N],w[N];      // 子树大小,重儿子
int top[N];          // 链顶
int vis[N];          // dfs1 的访问标记

// 差分标记
int c1[N],c2[N];     // c1: 奇环覆盖次数,c2: 偶环覆盖次数
int sum;             // 奇环总数
int pos;             // 唯一奇环对应的那条非树边编号
int ans[N],cnt;      // 答案数组

void add(int u,int v,int id){
    e[++tot].to=v;
    e[tot].nxt=hd[u];
    e[tot].id=id;
    hd[u]=tot;
}

// ---------- 树剖第一遍 ----------
// 求 f, d, sz, w,顺带染色
void dfs1(int u,int fa){
    vis[u]=1;
    sz[u]=1, d[u]=d[fa]+1, f[u]=fa;
    int mx=0,k=0;
    for (int i=hd[u];i;i=e[i].nxt){
        int v=e[i].to;
        if (!vis[v]){                    // 树边:儿子
            col[v]=col[u]^1;             // 染色:与父亲相反
            dfs1(v,u);
            sz[u]+=sz[v];
            if (sz[v]>mx)mx=sz[v],k=v;   // 找重儿子
        }
    }
    w[u]=k;                              // 重儿子
}

// ---------- 树剖第二遍 ----------
// 求 top
void dfs2(int u){
    if (!w[u])return;                    // 叶子
    top[w[u]]=top[u];                    // 重儿子继承链顶
    dfs2(w[u]);
    for (int i=hd[u];i;i=e[i].nxt){
        int v=e[i].to;
        if (f[v]!=u||v==w[u])continue;   // 只看轻儿子(父亲是 u 且不是重儿子)
        top[v]=v;                        // 轻儿子新开一条链
        dfs2(v);
    }
}

// ---------- 树剖 LCA ----------
int lca(int u,int v){
    while (top[u]!=top[v]){
        if (d[top[u]]>d[top[v]])u=f[top[u]];
        else v=f[top[v]];
    }
    return (d[u]>d[v]?v:u);
}

// ---------- 差分回溯 ----------
// 只沿树边向下(d[v]==d[u]+1),从叶子往上累加 c1, c2
void dfs3(int u,int pid){
    for (int i=hd[u];i;i=e[i].nxt){
        int v=e[i].to,id=e[i].id;
        if (id==pid)continue;
        if (d[v]==d[u]+1){               // 树边
            dfs3(v,id);
            c1[u]+=c1[v];
            c2[u]+=c2[v];
        }
    }
    // 判断这条树边 (u, f[u]) 是否可删
    if (pid&&c1[u]==sum&&c2[u]==0)ans[++cnt]=pid;
}

// ---------- 主函数 ----------
int main(){
    ios::sync_with_stdio(0);cin.tie(0);
    int n,m;cin>>n>>m;
    for (int i=1;i<=m;++i){
        int u,v;cin>>u>>v;
        add(u,v,i),add(v,u,i);
    }

    // 1. 建 dfs 树 + 树剖(处理多联通块)
    for (int i=1;i<=n;++i)if (!vis[i]){
        col[i]=0;
        dfs1(i,0);
        top[i]=i;
        dfs2(i);
    }

    // 2. 处理所有非树边,打差分标记
    //    d[v]<d[u] && f[u]!=v 保证每条非树边只由浅到深处理一次
    for (int u=1;u<=n;++u){
        for (int i=hd[u];i;i=e[i].nxt){
            int v=e[i].to,id=e[i].id;
            if (d[v]<d[u]&&f[u]!=v){
                if (col[u]==col[v]){          // 同色 → 奇环
                    sum++;
                    pos=id;                   // 记录这条非树边
                    c1[u]++,c1[v]++;          // 端点 +1
                    c1[lca(u,v)]-=2;          // LCA -2(差分)
                }
                else {                        // 异色 → 偶环
                    c2[u]++,c2[v]++;
                    c2[lca(u,v)]-=2;
                }
            }
        }
    }

    // 3. 回溯累加差分
    for (int i=1;i<=n;++i)if (d[i]==1)dfs3(i,0);

    // 4. 输出答案
    if (!sum){                                // 原图就是二分图
        cout<<m<<'\n';
        for (int i=1;i<=m;++i)cout<<i<<" ";
        return 0;
    }
    if (sum==1)ans[++cnt]=pos;                // 唯一奇环的非树边也可删
    sort(ans+1,ans+1+cnt);
    cout<<cnt<<'\n';
    for (int i=1;i<=cnt;++i)cout<<ans[i]<<" ";
}
P8346 「Wdoi-6」最澄澈的空与海
体感 *2100。
小清新,画一下图,发现如果每个点的度数都 \(\ge 2\),那么必然可以画出两种以上,然后此时有一种想法就是,要有度数为 \(1\) 的点,但是有几个不好刻画,那么我们就有一种类似于拓扑排序的想法,把所有的度数为 \(1\) 的点找出来,连点带边删掉,也就是先把突破口匹配掉,因为这个点死了所以与其相连的那个点也要配掉。然后继续找,发现这样找下去如果点都没了那么就是合法的,如果中间有一部分删不掉就不合法了。
#include<bits/stdc++.h>
using namespace std;
const int N=4e6+5;
struct egde{
    int to,nxt;
}e[N*2];
int hd[N],tot;
void add(int u,int v){
    e[++tot].to=v;
    e[tot].nxt=hd[u];
    hd[u]=tot;
}
int d[N],vis[N];
void solve(){
    int n,m;cin>>n>>m;
    n=n*2;
    for (int i=1;i<=n;++i) d[i]=vis[i]=hd[i]=0;
    tot=0;
    for (int i=1;i<=m;++i){
        int u,v;cin>>u>>v;
        v+=n/2;
        add(u,v);add(v,u);
        d[u]++;d[v]++;
    }
    queue<int>q;
    for (int i=1;i<=n;++i){
        if (d[i]==1)q.push(i);
    }
    while (!q.empty()){
        int u=q.front();q.pop();
        if (vis[u])continue;
        vis[u]=1;
        int vv=0;
        for (int i=hd[u];i;i=e[i].nxt){
            int v=e[i].to;
            if (!vis[v]){
                vv=v;
                break;
            }
        }
        if (!vv) continue;
        vis[vv]=1;
        for (int i=hd[vv];i;i=e[i].nxt){
            int w=e[i].to;
            if (!vis[w]){
                d[w]--;
                if (d[w]==1)q.push(w);
            }
        }
    }
    int ok=1;
    for (int i=1;i<=n;++i) ok&=vis[i];
    if (ok) cout<<"Renko\n";
    else cout<<"Merry\n";
}
int main(){
    int T;cin>>T;
    while (T--)solve();
}
P5663 [CSP-J 2019] 加工零件
体感 *1900。
这两天的博客中出现的第一道简单题。容易发现,我可以在一条边来回的刷,所以就是奇偶性的问题,考虑对 \(L\) 奇偶性分讨,然后维护一下分层图的最短路,判掉到不了 \(1\) 的情况就好了。。
#include<bits/stdc++.h>
using namespace std;
const int N=1e5+5;
struct edge{
    int to,nxt;
}e[N*2];
int tot,hd[N];
void add(int u,int v){
    e[++tot].to=v;
    e[tot].nxt=hd[u];
    hd[u]=tot;
}
int dis[N][2];
int main(){
    int n,m,Q;
    cin>>n>>m>>Q;
    for (int i=1;i<=m;++i){
        int u,v;
        cin>>u>>v;
        add(u,v);add(v,u);
    }
    queue<int>q;
    q.push(1);
    memset(dis,0x3f,sizeof dis);
    dis[1][0]=0;
    while (!q.empty()){
        int u=q.front();q.pop();
        for (int i=hd[u];i;i=e[i].nxt){
            int v=e[i].to;
            if (dis[u][1]+1<dis[v][0]){
                dis[v][0]=dis[u][1]+1;
                q.push(v);
            }
            if (dis[u][0]+1<dis[v][1]){
                dis[v][1]=dis[u][0]+1;
                q.push(v);
            }
        }
    }
    while (Q--){
        int a,L;
        cin>>a>>L;
        if (L%2==1){
            if (dis[a][1]<=L) cout<<"Yes\n";
            else cout<<"No\n";
        } else {
            if (dis[a][0]<=L) cout<<"Yes\n";
            else cout<<"No\n";
        }
    }
}
P9377 [THUPC 2023 决赛] 百合
好题!显然是蒟蒻做不出来的!
考虑边数太多,一定要去减少边数,然后点并没有很多,于是拆点,看一下不同位置数这个东西怎么刻画,我们可以刻画成取了 \(k\) 位反后相等,发现我并不能一下确定是哪 \(k\) 位,所以需要按位决策,\((i,j,k)\) 表示前 \(j\) 取了 \(k\) 位反,最终得到 \(i\)。转移是好刻画的。然后发现这个复杂度是不对的,我们可以考虑把长度为 \(0\) 的边单独拿出来,跑一遍 BFS 即可。
#include<bits/stdc++.h>
using namespace std;
const int N=1<<18;
int n,m,s;
long long c[20];
struct edge{
    int to,nxt;
    long long w;
}e[N*2];
int hd[N],tot;
void add(int u,int v,long long w){
    e[++tot].to=v;
    e[tot].w=w;
    e[tot].nxt=hd[u];
    hd[u]=tot;
}
long long dis[N];
int vis[N];
int q[N][3],l,r;
bool f[N][20][20];
priority_queue<pair<long long,int>,vector<pair<long long,int>>,greater<pair<long long,int>>>pq;

void update(int u,long long d){
    if (d<dis[u]){
        dis[u]=d;
        pq.push({d,u});
    }
}

void push(int x,int p,int cnt){
    if (!f[x][p][cnt]){
        f[x][p][cnt]=1;
        q[++r][0]=x;
        q[r][1]=p;
        q[r][2]=cnt;
    }
}

void spfa(int s){
    for (int i=0;i<(1<<n);++i)dis[i]=1e18;
    update(s,0);
    while (!pq.empty()){
        int u=pq.top().second;pq.pop();
        if (vis[u])continue;
        vis[u]=1;
        for (int i=hd[u];i;i=e[i].nxt){
            update(e[i].to,dis[u]+e[i].w);
        }
        l=1,r=0;
        push(u,0,0);
        while (l<=r){
            int x=q[l][0],p=q[l][1],cnt=q[l][2];l++;
            if (p<n){
                push(x,p+1,cnt);
                push(x^(1<<p),p+1,cnt+1);
            }
            else {
                update(x,dis[u]+c[cnt]);
            }
        }
    }
}

signed main(){
    ios::sync_with_stdio(0);cin.tie(0);
    cin>>n>>m>>s;
    for (int i=1;i<=n;++i)cin>>c[i];
    for (int i=1;i<=m;++i){
        int u,v;
        long long w;
        cin>>u>>v>>w;
        add(u,v,w),add(v,u,w);
    }
    spfa(s);
    for (int i=0;i<(1<<n);++i)cout<<dis[i]<<" ";
}
旧址
这个题,很厉害啊,考试想的差不多没做出来还是太弱了。显然的一个观察是,其实大的情况分布是偏少的,这是一种感觉,然后考虑什么情况能贡献 \(\ge 2\) 的,不妨先考虑 \(=2\),两个点在补图中度数如果都 $ < \frac{n}{2}$ 是肯定可以的,鸽巢原理。接着我们称这些度数 \(\le \frac{n}{2}\) 的点为大点,我们对所有的大点跑一遍补图最短路即可。可以来估算一下大点的数量,我们知道一张图中的度数和为 \(2m\),令大点有 \(k\) 个,则 \(2m \ge k\times \frac{n}{2}\),显然的移项 $ \frac{4m}{n}\ge k$,同时总点数为 \(n\),忽略常数 \(4\),所以大点最多有 \(\min(n,\frac{m}{n})\) 个,根号平衡,\(n= \sqrt {m}\) 时最大,所以复杂度实际很低。然后可以来说一下补图最短路咋做,考虑你知道一个图的补图,你要求原图上某个点到各个点的最短路,并且是原图远比补图稠密的情况,我们维护一个链表,表示当前还有多少点没有访问过,对于每个点,先把它在补图上的点标记为不能走,然后去遍历这个链表,如果还能连就把它松弛并删除,复杂度是 \(O(n+m)\) 的,这里的 \(m\) 注意是原图边数。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=1e6+5;
int n,m;
vector<int> e[N];
int d[N],ans[N],dis[N],pre[N],nxt[N],vis[N];
queue<int> q;
void del(int x){
    nxt[pre[x]]=nxt[x];
    pre[nxt[x]]=pre[x];
}
void bfs(int s){
    for(int i=1;i<=n;++i){
        pre[i]=i-1;
        nxt[i]=i+1;
        vis[i]=0;
        dis[i]=-1;
    }
    nxt[0]=1;pre[n+1]=n;
    q.push(s);del(s);dis[s]=0;
    while(!q.empty()){
        int u=q.front();q.pop();
        for(auto v:e[u])vis[v]=1;
        for(int i=nxt[0];i!=n+1;i=nxt[i]){
            if(!vis[i]){
                dis[i]=dis[u]+1;
                q.push(i);del(i);
            }
        }
        for(int v:e[u])vis[v]=0;
    }
}
signed main(){
    cin>>n>>m;
    for(int i=1;i<=m;++i){
        int u,v;cin>>u>>v;
        e[u].push_back(v);
        e[v].push_back(u);
        d[u]++;d[v]++;
    }
    ans[1]=n*(n-1)/2-m;
    for(int u=1;u<=n;++u){
        if(d[u]<n/2){
            for(auto v:e[u]){
                if(d[v]<n/2&&v<u)ans[2]++;
            }
        }
    }
    for(int i=1;i<=n;++i){
        if(d[i]>=n/2){
            bfs(i);
            for(auto v:e[i]){
                if(dis[v]!=-1&&(d[v]<n/2||v<i))ans[dis[v]]++;
            }
        }
    }
    for(int k=1;k<=n-1;++k)cout<<ans[k]<<" ";
}
丁香之路
好题,但是我会了所以应该至少理解难度没有那么高,第一次遇到确实不好想的。
首先有一个很典的性质,就是你发现连 \(i \to j\),不如连 \(i \to i+1 \to i+2 \cdots \to j\),连通性会更好,并且代价和原来是一样的。然后你发现这个东西其实可以从欧拉路径的角度去刻画,也就是 \(s\) 和 \(t\) 的度数为奇数,然后中间的度数全部偶数,这是奇偶性上的限制,我们先考虑把这个限制做出来,找出所有与自己奇偶性不相符的点,然后按照顺序,相邻的连上一条即可,可以证明这么做是最优的,接着考虑连通性的问题,那么考虑我现在的连通性本质上是若干个联通块,你就把相邻的块的左右端点分别连上,跑一个最小生成树即可。
#include<bits/stdc++.h>
using namespace std;
const int N=2505;
int d[N],f[N],bel[N];
int find(int x){
    if (f[x]==x)return x;
    return f[x]=find(f[x]);
}
void join(int x,int y){
    f[find(x)]=find(y);
}
struct edge{
    int u,v,w;
}e[N];
bool cmp(edge x,edge y){
    return x.w<y.w;
}
int main(){
    int n,m,s;cin>>n>>m>>s;
    for (int i=1;i<=n;++i)f[i]=i;
    long long sum=0;
    for (int i=1;i<=m;++i){
        int u,v;cin>>u>>v;
        d[u]++;d[v]++;sum+=abs(u-v);
        join(u,v);
    }
    for (int i=1;i<=n;++i)bel[i]=find(i);
    for (int t=1;t<=n;++t){
        for (int i=1;i<=n;++i)f[i]=i;
        join(bel[s],bel[t]);
        vector<int>v;
        long long ans=sum;
        for (int i=1;i<=n;++i){
            if ((d[i]&1)^(i==s)^(i==t))v.push_back(i);
        }
        sort(v.begin(),v.end());
        for (int i=1;i<(int)v.size();i+=2){
            for (int k=v[i-1];k<v[i];++k)join(bel[k],bel[v[i]]);
            ans+=v[i]-v[i-1];
        }
        vector<edge>b;
        int pre=0;
        for (int i=1;i<=n;++i){
            if (d[i]||i==s||i==t){
                if (pre&&find(bel[i])!=find(bel[pre]))
                    b.push_back({bel[pre],bel[i],i-pre});
                pre=i;
            }
        }
        sort(b.begin(),b.end(),cmp);
        for (int i=0;i<(int)b.size();++i){
            if (find(b[i].u)!=find(b[i].v)){
                join(b[i].u,b[i].v);
                ans+=b[i].w*2;
            }
        }
        cout<<ans<<" ";
    }
}
P4334 [COI 2007] Policija
是喜闻乐见的蠢蛋题。考虑先刻画询问 \(1\),会发现当且仅当 \((g1,g2)\) 是个割边,并且刚好把 \(a,b\) 分开,稍微想一下你就会发现就是一个在外面然后一个在 \(g1,g2\) 稍微深一些的那个的子树里,你 Tarjan 过程中维护一下 dfs 序的区间就能 \(O(1)\) 做。接着考虑操作二,你发现一个最基础的条件是 \(c\) 是割点,并且还要将 \(a,b\) 分开,可以简单思考一下,删除 \(c\),它的儿子们的子树要么和上面断开,要么就是连到上面了,先分类讨论:\(a,b\) 都不在,\(a,b\) 都在,一个在一个不在。第一种显然,对于第二种我们考虑先倍增得到 \(a,b\) 在 \(c\) 哪个儿子的子树中,可行就是都连到上面或在同一子树,第三种合法当且仅当在的那个能够连到外面,都用 dfn 和 low 判就可以了。本题唯一困难可能是代码不太好写()
#include<bits/stdc++.h>
using namespace std;
const int N=5e5+5;
struct edge{
    int to,nxt;
}e[N*2];
int hd[N],tot;
void add(int u,int v){
    e[++tot].to=v;
    e[tot].nxt=hd[u];
    hd[u]=tot;
}
int dfn[N],low[N],out[N],dep[N],cnt;
int vis[N];
int fa[N][20];
void tarjan(int u,int f){
    dep[u]=dep[f]+1;
    fa[u][0]=f;
    for (int j=1;j<20;++j)fa[u][j]=fa[fa[u][j-1]][j-1];
    low[u]=dfn[u]=++cnt;
    int k=0;
    for (int i=hd[u];i;i=e[i].nxt){
        int v=e[i].to;
        if (!dfn[v]){
            k++;
            tarjan(v,u);
            if (f!=0&&low[v]>=dfn[u])vis[u]=1;
            low[u]=min(low[u],low[v]);
        }
        else if (v!=f)low[u]=min(low[u],dfn[v]);
    }
    if (f==0&&k>=2)vis[u]=1;
    out[u]=cnt;
}
bool query(int u,int c){
    return dfn[c]<=dfn[u]&&dfn[u]<=out[c];
}
int find(int x,int c){
    for (int j=19;j>=0;--j){
        if (dep[fa[x][j]]>dep[c])x=fa[x][j];
    }
    return x;
}
int main(){
    int n,m;
    cin>>n>>m;
    for (int i=1;i<=m;++i){
        int u,v;
        cin>>u>>v;
        add(u,v);add(v,u);
    }
    for (int i=1;i<=n;++i){
        if (!dfn[i])tarjan(i,0);
    }
    int Q;cin>>Q;
    while (Q--){
        int op,a,b;cin>>op>>a>>b;
        if (op==1){
            int g1,g2;cin>>g1>>g2;
            if (dep[g1]<dep[g2])swap(g1,g2);
            if (fa[g1][0]==g2&&low[g1]>dfn[g2]){
                bool ina=query(a,g1);
                bool inb=query(b,g1);
                if (ina!=inb)cout<<"no\n";
                else cout<<"yes\n";
            }
            else cout<<"yes\n";
        }
        else {
            int c;cin>>c;
            if (!vis[c])cout<<"yes\n";
            else {
                bool ina=query(a,c);
                bool inb=query(b,c);
                if (!ina&&!inb)cout<<"yes\n";
                else if (ina&&inb){
                    int ta=find(a,c);
                    int tb=find(b,c);
                    if (ta==tb)cout<<"yes\n";
                    else {
                        if (low[ta]<dfn[c]&&low[tb]<dfn[c])cout<<"yes\n";
                        else cout<<"no\n";
                    }
                }
                else {
                    int t=ina?find(a,c):find(b,c);
                    if (low[t]<dfn[c])cout<<"yes\n";
                    else cout<<"no\n";
                }
            }
        }
    }
}
P4652 [CEOI 2017] One-Way Streets
全场最难绷之题,首先思路是一眼的,在如果限制在边双里肯定起不到作用,因为把所有边双都反一遍必然是,可行的,于是仅有可能是割边,于是把割边树建出来,然后我们把向上和向下分别用差分维护即可。代码很好写几本没有细节。
#include<bits/stdc++.h>
using namespace std;
const int N=5e5+5;
struct edge{
    int to,nxt;
}e[N*2];
int hd[N],tot=1;
void add(int u,int v){
    e[++tot].to=v;
    e[tot].nxt=hd[u];
    hd[u]=tot;
}
int dfn[N],low[N],cnt,p[N];
stack<int>stk;
vector<int>s[N];
int t;
void tarjan(int u,int fa){
    low[u]=dfn[u]=++cnt;
    stk.push(u);
    for (int i=hd[u];i;i=e[i].nxt){
        int v=e[i].to;
        if (i==(fa^1))continue;
        if (!dfn[v]){
            tarjan(v,i);
            low[u]=min(low[u],low[v]);
        }
        else low[u]=min(low[u],dfn[v]);
    }
    if (low[u]==dfn[u]){
        ++t;
        while (stk.top()!=u){
            p[stk.top()]=t;
            s[t].push_back(stk.top());
            stk.pop();
        }
        s[t].push_back(u);p[u]=t;
        stk.pop();
    }
}
vector<int>g[N];
set<pair<int,int>>st;
int u[N],v[N];
int w[N],sz[N],top[N],f[N],d[N];
void dfs1(int u,int fa){
    sz[u]=1;int k=0,mx=0;
    f[u]=fa;d[u]=d[fa]+1;
    for (auto v:g[u]){
        if (v==fa)continue;
        dfs1(v,u);
        sz[u]+=sz[v];
        if (sz[v]>mx)mx=sz[v],k=v;
    }
    w[u]=k;
}
void dfs2(int u){
    if (!w[u])return;
    top[w[u]]=top[u];
    dfs2(w[u]);
    for (auto v:g[u]){
        if (v==f[u]||v==w[u])continue;
        top[v]=v;dfs2(v);
    }
}
int LCA(int u,int v){
    while (top[u]!=top[v]){
        if (d[top[u]]>d[top[v]])u=f[top[u]];
        else v=f[top[v]];
    }
    return (d[u]>d[v]?v:u);
}
int a[N],b[N];
void dfs3(int u,int fa){
    for (auto v:g[u]){
        if (v==fa)continue;
        dfs3(v,u);
        a[u]+=a[v];b[u]+=b[v];
    }
}
int main(){
    int n,m;cin>>n>>m;
    for (int i=1;i<=m;++i){
        cin>>u[i]>>v[i];
        add(u[i],v[i]);add(v[i],u[i]);
    }
    for (int i=1;i<=n;++i){
        if (!dfn[i])tarjan(i,0);
    }
    for (int i=1;i<=m;++i){
        int x=p[u[i]],y=p[v[i]];
        if (x==y)continue;
        if (x<y)swap(x,y);
        st.insert(make_pair(x,y));
    }
    for (auto i:st){
        int x=i.first,y=i.second;
        g[x].push_back(y);
        g[y].push_back(x);
    }
    for (int i=1;i<=t;++i){
        if (!d[i]){
            dfs1(i,0);top[i]=i;dfs2(i);
        }
    }
    int Q;cin>>Q;
    while (Q--){
        int x,y;cin>>x>>y;
        x=p[x];y=p[y];
        int z=LCA(x,y);
        ++a[x];--a[z];
        ++b[y];--b[z];
    }
    for (int i=1;i<=t;++i){
        if (!f[i])dfs3(i,0);
    }
    for (int i=1;i<=m;++i){
        int x=p[u[i]],y=p[v[i]];
        if (x==y)cout<<'B';
        else if (f[x]==y){
            if (a[x])cout<<'R';
            else if (b[x])cout<<'L';
            else cout<<'B';
        }
        else{
            if (a[y])cout<<'L';
            else if (b[y])cout<<'R';
            else cout<<'B';
        }
    }
}
DP
镜寺
不会先咕着。
染色
link
很厉害的题目。体感 *2300。
我们考虑定义 \(f_i\) 表示在 \(i\) 这个位置,\(i\) 与前一位染不同颜色的最大分数。分析题目性质,因为颜色是相对的,所以此处可以嵌定 \(i\) 染上 \(0\) 色。如果 \(a_i\) 有贡献,显然存在一个 \(j\),使得形如:
j-1 j j+1 .... i-1 i
 0  1  1        1  0
因此枚举 \(j\),此时就可以得到一个暴力转移式:
\(f_j\) 为前面的贡献,\(\sum_{k=j+1}^{i-1}[a_k=a_{k-1}]a_k\) 是中间全部相同而产生的贡献,以及 \(i\) 自己的贡献 \([a_i=a_{j-1}]a_i\)。直接转移是 \(O(n^3)\) 的、
接着,显然的优化,我们记 \(b_i=[a_i=a_{i-1}]a_i\),然后对 \(b\) 做一个前缀和记为 \(s_i\),则原式可以化为:
这样转移是 \(O(n^2)\) 的,然后可以上一些经典技巧。
分离常数:
注意到 \(f_j\) 和 \(s_j\) 是相关的,记 \(p_j=f_j-s_j\)于是最值优化,记前面 \(p_j\) 的最大值为 \(mx\),原式化为:
艾弗森括号不好看,考虑分类讨论拆了,也就是说,两种转移:
- \(a_{j-1}=a_i\),有一个 \(mx\) 的贡献
- 不相等,直接就为 \(mx\)
再上一个最值优化,令 \(g_{a_i}=\max_{a_{j-1}=a_{i}} (p_j+a_i)\),则原式化为:
考虑 \(g\) 如何维护,每次更新完成后对 \(p_i+a_{i-1}\) 取 \(\max\) 即可,因为这里的 \(i\) 其实就是作为 \(g\) 定义的 \(j\) 取贡献未来的一个 \(i`\),然后 \(a_{i`}=a_{i-1}\),所以就是这个式子。
注意答案这里,由于我的状态定义是不相同颜色,如果相同颜色输出 \(f_n\) 就寄了,所以我们多整一位叫 \(n+1\) 即可。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=1e6+5;
int f[N],a[N],g[N],s[N];
void solve(){
    memset(f,0,sizeof f);
    memset(a,0,sizeof a);
    memset(s,0,sizeof s);
    memset(g,-0x3f,sizeof g);
    int n;cin>>n;
    for (int i=1;i<=n;++i)cin>>a[i];
    for (int i=1;i<=n;++i)s[i]=s[i-1]+(a[i]==a[i-1]?a[i]:0);
    int p=0;
    for (int i=2;i<=n+1;++i){
        f[i]=max(p,g[a[i]])+s[i-1];
        p=max(p,f[i]-s[i]);
        g[a[i-1]]=max(g[a[i-1]],f[i]-s[i]+a[i-1]);
    }
    cout<<f[n+1]<<'\n';
}
signed main(){
    int T;cin>>T;
    while (T--)solve();
}
冰火两重天
更厉害的题。体感 *2500。
考虑视作平面直角坐标系上的点,然后并令走冰过的为蓝点,火过的为红点。注意到一个性质,若一个点为蓝点,则其右下方也全部为蓝点,证明是简单的,反证法即可。相对的,若一个点是红点,则其左上方的所有点都为红点。那么也就是我们要找到一条轮廓线,右下方全部用冰过,左上方全部用火过。先排序,把所有点按照横坐标排序,然后考虑一个 DP,\(f_{j}\) 表示处理完前 \(i\) 个点,且所有已确定的蓝点中,最大的 \(y\) 坐标为 \(j\) 的最小花费。分类讨论处理:
- 若 \(j<y_{i}\),可以全分到红点中,此时 \(f_j=f_j+a_i\);也可以把当前的 \(j\) 拔高到 \(y_i\),也就是 \(f_{y_i}=min_{j<y_i}\{f_j\}+b_i\),当然不变也是可以的。
- 若 \(j>y_{i}\),只能分到蓝点,也就是 \(f_j=f_j+b_i\)。
发现这个东西可以线段树维护,区间加和取区间 \(\min\),于是做完了。对于每个新来的点,先取一下之前的 \(min_{j<y_i}f_j\),然后分别更新直接分点的情况,最后再单独处理拔高的情况即可。
#include<bits/stdc++.h>
#define int long long
#define lc(u) (2*u)
#define rc(u) (2*u+1)
using namespace std;
const int N=3e5+5;
const int INF=1e18;
int f[N];
struct node{
    int x,y,a,b;
}p[N];
bool cmp(node c,node d){
    return c.x<d.x;
}
struct SGT{
    int c[N*4],tag[N*4];
    void pushup(int u){
        c[u]=min(c[lc(u)],c[rc(u)]);
    }
    void build(int u,int l,int r){
        if (l==r){
            c[u]=(l==0?0:INF);
            return;
        }
        int mid=(l+r)/2;
        build(lc(u),l,mid);build(rc(u),mid+1,r);
        pushup(u);
    }
    void maketag(int u,int l,int r,int k){
        tag[u]+=k;
        c[u]+=k;
    }
    void pushdown(int u,int l,int r){
        int mid=(l+r)/2;
        maketag(lc(u),l,mid,tag[u]);
        maketag(rc(u),mid+1,r,tag[u]);
        tag[u]=0;
    }
    int query(int u,int l,int r,int ql,int qr){
        if (ql<=l&&r<=qr)return c[u];
        pushdown(u,l,r);
        int mid=(l+r)/2,ans=4e18;
        if (mid>=ql)ans=min(ans,query(lc(u),l,mid,ql,qr));
        if (mid<qr)ans=min(ans,query(rc(u),mid+1,r,ql,qr));
        return ans;
    }
    void modify(int u,int l,int r,int ql,int qr,int k){
        if (ql<=l&&r<=qr){
            maketag(u,l,r,k);
            return;
        }
        pushdown(u,l,r);
        int mid=(l+r)/2;
        if (mid>=ql)modify(lc(u),l,mid,ql,qr,k);
        if (mid<qr)modify(rc(u),mid+1,r,ql,qr,k);
        pushup(u);
    }
}sgt;
signed main(){
    int n;cin>>n;
    for (int i=1;i<=n;++i)cin>>p[i].x>>p[i].y>>p[i].a>>p[i].b;
    vector<int>v;
    for (int i=1;i<=n;++i)v.push_back(p[i].y);
    sort(v.begin(),v.end());
    v.erase(unique(v.begin(),v.end()),v.end());
    for (int i=1;i<=n;++i)p[i].y=lower_bound(v.begin(),v.end(),p[i].y)-v.begin()+1;
    sgt.build(1,0,n);
    sort(p+1,p+n+1,cmp);
    for (int i=1;i<=n;++i){
        int q=sgt.query(1,0,n,0,p[i].y-1);
        sgt.modify(1,0,n,0,p[i].y-1,p[i].a);
        sgt.modify(1,0,n,p[i].y,n,p[i].b);
        int q2=sgt.query(1,0,n,p[i].y,p[i].y);
        if (q+p[i].b<q2)sgt.modify(1,0,n,p[i].y,p[i].y,-q2+q+p[i].b);
    }
    cout<<sgt.query(1,0,n,0,n);
}
线性生物
常规题。感觉没有很 DP,偏数学啊。额蒟蒻独立做出来了所以体感 *1900。
我们先令 \(f_x=E_{x \to x+1}\),由期望线性性质易知,\(E_{1\to n+1}=\sum_{i=1}^n f_i\),考虑如何求 \(f_i\),令从 \(i\) 出发的有向边边集为 \(e_i\),先是一个显然的式子:
解释一下,前半段是直接走到 \(i+1\) 的期望步数,然后后半段是走返祖边的,首先选到这一条返祖边的概率为 \(\frac{1}{d_u+1}\),然后对于每一种情况,都是走到 \(i+1\),然后还有一步是 \(i \to v\) 这步。
显然可以化简,变成:
然后再考虑 \(E\) 的线性性质,看看概念,注意边界,发现就是
显然的前缀和优化,令前缀和数组为 \(s_i\),原式写为
发现我 \(s_i\) 是不知道的,\(s\) 不能出现 \(f_i\) 因为我还不知道,于是把他们都放到一起试试,再推推,先乘一下 \(d_i+1\)
正好 \(s_i\) 里有 \(f_i\),拿出来:
发现正好抵消!移项即可
直接转移即可。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=1e6+5;
const int mod=998244353;
vector<int>e[N];
int f[N],s[N],d[N];
signed main(){
    int id,n,m;cin>>id>>n>>m;
    for (int i=1;i<=m;++i){
        int u,v;cin>>u>>v;
        e[u].push_back(v);
        d[u]++;
    }
    for (int i=1;i<=n;++i){
        f[i]=d[i]+1;
        for (auto v:e[i])f[i]+=(s[i-1]%mod-s[v-1]%mod+mod)%mod;
        s[i]=s[i-1]+f[i];
        s[i]%=mod;
    }
    cout<<s[n]%mod;
}
中国象棋
是蒟蒻做不出的题。。最讨厌这种超级大分讨。体感 *2000。
心路历程大概是,哪道题先观察了一下,然后注意到每条横线和每条竖线的炮的个数都不改超过 \(3\) 个,然后就想到了我们要对于行一个取限制一个处理的时候顺手做好,顺势的一个 \(dp\),\(f_{i,j,k}\),前 \(i\) 行,\(j\) 列放了一个,\(k\) 列放了 \(2\) 的方案数。不放的转移显然,\(f_{i,j,k}=f_{i-1,j,k}\),接着发现是个分讨,做了一会就寄了不会了。。。遂查看题解。
第 \(i\) 行放一个炮:
- 放在有 \(0\) 个炮的列:
- 放在有 \(1\) 个炮的列:
第 \(i\) 行放两个炮:
- 都放在 \(0\) 列:
- 都放在 \(1\) 列:
- 一个放 \(0\) 列,一个放 \(1\) 列:
显然了,答案为 \(\sum_{j=0}^{m}\sum_{k=0}^{m-j} f_{n,j,k}\)。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int mod=9999973;
int f[105][105][105];
int C(int x){
    return x*(x-1)/2%mod;
}
signed main(){
    int n,m;cin>>n>>m;
    f[0][0][0]=1;
    for (int i=1;i<=n;++i){
        for (int j=0;j<=m;++j){
            for (int k=0;k<=m-j;++k){
                f[i][j][k]=f[i-1][j][k];
                if (j>=1)f[i][j][k]=(f[i][j][k]+f[i-1][j-1][k+1]*(k+1))%mod;
                if (k>=1)f[i][j][k]=(f[i][j][k]+f[i-1][j][k-1]*(m-j-k+1))%mod;
                if (j>=2)f[i][j][k]=(f[i][j][k]+f[i-1][j-2][k+2]*C(k+2))%mod;
                if (k>=2)f[i][j][k]=(f[i][j][k]+f[i-1][j][k-2]*C(m-j-k+2))%mod;
                if (j>=1&&k>=1)f[i][j][k]=(f[i][j][k]+f[i-1][j-1][k]*(k*(m-j-k+1)))%mod;
            }
        }
    }
    int ans=0;
    for (int j=0;j<=m;++j)for (int k=0;k<=m-j;++k)ans=(ans+f[n][j][k])%mod;
    cout<<ans;
}
快递服务
典典简单题。
考虑这个东西之和上一位有关,考虑记录上一位,则 \(f_{i,j,k,l}\) 表示处理完 \(a\) 的前 \(i\) 位,当前三个序列上一个值分别是 \(j,k,l\) 时的最小值,转移显然。然后有一个去除赘余状态的典,考虑 \(j,k,l\) 中必然有一个是 \(a_i\),所以我们定义 \(f_{i,j,k}\) 表示到 \(i\),剩下那位是 \(a_i\),\(j,k\) 是其余两位的方案数,转移显然,分讨把哪个设成 \(a_i\) 了即可,注意目标状态是 \(a_{i-1}\),因为相当于把原来那位替换到这里。时间复杂度 \(O(nm^2)\),空间滚一下,是 \(O(m^2+n)\) 的。
#include<bits/stdc++.h>
using namespace std;
const int M=205,N=1005;
int d[M][M],f[2][M][M],a[N];
int main(){
    int m;cin>>m;
    for (int i=1;i<=m;++i){
        for (int j=1;j<=m;++j)cin>>d[i][j];
    }
    int x,n=0;
    while (cin>>x){
        a[++n]=x;
    }
    a[0]=1;
    int ans=1e9;
    memset(f,0x3f3f3f,sizeof f);
    f[0][2][3]=0;
    for (int i=1;i<=n;++i){
        memset(f[i&1],0x3f3f3f,sizeof f[i&1]);
        for (int j=1;j<=m;++j){
            for (int k=1;k<=m;++k){
                f[i&1][j][k]=min(f[i&1][j][k],
                    f[(i-1)&1][j][k]+d[a[i-1]][a[i]]);
                f[i&1][a[i-1]][k]=min(f[i&1][a[i-1]][k],
                    f[(i-1)&1][j][k]+d[j][a[i]]);
                f[i&1][j][a[i-1]]=min(f[i&1][j][a[i-1]],
                    f[(i-1)&1][j][k]+d[k][a[i]]);
            }
        }
    }
    for (int j=1;j<=m;++j){
        for (int k=1;k<=m;++k)ans=min(ans,f[n&1][j][k]);
    }
    cout<<ans;
}
P6772 [NOI2020] 美食家
线性代数我喜欢你。经典好题。考虑最基本的 DP,\(f_{t,u}\) 表示第 \(t\) 天到了 \(u\) 的最大美味值,转移是显然的,注意到天数递增所以满足无后效性。考虑进一步优化这个 DP,有一个东西叫做广义矩阵乘法,也就是:
这个矩阵同样满足无后效性,继续考虑,我们可以维护一个 DP 值的向量,但是问题在于,边权不一样,也就是会从 \(f_{t,s} \to f_{t+w,s}\),很难通过若干次矩阵乘法刻画,我们考虑拆点,令 \((u,k)\) 表示还有多少天到 \(u\) 的状态,\(k \in [0,4]\),这样虽然点数变成了 \(5n\) 量级,但是可以转移了。考虑转移矩阵,由矩阵乘法的式子,不难发现这个矩阵刻画的应该是连通性,首先 \((u,k)\to (u,k-1)\) 的边,其中 \((u,1) \to (u,0)\) 会有 \(c_u\) 的边权,其余边权为 \(0\),第二种是原图上的边 \((u,v,w)\),建 \((u,0) \to (v,w-1)\) 的边即可,边权为 \(0\)。还有最后一个问题是如何处理美食节,我们可以考虑倍增,每次从 \(t_i\) 倍增到 \(t_{i+1}\),跳 \(t_{i+1}-t_{i}\) 步,然后在 \((x,0)\) 处加上 \(y\) 即可。
#include<bits/stdc++.h>
using namespace std;
const int N=255;
struct mar{
    long long a[N][N];
}A,g[31];
long long f[N],h[N];
int c[N],s;
int id(int v,int r){
    return 5*(v-1)+r;
}
mar mul(const mar &x,const mar &y){
    mar c;memset(c.a,-0x3f,sizeof c.a);
    for (int i=0;i<s;++i){
        for (int k=0;k<s;++k){
            if (x.a[i][k]<0)continue;
            for (int j=0;j<s;++j){
                if (y.a[k][j]<0)continue;
                c.a[i][j]=max(x.a[i][k]+y.a[k][j],c.a[i][j]);
            }
        }
    }
    return c;
}
void mul(const mar &x){
    memset(h,-0x3f,sizeof h);
    for (int i=0;i<s;++i){
        if (f[i]<0)continue;
        for (int j=0;j<s;++j){
            if (x.a[i][j]<0)continue;
            h[j]=max(h[j],f[i]+x.a[i][j]);
        }
    }
    memcpy(f,h,sizeof f);
}
struct jie{
    int t,x,y;
}p[N];
int t[N],x[N],y[N];
bool cmp(jie l,jie r){
    return l.t<r.t;
}
int main(){
    int n,m,T,k;cin>>n>>m>>T>>k;
    s=5*n;
    memset(A.a,-0x3f,sizeof A.a);
    for (int i=1;i<=n;++i)cin>>c[i];
    for (int v=1;v<=n;v++){
        A.a[id(v,4)][id(v,3)]=0;
        A.a[id(v,3)][id(v,2)]=0;
        A.a[id(v,2)][id(v,1)]=0;
        A.a[id(v,1)][id(v,0)]=c[v];
    }
    for (int i=1;i<=m;++i){
        int u,v,w;cin>>u>>v>>w;
        if (w==1){
            A.a[id(u,0)][id(v,0)]=max(A.a[id(u,0)][id(v,0)],(long long)c[v]);
        }
        else A.a[id(u,0)][id(v,w-1)]=max(A.a[id(u,0)][id(v,w-1)],0LL);
    }
    g[0]=A;
    memset(f,-0x3f,sizeof f);
    f[id(1,0)]=c[1];
    for (int i=1;i<=30;++i)g[i]=mul(g[i-1],g[i-1]);
    for (int i=1;i<=k;++i)cin>>p[i].t>>p[i].x>>p[i].y;
    sort(p+1,p+k+1,cmp);
    p[k+1].t=T;p[k+1].x=p[k+1].y=0;
    for (int i=1;i<=k+1;++i){
        int t=p[i].t-p[i-1].t,x=p[i].x,y=p[i].y;
        for (int j=0;j<=30;++j){
            if (t&(1<<j))mul(g[j]);
        }
        if (x)f[id(x,0)]+=y;
    }
    if (f[id(1,0)]<0)cout<<-1;
    else cout<<f[id(1,0)];
}
P11335 [NOISG 2020 Finals] Arcade
小清新捏。考虑两个按按钮的任务能够接上的条件,我们钦定 \(t_i>t_j\),\(|a_i-a_j| \le t_i-t_j\),然后套路的拆除绝对值,变成两个条件,\(a_i-a_j \le t_i-t_j\) 和 \(a_j-a_i \le t_i-t_j\),移项得到 \(a_i+t_i \le a_j+t_j\) 和 \(a_i-t_i \le a_j-t_j\),我们令 \(x_i=a_i+t_i,y_i=a_i-t_i\),那么就是有若干二元组,我们需要找到若干条连使得每条链内 \(x_{k_1}\le x_{k_2} \le \cdots\) 以及 \(y_{k_1} \le y_{k_2}\le \cdots\),两个东西不好刻画,我们考虑以 \(x\) 为第一关键字,\(y\) 为第二关键字排序,这样只需要统计 \(y\) 的最小链覆盖,考虑 Dilworth 定理,把这个不降的链覆盖转化成最长的严格递降子序列的长度,BIT 维护直接 DP 即可。注意有一些细节,要对 \(y\) 进行离散化,然后 BIT 只能查前缀所以要把 \(y\) 离散化的时候就取反,变成求严格递增的子序列即可。
#include<bits/stdc++.h>
#define lowbit(x) (-x&x)
using namespace std;
const int N=5e5+5;
int f[N],a[N],t[N];
struct node{
    int id,x,y;
}c[N];
int n,m;
bool cmp(node p,node q){
    if (q.x==p.x)return p.y<q.y;
    else return p.x<q.x;
}
int s[N];
void modify(int p,int x){
    for (int i=p;i<=m;i+=lowbit(i))s[i]=max(s[i],x);
}
int query(int p){
    int cnt=0;
    for (int i=p;i;i-=lowbit(i))cnt=max(cnt,s[i]);
    return cnt;
}
int main(){
    cin>>n>>m;
    for (int i=1;i<=m;++i)cin>>a[i];
    for (int i=1;i<=m;++i)cin>>t[i];
    for (int i=1;i<=m;++i){
        c[i].x=a[i]+t[i];
        c[i].y=a[i]-t[i];
        c[i].id=i;
        f[i]=c[i].y;
    }
    sort(c+1,c+m+1,cmp);
    sort(f+1,f+m+1);
    int k=unique(f+1,f+m+1)-f-1;
    for (int i=1;i<=m;++i){
        int p=k-(lower_bound(f+1,f+k+1,c[i].y)-f)+1;
        modify(p,query(p-1)+1);
    }
    cout<<query(m);
}
AT_abc400_g [ABC400G] Patisserie ABC 3
常规中带点厉害的题。这个题大概的想法是,先做一步转化,你配对这个东西可以转化成选出 \(2K\) 个 \(X_i,Y_i,Z_i\),并且每个的个数都是偶数,然后使它们的和最大,然后这个东西的正确性是,因为你转化前肯定是转化后答案的一个子集,然后并且你考虑转化前这个限制是更紧的,并且有这个限制肯定不劣于没有,所以这个转化就是对的。接着貌似就很典了,你考虑调整法,就是你先按照 \(\max(X_i,Y_i,Z_i)\) 排序拆掉这个东西,并取前 \(2K\) 位,发现唯一不满足的就是这个奇偶上的限制,考虑用后几个替换来调整,显然调整的个数不超过 \(3\) 个,那么我们分别对两部分进行 DP,然后合并即可,定义 \(f_{i,j,S}\) 表示前 \(i\) 位,选了 \(j\) 个,然后 \(S\) 维护的是三个东西选的奇偶性,转移显然,对于选和不选分别决策即可。\(g\) 就倒着处理,和 \(f\) 是对称的。最终答案就是 \(\max{f_{2K,j,S}+g_{2K+1,j,S}}\)。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=1e5+5;
const int INF=1e18;
static int f[N][4][15],g[N][4][15];
struct node{
    int b[4];
}a[N];
bool cmp(node p,node q){
    return max(max(p.b[0],p.b[1]),p.b[2])>max(max(q.b[0],q.b[1]),q.b[2]);
}
void solve(){
    int n,k;cin>>n>>k;
    k*=2;
    for (int i=1;i<=n;++i)cin>>a[i].b[0]>>a[i].b[1]>>a[i].b[2];
    sort(a+1,a+n+1,cmp);
	for (int i=0;i<=n+1;i++){
		for (int j=0;j<4;j++){
			for (int S=0;S<8;S++)
				f[i][j][S]=g[i][j][S]=-INF;
		}
	}
    f[0][0][0]=0;
    for (int i=1;i<=k;++i){
        for (int j=0;j<4;++j){
            for (int p=0;p<8;++p){
                for (int q=0;q<3;++q)
                f[i][j][p]=max(f[i-1][j][p^(1<<q)]+a[i].b[q],f[i][j][p]);
                if (j)f[i][j][p]=max(f[i-1][j-1][p],f[i][j][p]);
            }
        }
    }
    g[n+1][0][0]=0;
    for (int i=n;i>=k+1;--i){
        for (int j=0;j<4;++j){
            for (int p=0;p<8;++p){
                for (int q=0;q<3;++q){
                if (j)g[i][j][p]=max(g[i+1][j-1][p^(1<<q)]+a[i].b[q],g[i][j][p]);
                g[i][j][p]=max(g[i+1][j][p],g[i][j][p]);
                }
            }
        }
    }
    int ans=-INF;
    for (int j=0;j<4;++j){
        for (int p=0;p<8;++p)ans=max(ans,f[k][j][p]+g[k+1][j][p]);
    }
    cout<<ans<<'\n';
}
signed main(){
    cin.tie(nullptr)->ios::sync_with_stdio(0);
    int T;cin>>T;
    while (T--)solve();
}
P3473 [POI 2008] UCI-The Great Escape
[https://www.luogu.com.cn/problem/P3473]
神仙题。对第一篇题解做出了一些补充说明并说了一下自己的理解。
首先你考虑去刻画小偷走的过程,发现它必然是一个划分螺旋矩阵的过程,如图所示,借用了一下第一篇题解的图:

其中红色的是你走的路线,黑色是你划分出来的矩阵,并且我们发现,你总按照上,右,下,左的循环去走。
我们以此来考虑一个很神的 DP 状态,定义 \(f_{u,r,d,l,p}\) 表示你在矩形 \((u,l,d,r)\) 内,所有满足条件的路线数量,并且当前你沿着 \(p\) 方向运动,\(u,r,d,l\) 分别表示你当前在的这个矩形的上、右、左、下边界,\(p\) 就是你行走的状态,\(0\) 表示在向上走,\(1\) 表示在向右走,以此类推。继续考虑转移,我们用小矩阵去更新大矩形,以当前正在向上为例,也就是我们要找到一个高度去右拐,此时最左边的一列已经访问过了,所以要 \(l+1\),于是如果不考虑障碍物,转移式为 \(f_{u,r,d,l,0}=\sum_{k=u}^d f_{k,r,d,l+1,1}\),解图大概是这样的:
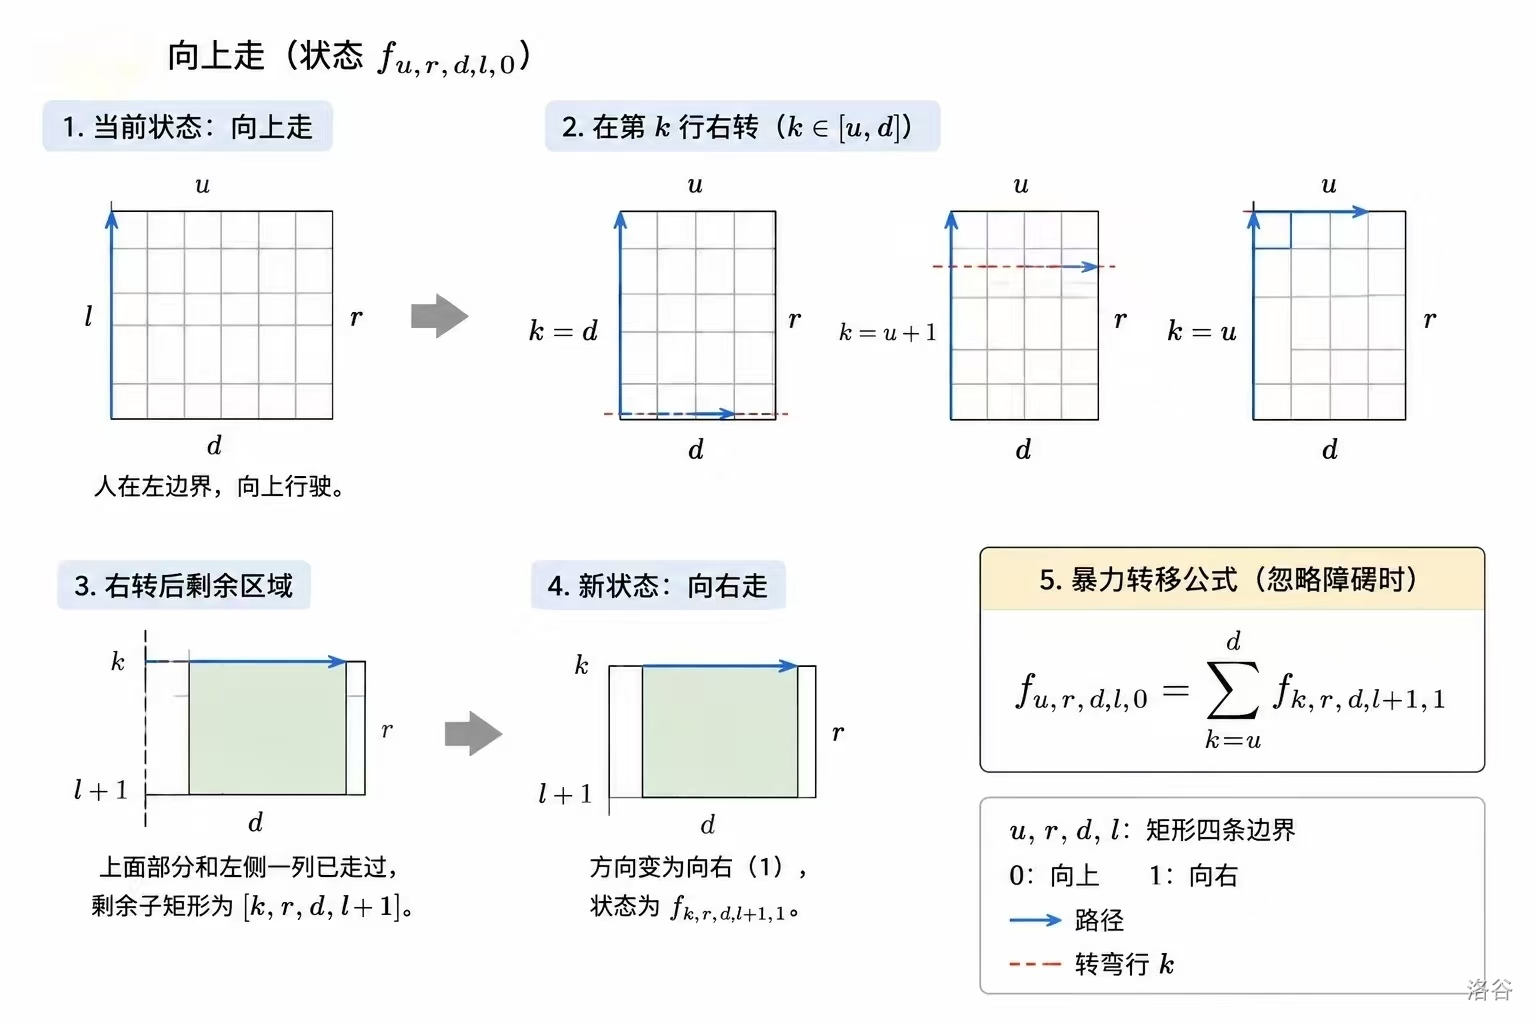
此时考虑障碍物的问题,我们记路径上是否有警察即为 \(check_u\),具体的,从当前位置走到转弯点的那条边上有没有障碍,维护是简单的随便前缀和可以求得,把 \(check\) 乘入 DP 转移即可。
然后剩下的转移式类似去考虑即可,加入障碍物也是简单的。接着就是要去优化这个 DP 了,我们把求和式拆一下,还是以向上为例,那么就可以拆成 \(f_{u,r,d,l+1,1}\times check_u+\sum_{k=u+1}^d (f_{u,r,d,l+1,1}\times check_k)\),后面那部分恰好是 \(f_{u+1,r,d,l+1,1}\),那么我们的转移就被优化到了 \(O(n^4)\)。此时再去考虑空间我问题,你注意到每一个来源状态的矩形大小都减少了 \(1\),也就是说当前层只依赖长度和宽度和少 \(1\) 的层,我们对长度和宽度的和做滚动数组即可。
#include<bits/stdc++.h>
using namespace std;
const int N=105;
int n,m,mod;
int x,y;
int s1[N][N];
int s2[N][N];
int f[2][N][N][N][4];
int main(){
    cin>>n>>m>>mod>>y>>x;
    for(int i=1;i<=n;i++){
        for(int j=1;j<=m;j++){
            char c;
            cin>>c;
            while(c!='+'&&c!='*')cin>>c;
            s1[i][j]=s1[i][j-1]+(c=='*');
            s2[i][j]=s2[i-1][j]+(c=='*');
        }
    }
    for(int s=2;s<=n+m;s++){
        int tmp=s&1;
        int last=tmp^1;
        for(int h=1;h<s;h++){
            int w=s-h;
            if(h>n||w>m)continue;
            for(int u=1;u+h-1<=n;u++){
                int d=u+h-1;
                for(int l=1;l+w-1<=m;l++){
                    int r=l+w-1;
                    if(d<x||r<y)continue;
                    f[tmp][u][l][d][0]=
                    (
                        f[last][u+1][l][d][0]
                        +
                        (s2[d][l]==s2[u-1][l])
                        *
                        (f[last][u][l+1][d][1]+(u==x&&l==y))
                    )%mod;
                    f[tmp][u][l][d][1]=
                    (
                        f[last][u][l][d][1]
                        +
                        (s1[u][r]==s1[u][l-1])
                        *
                        (f[last][u+1][l][d][2]+(u==x&&r==y))
                    )%mod;
                    f[tmp][u][l][d][2]=
                    (
                        f[last][u][l][d-1][2]
                        +
                        (s2[d][r]==s2[u-1][r])
                        *
                        (f[last][u][l][d][3]+(d==x&&r==y))
                    )%mod;
                    f[tmp][u][l][d][3]=
                    (
                        f[last][u][l+1][d][3]
                        +
                        (s1[d][r]==s1[d][l-1])
                        *
                        (f[last][u][l][d-1][0]+(d==x&&l==y))
                    )%mod;
                }
            }
        }
    }
    cout<<f[(n+m)&1][1][1][n][0];
}
CF1987F2
link
首先第一步,你肯定要考虑最基本的一个转化,如果我们把消除看成一对括号,容易发现,消除就是一个匹配括号的过程,然后就能够想到一种显然的区间 DP,就是你考虑 \(f_{l,r}\) 表示 \([l,r]\) 能不能都删掉,然后发现你能不能删主要是和前面你删了几个强相关的,\(f_{l,r,x}\) 表示你 \([l,r]\) 能不能都删,然后前面删了 \(x\) 个,发现你是过不了的,此时上一个经典套路,就是你把可达性变成最优性问题,这样可以消了,对于这道题:我们真正关心的不是前面删了多少以后,它能不能删,而是要让它删完,前面最少需要删多少。那么定义 \(f_{l,r}\) 表示把区间 \([l,r]\) 完全删除,至少需要在它左边删除多少个元素。那么转移你可以分类讨论,就是考虑:
- 外面套一个,你考虑其实就是删掉 \([l+1,r-1]\),然后删
\(l\),那么合法性就是判断里面是否可以删,以及 \(l\) 能否最后删掉,这个是简单的,需要注意如果 \([l,r]\) 长度等于 \(2\) 是天然成立的。具体转移就是 \(f_{l,r}=f_{l+1,r-1}+\frac{l-a_l}{2}\)。 - 两个拼起来,你就去枚举中间的连接点,你枚举一个 \([l,k]\) 和 \([k+1,r]\),考虑一下都有什么东西和这个相关,一个就是外层左括号的要求必须满足,所以和 \(\frac{l-a_l}{2}\) 有关,然后就是还有 \(f_{l,k}\) 这个是显然的,右半区间咋考虑?你考虑先删除左边,就会有一个 \(\frac{k-l+1}{2}\) 的贡献,所以要把它减去。然后这种的转移是三者取 \(\max\),原因是你考虑三种是并行的,你必须同时满足。
接着你考虑你会了 \(f\),怎么求出最终答案,这是一个很简单的线性 DP,我们定义 \(g_{i}\) 表示前 \(i\) 个元素最多被删多少次,分讨删不删 \(x\) 即可,即一种就直接 \(g_i=g_{i-1}\),另一种枚举最后一个删除段就行了,记得判一下删除次数够不够。
数学
NOIP R6 T4
link
感觉很困难,数学太差了花费了亿点点时间攻克。。。
令 \([l,r]\) 里 \(x\) 的个数为 \(k\),然后可以先考虑 \(k=0\) 时,此时如何重排其实对答案式没有影响的,就是区间重排数乘上原本的不含 \(x\) 的对数,后者显然可以预处理,记为 \(G_x\),前者记为 \(R\),记区间内颜色 \(c\) 出现次数为 \(f_c\),然后显而易见的,有:
记分母为 \(W\),\(r-l+1=m\),也就变成:
接着考虑 \(k \ge 1\) 的情况,答案可以拆成受影响的贡献+不受影响的贡献,后者可以写作 \(R(G_x-O)\),其中 \(O\) 是我要扣掉的一部分受影响的对数,具体的,我令 \([l,r]\) 左边最近的值为 \(x\) 的位置为 \(p\),右边类似为 \(q\),那么此时扣掉 \(p\) 到 \(q\) 之间的值即可,可以用前缀和维护。
我们考虑一下受影响的部分,这是本题的 hardest。我们继续拆解问题,可以拆成嵌定 \(x\) 位置的方案数乘上剩下数的排法的方案数,也就是 \(H=\frac{(m-k)!}{\prod_{c\neq x}f_c}\),我想用 \(W\) 表示,那么也就是 \(H=(m-k)!Wk!\)。
现在的问题就是求解嵌定 \(k\) 个 \(x\) 的方案,分类讨论,首先是完全位于区间内的贡献,考虑枚举区间长度 \(t\),则总贡献为 \(\sum_{t=1}^{m-k} (m-t+1)\binom{m-t}{k}\),应用上指标求和,令 \(s=m-t\),则原式化为 \(\sum_{s=k}^{m-1} (s+1)\binom{s}{k}\),然后把这个组合式拆开成阶乘的形式,少加整理可以得到,\(\sum_{s=k}^{m-1} (k+1)\binom{s+1}{k+1}\),把 \((k+1)\) 提出来,专门查了一下这个貌似叫冰球棍恒等式,可以把原式化为 \((k+1)\binom{m+1}{k+2}\)。第二种情况,中间随便选,这个区间都在两边,那么也就是 \([p,l-1]\) 和 \([r+1,q]\) 任选的和再乘上中间长度选 \(k\) 个的方案数即可(因为我只钦定了 \(k\) 个所以不是 \(m!\))。最后一部分就是左端点在 \([p,l-1]\) 右端点在 \([l,r]\),(右端点在 \([r+1,q]\) 的情况对称不赘述),左端点情况数是简单的,考虑右端点,其实是和第一个一样的,枚举在 \([l,r]\) 内的长度写出来一个求和式,然后也是上指标求和可以做出来,令 \([p,l-1]\) 长度为 \(A\),\([r+1,q]\) 长度为 \(B\),则这一部分的答案为 \((A+B)\binom{m}{k+1}\)。那么钦定 \(k\) 个 \(x\) 的方案即为:
其中 \(F(t) = \dfrac{t(t+1)}{2}\)
至此,这道题的推导完成了,答案式子即为 \(R(G_x-O)+HT\),发现需要维护的只有 \(W\),用个莫队就可以维护。
代码回头再补,想了一晚上要爆炸了。。。
[HAOI2010] 计数
?!数数?!
蒟蒻只会若只做法。考虑 \(0\) 的数量不好处理,来分类讨论:
- 当 \(0\) 的数量比原数小时,可以任意排列,数量显然,然后考虑要容斥掉开头为 \(0\) 的方案数,也是显然的。
- 考虑原数的重排用一个类似康拓展开的思路,也就是枚举每一位,然后表示前面都和原数相同,仅有这一位不同,后面任意重排,方案数显然,记得枚举这一位计算的时候不能统计它的贡献。
注意这里需要一点人类智慧,因为你要处理某个东西分之一,没有取模不能逆元,考虑上个 __int128,然后设置一个超级大的模数即可。
#include<bits/stdc++.h>
#define int __int128
using namespace std;
inline int read(){
	int x=0,f=1;
	char ch=getchar_unlocked();
	while (!isdigit(ch)){
		if (ch=='-')
			f=-1;
		ch=getchar_unlocked();
	}
	while (isdigit(ch)){
		x=(x<<1)+(x<<3)+(ch^48);
		ch=getchar_unlocked();
	}
	return x*f;
}
inline void write(int x){
	if (x<0)putchar('-'),x=-x;
	if (x>9)write(x/10);
	putchar(x%10+'0');
}
const int mod=9223372036854775837;
int qpow(int x,int y){
    int res=1;
    while(y){
        if(y&1)res=res*x%mod;
        x=x*x%mod;
        y>>=1;
    }
    return res%mod;
}
int f[2000005],g[200005];
void init(){
    f[0]=1;
    for(int i=1;i<=200000;i++)f[i]=f[i-1]*i%mod;
    g[200000]=qpow(f[200000],mod-2);
    for(int i=200000-1;i>=0;i--)g[i]=g[i+1]*(i+1)%mod;
}
int a[55],b[10];
signed main(){
    string s;cin>>s;int n=s.length();
    init();
    for (int i=1;i<=n;++i){a[i]=s[i-1]-'0';b[a[i]]++;}
    int ans=0;
    int c=1;
    for (int j=1;j<=9;++j)c=c*g[b[j]]%mod;
    for (int k=0;k<b[0];++k){
        int len=n-b[0]+k;
        if (!len)continue;
        int cnt=f[len]*c%mod*g[k]%mod;
        if(k){
            cnt=(cnt-f[len-1]*c%mod*g[k-1]%mod+mod)%mod;
        }
        ans=(ans+cnt)%mod;
    }
    for (int i=1;i<=n;++i){
        for (int d=(i==1?1:0);d<a[i];++d){
            if (b[d]){
                b[d]--;
                int cnt=f[n-i];
                for (int j=0;j<=9;++j)cnt=cnt*g[b[j]]%mod;
                ans=(ans+cnt)%mod;
                b[d]++;
            }
        }
        b[a[i]]--;
    }
    write(ans);
}
CF1228E
难绷貌似是推的很复杂的一种。称行最小值为 \(l_i\),列最小值为 \(r_j\),考虑把这个限制写出来:
容斥掉:
带公式:
经典变换,变成枚举 \(|S|\) 和 \(|P|\):
常数提取出来:
接下来只需要计算最后这个东西:
这里的“某一行满足 \(\ge2\)”其实就是这一行的所有数都不能填 \(1\),列同理。
假设我们已经选定了这 \(i\) 行和 \(j\) 列。
这 \(i\) 行覆盖了 \(in\) 个格子,\(j\) 列覆盖了 \(jn\) 个格子,但是行列交叉的 \(ij\) 个格子被算了两遍,所以一共有
个格子必须填 \(2\sim k\),每个位置都有 \(k-1\) 种选择。
剩下的格子数量就是
也可以直接看成没有被这些行和列覆盖的矩形:
这些位置没有任何限制,可以随便填 \(1\sim k\),每个位置有 \(k\) 种选择。
因此:
代回去:
于是题目就做完了。因为我是懒蛋,所以直接递推了组合数。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=255,mod=1e9+7;
int qpow(int a,int b){
    int res=1;
    a%=mod;
    while(b){
        if(b&1)res=res*a%mod;
        a=a*a%mod;
        b>>=1;
    }
    return res;
}
int c[N][N];
void init(){
    for (int i=0;i<N;++i){
        c[i][0]=1;
        for (int j=1;j<=i;++j) {
            c[i][j]=c[i-1][j]%mod+c[i-1][j-1]%mod;
            c[i][j]%=mod;
        }
    }
}
signed main(){
    init();
    int n,k;cin>>n>>k;
    int ans=0;
    for (int i=0;i<=n;++i){
        for (int j=0;j<=n;++j){
            ans+=((((i+j)%2==0?1:-1)*c[n][i]%mod*c[n][j]%mod*qpow(k-1,n*(i+j)-i*j)%mod*qpow(k,(n-i)*(n-j))%mod)%mod+mod)%mod;
            ans%=mod;
        }
    }
    cout<<ans%mod;
}
P6570 [NOI Online #3 提高组] 优秀子序列
link
首先这个欧拉函数你可以拆贡献拆掉,线筛最后乘上就可以。我们考虑统计和为 \(i\) 为子序列个数,记为 \(f_i\),然后注意到你所有的按位与都等于 \(0\),等价于每个一个二进制位都只被一个数占有,也就是它们的和在二进制上去刻画是唯一的,于是我这样 DP 是很有道理的。考虑去转移,对于一个 \(x\),现在考虑把数值为 \(x\) 的这个元素加入到已有的子序列中,我们枚举它补集的子集 \(s\),转移刷表,因为我任选一个 \(x\) 都可以去用,记 \(x\) 出现了 \(c_x\) 次,有:
可以理解成,我到 \(x|s\) 在 \(f_s\) 的基础上加上一个 \(x\)。那么这个题就做完了,时间复杂度应该是 \(O(3^{18})\) 次方的,然后应该存在一种 \(O(2^nn^2)\) 的做法但是我不会,还是冲到了最优解前几名,可能是你考虑转移时把没有的跳过补转移,并且不手懒用 \(18\) 而是找最大值。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=(1<<18)+5;
int c[N],f[N];
const int mod=1e9+7;
bool ok[N];
int phi[N];
vector<int>p;
void shai(){
    phi[1]=1;
    for (int i=2;i<N;++i){
        if (!ok[i]){
            phi[i]=i-1;
            p.push_back(i);
        }
        for (auto j:p){
            if (i*j>=N)break;
            ok[i*j]=1;
            if (i%j==0){
                phi[i*j]=phi[i]*j;
                break;
            }
            else phi[i*j]=phi[i]*phi[j];
        }
    }
}
signed main(){
    ios::sync_with_stdio(0);cin.tie(0);
    int n;cin>>n;
    shai();
    int mx=0;
    for (int i=1;i<=n;++i){
        int x;cin>>x;
        c[x]++;
        mx=max(mx,x);
    }
    int pw=1;
    for (int i=1;i<=c[0];++i) pw=pw*2%mod;
    int lim=1;
    while(lim<=mx)lim<<=1;
    f[0]=1;
    for (int x=1;x<lim;++x){
        if (!c[x]) continue;
        int b=(lim-1)^x;
        for (int s=b;;s=(s-1)&b){
            f[s|x]=(f[s|x]+f[s]*c[x])%mod;
            if (!s) break;
        }
    }
    int ans=0;
    for (int i=0;i<lim;++i)ans=(ans+f[i]*phi[1+i])%mod;
    ans=ans*pw%mod;
    cout<<ans;
}
基础算法
P6902 [ICPC 2014 WF] Surveillance
小萌新炸了。显然的,断环为链,复制一遍,然后考虑链上怎么做,如果你当前决策到 \(x\),那么你就一定会找到最靠右的 \(y\),能够覆盖 \(x\) 的区间,然后使得 \(x->y+1\),这样显然是最优的,考虑到这个路径唯一,所以可以倍增,你先考虑预处理第一步,我们对称的找最靠左的 \(x\) 即可,用一个类似扫描线的东西弄过去就可以了。最后枚举右端点,跳 \(\ge n\) 步即可,时间复杂度是一只 \(\log\),然后细节很多需要注意一下。
#include<bits/stdc++.h>
#define lowbit(x) (-x&x)
using namespace std;
const int N=2e6+5;
int l[N],r[N],f[N][25];
int c[N],n,k;
void modify(int p,int x){
    for (int i=2*n-p+1;i<=2*n;i+=lowbit(i))c[i]=min(c[i],x);
}
int query(int p){
    int cnt=2*n+1;
    for (int i=2*n-p+1;i;i-=lowbit(i))cnt=min(cnt,c[i]);
    return cnt==2*n+1?0:cnt;
}
vector<int>g[N];
int main(){
    cin>>n>>k;
    for (int i=0;i<=2*n;i++)c[i]=2*n+1;
    for (int i=1;i<=k;++i){
        cin>>l[i]>>r[i];
        if (l[i]>r[i])r[i]+=n;
        g[r[i]].push_back(l[i]);
        if (r[i]+n<=2*n)g[r[i]+n].push_back(l[i]+n);
    }
    for (int r=2*n;r>=1;--r){
        for (auto l:g[r])modify(r,l);
        f[r+1][0]=query(r);
    }
    for (int j=1;j<=20;++j)
        for (int r=2*n+1;r>=1;--r){
            f[r][j]=f[f[r][j-1]][j-1];
        }
    int ans=k+1;
    for (int r=n;r<=2*n;++r){
        int x=r+1,cnt=0;
        for (int j=20;j>=0;--j){
            if (f[x][j]&&r-f[x][j]+1<n){
                x=f[x][j];
                cnt+=(1<<j);
            }
        }
        if (f[x][0]&&r-f[x][0]+1>=n)ans=min(cnt+1,ans);
    }
    if (ans==k+1)cout<<"impossible";
    else cout<<ans;
}
P16902 [CCO 2026] Melborp
这个基本思路是不是典。你考虑极值,你发现最大值是一种单峰式的结构,如果是排列你可以直接建树,当成不断的删除叶子去做,但是重复值根本没办法处理,然后考虑最小值,容易发现这个最小值的条件就是 \(B_{i}=i(N-i+1)\),然后典的你考虑这个最小值将序列划分成若干部分,所以分治。假设当前考虑到 \([l,r]\) 找出所有 \(B_{i}=(i-l+1)(r-i+1)\) 的,然后向下分治,一种好写的方法是维护层数,然后如果 \(B_i>(i-l+1)(r-i+1)\) 说明它不是这一层的,赋值为上一层即可,容易得到每个相等的最多在下一层就会被处理,然后一个细节是如果是上一层的维护层数记得不能加一。考虑这样的时间复杂度,你每一层都是 \(O(n)\) 扫描,如果最小值的位置递增,你会被卡成 \(1+2+3+\cdots+n=\frac{n(n+1)}{2}\),\(O(n^2)\) 就死了。看了一下吃瓜喵的题解发现这里可以用一种很妙的东西,类似启发式分裂,你用双指针从两边同时去找,这个题就可以过了。
#include<bits/stdc++.h>
#define re register
#define int long long
using namespace std;
const int N=5e6+5;
static long long b[N];
static int a[N];
void solve(re int l,re int r,re int k){
    if (l>r)return;
    int s=l,t=r;
    while (s<=t){
        int i=s;
        if (b[i]>(i-l+1)*(r-i+1)){
            a[i]=k-1;
            solve(l,i-1,k);
            solve(i+1,r,k);
            return;
        }
        else if (b[i]==(i-l+1)*(r-i+1)){
            a[i]=k;
            solve(l,i-1,k+1);
            solve(i+1,r,k+1);
            return;
        }
        s++;
        i=t;
        if (b[i]>(i-l+1)*(r-i+1)){
            a[i]=k-1;
            solve(l,i-1,k);
            solve(i+1,r,k);
            return;
        }
        else if (b[i]==(i-l+1)*(r-i+1)){
            a[i]=k;
            solve(l,i-1,k+1);
            solve(i+1,r,k+1);
            return;
        }
        t--;
    }
}
signed main(){
    cin.tie(nullptr)->ios::sync_with_stdio(0);
    int n;cin>>n;
    for (int i=1;i<=n;++i)cin>>b[i];
    solve(1,n,1);
    for (int i=1;i<=n;++i)cout<<a[i]<<" ";
}

 浙公网安备 33010602011771号