
结合中断上下文切换和进程上下文切换分析Linux内核的一般执行过程
实验要求
结合中断上下文切换和进程上下文切换分析Linux内核一般执行过程
- 以fork和execve系统调用为例分析中断上下文的切换
- 分析execve系统调用中断上下文的特殊之处
- 分析fork子进程启动执行时进程上下文的特殊之处
- 以系统调用作为特殊的中断,结合中断上下文切换和进程上下文切换分析Linux系统的一般执行过程
并完成一篇博客总结分析Linux系统的一般执行过程,以期对Linux系统的整体运作形成一套逻辑自洽的模型
实验过程
一、以fork系统调用为例分析中断上下文的切换
fork()函数又叫计算机程序设计中的分叉函数,fork是一个很有意思的函数,它可以建立一个新进程,把当前的进程分为父进程和子进程,新进程称为子进程,而原进程称为父进程。fork调用一次,返回两次,这两个返回分别带回它们各自的返回值,其中在父进程中的返回值是子进程的PID,而子进程中的返回值则返回 0。因此,可以通过返回值来判定该进程是父进程还是子进程。还有一个很奇妙的是:fork函数将运行着的程序分成2个(几乎)完全一样的进程,每个进程都启动一个从代码的同一位置开始执行的线程。这两个进程中的线程继续执行,就像是两个用户同时启动了该应用程序的两个副本。
fork系统调用用于从已存在进程中创建一个新进程,新进程称为子进程,而原进程称为父进程。fork调用一次,返回两次,这两个返回分别带回它们各自的返回值,其中在父进程中的返回值是子进程的进程号,而子进程中的返回值则返回 0。因此,可以通过返回值来判定该进程是父进程还是子进程。使用fork函数得到的子进程是父进程的一个复制品,它从父进程处继承了整个进程的地址空间,包括进程上下文、进程堆栈、内存信息、打开的文件描述符、信号控制设定、进程优先级、进程组号、当前工作目录、根目录、资源限制、控制终端等,而子进程所独有的只有它的进程号、计时器等。因此可以看出,使用fork系统调用的代价是很大的,它复制了父进程中的数据段和堆栈段里的绝大部分内容,使得fork系统调用的执行速度并不很快。
do_fork的代码如下
long do_fork(unsigned long clone_flags,
          unsigned long stack_start,
          unsigned long stack_size,
          int __user *parent_tidptr,
          int __user *child_tidptr)
{
    struct task_struct *p;
    int trace = 0;
    long nr;

    // ...

    // 复制进程描述符,返回创建的task_struct的指针
    p = copy_process(clone_flags, stack_start, stack_size,
             child_tidptr, NULL, trace);

    if (!IS_ERR(p)) {
        struct completion vfork;
        struct pid *pid;

        trace_sched_process_fork(current, p);

        // 取出task结构体内的pid
        pid = get_task_pid(p, PIDTYPE_PID);
        nr = pid_vnr(pid);

        if (clone_flags & CLONE_PARENT_SETTID)
            put_user(nr, parent_tidptr);

        // 如果使用的是vfork,那么必须采用某种完成机制,确保父进程后运行
        if (clone_flags & CLONE_VFORK) {
            p->vfork_done = &vfork;
            init_completion(&vfork);
            get_task_struct(p);
        }

        // 将子进程添加到调度器的队列,使得子进程有机会获得CPU
        wake_up_new_task(p);

        // ...

        // 如果设置了 CLONE_VFORK 则将父进程插入等待队列,并挂起父进程直到子进程释放自己的内存空间
        // 保证子进程优先于父进程运行
        if (clone_flags & CLONE_VFORK) {
            if (!wait_for_vfork_done(p, &vfork))
                ptrace_event_pid(PTRACE_EVENT_VFORK_DONE, pid);
        }

        put_pid(pid);
    } else {
        nr = PTR_ERR(p);
    }
    return nr;
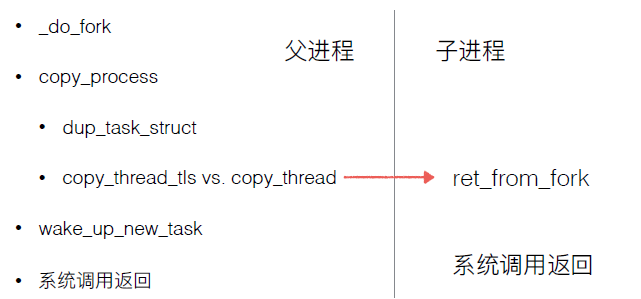
_do_fork函数主要完成了调用copy_process复制父进程、获得pid、调用wake_up_new_task将子进程加入就绪队列等待调度执行等。我们知道,在Linux中,除了0号进程由手工创建外,其他进程都是通过复制已有进程创建而来,而这正是fork的主要工作,具体的任务交由copy_process完成。
copy_process函数主要完成了调用dup_task_struct复制当前进程(父进程)描述符task_struct、信息检查、初始化、把进程状态设置为TASK_RUNNING(此时⼦进程置为就绪态)、采⽤写时复制技术逐⼀复制所有其他进程资源、调⽤copy_thread_tls初始化子进程内核栈、设置子进程pid等。其中copy_thread_tls所做的工作是关键。我们知道执行fork系统调用之后,会由内核态返回两次:一次返回到父进程,这与一般的系统调用返回流程别无二致;而另一次则返回到子进程,为了实现这一点,就需要为子进程构造出合适的执行上下文,也就是初始化其内核栈和进程描述符的thread字段。这正是copy_thread_tls的任务。
⽗进程通过fork系统调⽤进⼊内核_do_fork函数,复制进程描述符及相关进程资源(采⽤写时复制技术)、分配⼦进程的内核堆栈并对内核堆栈和thread等进程关键上下⽂进⾏初始化,最后将⼦进程放⼊就绪队列,fork系统调⽤返回;⽽⼦进程则在被调度执⾏时根据设置的内核堆栈和thread等进程关键上下⽂开始执⾏。
特殊之处:
fork在陷⼊内核态之后有两次返回,第⼀次返回到原来的⽗进程的位置继续执⾏,但是在⼦进程中fork也返回了⼀次,会返回到⼀个特 定的点——ret_from_fork,所以它可以正常系统调⽤返回到⽤户态。
二、以execve系统系统调用为例分析中断上下文的切换
execve() 系统调用通常与 fork() 系统调用配合使用。从一个进程中启动另一个程序时,通常是先 fork() 一个子进程,然后在子进程中使用 execve() 变身为运行指定程序的进程。 例如,当用户在 Shell 下输入一条命令启动指定程序时,Shell 就是先 fork() 了自身进程,然后在子进程中使用 execve() 来运行指定的程序。
execve() 系统调用的函数原型为:
int execve(const char *filename, char *const argv[], char *const envp[]);filename 用于指定要运行的程序的文件名,argv 和 envp 分别指定程序的运行参数和环境变量。除此之外,该系列函数还有很多变体,它们执行大体相同的功能,区别在于需要的参数不同,包括 execl、execlp、execle、execv、execvp、execvpe 等。它们的参数意义和使用方法请读者自行查看帮助手册。
execve系统调用的过程总结如下:
-
execve系统调用陷入内核,并传入命令行参数和shell上下文环境
-
execve陷入内核的第一个函数:do_execve,该函数封装命令行参数和shell上下文
-
do_execve调用do_execveat_common,后者进一步调用__do_execve_file,打开ELF文件并把所有的信息一股脑的装入linux_binprm结构体
-
__do_execve_file中调用search_binary_handler,寻找解析ELF文件的函数
-
search_binary_handler找到ELF文件解析函数load_elf_binary
-
load_elf_binary解析ELF文件,把ELF文件装入内存,修改进程的用户态堆栈(主要是把命令行参数和shell上下文加入到用户态堆栈),修改进程的数据段代码段
-
load_elf_binary调用start_thread修改进程内核堆栈(特别是内核堆栈的ip指针)
-
进程从execve返回到用户态后ip指向ELF文件的main函数地址,用户态堆栈中包含了命令行参数和shell上下文环境
execve系统调用代码
int do_execve(char * filename, char __user *__user *argv,
        char __user *__user *envp,     struct pt_regs * regs)
{
    struct linux_binprm *bprm;        // 保存和要执行的文件相关的数据
    struct file *file;
    int retval;
    int i;
    retval = -ENOMEM;
    bprm = kzalloc(sizeof(*bprm), GFP_KERNEL);
    if (!bprm)
        goto out_ret;
    // 打开要执行的文件,并检查其有效性(这里的检查并不完备)
    file = open_exec(filename);
    retval = PTR_ERR(file);
    if (IS_ERR(file))
        goto out_kfree;
    // 在多处理器系统中才执行,用以分配负载最低的CPU来执行新程序
    // 该函数在include/linux/sched.h文件中被定义如下:
    // #ifdef CONFIG_SMP
    // extern void sched_exec(void);
    // #else
    // #define sched_exec() {}
    // #endif
    sched_exec();
    // 填充linux_binprm结构
    bprm->p = PAGE_SIZE*MAX_ARG_PAGES-sizeof(void *);
    bprm->file = file;
    bprm->filename = filename;
    bprm->interp = filename;
    bprm->mm = mm_alloc();
    retval = -ENOMEM;
    if (!bprm->mm)
        goto out_file;
    // 检查当前进程是否在使用LDT,如果是则给新进程分配一个LDT
    retval = init_new_context(current, bprm->mm);
    if (retval  0)
        goto out_mm;
    // 继续填充linux_binprm结构
    bprm->argc = count(argv, bprm->p / sizeof(void *));
    if ((retval = bprm->argc)  0)
        goto out_mm;
    bprm->envc = count(envp, bprm->p / sizeof(void *));
    if ((retval = bprm->envc)  0)
        goto out_mm;
    retval = security_bprm_alloc(bprm);
    if (retval)
        goto out;
    // 检查文件是否可以被执行,填充linux_binprm结构中的e_uid和e_gid项
    // 使用可执行文件的前128个字节来填充linux_binprm结构中的buf项
    retval = prepare_binprm(bprm);
    if (retval  0)
        goto out;
    // 将文件名、环境变量和命令行参数拷贝到新分配的页面中
    retval = copy_strings_kernel(1, &bprm->filename, bprm);
    if (retval  0)
        goto out;
    bprm->exec = bprm->p;
    retval = copy_strings(bprm->envc, envp, bprm);
    if (retval  0)
        goto out;
    retval = copy_strings(bprm->argc, argv, bprm);
    if (retval  0)
        goto out;
    // 查询能够处理该可执行文件格式的处理函数,并调用相应的load_library方法进行处理
    retval = search_binary_handler(bprm,regs);
    if (retval >= 0) {
        free_arg_pages(bprm);
        // 执行成功
        security_bprm_free(bprm);
        acct_update_integrals(current);
        kfree(bprm);
        return retval;
    }
out:
    // 发生错误,返回inode,并释放资源
    for (i = 0 ; i  MAX_ARG_PAGES ; i++) {
        struct page * page = bprm->page;
        if (page)
            __free_page(page);
    }
    if (bprm->security)
        security_bprm_free(bprm);
out_mm:
    if (bprm->mm)
        mmdrop(bprm->mm);
out_file:
    if (bprm->file) {
        allow_write_access(bprm->file);
        fput(bprm->file);
    }
out_kfree:
    kfree(bprm);
out_ret:
    return retval;
}
do_execve中将加载可执⾏⽂件,把当前进程的可执⾏程序给覆盖掉。当execve系统调⽤返回时,返回的已经不是原来的那个可执⾏程序了,⽽是新的可执⾏程序。execve返回的是新的可执⾏ 程序执⾏的起点,静态链接的可执⾏⽂件也就是main函数的⼤致位置,动态链接的可执⾏⽂件还需 要ld链接好动态链接库再从main函数开始执⾏。
特殊之处:
当execve在调用时陷入内核态,就执行do_execve文件,覆盖当前的可执行程序,所以 返回的是新的可执行程序的起点。main函数位置是静态链接的可执行文件,动态链接的可执行文件需要连接动态链接库后在开始执行。
三、Linux系统的一般执行过程
最一般的情况:正在运行的用户态进程X切换到运行用户态进程Y的过程
(1)正在运行的用户态进程X
(2)发生中断——save cs:eip/esp/eflags(current) to kernel stack,then load cs:eip(entry of a specific ISR) and ss:esp(point to kernel stack).
(3)SAVE_ALL //保存现场
(4)中断处理过程中或中断返回前调用了schedule(),其中的switch_to做了关键的进程上下文切换
(5)标号1之后开始运行用户态进程Y(这里Y曾经通过以上步骤被切换出去过因此可以从标号1继续执行)
(6)restore_all //恢复现场
(7)iret - pop cs:eip/ss:esp/eflags from kernel stack
(8)继续运行用户态进程Y
Linux系统执行过程中的几个特殊情况
(1)通过中断处理过程中的调度时机,用户态进程与内核线程之间互相切换和内核线程之间互相切换,与最一般的情况类似,只是内核线程运行过程中发生中断没有进程用户态和内核态的转换;
(2)内核线程主动调用schedule(),只有进程上下文的切换,没有发生中断上下文的切换,与最一般的情况略简略;
(3)创建子进程的系统调用在子进程中的执行起点及返回用户态,如fork;
(4)加载一个新的可执行程序后返回到用户态的情况,如execve;

 浙公网安备 33010602011771号