
复杂科研问题,为什么需要把检索拆成专家模式
普通关键词检索适合明确问题,比如找某个疾病、某个模型、某个指标。复杂科研问题麻烦在限定条件多:时间范围、研究对象、任务类型、论文类型、评价方式,经常混在一句自然语言里。
这时让 AI 直接生成报告,风险不在“写得不好”,而在候选文献池一开始就偏了。报告越顺,越容易掩盖漏检、误召回和来源不清。
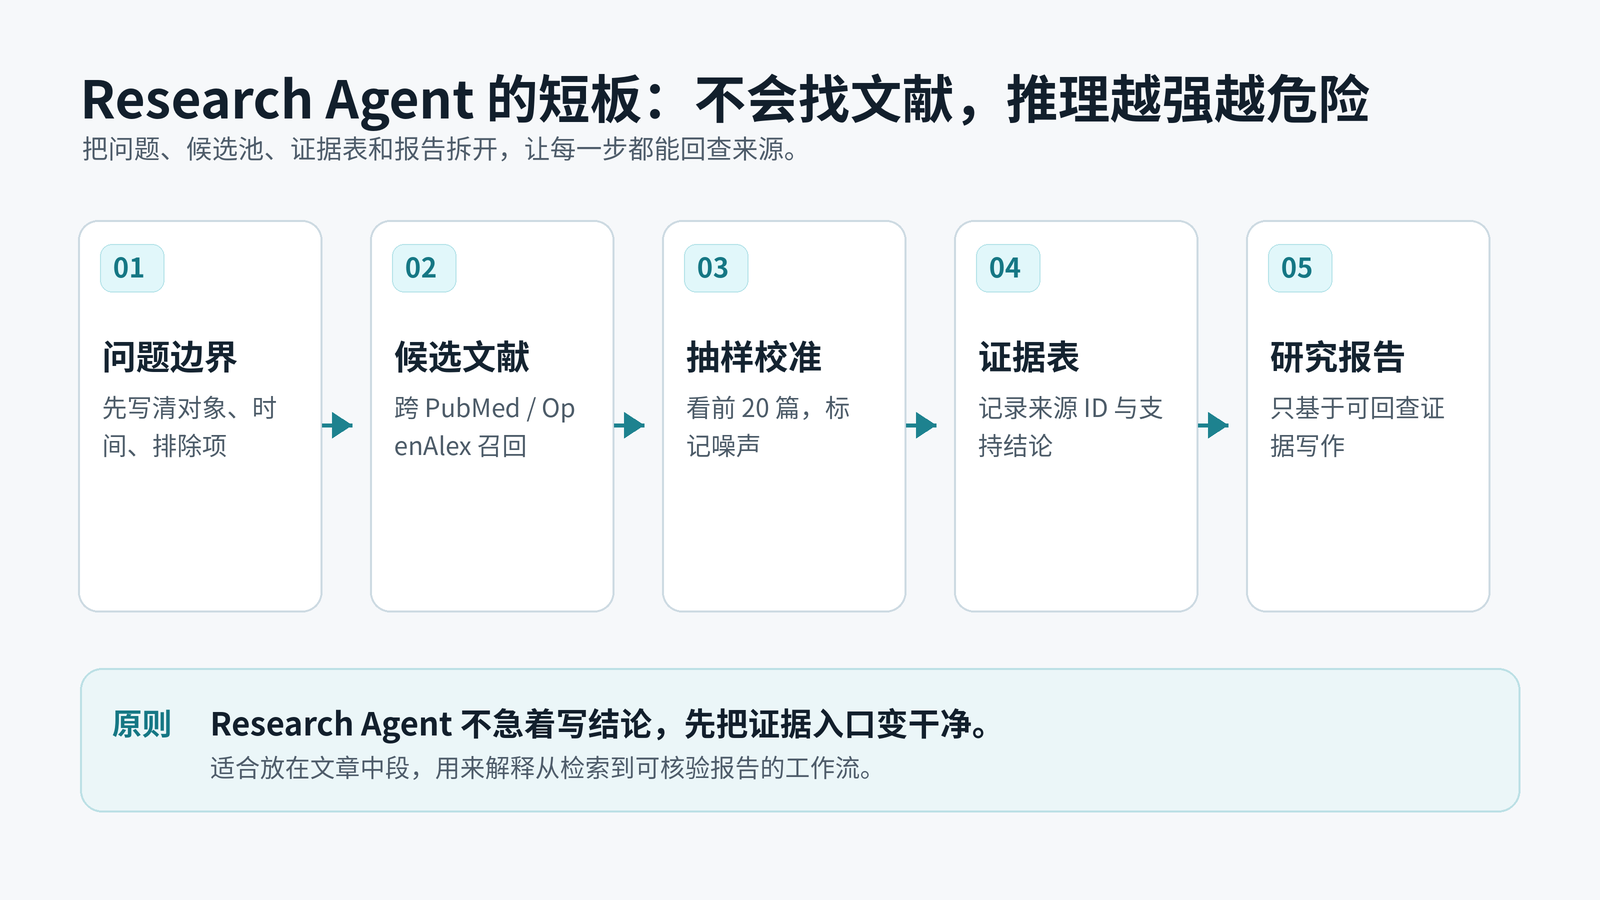
先拆问题,再谈报告
以“LLM agent 在科研工作流里的评测进展”为例,一个粗 query 可能是:
LLM agent scientific research benchmark literature review experiment design这会召回很多相关但不够准确的文章。更好的做法是把问题拆成几个分支:literature review agent、AI scientist benchmark、experiment design agent、data analysis workflow。每个分支单独看候选文献,再合并去重。
这里需要记录的不只是最终结果,还包括 query plan、candidate table、dedupe report 和 source_id。否则后面很难解释一条结论来自哪里。
专家模式更像候选池构建器
我理解的专家模式,不是替研究者直接下结论,而是用更多检索轮次和交叉验证,把复杂问题拆开。它适合做三件事:扩展同义表达,跨库建立候选池,保留来源线索。
如果要试一个工具节点,可以用 超能文献 的专家模式做中文复杂问题检索,覆盖 PubMed / OpenAlex,再回到来源列表和摘要人工复核。这个位置比较克制:它负责证据入口和候选池,不替代论文质量判断。
看四个指标
我会用四个指标判断检索是否靠谱。
- 覆盖度:综述、benchmark、方法论文、应用案例是否都有。
- 相关性:top 20 里有多少文章真正回答问题。
- 来源质量:预印本、会议、期刊、综述是否分层。
- 结论回链:报告里的关键判断能否回到 DOI、PMID 或 OpenAlex ID。
这几个指标不复杂,但能把“AI 写得像不像”拉回到“证据是不是站得住”。
一个小流程
团队内部可以先做一个很小的实验:选 3 个研究问题,每个问题保留 query plan、候选文献表、排除理由和结论来源映射。不要急着让模型写长报告,先抽样检查候选池。
候选池稳定以后,再生成摘要或综述初稿。这样即使模型写得一般,至少证据来源还能回查;如果一开始就让模型写完整报告,后面排查会很累。
复杂检索最怕黑箱。专家模式真正有价值的地方,是把问题拆细、把来源留下来,让 AI 写作站在可复核的候选池上。

 浙公网安备 33010602011771号