主流开源大模型架构对比报告
一、主流开源大模型 对比
目前开源大模型,比较经典的有:
国外:LLaMA、BLOOM、Falcon、Mixtral、T5
国内:Qwen、DeepSeek、ChatGLM、
|
模型
|
核心架构
|
注意力机制
|
位置编码
|
归一化层
|
激活函数
|
关键创新/特点
|
|
LLaMA (3)
|
Decoder-only
|
GQA (分组查询)
|
RoPE
|
RMSNorm
|
SwiGLU
|
现代高效 Decoder 架构的事实标准
|
|
BLOOM
|
Decoder-only
|
MHA (标准多头)
|
ALiBi
|
LayerNorm
|
GELU
|
纯粹的多语言设计,ALiBi 位置编码
|
|
Falcon
|
Decoder-only
|
MQA (多查询) / GQA
|
RoPE
|
RMSNorm
|
GeLU
|
MQA 提升推理效率,并行注意力
|
|
Mixtral
|
MoE (专家混合)
|
GQA
|
RoPE
|
RMSNorm
|
SwiGLU
|
开源 MoE 模型的标杆,稀疏激活
|
|
|
|
|
|
|
|
|
|
T5
|
Encoder-Decoder
|
MHA
|
相对位置偏置
|
LayerNorm
|
GeLU
|
Seq2Seq 任务框架,适用于翻译、摘要
|
|
Qwen (通义千问)
|
Decoder-only
|
GQA / MHA
|
RoPE
|
RMSNorm
|
SwiGLU
|
超大词汇表 (多语言)、长上下文支持
|
|
DeepSeek
|
MoE (专家混合)
|
MHA
|
RoPE
|
RMSNorm
|
SwiGLU
|
对标 Mixtral,代码和推理能力突出
|
|
ChatGLM (3)
|
GLM (通用语言模型)
|
GQA / MHA
|
RoPE
|
DeepNorm
|
SwiGLU
|
独特的 GLM 框架,双向注意力
|
二、大模型架构
LLaMA(Large Language Model Meta AI)
- 研发机构: Meta AI
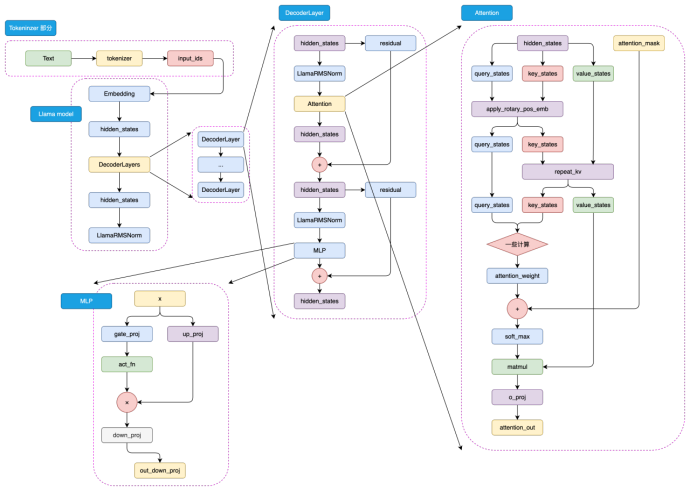
- 架构: LLaMA 系列模型采用了经典的 仅解码器(Decoder-only)的 Transformer 架构。Llama 3.1架构是经过高度优化的实现,包含了当前业界公认的高性能组件:( RMSNorm + SwiGLU + RoPE + GQA)
○ 归一化 :采用前置归一化(Pre-normalization)并使用RMSNorm来保证训练过程的稳定性。
○ 激活函数:使用SwiGLU激活函数,相较于标准的ReLU,它能提供更好的性能表现。
○ 位置编码:采用旋转位置编码(Rotary Positional Embeddings, RoPE)来为序列中的token注入位置信息。
○ 注意力机制:在所有尺寸的模型(8B、70B和405B)中均采用了分组查询注意力(Grouped-Query Attention, GQA)。GQA通过让多组查询头(Query heads)共享同一份键(Key)和值(Value)头,显著减少了推理过程中键值缓存(KV cache)的内存占用,这是实现模型可扩展性,尤其是在处理长序列时的一项关键优化。
○ LLaMA: “LLaMA: Open and Efficient Foundation Language Models”https://arxiv.org/abs/2302.13971
![image]()
图 LLaMA-3 模型结构
三、细节结构解释
1. 核心结构
Decoder-only (解码器架构):这是当前主流生成式 LLM 的选择,包括 LLaMA、BLOOM、Falcon、Qwen、Kimi。这种架构非常适合自回归的文本生成任务,如对话、写作、问答等。模型根据已经生成的文本,预测下一个词。
Encoder-Decoder (编码器-解码器架构):T5 是该架构的典型代表。它拥有一个完整的编码器来理解输入文本(源序列),和一个解码器来生成输出文本(目标序列)。这种结构天然适用于序列到序列 (Seq2Seq) 任务,如机器翻译、文本摘要、问题生成等。
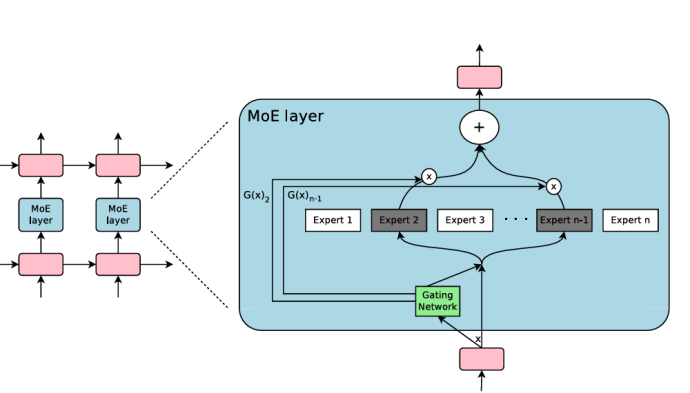
MoE (Mixture-of-Experts / 专家混合架构):Mixtral、DeepSeek、悟道 采用了这种高效扩展架构。其核心思想是,模型包含大量“专家”(即前馈网络),但在处理每个 token 时,只通过一个“路由器”动态选择激活一小部分专家。
- 优势: 可以在保持计算量(FLOPs)相对稳定的情况下,将模型总参数量扩展到极大(万亿级别),从而增强模型的容量和知识储备。这是实现“大而快”的关键。
GLM (General Language Model / 通用语言模型):ChatGLM 采用的独特架构。它通过自回归填空的目标进行预训练,并采用特殊的注意力掩码,使其能够同时处理双向和单向的上下文信息。这使得它在理解(NLU)和生成(NLG)任务上都有较好的表现。
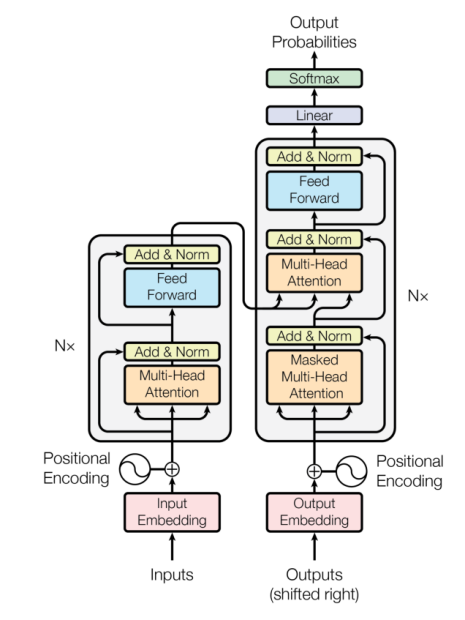
Transformer
目前大模型的基本架构是基于Transformer的。
![image]()
图 transformer架构
MoE 专家混合模型
MoE 并不是一个特定的模型,而是一种架构范式 (Architectural Paradigm)。它的核心思想是通过条件计算 (Conditional Computation) 来扩大模型规模,而不是简单地增加模型密度。
想象一下,你不需要在解决每个问题时都动用整个大脑,而是根据问题的类型,只激活大脑中特定领域的专家区域。这就是 MoE 的直觉。
核心思想
- 稀疏激活 (Sparse Activation):在一个稠密模型(Dense Model)中,对于任何输入,所有参数都会被激活和使用。而在 MoE 模型中,输入 token 只会被路由到一小部分“专家”(Experts)那里进行处理。
- 专家网络 (Experts):每个专家通常是一个独立的前馈神经网络 (FFN)。一个 MoE 层包含多个这样的专家。
- 门控网络/路由器 (Gating Network / Router):这是一个小型的神经网络,它的作用是“决策者”。它接收输入的 token,然后决定应该将这个 token 发送给哪些专家处理。它会为每个专家生成一个权重,通常只选择权重最高的 Top-k 个专家(k 通常是 1 或 2)。
- 组合输出:各个被激活的专家的输出会根据门控网络给出的权重进行加权求和,形成最终的输出。
MoE 的优势
- 巨大的参数规模:可以在不显著增加计算成本(FLOPs)的情况下,将模型的总参数量扩展到数万亿级别。因为每次前向传播只使用了总参数的一小部分。
- 训练和推理更快:对于给定的参数总量,MoE 模型的计算量远小于同等规模的稠密模型。例如,一个 1.8T 参数的 MoE 模型(如 Mixtral 8x7B),其每次前向传播的计算量只相当于一个 14B 的稠密模型(因为每个 token 只激活 2 个 7B 的专家)。
- 专业化:不同的专家可以在训练过程中学会处理不同类型的数据或模式,实现某种程度的专业化。
MoE 的挑战
- 训练不稳定:门控网络的决策可能导致负载不均衡(某些专家被过度使用,某些专家几乎不用),需要引入额外的损失函数(如 Load Balancing Loss)来鼓励均匀分配。
- 通信开销大:在分布式训练中,不同专家可能位于不同的 GPU 上,token 在专家之间的路由会引入显著的通信延迟。
- 推理复杂:需要更多的 VRAM 来容纳所有专家参数,即使每次只使用一小部分。这使得模型部署变得困难。
![image]()
GLM
参考资料 :复制的 DataWhale happyllm项目 chapter3 https://github.com/datawhalechina/happy-llm/blob/main/docs/chapter3/%E7%AC%AC%E4%B8%89%E7%AB%A0%20%E9%A2%84%E8%AE%AD%E7%BB%83%E8%AF%AD%E8%A8%80%E6%A8%A1%E5%9E%8B.md#333-glm
GLM 最初是由清华计算机系推出的一种通用语言模型基座,其核心思路是在传统 CLM 预训练任务基础上,加入 MLM 思想,从而构建一个在 NLG 和 NLU 任务上都具有良好表现的统一模型。
在整体模型结构上,GLM 和 GPT 大致类似,均是 Decoder-Only 的结构,仅有三点细微差异:
- 使用 Post Norm 而非 Pre Norm。Post Norm 是指在进行残差连接计算时,先完成残差计算,再进行 LayerNorm 计算;而类似于 GPT、LLaMA 等模型都使用了 Pre Norm,也就是先进行 LayerNorm 计算,再进行残差的计算。相对而言,Post Norm 由于在残差之后做归一化,对参数正则化的效果更强,进而模型的鲁棒性也会更好;Pre Norm相对于因为有一部分参数直接加在了后面,不需要对这部分参数进行正则化,正好可以防止模型的梯度爆炸或者梯度消失。因此,对于更大体量的模型来说,一般认为 Pre Norm 效果会更好。但 GLM 论文提出,使用 Post Norm 可以避免 LLM 的数值错误(虽然主流 LLM 仍然使用了 Pre Norm);
- 使用单个线性层实现最终 token 的预测,而不是使用 MLP;这样的结构更加简单也更加鲁棒,即减少了最终输出的参数量,将更大的参数量放在了模型本身;
- 激活函数从 ReLU 换成了 GeLUs。ReLU 是传统的激活函数,其核心计算逻辑为去除小于 0的传播,保留大于 0的传播;GeLUs 核心是对接近于 0的正向传播,做了一个非线性映射,保证了激活函数后的非线性输出,具有一定的连续性。
(2)预训练任务-GLM
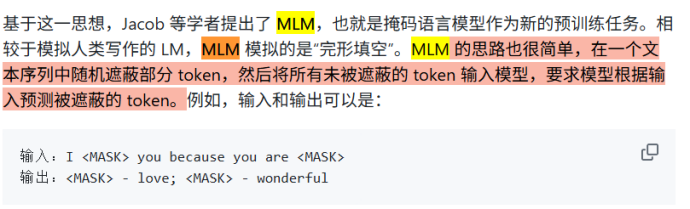
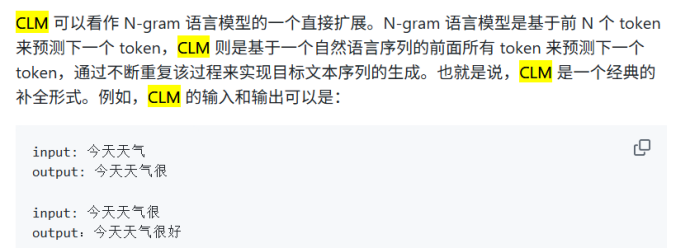
GLM 的核心创新点主要在于其提出的 GLM(General Language Model,通用语言模型)任务,这也是 GLM 的名字由来。GLM 是一种结合了自编码思想和自回归思想的预训练方法。所谓自编码思想,其实也就是 MLM 的任务学习思路,在输入文本中随机删除连续的 tokens,要求模型学习被删除的 tokens;所谓自回归思想,其实就是传统的 CLM 任务学习思路,也就是要求模型按顺序重建连续 tokens。
GLM 通过优化一个自回归空白填充任务来实现 MLM 与 CLM 思想的结合。其核心思想是,对于一个输入序列,会类似于 MLM 一样进行随机的掩码,但遮蔽的不是和 MLM 一样的单个 token,而是每次遮蔽一连串 token;模型在学习时,既需要使用遮蔽部分的上下文预测遮蔽部分,在遮蔽部分内部又需要以 CLM 的方式完成被遮蔽的 tokens 的预测。例如,输入和输出可能是:
|
Plain Text
输入:I <MASK> because you <MASK>
输出:<MASK> - love you; <MASK> - are a wonderful person
|
通过将 MLM 与 CLM 思想相结合,既适配逐个 token 生成的生成类任务,也迫使模型从前后两个方向学习输入文本的隐含关系从而适配了理解类任务。
不过,GLM 预训练任务更多的优势还是展现在预训练模型时代,迈入 LLM 时代后,针对于超大规模、体量的预训练,CLM 展现出远超 MLM 的优势。通过将模型体量加大、预训练规模扩大,CLM 预训练得到的生成模型在文本理解上也能具有超出 MLM 训练的理解模型的能力,因此,ChatGLM 系列模型也仅在第一代模型使用了 GLM 的预训练思想,从 ChatGLM2 开始,还是回归了传统的 CLM 建模。虽然从 LLM 的整体发展路径来看,GLM 预训练任务似乎是一个失败的尝试,但通过精巧的设计将 CLM 与 MLM 融合,并第一时间产出了中文开源的原生 LLM,其思路仍然存在较大的借鉴意义。
![image]()
![image]()
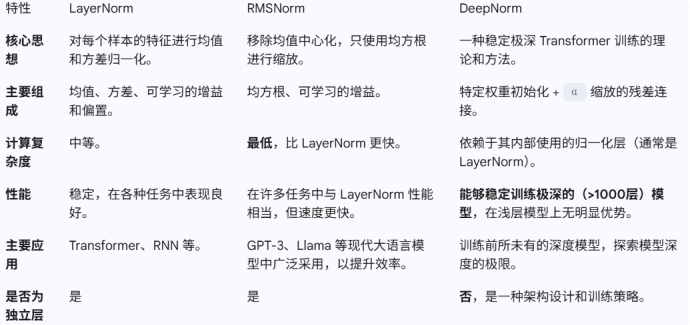
2. 归一化层
LayerNorm: 经典归一化层,BLOOM、T5 使用。
RMSNorm: LLaMA、Falcon、Mixtral、Qwen、DeepSeek 等现代模型的标配。它简化了 LayerNorm,移除了均值中心化步骤,计算更快。
DeepNorm: ChatGLM 使用的一种更复杂的归一化技术,旨在让极深层网络的训练更加稳定。
位置: 所有现代模型都采用了预归一化 (Pre-Normalization),即在每个子模块(注意力和FFN)的输入端进行归一化,这已成为稳定训练的标准实践。
![image]()
如何选择?
LayerNorm:是一个非常安全和稳健的选择,适用于绝大多数 Transformer 和其他需要样本内归一化的场景。
RMSNorm:如果你追求极致的训练和推理速度,并且实验证明在你的任务上性能与 LayerNorm 无异,那么 RMSNorm 是一个绝佳的替代品。现代很多大模型(如 Llama 系列)已经默认使用 RMSNorm。
DeepNorm:只有当你需要训练非常非常深(例如几百上千层)的模型时才需要考虑。对于常规深度(例如 12-48 层)的 Transformer,标准的 Post-LN 或 Pre-LN 结构通常已经足够稳定。
LayerNorm
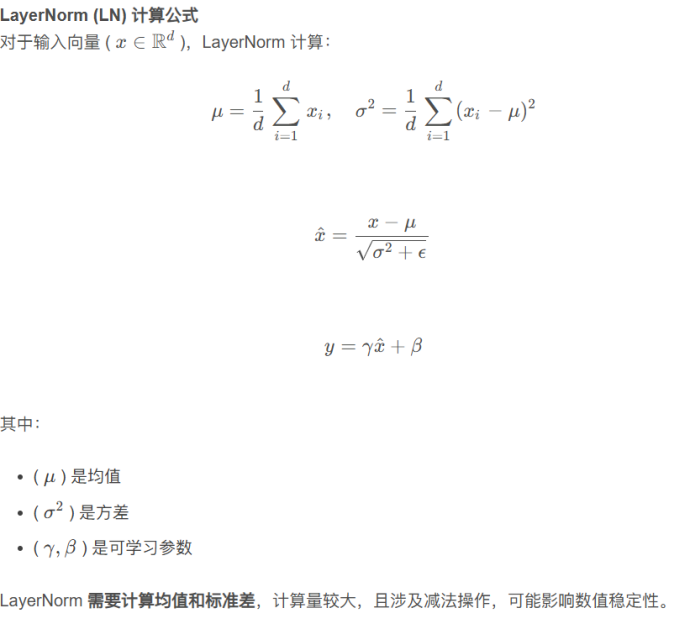
对单个样本(或 token)的所有特征进行归一化。
LayerNorm 是为了解决 Batch Normalization (BN) 在循环神经网络 (RNN) 和小批量 (small batch size) 场景下的不足而提出的。与 BN 在批次维度上进行归一化不同,LayerNorm 在单个样本的特征维度上进行归一化。
核心思想
对于每一个样本,独立地计算其所有特征的均值和方差,然后用这些统计量来归一化该样本的特征。
这种方式有两个主要优点:
- 独立于批次大小:每个样本独立计算,即使批次大小为 1 也能正常工作。
- 适用于序列数据:对于变长的序列数据(如文本),可以在每个时间步上对特征向量进行归一化,非常方便。
![image]()
|
Python
import torch
import torch.nn as nn
class LayerNorm(nn.Module):
def __init__(self, normalized_shape, eps=1e-5):
super().__init__()
# 如果 normalized_shape 是整数,则将其转换为元组
if isinstance(normalized_shape, int):
normalized_shape = (normalized_shape,)
self.normalized_shape = normalized_shape
self.eps = eps
# 可学习的增益 gamma 和偏置 beta
self.gamma = nn.Parameter(torch.ones(self.normalized_shape))
self.beta = nn.Parameter(torch.zeros(self.normalized_shape))
def forward(self, x):
# 计算需要归一化的维度的均值和方差
# keepdim=True 保持维度以便进行广播计算
mean = x.mean(dim=-1, keepdim=True)
var = x.var(dim=-1, unbiased=False, keepdim=True)
# 归一化
x_normalized = (x - mean) / torch.sqrt(var + self.eps)
# 缩放和平移
output = self.gamma * x_normalized + self.beta
return output
# 使用示例
# 假设我们有一个批次为 4,序列长度为 10,特征维度为 20 的张量
x = torch.randn(4, 10, 20)
ln = LayerNorm(normalized_shape=20)
output = ln(x)
print("自定义 LayerNorm 输出尺寸:", output.shape)
# 对比 PyTorch 内置的 LayerNorm
pytorch_ln = nn.LayerNorm(normalized_shape=20)
pytorch_output = pytorch_ln(x)
print("PyTorch LayerNorm 输出尺寸:", pytorch_output.shape)
|
RMSNorm
RMSNorm (Root Mean Square Layer Normalization) 是对 LayerNorm 的一种简化,旨在减少计算开销。研究者发现,LayerNorm 中的均值中心化(减去均值 μ)对性能的贡献不大,但却占用了相当一部分计算量。
核心思想
移除均值中心化步骤,只通过均方根 (Root Mean Square) 来对神经元的激活值进行缩放。
这种简化的主要优点是:
- 计算效率更高:在 GPU 上,RMSNorm比 LayerNorm 快 7% 到 64% 不等。
- 性能相当:在多种任务上,RMSNorm 的性能与 LayerNorm 相当。
![image]()
![image]()
g是可学习参数
|
Python
import torch
import torch.nn as nn
class RMSNorm(nn.Module):
def __init__(self, dim, eps=1e-6):
super().__init__()
self.eps = eps
# 增益参数 gamma
self.gamma = nn.Parameter(torch.ones(dim))
def _norm(self, x):
# 计算输入的均方根
# rsqrt 是平方根倒数的快速计算
return x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + self.eps)
def forward(self, x):
# 归一化并应用增益
return self._norm(x) * self.gamma
# 使用示例
# 假设我们有一个批次为 4,序列长度为 10,特征维度为 20 的张量
x = torch.randn(4, 10, 20)
rms_norm = RMSNorm(dim=20)
output = rms_norm(x)
print("RMSNorm 输出尺寸:", output.shape)
|
优势
- 更快的计算,RMSNorm 只计算平方和,计算量减少:
- 数值稳定性
LayerNorm 计算 μ 时可能出现小数精度问题,而 RMSNorm 不涉及均值计算,数值更稳定。
避免均值归一化导致的梯度消失问题。
- 适用于 Transformer
在 GPT、Llama、Gemma 这类 超大规模 Transformer 语言模型 中,RMSNorm 的高效计算可以显著减少训练时间。
Google DeepMind 研究表明,RMSNorm 可以替代 LayerNorm 而不损失性能,特别是在 低精度训练(FP16, BF16) 场景下。
DeepNorm
DeepNorm 并不是像 LayerNorm 或 RMSNorm 那样的一种具体的“归一化层”,而是一种用于稳定极深 Transformer 模型训练的理论和方法。它通过结合特定的权重初始化和对残差连接的理论分析,使得训练超过 1000 层的 Transformer 成为可能。
DeepNorm 通常与 LayerNorm 结合使用。
核心思想
通过理论推导,DeepNorm 认为模型训练不稳定的根源在于梯度消失或爆炸,这与模型参数的初始化以及残差连接中的数值范围有很大关系。DeepNorm 的目标是限制模型前向传播和反向传播中数值的剧烈变化。
它主要包含两个部分:
- 理论指导的初始化: 对于 Transformer 的某些权重矩阵(例如 FFN 的第二层线性层和注意力机制的输出投影层),使用一个比标准初始化小得多的值进行初始化。
- 修改残差连接: 在标准的 x + Sublayer(x) 残差连接中,DeepNorm 引入一个常数缩放因子 α:
![image]()
数学公式/伪代码
在一个标准的 Transformer 块中,残差连接的形式如下:
|
Plain Text
# 标准 Transformer
x = x + attention(LayerNorm(x))
x = x + ffn(LayerNorm(x))
|
使用 DeepNorm 后,这个结构会变成:
|
Plain Text
# 使用 DeepNorm 的 Transformer
x = LayerNorm(x + \alpha * attention(x)) # 注意,LayerNorm 放在了残差连接之后
x = LayerNorm(x + \alpha * ffn(x))
|
其中 α 是一个关键的超参数,它的值由模型的深度 N(编码器或解码器层数)决定,通常设置为 (2N)**(1/4) 或类似的值,以保证数值范围的稳定。
同时,FFN 和 Attention 中的某些权重矩阵需要被初始化为一个较小的值,例如用 c⋅N**(−1/4) 这样的因子进行缩放,其中 c 是一个小的常数。
DeepNorm 的实现不是一个独立的 nn.Module,而是对 Transformer Block 结构的修改。
|
Python
import torch
import torch.nn as nn
# 这是一个概念性实现,展示 DeepNorm 如何修改 Transformer 块
class DeepNormTransformerBlock(nn.Module):
def __init__(self, dim, num_layers, ffn_expansion_factor=4):
super().__init__()
self.dim = dim
self.num_layers = num_layers
# 定义 alpha,这是 DeepNorm 的核心
self.alpha = (2 * self.num_layers) ** 0.25
self.norm1 = nn.LayerNorm(dim)
self.attn = nn.MultiheadAttention(dim, heads=8) # 示例
self.norm2 = nn.LayerNorm(dim)
self.ffn = nn.Sequential(
nn.Linear(dim, dim * ffn_expansion_factor),
nn.ReLU(),
nn.Linear(dim * ffn_expansion_factor, dim)
)
# DeepNorm 特定的初始化
self.init_weights()
def init_weights(self):
# 论文中建议对 FFN 的第二层和 Attention 的输出层进行特殊初始化
# 这里仅为示意,具体初始化策略需参考原论文
for name, param in self.ffn.named_parameters():
if 'weight' in name and '1.weight' in name: # 第二个线性层
nn.init.xavier_normal_(param, gain=0.1) # 示意性的较小初始化
for name, param in self.attn.named_parameters():
if 'out_proj.weight' in name:
nn.init.xavier_normal_(param, gain=0.1)
def forward(self, x):
# 残差连接的修改
# 注意 LayerNorm 的位置和 alpha 的使用
attn_output, _ = self.attn(x, x, x)
x = self.norm1(x + self.alpha * attn_output)
ffn_output = self.ffn(x)
x = self.norm2(x + self.alpha * ffn_output)
return x
|
3. 位置编码
![image]()
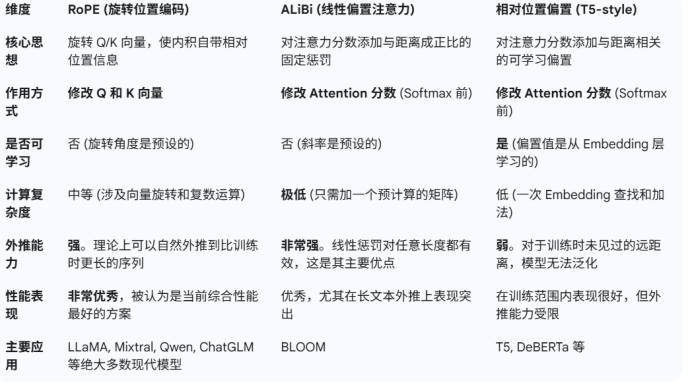
RoPE 已成为当前大模型架构的黄金标准,因为它在性能和外推能力上取得了最佳的平衡。
ALiBi 是一个非常优雅且高效的替代方案,它的简单性和强大的外推能力使其在特定场景下极具吸引力。
相对位置偏置 是一个经典且有效的方法,但其外推能力弱的缺点使其在需要处理超长文本的现代大模型中逐渐被 RoPE 和 ALiBi 取代。
RoPE 旋转位置编码
通过绝对位置来编码相对位置关系。 RoPE 的精妙之处在于,它将位置信息融入到注意力计算中的 Query (查询) 和 Key (键) 向量中。它通过对 Q 和 K 向量进行“旋转”操作,使得两个 token 的 Q 和 K 经过旋转后的内积(即注意力分数),只与它们的相对位置有关,而与它们的绝对位置无关。
1. 工作原理
想象一个二维平面上的向量 v = (x, y)。如果将它旋转 θ 角度,会得到一个新的向量。RoPE 将高维的词向量两两配对,看作是一系列的二维向量(或者说,复数),然后根据其绝对位置 m 旋转一个特定的角度 mθ。
- 位置为 m 的 token 的 Query 向量 q_m 会被旋转 mθ。
- 位置为 n 的 token 的 Key 向量 k_n 会被旋转 nθ。
当计算它们的注意力分数时,即计算 (R_m * q_m) 和 (R_n * k_n) 的点积,数学上可以证明这个结果等于原始向量 q_m 和 k_n 与一个只依赖于相对位置 (m-n) 的旋转矩阵 R_{m-n} 的运算结果。这样,模型就自然地捕捉到了相对位置信息。
原理解释 :
假设 q_m 和 k_n 是位置 m 和 n 的向量。RoPE 将它们乘以一个旋转矩阵 R:
![image]()
其中旋转矩阵 R_m 定义为:
![image]()
这里的 θ_i = 10000^{-2i/d} 是预设的、不同维度上的旋转“角速度”,d 是向量维度。
关键在于,内积(注意力分数)变为:
![image]()
这个结果只依赖于相对距离 n-m。
2. 更详细的原理流程解释
第一步 计算基础角速度 θ_i
RoPE 的设计者不希望所有维度都以相同的速度旋转。他们希望:
- 低频部分 (low-frequency):对应向量的前几个维度,旋转得慢(波长长),用于捕捉长距离的相对位置关系。
- 高频部分 (high-frequency):对应向量的后几个维度,旋转得快(波长短),用于捕捉短距离、精细的相对位置关系。
为了实现这一点,他们使用了一个几何级数 (geometric progression) 来生成这些角速度。
对于一个维度为 d 的向量,我们有 d/2 个角速度 θ_i,其中 i 从 0 到 d/2 - 1。公式如下:
![image]()
。
- i:维度对的索引,i ∈ [0, 1, 2, ..., (d/2 - 1)]。
- b:一个预设的基数 (base),通常是一个很大的数,比如 10000。这个基数 b 控制了旋转波长的范围。
第二步:结合绝对位置 m
现在我们有了基础速度 θ_i,对于一个在序列中绝对位置为 m 的 token,其在第 i 个二维平面上的最终旋转角度就是:
![image]()
这就像物理学中的 角位移 = 角速度 × 时间。这里,m 扮演了“时间”的角色。
第三步:构建旋转矩阵 R_m
有了每个维度对在特定位置 m 的最终旋转角度 mθ_i,我们就可以构建完整的旋转矩阵 R_m 了。
R_m 是一个 d x d 的块对角矩阵 (block-diagonal matrix)。这意味着它的大部分元素都是 0,只有对角线上一系列 2x2 的小矩阵(块)有值。每个 2x2 的块负责旋转一对维度。
对于第 i 个维度对(即向量的第 2i 和 2i+1 维),其对应的 2x2 旋转矩阵是标准的二维旋转矩阵:
![image]()
最终,将这个矩阵 R_m 应用于原始的 Query 向量 q_m 或 Key 向量 k_m,就完成了位置信息的注入:
![image]()
旋转矩阵R_m实际上是一个巨大的稀疏矩阵,在代码实现中,直接构建并乘以一个巨大的稀疏矩阵 R_m 是非常低效的。一个更聪明的方法是利用复数。
- 将 d 维向量 x 的每对 看作一个复数
- 在复平面中,旋转一个角度 α 等价于乘以
- 所以,旋转操作就变成了简单的复数乘法:
![image]()
在 PyTorch 实现代码中,你会看到torch.view_as_complex 和 torch.polar这些函数,它们将向量转换为复数,进行乘法运算,再转换回实数,从而高效地实现了旋转操作。
|
Python
import torch
def precompute_freqs_cis(dim: int, end: int, theta: float = 10000.0):
"""预计算旋转角度的复数表示"""
# 计算频率 a = 1 / (theta^(2k/d))
freqs = 1.0 / (theta ** (torch.arange(0, dim, 2)[: (dim // 2)].float() / dim))
# 计算位置 t = [0, 1, ..., end-1]
t = torch.arange(end, device=freqs.device) #确保生成的位置张量 t 与之前预计算的「角速度张量 freqs」在同一计算设备(如 CPU、GPU)上。
# 计算 t * a 的外积,得到每个位置在每个频率上的角度
freqs = torch.outer(t, freqs).float()
# 转换为复数形式 cos(theta) + i*sin(theta)
freqs_cis = torch.polar(torch.ones_like(freqs), freqs)
return freqs_cis
def apply_rotary_emb(x: torch.Tensor, freqs_cis: torch.Tensor):
"""将旋转位置编码应用到输入张量 x (q 或 k)"""
# 将 x 的最后一维转换为复数 (d -> d/2)
# x.shape: [bs, seq_len, num_heads, head_dim]
# x_complex.shape: [bs, seq_len, num_heads, head_dim/2]
# 1. x.float().reshape(*x.shape[:-1], -1, 2)的形状是[bs, seq_len, num_heads, head_dim/2,2]
# 2. 然后torch.view_as_complex 会将最后一个维度的内容组装成实部虚部,最后一的维度会消失
x_complex = torch.view_as_complex(x.float().reshape(*x.shape[:-1], -1, 2))
# freqs_cis 需要调整形状以匹配 x_complex
# freqs_cis.shape: [seq_len, head_dim/2] -> [1, seq_len, 1, head_dim/2]
freqs_cis = freqs_cis.unsqueeze(0).unsqueeze(2)
# 核心操作:复数乘法实现旋转
# x_rotated.shape: [bs, seq_len, num_heads, head_dim/2]
#x_complex [bs, seq_len, num_heads, head_dim/2]
#freqs_cis [1 , seq_len, 1 , head_dim/2]
x_rotated = x_complex * freqs_cis
# 将旋转后的复数转换回实数张量
# x_out.shape: [bs, seq_len, num_heads, head_dim]
x_out = torch.view_as_real(x_rotated).flatten(3)#按照第三个维度展平,就是把最后两个合并。
return x_out.type_as(x)
# 使用示例
# seq_len, batch_size, num_heads, head_dim = 10, 2, 4, 32
# freqs_cis = precompute_freqs_cis(head_dim, seq_len)
# q = torch.randn(batch_size, seq_len, num_heads, head_dim)
# q_rotated = apply_rotary_emb(q, freqs_cis)
# print(q_rotated.shape) # torch.Size([2, 10, 4, 32])
|
ALiBi 线性偏置注意力
ALiBi 是一个非常简洁且高效的方案,主要被 BLOOM 模型采用。它的核心思想是,位置信息不应该作用于词向量本身,而应该在计算注意力分数时作为一个“惩罚项”或“偏置”加入。
核心思想
距离惩罚。 两个 token 在序列中的距离越远,它们之间的注意力分数就应该受到越大的惩罚。这个惩罚是线性的,并且是加在 softmax 操作之前。
工作原理
在计算完 QK^T 得到原始的注意力分数矩阵后,ALiBi 会加上一个预先计算好的偏置矩阵。这个偏置矩阵的值只与 query 和 key 的相对位置有关。
- 对于第 i 个 query 和第 j 个 key,添加的偏置是 m * |i - j|。
- |i - j| 是它们之间的距离。
- m 是一个为每个注意力头预设的、固定的、不可学习的斜率(slope)。通常,头的编号越小,斜率越大(惩罚越强),编号越大,斜率越小(惩罚越弱)(m 的值越大,m * (-|i - j|) 的值就越接近 0(即惩罚越弱)),这让不同的头关注不同距离范围的信息。
数学公式
![image]()
在解码器中,为了保证因果性,通常会结合上三角掩码。
![image]()
其中 BiasMatrix[i, j] = m * |i - j| (对于 j <= i)。
|
Python
import torch
import math
def get_alibi_biases(num_heads, seq_len):
"""计算 ALiBi 偏置矩阵"""
# 计算每个头的斜率 m
def get_slopes(n):
# 计算最接近 2^-(8/n) 的 2 的幂
def get_next_power_of_2(x):
return 2 ** math.floor(math.log2(x))
start = (2**(-2**-(math.log2(n)-3)))
ratio = start
return [start*ratio**i for i in range(n)]
slopes = torch.Tensor(get_slopes(num_heads))
# 计算距离矩阵 |i - j|
# 注意:这里是解码器场景,所以是下三角矩阵
# unsqueeze(1) “第 1 个维度位置” 插入一个新的、尺寸为 1 的维度
# 变成了 shape: 【sep_len,1】 和 【1,sep_len】
alibi = torch.arange(seq_len).unsqueeze(1) - torch.arange(seq_len).unsqueeze(0)
#现在我们用形状为 (5, 1) 的列向量减去形状为 (1, 5) 的行向量。PyTorch 的广播机制会自动将它们扩展到相同的形状 (5, 5) 再进行逐元素相减。
alibi = -torch.abs(alibi) # 变成负数
# 每个头的斜率乘以距离矩阵
# 【1,sep_len,sep_len】 [num_heads,1,1]
alibi = alibi.unsqueeze(0) * slopes.unsqueeze(1).unsqueeze(2)# 【num_heads,sep_len,1,sep_len】
return alibi
# 使用示例
# num_heads, seq_len = 4, 10
# attn_scores = torch.randn(1, num_heads, seq_len, seq_len) # 假设这是 QK^T
# alibi_biases = get_alibi_biases(num_heads, seq_len)
#
# # 添加偏置
# attn_scores_with_alibi = attn_scores + alibi_biases
# print(attn_scores_with_alibi.shape) # torch.Size([1, 4, 10, 10])
|
相对位置偏置
这是 T5、DeBERTa 等模型中使用的经典方法。它的思想与 ALiBi 类似,都是在注意力分数上添加偏置,但这个偏置是可学习的。
核心思想
为不同的相对距离学习一个专属的偏置值。 模型会维护一个查询表(Embedding Table),根据两个 token 的相对距离 i - j,从表中查找对应的偏置值,加到注意力分数上。
工作原理
- 计算相对距离:对于注意力矩阵中的每个元素 (i, j),计算其相对距离 i - j。
- 分桶 (Bucketing):由于相对距离的范围可能很大,直接为每个距离都学习一个偏置不现实。因此,通常会使用“分桶”策略,将一定范围内的距离映射到同一个桶里(例如,距离 8-15 都属于一个桶)。这样可以大大减少需要学习的参数量。
- 查找偏置:创建一个可学习的 Embedding 层,其大小为桶的数量。根据分桶后的相对距离索引,从这个 Embedding 层中查找对应的偏置向量。
- 添加偏置:将查找到的偏置值加到 QK^T 的对应位置上。
数学公式
![image]()
其中 b_ij 是从一个可学习的查询表 B 中根据相对位置 i - j 查找得到的值:
![image]()
|
import torch
import torch.nn as nn
class RelativePositionBias(nn.Module):
def __init__(self, num_buckets, max_distance, num_heads):
super().__init__()
self.num_buckets = num_buckets
self.max_distance = max_distance
self.num_heads = num_heads
# 创建可学习的偏置查询表
self.relative_attention_bias = nn.Embedding(self.num_buckets, self.num_heads)
def _relative_position_bucket(self, relative_position):
"""将相对距离分桶"""
# 正负距离分开处理
num_buckets = self.num_buckets // 2
ret = (relative_position > 0).to(torch.long) * num_buckets
n = torch.abs(relative_position)
# 超过 max_distance 的距离被归入同一个桶
max_exact = num_buckets // 2
is_small = n < max_exact
# 对近距离使用对数分桶,远距离直接映射
val_if_large = max_exact + (
torch.log(n.float() / max_exact) / math.log(self.max_distance / max_exact) * (num_buckets - max_exact)
).to(torch.long)
val_if_large = torch.min(val_if_large, torch.full_like(val_if_large, num_buckets - 1))
ret += torch.where(is_small, n, val_if_large)
return ret
def forward(self, seq_len):
q_pos = torch.arange(seq_len, dtype=torch.long)[:, None]
k_pos = torch.arange(seq_len, dtype=torch.long)[None, :]
relative_position = k_pos - q_pos # 计算相对距离矩阵
bucketed_position = self._relative_position_bucket(relative_position)
# 从 Embedding 表中查找偏置
bias = self.relative_attention_bias(bucketed_position) # [seq_len, seq_len, num_heads]
# 调整形状以匹配注意力分数矩阵 [1, num_heads, seq_len, seq_len]
bias = bias.permute(2, 0, 1).unsqueeze(0)
return bias
# 使用示例
# num_heads, seq_len = 4, 10
# attn_scores = torch.randn(1, num_heads, seq_len, seq_len)
# relative_bias_module = RelativePositionBias(num_buckets=32, max_distance=128, num_heads=num_heads)
# biases = relative_bias_module(seq_len)
#
# attn_scores_with_bias = attn_scores + biases
# print(attn_scores_with_bias.shape) # torch.Size([1, 4, 10, 10])
|
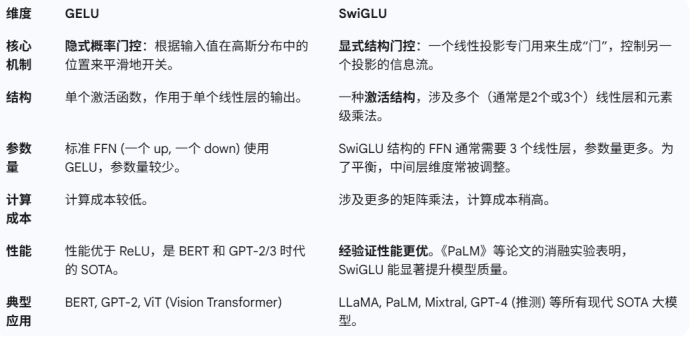
4. 激活函数
GELU: BLOOM、Falcon、T5 等模型使用,是 BERT 时代以来的常用选择。
SwiGLU: 一种门控线性单元,LLaMA、Mixtral、Qwen、DeepSeek、ChatGLM 等新一代模型的选择。实践证明,SwiGLU 能带来比 GELU 和 ReLU 更好的性能。
![image]()
GELU
设计思想是结合随机正则化(如 Dropout)和传统激活函数(如 ReLU)的优点。
核心思想
随机的、平滑的 ReLU。 ReLU 的“门控”是确定性的:如果输入 x > 0,门就打开(输出 x);如果 x <= 0,门就关闭(输出 0)。
GELU 的门控则是概率性的。它根据输入值 x 服从标准正态分布的概率来决定其输出。具体来说,它将输入 x 乘以一个范围在 (0, 1) 之间的“门控值”,这个门控值由高斯累积分布函数 Φ(x) 决定。
- 如果一个输入 x 非常小(远小于其他输入),那么 Φ(x) 会接近 0,GELU 的输出也接近 0(门关闭)。
- 如果一个输入 x 非常大(远大于其他输入),那么 Φ(x) 会接近 1,GELU 的输出就接近 x 本身(门打开)。
- 对于接近 0 的输入,GELU 提供了一个非常平滑的过渡,而不是像 ReLU 那样在 0 点有一个突变。
数学公式
GELU 的精确定义是:
GELU(x)=x⋅Φ(x)
其中 Φ(x) 是标准正态分布的累积分布函数 (CDF)。由于 CDF 的计算比较复杂,实践中通常使用一个更快的近似公式:
GELU(x)≈x⋅σ(1.702⋅x)
其中 σ 是 Sigmoid 函数。这个近似版本在性能上几乎没有差异,但计算速度更快。
|
Python
import torch
import torch.nn as nn
import torch.nn.functional as F
import math
# 使用 PyTorch 内置的 GELU
gelu_builtin = nn.GELU()
x = torch.randn(5)
print(f"Input: {x}")
print(f"Built-in GELU output: {gelu_builtin(x)}")
# 手动实现精确的 GELU (使用误差函数 erf)
def gelu_exact(x):
# Φ(x) = 0.5 * (1.0 + erf(x / sqrt(2)))
return x * 0.5 * (1.0 + torch.erf(x / math.sqrt(2.0)))
print(f"Manual exact GELU: {gelu_exact(x)}")
# 手动实现近似的 GELU
def gelu_approx(x):
return x * torch.sigmoid(1.702 * x)
print(f"Manual approx GELU: {gelu_approx(x)}")
|
SwiGLU
SwiGLU 不仅仅是一个激活函数,它是一种激活结构。它属于门控线性单元 (Gated Linear Unit, GLU) 家族。它的出现,显著提升了 Transformer 模型中前馈网络 (FFN) 的性能。
核心思想
显式的门控机制。 与 GELU 的隐式概率门控不同,SwiGLU 设计了一个非常直接的“门”。你可以把它想象成一个“音量旋钮”。
在前馈网络中,输入 x 会被送到两个并行的线性层,产生两个输出 A 和 B:
- 内容向量 (Content Vector) A: 这是主要的、携带信息的数据流。
- 门控向量 (Gate Vector) B: 这个向量经过 Swish/SiLU 激活函数后,将决定内容向量 A 中有多少信息可以通过。
最后,将 A 和 Swish(B) 进行元素级相乘 (element-wise multiplication)。如果 Swish(B) 中某个元素接近 0,那么 A 中对应位置的信息就会被“静音”;如果 Swish(B) 中某个元素值较大,A 中对应的信息就会被放大或通过。
Swish (或 SiLU) 本身也是一个激活函数,其公式是 x * sigmoid(x)。它被选为门控函数是因为它平滑、非单调,并且在实践中表现出色。
数学公式
一个标准的 SwiGLU 前馈网络层通常由三个线性层组成:
- 上投影/门投影层 (gate_proj 和 up_proj): 将输入 x 投影到更高的中间维度。
- 下投影层 (down_proj): 将结果投影回原始维度。
![image]()
其中:
- x 是输入。
- 是三个线性层的权重矩阵。
- 是sigmod函数
- ⊙ 代表元素级相乘。
https://zhuanlan.zhihu.com/p/31289994147
|
Python
import torch
import torch.nn as nn
import torch.nn.functional as F
class SwiGLU_FFN(nn.Module):
def __init__(self, in_features, hidden_features, out_features):
super().__init__()
# 通常 hidden_features 会被设置为 in_features 的倍数,
# 例如 4 * in_features。为了保持参数量与标准 FFN 相似,
# LLaMA 等模型会使用 2/3 * (4 * in_features) 的技巧。
# 这里为了清晰,我们直接使用 hidden_features。
self.gate_proj = nn.Linear(in_features, hidden_features, bias=False)
self.up_proj = nn.Linear(in_features, hidden_features, bias=False)
self.down_proj = nn.Linear(hidden_features, out_features, bias=False)
def forward(self, x):
# x.shape: [batch_size, seq_len, in_features]
# 门控向量
gate = self.gate_proj(x)
# gate.shape: [batch_size, seq_len, hidden_features]
# 内容向量
up = self.up_proj(x)
# up.shape: [batch_size, seq_len, hidden_features]
# 核心操作:应用 SiLU (Swish) 到门控上,然后与内容相乘
fused_gate_up = F.silu(gate) * up
# fused_gate_up.shape: [batch_size, seq_len, hidden_features]
# 投影回原始维度
output = self.down_proj(fused_gate_up)
# output.shape: [batch_size, seq_len, out_features]
return output
# 使用示例
in_dim = 64
hidden_dim = 128
out_dim = 64
swiglu_ffn = SwiGLU_FFN(in_dim, hidden_dim, out_dim)
x = torch.randn(4, 10, in_dim) # [batch, seq_len, features]
output = swiglu_ffn(x)
print(f"Input shape: {x.shape}")
print(f"SwiGLU FFN output shape: {output.shape}")
|
- 为什么LLaMA等大模型选择SwiGLU而非GELU?
核心原因:SwiGLU在相同参数量下表现更优的实验结果(如下游任务准确率提升0.6%);门控机制减少了FFN层的冗余计算,适合长序列处理。
策略建议:采用LoRA微调(冻结大部分参数,仅训练门控相关矩阵);使用混合精度训练(FP16存储+FP32计算门控乘积)。
5. 注意力机制
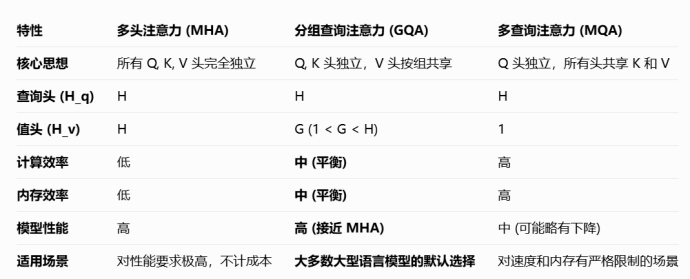
MHA (Multi-Head Attention):标准多头注意力,BLOOM、T5 等早期模型使用。每个头都有独立的查询(Q)、键(K)、值(V)矩阵,表达能力最强,但计算和显存开销最大。
GQA (Grouped-Query Attention):分组查询注意力,被 LLaMA 2/3、Mixtral、Qwen 等新一代模型广泛采用。它将查询头分组,组内共享一套 K 和 V。这是在性能和效率之间取得的绝佳平衡。
MQA (Multi-Query Attention):多查询注意力,Falcon 采用。这是 GQA 的一个极端形式,所有查询头共享同一套 K 和 V。推理速度极快,但可能带来轻微的性能损失。
在现代大语言模型(LLM)的设计中,GQA 已经成为事实上的标准,因为它能够在几乎不损失模型性能的前提下,获得与 MQA 相近的推理速度和内存优势,是目前最佳的权衡方案。
![image]()
MHA 多头注意力机制
MHA 是原始 Transformer 论文《Attention Is All You Need》中提出的标准注意力机制。它是后续所有变体的基础。
核心思想
MHA 的核心思想是“分而治之”。它没有让模型只进行一次单一的、高维度的注意力计算,而是将模型的维度(d_model)拆分成多个“头”(heads),每个头在较低的维度上并行地进行注意力计算。
这允许模型在不同的表示子空间中同时关注来自不同位置的信息。例如,一个头可能关注句法关系,另一个头可能关注语义上的近义词。最后,将所有头的输出拼接起来,通过一个线性层进行融合。
结构与公式
- 输入:查询(Query, Q)、键(Key, K)、值(Value, V)。
- 线性投影:将 Q, K, V 分别通过 h 个独立的线性层,投影成 h 组低维的 Qi,Ki,Vi。h 是头的数量。
![image]()
- 并行计算注意力:对每一个头,独立计算缩放点积注意力(Scaled Dot-Product Attention)。
![image]()
其中 dk 是每个头的维度(dk = d_model / h)。
- 拼接与融合:将所有头的输出拼接起来,再通过一个最终的线性层 WO 进行融合。
![image]()
关键点:每个头都有一套独立的 Q, K, V 权重矩阵。如果有 h 个头,就有 h 组 Q 投影矩阵、 h 组 K 投影矩阵和 h 组 V 投影矩阵。
|
Python
import torch
import torch.nn as nn
import math
class MultiHeadAttention(nn.Module):
def __init__(self, d_model, num_heads):
super().__init__()
assert d_model % num_heads == 0, "d_model must be divisible by num_heads"
self.d_model = d_model
self.num_heads = num_heads
self.d_k = d_model // num_heads
# MHA: 每个头都有自己的 Q, K, V 投影权重
# 这里用一个大的线性层实现,然后分割,效率更高
self.wq = nn.Linear(d_model, d_model)
self.wk = nn.Linear(d_model, d_model)
self.wv = nn.Linear(d_model, d_model)
self.wo = nn.Linear(d_model, d_model)
def forward(self, q, k, v, mask=None):
batch_size, seq_len, _ = q.shape
# 1. 线性投影
# (batch_size, seq_len, d_model)
q = self.wq(q)
k = self.wk(k)
v = self.wv(v)
# 2. 拆分成多个头
# (batch_size, seq_len, num_heads, d_k) -> (batch_size, num_heads, seq_len, d_k)
q = q.view(batch_size, seq_len, self.num_heads, self.d_k).transpose(1, 2)
# view是维度重塑,transpose 是维度交换
# view是维度重塑, reshape实际上是,调用contiguous()让张量变为连续内存存储,然后调用view
k = k.view(batch_size, seq_len, self.num_heads, self.d_k).transpose(1, 2)
v = v.view(batch_size, seq_len, self.num_heads, self.d_k).transpose(1, 2)
# 3. 计算注意力分数
# (batch_size, num_heads, seq_len, d_k) @ (batch_size, num_heads, d_k, seq_len) -> (batch_size, num_heads, seq_len, seq_len)
attn_scores = (q @ k.transpose(-2, -1)) / math.sqrt(self.d_k)
# @ 是矩阵乘法
if mask is not None:
attn_scores = attn_scores.masked_fill(mask == 0, -1e9)
attn_weights = torch.softmax(attn_scores, dim=-1)
# 4. 应用注意力权重到 V
# (batch_size, num_heads, seq_len, seq_len) @ (batch_size, num_heads, seq_len, d_k) -> (batch_size, num_heads, seq_len, d_k)
output = attn_weights @ v
# 5. 拼接头并进行最终线性变换
# (batch_size, num_heads, seq_len, d_k) -> (batch_size, seq_len, num_heads, d_k) -> (batch_size, seq_len, d_model)
output = output.transpose(1, 2).contiguous().view(batch_size, seq_len, self.d_model)
return self.wo(output)
|
MQA 多查询注意力机制
MQA 是对 MHA 的一种简化,旨在解决 MHA 在推理时的一个巨大瓶颈:KV 缓存(KV Cache)。
在自回归生成(autoregressive decoding)任务中,模型每生成一个新 token,都需要将这个新 token 的 Key 和 Value 与之前所有 token 的 Key 和 Value 拼接起来。对于 MHA,你需要为 每个头 都存储和加载一套 K 和 V。这导致了巨大的内存带宽消耗。
核心思想
MQA 提出,多个 Query 头可以 共享同一组 Key 和 Value 投影。
- Query (Q):仍然有 h 个独立的头,和 MHA 一样。
- Key (K) 和 Value (V):不再有 h 个头,而是 只有 1 个头,这个头被所有的 Query 头共享。
优势与劣势
○ 大幅减少 KV 缓存大小:KV 缓存的大小从 [batch, num_heads, seq_len, d_k] 变为 [batch, 1, seq_len, d_k],减少为原来的 1/h。
○ 显著提升推理速度:内存带宽是 LLM 推理的主要瓶颈,减少 KV 缓存的读写量可以极大地加速生成过程。
○ 可能导致模型质量下降:所有 Query 头被迫从同一组 K 和 V 中提取信息,模型的表达能力受到限制,可能会牺牲一些性能。
|
Python
class MultiQueryAttention(nn.Module):
def __init__(self, d_model, num_heads):
super().__init__()
assert d_model % num_heads == 0
self.d_model = d_model
self.num_heads = num_heads
self.d_k = d_model // num_heads
self.wq = nn.Linear(d_model, d_model) # Q 仍然有 num_heads 个头
# MQA: K 和 V 共享一个头
self.wk = nn.Linear(d_model, self.d_k)
self.wv = nn.Linear(d_model, self.d_k)
self.wo = nn.Linear(d_model, d_model)
def forward(self, q, k, v, mask=None):
batch_size, seq_len, _ = q.shape
# 投影 Q,并拆分成多个头
q = self.wq(q)
q = q.view(batch_size, seq_len, self.num_heads, self.d_k).transpose(1, 2)
# 投影 K 和 V,它们只有一个头
# (batch_size, seq_len, d_k) -> (batch_size, 1, seq_len, d_k)
k = self.wk(k).view(batch_size, seq_len, 1, self.d_k).transpose(1, 2)
v = self.wv(v).view(batch_size, seq_len, 1, self.d_k).transpose(1, 2)
# K 和 V 的头维度是 1,在计算注意力时会自动广播 (broadcast) 到 num_heads
# (batch_size, num_heads, seq_len, d_k) @ (batch_size, 1, d_k, seq_len) -> (batch_size, num_heads, seq_len, seq_len)
attn_scores = (q @ k.transpose(-2, -1)) / math.sqrt(self.d_k)
if mask is not None:
attn_scores = attn_scores.masked_fill(mask == 0, -1e9)
attn_weights = torch.softmax(attn_scores, dim=-1)
# (batch_size, num_heads, seq_len, seq_len) @ (batch_size, 1, seq_len, d_k) -> (batch_size, num_heads, seq_len, d_k)
output = attn_weights @ v
output = output.transpose(1, 2).contiguous().view(batch_size, seq_len, self.d_model)
return self.wo(output)
|
GQA分组查询注意力
GQA 是 MHA 和 MQA 之间的一个折衷方案,旨在 同时获得 MQA 的高效率和 MHA 的高质量。它被用于 Llama 2、Mistral 等先进模型中。
核心思想
GQA 将 Query 头分成 g 个组,每个组内的所有 Query 头共享同一组 Key 和 Value 投影。
- 假设有 h 个 Query 头。
- 假设有 g 个 Key/Value 头(也叫 KV 头)。
- 要求 h 必须是 g 的整数倍。
- h/g 个 Query 头会共享同一套 KV 投影。
两个极端情况:
- 当 g=h 时,GQA 等价于 MHA(每个 Q 头都有自己的 KV 头)。
- 当 g=1 时,GQA 等价于 MQA(所有 Q 头共享一个 KV 头)。
优势与劣势
○ 在模型质量上,远超 MQA,非常接近 MHA 的水平。
○ 在推理速度和内存占用上,远优于 MHA,接近 MQA 的水平。
○ 提供了一个可以在性能和效率之间灵活权衡的旋钮(参数 g)。
○ 实现比 MQA 稍微复杂一点。
|
Python
class GroupedQueryAttention(nn.Module):
def __init__(self, d_model, num_q_heads, num_kv_heads):
super().__init__()
assert d_model % num_q_heads == 0
assert num_q_heads % num_kv_heads == 0
self.d_model = d_model
self.num_q_heads = num_q_heads
self.num_kv_heads = num_kv_heads
self.num_groups = num_q_heads // num_kv_heads
self.d_k = d_model // num_q_heads
self.wq = nn.Linear(d_model, d_model)
# GQA: 有 num_kv_heads 组 K, V
self.wk = nn.Linear(d_model, self.num_kv_heads * self.d_k)
self.wv = nn.Linear(d_model, self.num_kv_heads * self.d_k)
self.wo = nn.Linear(d_model, d_model)
def repeat_kv(self, x, num_reps):
# x: (batch_size, num_kv_heads, seq_len, d_k)
# -> (batch_size, num_kv_heads, 1, seq_len, d_k)
# -> (batch_size, num_kv_heads, num_reps, seq_len, d_k)
# -> (batch_size, num_q_heads, seq_len, d_k)
batch_size, _, seq_len, d_k = x.shape
x = x.unsqueeze(2).expand(batch_size, self.num_kv_heads, num_reps, seq_len, d_k)
return x.reshape(batch_size, self.num_q_heads, seq_len, d_k)
def forward(self, q, k, v, mask=None):
batch_size, seq_len, _ = q.shape
# 投影 Q,并拆分成 num_q_heads 个头
q = self.wq(q).view(batch_size, seq_len, self.num_q_heads, self.d_k).transpose(1, 2)
# 投影 K 和 V,拆分成 num_kv_heads 个头
k = self.wk(k).view(batch_size, seq_len, self.num_kv_heads, self.d_k).transpose(1, 2)
v = self.wv(v).view(batch_size, seq_len, self.num_kv_heads, self.d_k).transpose(1, 2)
# 将 KV 头重复以匹配 Q 头的分组
k = self.repeat_kv(k, self.num_groups)
v = self.repeat_kv(v, self.num_groups)
# (batch_size, num_q_heads, seq_len, d_k) @ (batch_size, num_q_heads, d_k, seq_len) -> (batch_size, num_q_heads, seq_len, seq_len)
attn_scores = (q @ k.transpose(-2, -1)) / math.sqrt(self.d_k)
if mask is not None:
attn_scores = attn_scores.masked_fill(mask == 0, -1e9)
attn_weights = torch.softmax(attn_scores, dim=-1)
output = attn_weights @ v
output = output.transpose(1, 2).contiguous().view(batch_size, seq_len, self.d_model)
return self.wo(output)
|


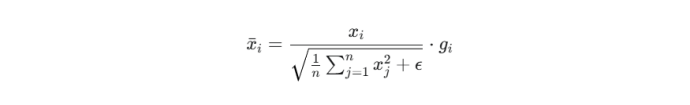
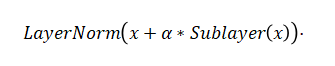
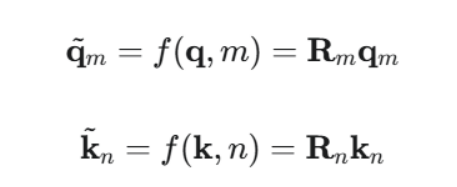
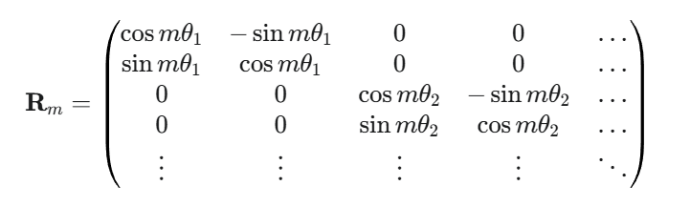
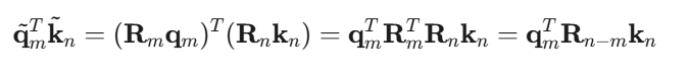
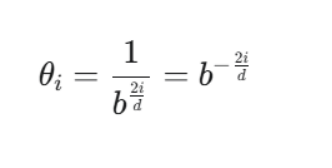
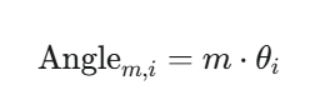
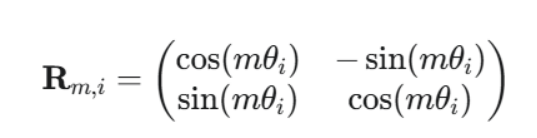
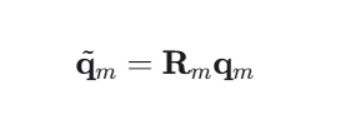
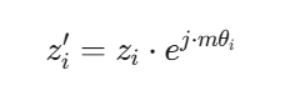
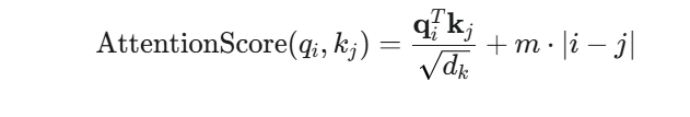
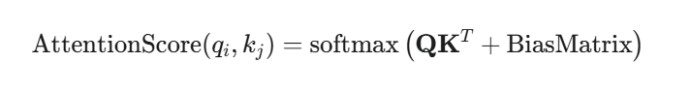
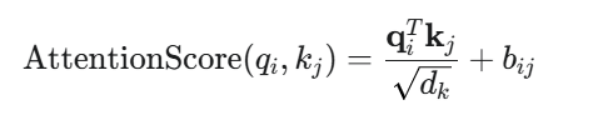
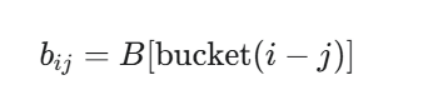
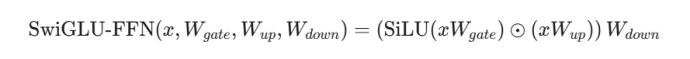
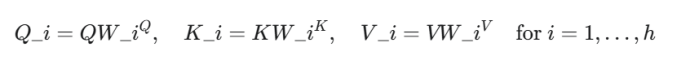
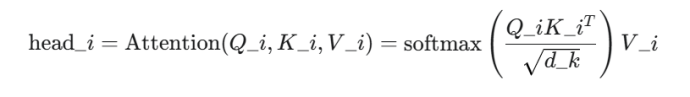
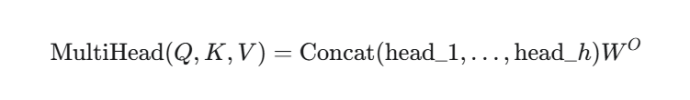

 浙公网安备 33010602011771号