
Job Completion G & 「JSOI2007」建筑抢修 题解——反悔贪心
Job Completion G & 「JSOI2007」建筑抢修
这两道题几乎是一模一样所以就一起写了。反正我是看不懂洛谷上的题解,所以为了造福和我一样的后人,写一篇题解。
题目大意
有 \(N(1 \leq N \leq 2 \times 10^5)\) 项任务需要处理。
对于第 \(i\) 项任务,如果要做它,最晚在时刻 \(s_i\) 开始,并且从开始到做完需要连续不间断地花 \(t_i\) 个单位时间。(可以放弃任务)
求最多能完整做完多少项任务。
大致思路
使用贪心。题解里面说是反悔贪心自动机,不过我们不需要管那些高大上的名词,当成普通贪心做就好。
首先预处理出每个区间的最晚结束时间并升序排序,这是显然的。(具体原因去看洛谷题解)然后按照“早结束的先做”的策略贪心,就可以最大限度减少冲突。
但是,如果区间一定会产生冲突,显然就不能直接按照“早结束的先做”的策略贪了,因为会有这样的情况:
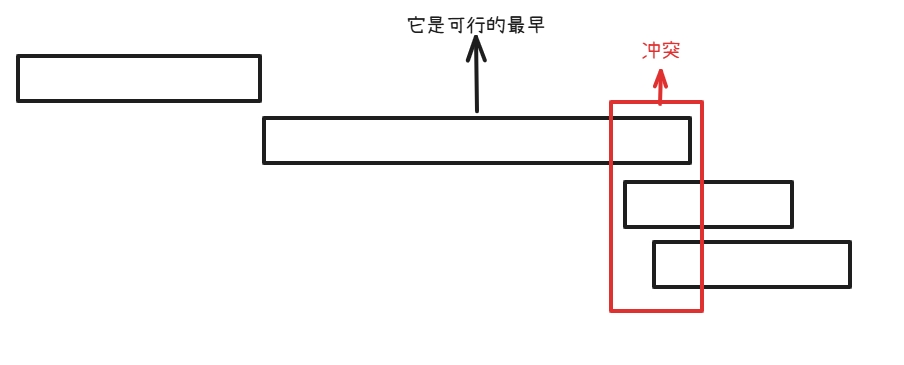
此时,不选择中间那个长区间而选择后面的两个短区间,比选择长区间更优。
那么,就引出了一个问题,当有两个区间必定会冲突时,我们该如何选择?
冲突处理
注意到 我们注意力惊人 如果选择了某个结束时间较当前区间早,但消耗时间较当前区间长的区间,一定不优于放弃那个区间选择当前区间。
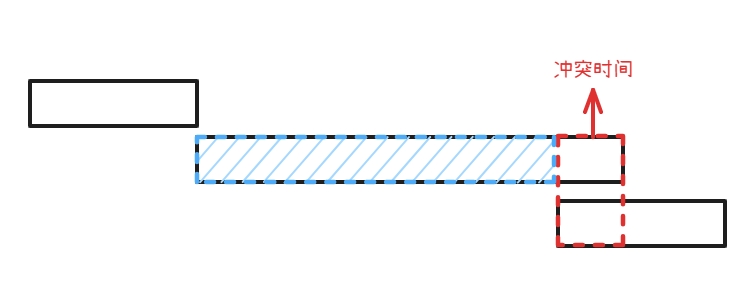
如上图,蓝色部分是被浪费掉的,舍弃长区间后可以让短区间直接接在上一个区间后面,从而节约时间。(舍弃后如下图)
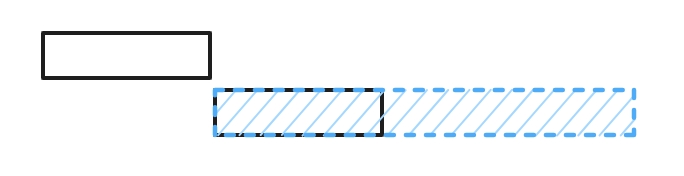
显然,长区间和当前区间不相邻时也可以。
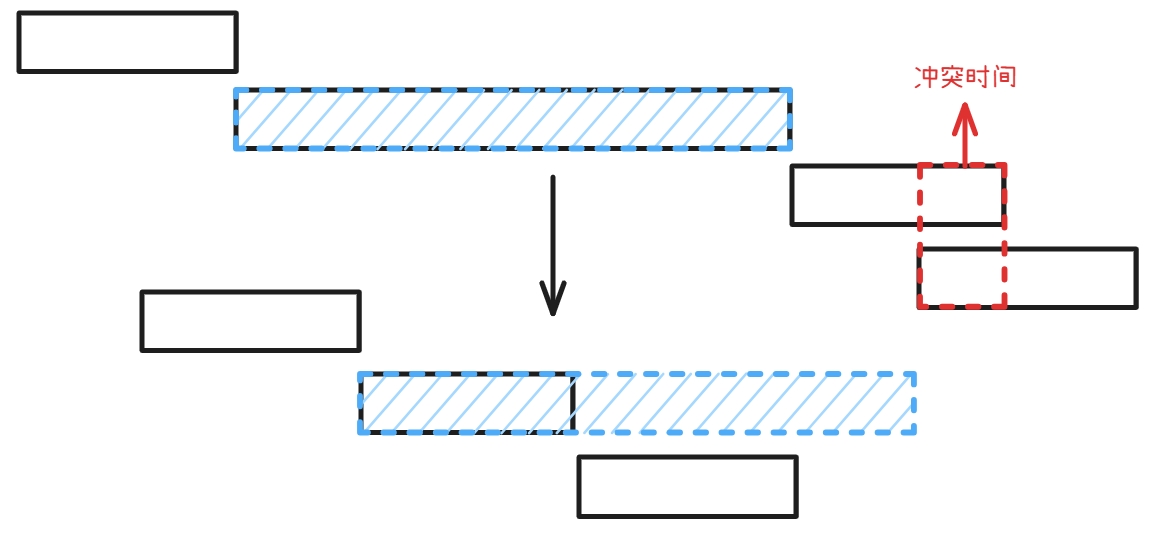
那么再显然一下,发生冲突时,找前面耗时最长的区间放弃是最优的。
正确性证明:前面耗时最长的区间,它的耗时一定大于等于当前区间,而前面的区间又都是已经完成的,所以删除前面的区间一定能够保证当前区间能够合法完成。
算法流程
用大根堆实现。
先将所有区间按最大结束时间升序,然后遍历 \(n\) 个区间。假设当前遍历到了第 \(i\) 个区间。
先将 \(i\) 的耗时加入堆中。
若区间 \(i\) 本身就不冲突,则直接统计答案;若冲突,则弹出堆顶耗时最大的区间,注意这里不要统计答案。
为什么要先将 \(i\) 的耗时加入堆中?这样写为什么是对的?
简化代码。正确性分情况说明。
若 \(i\) 没有冲突,则 \(i\) 的耗时本来就是要放入堆中的,没有问题。
若 \(i\) 有冲突:
- 若已完成的区间中存在比 \(i\) 耗时长的区间, 逻辑上弹出那个区间然后将 \(i\) 加入堆,代码中仅仅是先加入,没有问题。
- 若已完成的区间中不存在比 \(i\) 耗时长的区间,那 \(i\) 逻辑上不入堆,代码中先入堆然后又被弹出,没有问题。
AC代码
#include <bits/stdc++.h>
using namespace std;
#define ll long long
const int N=2e5+5;
struct node{
	ll s;
	ll t;
	ll ed;
};
node a[N];
vector<int>path;
int n,ans;
bool cmp(node a,node b){
	return a.ed<b.ed;
}
int main(){
	ios::sync_with_stdio(false);
	cin.tie(0);
	cin>>n;
	for(int i=1;i<=n;i++){
		cin>>a[i].s>>a[i].t;
	}
	//发明反悔贪心?
	//预处理最晚结束时间
	for(int i=1;i<=n;i++){
		a[i].ed=a[i].s+a[i].t;
	}
	sort(a+1,a+n+1,cmp);
	priority_queue<ll>pq;
	ll tim=0;
	for(int i=1;i<=n;i++){
		//放入堆
		pq.push(a[i].t);
		if(tim+a[i].t<=a[i].ed){
			//可以进行
			ans++;
			tim+=a[i].t;
		}
		else{
			//一定冲突
			//放弃最长的
			tim=tim-pq.top()+a[i].t;
			pq.pop();
		}
	}
	cout<<ans;
	return 0;
}

 浙公网安备 33010602011771号