
ML之多元线性回归
转自:http://www.cnblogs.com/zgw21cn/archive/2009/01/07/1361287.html
1、多元线性回归模型
假定被解释变量 与多个解释变量
 之间具有线性关系,是解释变量的多元线性函数,称为多元线性回归模型。即
 (1.1)
其中 为被解释变量,
 为
 个解释变量,
 为
 个未知参数,
 为随机误差项。
被解释变量 的期望值与解释变量
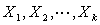 的线性方程为:
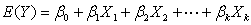 (1.2)
称为多元总体线性回归方程,简称总体回归方程。
对于 组观测值
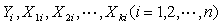 ,其方程组形式为:
 (1.3)
即
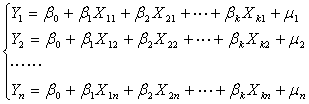
其矩阵形式为
 =

 +

即
 (1.4)
其中

 为被解释变量的观测值向量;

 为解释变量的观测值矩阵;

 为总体回归参数向量;

 为随机误差项向量。
总体回归方程表示为:
 (1.5)
多元线性回归模型包含多个解释变量,多个解释变量同时对被解释变量 发生作用,若要考察其中一个解释变量对
 的影响就必须假设其它解释变量保持不变来进行分析。因此多元线性回归模型中的回归系数为偏回归系数,即反映了当模型中的其它变量不变时,其中一个解释变量对因变量
 的均值的影响。
由于参数 都是未知的,可以利用样本观测值
 对它们进行估计。若计算得到的参数估计值为
 ,用参数估计值替代总体回归函数的未知参数
 ,则得多元线性样本回归方程:
 (1.6)
其中 为参数估计值,
 为
 的样本回归值或样本拟合值、样本估计值。
其矩阵表达形式为:
 (1.7)
其中
 为被解释变量样本观测值向量
 的
 阶拟合值列向量;

 为解释变量
 的
 阶样本观测矩阵;


 为未知参数向量
 的
 阶估计值列向量。
样本回归方程得到的被解释变量估计值 与实际观测值
 之间的偏差称为残差
 。
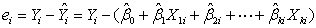 (1.8)
2、多元线性回归模型的假定
与一元线性回归模型相同,多元线性回归模型利用普通最小二乘法(OLS)对参数进行估计时,有如下假定:
假定1 零均值假定: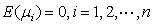 ,即
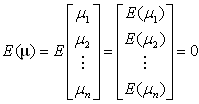 (2.1)
假定2 同方差假定( 的方差为同一常数):
 (2.2)
假定3 无自相关性:
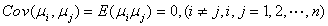
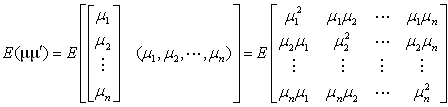
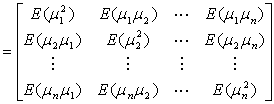
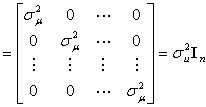 (2.3)
假定4 随机误差项 与解释变量
 不相关(这个假定自动成立):
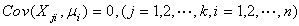 (2.4)
假定5 随机误差项 服从均值为零,方差为
 的正态分布:
 (2.5)
假定6 解释变量之间不存在多重共线性:

即各解释变量的样本观测值之间线性无关,解释变量的样本观测值矩阵 的秩为参数个数k+1,从而保证参数
 的估计值唯一。
3、多元线性回归模型的参数估计
3.1回归参数的最小二乘估计
对于含有 个解释变量的多元线性回归模型
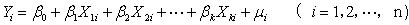
设 分别作为参数
 的估计量,得样本回归方程为:
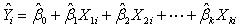
观测值 与回归值
 的残差
 为:

由最小二乘法可知 应使全部观测值
 与回归值
 的残差
 的平方和最小,即使

 (3.1)
取得最小值。根据多元函数的极值原理, 分别对
 求一阶偏导,并令其等于零,即
 (3.2)
即

化简得下列方程组
 (3.3)
上述 个方程称为正规方程,其矩阵形式为
 (3.4)
因为


设 为估计值向量
样本回归模型 两边同乘样本观测值矩阵
 的转置矩阵
 ,则有

得正规方程组:
 (3.5)
由假定(6), ,
 为
 阶方阵,所以
 满秩,
 的逆矩阵
 存在。因而
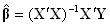 (3.6)
则为向量 的OLS估计量。
以二元线性回归模型为例,导出二元线性回归模型的OLS估计量的表达式。由(1.3)式得二元线性回归模型为
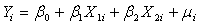
为了计算的方便,先将模型中心化。
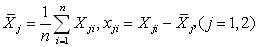

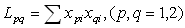
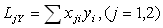

设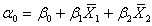 ,则二元回归模型改写为中心化模型。
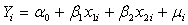 (3.7)
记
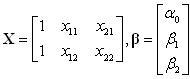
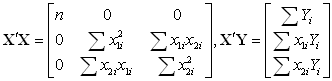 (3.8)
将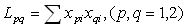 代入得
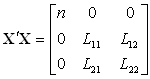 (3.9)
因为

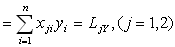 (3.10)
则

由(3.6)式得
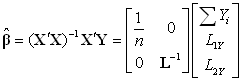 (3.11)
其中

由(3.11)式可知


得
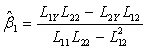 (3.12)
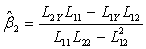 (3.13)
 (3.14)
3.2随机误差项![]() 的方差
![]() 的估计量
 的方差
 的估计量
样本回归方程得到的被解释变量估计值 与实际观测值
 之间的偏差称为残差


则

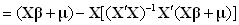

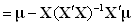
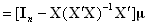
设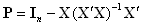 ,可以得出
 是
 阶对称幂等矩阵,
 ,
 。于是

而残差的平方和为

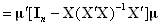
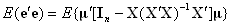
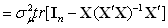
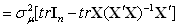
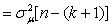
其中" "表示矩阵的迹,即矩阵主对角线元素的和。于是

随机误差项 的方差
 的无偏估计量,记作
 ,即
 ,
 ,
 为残差的标准差(或回归标准差)。
因此
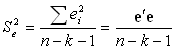 (3.15)
其中
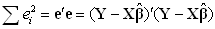
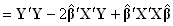
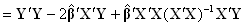
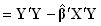 (3.16)
例如,对于二元线性回归模型( )
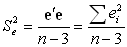 (3.17)
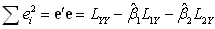
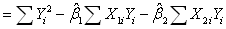 (3.18)
3.3、估计参数的统计性质
1、线性性
指最小二乘估计量 是被解释变量的观测值
 的线性函数。
由于
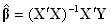
设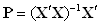 ,则矩阵
 为一非随机的
 阶常数矩阵。所以
 (3.19)
显然最小二乘估计量 是被解释变量的观测值
 的线性函数。
2、无偏性
将 代入(3-16)式得

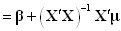 (3.20)
则

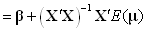

所以 是
 的无偏估计量。
3.最小方差性
设 为
 阶数值矩阵,
 为
 阶随机矩阵(随机变量为元素的矩阵),
 为
 阶数值矩阵,则
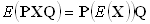
下面推导 的方差、协方差矩阵。
定义: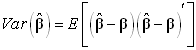
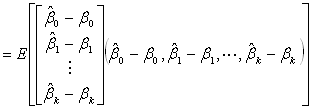
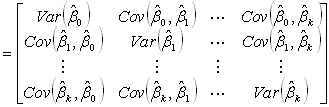
由(3.20)式得
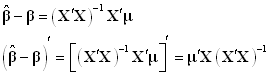
所以
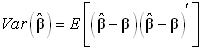
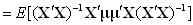
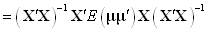

 (3.21)
这个矩阵主对角线上的元素表示 的方差,非主对角线上的元素表示
 的协方差。例如
 是位于
 的第
 行与第
 列交叉处的元素(主对角线上的元素);
 是位于
 的第
 行与第
 列交叉处的元素(非主对角线上的元素)
在应用上,我们关心的 的方差,而忽略协方差,因此把(3.21)式记作
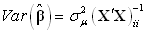 (3.22)
记 ,则
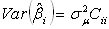 ,所以
 是
 的最小方差线性无偏估计。这说明,在(1.1)式系数的无偏估计量中,OLS估计量的方差比用其它估计方法所得的无偏估计量的方差都要小,这正是OLS的优越性所在。
用 代替
 则得
 的标准估计量的估计值,乃称为标准差。
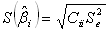 (3.23)
其中

对于二元回归模型( ),求估计量
 的方差,由(3.22)式得
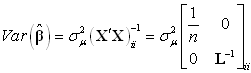
其中

于是

所以
 (3.24)
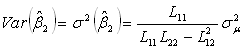 (3.25)
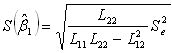 (3.26)
 (3.27)
其中

4. 显著性检验
4.1 拟合优度检验
4.1.1总离差平方和分解
设具有 个解释变量的回归模型为
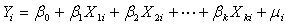
其回归方程为

离差分解:
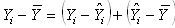
总离差平方和分解式为:
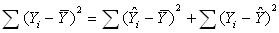 (4.1)
即
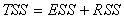 (4.2)总离差平方和分解为回归平方和与残差平方和两部分。
 体现了观测值
 总波动大小,称为总偏差平方和,记作TSS.
 体现了n个估计值
 的波动大小,它是由于Y与自变量
 的变化而引起,被称作为回归平方和,记为ESS(Explained Sum of Squares)或U;
 称为残差平方和,记为RSS(Residual Sum of Squares)或Q.
4.1.2样本决定系数
对于多元回归方程,其样本决定系数为复决定系数或多重决定系数。
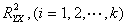 ,简记为
 。
 (4.3)
根据式(4.2)
 (4.4)
因为
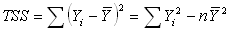
由(3.16)式知
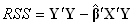
所以
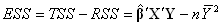
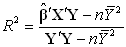 (4.5)
 作为检验回归方程与样本值拟合优度的指标:

 越大,表示回归方程与样本拟合的越好;反之,回归方程与样本值拟合较差。
具体的,当 时,求样本决定系数
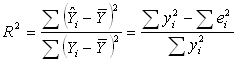
由(3.8)式,得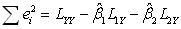 ,因此有
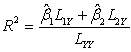 (4.6)
4.1.3调整后的样本决定系数
在使用 时,容易发现
 的大小与模型中的解释变量的数目有关。如果模型中增加一个新解释变量,总离差
 不会改变,但总离差中由解释变量解释的部分,即回归平方和
 将会增加,这就是说
 与模型中解释变量个数有关。但通过增加模型中解释变量的数目而使
 增大是错误的,显然这样
 来检验被回归方程与样本值拟合优度是不合适的,需要对
 进行调整,使它不但能说明已被解释离差与总离差的关系,而且又能说明自由度的数目。
以 表示调整样本决定系数,
 (4.7)
其中

这里 是残差平方和的自由度,
 是总离差平方和的自由度。
由(4.7)式得
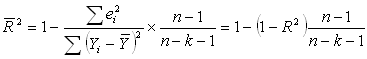
其中, 是样本观测值的个数,
 是解释变量的个数。从式中可以看出,当增加一个解释变量时,由前面分析可知
 会增加,引起
 减少,而
 增加,因而
 不会增加。这样用
 判定回归方程拟合优度,就消除了
 对解释变量个数的依赖。
 或
 只能说明在给定的样本条件下回归方程与样本观测值拟合优度,并不能做出对总体模型的推测,因此不能单凭
 或
 来选择模型,必须对回归方程和模型中各参数的估计量做显著性检验。
4.2方程显著性检验
由离差平方和分解(4.2)式可知,总离差平方和 的自由度为
 ,回归平方和
 是由
 个解释变量
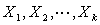 对
 的线性影响决定的。因此它的自由度为
 。所以,残差平方和的自由度由总离差平方和的自由度减去回归平方和的自由度,即为
 。
检验回归方程是否显著,
第一步,作出假设
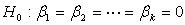
备择假设H1:b1 、 b2 、…、bk不同时为0
第二步,在 成立的条件下,计算统计量

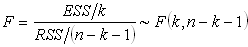
第三步,查表临界值
对于假设 ,根据样本观测值计算统计量
 给定显著水平
 ,查第一个自由度为
 ,第二个自由度为
 的
 分布表得临界值
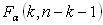 。当
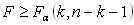 时,拒绝
 ,则认为回归方程显著成立;当
 时,接受
 ,则认为回归方程无显著意义。
4.3![]() 参数显著性检验
 参数显著性检验
回归方程显著成立,并不意味着每个解释变量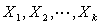 对被解释变量
 的影响都是重要的。如果某个解释变量对被解释变量
 的影响不重要,即可从回归模型中把它剔除掉,重新建立回归方程,以利于对经济问题的分析和对
 进行更准确的预测。为此需要对每个变量进行考查,如果某个解释变量
 对被解释变量
 的作用不显著,那么它在多元线性回归模型中,其前面的系数可取值为零。因此必须对
 是否为零进行显著性检验。
由(3.23)式
 (4.8)
其中

 为
 的第i个对角元素,而
 ,
 是中心化的数据阵。
对回归系数 进行显著性
 检验,步骤如下:
(1)提出原假设 ;备择假设
 。
(2)构造统计量 ,当
 成立时,统计量
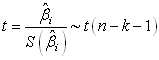 。这里
 是
 的标准差,
 为解释变量个数,计算由式(4.8)给出。
(3)给定显著性水平 ,查自由度为
 的
 分布表,得临界值
 。
(4)若 ,则拒绝
 ,接受
 ,即认为
 显著不为零。若
 ,则接受
 ,即认为
 显著为零。
5.回归变量的选择与逐步回归
5.1变量选择问题
在实际问题中,影响因变量Y的因素(自变量)很多,人们希望从中挑选出影响显著的自变量来建立回归关系式,这就涉及到自变量选择的问题。
在回归方程中若漏掉对Y影响显著的自变量,那么建立的回归式用于预测时将会产生较大的偏差。但回归式若包含的变量太多,且其中有些对Y影响不大,显然这样的回归式不仅使用不方便,而且反而会影响预测的精度。因而选择合适的变量用于建立一个"最优"的回归方程是十分重要的问题。
选择"最优"子集的变量筛选法包括逐步回归法(Stepwise),向前引入法(Forward)和向后剔除法(Backwad)。
向前引入法是从回归方程仅包括常数项开始,把自变量逐个引入回归方程。具体地说,先在m个自变量中选择一个与因变量线性关系最密切的变量,记为 ,然后在剩余的m-1个自变量中,再选一个
 ,使得
 联合起来二元回归效果最好,第三步在剩下的m-2个自变量中选择一个变量
 ,使得
 联合起来回归效果最好,...如此下去,直至得到"最优"回归方程为止。
向前引入法中的终止条件为,给定显著性水平 ,当某一个对将被引入变量的回归系数作显著性检查时,若p-value

 ,则引入变量的过程结束,所得方程即为"最优"回归方程。
向前引入法有一个明显的缺点,就是由于各自变量可能存在着相互关系,因此后续变量的选入可能会使前面已选入的自变量变得不重要。这样最后得到的"最优"回归方程可包含一些对Y影响不大的自变量。
向后剔除法与向前引入法正好相反,首先将全部m个自变量引入回归方程,然后逐个剔除对因变量Y作用不显著的自变量。具体地说,从回归式m个自变量中选择一个对Y贡献最小的自变量,比如 ,将它从回归方程中剔除;然后重新计算Y与剩下的m-1个自变量回归方程,再剔除一个贡献最小的自变量,比如
 ,依次下去,直到得到"最优"回归方程为止。向后剔除法中终止条件与向前引入法类似。
向后剔除法的缺点在于,前面剔除的变量有可能因以后变量的剔除,变为相对重要的变量,这样最后得到的"最优"回归方程中有可能漏掉相对重要的变量。
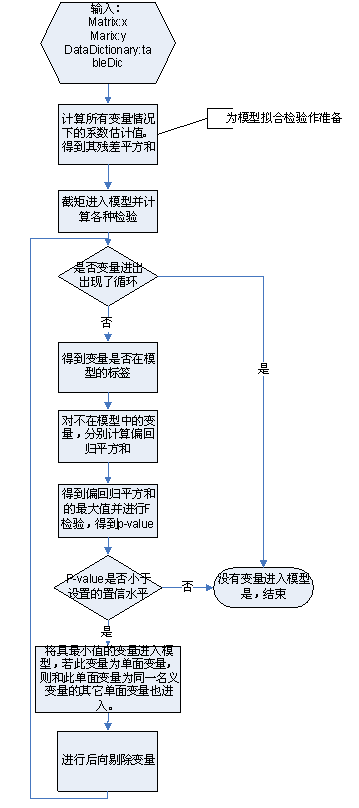
逐步回归法是上述两个方法的综合。向前引入中被选入的变量,将一直保留在方程中。向后剔除法中被剔除的变量,将一直排除在外。这两种方程在某些情况下会得到不合理的结果。于是,可以考虑到,被选入的的变量,当它的作用在新变量引入后变得微不足道时,可以将它删除;被剔除的变量,当它的作用在新变量引入情况下变得重要时,也可将它重新选入回归方程。这样一种以向前引入法为主,变量可进可出的筛选变量方法,称为逐步回归法。
5.2逐步回归分析
5.2.1基本思想
逐个引入自变量。每次引入对Y影响最显著的自变量,并对方程中的老变量逐个进行检验,把变为不显著的变量逐个从方程中剔除掉,最终得到的方程中既不漏掉对Y影响显著的变量,又不包含对Y影响不显著的变量。
5.2.2筛选的步骤
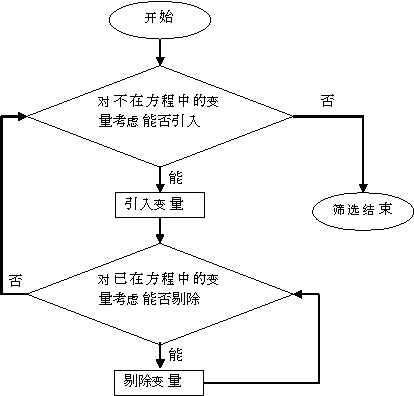
首先给出引入变量的显著性水平 和剔除变量的显著性水平
 ,然后按下图筛选变量。
5.2.3逐步筛选法的基本步骤
逐步筛选变量的过程主要包括两个基本步骤:一是从回归方程中考虑剔除不显著变量的步骤;二是从不在方程中的变量考虑引入新变量的步骤。
(1)考虑可否引入新变量的基本步骤。假设已入选r个变量,不在方程中的变量记为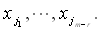
-
计算不在方程中的变量
![]() 的偏回归平方和
![]() :
 的偏回归平方和
 :
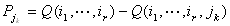 ,Q表示括号中这些变量的回归模型的残差平方和。并设
 ,即不在方程中的变量
 是对Y影响最大的变量。
-
检验变量
![]() 对Y的影响是否显著。对变量
![]() 作回归系数的显著性检验,即检验
![]() ,检验统计量为
 对Y的影响是否显著。对变量
 作回归系数的显著性检验,即检验
 ,检验统计量为
 及
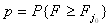 ,其中F~F(1,n-r-1).
若p< ,则引入
 ,并转入考虑可否剔除变量的步骤。若
 ,则逐步筛选变量的过程结束。
(2)考虑可否剔除变量的基本步骤。假设已引入回归方程的变量为 .
-
计算已在方程中的变量
![]() 的偏回归平方和
![]() 。
![]() 其中Q表示括号中这些变量的回归模型的残差平方和,U表示其回归平方和。设
 的偏回归平方和
 。
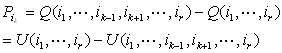 其中Q表示括号中这些变量的回归模型的残差平方和,U表示其回归平方和。设
 ,即相应的变量
 是方程中对Y影响最小的变量。
-
检验
![]() 对Y的影响是否显著。对变量
![]() 进行回归系数的显著性检验,即检验
![]() ,检验统计量为
 对Y的影响是否显著。对变量
 进行回归系数的显著性检验,即检验
 ,检验统计量为
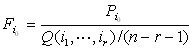 及
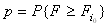 ,其中F~F(1,n-r-1)。
若p大于等于 ,则剔除
 ,重新建立Y与其余r-1个变量的回归方程,然后再检验方程中最不重要的变量可否删除,直到方程中没有变量可删除后,转入考虑能否引入新变量的步骤。
5.3流程图
(1)后向选择
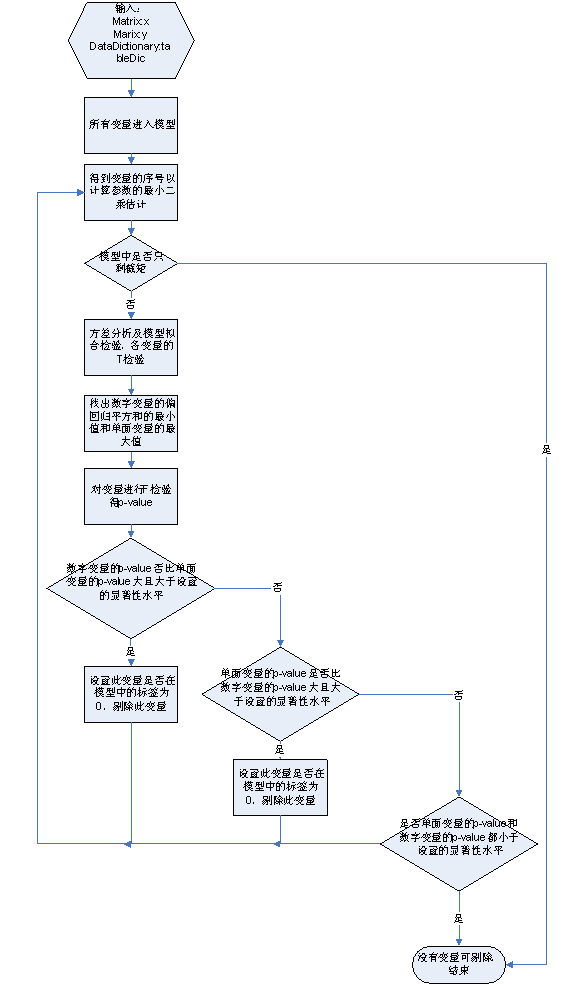
(2) 前向引入(Forward)
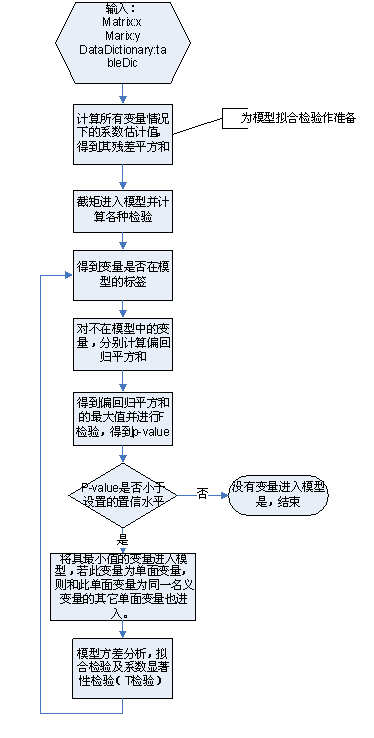
(3)逐步回归(Stepwise)

 浙公网安备 33010602011771号