
初识DPO
Bradley Terry模型
\[P(i \succ j)
= \frac{e^{s_i}}{e^{s_i} + e^{s_j}}\\e^{s_i}表示{s_i}的实力,则P(i \succ j)表示{s_i}战胜{s_j}的概率
\]
假设x为prompt,LLM的response为y,评价一个回答的好坏就是用reward model来评估即 \(r(x,y)\)
\({y_1}\)好于\({y_2}\)即表示为
\[P({y_1} \succ {y_2})
= \frac{r(x,{y_1})}{r(x,{y_1}) + r(x,{y_2})}
\]
但是r可能为负数,所以再加上exp函数,即
\[P({y_1} \succ {y_2})
= \frac {e^{r(x,{y_1})}}{e^{r(x,{y_1})} + e^{r(x,{y_2})}}
\]
对于reward模型,要想使得\({y_1}\)好于\({y_2}\),可以使用对数最大似然估计,加上负号就成了loss(最小化)
\[\begin{aligned}
\mathcal{L}
&= - \mathbb{E}_{(x, y_w, y_l)\sim \mathcal{D}}
\left[
\ln \frac{e^{\bigl(r(x, y_w)\bigr)}}
{e^{\bigl(r(x, y_w)\bigr)} + e^{\bigl(r(x, y_l)\bigr)}}
\right] \\[6pt]
&= - \mathbb{E}_{(x, y_w, y_l)\sim \mathcal{D}}
\left[
\ln \frac{1}
{1 + e^{\bigl(r(x, y_l) - r(x, y_w)\bigr)}}
\right] \\[6pt]
&= - \mathbb{E}_{(x, y_w, y_l)\sim \mathcal{D}}
\left[
\ln \, \sigma\!\left(r(x, y_w) - r(x, y_l)\right)
\right]
\end{aligned} ,{ \sigma}为sigmoid
\]
通过优化该loss,使得\({y_w}\)的reward分数大于\({y_l}\),二者分别对应DPO数据集中的chosen和rejected,这便是DPO的训练目标。(直接基于 pairwise preference 优化策略)
RLHF
RLHF的正则化目标:
\[\max_{\pi_\theta}
\;
\mathbb{E}_{x \sim \mathcal{D},\, y \sim \pi_\theta(\cdot|x)}
\big[ r(x,y) \big]
\;-\;
\beta \,
\mathrm{KL}\!\left(
\pi_\theta(\cdot|x)\;\|\;\pi_{\text{ref}}(\cdot|x)
\right)
\]
在保证策略不要偏离原模型太远的前提下,让模型生成的答案尽量“更符合人类偏好”。(最大化 reward + KL 正则)
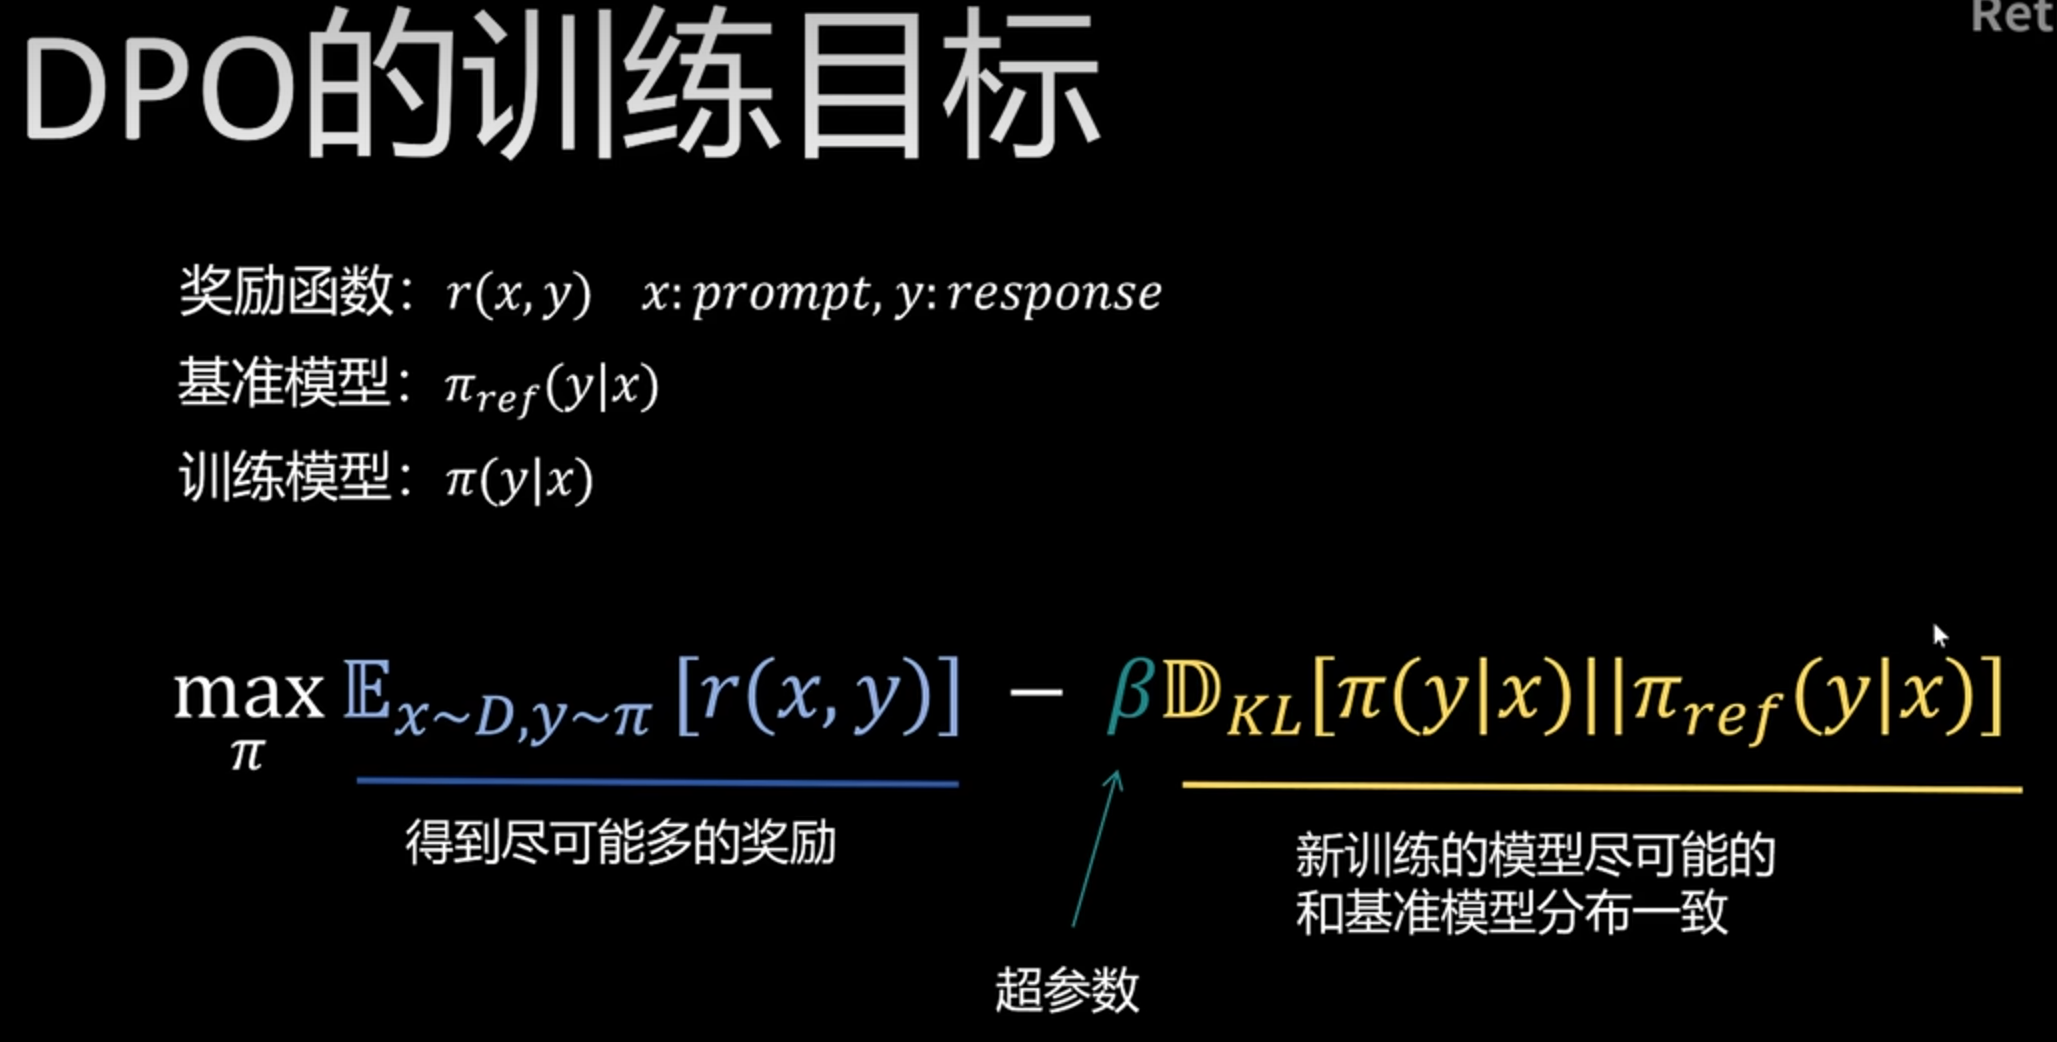
下面是推导过程,由于笔者的latex水平有限,直接贴图
根据RLHF的目标,构造了一个最优分布,并且其目标指向这个最优分布,再反推出reward公式,带入DPO的loss函数,就得到了最终形态
1、首先RLHF的目标函数化简推导
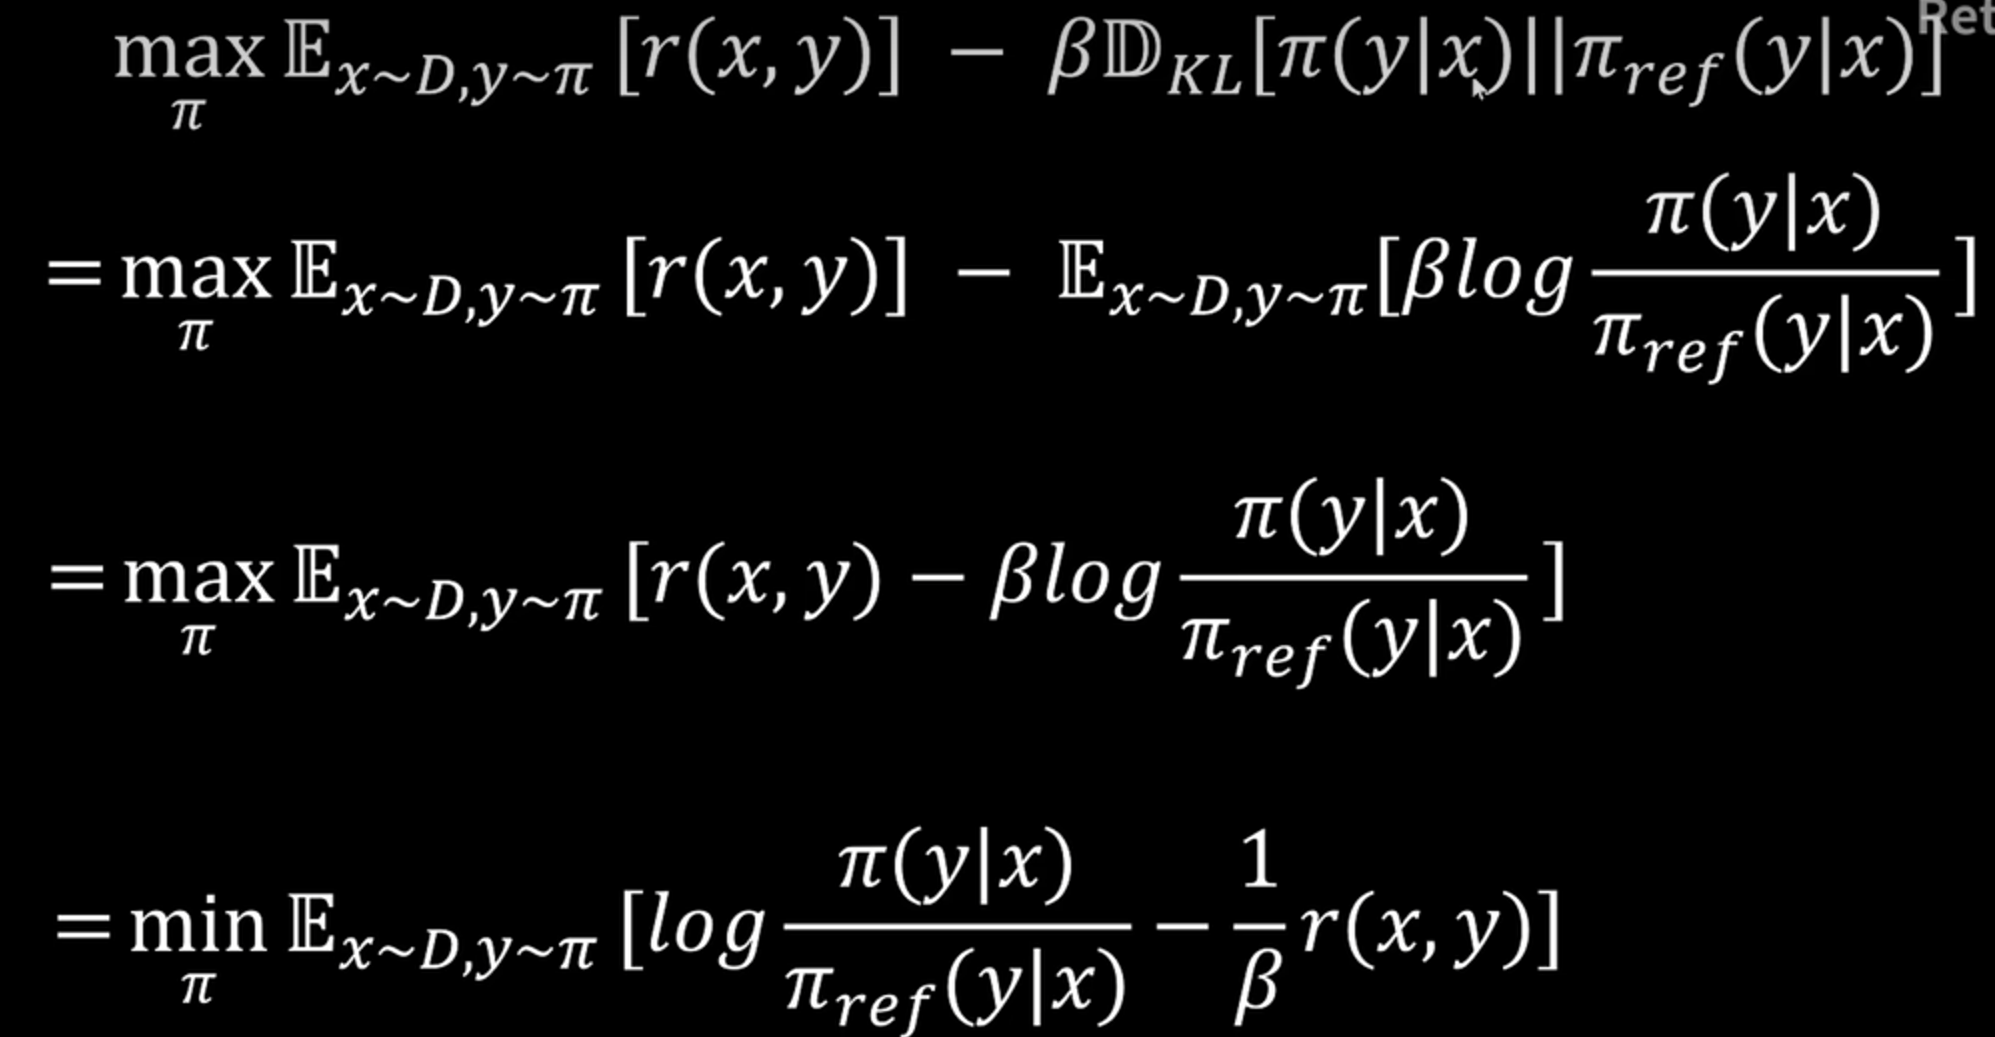
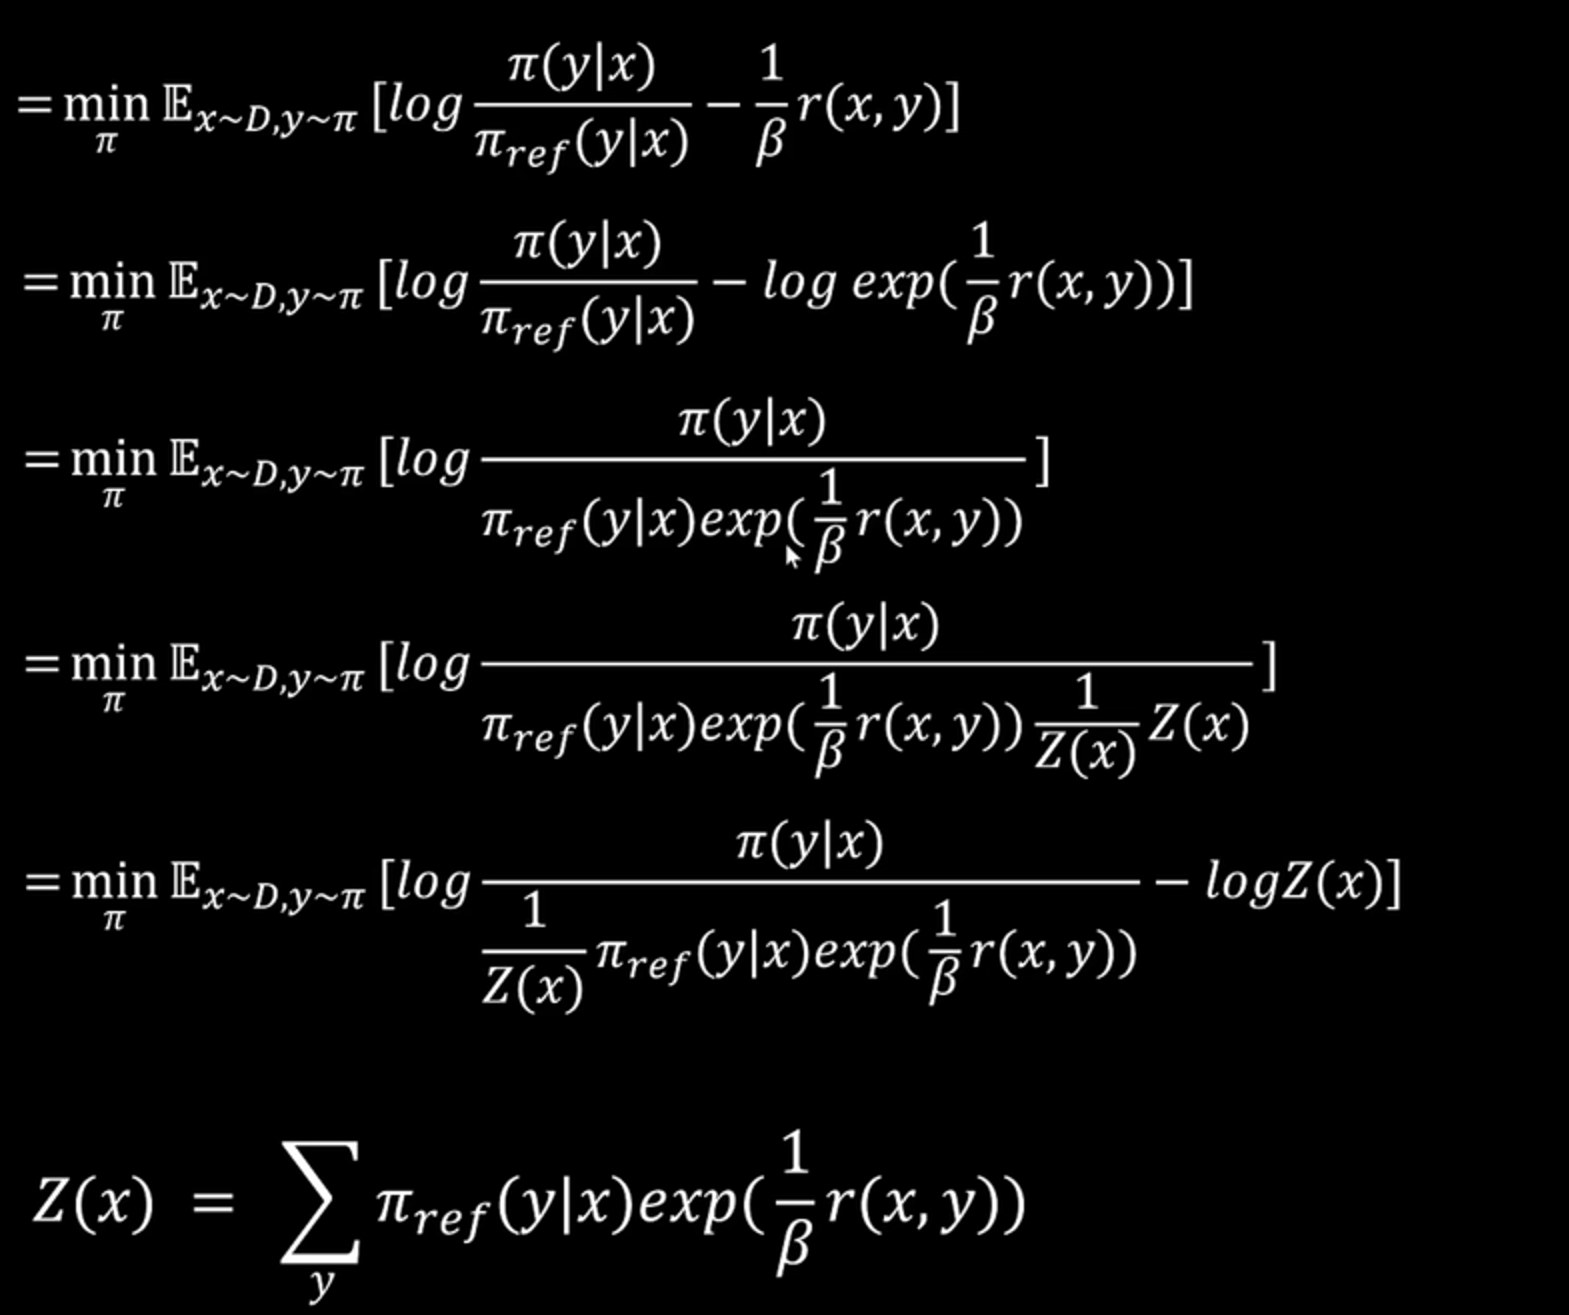
2、RLHF的最优解即最小化这个KL散度(为0)时,得到最优策略分布\(\pi^*(y\mid x)\),这是人为构造的目标分布,也是 Boltzmann 分布的形式。
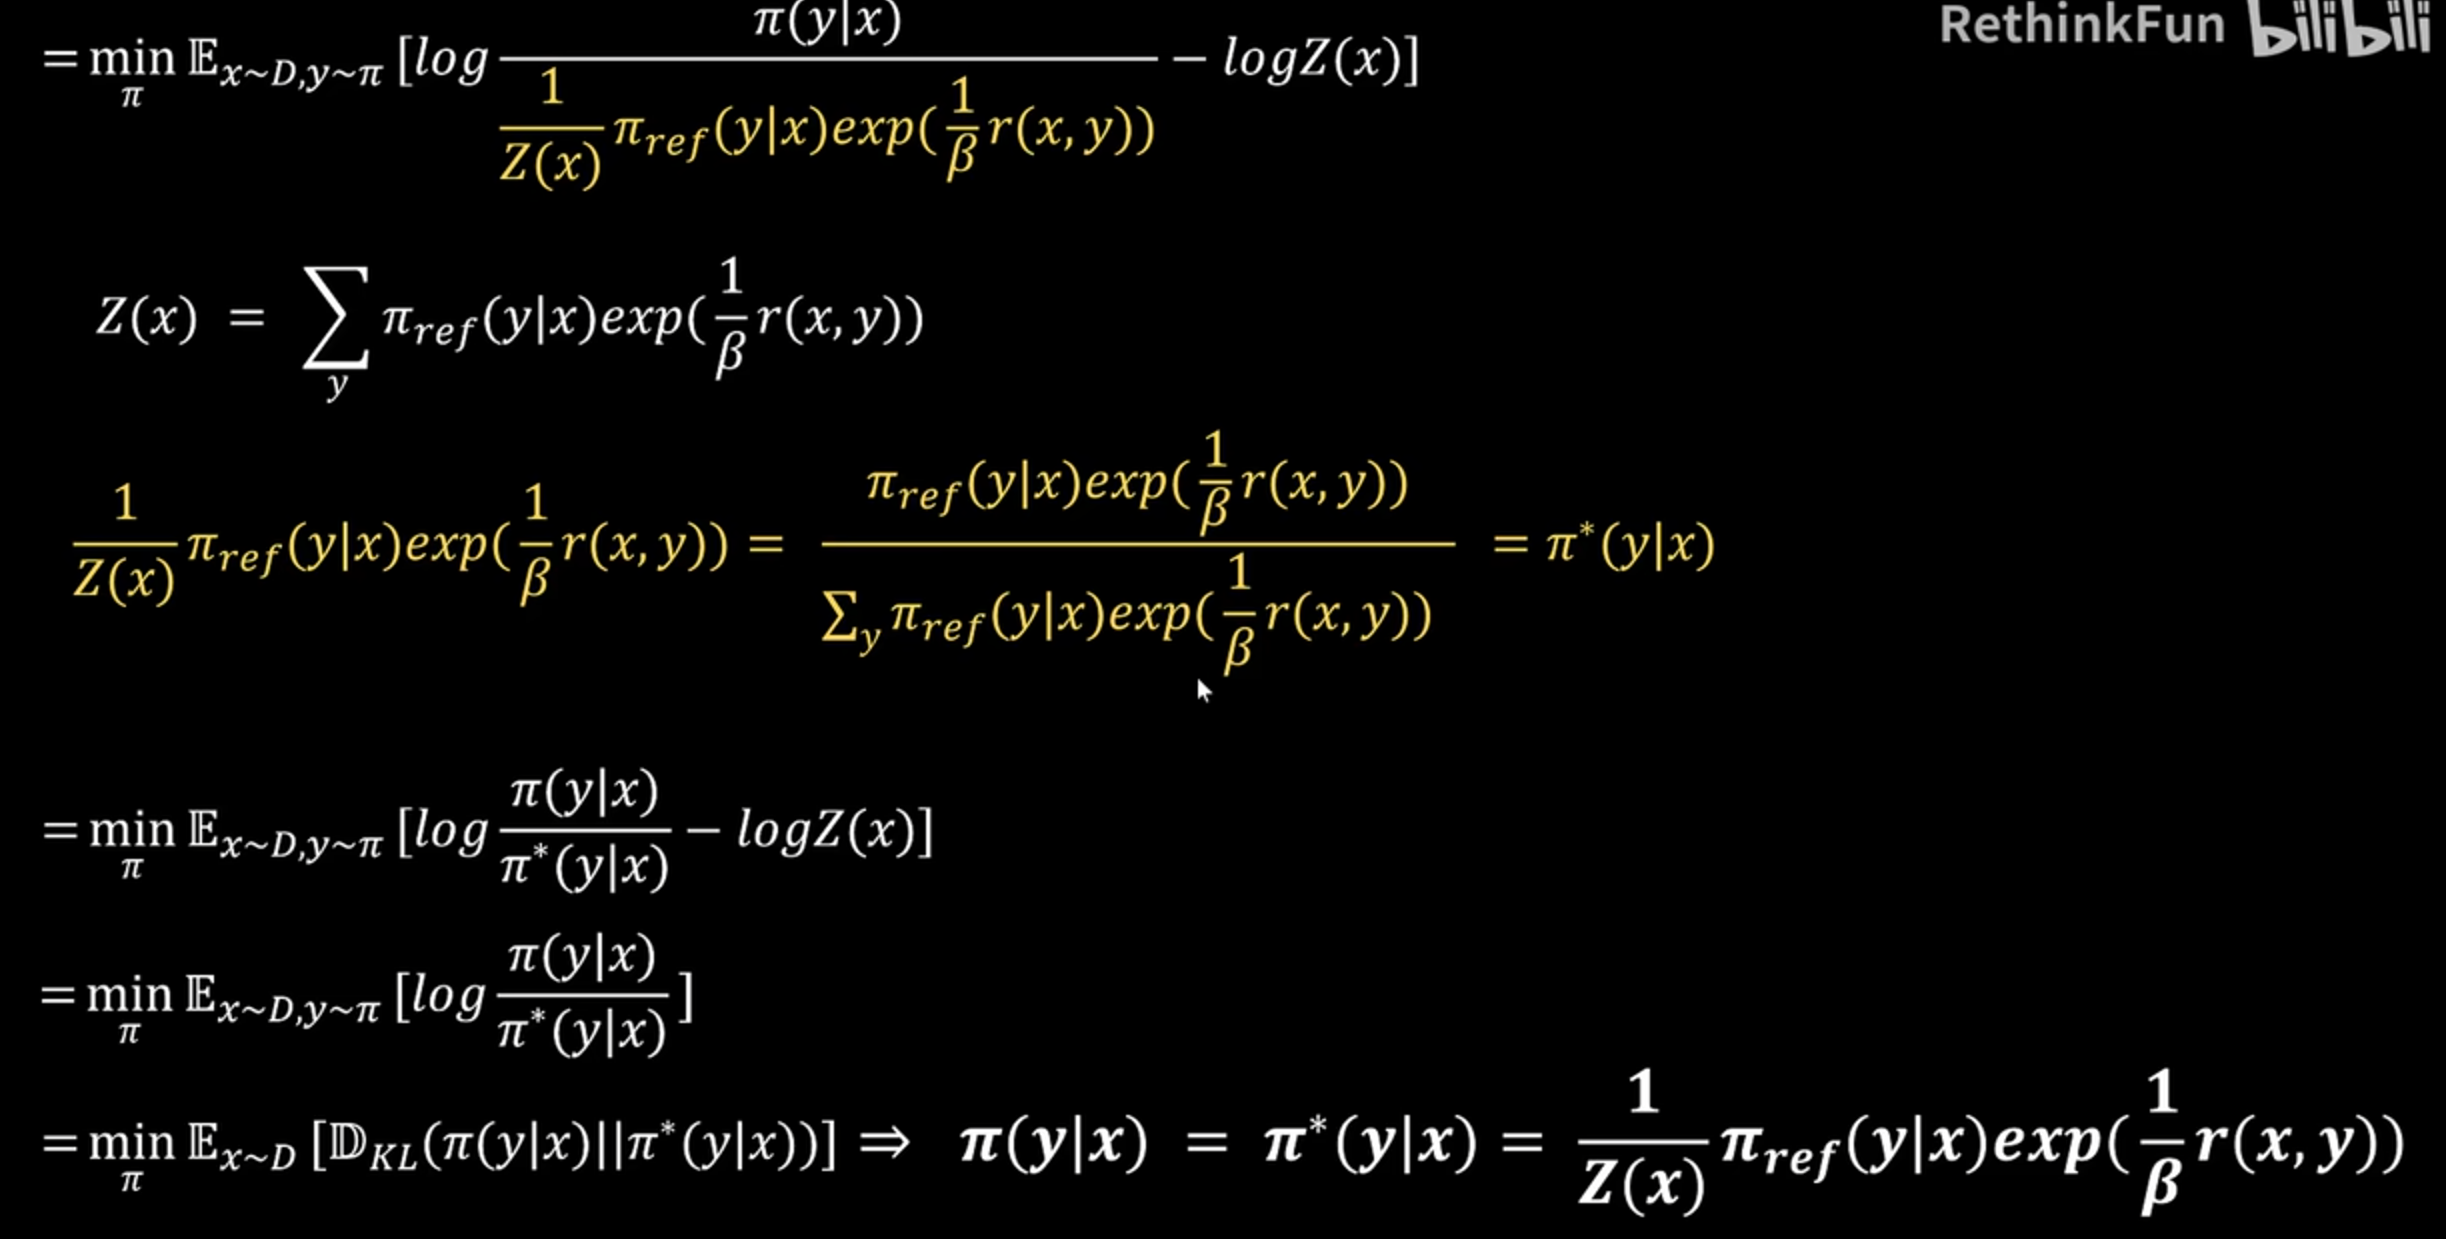
3、根据最优分布反推出reward公式(当reward这么算的时候最优,也说明在最优点附近,reward 和最优策略是一一对应的)
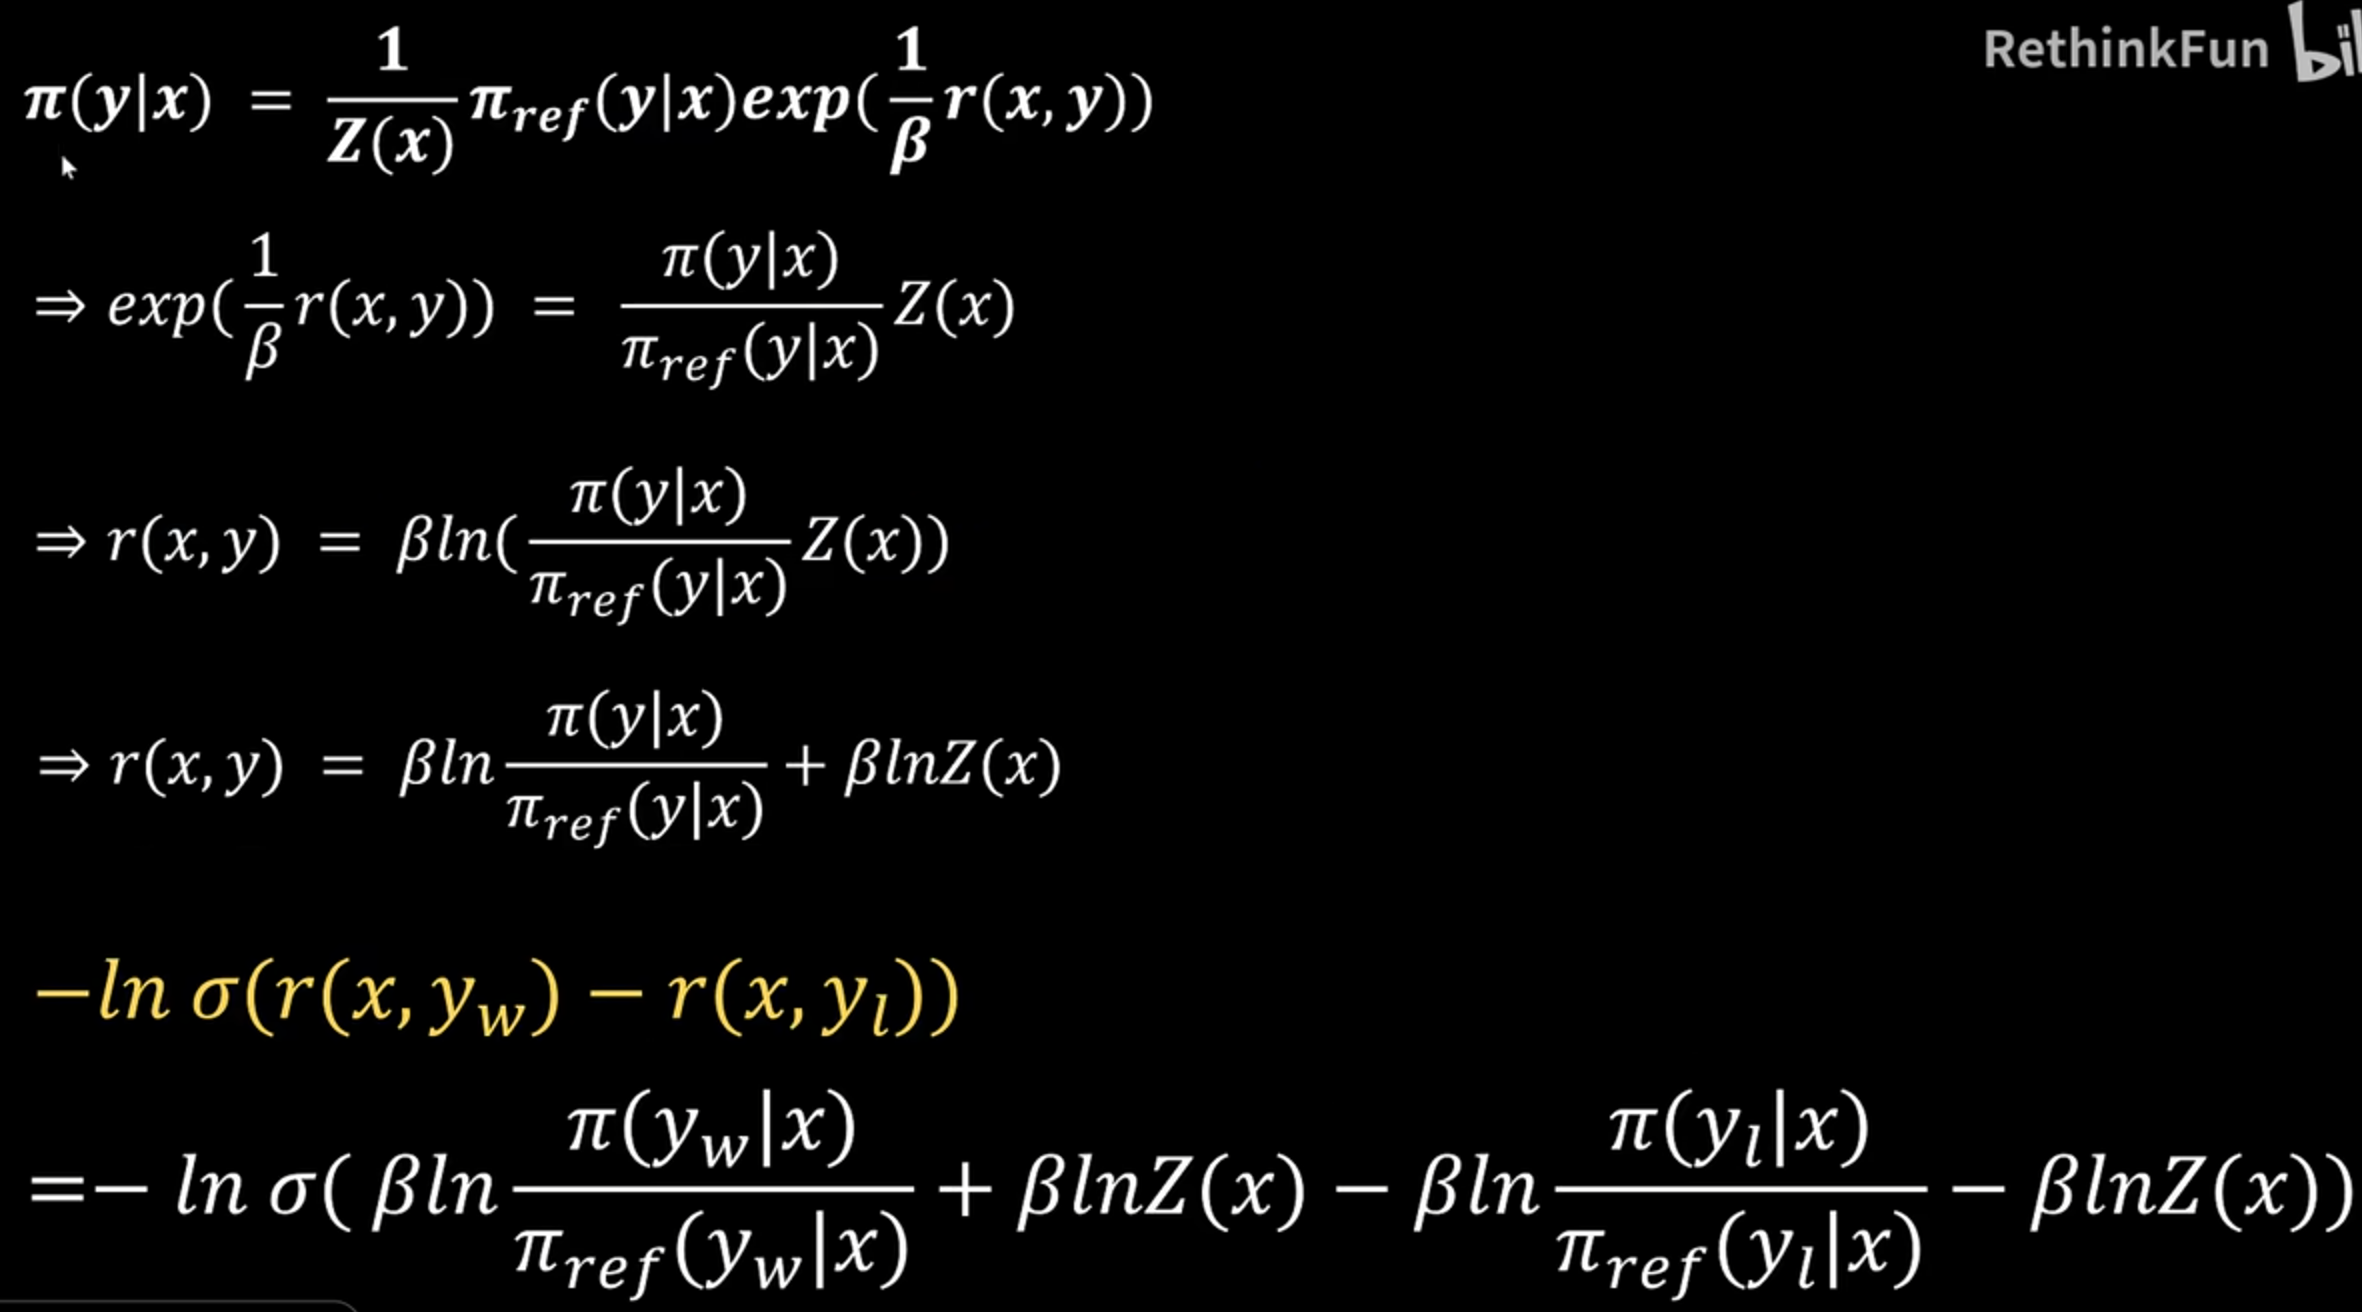
4、最后带入DPO的loss函数得到最终形态
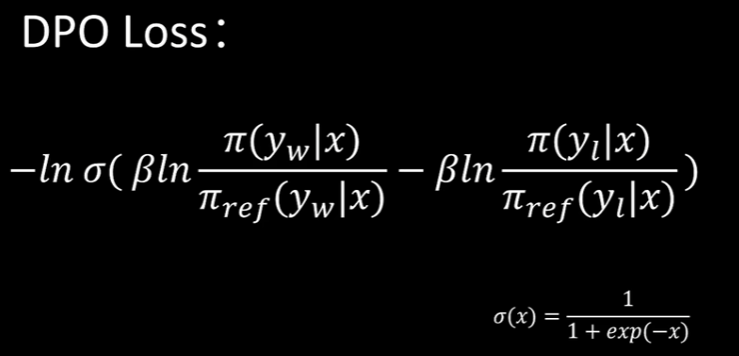
DPO 通过 直接最大化最优策略下更好样本被选中的概率,实现了 RLHF 的 KL-正则化目标的等价优化,用\(\pi\)逼近\(\pi^*\)。

 浙公网安备 33010602011771号