
python学习笔记
Python学习
第一章:python基础
字面量
-
字面量的含义:代码中,被写在代码里固定的值
-
常见的字面量类型
- 整数
- 浮点数
- 字符串
-
print语句完成字面量输出的基本格式
-
print("字符串")
print(整数\浮点数)
-
-
注意事项:当数据被引号包起来,无论单引号和双引号,都是字符串
注释
- 注释的作用
- 代码中的解释性语句,用于对代码内容进行解释(注释不是代码,不会被程序执行)
-
单行注释的定义
- 通过一个#定义,在#右侧均为注释内容(规范写法,在#与注释内容之间保留一个空格)
例:
# 打印输出hello world print("hello world") -
多行注释的定义
- 通过一对三引号来定义('''注释内容'''),引号内部均为注释,可以换行
- 多行注释一般对:python文件,类或者方法进行注释
变量
- 变量的定义与作用
- 定义:在程序运行时,能储存数据计算结果或能表示值的抽象概念
- 作用:简单而言,可以用来记录数据
- 变量的定义格式
- 变量名称 = 变量的值
- 变量的特征
- 变量的值可以改变
- python语句多内容的输出
例:
print("内容1","内容2",....,"内容N")
钱包余额练习

数据类型
-
入门的三类数据类型
- 字符串类型(string)
- 整数类型(int)
- 浮点型(float)
-
查看数据类型的方法:使用type()语句
-
基本格式及示例
'''直接输出数据类型''' # 字符串的类型输出 print(type("黑马程序员")) # 整数型的类型输出 print(type(666)) # 浮点型的类型输出 print(type(11.11)) '''用变量存储type语句返回的数据类型'''(举一例,其他类比即可) type1 = type(111) print(type1) -
type()语句的注意事项
- type()语句查看的是字面量和变量中存储的数据的类型而不会是变量的类型(变量无类型)
-
数据类型转换
- 常见的转换语句
| 语句(函数) | 说明 |
|---|---|
| int(x) | 将x转换为一个整数 |
| float(x) | 将x转换为一个浮点数 |
| str(x) | 将x转换为一个字符串 |
- 转换语句的使用举例(仅举一例,其余类比)
# 定义一个浮点型变量x
x = 33.3
#将变量类型转换的基本格式(需要用变量本身或其余变量来获取转换后的变量)
x = int(x)
#将x变量内的数据的类型用type1存储
type1 = type(x)
print(f"x的值为{x},x的类型为{type1}")
'''最终运行结果为
x的值为33,x的类型为<class 'int'>'''
- 注意事项
- 当浮点型转变为实数型时,数据会向下取整而不是四舍五入
- 任何类型都可以转换成字符串,字符串内只有数字才可以转换成数字
- 浮点数转换为整数会丢失精度(小数部分)
标识符
-
标识符的定义:用户在编程过程中所使用的一系列名字,包括但不仅限于变量,类,方法的命名
-
标识符的命名规则:
- 标识符命名中只允许出现:
- 英文(区分大小写)
- 中文
- 数字
- 下划线(_)
- 不可使用关键字(在python中有特殊用途的词)包括但不限于:False,True,And,none,as,if,type等等
- 标识符命名中只允许出现:
-
标识符尽量做到见名知意且简洁
运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
| + | 加 | 10+10=20 |
| - | 减 | 10-10=0 |
| * | 乘 | 10*10=100 |
| / | 除 | 100/10=10 |
| // | 取整除 | 9//2=4(取除法后商4余1,取整除运算取商去余数) |
| % | 取余 | 9//2=4(取除法后商4余1,取余运算取余数去商) |
| ** | 指数 | 10**10=10000000000(十的十次方) |
赋值运算符及复合赋值运算符
| 运算符 | 描述 | 实例 |
|---|---|---|
| = | 赋值运算符 | 把等号右边的结果 赋值给左边的变量,如 num =1+2*3,最后 num = 7 |
| += | 加法赋值运算符 | 等效于c = c+a |
| -= | 减法赋值运算符 | c -= a等效于c = c-a |
| *= | 乘法赋值运算符 | c *= a等效于c = c *a |
| /= | 除法赋值运算符 | c /= a等效于c = c/a |
| %= | 取余赋值运算符 | c %= a等效于c = c%a |
| **= | 幂赋值运算符 | c **= a等效于c = c **a |
| //= | 取整除赋值运算符 | c //= a等效于c =c//a |
字符串扩展
- 字符串的定义可以用单引号,双引号以及三引号包围字符串,若想字符串内带有引号,可以使用一种引号包围另一种引号
例:
# 输出hello world
print("hello world")
# 输出hello world
print('hello world')
# 输出hello world
print('''hello world''')
# 输出he'll'o world
print("he'll'o world")
- 若想字符串内带有引号,可以使用一种引号包围另一种引号,也可以使用转义符号
例:
# 输出he'll'o world
print("he'll'o world")
# 输出he"llo wor"ld
print("he\"llo wor\"ld")
字符串拼接
- 完成字符串拼接的方式
- 使用 "+" 号连接字符串变量或者字符串常量即可(无法和非字符串类型拼接)
字符串格式化
- 占位符:%d(整数型) , %f(浮点型) , %s(字符串)
- 通过占位符进行字符串格式化以完成拼接
name = "pm"
score = 534
# 使用占位符完成字符串和其他类型变量的拼接
print("我的名字是%s,我的高考成绩为%d"%(name,score))
- 其他类型变量也可以使用%s占位,%s会把其他类型变为字符串类型
- 数字精度控制
- 我们可以使用辅助符号"m,n”来控制数据的宽度和精度
- m,控制宽度,要求是数字(很少使用),**设置的宽度小于数字自身,不生效 **
- .n,控制小数点精度,要求是数字,会进行小数的四舍五入
- 我们可以使用辅助符号"m,n”来控制数据的宽度和精度
例:
num = 1.12456
# 输出1.12
print("%3.2f"%num)
# 输出 1.12(前面存在一个空格以保证宽度)
print("%5.2f")
- 快速字符串格式化
- 通过语法:f"内容(变量}”的格式来快速格式化
例:
name = "传智播客"
price = 19.99
stock_code = "003032"
stock_price = 19.99
factor = 1.2
days = 7
print(f"公司:{name},股票代码{stock_code},当前股价{stock_price}")
# 输出:公司:传智播客,股票代码003032,当前股价19.99
- 特点:不理会类型,不做精度控制
表达式格式化
参考上述内容,与变量的格式化类似
name = "传智播客"
price = 19.99
stock_code = "003032"
stock_price = 19.99
factor = 1.2
days = 7
print("每日增长系数为%.2f\n经过%d天的增长后\n股价达到了%.2f" % (factor, days, factor**days*price))
'''
输出:
每日增长系数为1.20
经过7天的增长后
股价达到了71.63
'''
练习:股价计算小程序

键盘输入
- 键盘输入的方法:
- 使用input()语句可以从键盘获取输入
使用一个变量接收(存储)input语句获取的键盘输入数据即可
num = input()
print(f"{num}")
练习:欢迎登陆小程序

- 进阶应用:
将对用户输入的提示语放入后面括号
格式:input("提示语")
示例:
num = input("请输入一个数字")
# 还可以直接使用int来快捷转换数据类型(在条件控制语句中尤为有用)
int(input("请输入一个数字"))
print语句扩展
- 输出不换行

- 制表符的应用

**注意点:一个\t最多占四个空格,在四个空格以内都会自动识别对齐
第二章:判断语句学习
布尔类型与比较运算符
- 布尔表达现实生活中的真和假
- True表示真
- False表示假
- 定义变量存储布尔类型数据
- 变量名称 = 布尔类型字面量
- 比较运算符
| 运算符 | 描述 | 示例 |
|---|---|---|
| == | 判断内容是否相等,满足为True,不满足为False | 如a=3,b=3,则(a==b)为True |
| != | 判断内容是否不相等,满足为True,不满足为False | 如a=1,b=3,则(a!=b)为True |
| > | 判断运算符左侧内容是否大于右侧,满足为True,不满足为False | 如a=7,b=3,则(a>b)为True |
| < | 判断运算符左侧内容是否小于右侧,满足为True,不满足为False | 如a=3,b=7,则(a<b)为True |
| >= | 判断运算符左侧内容是否大于等于右侧,满足为True,不满足为False | 如a=3,b=3,则(a >= b)为 True |
| <= | 判断运算符左侧内容是否小于等于右侧,满足为True,不满足为False | 如a=3,b=3,则(a<=b)为True |
if语句的基本格式
- if语句的格式
-
if 要判断的条件:
条件成立时,要执行的代码
-
示例:
# 定义变量
age = 30
# 进行判断
if age > 18:
    print("我已经成年了")
- 注意点:
- 判断条件的结果一定是布尔类型
- 不能忘记判断条件后的冒号
- 归属于if语句的代码块,需要在前方填充四个空格缩进
- 使用键盘输入数字做判断时,一定要将数据转化为整型或浮点型
练习:成年人判断

if else语句
- if else的格式
-
if 条件:
满足条件要执行的代码1
满足条件要执行的代码2
......(省略)
else:
不满足条件要执行的代码1
......(省略)
- 示例:
age = 30
if age >= 18:
    print("您已成年")
else:
    print("您还未成年")
- 注意事项
- else不需要判断条件,当if的条件不满足时,else执行
- else的代码块,同样需要4个空格缩进
练习:我要买票吗

if elif else语句:
- if elif else语句的格式
-
if条件1:
条件1满足应执行的代码
条件1满足应执行的代码
elif条件2:
条件2满足应执行的代码
条件2满足应执行的代码
elif条件N:
条件N满足应执行的代码
条件N满足应执行的代码else:
所有条件都不满足应执行的代码
所有条件都不满足应执行的代码 -
示例:
age = 18
if age > 18:
    print("您超过十八岁")
elif age == 18:
    print("您刚好18岁")
else:
    printf("您未满十八岁")
- 注意事项:
- elif可以写多个
- 判断是互斥且有序的,上一个满足之后下一个就不会再判断了
- 可以在条件判断中直接写input语句(要注意类型转换)
练习:猜猜心里数

该段代码充分体现了if语句的以下特性:
- 程序从上往下依次执行对比和键盘输入语句,当条件成立,程序不再继续执行if语句下面的内容
判断语句的嵌套
- 嵌套判断语句的基本格式:
-
if 条件1:
满足条件1应执行的代码1
满足条件1应执行的代码2 if 条件2:
满足条件2应执行的代码1
满足条件2应执行的代码2 -
示例:
age = 18
if age >= 18:
    print("您已经成年")
    if age <= 30:
        print("并且正值壮年")
    else:
        print("您虽然成年,但年纪有点大了")
else:
    print("您没有成年")
- 注意事项
-
嵌套的关键点在于:空格缩进(决定层次关系)
-
当外层条件满足时,才会执行内部if判断
练习:条件判断语句嵌套

第三章:循环语句的学习
while循环的基础语法
- while循环语句的格式:
- while 条件:
条件满足时,执行的代码1
条件满足时,执行的代码2
条件满足时,执行的代码3
- 以上代码只要条件满足就会无限执行
- 示例
age = 30
while age > 18:
    print("您已经成年")
# 会持续无限输出"您已经成年"
- 注意事项:
- while语句的条件需要得到布尔类型,True表示继续循环,False表示结束循环
- 一般情况下需要设置循环的终止条件,如i+=1配合i<100,就能确保100次后停止,否则将无限循环
- 空格缩进和if判断一样,都需要设置
练习:一到一百的和

while循环的基础案例
练习:循环猜数字

其他思路:
设置一个标志,当符合条件,再更改标志以跳出循环

注意事项:
- 上述的第一种思路中,条件符合时,不进入循环,i不会+1,所以i初始值为1
- 第二种思路中,条件符合时,仍会运行循环中的程序一次,i会+1,所以i的初始值为0
while循环的嵌套应用
- while的嵌套循环的基本格式:
- while 条件1:
条件1满足时,执行的代码1
条件1满足时,执行的代码2
条件1满足时,执行的代码3
...(省略)...
while 条件2:
条件2满足时,执行的代码1
条件2满足时,执行的代码2
条件2满足时,执行的代码3
...(省略)... - 示例:
i = 1
j = 1
while i <= 10:
    print("我爱你")
    i += 1
    j = 1
    while j <= 10:
        print("我要送你花")
        j += 1
- 注意事项
- 注意条件的控制,避免陷入无限循环,也要保证能够进入循环
- 多层嵌套也使用空格缩进来确定层次关系
while循环的嵌套案例
练习:九九乘法表

for循环的基础语法
- for循环与while循环的区别

- for循环(遍历循环)的基础语法:
- for 临时变量 in 待处理数据集
循环满足条件时执行的代码
示例:
# 定义字符串name
name = "itheima"
# for循环处理字符串
for x in name:
    print(x)
'''
for循环会将name中所有元素拿出来放入x中再并执行代码
字符串中的单个元素即单个字符,故输出结果为:
i
t
h
e
i
m
a
'''
注意事项:
- 无法定义循环条件,只能被动依次取出所有数据处理
- 循环内的语句,需要空格缩进
练习:数一数有几个a

-
range语句
- range语句的三种语法
- range(num)
获取一个从0开始,到num结束的数字序列(不含num本身)
如range(5)取得的数据是:[0,1, 2, 3, 4]-
range(num1,num2 )
获得一个从num1开始,到num2结束的数字序列(不含num2本身)如,range(5, 10)取得的数据是:[5, 6, 7, 8, 9]
-
range(num1, num2, step)
获得一个从num1开始,到num2结束的数字序列(不含num2本身) 数字之间的步长,以step为准(step默认为1),step指取每个数字之间的间隔。如,range(5,10,2)取得的数据是:[5,7, 9]
- 功能:获取一个数字序列,与for循环搭配使用,不需要变量接收
示例:
for x in range(10):
    print(f"送出第{x}朵玫瑰花")
练习:有几个偶数
![有几个偶数.png]()
-
临时变量的作用域
- for循环中的临时变量可以在外部被访问,但这并不规范(不建议使用)

for循环的嵌套应用
- 嵌套for循环的基础格式
for 临时变量 in 待处理数据集(序列):
    循环满足条件应执行的代码1
    循环满足条件应执行的代码2
    循环满足条件应执行的代码N

    for 临时变量 in 待处理数据集(序列):
        循环满足条件应执行的代码1
        循环满足条件应执行的代码2
        循环满足条件应执行的代码N
- 注意事项:
- for循环与while循环可以互相嵌套
- 注意缩进确定层次
练习:九九乘法表

循环中断:break和continue
- continue:用于中断循环,直接进入下一循环
- 特点:在for循环与while循环中效果一致
- 应用场景:在循环中,因某些原因,临时结束当此循环
示例:
for i in range(1,6):
    print("1")
    continue
    print("2") # 此行代码不会被执行因为一直被跳过
- 注意事项:在嵌套循环中,只对所处的那个小循环生效
- break:用于直接结束循环
- 特点:在for循环与while循环中效果一致
- 应用场景:需要直接结束循环运行循环后的语句或停止循环
示例:
for i in range(1,6):
    print("1") # 这段代码只会被执行一次
    break
    print("2") # 此行代码不会被执行因为一直被跳过
- 注意事项:在嵌套循环中,只对所处的那个小循环生效
循环综合案例
练习:发工资

第四章:函数
函数介绍
函数:函数是组织好的,可重复使用的,用来实现特定功能的代码段
函数的定义
- 函数的定义语法格式
# 定义函数
def 函数名(传入参数):
    函数体
    return 返回值
基础部分注释部分可不管


# 调用函数
函数名(参数)
示例:
# 定义函数
def named():
    print("我是黑马程序员")
# 调用函数
named()
- 注意事项:
- 参数如不需要,可以省略
- 返回值如不需要,可以省略
- 函数需先定义后使用
函数的参数
- 传入参数的功能是:在函数进行计算的时候,接受外部(调用时)提供的数据
示例:
def add(x,y):
    result = x + y
    print(f"{x}+{y}={result}")


add(1,2)
- 注意事项:
-
函数定义中的参数,称之为形式参数
-
函数调用中的参数,称之为实际参数
-
函数的参数数量不限,使用逗号分隔开
-
传入参数的时候,要和形式参数一一对应,逗号隔开
函数返回值
- 返回值:所谓“返回值”,就是程序中函数完成事情后,最后给调用者的结果
示例:
def add(x,y):
    m = x+y
    return m # return是函数体的结束


x = add(1,2)
print(x)
-
注意事项:函数体在遇到return后就结束了,所以写在return后的代码不会执行
-
none类型
- None类型的应用场景
- 用在函数无返回值上
- 用在if判断上
- 在if判断中,None等同于False
- 一般用于在函数中主动返回None,配合if判断做相关处理
- 定义变量,但暂时不需要变量有具体值,可以用None来代替
函数嵌套调用
- 定义:一个函数中调用另一个函数
函数会在调用过程中依次向下执行
变量的作用域
- 局部变量:
在函数体内部定义的变量,只在函数体内部生效
- 全局变量:
函数外定义的变量,可以在之后的任何一处地方使用(包括函数内)
函数内对全局变量的修改一般只在函数内生效(global声明后可修改全局)
num = 100
def test1():
    print(num)

def test2():
    global num #声明此处num为全局变量
    num = 200 #会改变全局变量num的值
    print(num)
函数综合案例
第五章:数据容器
数据容器入门
意义:可以同时容纳多份数据
定义:一种可以存储多个元素的Python数据类型
数据容器的种类:
list(列表)、tuple(元组)、str(字符串)、set(集合)、dict(字典)
它们各有特点,但都满足可容纳多个元素的特性。
数据容器:list(列表)——可修改
定义一个列表的基本格式:
# 变量名称 = [元素1,元素2,元素3 ...]
aaa = [11,22,33,44]

'''
定义空列表:
变量名称 = []
变量名称 = list()
'''
注意事项:列表可以一次性存储多个数据,不同元素之间使用逗号分隔,且可以为不同数据类型,支持嵌套
列表的下标索引:
# 定义一个列表
aaa = ['heima','jack','rose',[1,2,3,4]]
# 从0开始一一对应各个元素
aaa[0] = heima
# 嵌套列表内的数据可以用二层下标(字符串也是一个列表)
aaa[3][0] = 1
aaa[0][0] = h
# 可以使用负数索引来实现从后往前取数据
aaa[-2] = rose
利用下标索引取数据时一定不要超出范围
列表的常用操作:
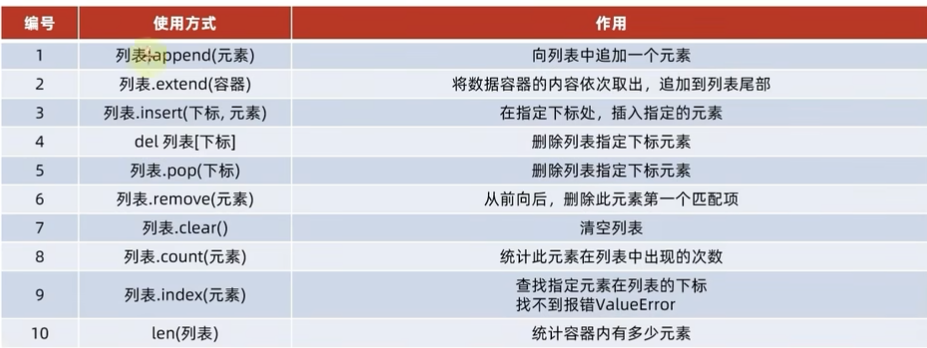
简单来说:列表内提供了一系列的函数(本质上是类)
1.下标索引——查找元素对应下标(index)
-
功能:查找指定元素在列表的下标,如果找不到,就会出现ValueError报错
-
语法格式:列表名.index(查找元素)
示例:
# 定义一个列表
aaa = ['heima','jack','rose',[1,2,3,4]]
# 利用index方法查找下标
index = aaa.index('heima')
# 查找嵌套列表的下标时,要先把第一层写出来 即 index只能查找到往下一层的元素
index = aaa[3].index(3)
2.对列表中元素的修改
- 语法:列表名[下标] = 值
示例:
# 定义一个列表
aaa = ['heima','jack','rose',[1,2,3,4]]
# 修改值
aaa[3][0] = 2
# 修改后列表为:
aaa = ['heima','jack','rose',[2,2,3,4]]
3.列表元素的插入(insert)
语法:列表名.insert(下标,元素)
示例:
# 定义一个列表
aaa = ['heima','jack','rose',[1,2,3,4]]
# 插入一个元素
aaa.insert(1,'come')
# 插入元素后,新的列表为:['heima','come','jack','rose',[1,2,3,4]]
print(f"插入后的列表为{aaa}")
注意事项:插入元素的过程中,其他元素会为了插入元素对应后移
4.追加元素(元素:append,数据容器:extend)
语法:列表名.append(元素) --将指定元素追加到列表末尾
# 定义一个列表
aaa = [1,2,3,4]
# 在列表末尾追加一个元素
aaa.append(5)
# 输出列表
print(aaa)
# 输出结果为:[1, 2, 3, 4, 5]
在列表后也可追加一批多个元素:
语法:列表名.extend(其他数据容器)--将其它数据容器的内容取出,依次追加到列表尾部
示例:
# 定义两个列表
list1 = [1,2,3]
list2 = [4,5,6]
#将list2追加到list1末尾
list1.extend(list2)
# 输出新的list1
print(list1)
# 结果为:[1, 2, 3, 4, 5, 6]
5.删除元素(指定下标:del,pop 指定元素:remove 清空列表:clear)
语法1: del 列表名[下标]
语法2: 列表名.pop(下标)
示例:
# 定义两个列表
list1 = [1,2,3]
list2 = [4,5,6]
# 方法一:del
del list1[0]
print (list1)
# 结果为:[2, 3]

# 方法二: pop
list2.pop(0)
print(list2)
#结果为:[5, 6]
删除列表中指定的某元素(指定元素而非下标)
语法:列表名.remove(元素)
示例:
# 定义一个列表
aaa = ['heima','heima','jack','rose',[1,2,3,4]]
# 删除其中元素'rose'
aaa.remove('heima')
# 输出删除后的列表
print(aaa)
# 输出结果为:['heima', 'jack', 'rose', [1, 2, 3, 4]]
# 上面这个例子remove之会从前往后删除遇到的第一个需要删除的元素
清空列表全部内容:
语法:列表名.clear()
示例:
# 定义一个列表
aaa = ['heima','heima','jack','rose',[1,2,3,4]]
# 清空列表
aaa.clear()
# 输出清空后的列表
print(aaa)
# 输出结果为:[]
6.统计某元素在列表内的数量(count)
语法:列表名.count(元素)
示例:
# 定义一个列表
aaa = ['heima','heima','jack','rose',[1,2,3,4]]
# 输出某元素的数量
print(aaa.count(heima))
# 输出结果为:2
7. 统计列表内有多少元素(len)
语法:len(列表)
示例:
# 定义一个列表
aaa = ['heima','heima','jack','rose',[1,2,3,4]]
# 统计列表内有多少元素
print(len(aaa)) # 结果为:5
print(len(aaa[4])) # 结果为:4
# 根据以上示例,二层列表在一层列表内仅被当做单个元素
总结
list列表的遍历
1.while循环遍历
结合while循环基本格式,控制循环条件和下标增减实现遍历
示例:
i = 0
while i < len(列表):
    元素 = 列表[i]
    i += 1
# 示例:依次打印列表内数据
# 定义一个列表
aaa = ['heima','heima','jack','rose',[1,2,3,4]]
# 依次打印列表内数据
i = 0
while i < len(aaa):
    print(aaa[i])
    i += 1 #需要控制按量变化保证不会一直循环
2. for循环遍历
结合for循环基本格式,控制步长等数据对下标修改进行遍历
for i in 列表:
    元素 = 列表[i]
# 示例:依次打印列表内数据
# 定义一个列表
aaa = ['heima','heima','jack','rose',[1,2,3,4]]
for i in aaa:
    print(i)
# 无需控制循环结束条件
3.总结与对比
while循环和for循环,都是循环语句,但细节不同:
-
在循环控制上:
- while循环可以自定循环条件,并自行控制
- for循环不可以自定循环条件,只可以一个个从容器内取出数据
-
在无限循环上:
- while循 环可 以通 过 条 件 控 制 做 到 无 限 循 环
- for循环理论上不可以,因为被遍历的容器容量不是无限的
-
在使用场景上:
- while循 环 适 用 于 任 何 想 要 循 环 的 场 景
- for循 环 适 用 于 ,遍 历 数 据 容 器 的 场 景 或 简 单 的 固 定 次 数 循 环 场 景
数据容器:tuple(元组)——不可修改
元组的特点:
元组一旦定义完成,就不可修改
元组的定义语法:
变量名称 = (元素,元素,元素)
定义空元组
变量名称 = ()
变量名称 = tuple()
元组可以嵌套,定义格式为
变量名称 = ((元素,元素,元素),(元素,元素,元素))
元组可通过下标索引取出内容——与list格式一样
# 定义元组
aaa = ((1,2,3),4,5,6)
print (aaa[0])# 结果为(1, 2, 3)
print (aaa[0][0])# 结果为1
-
元组有且仅有index方法,count方法,len方法用法都与list一样
-
元组的遍历与列表的遍历类似
注意事项:若元组内嵌套了列表,列表内的元素可以修改
数据容器:str(字符串)——不可修改
下标索引与list一致
示例:
aaa = 'heima'
print(aaa[0])
# 结果为:h
index方法(与list一致)
示例:
aaa = 'heima'
index = aaa.index('h')# 字符需要用引号包裹
print(index)
# 结果为:0
replace方法(字符串替换)
语法:字符串.replace(需要替换的部分,字符串2)
功能:将字符串内的全部:字符串1替换为字符串2
注意:不是修改字符串本身,而是得到了一个新字符串,所以需要变量接收
示例:
aaa = "heima heiyu"
aaa = aaa.replace('hei','bai')
print(aaa)
# 结果为:baima baiyu
split方法(字符串分割)
语法:字符串.split(分隔的特定标识)
功能:按照指定的分隔符字符串,将字符串划分为多个字符串,并存入列表对象中
注意:字符串本身不变,而是得到了一个列表对象所以需要变量接收
示例:
aaa = "heima heiyu"
list1 = aaa.split(" ")# 此处以空格为标识,则在每个空格处分割字符串
print(list1)
# 结果为:['heima', 'heiyu']
strip方法(字符串规整)
语法一(去前后空格):字符串.strip()
示例:
aaa = "  heima heiyu  "
aaa = aaa.strip()
print(aaa)
# 结果为:heima heiyu(前后空格被去掉)
语法二(去掉前后指定字符与字符串):字符串.strip(字符串)
示例:
my_str ="12itheima and itcast21"
print (my_str.strip("12"))
# 结果:"itheima and itcast"
注意,传入的是“12”其实就是:“1”和”2”都会移除,是按照单个字符。
count方法(统计某字符串出现的次数)
与list一致(传入参数为字符串,需要引号)
示例:
aaa = "heima,heiyu"
count = aaa.count("hei")# 用引号包裹字符串
print(count)
#结果为:2
len方法(统计字符串长度)
与list一致
示例:
aaa = "heima,heiyu"
len = len(aaa)# 用引号包裹字符串
print(len)
#结果为:11
循环遍历:参考list(for与while皆可以使用)
字符串的大小比较
根据ASCII码表来对应排序与找出最大最小值
字符串的互相比较会从头到尾一位一位比较,只要有一位能出结果,就直接可以得出大小关系
数据容器(序列)的切片
序列是指:内容连续、有序,可使用下标索引的一类数据容器
列表、元组、字符串,均可以可以视为序列。
序列支持切片,即:列表、元组、字符串,均支持进行切片操作
切片:从一个序列中,取出一个子序列
语法:序列[起始下标:结束下标:步长]——注意是冒号
起始下标为空说明从头开始,结束下标为空说明到最后结束
步长表示,依次取元素的间隔
-
步长1表示,一个个取元素
-
步长2表示,每次跳过1个元素取
-
步长N表示,每次跳过N-1个元素取
-
步长为负数表示,反向取(注意,起始下标和结束下标也要反向标记)
注意:此操作不影响序列本身,而是会产生一个序列
示例:
list1 = ['aaa','bbb','ccc','ddd','eee']
result1 = list1[1:3]
print(result1)
#结果为:['bbb', 'ccc']——由此可见,取出的元素不包括当前下标本身
步长可为负数即从后往前取,前面的参数依然为起始下标与结束下标
示例:
list1 = [1,2,3,4,5,6,7]
result = list1[-1:1:-1]
print(result)
# 结果为: [7, 6, 5, 4, 3]——从后往前取
aaa = "heima"
result = aaa[::-1]
print(result)
# 结果为:amieh——字符串逆序输出
注意:切片遵循左闭右开,即保留起始下标对应值,舍弃结束下标对应值
数据容器:set(集合)——无序可修改
集合中的元素不允许重复且无序,顺序无法保证——所以不支持下标索引
语法:变量名 = {元素1,元素2,元素3}
示例:
# 定义集合
aaa = {1,2,3,4}
# 定义空集合
aaa = set()
add方法(添加元素)
注意,add方法是对集合本身的修改,不需要变量接收
语法:集合.add(元素)
示例:
set1 = {1,2}
set1.add(3)
print(set1)
#结果为: {1, 2, 3}
remove方法(移除指定元素)
注意,remove方法是对集合本身的修改,不需要变量接收
语法:集合.remove(元素)
示例:
set1 = {1,2,3}
set1.remove(2)
print(set1)
#结果为: {1, 3}
pop方法(随机取出一个元素)
注意:集合本身会直接被修改,无需变量接收,取出的元素若需要,需要用变量接收
语法:变量名 = 集合.pop()
示例:
set1 = {1,2,3,4,5,6,7,8,9}
num = set1.pop()
print(set1)
print(num)
# 结果不可预估,集合中少一个元素,这个元素被num接收
set1.pop()
print(set1)
# 集合中直接少一个元素
clear方法(清空集合)
语法:集合.clear()
示例:
set1 = {1,2,3,4,5,6,7,8,9}
set1.clear()
print(set1)
# 结果为:set()
difference方法(取差集)
注意:取差集会得到一个新的集合,集合1和集合2不改变
语法1:集合1.difference(集合2)
功能:取出集合1和集合2的差集(集合1有而集合2没有的)
示例:
set1 ={1,2,3}
set2 ={1,5,6}
set3= setl.difference(set2)
print(set3)# 得到的新集合结果:{2,3}
print(setl)# 结果:{1,2,3} 不变
print(set2)# 结果:{1,5,6} 不变
语法2:集合1.difference_update(集合2)
功能:对比集合1和集合2,在集合1内,删除和集合2相同的元素
注意:在这个过程中,集合1被修改,集合2不发生改变
示例:
set1 = {1,2,3,4,5,6}
set2 = {1,2,3}
set1.difference_update(set2)
print(set1) #结果为: {4, 5, 6}
print(set2) #结果为: {1, 2, 3}
union方法(合并两个集合)
语法:集合1.union(集合2)
功能:将集合1和集合2组合成新集合
注意:在这个过程中会得到一个新集合,集合1和集合2不变
示例:
set1 = {1,2,3,4}
set2 = {2,3,4,5,6}
set3 = set1.union(set2)
print(set1)#结果为:{1, 2, 3, 4}
print(set2)#结果为:{2, 3, 4, 5, 6}
print(set3)#结果为:{1, 2, 3, 4, 5, 6}
len方法(统计元素数量)
语法:len(集合)
注意:在这个过程中,不会对集合进行修改,但需要一个变量来接收这个长度
示例:
set1 = {"heima","baima",1,2}
num = len(set1)
print(num)
# 结果为:4
set1 = {"heima","heima",1,2}
num = len(set1)
print(num)
# 结果为:3——所以重复元素不会被放入集合,自然也不会被度量到
集合的遍历(集合不支持下标索引,所以不能使用while循环)
集合可以使用for循环遍历
示例:
set1 = {1,2,'baima','gogogo'}
num = 0
for i in set1:
    num +=1
print(f"set1中总共有{num}个元素")
# 结果为:set1中总共有4个元素
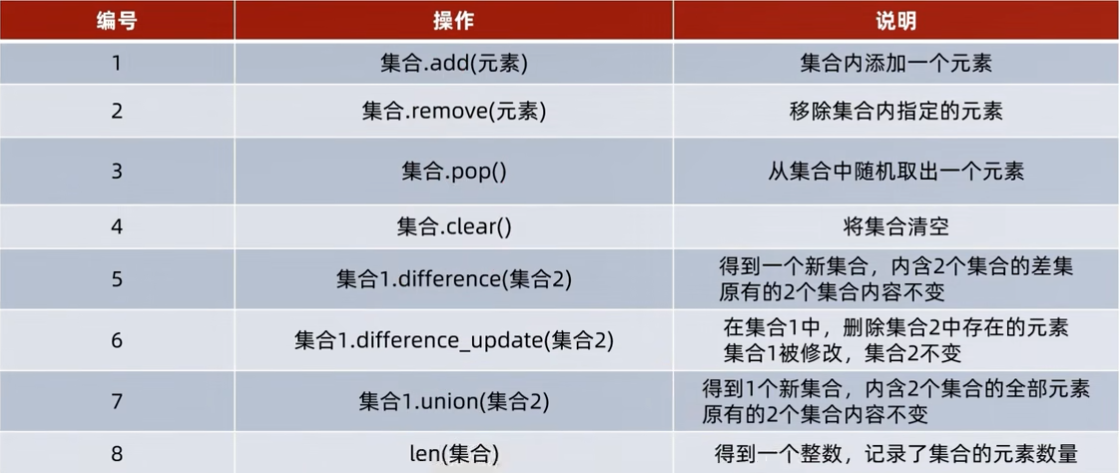
总结
数据容器:dict(字典,映射)——可修改
字典的定义
字典中的每个元素并非单个,而是一个个的键值对
定义语法:变量名 = {key:value,key:value,......}
示例:
# 定义一个字典
dict1 = {1:q,2:w,3:e}
# 定义空字典
dict2 = {}
dict3 = dict()
# 定义重复key的字典(会报错)
dict4 = {1:22,2:33,1:44}
print(dict4)
# 结果为:{1: 44, 2: 33}——说明当有重复key时,后出现的value会覆盖前面的
字典数据的获取
语法:变量名 = 字典[key]
示例:
dict1 = {"pm":100,"dt":99,"pqq":98,"mxh":97,"pcx":96}
num = dict1["pm"]
print(num) # 结果为:100
print(dict1["dt"]) # 结果为:99
字典的嵌套
字典的kek和value可以为任何数据类型,所以可以嵌套(key不可以是字典)
示例:
dict1 = {'语文':{"pm":100,"dt":99},'数学':{"pm":100,"dt":99},'英语':{"pm":100,"dt":99}}

print(dict1['数学']['pm']) # 结果为:100
字典的常用操作
字典的元素修改与新增:
语法:字典[key] = Value——当key存在时,对与其对应的Value进行修改,key不存在时,则会新增一对键值对
示例:
dict1 = {"pm":100,"dt":99,"pqq":98,"mxh":97}
dict1['pcx'] = 96
print(dict1)# 结果为:{'pm': 100, 'dt': 99, 'pqq': 98, 'mxh': 97, 'pcx': 96}
dict1['pm'] = 95
print(dict1)# 结果为:{'pm': 95, 'dt': 99, 'pqq': 98, 'mxh': 97, 'pcx': 96}
pop方法(取出指定key对应的Value)
注意:在这个过程中,指定key所对应的键值对被取出,可以使用一个变量来接受对应的Value值
语法:变量名 = 字典.pop(指定key)
示例:
dict1 = {"pm":100,"dt":99,"pqq":98,"mxh":97}
num = dict1.pop("mxh")
print(num) # 结果为:97——mxh对应值被取出
print(dict1)# 结果为:{'pm': 100, 'dt': 99, 'pqq': 98}——mxh对应键值对被取出
clear方法(清空字典)
语法:字典.clear()
注意:在此过程中,字典本身直接被修改,元素被清空
示例:
dict1 = {"pm":100,"dt":99,"pqq":98,"mxh":97}
dict1.clear()
print(dict1)# 结果为:{}——字典被清空
keys方法(获取字典内全部的key)
语法:字典.keys()
注意:此过程对字典本身无影响,只是将所有key得出来
示例:
dict1 = {"pm":100,"dt":99,"pqq":98,"mxh":97}
aaa = dict1.keys()
print(aaa)# 结果为:dict_keys(['pm', 'dt', 'pqq', 'mxh'])
字典的遍历
因为字典不支持下标索引,所以不能使用下标索引
字典的元素为键值对,所以遍历时需要根据需求,将key和Value分开遍历这个过程中需要keys放法来帮助得到key
示例:
# 定义一个字典
dict1 = {"pm":100,"dt":99,"pqq":98,"mxh":97}
# 取出所有key
dict1_key = dict1.keys()
# 遍历key
for i in dict1_key:
    print(i)
# 结果为: pm
# dt
# pqq
# mxh
# 遍历Value
for i in dict1_key:
    print(dict1[i])
# 结果为: 100
# 99
# 98
# 97
注意:当直接遍历字典时,得到的也是key
示例:
dict1 = {"pm":100,"dt":99,"pqq":98,"mxh":97}
for i in dict1:
    print(i)
    print(dict1[i])
# 结果为:pm
100
dt
99
pqq
98
mxh
97
len方法(统计元素数量)
语法:变量 = len(字典)
注意:此过程对字典本身无影响,只是统计键值对数量
示例:
dict1 = {"pm":100,"dt":99,"pqq":98,"mxh":97}
dict1_len = len(dict1)
print(dict1_len)
# 结果为:4——由此可见,len统计的是字典的键值对数量
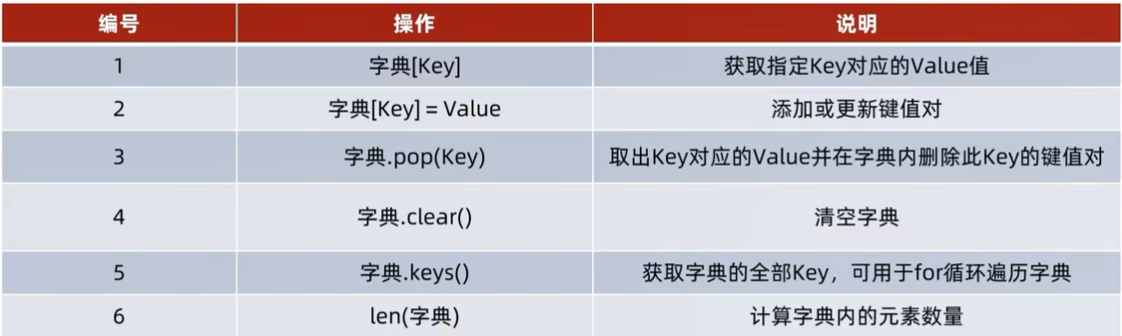
总结:
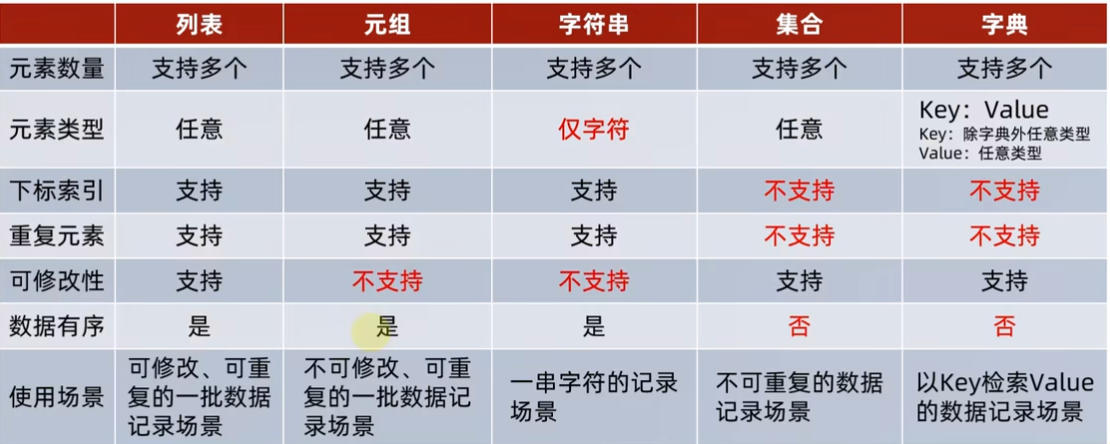
数据容器总结对比
数据容器可以从以下视角进行简单的分类:
- 是否支持下标索引
-
支持:列表、元组、字符串-序列类型
-
不支持:集合、字典一非序列类型
- 是否支持重复元素:
-
支持:列表、元组、字符串一序列类型
-
不支持:集合、字典一非序列类型
- 是否可以修改
-
支持:列表、集合、字典
-
不支持:元组、字符串。
数据容器的通用操作
循环遍历
- for循环任何数据容器皆可以使用
- while循环只能在支持下标索引的数据容器内使用
len方法(统计元素个数)
- 语法:len(容器)
max方法(统计元素最大值)
- 语法:max(容器)
min方法(统计元素最小值)
- 语法:min(容器)
类型转换
语法:转化后的类型(容器)
注意:转换过程中,不会对数据容器本身改变(除非用数据容器本身取承接),而是会创造一个新数据容器
示例:
aaa = {1,2,3,4,5}
list(aaa)
print(aaa)
# 结果为:aaa = {1,2,3,4,5}
aaa = list(aaa)
print(aaa)# 结果为:[1, 2, 3, 4, 5]
sorted方法(容器通用排序)
语法:sorted(容器,reverse = True)——reverse = True在逆向排序时使用
示例:
# 正向排序
my_list=[3,1,2,5,4]
my_tuple =(3,1,2,5,4)
my_str = "bdcefga"
my_set = {3,1, 2,5, 4}
my_dict ={"key3":1, "key1":2, "key2":3, "key5":4, "key4":5}
print(f"列表对象的排序结果:{sorted(my_list)}")# 结果为:列表对象的排序结果:[1, 2, 3, 4, 5]
print(f"元组对象的排序结果:{sorted(my_tuple)}")# 结果为:元组对象的排序结果:[1, 2, 3, 4, 5]
print(f"字符串对象的排序结果:{sorted(my_str)}")# 结果为:字符串对象的排序结果:['a', 'b', 'c', 'd', 'e', 'f', 'g']
print(f"集合对象的排序结果:{sorted(my_set)}")# 结果为:字符串对象的排序结果:['a', 'b', 'c', 'd', 'e', 'f', 'g']
print(f"字典对象的排序结果:{sorted(my_dict)}")# 结果为:字典对象的排序结果:['key1', 'key2', 'key3', 'key4', 'key5']
# 逆向排序
my_list=[3,1,2,5,4]
print(f"列表对象的排序结果:{sorted(my_list,reverse=True)}")
# 结果为:列表对象的排序结果:[5, 4, 3, 2, 1]
第六章:函数的进阶
函数的多返回值
函数中只能有一个return语句,但可以有多个返回值,多个返回值可以在一个return中用逗号隔开
示例:
def test(num):
    num1 = num + 2
    num2 = num * 2
    return num1,num2

x,y = test(5)
print(x) #结果为:7
print(y) #结果为:10
按照返回值的顺序,写对应顺序的多个变量接收即可
变量之间用逗号隔开
支持不同类型的数据return
函数的多种传参方式
函数有四种常见参数使用方式
- 位置参数
- 关键字参数
- 缺省参数
- 不定长参数
位置参数
位置参数:调用函数时根据函数定义的参数位置来传递参数
注意:传递的参数和定义的参数的顺序和个数必须一致
示例:
def info(name,score,paiming):
    print(f"您的名字为{name},你的分数为{score},您的排名为{paiming}")

info('pm',534,110032)
关键字参数
关键字参数:函数调用时通过"键 = 值"的形式传递参数
作用:使函数定义与运用都更加清晰
注意:函数调用时,如果有位置参数时,位置参数必须在关键字参数的前面,并且匹配上参数顺序,但关键字参数之间不存在先后顺序
示例:
def user_info(name, age, gender)
print(f"您的名字是:{name},年龄是:{age},性别是:[gender}"
# 关键字传参
user_info (name="小明”,age=20,gender="男")
#可以不按照固定顺序
user_info(age=20,gender="男",name="小明")
#可以和位置参数混用,位置参数必须在前,且匹配参数顺序
user_info("小明",age=20,gender="男"
缺省参数
缺省参数:缺省参数也叫默认参数,用于定义函数,为参数提供默认值,调用函数时可不传该默认参数的值
如果缺省参数被修改,则使用修改值,如果缺省参数未被修改,则使用定义时的默认值
(注意:所有位置参数必须出现在默认参数前,包括函数定义和调用)
def info(name,age,gender = '男'):
    print(f'您的名字为{name},年龄为{age},性别是{gender}')

info('pm','18')#结果为:您的名字为pm,年龄为18,性别是男
info('dt','21',gender = '女')#结果为:您的名字为pm,年龄为18,性别是男
不定长参数
不定长参数:不定长参数也叫可变参数,用于不确定调用的时候会传递多少
个参数(不传参也可以)的场景。
作用:当调用函数时不确定参数个数时,可以使用不定长参数
不定长参数的类型:
- 位置传递
示例:
def info(*args):# 使用位置不定长参数时,使用一个*来表示不定长参数
    print(args)# 输出为元组

info('1','2',3)# 结果为:('1', '2', 3)
注意:传进的所有参数都会被args变量收集,它会根据传进参数的位置合并为一个元组(tuple),args是元组类型,这就是位置传递
- 关键字传递:
示例:
# 使用关键字不定长参数时,使用两个*来表示不定长参数
def info(**kwargs):
    print(kwargs)# 输出为字典

# 参数传递时,以键 = 值的形式定义
info(name = 'pm',age = 18,score = 534)
#结果为:{'name': 'pm', 'age': 18, 'score': 534}
注意:传进的所有参数都会被kwargs变量收集,它会根据传进参数的位置合并为一个字典(dict),kwargs是字典类型,这就是关键字
匿名函数
匿名传参
函数传参的过程中,不止可以传上变量,具体数据,也可以传入另一个函数
示例:
def aaa(sum):
    result = sum(1,2)
    print(result)
def sum(x,y):
    return x+y
def jian(x,y):
    return x-y

aaa(sum)# 结果为:3
aaa(jian)# 结果为:-1
所以,这是一种,计算逻辑的传递,而非数据的传递。
就像上述代码那样,不仅仅是相加,相见、相除、等任何逻辑都可以自行定义并作为函数传入
lambda匿名函数
lambda可以定义一个无需名字的函数,但这个函数只能使用一次,不能重复使用
语法:lambda 传入参数:函数体(只能有一行代码)
示例:
def aaa(sum):
    result = sum(1,2)
    print(result)

aaa(lambda x,y:x+y)#结果为3
#在lambda函数中,无需写return,最后输出的结果会自动返回

 浙公网安备 33010602011771号