
自监督学习
非原创!侵删
From知乎:@信息门下憨狗 Self-supervised Learning 再次入门
本文前半部分为个人学习摘要,以上为原文。

过程:输入向量 - Encoder - 隐层向量 - Decoder - 输出向量
理想情况:1. 输入向量=输出向量(无损重构)2. 隐层向量维度远小于输入样本
表征学习(Representation Learning):如何学习隐层向量
自监督学习的主要方法
1. 基于上下文(Context Based)
NLP:Word2vec。例如,CBOW 通过前后的词来预测中间的词,而 Skip-Gram 通过中间的词来预测前后的词。
Image:Jigsaw(拼图)构造辅助任务;抠图(与NLP中的BERT的MASK LM 训练方式有异曲同工之妙);预测黑白图片的色彩;数据增广,预测旋转角度
2. 基于时序(Temporal Based)
之前介绍的方法大多是基于样本自身的信息,比如旋转、色彩、裁剪等。而样本间其实也是具有很多约束关系的,这里我们来介绍利用时序约束来进行自监督学习的方法。最能体现时序的数据类型就是视频了(video)。
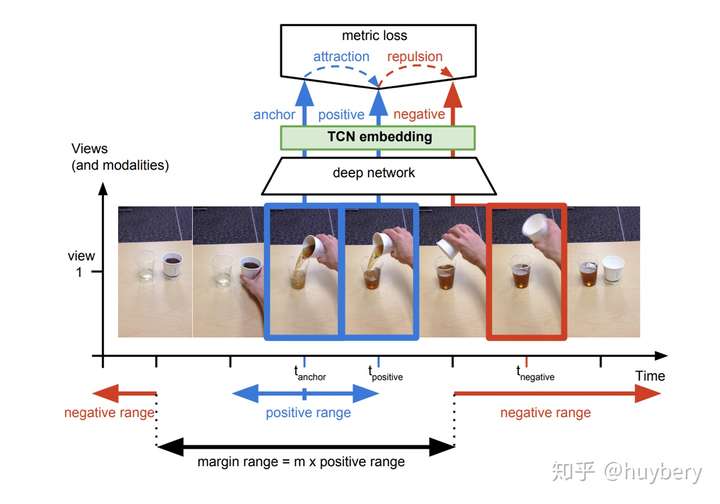
第一种思想是基于帧的相似性[17],对于视频中的每一帧,其实存在着特征相似的概念,简单来说我们可以认为视频中的相邻帧特征是相似的,而相隔较远的视频帧是不相似的,通过构建这种相似(position)和不相似(negative)的样本来进行自监督约束。
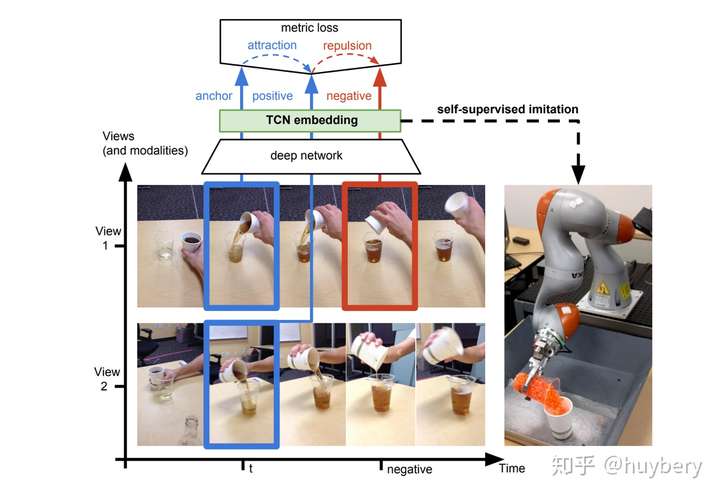
另外,对于同一个物体的拍摄是可能存在多个视角(multi-view),对于多个视角中的同一帧,可以认为特征是相似的,对于不同帧可以认为是不相似的。
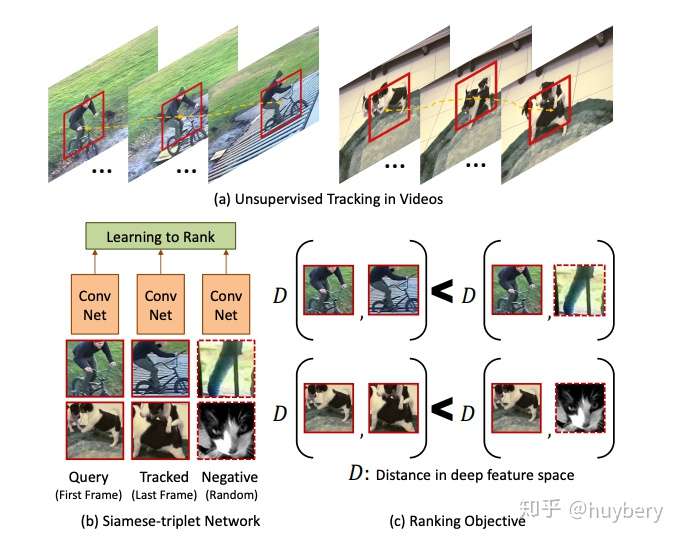
还有一种想法是来自
大佬 ICCV 2015 [18]的基于无监督追踪方法,首先在大量的无标签视频中进行无监督追踪,获取大量的物体追踪框。那么对于一个物体追踪框在不同帧的特征应该是相似的(positive),而对于不同物体的追踪框中的特征应该是不相似的(negative)。
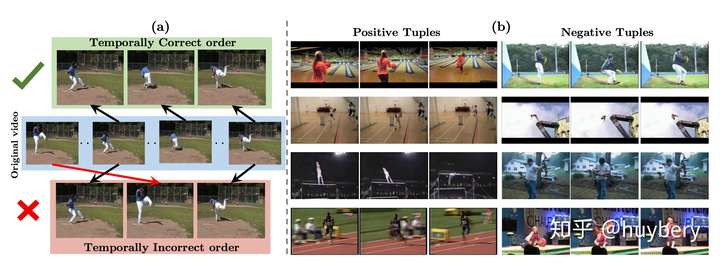
除了基于特征相似性外,视频的先后顺序也是一种自监督信息。比如ECCV 2016, Misra, I. [19] 等人提出基于顺序约束的方法,可以从视频中采样出正确的视频序列和不正确的视频序列,构造成正负样本对然后进行训练。简而言之,就是设计一个模型,来判断当前的视频序列是否是正确的顺序。
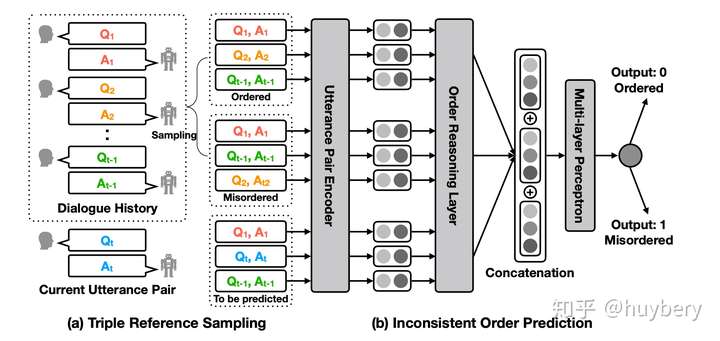 Self-supervised Dialogue Learning
基于顺序的约束还被应用了到了对话系统中,ACL 2019 [20] 提出的自监督对话学习就是基于这种思想。这篇文章主要是想解决对话系统中生成的话术连贯性的问题,期待机器生成的回复和人类交谈一样是符合之前说话的风格、习惯等等。从大量的历史预料中挖掘出顺序的序列(positive)和乱序的序列(negative),通过模型来预测是否符合正确的顺序来进行训练。训练完成后就拥有了一个可以判断连贯性的模型,从而可以嵌入到对话系统中,最后利用对抗训练的方式生成更加连贯的话术。
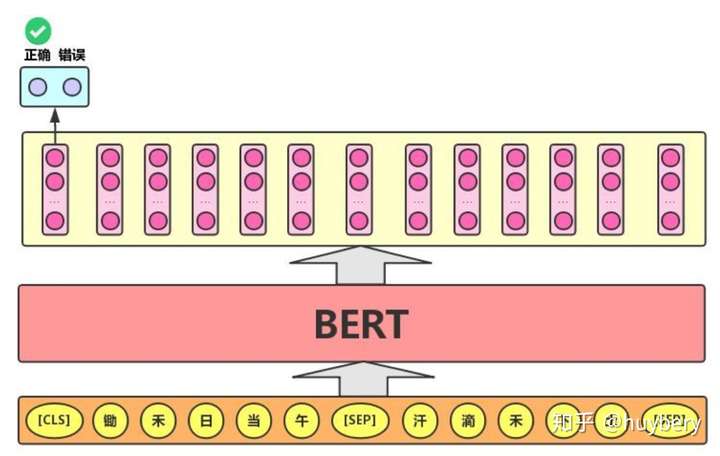 BERT pic from [21]
而 BERT 的另一种训练方式,Next Sentence Prediction 也可以看作是基于顺序的约束,通过构造大量的上下文样本,目的是让模型理解两个句子之间的联系。这一任务的训练语料可以从语料库中抽取句子对包括两个句子A和B来进行生成,其中50%的概率B是A的下一个句子,50%的概率B是语料中的一个随机句子。该任务预测B是否是A的下一句。
3. 基于对比(Contrastive Based)
第三类自监督学习的方法是基于对比约束,它通过学习对两个事物的相似或不相似进行编码来构建表征,这类方法的性能目前来说是非常强的,从最近的热度就可以看出,很多大牛的精力都放在这个方向上面。关于这个方向的方法,[22] 总结的比较好。这里我们再简单的阐述一下,加上一些我个人的看法。
其实我们第二部分所介绍的基于时序的方法已经涉及到了这种基于对比的约束,通过构建正样本(positive)和负样本(negative),然后度量正负样本的距离来实现自监督学习。核心思想样本和正样本之间的相似度远远大于样本和负样本之间的相似度:
这里的 x 通常也称为 「anchor」数据,为了优化 anchor 数据和其正负样本的关系,我们可以使用点积的方式构造距离函数,然后构造一个 softmax 分类器,以正确分类正样本和负样本。这应该鼓励相似性度量函数(点积)将较大的值分配给正例,将较小的值分配给负例:
通常这个损失也被称为 InfoNCE (多么炫酷的名字啊),后面的所有工作也基本是围绕这个损失进行的。
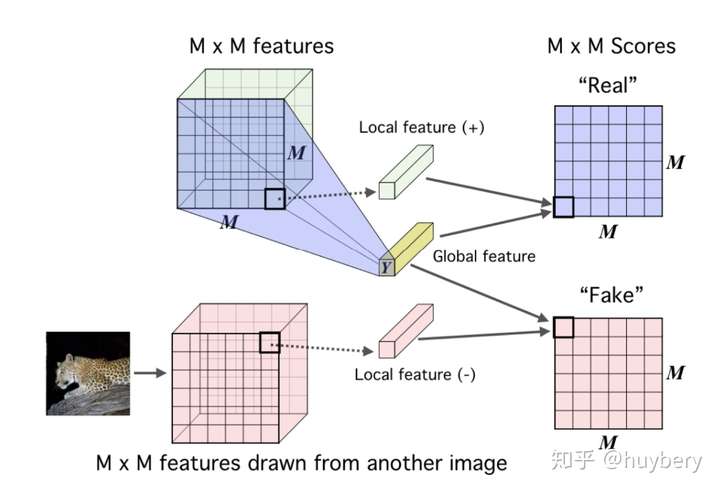 DIM
我们首先介绍 ICLR 2019 的 DIM [23],DIM 的具体思想是对于隐层的表达,我们可以拥有全局的特征(编码器最终的输出)和局部特征(编码器中间层的特征),模型需要分类全局特征和局部特征是否来自同一图像。所以这里 x 是来自一幅图像的全局特征,正样本是该图像的局部特征,而负样本是其他图像的局部特征。这个工作的开创性很强,已经被应用到了其他领域,比如 graph [24]。
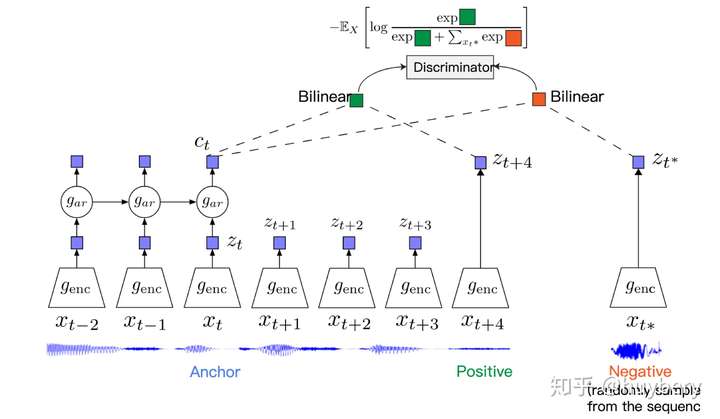 CPC
CPC 同样是一个基于对比约束的自监督框架,主要是可以应用于能够以有序序列表示的任何形式的数据:文本、语音、视频、甚至图像(图像可以被视为像素或块的序列,后面作者也给出了具体的想法)。CPC 主要是利用自回归的想法,对相隔多个时间步长的数据点之间共享的信息进行编码来学习表示,这个表示 c_t 可以代表融合了过去的信息,而正样本就是这段序列 t 时刻后的输入,负样本是从其他序列中随机采样出的样本。CPC的主要思想就是基于过去的信息预测的未来数据,通过采样的方式进行训练。
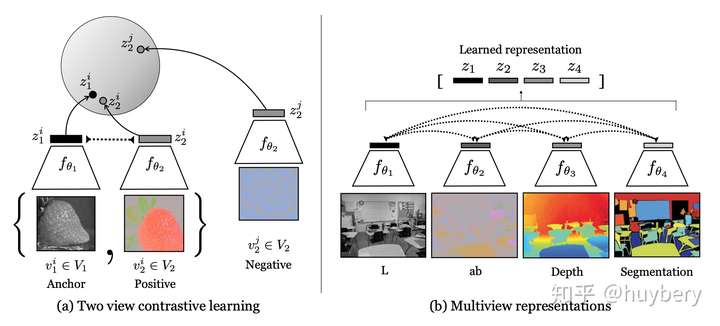 CMC
所以基于对比约束的自监督方法主要围绕如何选取正负样本,
大佬提出了利用多模态(多视角)的信息来构造样本[26] ,一个样本的多个模态为正样本,其他样本的模态为负样本。我认为这个工作还是很有启发性的,很遗憾 ICCV2019 没有中,真心希望这篇文章能够有一个好的归宿。
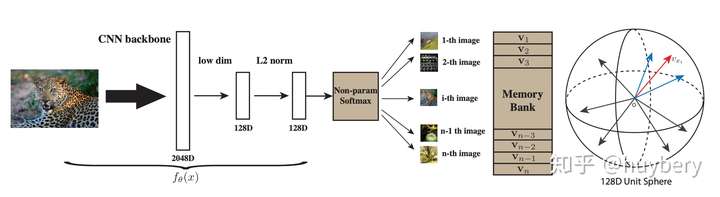 Memory Bank
对于具体的实现上,因为存在大量的样本,如何存取和高效的计算损失是急需解决的。研究人员提出了memory bank [27]的概念,也就是说我们把之前模型产生样本特征全部存起来,当前计算损失的时候直接拿来用就可以了,每次模型更新完后将当前的特征重新更新到 memory bank 中,以便下一次使用。这个工作的缺点就在于每次需要将所有样本的特征全部存起来。后续 kaiming 大神提出的 Moco[28], 主要的贡献是 Momentum Update、 shuffleBN 等技术点来优化这个过程。关于 Moco 知乎上已经有了很多的解释了,推荐大家阅读 [2],这里我们就不展开介绍了。
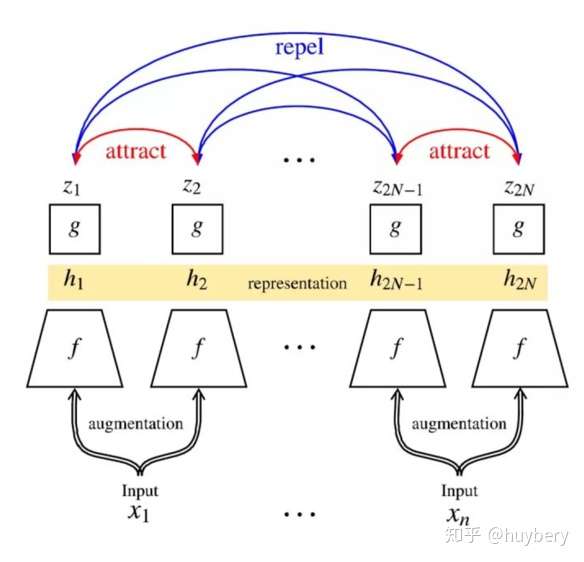 SImCLR
最近 hinton 组又放出了 SimCLR[29],这个工作主要是对于一个输入的样本,进行不同的数据增广方式,对于同一个样本的不同增广是正样本,对于不同样本的增广是负样本。整个过程比之前kaiming提出的动量对比(MoCo)更加的简单,同时省去了数据存储队列。这个工作的创新主要有两个:
- 在表征层和最后的损失层增加了一个非线性映射可以增加性能 (这个地方我比较好奇,希望能有大佬给出更直观的解释)。
- 数据增广对于自监督学习是有益的,不同数据增广方式的结合比单一增广更好。
同时作者公布了非常多的实验经验,比如自监督学习需要更大的 batch 和更长的训练时间。

 浙公网安备 33010602011771号