第二周作业:查重
第二周个人编程作业:论文查重
作业信息
| 项目 | 内容 |
|---|---|
| 姓名 | 吴与同 |
| 学号 | 3124004108 |
| 班级 | 计算机科学与技术 6 班 |
| 作业要求 | 第二周个人编程作业 |
| GitHub 仓库 | FLC-niko/3124004108 |
| 使用语言 | Java 17 |
一、题目和完成情况
这次作业的题目是论文查重。程序从命令行接收原文、抄袭版和答案文件的绝对路径,读取两个文本,计算相似度,并把保留两位小数的结果写入答案文件。
仓库中新建了学号目录 3124004108,里面包含源代码、测试代码、构建脚本和 main.jar。运行方式如下:
cd 3124004108
java -jar main.jar <原文绝对路径> <抄袭版绝对路径> <答案绝对路径>
程序只访问命令行指定的三个路径,不联网,也不调用系统命令。答案文件只写入类似 0.78 的结果,不输出额外说明。
二、PSP 表格
下面的表格根据本次开发过程整理,提交前我会再按照自己的实际记录核对时间。
| 阶段 | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|
| Planning 计划 | 20 | 25 |
| Analysis 需求分析 | 40 | 45 |
| Design Spec 设计文档 | 30 | 35 |
| Design Review 设计复审 | 20 | 15 |
| Coding Standard 代码规范 | 15 | 10 |
| Design 具体设计 | 30 | 35 |
| Coding 具体编码 | 100 | 120 |
| Code Review 代码复审 | 25 | 25 |
| Test 测试 | 60 | 75 |
| Test Report 测试报告 | 20 | 25 |
| Size Measurement 工作量统计 | 10 | 10 |
| Postmortem & Process Improvement Plan | 20 | 20 |
| 合计 | 390 | 440 |
这次花时间比较多的地方是边界情况和命令行文件读写。刚开始容易只关注正常输入,后来把空文件、路径错误、编码错误和输出目录不存在也列进了测试范围。
三、计算模块的设计与实现
1. 类和函数的划分
程序没有把所有逻辑都写在 main 方法里,而是按职责分成几个小模块:
Main
 ├── FileService:读取 UTF-8 输入文件、写入答案文件
 └── SimilarityCalculator
      ├── TextTokenizer:把文本转换成可比较的 token
      └── SimilarityResult:保存相似度和 token 数量
Main 只负责检查参数、串起流程和处理错误。FileService 不负责计算,计算模块也不直接操作文件,这样测试相似度时不需要先准备文件。
2. 分词方法
这次没有引入网络词典或第三方分词包,主要考虑到评测环境可能没有额外依赖。具体处理方式是:
- 中文字符按单个字符处理;
- 英文和数字按连续内容组成一个 token,并统一转成小写;
- 空格、换行和标点不参与比较;
- 中英文混合文本按各自规则处理。
这个方法不追求完整的自然语言理解,但对于本题的增删改文本足够简单、稳定,也方便在 Windows 和 Linux 环境中直接编译。
3. 相似度计算
先统计每个 token 出现的次数,得到两个词频向量。最后使用余弦相似度:
similarity = A·B / (|A| × |B|)
相同文本的结果为 1.00,完全没有共同 token 的文本为 0.00。如果两个文件都只有标点或空白,程序将它们视为相同的空文本;只有一边为空时返回 0.00。
计算时使用哈希表保存词频,不需要对两个文本的每一个 token 做逐个比较。假设不同 token 数量为 n、m,建表和计算的主要复杂度约为 O(n + m),额外空间为 O(n + m)。
四、性能改进
性能检查时重点看了两个地方:文本扫描和词频向量计算。实现中让 TextTokenizer 对每个字符只扫描一次;计算点积时只遍历原文词频表,再从另一张表中查找同名 token,避免使用双重循环比较所有 token。
为了方便重复测试,仓库的 performance/PerformanceBenchmark.java 会对较长的中英文文本重复计算。实际采样时使用 IntelliJ IDEA 自带的 async-profiler,以 CPU 事件记录运行 3000 次的调用栈,得到的运行时间约为 22270.44 ms。
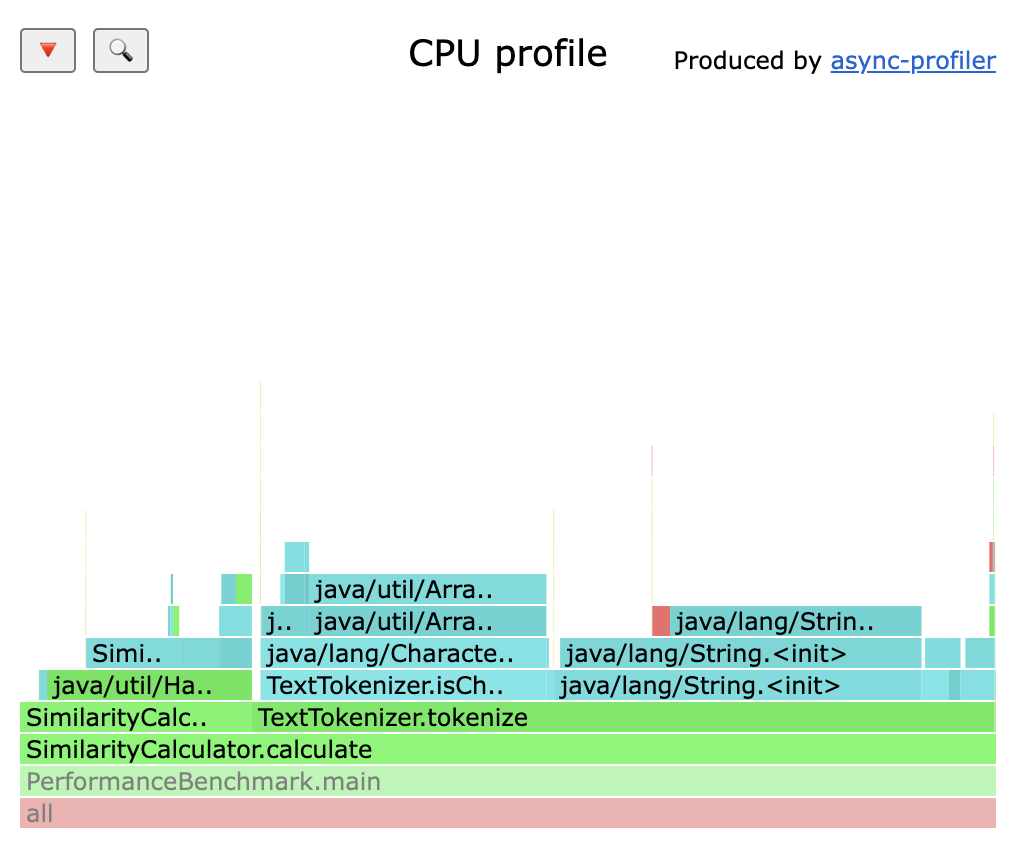
从采样图可以看到,SimilarityCalculator.calculate 负责组织一次完整计算,放大该方法后 profiler 显示为 2,201 samples,96.32%;TextTokenizer.tokenize 在业务调用栈中占据较宽的部分,说明逐字符扫描和 token 创建是主要开销之一。词频统计函数 SimilarityCalculator.frequency 也出现在这条调用路径中,放大后显示为 523 samples,22.89%。这里的函数名和采样数字来自 profiler 的实际结果,不是预先猜测的热点。如果后续测试发现超长文件仍然占用较多内存,可以进一步改为流式读取和增量统计,但本题要求先读取文件后统一计算,当前实现更容易保证逻辑清楚。
五、单元测试
测试代码位于 3124004108/src/test/java,不依赖网络。执行:
bash scripts/test.sh
本次共设计 15 个测试用例,主要覆盖:
- 英文完全相同;
- 完全不同;
- 两个空文本;
- 单边空文本;
- 增加内容;
- 删除内容;
- 替换内容;
- 重复词;
- 中文增删改;
- 标点和空白差异;
- 中英文混合;
- token 数量统计;
- 命令行输出两位小数;
- 参数数量错误;
- 相对路径和输入文件不存在。
测试使用的一个例子如下:
void ChineseTextCanBeComparedWithoutDictionary() {
    SimilarityResult result = calculator.calculate(
            "今天是星期天,天气晴,今天晚上我要去看电影。",
            "今天是周天,天气晴朗,我晚上要去看电影。");
    TestSupport.assertTrue(result.getSimilarity() > 0.5
            && result.getSimilarity() < 1.0,
            "中文增删改文本应保留明显的相似度");
}
本地运行结果为 15 passed, 0 failed。
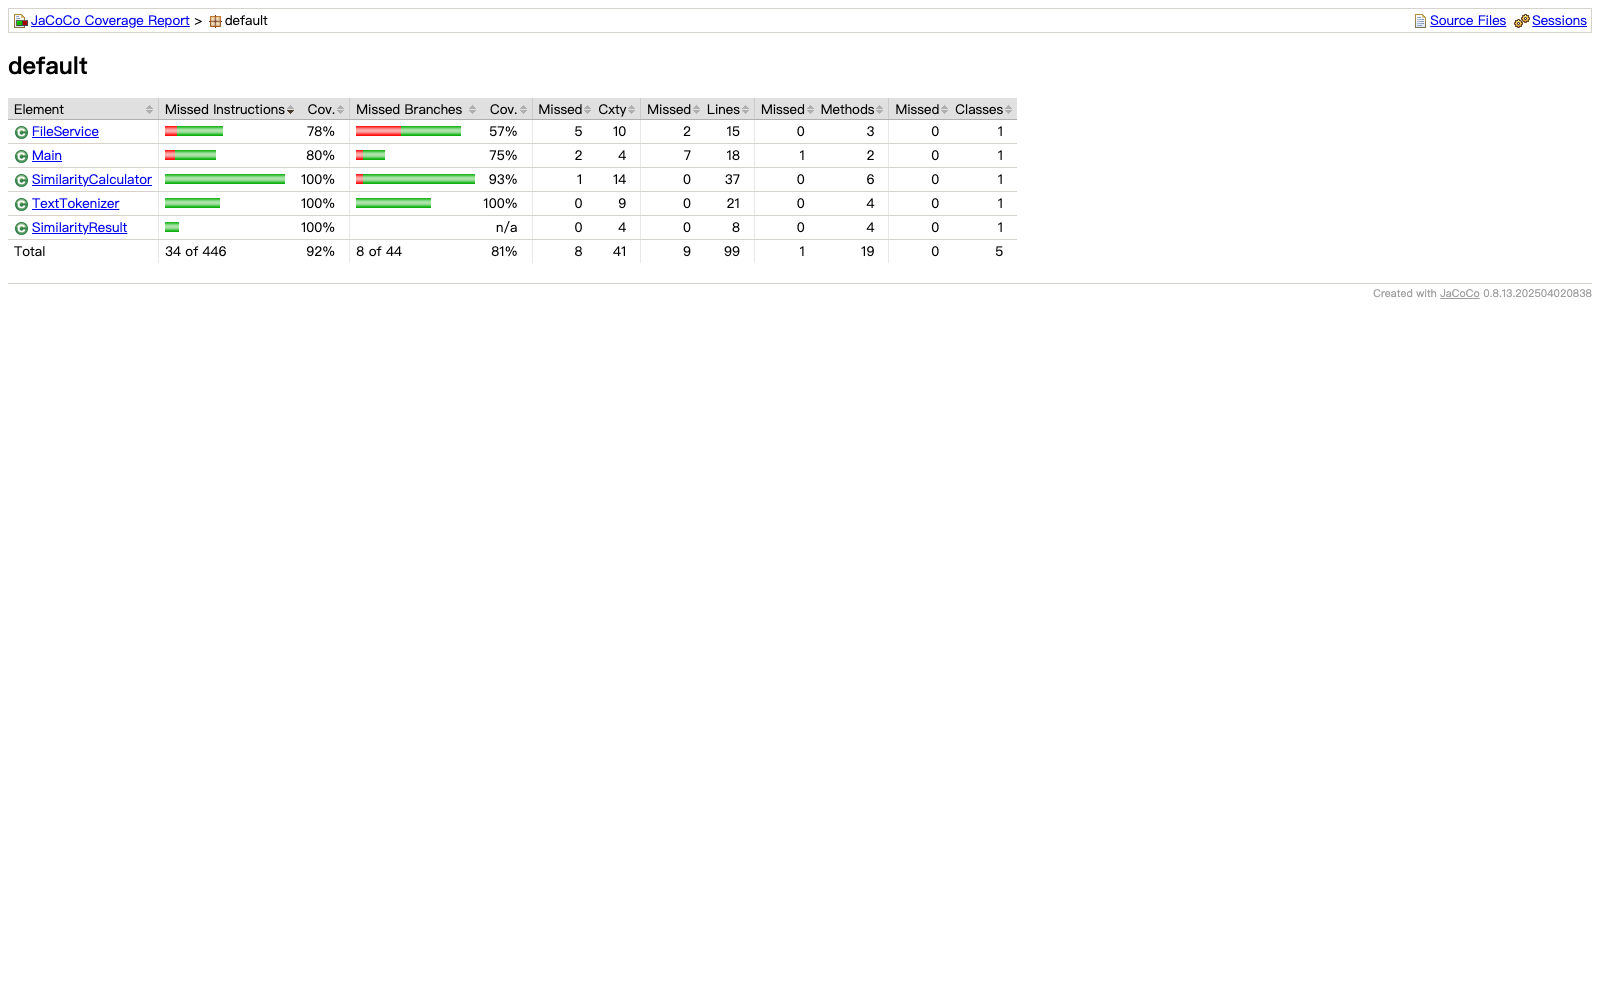
覆盖率报告由 JaCoCo 0.8.13 根据这 15 个测试的实际执行结果生成,汇总覆盖率为:指令 92%、分支 81%、行覆盖率约 91%、方法覆盖率约 95%、类覆盖率 100%。博客中可插入仓库里的报告截图:
六、异常处理
程序把可预期的错误转换成清楚的错误信息,并以非零状态码结束:
| 场景 | 处理方式 |
|---|---|
| 参数不是 3 个 | 提示命令格式并退出 |
| 输入或输出不是绝对路径 | 拒绝执行并提示原因 |
| 输入文件不存在或不是普通文件 | 抛出文件异常并提示路径 |
| 输出目录不存在 | 不擅自创建其他目录,提示输出路径错误 |
| 文件不是有效 UTF-8 | 由文件读取异常统一报告 |
| 计算过程中出现非法空值 | 由模块参数检查及时发现 |
这些场景都不应该让程序输出一个看起来正常但实际不可信的答案。单元测试已经覆盖参数数量、相对路径和输入文件不存在的情况。
七、GitHub 过程记录
我按“先完成基本功能,再补充测试和文档”的顺序提交代码。每次修改后先运行构建和测试脚本,再提交到仓库。提交记录和仓库首页截图放在这里:


仓库中还配置了 GitHub Actions,在 push 和 pull request 时自动执行测试以及 javac -Xlint:all -Werror 检查。这样可以在本地检查之外再多一层验证。
八、总结
这次作业让我比较明显地体会到,输入输出题也不能只写一个能跑的主函数。文件路径、编码、空输入和错误处理都会影响最后的结果。把分词、计算和文件操作拆开以后,测试也更容易写。
当前程序的优点是依赖少、运行入口简单、边界处理比较完整;不足是中文只按单字处理,不能识别真正的词语,也没有用大型样本做准确度对比。后续如果要继续改进,我会先准备一批带人工结果的样本,再比较词典分词、字符 n-gram 和当前词频余弦方法的差异,而不是只凭一个样例判断算法好坏。

 浙公网安备 33010602011771号