
 读懂大模型量化标签:存储格式、计算精度与运行时内存
 从系统视角区分权重编码、计算类型、激活、KV cache 和文件容器,说明为什么一个 Q4 标签无法决定速度与质量。
一个模型文件名里可能同时出现 8B、Q4_K_M 和 GGUF,运行日志里又出现 BF16。若把这些字段当成同一层精度描述,容量和性能判断很容易出错。
更稳妥的做法,是沿着模型数据的生命周期分层阅读。
参数规模与权重编码
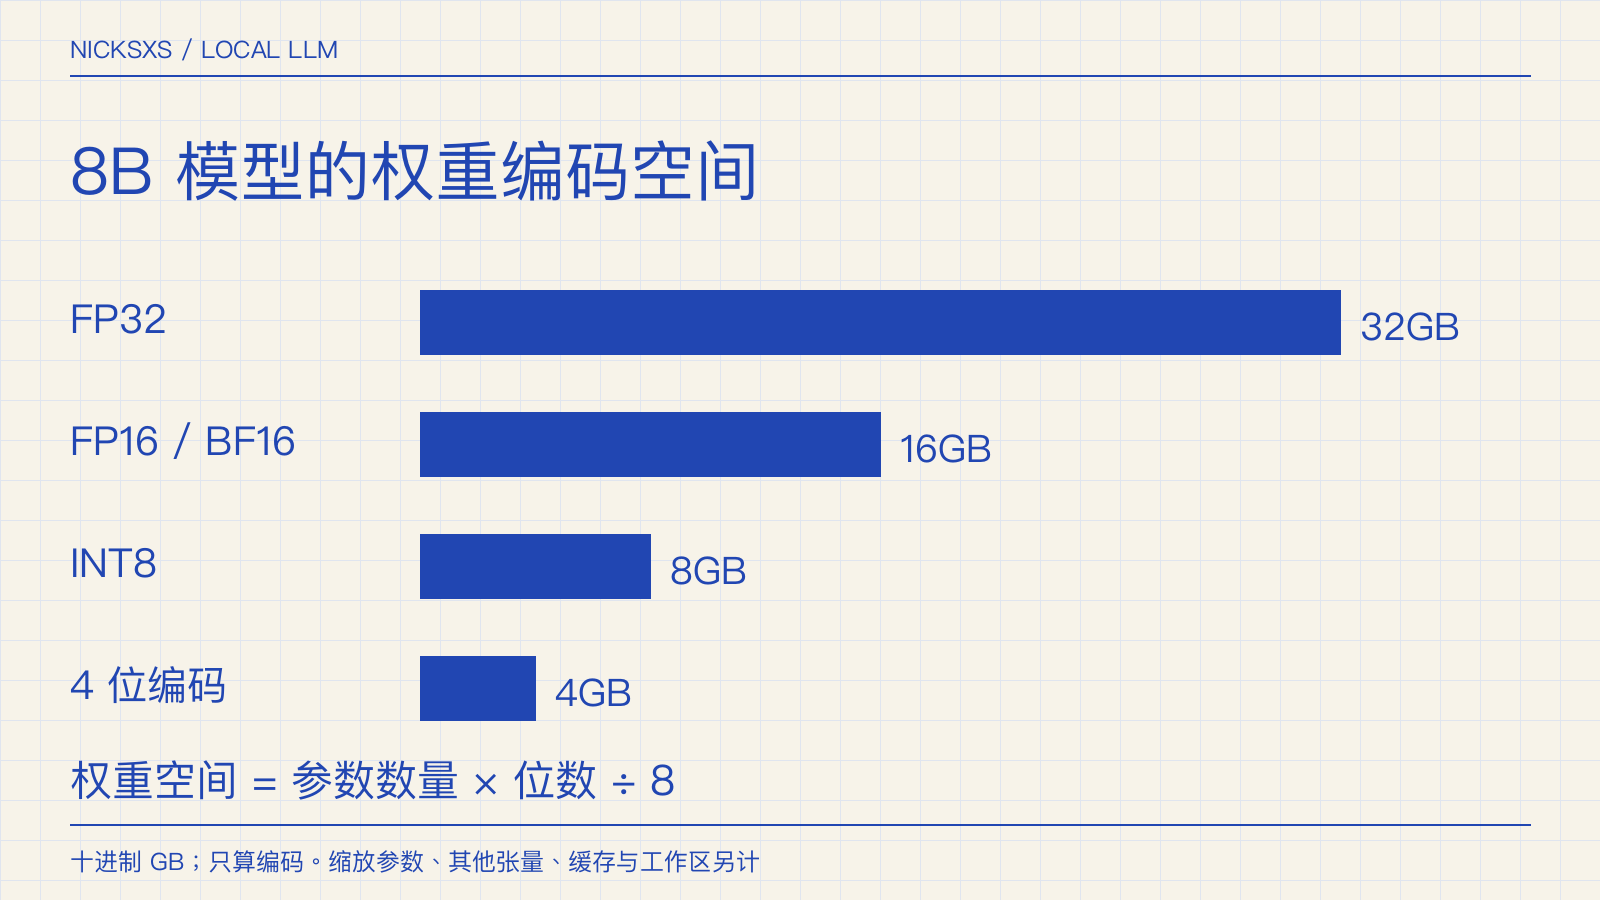
8B 表示约 80 亿个参数。忽略辅助信息时:
weight_bytes = parameters × bits_per_parameter / 8
16 位权重约 16GB,4 位编码约 4GB。真实文件还包含量化参数、未量化张量和元数据。
浮点格式不是只看总位数
FP16 与 BF16 都占 16 位。FP16 将更多位留给有效数字,BF16 将更多位留给指数范围。前者刻度更细,后者覆盖范围更宽。
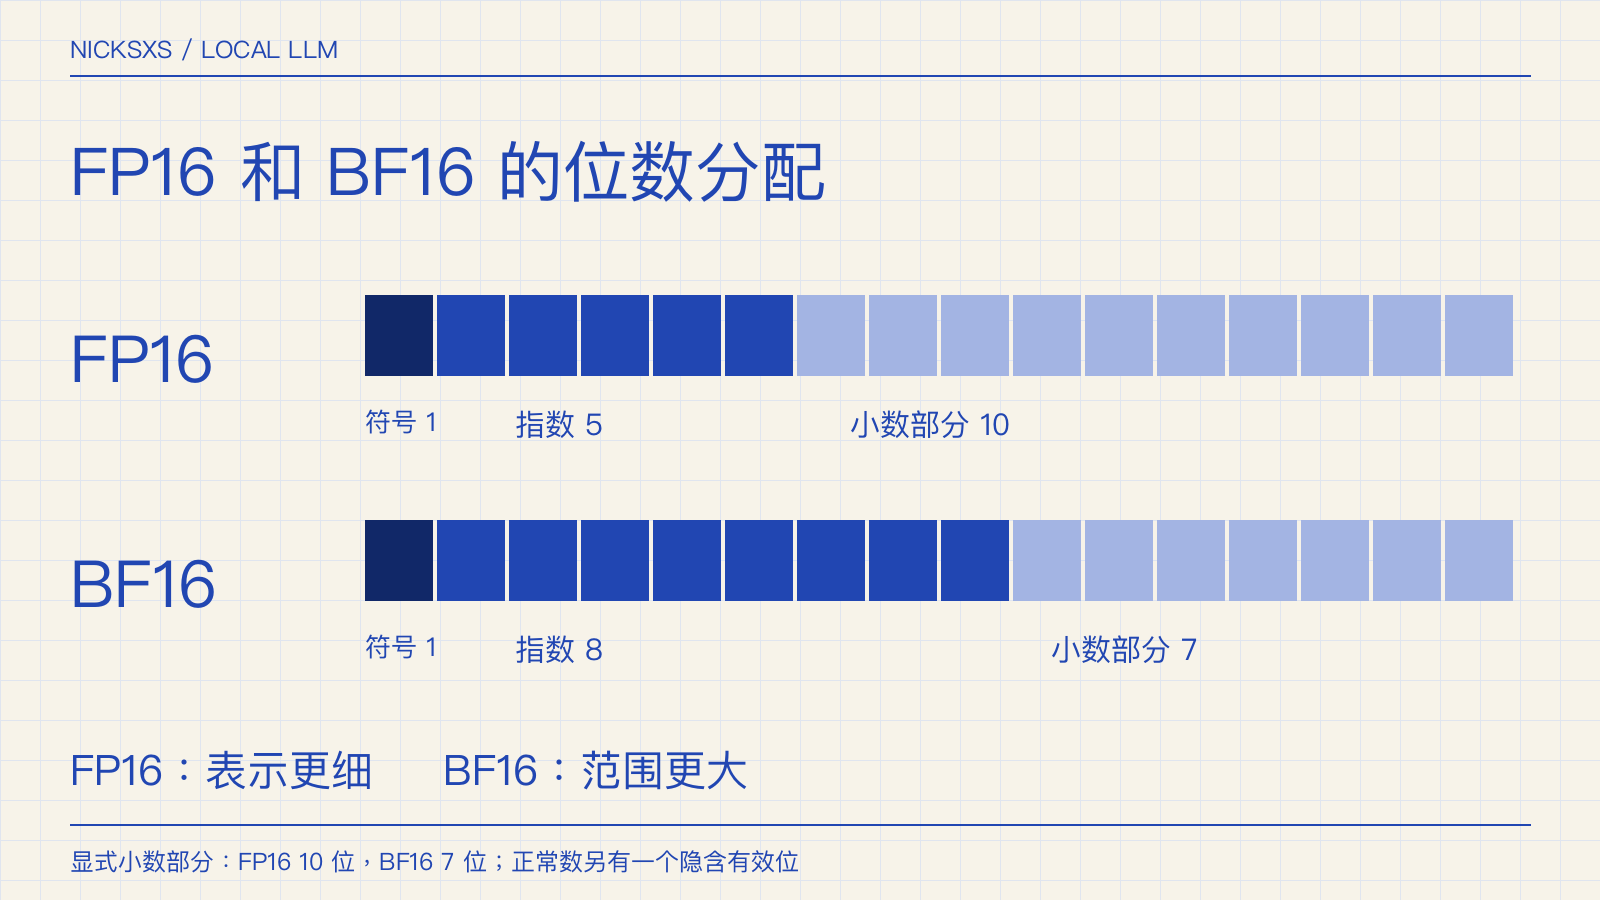
因此,“BF16 比 FP16 更省内存”不是一个成立的判断。选择哪种格式,需要看硬件支持、算子实现和数值范围。
整数量化依赖 scale 与 zero point
常见仿射量化:
q = clip(round(x / scale + zero_point))
x_approx = scale × (q - zero_point)
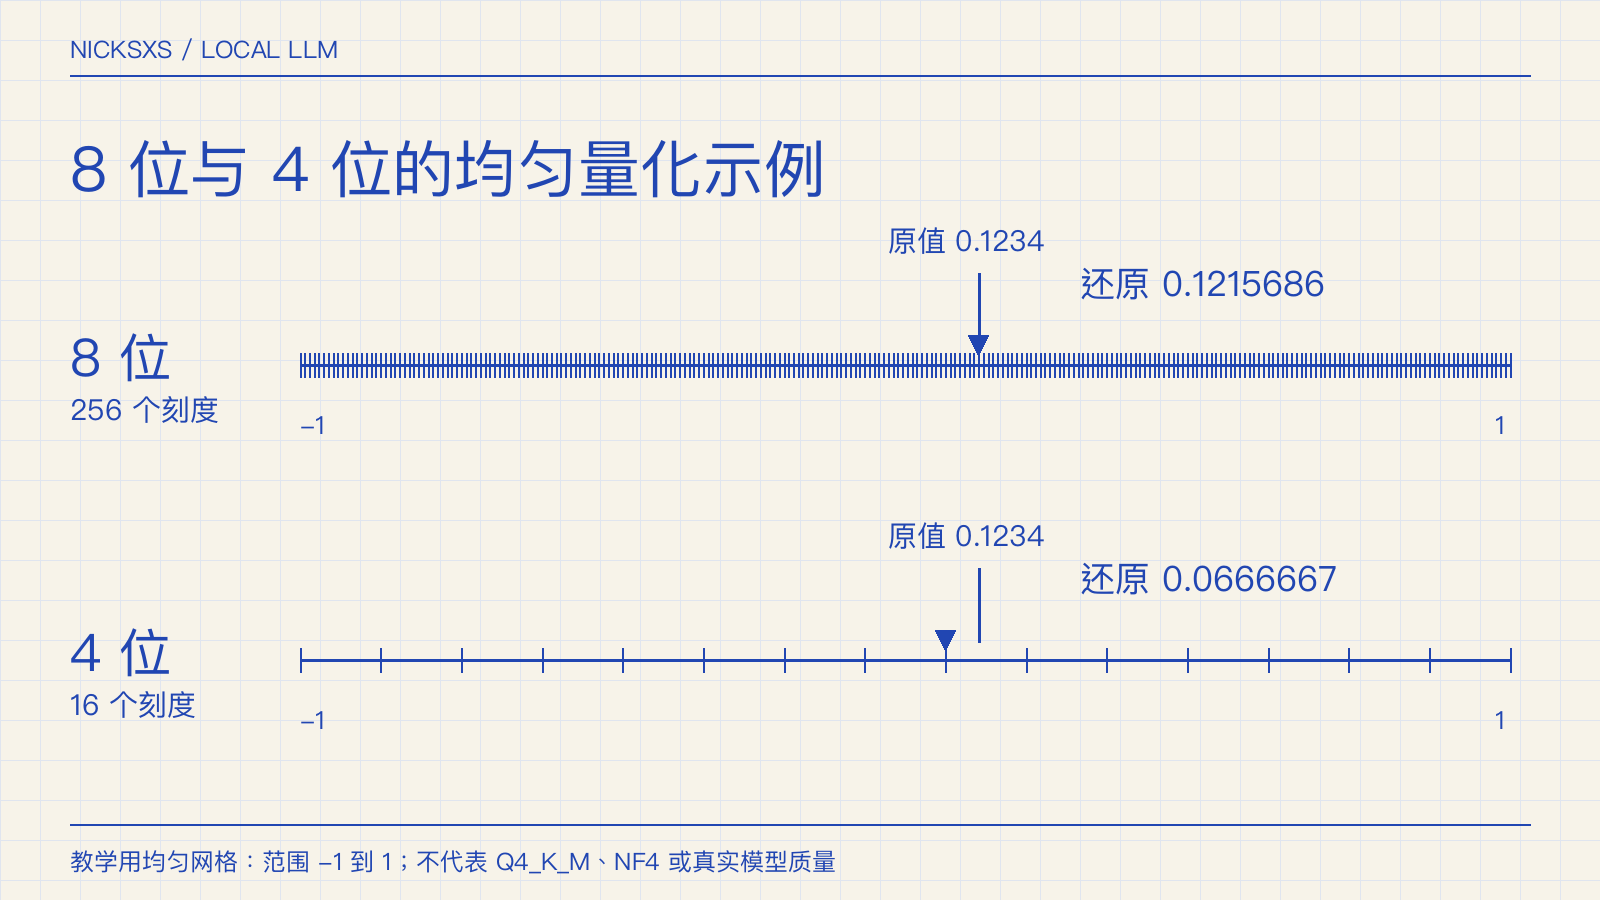
整数只是刻度编号。per-tensor、per-channel 和 per-group 的差别,是多大范围共享一组量化参数。粒度更细通常能更好地适应局部数值范围,也会增加辅助数据与实现复杂度。
4 位编码只有 16 个值。GPTQ 使用校准输入和近似二阶信息,AWQ 根据激活分布保护重要权重通道,NF4 使用非均匀码本。它们都在解决有限刻度怎样分配的问题。
Q4_K_M 是预设,不是单一基础类型
llama.cpp 的 Q4_0 块包含 32 个 4 位权重和一个 FP16 scale,平均 4.5 bit/weight。Q4_K 块还包含 super-block 的 scale、min 和量化后的子块 scale,当前源码同样标注为有效 4.5 bit/weight。
Q4_K_M 以 Q4_K 为主,并为部分敏感张量选择 Q5_K 或 Q6_K。M 表示 Medium 预设。模型架构与实现版本会影响具体张量分配,文件整体不能按严格 4 位数组理解。
运行时是另一套类型系统
压缩权重可以按块解码后使用 BF16 或 FP16 计算。实现若能把解码、缩放与矩阵运算融合,便不必常驻完整的 16 位权重副本。
W4A16 描述权重与激活的位数,KV cache 则是独立的运行状态。缓存精度、上下文长度、batch、并发和模型结构都会改变运行时内存。
GGUF 和 safetensors 负责文件组织,不决定里面每个张量的编码。PTQ 与 QAT 描述量化发生在训练之后,还是训练时就模拟量化误差。把这些维度分开,文件名才读得完整。
容量、速度与质量分别验证
容量可以先按权重文件、KV cache、激活工作区和框架余量估算。速度至少分 prefill 与 decode;质量则用固定基础模型、提示词和采样设置,在真实任务集合上比较。
低位权重减少内存带宽,有机会提高速度。解包、缩放、设备间传输和后端内核也有成本,因此不存在“权重缩小 4 倍,推理必然快 4 倍”的通用关系。
配套数值脚本只复核位数、浮点舍入和均匀量化教学示例,不加载模型。
参考资料
- 量化对象和数字编码:Hugging Face 量化概念、量化公式与数字格式。
- 浮点范围:NVIDIA FP16 说明、Google Cloud BF16 说明。
- Q4 块大小与混合预设:llama.cpp 块定义、量化实现。
- 存储、计算与缓存:bitsandbytes 配置、KV cache 文档。
- 量化方法:GPTQ 论文、AWQ 论文、QLoRA / NF4 论文。
- 文件容器:GGUF 官方规范。

 浙公网安备 33010602011771号