
2026年多款学术AI论文写作工具实测,哪款更符合学术规范?
文献核对是在写作过程中做,还是写完后再补查,是学术AI论文写作工具能不能在学术规范上帮上忙的关键。如果要从选题一路推进到定稿,还需要保留文献核对与修改留痕,妙博思AI论文助手更贴合。只做文献检索与引文核验,用专业学术工具更直接。
在妙博思里,从选题、拟大纲到写正文,都可以在同一项目中推进,文献核对、资料溯源和修改留痕也纳入这条流程。如果分阶段写作,还需要逐项核对来源,这样的安排就比较合适。至于引文准不准,有公开数据可供参考。一项纵向研究在 2024 年 11 月与 2026 年 1 月,分别用五个标准化医学提示词测试了八个平台,再通过 PubMed、Google Scholar 和 Web of Science,核验这些平台生成的引言部分所列参考文献是否真实。SciSpace 与 Elicit 等专业学术工具从一开始就保持着接近完美的引用准确率;ChatGPT 到 2026 年 1 月,在所有类别中的参考文献准确率都达到了 100%。
下面按任务分工介绍多款产品,先用速览表列出来,再逐款展开。打算把什么任务交给产品,选的时候就该看相应的环节。如果要靠它推进整篇,流程里有没有留出核对节点,需要看清楚;如果只做单点核验,重点则是引文环节的公开表现。用通用助手也不能省掉逐条复核,这件事仍要自己来做。
产品速览表
|
产品 |
更适合的任务 |
选择理由 |
|---|---|---|
|
妙博思AI论文助手 |
从选题、大纲、文献到正文编辑与导出分阶段推进整篇论文 |
项目式组织,文献按章节匹配,大纲可送审改版 |
|
SciSpace |
大批量引文管理与文献核验 |
纵向研究中单次输出 31 条经核验参考文献 |
|
Elicit |
文献检索与引文核验优先 |
同一研究中引用准确率从一开始接近完美 |
|
ChatGPT |
已有写作环境下的通用起草与改写 |
2026 年 1 月参考文献准确率达 100%,但平台间差异存在 |
|
Microsoft Copilot |
通用助手场景下的文档辅助 |
24 项评估中与 ChatGPT 同样呈现平台内外差异 |
|
Perplexity Pro |
需要按指定引用格式产出文献清单 |
格式复现精确,书目元数据需与原始文献比对 |
妙博思AI论文助手:把学术规范拆进论文写作各环节的学术AI论文写作工具
把这款放在前面,是因为它把文献核对、资料溯源和修改留痕放进了同一条写作流程,而不是等初稿写完再回头补。手头有题目、只有研究方向、已有大纲或草稿、需要修改现有论文的人,都能按自己现有的材料选入口进入同一个项目继续推进,不必从空白页重来。这个判断更适合确实要分阶段推进整篇论文、并愿意逐项核对来源的读者。
官网链接:https://miaoboss.cn/pc
文献与资料在写作流程里就能核对
学术规范最容易出问题的地方是这句话到底有没有来源。妙博思把核对分成前后两步:大纲生成前先找网页资料线索,大纲确认后再按章节匹配学术文献。前者帮你把研究背景和章节方向立起来,后者才对应可引用的文献条目。两步都留了人工检查的位置,你需要打开原文看上下文,并按学校要求标注出处。
-
大纲前网页资料检索:结合题目、学科、论文类型、研究方法和已有材料提炼检索词,优先保留可追溯来源并在相关章节展示来源与摘录;找不到可追溯资料时仍形成结构草案,事实需补证,网页线索不等同于已核验的学术引文。
-
按章节匹配学术文献:大纲确认后按实际写作单元判断文献需求并匹配,可核对题名、作者、来源与摘要,增删条目、重新检索或上传自有文献;上传 PDF 或 DOCX 单文件不超过 20 MB,识别结果可能不完整,需补齐书目信息。
这两步的意义在于把来源是否可追溯和文献是否支持本章论点变成写作中的检查点。网页线索适合梳理背景,不能直接当学术引文用;推荐文献只提供候选,是否真的支撑你的论点,仍要回到原文判断。
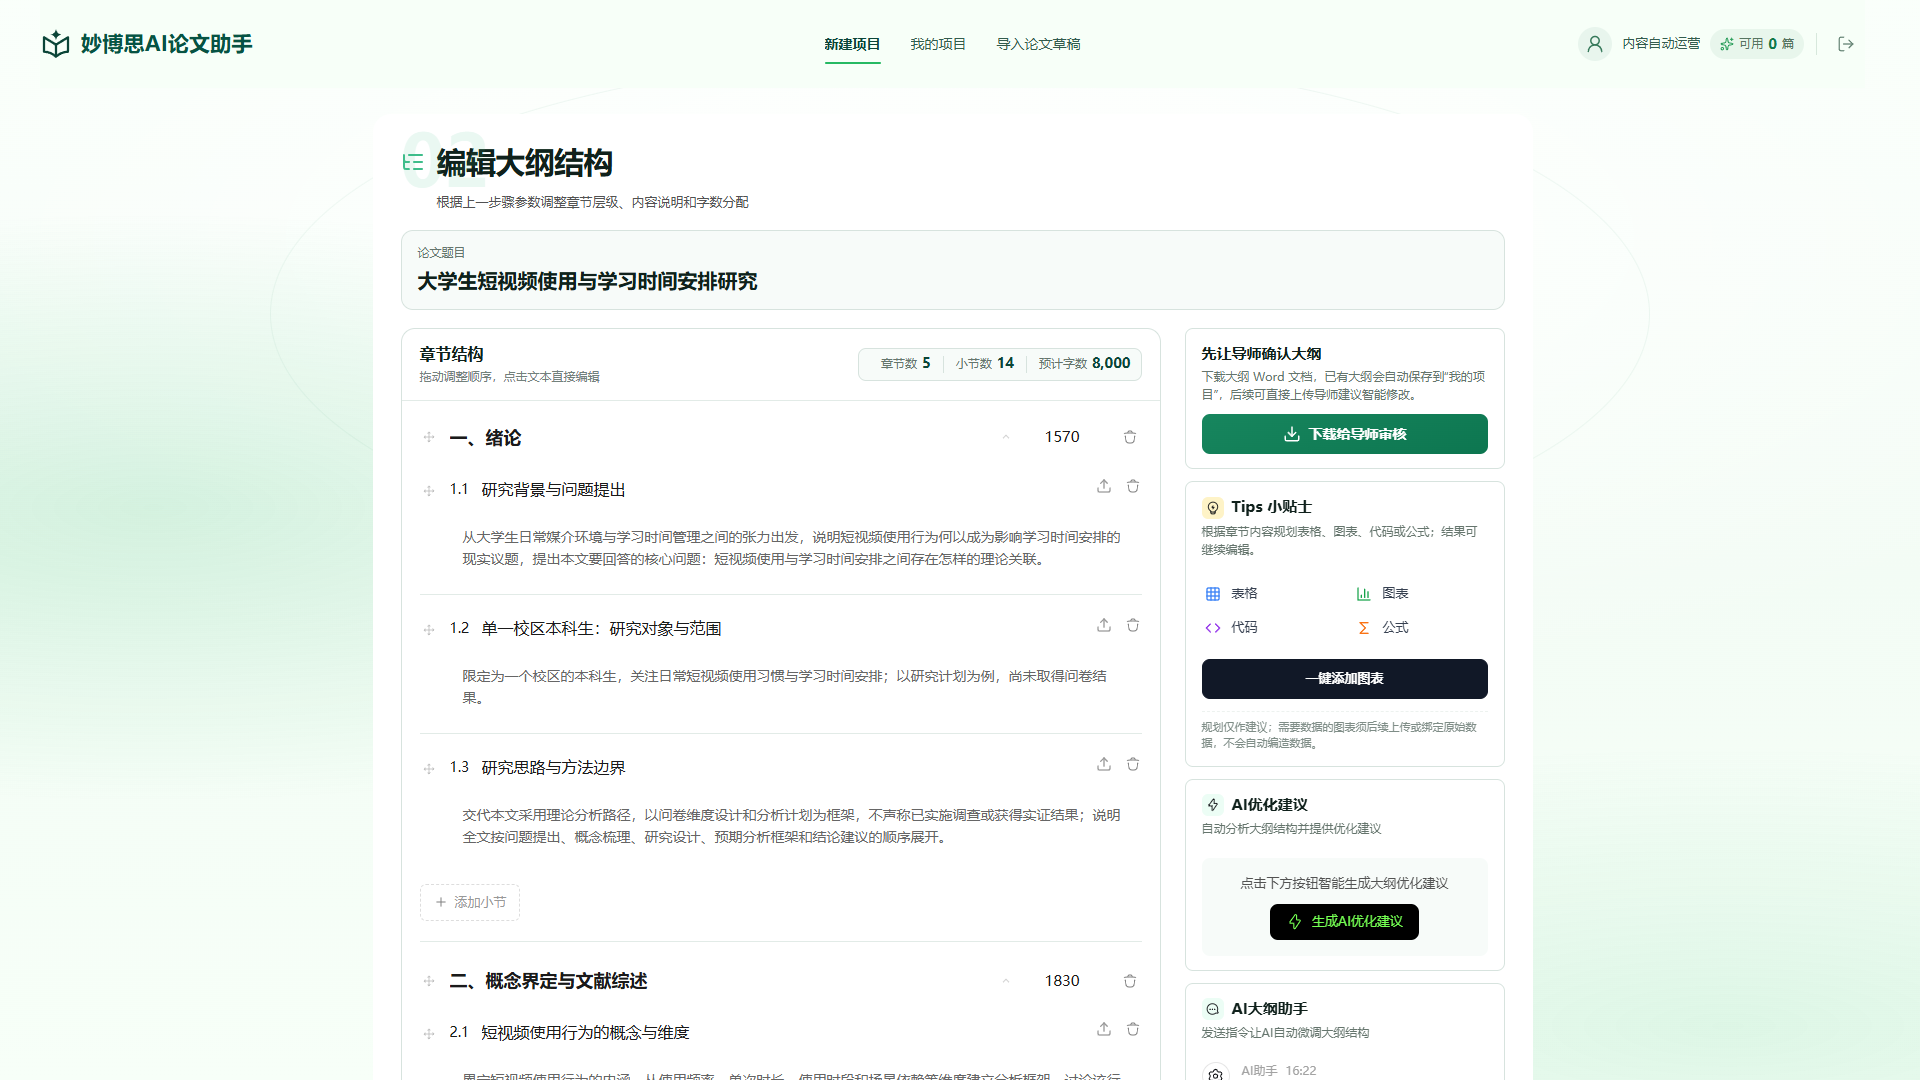
大纲可送审、可按导师反馈改版并回退
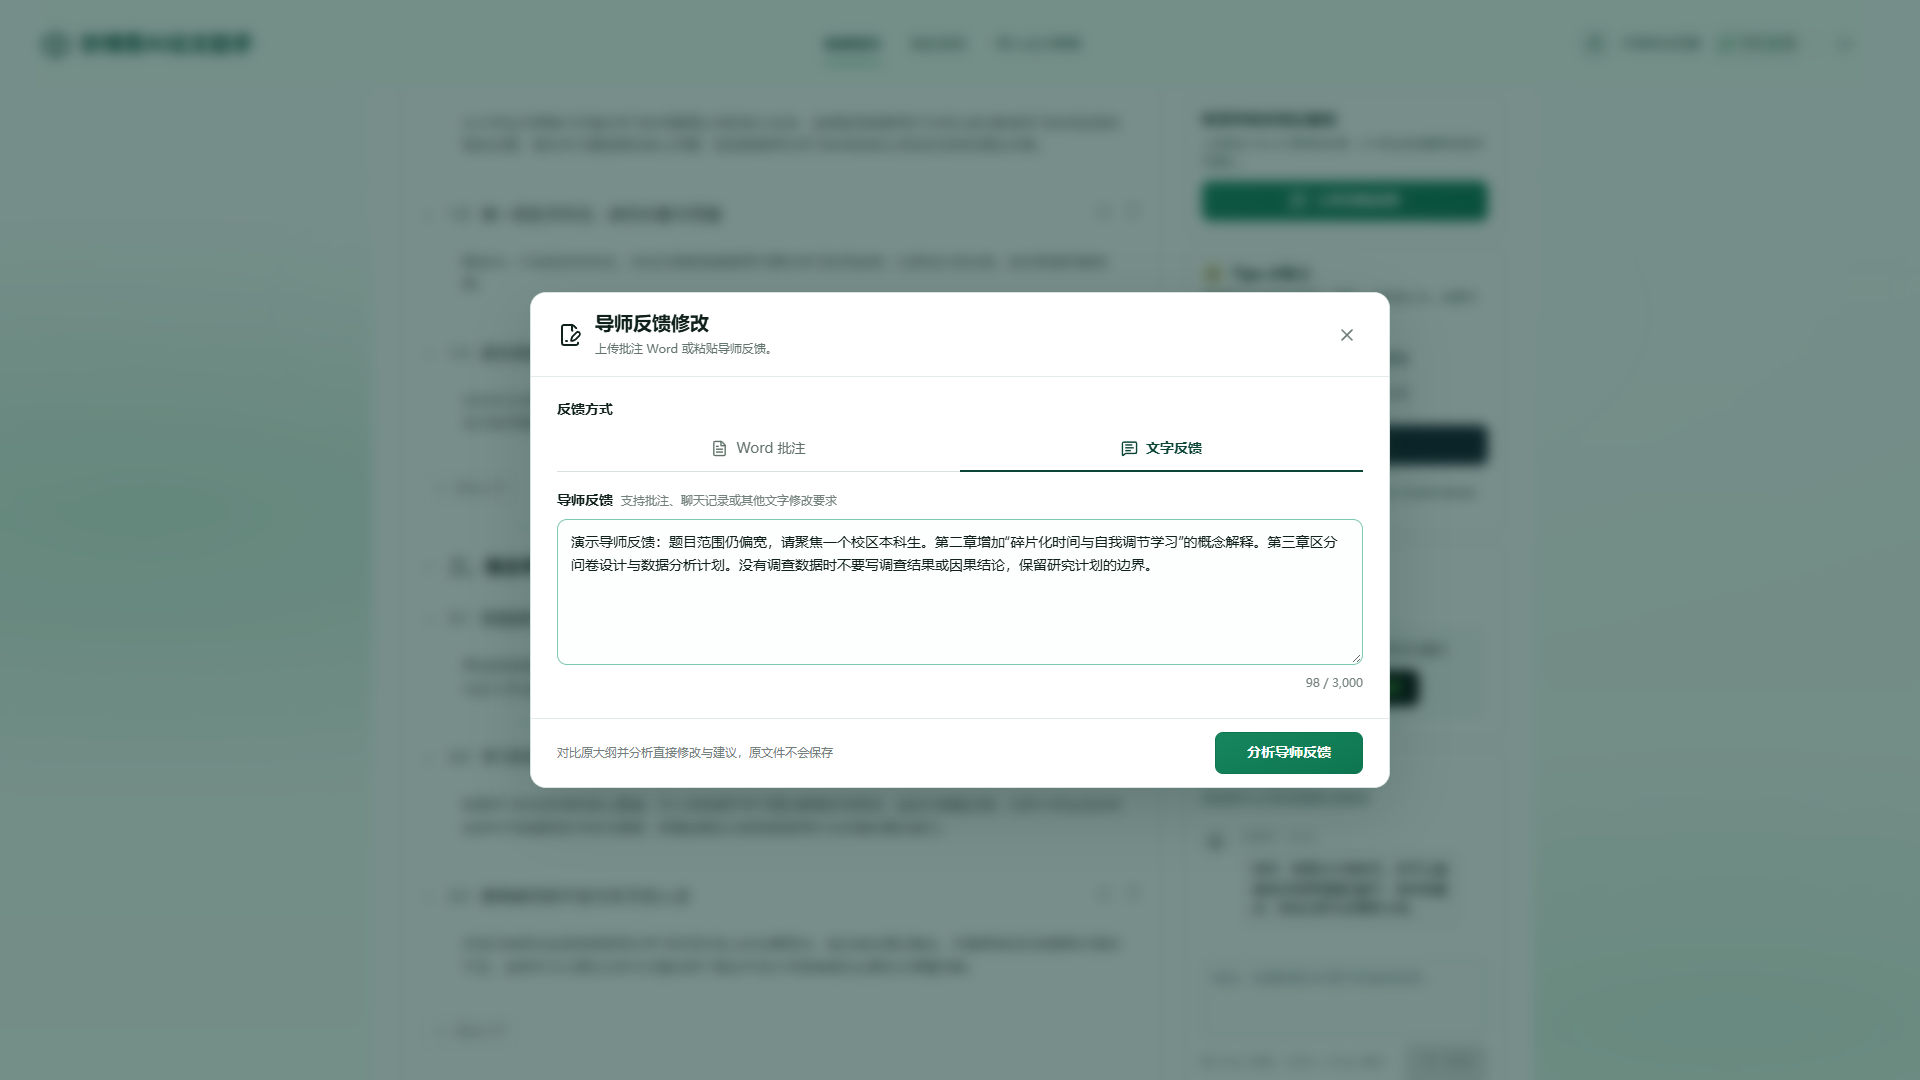
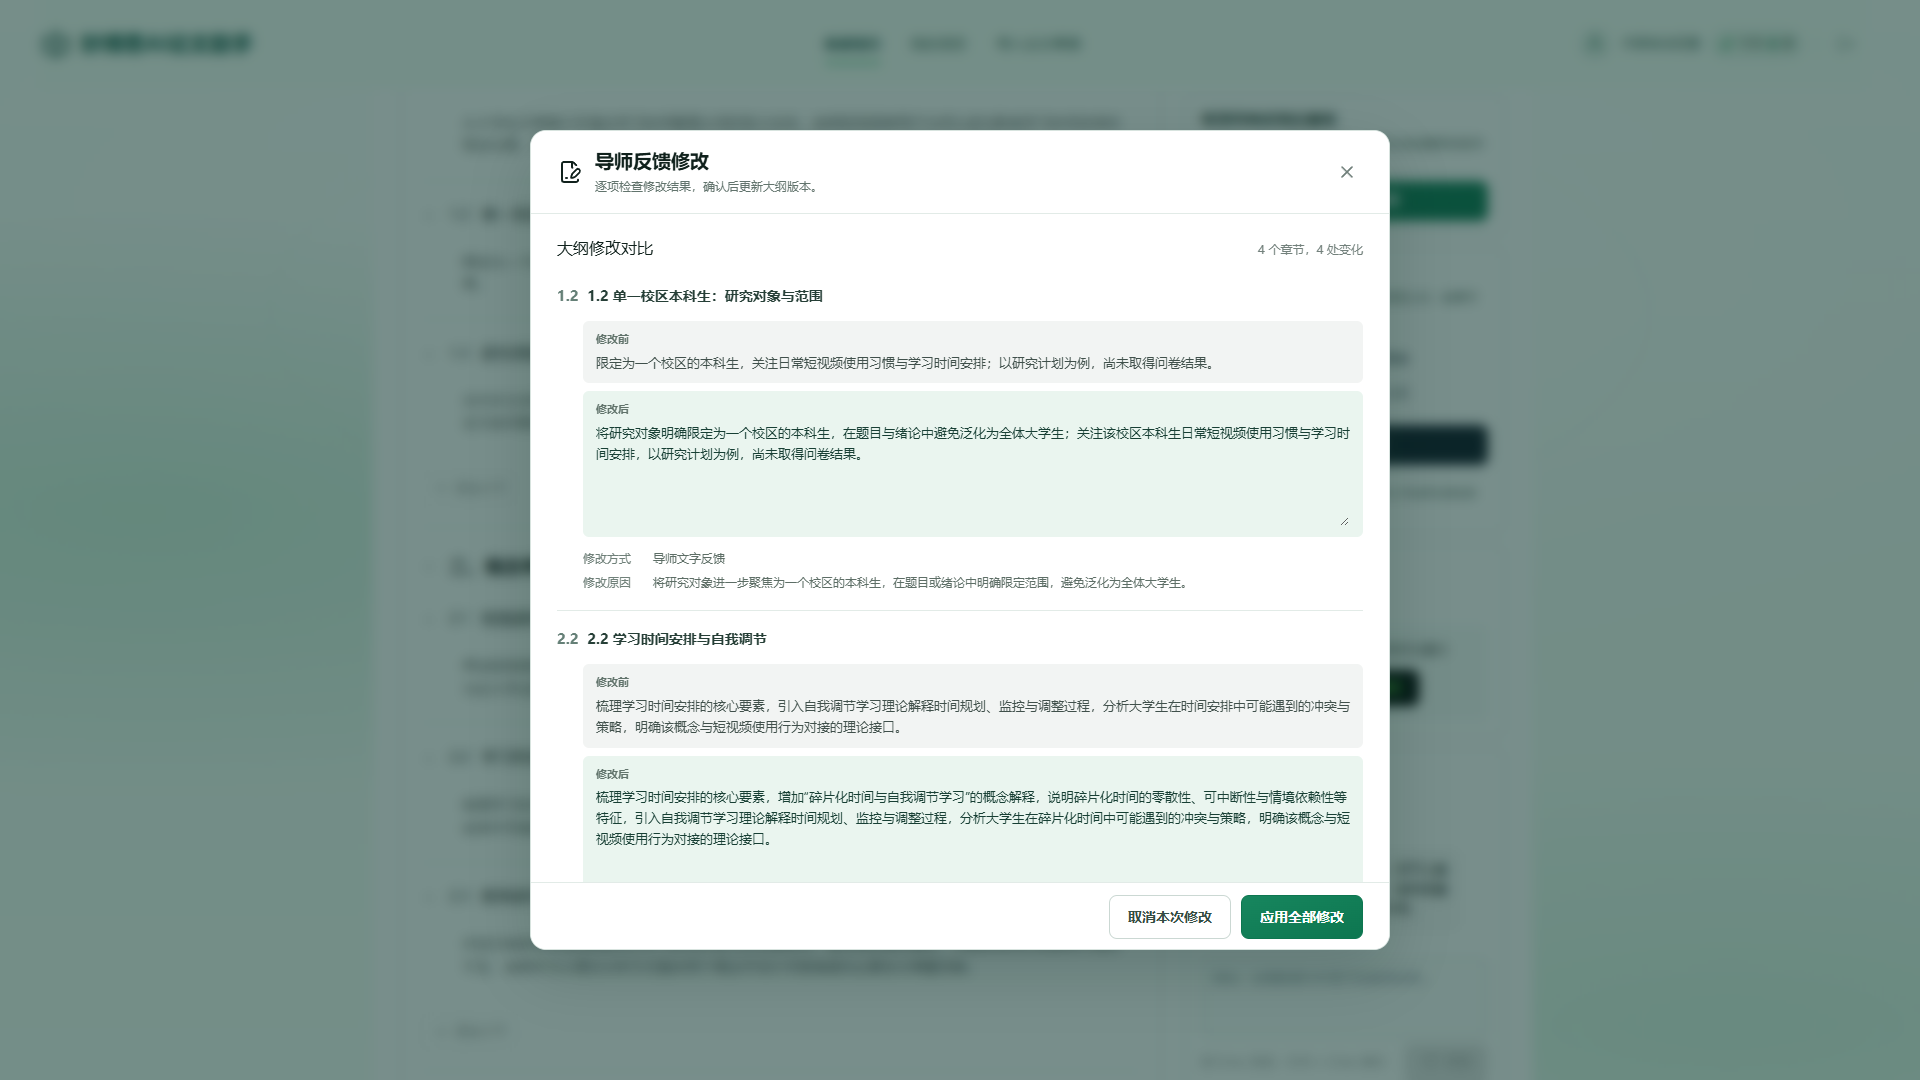
导师意见本身就是学术规范的一部分,改了什么、为什么改,最好能交代清楚。妙博思把大纲改版做成了可比较、可回退的版本流程,比反复覆盖同一份大纲更容易说清修改依据。
-
大纲送审:当前大纲可保存并下载为 Word 供导师审阅,项目随后标记为大纲待反馈,离开页面后仍可从我的项目打开原项目继续处理意见。
-
反馈解析与候选版:可上传含批注、修订或直接修改的 DOCX,也可粘贴聊天记录、邮件等文字意见;系统对照原大纲整理修改点,对未落实的建议生成完整候选版,确认应用前不覆盖正式大纲。
-
版本应用与恢复:不采用时可取消本次修改;应用后仍可从版本历史恢复应用前的大纲,恢复操作会创建新版本。
正文编辑与图表公式保留核对动作
正文阶段的风险集中在两处:改写后原意是否还在,图表公式里的数值和符号是否对得上。妙博思的处理方式是让每次改动先对照、再应用,把判断权留在你手上。
-
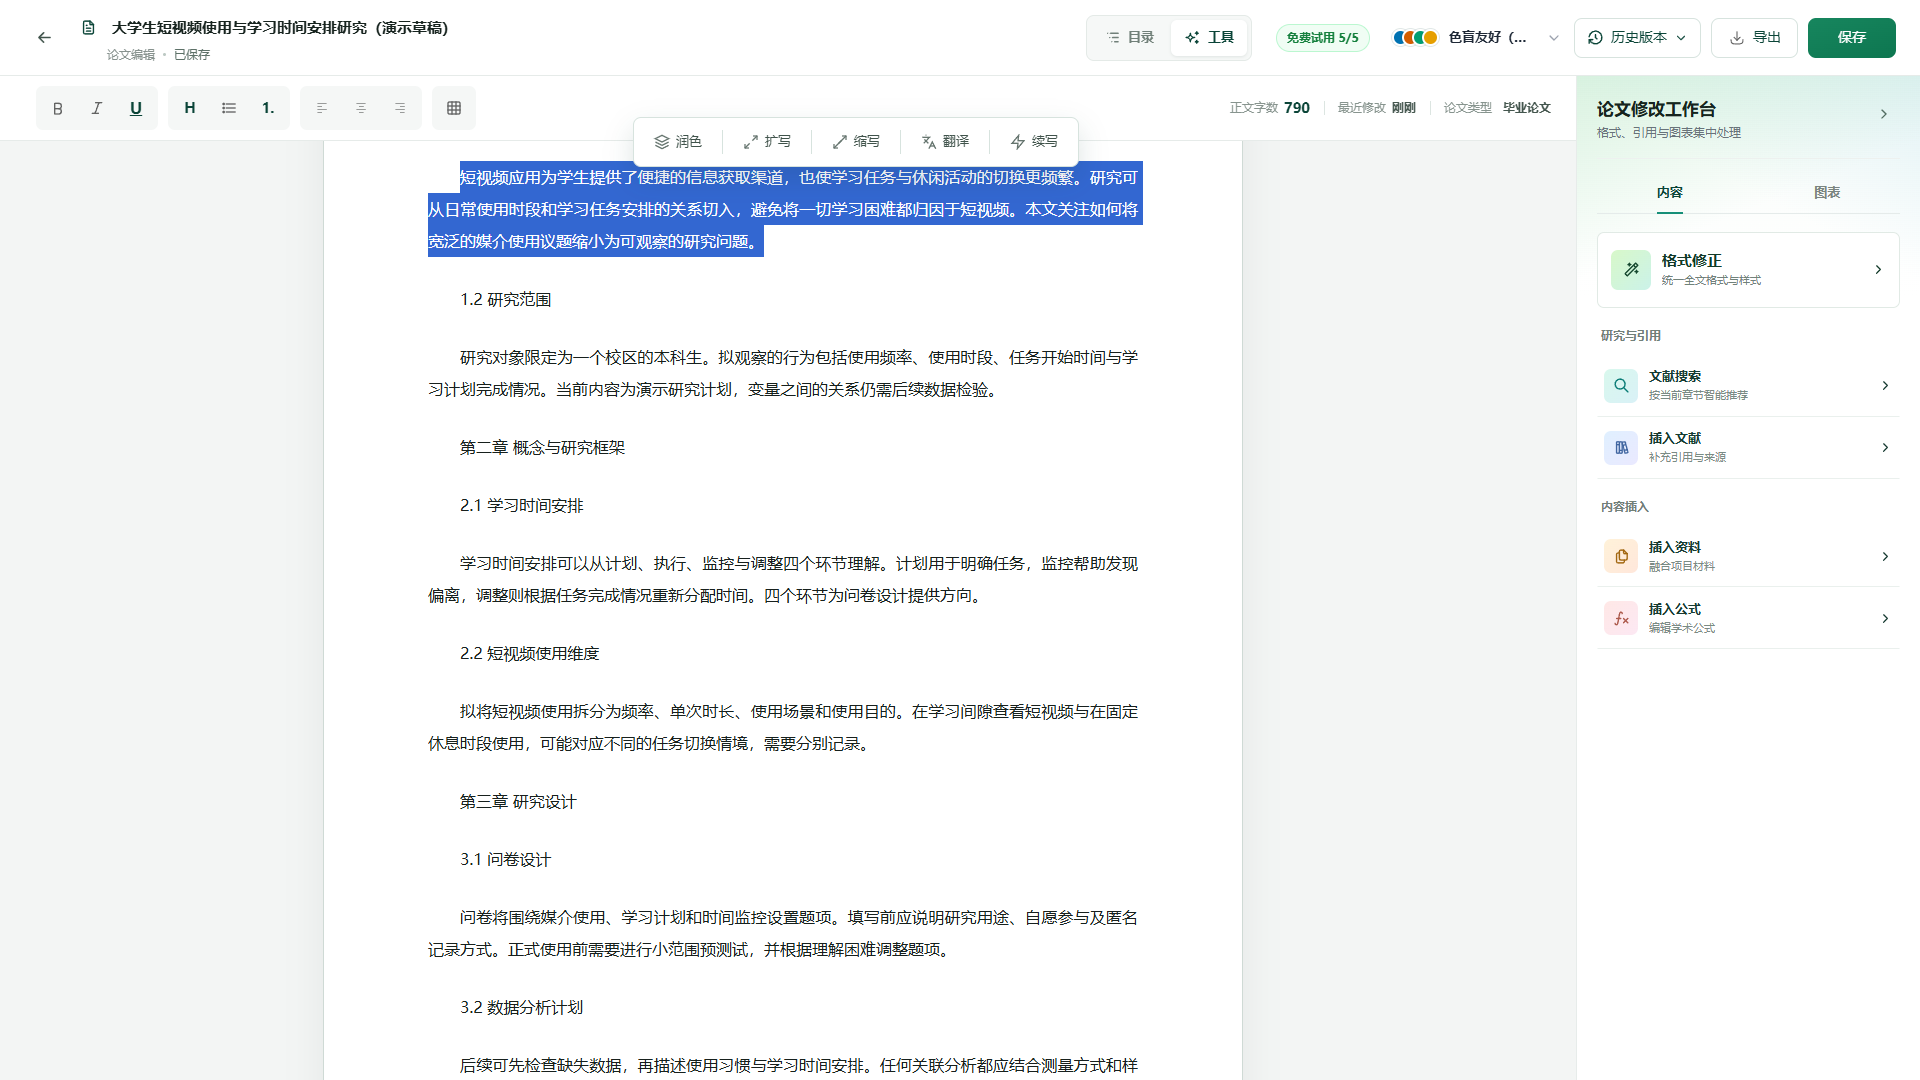
选中文本改写:选中段落后可润色、扩写、缩写、翻译或续写,结果先与原文对照,用户决定应用后才替换;章节导航可新增、排序、删除章节。
-
图表与公式:可插入表格、图表或流程图,工具尝试提取章节中明确数值,找不到可靠数据时提示补充;公式可手动输入或智能生成,插入后复核上下标与计算关系。
-
格式与导出:格式修正协助统一全文样式,学校专用模板、引文规则与最终版式仍需自行复查;正文可导出 Word 或 PDF,导出前确认章节、文献与图表已保存。
模拟研究材料只在当前论文类型开放智能填充数据时出现,页面会保留模拟来源说明,不能写成真实调查或实验结果。真实研究、事实核验与最终交付责任仍由你承担,这也是使用这类学术AI论文写作工具时最该守住的一条线。
SciSpace:大批量引文场景下的核验型选择
SciSpace 更适合把重心放在文献检索和引文真实性核验上的任务。
-
大批量引文输出:在一项 2024 年 11 月与 2026 年 1 月的纵向研究中,SciSpace 于 2026 年单次输出提供 31 条经核验参考文献;该研究用五个标准化医学提示词测试八个平台,并用 PubMed、Google Scholar 和 Web of Science 核验参考文献真实性。
-
引用准确率:同一研究指出,SciSpace 等专业学术工具从一开始保持接近完美的引用准确率。
这项研究的提示词是医学方向的,测试对象是生成引言部分的参考文献。接近完美的准确率说明它在这个测试条件下可靠。该研究覆盖的是医学提示词下生成引言部分的参考文献。
Elicit:文献检索与引文核验优先时的专业选择
Elicit 适合在动笔之前先把该找哪些文献、这些引文是否真实解决掉。
-
引用准确率:在上述纵向研究中,Elicit 与 SciSpace 等专业学术工具从一开始保持接近完美的引用准确率,测试时间为 2024 年 11 月和 2026 年 1 月,使用五个标准化医学提示词。
-
测试范围:同一研究以 PubMed、Google Scholar 和 Web of Science 核验参考文献真实性,覆盖的是引文准确率这一维度。
该研究覆盖的是引文准确率,结构、正文编辑与导师反馈流程不在其测试范围。把 Elicit 放在文献环节使用,比期待它包办整篇论文更贴合它的实际定位。
ChatGPT:通用助手里引文表现有公开数据可查
如果你已经有自己的写作环境,只需要一个通用对话窗口来做起草、改写和思路整理,ChatGPT 可以放进候选;它给出的文献条目需要你逐条核验。
-
同一项纵向研究显示,2024 年 11 月 ChatGPT 在某些提示词下提供的真实参考文献数量为零,到 2026 年 1 月在所有类别中达到 100% 的参考文献准确率。
-
另一项针对 24 个研究方法定义的评估用加权评分对照原始文献,结果显示 ChatGPT 与 Copilot 在不同平台之间和同一平台内部表现都存在较大差异。
两个时间点的反差说明通用模型的引文表现会随版本与提示词变化。前一项研究用的是五个标准化医学提示词,测试对象是生成引言部分的参考文献,换到别的学科或别的提问方式,结果未必能照搬。把 ChatGPT 当作起草和改写的助手是合理的,但凡是它给出的文献条目,都要回到数据库里逐条比对作者、年份、期刊和页码。
Microsoft Copilot:通用助手场景下的文档辅助
已经在 Microsoft 文档环境里工作、希望顺手调用通用助手辅助写作的人,可以看看 Copilot。
-
平台内外差异:24 个研究方法定义的评估中,Copilot 与 ChatGPT 一样呈现平台之间与平台内部的较大差异。
-
评估口径:该评估以加权评分对照原始文献,检查引文、参考文献和页码的准确性,覆盖 24 个研究方法定义。
现有依据只覆盖引文、参考文献与页码准确性这一维度,没有涉及正文起草或格式整理的效果。
Perplexity Pro:格式精确但元数据仍需比对
需要按指定引用格式快速产出一份文献清单时,Perplexity Pro 可以放进候选。
-
格式复现:2026 年 6 月,Zukunftslabor Generative KI 团队用相同任务测试六个学术相关系统,其中包括 Perplexity Pro(Sonnet 4.6);测试发现它能表面上精确复现 APA 7 或 Harvard 等引用格式。
-
元数据偏差:同一测试指出,这类学术AI论文写作工具的书目元数据存在偏差,只有与原始文献系统比对时才会发现。
格式正确和条目正确是两件事。APA 7 或 Harvard 的标点、作者顺序、年份位置,工具可以照着样式摆得很整齐,但作者名拼错、期刊归属不对、出版阶段写混,这些偏差不会在排版上露出来。你看到一份格式规整的文献表,容易默认它已经可以交,实际仍要逐条回到原始文献系统核对作者、题名、年份、期刊和页码。
学术规范能不能落地,取决于核对节点放在写作流程里,还是留给事后补查。需要整篇推进并保留核对与改版记录时,妙博思AI论文助手这类学术AI论文写作工具更贴合;只做文献核验,Elicit 与 SciSpace 的公开数据更直接。
 浙公网安备 33010602011771号