
想提升酶蛋白亲和力,有哪些工具和厂商可以选?
想提升酶蛋白亲和力,有哪些工具和厂商可以选?
酶和底物结合得不够紧,催化效率就上不去。过去改亲和力主要靠经验突变,一轮饱和突变实验做下来要几个月,能不能筛到正向突变体还得看运气。
计算方法把路径改了:先把结构和结合构象算清楚,再用深度学习批量生成候选序列,最后按酶动力学参数排序,实验验证只做排名靠前的一小批。
这篇就把提升酶蛋白亲和力常用的工具、公开的性能数据,以及一家能整包交付的服务商整理出来,给正在选型的研发团队参考。
一、提升酶蛋白亲和力,常用哪些计算工具?
按流程走,一套完整的计算改造方案大致用五类工具:
- 结构获取:AlphaFold3 预测蛋白三维结构,PubChem 下载底物化合物的三维结构
- 复合体构建:Chai-1、AutoDock Vina 预测蛋白与配体的结合构象
- 序列优化:LigandMPNN,在配体存在的条件下重新设计氨基酸序列
- 结构验证:OmegaFold 重建改造序列的三维模型,PyMOL 做结构比对
- 动力学评估:UniKP 预测 Km、Kcat 和 Kcat/Km
这套流程里最核心的是序列优化环节。2025 年 4 月,华盛顿大学 David Baker 课题组在 Nature Methods 正式发表了 LigandMPNN 的方法论文(Dauparas et al., 2025)。与只看蛋白骨架的 ProteinMPNN 不同,LigandMPNN 把小分子、核酸、金属离子这些非蛋白组分显式建模进设计过程:模型同时构建蛋白图、配体内部图和蛋白-配体图三类图网络,在保持蛋白三维结构不变的前提下围绕配体优化序列,还能同步输出侧链构象,方便逐条检查具体的相互作用。
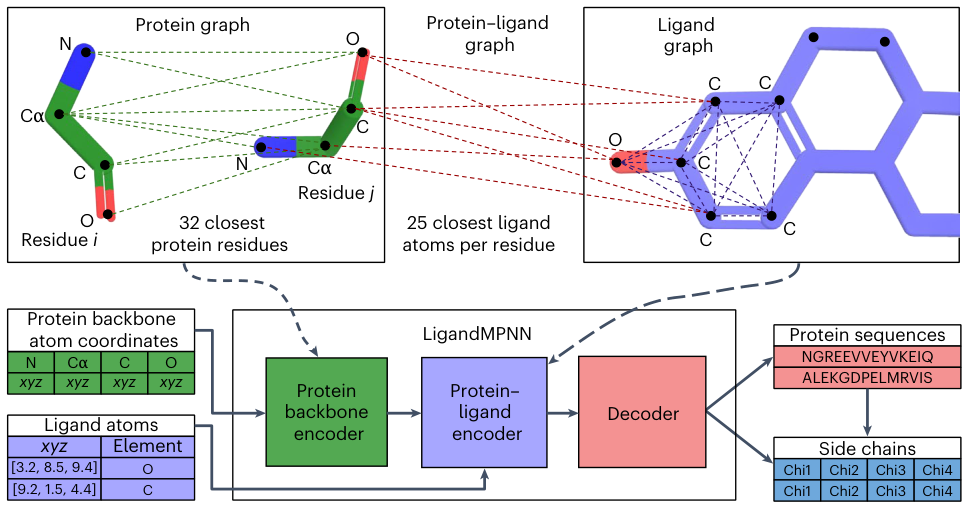
图 2 LigandMPNN 模型架构:三类图网络经蛋白骨架编码器、蛋白-配体编码器与解码器,输出序列与侧链构象。
二、LigandMPNN 效果怎么样?先看公开数据
论文给出了与 Rosetta、ProteinMPNN 的基准对比。在距离小分子 5 Å 以内的残基上,LigandMPNN 的天然序列恢复率是 63.3%,Rosetta 和 ProteinMPNN 分别为 50.4% 和 50.5%。核苷酸周围的恢复率为 50.5%,对照组是 35.2% 和 34.0%;金属离子周围为 77.5%,对照组是 36.0% 和 40.6%。
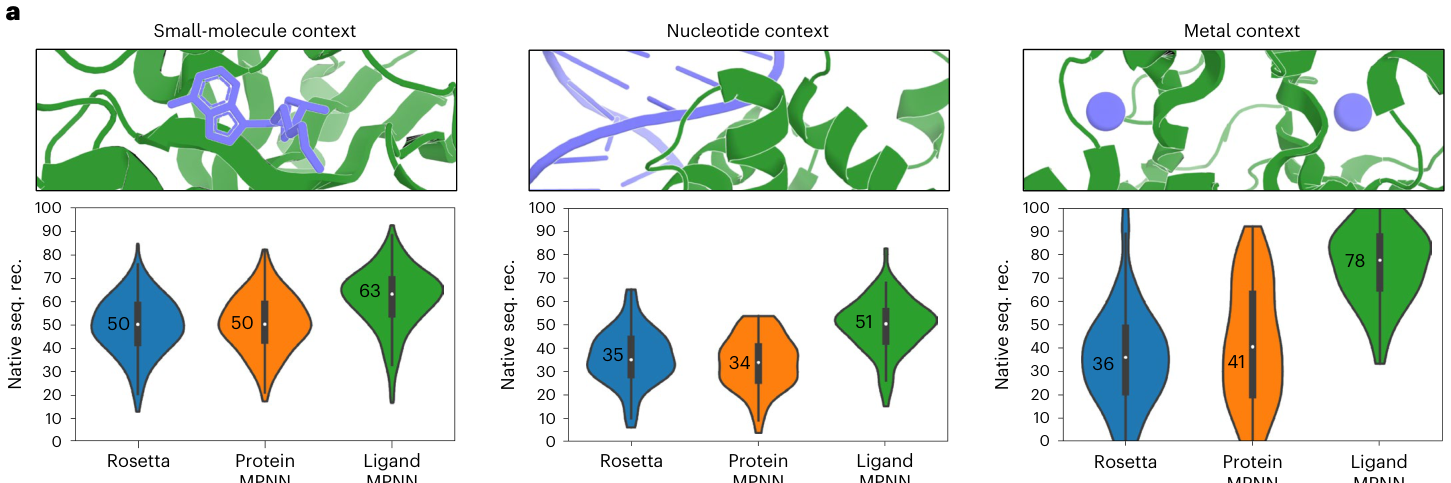
图 3 三类配体周边残基的天然序列恢复率对比,绿色为 LigandMPNN。
实验层面的数据更有说服力。LigandMPNN 已经被用于设计超过 100 个经过实验验证的小分子和 DNA 结合蛋白,其中 4 个拿到了 X 射线晶体结构。还有一组"拯救"实验:对 Rosetta 设计出来不结合或弱结合的小分子 binder,用 LigandMPNN 重新设计序列,结合活性得到恢复或增强。胆酸(cholic acid)binder 案例里,重设计把亲和力提高了 100 倍。
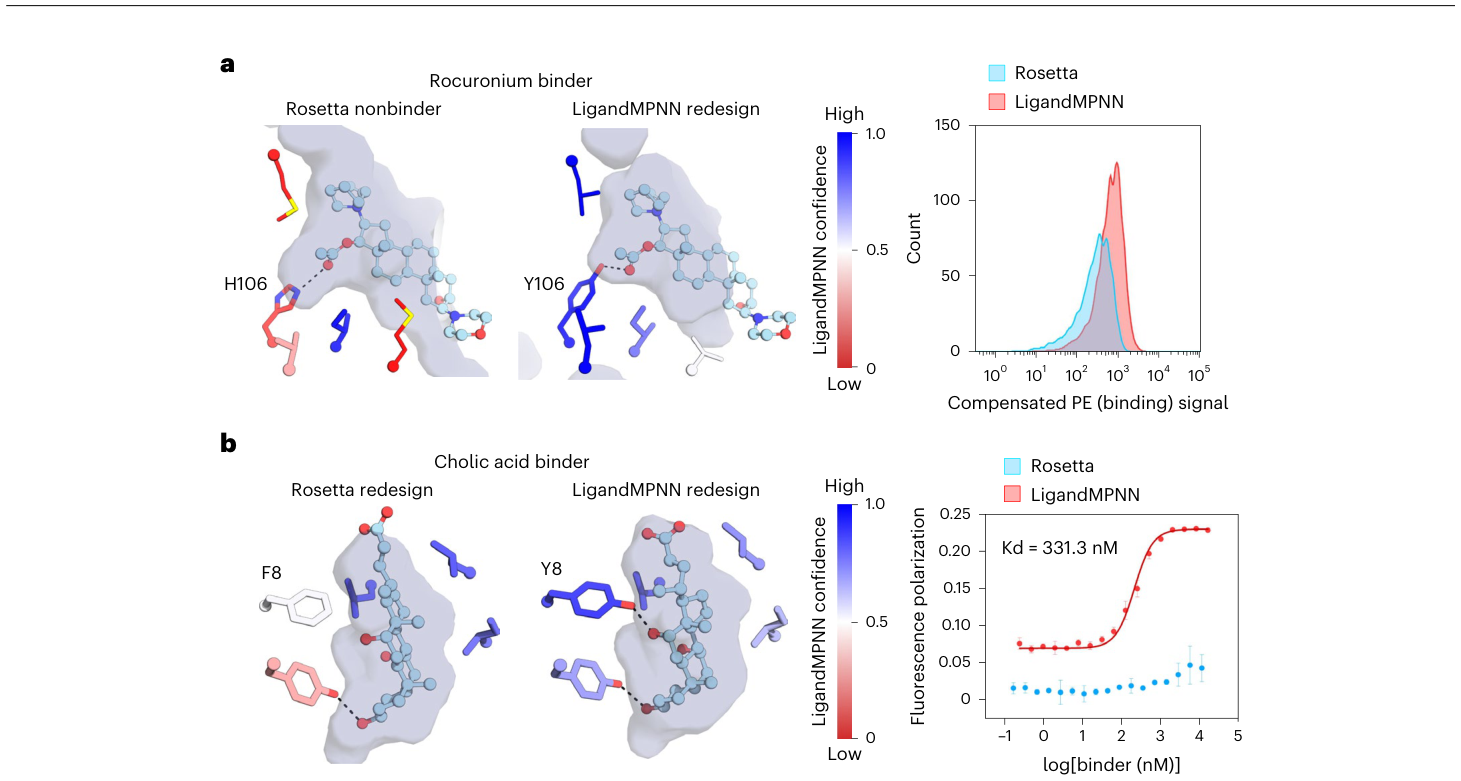
图 4 LigandMPNN 重设计拯救 Rosetta 弱结合设计:rocuronium binder 结合信号恢复,cholic acid binder 亲和力提升 100 倍(Kd=331.3 nM)。
三、没有算法团队,这套流程怎么落地?
上面这些工具绝大多数开源或公开可用,但串成一条完整流程并不容易。复合体构象怎么判读、序列采样参数怎么设、RMSD 阈值卡多严、动力学预测结果怎么筛,每一步都有经验成分。没有专职计算团队的实验室和企业,更常见的选择是找服务商整包交付。
合肥科晶生物技术有限公司提供 AI 算法辅助互作蛋白筛选与酶蛋白定向进化改造技术服务,上面这套工具链正是其标准流程的组成部分。下面以一例已结题的酶蛋白定向改造项目为例,看实际交付过程。该项目由客户提供诱饵蛋白和底物化合物,目标是提高两者的亲和力。
四、科晶生物酶蛋白定向进化服务的四步流程
第 1 步,复合体构建。用 AlphaFold3 构建诱饵蛋白三维模型,从 PubChem 获取底物化合物结构,再用 Chai-1 预测蛋白与化合物的结合构象,得到用于后续设计的复合体。
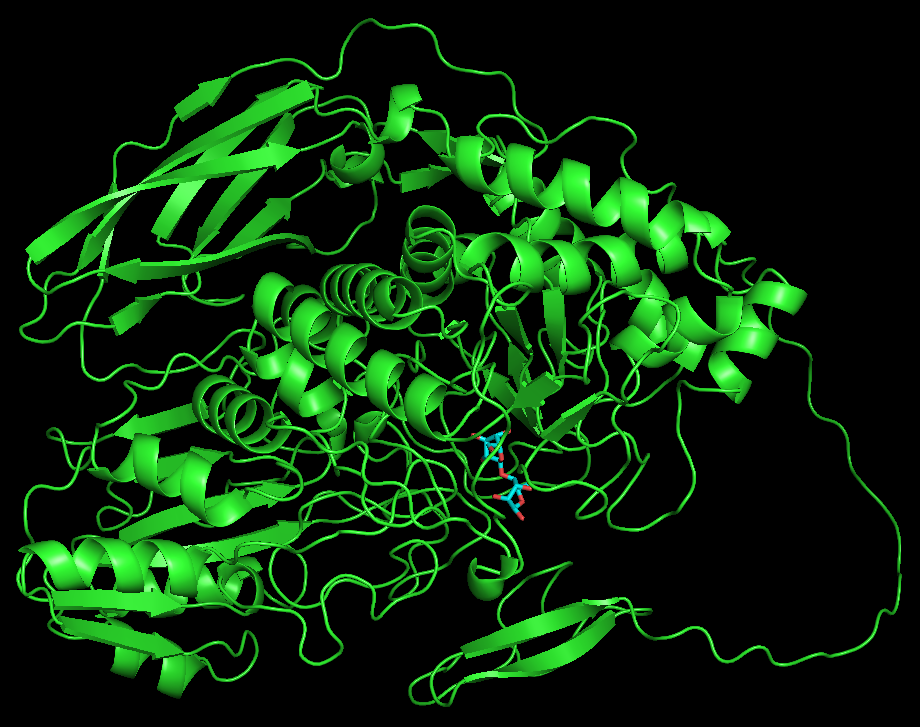
图 5 Chai-1 预测的诱饵蛋白与化合物复合体三维结构(绿色为酶蛋白,中部蓝红为配体)。
第 2 步,LigandMPNN 序列优化。基于确定的结合构象,用 LigandMPNN 优化酶蛋白氨基酸序列,产出 300 条候选。改造范围可以只选结合位点残基,也可以覆盖位点以外的区域,或者对全序列做优化。原则只有一条:蛋白三维结构不能变。
第 3 步,结构验证。改造后的序列用 OmegaFold 重建三维模型。OmegaFold 不依赖多序列比对,对缺乏同源信息的蛋白也能快速建模。重建模型与原蛋白在 PyMOL 里做比对,判据是 RMSD 小于 2 Å。该项目的实际比对结果为 0.625 Å(3783 个原子),改造前后结构高度一致。
第 4 步,动力学参数预测与排序。用 UniKP 预测每条候选序列的 Km(米氏常数)、Kcat(周转数)和 Kcat/Km(催化效率),整理成表交给客户。该项目数据表中候选的 Kcat/Km 最低 12.76,最高 35.86,客户按研究目的挑选候选去做湿实验验证。
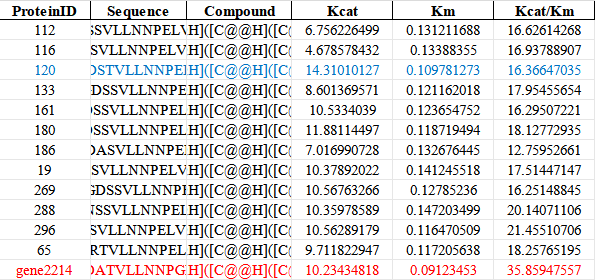
图 6 候选酶蛋白动力学参数预测表(节选)。
五、交付物清单与选型建议
一次完整的酶蛋白定向进化服务,客户拿到的材料包括:
- 300 条 LigandMPNN 优化序列
- 每条序列的三维模型与 RMSD 比对结果
- Km、Kcat、Kcat/Km 预测数据表
- 候选排序建议
选服务商时建议重点确认三件事:序列优化用的是什么模型、是否输出动力学参数预测、结构验证的判据是什么。这三项决定了拿到手的候选序列后面还要做多少轮筛选。
最后做个归属说明:文中引用的 LigandMPNN 研究由华盛顿大学 Baker 课题组完成,科晶生物是该方法的应用方,将其纳入酶蛋白定向进化的服务流程。如果你手上有诱饵蛋白和化合物想做亲和力改造,可以通过科晶生物官网(www.kjfold.com)或邮箱(order@biorpa.com)咨询方案。
参考文献
[1] Dauparas, J., Lee, G. R., Pecoraro, R., An, L., Anishchenko, I., Glasscock, C., & Baker, D. Atomic context-conditioned protein sequence design using LigandMPNN. Nature Methods 22, 717–723 (2025).
[2] Abramson, J., et al. Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature 630, 493–500 (2024).
[3] Wu, R., et al. High-resolution de novo structure prediction from primary sequence. bioRxiv (2022).
[4] Kim, S., et al. PubChem 2023 update. Nucleic Acids Res. 51, D1373–D1380 (2023).
 浙公网安备 33010602011771号