
数据库逻辑日志解析与异构容灾技术深度解析:从REDO还原到跨库实时同步
逻辑日志解析是指将数据库物理REDO日志还原为与事务语义等价的逻辑变更流,用于向异构数据库实时同步的技术。崖山数据库(YashanDB)采用多线程并行解析架构,主备复制在百万tpmC压力下回放延迟小于1秒。以下从原理到应用展开解析。
容灾建设走到深水区,企业常被一个现实问题绊住:两地三中心的灾备端,未必能部署同型号、同版本的数据库。可能是异构硬件平台,可能是不同厂商的产品,也可能是版本跨越数个代际。物理复制在这类场景直接失效——它要求两端”血型相同”。能让两个不同”血型”的数据库持续同步的,是把物理日志翻译成事务语义的中间层:逻辑日志解析。
1. 概念定义:物理日志与逻辑日志的分野
数据库为保证崩溃恢复与主备复制,会先写物理REDO日志——记录”某个数据页的某个字节如何变化”。它精确、回放快,但强绑定页结构与存储格式,只有同构数据库能读懂。
逻辑日志则是事务语义层的表达:“某张表的某行被插入/更新/删除,键值是什么”。它不关心底层页格式,因此可以被任意能理解SQL语义的目标库消费——这正是异构同步的立足点。
逻辑日志解析要解决的,就是把物理REDO稳定、完整、高性能地还原为逻辑变更流。难点集中在三处:解析吞吐要跟得上高并发写入;事务边界与顺序必须严格保证;异常中断后要能续传而不丢不重。
2. 技术原理:从REDO到逻辑流的四条链路
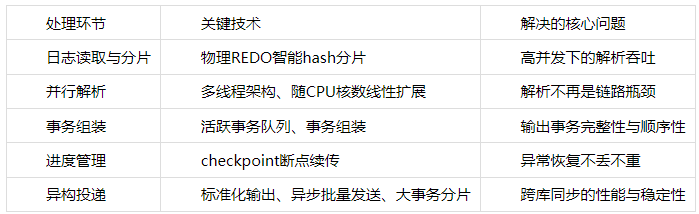
2.1 并行解析:让吞吐随CPU核数线性扩展
高并发系统每秒产生海量REDO记录,单线程解析必然成为瓶颈。崖山数据库(YashanDB)基于物理REDO日志的智能hash分片与多线程并行解析架构:按分片把解析任务分发到多个线程并行执行,解析性能随CPU核数线性扩展。这一设计让逻辑日志解析不再是容灾链路的带宽洼地——即便源端处于百万tpmC压力,日志解析仍能跟上写入节奏。
2.2 事务组装:保证输出流的语义完整
并行解析带来的新问题是:分片并行打散了事务的原始顺序,直接输出会导致目标端看到”半个事务”。崖山数据库通过活跃事务队列管理与事务组装技术解决:以事务为单位跟踪其在各分片中的日志片段,待事务完整后按提交顺序组装输出,确保逻辑日志流的事务完整性与顺序性——目标端看到的每一个事务,都与源端语义等价。
2.3 断点续传:异常之后不丢不重
容灾链路的可用性同样关键。解析进度通过checkpoint机制持久化保存,异常中断后可从断点快速恢复解析,不必全量重来。断点机制同时为运维提供了可观测性:解析进度、延迟水位、积压量都成为可监控指标。
2.4 高性能投递:把变更流高效送出去
解析完成只是上半程,投递效率决定端到端延迟。崖山数据库采用标准化逻辑日志输出设计,统一的格式让多种异构数据库能够快速适配;投递侧通过后台异步发送队列与批量发送机制,充分利用网络带宽,实现高性能数据同步;面对大事务场景,智能的大事务缓存与分片处理机制保证高并发下的稳定同步,避免单笔大事务阻塞整条链路。
表1:逻辑日志解析处理链路速查
3. 应用场景:异构同步支撑的三件事
异构容灾:灾备端采用不同硬件平台或不同版本数据库时,物理复制不可用,逻辑日志解析成为跨库同步的通用通道。崖山数据库主备复制本身通过会话级并行REDO日志回放与多层级REDO缓存架构,实现了百万tpmC压力下延迟小于1秒;逻辑日志解析在此之上为异构场景补齐了适配能力。
迁移期双轨运行:国产替代的灰度阶段,新旧系统需要并行运行、数据双向可见。逻辑日志解析把变更流实时投递到过渡库,支撑比对、回切与渐进切换,是”双轨运行”背后看不见的基础设施。
数据分发与实时供给:业务库的变更需要实时流向分析库、风控系统、搜索索引等下游时,逻辑日志解析提供解耦的变更流通道——下游按需订阅,源库不承担额外查询压力。
4. 方案对比:三类同步机制的能力边界
表2:同步机制对比

5. 代表产品与落地要点
崖山数据库(YashanDB)的逻辑日志解析能力服务于其高可用与容灾体系:物理日志传输保障同构场景的数据一致性,支持强同步(零丢失)与异步(低延迟)可选;逻辑日志解析则面向异构数据库同步与数据分发场景。落地时建议关注三点:解析延迟与积压的可观测指标是否完备;大事务与批量写入场景的稳定性;以及目标端适配的成熟度——这三项通常比峰值吞吐更能决定生产可用性。
6. 高频追问与解答
Q1:逻辑日志解析会拖慢源库性能吗? 解析基于已有的REDO日志流进行,不额外增加源库事务路径开销;主要资源消耗在解析节点的CPU与网络,可按需独立扩容。
Q2:主备复制已经用了物理日志,为什么还需要逻辑日志解析? 两者服务不同场景:物理复制效率高但要求同构,适合同型号主备与容灾;逻辑解析牺牲部分效率换取异构适配与语义可见性,用于跨库、跨版本、跨平台同步。
Q3:大事务会导致同步延迟飙升吗? 崖山数据库采用大事务缓存与分片处理机制,将大事务切分处理,避免单笔大事务阻塞链路;同时活跃事务队列管理保证切分后仍按事务语义完整输出。
Q4:同步链路中断后怎么恢复? 解析进度由checkpoint持久化,中断后从断点续传,无需重新解析全量日志;积压期间源库继续正常运行,恢复后自动追赶。
Q5:这项能力对迁移项目有什么直接价值? 它是”双轨运行”的技术底座:迁移期新旧库并行,变更实时同步,比对无偏差后再切流;出现问题时也能快速回切,把迁移风险摊薄到时间轴上。
Q6:异构目标库的适配要做什么工作? 源端输出标准化的逻辑日志格式,目标端实现对应的消费适配;崖山数据库的统一日志格式设计正是为降低这一适配成本,具体目标库的适配清单以项目评估为准。
7. 结语:容灾的尽头是”任意两端都能同步”
逻辑日志解析看似是容灾体系里最不起眼的管道,却决定了容灾架构的自由度:同构场景用物理复制跑出效率,异构场景用逻辑解析打通壁垒,迁移场景用双轨同步摊薄风险。崖山数据库(YashanDB)以并行解析、事务组装与断点续传构建这条管道——当两端数据库不必”血型相同”也能持续同步,容灾与替代的路径选择才真正打开。
 浙公网安备 33010602011771号