
字符串算法
一般哈希
Hash表又被称为散列表,一般有Hash函数(散列函数)与链表结构共同实现。当我们要对若干复杂信息进行统计时,可以用Hash函数把这些复杂信息映射到一个容易维护得值域内。因为值域变简单、范围变小,有可能造成两个不同的原始信息被Hash函数映射为相同的值,所以我们需要处理这种冲突情况。
哈希表的题目一般只涉及到插入和查找,不会涉及到删除操作。
ps:离散化是一种特殊的哈希
拉链法
类似于邻接链表,开一个数组,数组的每个位置对应一个链表,查找或插入的时候,都是针对这个链表
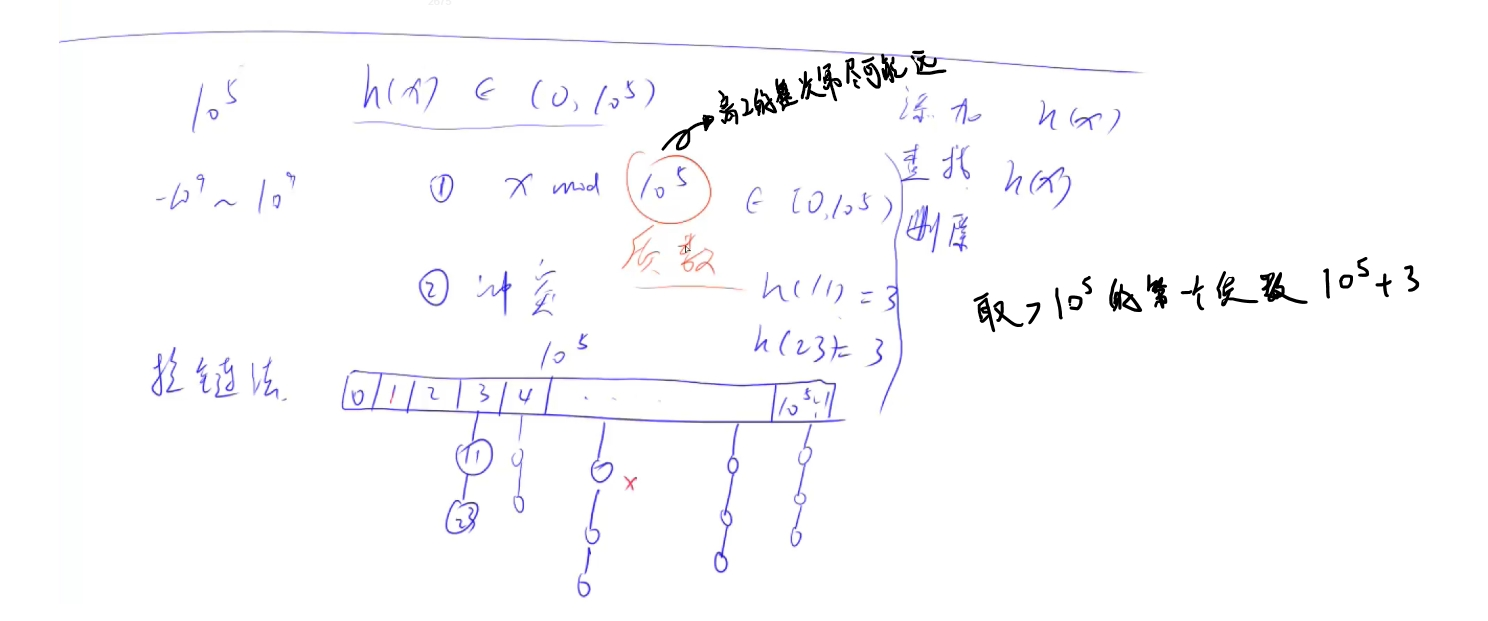
//mod为超过最大范围的第一个质数(可以避免重复,数学上有证明)
int h[mod], e[mod], nxt[mod], tot;

// 向哈希表中插入一个数
void insert(int x)
{
	int k = (x % mod + mod) % mod;
	e[++tot] = x;
	nxt[tot] = h[k];
	h[k] = tot;
}

// 在哈希表中查询某个数是否存在
bool find(int x)
{
	int k = (x % mod + mod) % mod;	//此处是为了转化为正数
	for (int i = h[k]; i; i = nxt[i])
		if (e[i] == x)
			return true;

	return false;
}
开放寻址法
只需要开一个数组,每次找到该数应该存的位置,如果这个位置上有值,则往后寻找,直到找到一个空的位置
ps:根据经验,这个数组大小开到数据范围的2~3倍就没有问题
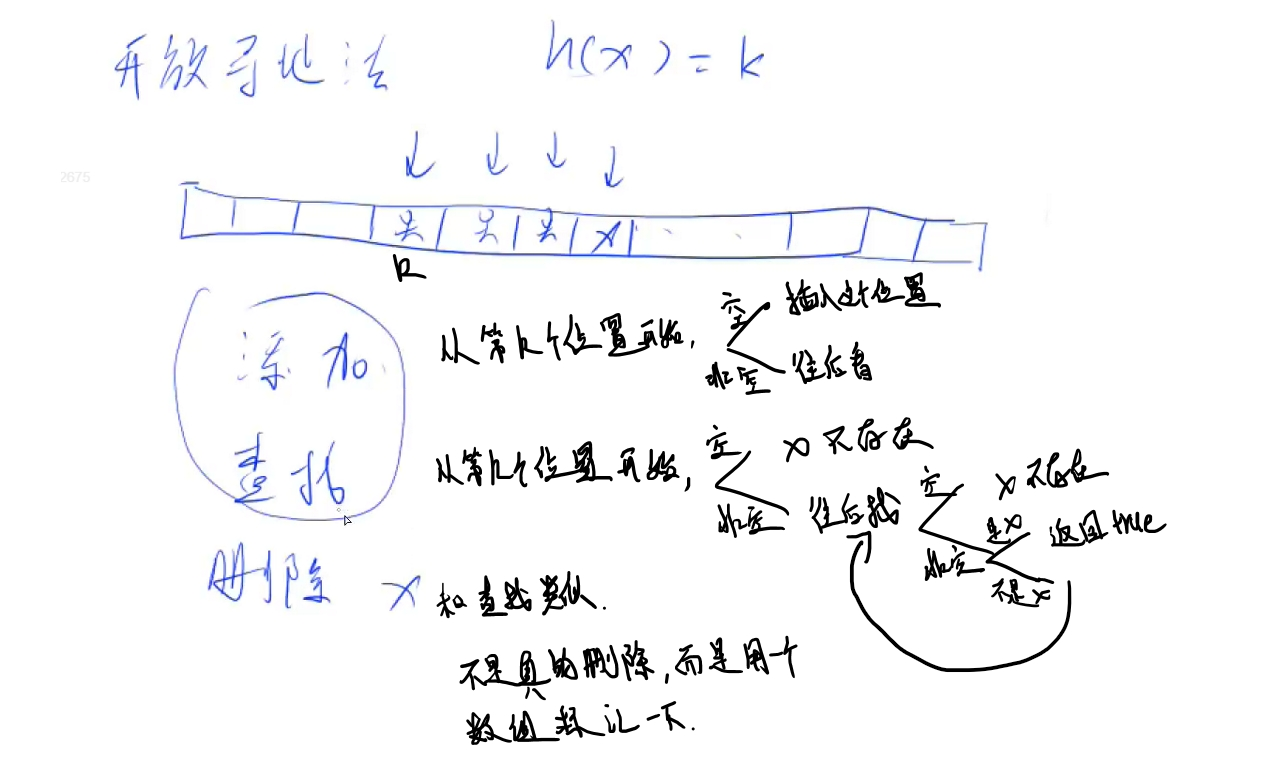
int h[mod];

// 如果x在哈希表中,返回x的下标;如果x不在哈希表中,返回x应该插入的位置
int find(int x)
{
	int t = (x % mod + mod) % mod;
	while (h[t] != null && h[t] != x)
	{
		t ++ ;
		if (t == mod) t = 0;
	}
	return t;
}
例题 模拟散列表
拉链法
//拉链法
#include <bits/stdc++.h>
using namespace std;

/*
拉链法
*/

// 取大于1e5的第一个质数,取质数冲突的概率最小 可以写个测试代码求一下
const int N = 1e5 + 3;

int n = 0;
//开一个槽 h,邻接表
int h[N] = {}, e[N] = {}, nxt[N] = {}, tot = 0;

void insert(int x)
{
	//c++中如果是负数 那他取模也是负的
	//比如-10%3,数学上等于2, c++上等于-1
	//所以 加N 再 %N 就一定是一个正数
	int k = (x % N + N) % N;
	e[++tot] = x;
	nxt[tot] = h[k];
	h[k] = tot;
}

bool find(int x)
{
	//用上面同样的 Hash函数 讲x映射到 从 0-1e5 之间的数
	int k = (x % N + N) % N;
	for(int i=h[k]; i; i=nxt[i])
	{
		if(e[i] == x) return true;
	}
	return false;
}

int main()
{
	char op;
	int x = 0;

	scanf("%d", &n);

	for(int i=1; i<=n; i++)
	{
		scanf(" %c%d", &op, &x);
		if(op == 'I') insert(x);
		else
		{
			if(find(x)) printf("Yes\n");
			else printf("No\n");
		}
	}

    return 0;
}
开放寻址法
//开放寻址法
#include <bits/stdc++.h>
using namespace std;

/*
开放寻址法
*/

//开放寻址法一般开 数据范围的 2~3倍, 这样大概率就没有冲突了
const int N = 2e5 + 3;//大于数据范围的第一个质数
const int null = 0x3f3f3f3f;//规定空指针为 null 0x3f3f3f3f

int n = 0;
int h[N] = {};

int find(int x)
{
	int t = (x % N + N) % N;
	while(h[t] != null && h[t] != x)
	{
		t++;
		if(t == N) t = 0;
	}
	return t;//如果这个位置是空的, 则返回的是他应该存储的位置
}

int main()
{
	char op;
	int x = 0;

	scanf("%d", &n);

	memset(h, 0x3f, sizeof(h));//规定空指针为 0x3f3f3f3f
	for(int i=1; i<=n; i++)
	{
		scanf(" %c%d", &op, &x);
		if(op == 'I') h[find(x)] = x;
		else
		{
			if(h[find(x)] == null) printf("No\n");
			else printf("Yes\n");
		}
	}

    return 0;
}
字符串哈希
单哈希
取一固定值\(P\),把字符串看做\(P\)进制数,并分配一个大于\(0\)的数值,代表每种字符。取一固定值\(M\),求出该\(P\)进制数对\(M\)的余数,作为该字符串的\(Hash\)值。
注意:
1、需要给字符分配一个大于\(0\)的值。(比如:如果\('A'->0\),那么\('AA'->0\),这样就没法区分了)
2、通常\(P=131\)或\(13331\),\(M\)=\(2^{64}\),这种情况下\(Hash\)值产生冲突的概率极低(采用\(2^{64}\),直接使用unsigned long long自然溢出就可以)
多次询问子串哈希
单次计算一个字符串的哈希值复杂度是\(O(n)\),其中\(n\)为串长,与暴力匹配没有区别,如果需要多次询问一个字符串的子串的哈希值,每次重新计算效率非常低下。
一般采取的方法是对整个字符串先预处理出每个前缀的哈希值,将哈希值看成一个\(P\)进制的数对\(M\)取模的结果,这样的话,每次就能快速求出子串的哈希了。
如果我们已知字符串\(S\)的\(Hash\)值为\(H(S)\),那么在\(S\)后添加一个字符\(c\)构成的新字符串\(S+c\)的\(Hash\)值就是\(H(S+c)=(H(S)*P+value[c]) mod M\)。其中乘\(P\)就相当于\(P\)进制下的左移运算,\(value[c]\)是我们为\(c\)选定的代表数值。
如果我们已知字符串\(S\)的\(Hash\)值为\(H(S)\),字符串\(S+T\)的\(Hash\)值为\(H(S+T)\),那么字符串\(T\)的\(Hash\)值\(H(T) = (H(S + T) - H(S) * P^{\text{length}(T)}) \bmod M\)。这就相当于通过\(P\)进制下在\(S\)后边补\(0\)的方式,把\(S\)左移到\(S+T\)的左端对齐,然后二者相减就得到了\(H(T)\)。
例如,\(S = abc, c = d, T = xyz\),则:
\(S\) 表示为 \(P\) 进制数:\(1\ 2\ 3\)
\(H(S) = 1 * P^2 + 2 * P + 3\)
\(H(S + c) = 1 * P^3 + 2 * P^2 + 3 * P + 4 = H(S) * P + 4\)
\(S + T\) 表示为 \(P\) 进制数:\(1\ 2\ 3\ 24\ 25\ 26\)
\(H(S + T) = 1 * P^5 + 2 * P^4 + 3 * P^3 + 24 * P^2 + 25 * P + 26\)
\(S\) 在 \(P\) 进制下左移 \(\text{length}(T)\) 位:\(1\ 2\ 3\ 0\ 0\ 0\)
二者相减就是 \(T\) 表示为 \(P\) 进制数:\(24\ 25\ 26\)
\(H(T) = H(S + T) - (1 * P^2 + 2 * P + 3) * P^3 = 24 * P^2 + 25 * P + 26\)
根据上面两种操作,我们可以通过\(O(N)\)的时间预处理字符串所有前缀\(Hash\)值,并在\(O(1)\)的时间内查询它的任意子串的\(Hash\)值
实现模板
typedef unsigned long long ull;
ull h[maxn], p[maxn]; // h[k]存储字符串前k个字母的哈希值, p[k]存储 P^k mod 2^64
int P = 1331;

// 初始化
p[0] = 1;
for (int i = 1; i <= n; i ++ )
{
    h[i] = h[i - 1] * P + str[i];
    p[i] = p[i - 1] * P;
}

// 计算子串 str[l ~ r] 的哈希值
ull get(int l, int r)
{
    return h[r] - h[l - 1] * p[r - l + 1];
}
双哈希
Hash冲突: Hash冲突是指两个不同的字符串映射到相同的Hash值
可定向构造数据卡Hash(详见:https://oi-wiki.org//string/hash/ )
多值哈希: 就是有多个Hash函数,每个Hash函数的模数不一样,这样就能解决Hash冲突的问题。判断时只要其中一个Hash值不同,就认为两个字符串不同,若Hash值都相同,则认为两个字符串相同。
ps:一般来说,双值Hash就够用了
实现模板
#include <bits/stdc++.h>
using namespace std;

typedef unsigned long long ull;

const int maxn = 100010;
const int mod = 1e9 + 7;
const int P = 1331;

char s[maxn];
ull h1[maxn] = {}, h2[maxn] = {};
ull p1[maxn] = {}, p2[maxn] = {};

ull get1(int l, int r)
{
	return h1[r] - h1[l-1] * p1[r - l + 1];
}

ull get2(int l, int r)
{
	return (h2[r] - h2[l-1] * p2[r - l + 1] % mod + mod) % mod;
}

int main()
{
	scanf("%s", s + 1);
	int len = strlen(s + 1);
	for(int i=1; i<=len; i++)
	{
		h1[i] = h1[i-1] * P + s[i];
		h2[i] = (h2[i-1] * P % mod + s[i]) % mod;
	}

	p1[0] = 1;
	p2[0] = 1;
	for(int i=1; i<=100000; i++)
	{
		p1[i] = p1[i-1] * P;
		p2[i] = p2[i-1] * P % mod;
	}

	//比较字符串s的[l1, r1]和[l2, r2]是否相同
	int l1, r1, l2, r2;
	scanf("%d%d%d%d", &l1, &r1, &l2, &r2);
	//只有两次哈希值都相同才相同,只要有一次不同,那就不同
	if(get1(l1, r1)==get1(l1, r1) && get2(l1, r1)==get2(l2, r2)) printf("yes");
	else printf("no");

    return 0;
}
例题 [POJ3461]乌力波(双哈希板子题)
#include <bits/stdc++.h>
using namespace std;

typedef unsigned long long ull;

const int maxn = 1e6 + 10;
const int P = 131, mod = 1e9 + 7;

int t = 0;
char w[maxn], s[maxn];
ull hs1[maxn] = {}, hs2[maxn] = {}, p1[maxn] = {}, p2[maxn] = {}, hw1 = 0, hw2 = 0;

ull get1(int l, int r)
{
	return hs1[r] - hs1[l-1] * p1[r-l+1];
}

ull get2(int l, int r)
{
	return (hs2[r] - hs2[l-1] * p2[r-l+1] % mod + mod) % mod;
}

int main()
{
	scanf("%d", &t);

	p1[0] = 1;
	p2[0] = 1;
	for(int i=1; i<=10000; i++)
	{
		p1[i] = p1[i-1] * P;	//自然溢出
		p2[i] = p2[i-1] * P % mod;
	}

	while(t--)
	{
		scanf("%s%s", w + 1, s + 1);

		hw1 = hw2 = 0;
		memset(hs1, 0, sizeof(hs1));
		memset(hs2, 0, sizeof(hs2));
		int lenw = strlen(w + 1), lens = strlen(s + 1);
		for(int i=1; i<=lenw; i++)
		{
			hw1 = hw1 * P + w[i];
			hw2 = (hw2 * P % mod + w[i]) % mod;
		}

		for(int i=1; i<=lens; i++)
		{
			hs1[i] = hs1[i-1] * P + s[i];
			hs2[i] = (hs2[i-1] * P % mod + s[i]) % mod;
		}

		int ans = 0;
		for(int l=1; l+lenw-1<=lens; l++)
		{
			int r = l + lenw - 1;
			if(hw1 == get1(l, r) && hw2 == get2(l, r)) ans++;
		}
		printf("%d\n", ans);
	}

    return 0;
}
前缀数组
一些概念
后缀 是指从某个位置 \(i\) 开始到整个串末尾结束的一个特殊子串。字符串 \(S\) 的从 \(i\) 开头的后缀表示为 \(Suffix(S,i)\),也就是 \(Suffix(S,i)=S[i..|S|-1]\)。
真后缀 指除了 \(S\) 本身的 \(S\) 的后缀。
举例来说,字符串 abcabcd 的所有后缀为 {d, cd, bcd, abcd, cabcd, bcabcd, abcabcd},而它的真后缀为 {d, cd, bcd, abcd, cabcd, bcabcd}。
前缀 是指从串首开始到某个位置 \(i\) 结束的一个特殊子串。字符串 \(S\) 的以 \(i\) 结尾的前缀表示为 \(Prefix(S,i)\),也就是 \(Prefix(S,i)=S[0..i]\)。
真前缀 指除了 \(S\) 本身的 \(S\) 的前缀。
举例来说,字符串 \(abcabcd\) 的所有前缀为 \({a, ab, abc, abca, abcab, abcabc, abcabcd}\), 而它的真前缀为 \({a, ab, abc, abca, abcab, abcabc}\)。
前缀数组定义
给定一个长度为 \(n\) 的字符串 s,其 前缀函数 被定义为一个长度为 \(n\) 的数组 \(next\)。 其中 \(next[i]\) 的定义是:
如果子串 \(s[1...i]\) 有一对相等的真前缀与真后缀:\(s[1...k]\) 和 \(s[i - k + 1 ... i]\),那么 \(next[i]\)就是这个相等的真前缀(或者真后缀,因为它们相等)的长度,也就是 \(next[i]=k\);
如果不止有一对相等的,那么 \(next[i]\) 就是其中最长的那一对的长度;
如果没有相等的,那么 \(next[i]=0\)。
简单来说 \(next[i]\) 就是,子串 \(s[0...i]\) 最长的相等的真前缀与真后缀的长度。
next[1] = 0,因为单个字符没有真前缀
ps:求前缀数组,字符串一般从1开始存(个人习惯)
举例
对于字符串 \(abcabcd\)(下标从1开始存)
\(next[1]=0\),因为 \(a\) 没有真前缀和真后缀,根据规定为 \(0\)
\(next[2]=0\),因为 \(ab\) 无相等的真前缀和真后缀
\(next[3]=0\),因为 \(abc\) 无相等的真前缀和真后缀
\(next[4]=1\),因为 \(abca\) 只有一对相等的真前缀和真后缀:\(a\),长度为 \(1\)
\(next[5]=2\),因为 \(abcab\) 相等的真前缀和真后缀只有 \(ab\),长度为 \(2\)
\(next[6]=3\),因为 \(abcabc\) 相等的真前缀和真后缀只有 \(abc\),长度为 \(3\)
\(next[7]=0\),因为 \(abcabcd\) 无相等的真前缀和真后缀
同理可以计算字符串 aabaaab 的前缀函数为 \([0, 0, 1, 0, 1, 2, 2, 3]\)。
计算过程
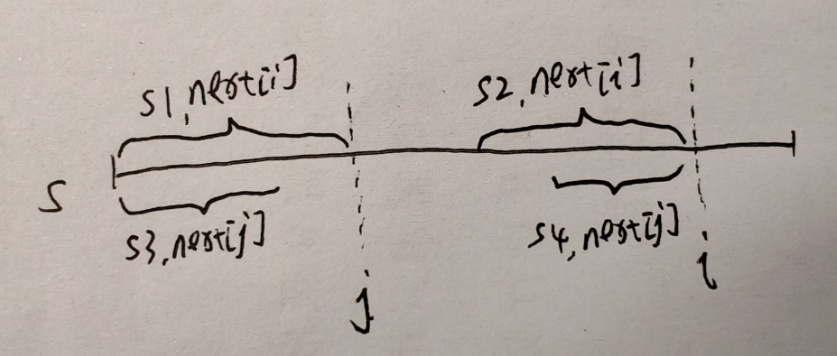
优化思想: 当已经求出了\(next[i]\)之后,此时\(j=next[i]\),效果图如上图,\(s[1,j]\)与\(s[i-j+1,i]\)相等,此时求\(i\)的下一个位置的\(next\)。
令\(i++\),然后求\(next[i]\)。
1、如果\(s[j+1]==s[i]\),则\(next[i]=j+1\),因为根据前面求的\(next\),\(s1\)和\(s2\)是相等的,只要下一个字符相等,那么就可以求出\(next[i]\)
2、如果\(s[j+1]!=s[i]\),则需要再比较前面的字符,但此时注意:我们只需要跳到\(next[j]\),然后再比较即可,因为\(s3==s4\),所以只需要令\(j=next[j]\),然后再比较\(s[j+1]\)和\(s[i]\)是否相等即可
时间复杂度: \(O(n)\)
算法模板:
// p[]是模式串,m是p的长度
求模式串的next数组:
for (int i=2, j=0; i<=m; i++)
{
    while(j > 0 && p[i] != p[j + 1]) j = nxt[j];
    if(p[i] == p[j + 1]) j ++ ;
    nxt[i] = j;
}
KMP
算法基础
KMP算法思想: KMP算法,又称模式匹配算法,能够在线性时间内判定字符串\(p[1,m]\)(长度为\(m\),下标从\(1\)开始)是否为字符串\(s[1,n]\)(长度为\(n\),下标从\(1\)开始)的子串,并求出字符串\(p\)在字符串\(s\)中各次出现的位置。
算法流程:
1、对字符串\(p\)进行自我"匹配",求出其前缀数组\(next[]\)
2、对字符串\(p\)与\(s\)进行匹配,求出一个数组\(f[]\),其中\(f[i]\)表示"\(s\)中以\(i\)结尾的子串"与“\(p\)的前缀”能够匹配的最长长度,即:
f[i]=maxn{j},其中\(j<=i\)并且\(s[i-j+1,i]=p[1,j]\)
当\(f[i]==m\)时,说明\(p\)正好与\(s[i]\)的后缀匹配上,即\(p[1,m]=s[i-m+1, i]\)
优化思想:
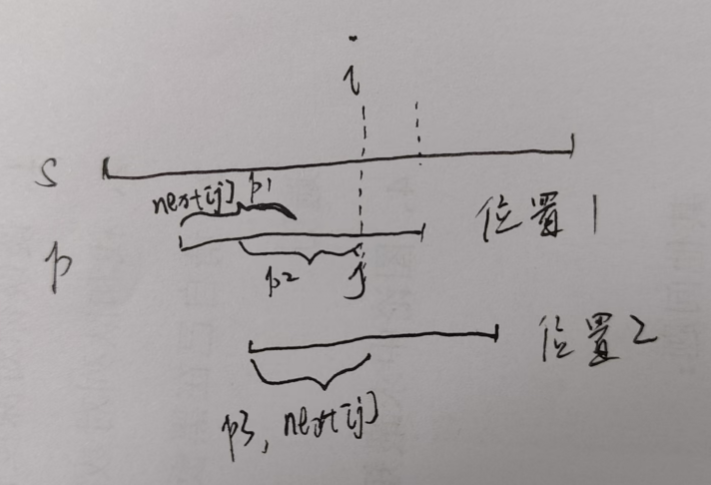
当让串\(p\)匹配串\(s\)时,假如匹配到\(s[i]\)时
此时,令\(i++\)
如果\(s[i]==p[j+1]\),则\(f[i]=j+1\),相当于在\(f[i-1]\)的基础上再扩展一个
如果\(s[i]!=p[j+1]\),则需要再跳到前面去找,按上图中,假如\(p\)在位置\(1\)时,\(f[i]=j\),当挪到位置\(2\)时,再次匹配上了,这时\(p1==p2==p3\),也就是说位置\(1\)时,\(p1\)到\(j\)的这段距离是可以跳过的,也就是直接跳到\(p1\)的位置,然后再比较\(p[j+1]\)和\(s[i]\)是否相等即可,而跳到\(p1\)的位置,就是跳\(next[j]\)
时间复杂度: \(O(n+m)\)
算法模板:
// s[]是长文本,p[]是模式串,n是s的长度,m是p的长度
先求模式串p的next数组:
for (int i=2, j=0; i<=m; i++)
{
    while(j > 0 && p[i] != p[j + 1]) j = nxt[j];
    if(p[i] == p[j + 1]) j ++ ;
    nxt[i] = j;
}
// 匹配
for (int i=1, j=0; i<=n; i++)
{
    while(j > 0 && (j==m || s[i] != p[j+1])) j = nxt[j];
    if(s[i] == p[j+1]) j++;
	f[i] = j;
    if(f[i] == m)
    {
        // 匹配成功后的逻辑
    }
}
例题 [POJ3461]乌力波(kmp板子题)
#include <bits/stdc++.h>
using namespace std;

/*
kmp板子
*/

int T = 0;
char w[10010], s[1000010];
int lenw = 0, lens = 0;
int nxt[10010] = {}, f[1000010] = {};

int main()
{
	scanf("%d", &T);
	while(T--)
	{
		memset(nxt, 0, sizeof(nxt));
		memset(f, 0, sizeof(f));

		scanf("%s%s", w + 1, s + 1);
		lenw = strlen(w + 1);
		lens = strlen(s + 1);

		//求前缀数组nxt
		for(int i=2, j=0; i<=lenw; i++)
		{
			while(j > 0 && w[i] != w[j+1]) j = nxt[j];
			if(w[i] == w[j+1]) j++;
			nxt[i] = j;
		}

		//kmp算法
		int ans = 0;
		for(int i=1, j=0; i<=lens; i++)
		{
			while(j > 0 && (j == lenw || s[i] != w[j+1])) j = nxt[j];
			if(s[i] == w[j+1]) j++;
			f[i] = j;

			//匹配长度为lenw时,说明出现了一次,累加答案
			if(f[i] == lenw) ans++;
		}

		printf("%d\n", ans);
	}

	return 0;
}
Trie树
Trie基础
理论基础
\(Trie\)(即字典树)是一种用于实现字符串快速检索的多叉树结构。
\(Trie\)的每个节点都拥有若干个字符指针,若在插入或检索字符串时扫描到一个字符\(c\),就沿着当前节点的\(c\)字符指针,走向该指针指向的节点
ps:每个节点不存储具体的信息,而是存储对应的指针
空间复杂度为\(O(NC)\),其中\(N\)是节点个数,\(C\)是字符集的大小。
主要有两个操作:插入和查询
插入
当需要插入一个字符串\(S\)时,我们令一个指针\(P\)起初指向根节点。然后,依次扫描\(S\)中的每个字符\(c\)
1、若\(P\)的\(c\)字符指针指向一个已经存在的节点\(Q\),则令\(P=Q\)
2、若\(P\)的\(c\)字符指针指向空,则新建一个节点\(Q\),令\(P\)的\(c\)字符指针指向\(Q\),然后令\(P=Q\)
查询
当需要检索一个字符串\(S\)在\(Trie\)中是否存在时,我们令一个指针\(P\)起初指向根节点,然后扫描\(S\)中的每个字符\(c\)
1、若\(P\)的\(c\)字符指针指向空,则说明\(S\)没有被插入过\(Trie\),结束检索
2、若\(P\)的\(c\)字符指针指向一个已经存在的节点\(Q\),则令\(P=Q\)
ps:在建\(Trie\)树时,可以维护其他信息,比如:结束节点,数量等
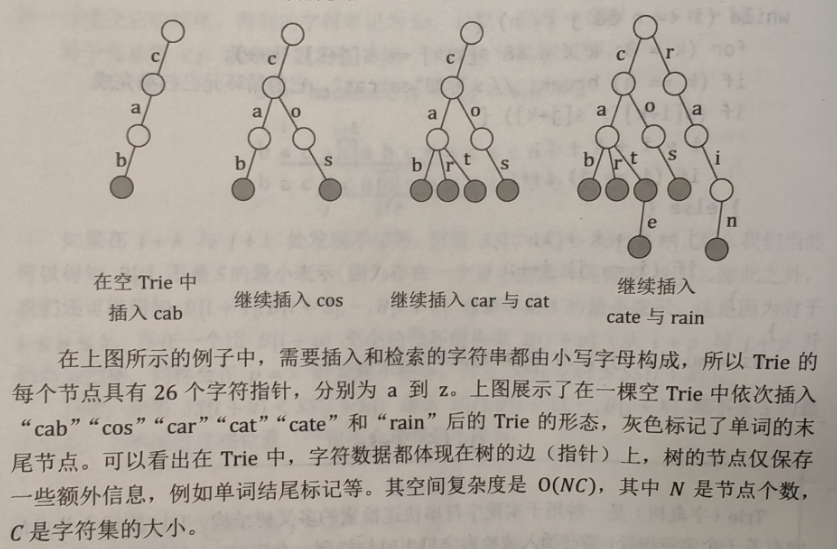
代码模板
int Trie[maxn][26] = {}, tot = 1, end[maxn*26] = {};	//初始化,假设字符串由小写字母构成
void insert(char str[])	//插入一个字符串
{
	int len = strlen(str), p = 1;
	for(int i=0; i<len; i++)
	{
		int ch = str[i] - 'a';
		if(Trie[p][ch] == 0) Trie[p][ch] = ++tot;
		p = Trie[p][ch];
	}
	end[p] = true;
}
bool search(char str[])	//检索字符串是否存在
{
	int len = strlen(str), p = 1;
	for(int i=0; i<len; i++)
	{
		p = Trie[p][str[i] - 'a'];
		if(p == 0) return false
	}
	return end[p];
}
例题「一本通 2.3 例 1」Phone List
#include <bits/stdc++.h>
using namespace std;

/*
Trie树,每个节点不存储具体值,而是存储对应的指针
假如先插入a串,再插入b串
1、插入过程中,b串已经插入完,但还没有建新的节点,说明b是a的前缀
2、插入过程中,b串经过了a串的结尾,说明a是b的前缀
*/

//注意:这里maxn要定义为1e5+10
//因为题目中说n<=1e4,而每个串长度<=10
//所以最多可能有1e4 * 10个节点
const int maxn = 1e5 + 10;

int T = 0, n = 0;
//trie[maxn][15]的第二维表示每个节点可能有的状态,即0~9,这里开到15足够
int trie[maxn][15] = {}, tot = 1;
bool ed[maxn] = {};
char s[15];

//Trie树的插入操作
//在插入的同时,进行判断是否有前缀
bool insert(char str[])
{
	bool bRet = false;
	int len = strlen(str), p = 1;

	for(int i=0; i<len; i++)
	{
		int ch = str[i] - '0';
		if(trie[p][ch] == 0) trie[p][ch] = ++tot;
		else if(i == len - 1) bRet = true;

		p = trie[p][ch];
		if(ed[p]) bRet = true;
	}
	ed[p] = true;

	return bRet;
}

int main()
{
	scanf("%d", &T);
	while(T--)
	{
		memset(trie, 0, sizeof(trie));
		memset(ed, 0, sizeof(ed));
		tot = 1;

		bool flag = false;
		scanf("%d", &n);
		while(n--)
		{
			scanf("%s", s);
			if(insert(s))
			{
				flag = true;
				//break; 这里不能直接break,因为要把后面的字符串读完,否则会影响后面的读入
			}
		}

		if(flag) printf("NO\n");
		else printf("YES\n");
	}

    return 0;
}
01-Trie
维护异或极值
将数的二进制表示看做一个字符串,就可以构建出字符集为{0,1}的Trie树
例题:The XOR Largest Pair
把每个数拆成32位,每位为0或1
从高到低,按位插入Trie树中
因为每个数都是32位,所以trie树中每个分支就是一个数
然后遍历每个数,从高到低进行匹配
贪心思想,优先高位进行异或,只要有不一样的位,则加上该位的次方值
最后走的哪个分支,就是和哪个数进行匹配
维护异或和
例题:The XOR-longest Path
根据异或的性质,可将节点1作为中转节点
有两种情况:
1、有重合路径

假如求节点3到节点4的路径异或和,可先求出1->3和1->4,分别是\(3 \oplus 4\)和\(3 \oplus 6\)
而节点3到节点4路径异或和就是\(3 \oplus 4 \oplus 3 \oplus 6=4 \oplus 3 \oplus 3 \oplus 6=4 \oplus 6\)
2、无重合路径

假如求节点3到节点5的路径异或和,可先求出1->3和1->5,分别是\(3 \oplus 4\)和\(5 \oplus 6\)
而节点3到节点5的路径异或和就是\(3 \oplus 4 \oplus 5 \oplus 6\)
因此,该题解题思路:
1、dfs一下,求出1到其他点的异或值
2、任意x到y的路径上的异或值,就是\(d[x] \oplus d[y]\)
3、该问题就转换为了The XOR Largest Pair这个题,求最大异或对
AC 自动机
概述
AC自动机是以\(Trie\)的结构为基础,结合\(KMP\)的思想建立的自动机,用于解决多模式匹配等任务。
AC自动机本质上是\(Trie\)上的自动机
解释
简单来说,建立一个AC自动机有两个步骤:
1、基础的\(Trie\)结构:将所有的模式串构成一棵\(Trie\)
2、\(KMP\)思想:对\(Trie\)树上所有的节点构造失配指针
建立完毕后,就可以利用它进行多模式匹配
字典树构建
AC自动机在初始时会将若干模式串插入到一个\(Trie\)里,然后再\(Trie\)上建立AC自动机。这个\(Trie\)就是普通的\(Trie\),按照\(Trie\)原本的建树方法建树即可。
需要注意的是,\(Trie\)中的结点表示的是某个模式串的前缀。我们在后文也将其称作状态。一个节点表示一个状态,\(Trie\)的边就是状态的转移。
形式化的说,对于若干个模式串\(s_1, s_2, ..., s_n\),将它们构建一棵字典树后的所有状态的集合记作\(Q\)。
失配指针
AC自动机利用一个\(fail\)指针来辅助多模式串的匹配。
状态\(u\)的\(fail\)指针指向另一个状态\(v\),其中\(v∈Q\),且\(v\)是\(u\)的最长后缀(即在若干个后缀状态中取最长的一个作为\(fail\)指针)。
\(fail\)指针与\(KMP\)中的\(next\)指针相比:
1、共同点:两者同样是在失配的时候用于跳转的指针。
2、不同点:\(next\)指针求的是最长\(Border\)(即最长的相同前后缀),而\(fail\)指针指向所有模式串的前缀中匹配当前状态的最长后缀
因为\(KMP\)只对一个模式串做匹配,而AC自动机要对多个模式串做匹配,有可能\(fail\)指针指向的节点对应着另一个模式串,两者前缀不同。
总结下来,AC自动机的失配指针指向当前状态的最长后缀状态。
注意:AC自动机在做匹配时,同一位上可匹配多个模式串。
朴素字典树算法
构建指针(朴素算法)
下面介绍构建\(fail\)指针的基础思想:
构建\(fail\)指针,可以参考\(KMP\)中构造\(next\)指针的思想。
考虑字典树中当前的节点\(u\),\(u\)的父节点是\(p\),\(p\)通过字符\(c\)的边指向\(u\),即\(trie(p, c)=u\),假设深度小于\(u\)的所有节点的\(fail\)指针都已求得。
1、如果\(trie(fail(p), c)\)存在:则让\(u\)的\(fail\)指针指向\(trie(fail(p), c)\)。相当于在\(p\)和\(fail(p)\)后面加一个字符\(c\),分别对应\(u\)和\(fail(u)\)
2、如果\(trie(fail(p), c)\)不存在:那么我们继续找到\(trie(fail(fail(p)), c)\),重复判断过程,一直跳\(fail\)指针直到根节点
3、如果依然不存在,就让\(fail\)指针指向根节点。
如此即完成了\(fail(u)\)的构建。
图例
下面将使用若干张gif动图来演示对字符串\(i、he、his、she、hers\)组成的字典树构建\(fail\)指针的过程:
1、黄色节点:当前的节点\(u\)
2、绿色节点:表示已经BFS遍历完毕的节点
3、橙色的边:\(fail\)指针
4、红色的边:当前求出的\(fail\)指针

我们重点分析节点\(6\)的\(fail\)指针构建:

找到\(6\)的父节点\(5\),\(fail(5)=10\),然而节点\(10\)没有字母\(s\)连出的边;继续跳到\(10\)的\(fail\)指针,\(fail(10)=0\),发现\(0\)节点有字母\(s\)连出的边,指向\(7\)节点;所以\(fail(6)=7\).
下图展示了构建完毕的状态:

代码实现
void build()
{
	queue<int> q;
	for(int i=0; i<26; i++)
	{
		if(trie[0][i]) q.push(trie[0][i]);
 	}

 	while(!q.empty())
 	{
 		int u = q.front();
		q.pop();
		for(int i=0; i<26; i++)
		{
			//求x的失配指针,x的父节点为u
			int x = trie[u][i];
			if(!x) continue;

			int j = fail[u];	//跳到x的父节点的失配指针
			//不断往上跳,直到跳到0节点,或者j节点下面有i的指针
			while(j && !trie[j][i]) j = fail[j];
			if(trie[j][i]) j = trie[j][i];
			fail[x] = j;
			q.push(x);
		}
	}
}
解释:
\(build\)函数将节点按\(bfs\)顺序入队,依次求\(fail\)指针。这里的字典树根节点为\(0\),我们将根节点的子节点一一入队。若将根节点入队,则在第一次\(bfs\)的时候,会将根节点儿子的\(fail\)指针标记为本身。因此我们将根节点的儿子一一入队,而不是将根节点入队。
然后开始\(bfs\):每次取出队首的节点\(u\)(\(fail(u)\)在之前的\(bfs\)过程中以求得),然后遍历字符集(这里是\(0~25\),对应\(a~z\),即\(u\)的各个子节点)
1、如果\(x=trie[u][i]\)存在,则跳到\(x\)的父亲节点的\(fail\)指针,即\(fail(u)\),令\(j=fail(u)\)
①此时若\(trie[j][i]\)存在,则\(fail[x]=trie[j][i]\)
②若\(trie[j][i]\)不存在,则继续找其父节点的\(fail\)指针,直到跳到根节点或\(trie[j][i]\)存在
2、如果\(x=trie[u][i]\)不存在,则没有失配指针,继续下一个循环
多模式匹配(朴素算法)
void query()
{
	int u = 0;
	for(int i=0; t[i]; i++)
	{
		//这里相当于找到最长的可以与t匹配的模式串
		int x = t[i] - 'a';
		while(u && !trie[u][x]) u = fail[u];
		if(trie[u][x]) u = trie[u][x];

		//从j开始往前跳,即j前的所有前缀串都可以与t匹配
		int p = u;
		while(p)
		{
			ans += cnt[p];	//以p点作为结尾的模式串,都在文本串中出现过
			cnt[p] = 0;		//避免重复计算
			p = fail[p];	//往上跳
		}
	}
}
解释:
原理:当某个节点可以匹配文本串的第\(i\)个字符时,该节点及其所有的\(fail\)指针的节点都在该文本中出现过
遍历文本串,先找到字典树中可以匹配的点,然后不断往上调\(fail\)指针,累加次数,每次累加完,将该点次数清零,避免重复计算
例题:AC自动机(超简单版)
#include <bits/stdc++.h>
using namespace std;

const int maxn = 1e6 + 10;

int n = 0;
//trie:普通字典树,节点从0开始编号
//cnt[p]:以p点作为结尾的模式串的数量,因为该题有可能有相同的模式串
int trie[maxn][30], tot = 0, cnt[maxn];
char s[maxn], t[maxn];
int fail[maxn], ans = 0;

//构建trie树
void insert(char str[])
{
	int p = 0;
	//遍历字符串s,这样写就不用先求strlen(s)了
	for(int i=0; str[i]; i++)
	{
		int x = str[i] - 'a';
		if(!trie[p][x]) trie[p][x] = ++tot;
		p = trie[p][x];
	}
	cnt[p]++;	//以p点作为结尾的模式串的数量
}

//构建AC自动机
//构建fail指针
void build()
{
	queue<int> q;
	for(int i=0; i<26; i++)
	{
		if(trie[0][i]) q.push(trie[0][i]);
 	}

 	while(!q.empty())
 	{
 		int u = q.front();
		q.pop();
		for(int i=0; i<26; i++)
		{
			//求x的失配指针,x的父节点为u
			int x = trie[u][i];
			if(!x) continue;

			int j = fail[u];	//跳到x的父节点的失配指针
			//不断往上跳,直到跳到0节点,或者j节点下面有i的指针
			while(j && !trie[j][i]) j = fail[j];
			if(trie[j][i]) j = trie[j][i];
			fail[x] = j;
			q.push(x);
		}
	}
}

void query()
{
	int u = 0;
	for(int i=0; t[i]; i++)
	{
		//这里相当于找到最长的可以与t匹配的模式串
		int x = t[i] - 'a';
		while(u && !trie[u][x]) u = fail[u];
		if(trie[u][x]) u = trie[u][x];

		//从j开始往前跳,即j前的所有前缀串都可以与t匹配
		int p = u;
		while(p)
		{
			ans += cnt[p];	//以p点作为结尾的模式串,都在文本串中出现过
			cnt[p] = 0;		//避免重复计算
			p = fail[p];	//往上跳
		}
	}
}

int main()
{
	scanf("%d", &n);
	for(int i=1; i<=n; i++)
	{
		scanf("%s", s);
		insert(s);
	}
	scanf("%s", t);

	//构建AC自动机
	build();
	//查找
	query();

	printf("%d\n", ans);

    return 0;
}
字典树与字典图
在朴素版本中,字典树中的某个节点\(x\),若其子节点\(i\)存在,则\(trie[x][i]\)的值为其子节点的编号,若\(trie[x][i]\)不存在,则默认为\(0\)。
这里我们可以进行优化,当\(trie[x][i]\)不存在时,令其指向\(trie[fail[u]][i]\),其中\(u\)为\(x\)的父节点,因为\(bfs\)是从根节点开始,所以\(x\)的父节点一定已经处理完了,这样直接令\(fail[x]=trie[fail[u]][i]\)即可。
ps:字典图就相当于某个节点\(x\)直接向其\(fail[x]\)连边,\(x->fail[x]\)
过程
这里依然用若干张gif动图展示构建过程:

1、蓝色节点:\(bfs\)遍历到的节点\(u\)
2、蓝色的边:当前节点下,\(AC\)自动机修改字典树结构连出的边
3、黑色的边:\(AC\)自动机修改字典树结构连出的边
4、红色的边:当前节点求出的\(fail\)指针
5、黄色的边:\(fail\)指针
6、灰色的边:字典树的边
可以发现,众多交错的黑色边将字典树变成了字典图。图中省略了连向根节点的黑边(否则会更乱)。我们重点分析一下节点\(5\)遍历时的情况。我们求节点\(6\)的\(fail\)指针:

朴素算法,是找\(fail\)指针,于是我们跳到\(fail[5]=10\),发现没有\(s\)连出的字典树的边,于是跳到\(fail[10]=0\),发现有\(trie[0][s]=7\),于是\(fail[6]=7\)
字典图优化,因为5之前的层里的点数均已处理完,所以可以沿黑边、蓝边跳,我们跳到\(fail[5]=10\)之后,直接走\(trie[10][s]=7\),就走到了\(7\)号节点了
这就是\(build\)完成的两件事:构建\(fail\)指针和建立字典图。这个字典图也会在查询的时候起到关键作用。
时间复杂度: 定义 \(|s_i|\) 是模板串的长度,\(|S|\) 是文本串的长度,\(|\Sigma|\) 是字符集的大小(常数,一般为 \(26\))。如果建了trie图,时间复杂度就是 \(O(\sum|s_i|+n|\Sigma|+|S|)\),其中 \(n\) 是 AC 自动机中结点的数目,并且最大可以达到 \(O(\sum|s_i|)\)。
\(\sum|s_i|\)是建trie树的时间
\(n|\Sigma|\)是建\(fail数组\)、连\(trie\)图的时间
\(|S|\)是遍历文本串的时间
代码示例
//构建AC自动机,trie图
void build()
{
	queue<int> q;
	for(int i=0; i<26; i++)
	{
		if(trie[0][i]) q.push(trie[0][i]);
 	}

 	while(!q.empty())
 	{
 		int u = q.front();
		q.pop();
		for(int i=0; i<26; i++)
		{
			//构建trie图
			int x = trie[u][i];
			if(!x) trie[u][i] = trie[fail[u]][i];
			else
			{
				fail[x] = trie[fail[u]][i];
				q.push(x);
			}
		}
	}
}

//查找
void query()
{
	int u = 0;
	for(int i=0; t[i]; i++)
	{
		int x = t[i] - 'a';
		u = trie[u][x];

		int p = u;
		//cnt[p]!=-1这个条件很关键,可有效减少循环次数
		//当p节点已经累加后,标记为-1,此时p前面的fail节点,一定被累加过了
		//当p后面的节点跳到p时,不需要再从p往前跳
		while(p && cnt[p]!=-1)
		{
			ans += cnt[p];	//以p点作为结尾的模式串,都在文本串中出现过
			cnt[p] = -1;	//避免重复计算
			p = fail[p];		//往上跳
		}
	}
}
例题:AC 自动机(简单版)
#include <bits/stdc++.h>
using namespace std;

const int maxn = 1e6 + 10;

int n = 0;
int trie[maxn][30], tot = 0, cnt[maxn];
char s[maxn], t[maxn];
int fail[maxn], ans = 0;

void insert(char str[])
{
	int p = 0;
	//遍历字符串s,这样写就不用先求strlen(s)了
	for(int i=0; str[i]; i++)
	{
		int x = str[i] - 'a';
		if(!trie[p][x]) trie[p][x] = ++tot;
		p = trie[p][x];
	}
	cnt[p]++;	//以p点作为结尾的模式串,有可能有相同的模式串
}

//构建AC自动机,trie图
void build()
{
	queue<int> q;
	for(int i=0; i<26; i++)
	{
		if(trie[0][i]) q.push(trie[0][i]);
 	}

 	while(!q.empty())
 	{
 		int u = q.front();
		q.pop();
		for(int i=0; i<26; i++)
		{
			//构建trie图
			int x = trie[u][i];
			if(!x) trie[u][i] = trie[fail[u]][i];
			else
			{
				fail[x] = trie[fail[u]][i];
				q.push(x);
			}
		}
	}
}

//查找
void query()
{
	int u = 0;
	for(int i=0; t[i]; i++)
	{
		int x = t[i] - 'a';
		u = trie[u][x];

		int p = u;
		//cnt[p]!=-1这个条件很关键,可有效减少循环次数
		//当p节点已经累加后,标记为-1,此时p前面的fail节点,一定被累加过了
		//当p后面的节点跳到p时,不需要再从p往前跳
		while(p && cnt[p]!=-1)
		{
			ans += cnt[p];	//以p点作为结尾的模式串,都在文本串中出现过
			cnt[p] = -1;	//避免重复计算
			p = fail[p];		//往上跳
		}
	}
}

int main()
{
	scanf("%d", &n);
	for(int i=1; i<=n; i++)
	{
		scanf("%s", s);
		insert(s);
	}
	scanf("%s", t);

	build();
	query();

	printf("%d\n", ans);

    return 0;
}
拓扑排序优化AC自动机
思路
参见例题:P5357 【模板】AC 自动机
题目让我们求每个模式串在文本中出现的次数,利用上面字典树与字典图的思想,在\(query\)函数中,每次匹配,会一直向\(fail\)边跳来找到所有的匹配,但是这样的效率太低,在某些题目中会超时。
那么如何优化呢?首先需要了解到\(fail\)指针的性质:一个AC自动机中,如果只保留\(fail\)边,那么剩余的图一定是一棵树。
这是显然的,因为\(fail\)不会成环,且深度一定比现在低,所以得证。
具体思路:
我们在构建字典图时,边是由\(x->fail[x]\),这样由这些边构成一棵树,记录每个点的入度数。遍历完文本串后,若x符合要求,则fail[x]也一定符合要求,因此,我们只需要记录下每个点的数量,然后沿着边不断累加即可。在拓扑排序时,数量值会沿着边的方向向上传递,所以跑一遍拓扑排序,就可以从下往上累计起来。
大概类似于下图:

例题:【模板】AC 自动机
#include <bits/stdc++.h>
using namespace std;

const int maxn = 2e5 + 10;
const int maxx = 2e6 + 10;

int n = 0;
int trie[maxx][30], tot = 0;
char s[maxn], t[maxx];
//idx[i]表示第i个模式串对应的trie树中的节点
//cnt[i]表示trie树中的第i个节点在文本串中出现的次数
//du表示每个节点的入度
int fail[maxn], idx[maxx], cnt[maxx], du[maxx];

void insert(char str[], int k)
{
	int p = 0;
	//遍历字符串s,这样写就不用先求strlen(s)了
	for(int i=0; str[i]; i++)
	{
		int x = str[i] - 'a';
		if(!trie[p][x]) trie[p][x] = ++tot;
		p = trie[p][x];
	}
	idx[k] = p;
}

//构建AC自动机,trie图
void build()
{
	queue<int> q;
	for(int i=0; i<26; i++)
	{
		if(trie[0][i]) q.push(trie[0][i]);
 	}

 	while(!q.empty())
 	{
 		int u = q.front();
		q.pop();
		for(int i=0; i<26; i++)
		{
			//构建trie图
			int x = trie[u][i];
			if(!x) trie[u][i] = trie[fail[u]][i];
			else
			{
				fail[x] = trie[fail[u]][i];
				du[trie[fail[u]][i]]++;
				q.push(x);
			}
		}
	}
}

//查找
void query()
{
	int u = 0;
	for(int i=0; t[i]; i++)
	{
		int x = t[i] - 'a';
		u = trie[u][x];
		cnt[u]++;
	}
}

void topu()
{
	queue<int> q;
	for(int i=0; i<=tot; i++)
	{
		if(du[i] == 0) q.push(i);
	}
	while(!q.empty())
	{
		int x = q.front();
		q.pop();

		int y = fail[x];
		cnt[y] += cnt[x];
		du[y]--;
		if(du[y] == 0) q.push(y);
	}
}

int main()
{
	scanf("%d", &n);

	for(int i=1; i<=n; i++)
	{
		scanf("%s", s);
		insert(s, i);
	}
	scanf("%s", t);

	build();
	query();
	topu();

	for(int i=1; i<=n; i++)
	{
		printf("%d\n", cnt[idx[i]]);
	}

    return 0;
}
DFS优化AC自动机
思路
参见例题:P5357 【模板】AC 自动机
具体思路:
相当于上述拓扑排序优化的反向操作,我们在构建字典图时,边是由\(x->fail[x]\),现在我们再构建一个图\(g\),该图的边是由\(fail[x]->x\),这样当\(fail[x]\)到\(x\)之间的链上有点能匹配时,只修改该点的数量,最后对图\(g\)执行\(dfs\),求某个点的子树和,这就是该点出现的次数,因为其子节点出现过,一定会使该节点也出现过。
大概类似于下图:

这样就不需要每次都不断地跳\(fail\)指针了,只需要最后\(dfs\)一遍就可以
例题:【模板】AC 自动机
#include <bits/stdc++.h>
using namespace std;

const int maxn = 2e5 + 10;
const int maxx = 2e6 + 10;

int n = 0;
int trie[maxx][30], tot = 0;
char s[maxn], t[maxx];
//idx[i]表示第i个模式串对应的trie树中的节点
//cnt[i]表示trie树中的第i个节点在文本串中出现的次数
int fail[maxn], idx[maxx], cnt[maxx];
vector<int> g[maxn];

void insert(char str[], int k)
{
	int p = 0;
	//遍历字符串s,这样写就不用先求strlen(s)了
	for(int i=0; str[i]; i++)
	{
		int x = str[i] - 'a';
		if(!trie[p][x]) trie[p][x] = ++tot;
		p = trie[p][x];
	}
	idx[k] = p;
}

//构建AC自动机,trie图
void build()
{
	queue<int> q;
	for(int i=0; i<26; i++)
	{
		if(trie[0][i])
		{
			g[0].push_back(trie[0][i]);
			q.push(trie[0][i]);
		}
 	}

 	while(!q.empty())
 	{
 		int u = q.front();
		q.pop();
		for(int i=0; i<26; i++)
		{
			//构建trie图
			int x = trie[u][i];
			if(!x) trie[u][i] = trie[fail[u]][i];
			else
			{
				fail[x] = trie[fail[u]][i];
				g[trie[fail[u]][i]].push_back(x);
				q.push(x);
			}
		}
	}
}

//查找
void query()
{
	int u = 0;
	for(int i=0; t[i]; i++)
	{
		int x = t[i] - 'a';
		u = trie[u][x];
		cnt[u]++;
	}
}

void dfs(int x)
{
	for(int y : g[x])
	{
		dfs(y);
		cnt[x] += cnt[y];
	}
}

int main()
{
	scanf("%d", &n);

	for(int i=1; i<=n; i++)
	{
		scanf("%s", s);
		insert(s, i);
	}
	scanf("%s", t);

	build();
	query();
	dfs(0);

	for(int i=1; i<=n; i++)
	{
		printf("%d\n", cnt[idx[i]]);
	}

    return 0;
}
AC自动机上DP
例题:P2292 [HNOI2004] L 语言
暴力写法(TLE)
#include <bits/stdc++.h>
using namespace std;

/*
ac自动机上的dp
1、先建立trie树
2、跑ac自动机,建立trie图
3、在查询的时候跑dp
①状态定义:
f[i]表示文章的前i个字符能否被理解
②状态转移:
当节点i为某个单词结尾时,可以转移,此时该单词长度可通过dep求出(需要跳fail)
当f[i-dep]为真时,f[i]为真,表示可以拼成
③状态初始值:
f全部置为false
*/

const int maxn = 25;
const int maxs = 25;
const int maxt = 2e6 + 10;

int n = 0, m = 0;
char s[maxs], t[maxt];
int trie[maxn*maxs][30], tot = 0, dep[maxn*maxs];
bool vis[maxn*maxs];
int fail[maxn*maxs];
//f[i]表示文章的前i个字符能否被理解
int f[maxt];

//建立trie树
void insert(char str[])
{
	int p = 0;
	for(int i=0; str[i]; i++)
	{
		int x = str[i] - 'a';
		if(!trie[p][x]) trie[p][x] = ++tot;
		p = trie[p][x];
	}
	vis[p] = true;
}

//跑ac自动机,建trie图
void build()
{
	queue<int> q;
	for(int i=0; i<26; i++)
	{
		if(trie[0][i])
		{
			dep[trie[0][i]] = 1;
			q.push(trie[0][i]);
		}
	}

	while(!q.empty())
	{
		int u = q.front();
		q.pop();
		for(int i=0; i<26; i++)
		{
			int x = trie[u][i];
			if(!x) trie[u][i] = trie[fail[u]][i];
			else
			{
				dep[x] = dep[u] + 1;
				fail[x] = trie[fail[u]][i];
				q.push(x);
			}
		}
	}
}

void query()
{
	int u = 0;
	for(int i=0; t[i]; i++)
	{
		int x = t[i] - 'a';
		u = trie[u][x];

		int j = i+1;
		for(int p=u; p; p=fail[u])
		{
			if(!vis[p]) continue;
			if(f[j-dep[p]] || j==dep[p]) f[j] = true;
		}
	}
}

int main()
{
	scanf("%d%d", &n, &m);
	for(int i=1; i<=n; i++)
	{
		scanf("%s", s);
		insert(s);
	}

	build();

	for(int i=1; i<=m; i++)
	{
		scanf("%s", t);

		memset(f, 0, sizeof(f));
		query();

		int ans = 0, len = strlen(t);
		for(int i=len; i>=1; i--)
		{
			if(f[i])
			{
				ans = i;
				break;
			}
		}
		printf("%d\n", ans);
	}

	return 0;
}
正解
#include <bits/stdc++.h>
using namespace std;

const int maxn = 25;
const int maxs = 25;
const int maxt = 2e6 + 10;

int n = 0, m = 0;
char s[maxs], t[maxt];
int trie[maxn*maxs][30], tot = 0, dep[maxn*maxs];
bool vis[maxn*maxs];
int fail[maxn*maxs];
//状压dp
//d[i]表示trie树中的节点i的状态,以二进制位表示
//若某一位为1,表示该节点是为单词尾,否则不是
//当前结点的状态在第dep[i]位
int d[maxn*maxs];

void insert(char str[])
{
	int p = 0;
	for(int i=0; str[i]; i++)
	{
		int x = str[i] - 'a';
		if(!trie[p][x]) trie[p][x] = ++tot;
		p = trie[p][x];
	}
	vis[p] = true;
}

void build()
{
	queue<int> q;
	for(int i=0; i<26; i++)
	{
		if(trie[0][i])
		{
			dep[trie[0][i]] = 1;
			q.push(trie[0][i]);
		}
	}

	while(!q.empty())
	{
		int u = q.front();
		q.pop();

		//对状压状态的更新
		int p = fail[u];
		d[u] = d[p];
		if(vis[u]) d[u] |= 1 << dep[u];

		for(int i=0; i<26; i++)
		{
			int x = trie[u][i];
			if(!x) trie[u][i] = trie[fail[u]][i];
			else
			{
				dep[x] = dep[u] + 1;
				fail[x] = trie[fail[u]][i];
				q.push(x);
			}
		}
	}
}

int query()
{
	int u = 0, ret = 0, st = 1;
	for(int i=0; t[i]; i++)
	{
		int x = t[i] - 'a';
		u = trie[u][x];

		st <<= 1;
		if(d[u] & st)
		{
			st |= 1;
			ret = i + 1;
		}
	}
	return ret;
}

int main()
{
	scanf("%d%d", &n, &m);
	for(int i=1; i<=n; i++)
	{
		scanf("%s", s);
		insert(s);
	}

	build();

	for(int i=1; i<=m; i++)
	{
		scanf("%s", t);
		printf("%d\n", query());
	}

	return 0;
}

 浙公网安备 33010602011771号