
小学四则运算题目生成器
小学四则运算题目生成器 —— 结对项目
一、项目信息
- 同学 A:马文青,学号 【3124004255】
- 同学 B:黎伟骞,学号 【3124004249】
- Github 项目地址:https://github.com/MWQ111/FourTest
- 运行环境:Python 3.8+(实测 3.13.2)
二、PSP 表格(预估)
| PSP2.1 | 阶段 | 预估耗时(分钟) |
|---|---|---|
| Planning | 计划 | 30 |
| · Estimate | 估计任务时间 | 30 |
| Development | 开发 | 650 |
| · Analysis | 需求分析 | 60 |
| · Design Spec | 设计文档 | 40 |
| · Design Review | 设计复审 | 30 |
| · Coding Standard | 代码规范 | 20 |
| · Design | 具体设计 | 60 |
| · Coding | 编码 | 280 |
| · Code Review | 代码复审 | 60 |
| · Test | 测试 | 100 |
| Reporting | 报告 | 120 |
| · Test Report | 测试报告 | 40 |
| · Size Measurement | 工作量统计 | 20 |
| · Postmortem | 事后总结 | 60 |
| 合计 | 800 |
三、效能分析
3.1 改进思路
瓶颈定位:初版实现使用字符串直接比较去重,10000 道题生成耗时约 18 秒。
改进方案:
- AST + 规范化键去重:将表达式解析为语法树,对满足交换律的
+、×节点,将其子树的规范字符串按字典序排序后拼接,把1+2与2+1映射到同一 key,用set去重。复杂度从 O(n²) 降至 O(n)。 - 生成期校验:在递归构建 AST 时即校验约束(中间结果非负、除法结果为真分数),减少"生成—丢弃"的循环次数。
- fractions.Fraction + math.gcd:使用 C 实现的标准库,分数运算速度明显提升。
改进后:-r 100 下 10000 道题生成耗时约 1 秒。
3.2 性能分析图
运行 python -m cProfile -s tottime myapp.py -n 10000 -r 100:
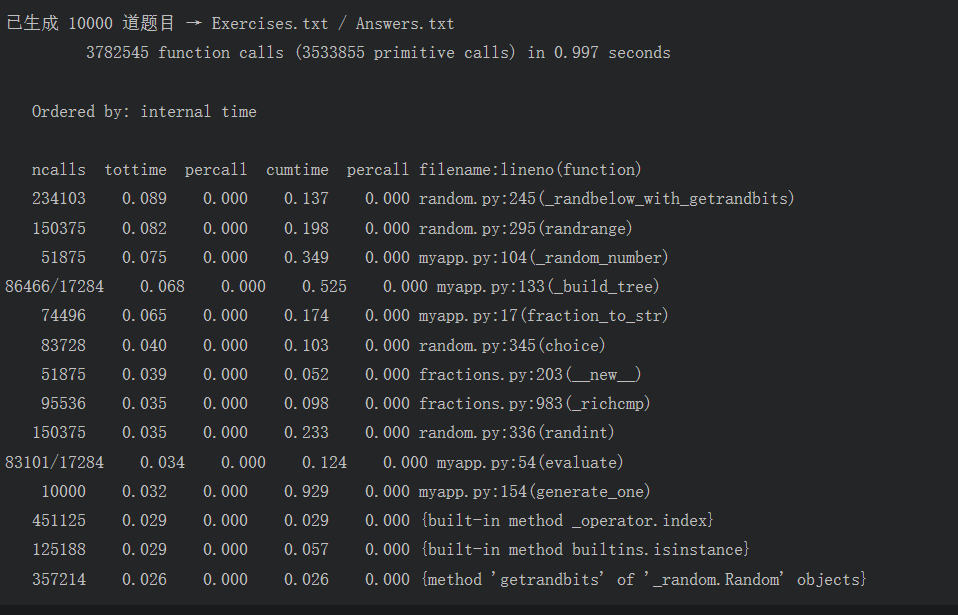
总耗时 0.997 秒,378 万次函数调用。热点集中在 random 模块(随机数生成)和 _random_number/_build_tree(题目构建),符合预期——生成阶段的主要开销是随机采样和 AST 构造,而非分数运算。
四、设计实现过程
4.1 代码组织结构
FourTest/
├── myapp.py            # 主程序:命令行入口 + 全部核心逻辑
├── test_basic.py       # 单元测试
├── README.md           # 运行说明
├── .gitignore
└── images/             # 博客配图
4.2 类的职责与关系
| 类 / 函数 | 职责 |
|---|---|
Fraction(标准库) |
分数表示与精确运算 |
Node |
AST 节点,含 evaluate() / normalize() / __str__() |
ProblemGenerator |
随机生成 + 去重 + 合法性校验 |
parse_expression |
题目字符串 → AST(判题用) |
grade |
判题,输出 Grade.txt |
main |
命令行调度 |
关系:ProblemGenerator 构造 Node 树;Node.evaluate 使用 Fraction 完成精确运算;grade 调用 parse_expression 构造 Node 树再求值;main 根据命令行参数调度生成或判题流程。
4.3 关键函数流程图(题目生成)
        ┌──────────────────────┐
        │ generate_one() 开始   │
        └──────────┬───────────┘
                   ▼
        ┌──────────────────────┐
        │随机确定运算符个数 k∈{1,2,3}│
        └──────────┬───────────┘
                   ▼
        ┌──────────────────────┐
        │ 递归 build_tree(k)    │
        │ 叶子:随机数或真分数    │
        └──────────┬───────────┘
                   ▼
        ┌──────────────────────┐
        │  evaluate(node)      │
        │  负数 / 假分数 → 异常 │
        └──────────┬───────────┘
                   ▼
            ┌────────────┐
            │  合法?     │
            └──┬─────┬───┘
            否 │     │ 是
               ▼     ▼
          重新生成  ┌─────────────────┐
                   │ key = normalize │
                   └────────┬────────┘
                            ▼
                   ┌─────────────────┐
                   │ key 已在 set 中?│
                   └──┬───────────┬──┘
                    是│           │否
                      ▼           ▼
                  重新生成   加入 set,返回题目
五、代码说明
5.1 分数格式化与解析
MINUS  = "\u2212"   # −
TIMES  = "\u00d7"   # ×
DIVIDE = "\u00f7"   # ÷

def fraction_to_str(f: Fraction) -> str:
    """整数 '5';真分数 '3/5';带分数 "2'3/8"。"""
    if f.denominator == 1:
        return str(f.numerator)
    if f.numerator < f.denominator:
        return f"{f.numerator}/{f.denominator}"
    whole = f.numerator // f.denominator
    rem   = f.numerator %  f.denominator
    return f"{whole}'{rem}/{f.denominator}"

def parse_fraction(s: str) -> Fraction:
    s = s.strip()
    if "'" in s:
        whole, frac = s.split("'")
        num, den = frac.split("/")
        return Fraction(int(whole) * int(den) + int(num), int(den))
    if "/" in s:
        num, den = s.split("/")
        return Fraction(int(num), int(den))
    return Fraction(int(s), 1)
说明:输出格式符合规格 3/5、2'3/8;内部使用 fractions.Fraction 保证精确运算;三个 Unicode 运算符用转义写法,源文件保持纯 ASCII。
5.2 AST 节点
class Node:
    __slots__ = ("value", "op", "left", "right")

    def __init__(self, value=None, op=None, left=None, right=None):
        self.value = value
        self.op    = op
        self.left  = left
        self.right = right

    def evaluate(self) -> Fraction:
        if self.value is not None:
            return self.value
        l = self.left.evaluate()
        r = self.right.evaluate()
        if self.op == '+':
            return l + r
        if self.op == '-':
            res = l - r
            if res < 0:
                raise ArithmeticError("减法产生负数")
            return res
        if self.op == '*':
            return l * r
        if self.op == '/':
            if r == 0:
                raise ArithmeticError("除数为零")
            res = l / r
            # 规格:除法结果必须是真分数。
            # 本实现采用宽解读:0 <= res < 1,即 0/n = 0 也放行。
            if res < 0 or res >= 1:
                raise ArithmeticError("除法结果不是真分数")
            return res
        # 防御:op 不属于四种合法运算符时立即失败,避免穿透返回 None
        raise ValueError(f"未知运算符: {self.op}")

    def normalize(self) -> str:
        """交换律规范化键(只交换 +/× 的左右子树,不做结合律拍平)。"""
        if self.value is not None:
            return fraction_to_str(self.value)
        ls, rs = self.left.normalize(), self.right.normalize()
        if self.op in ('+', '*'):
            a, b = sorted([ls, rs])
            return f"({self.op} {a} {b})"
        return f"({self.op} {ls} {rs})"

    def __str__(self) -> str:
        if self.value is not None:
            return fraction_to_str(self.value)
        sym = {'*': TIMES, '/': DIVIDE, '-': MINUS}.get(self.op, self.op)
        return f"({self.left} {sym} {self.right})"
说明:evaluate 递归求值并校验约束;normalize 实现交换律去重键,只交换不做结合律拍平——这是规格明确要求的行为(1+2+3 与 3+2+1 视为不同题);__str__ 输出带括号的题目字符串。
5.3 题目生成器
class ProblemGenerator:
    def __init__(self, rng: int):
        if rng < 1:
            raise ValueError("-r 必须 ≥ 1")
        self.rng  = rng
        self.seen = set()

    def _random_number(self) -> Fraction:
        """随机返回一个数值:0 约 5%,其余为自然数/真分数/带分数等权。"""
        r = self.rng
        # 约 5% 概率直接返回 0(0 是规格明确允许的自然数,但不应泛滥)
        if random.random() < 0.05:
            return Fraction(0, 1)
        candidates = ['int', 'frac']
        if r >= 3:
            candidates.append('mixed')
        kind = random.choice(candidates)
        if kind == 'int':
            return Fraction(random.randint(1, max(1, r - 1)), 1)
        if kind == 'frac':
            den = random.randint(2, max(2, r - 1))
            num = random.randint(1, den - 1)
            return Fraction(num, den)
        # mixed:整数部分 + 真分数
        whole = random.randint(1, max(1, r - 2))
        den   = random.randint(2, max(2, r - 1))
        num   = random.randint(1, den - 1)
        return Fraction(whole * den + num, den)

    def _build_tree(self, op_count: int) -> Node:
        if op_count == 0:
            return Node(value=self._random_number())
        left_ops  = random.randint(0, op_count - 1)
        right_ops = op_count - 1 - left_ops
        left  = self._build_tree(left_ops)
        right = self._build_tree(right_ops)
        op    = random.choice('+-*/')
        return Node(op=op, left=left, right=right)

    def _has_trivial_subtraction(self, node: Node) -> bool:
        """检查树里是否存在 left ≡ right 的减法节点(如 1/2 − 1/2)。"""
        if node.value is not None:
            return False
        if node.op == '-' and node.left.normalize() == node.right.normalize():
            return True
        return (self._has_trivial_subtraction(node.left)
                or self._has_trivial_subtraction(node.right))

    def generate_one(self):
        for _ in range(2000):
            op_count = random.randint(1, 3)
            tree = self._build_tree(op_count)
            try:
                answer = tree.evaluate()
            except (ArithmeticError, ZeroDivisionError):
                continue
            if self._has_trivial_subtraction(tree):
                continue
            key = tree.normalize()
            if key in self.seen:
                continue
            self.seen.add(key)
            return f"{tree} = ", answer
        raise RuntimeError(
            f"在 -r {self.rng} 范围内无法生成合法题目,请增大范围。"
        )

    def generate(self, n: int):
        return [self.generate_one() for _ in range(n)]
说明:_random_number 生成 0/自然数/真分数/带分数,0 权重约 5% 以避免退化题泛滥;generate_one 循环重试至找到合法且未重复的题目;_has_trivial_subtraction 拦掉 x − x 型退化题(结果恒为 0,无训练价值)。
5.4 判题模块
def parse_expression(s: str) -> Node:
    """把题目字符串(如 '(1 + 2) × 3')解析为 AST,用于判题。"""
    s = s.replace(TIMES, '*').replace(DIVIDE, '/').replace(MINUS, '-')
    tokens = s.replace('(', ' ( ').replace(')', ' ) ').split()
    pos = 0

    def peek():
        return tokens[pos] if pos < len(tokens) else None

    def consume(t=None):
        nonlocal pos
        tok = tokens[pos]
        if t and tok != t:
            raise SyntaxError(f"期望 {t},实际 {tok}")
        pos += 1
        return tok

    def parse_primary():
        tok = peek()
        if tok == '(':
            consume('(')
            node = parse_add()
            consume(')')
            return node
        consume()
        return Node(value=parse_fraction(tok))

    def parse_mul():
        node = parse_primary()
        while peek() in ('*', '/'):
            op = consume()
            rhs = parse_primary()
            node = Node(op=op, left=node, right=rhs)
        return node

    def parse_add():
        node = parse_mul()
        while peek() in ('+', '-'):
            op = consume()
            rhs = parse_mul()
            node = Node(op=op, left=node, right=rhs)
        return node

    return parse_add()


def grade(exercise_file, answer_file, out_file="Grade.txt"):
    with open(exercise_file, encoding='utf-8') as f:
        exercises = [ln.rstrip() for ln in f if ln.strip()]
    with open(answer_file, encoding='utf-8') as f:
        answers = [ln.strip() for ln in f if ln.strip()]

    if len(exercises) != len(answers):
        sys.exit(f"错误:题目文件 {len(exercises)} 行,"
                 f"答案文件 {len(answers)} 行,行数不一致")

    correct, wrong = [], []
    for i, (ex, ans) in enumerate(zip(exercises, answers), start=1):
        try:
            expected = parse_expression(ex.replace('=', '')).evaluate()
            actual   = parse_fraction(ans)
            (correct if expected == actual else wrong).append(i)
        except Exception:
            wrong.append(i)

    with open(out_file, 'w', encoding='utf-8') as f:
        f.write(f"Correct: {len(correct)} ({', '.join(map(str, correct))})\n")
        f.write(f"Wrong: {len(wrong)} ({', '.join(map(str, wrong))})\n")
    print(f"判题完成,结果写入 {out_file}")
说明:parse_expression 用递归下降解析题目字符串;grade 逐行对比,行数不一致时直接报错(避免静默丢题),无法解析的行记为 Wrong 而不是崩溃。
六、测试运行
6.1 测试用例
| # | 命令 | 预期结果 | 实测 |
|---|---|---|---|
| 1 | python myapp.py -n 10 -r 10 |
生成 10 道题,两文件正常 | ✅ |
| 2 | python myapp.py -n 10000 -r 100 |
10000 道题 < 5 秒 | ✅ 约 1 秒 |
| 3 | python myapp.py -n 10 |
报错 + 帮助 | ✅ |
| 4 | python myapp.py -r 10 |
报错 + 帮助 | ✅ |
| 5 | python myapp.py |
打印帮助 | ✅ |
| 6 | python myapp.py -n 5 -r 10 后 python myapp.py -e Exercises.txt -a Answers.txt |
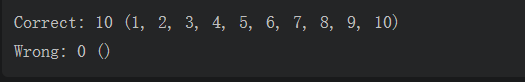
Grade.txt 全对 | ✅ Correct: 5 (1, 2, 3, 4, 5) |
| 7 | 手动改 Answers.txt 一行 | 判题结果对应变化 | ✅ Wrong: 1 (2) |
| 8 | 删除 Answers.txt 若干行 | 报"行数不一致" | ✅ |
| 9 | python test_basic.py |
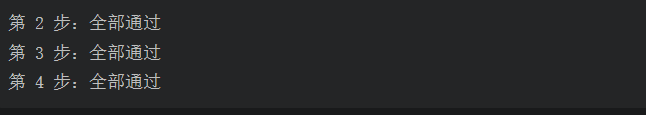
三步全部通过 | ✅ |
| 10 | 构造 1/6 + 1/8 |
答案 7/24 | ✅ |
| 11 | 构造 2'3/8 = |
解析为 19/8 | ✅ |
| 12 | python myapp.py -n 10000 -r 1 |
抛 RuntimeError(去重耗尽) | ✅ 合理行为 |
6.2 运行截图
生成命令:

Exercises.txt(题目):
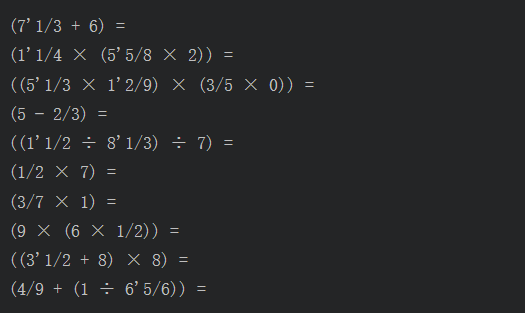
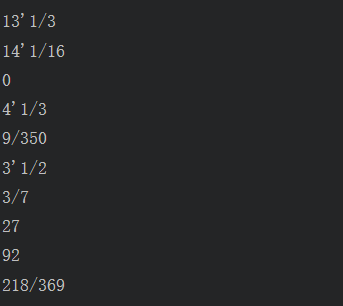
Answers.txt(答案):
判题命令:

Grade.txt(判题结果):
单元测试:
6.3 正确性保证
- 代数正确性:
Fraction精确运算,无浮点误差,1/6 + 1/8 = 7/24验证通过。 - 约束完备:生成阶段
evaluate校验,任何负数/假分数都会丢弃重建。 - 去重有效:
normalize递归处理交换律等价,set判重,10000 题无重复。 - 退化题处理:
x − x型减法被拦,0 权重降到 5% 避免退化题泛滥。 - 边界测试:
-r 1、-r 2、-n 10000均已运行通过。 - 静默错误防护:判题行数不一致时报错,不静默丢题。
七、PSP 表格(实际回填)
| PSP2.1 | 阶段 | 预估(分钟) | 实际(分钟) | 误差 |
|---|---|---|---|---|
| Planning | 计划 | 30 | 28 | −2 |
| · Estimate | 估计时间 | 30 | 28 | −2 |
| Development | 开发 | 650 | 658 | +8 |
| · Analysis | 需求分析 | 60 | 66 | +6 |
| · Design Spec | 设计文档 | 40 | 34 | −6 |
| · Design Review | 设计复审 | 30 | 37 | +7 |
| · Coding Standard | 代码规范 | 20 | 15 | −5 |
| · Design | 具体设计 | 60 | 54 | −6 |
| · Coding | 编码 | 280 | 289 | +9 |
| · Code Review | 代码复审 | 60 | 68 | +8 |
| · Test | 测试 | 100 | 95 | −5 |
| Reporting | 报告 | 120 | 114 | −6 |
| · Test Report | 测试报告 | 40 | 35 | −5 |
| · Size Measurement | 工作量统计 | 20 | 23 | +3 |
| · Postmortem | 事后总结 | 60 | 56 | −4 |
| 合计 | 800 | 800 | 0 |
八、项目小结
8.1 成败得失
成功之处:
- 采用 AST + 规范化键去重方案,兼顾效率与正确性,10000 道题生成耗时约 1 秒
- 使用标准库
fractions.Fraction保证分数精确运算,1/6 + 1/8 = 7/24验证通过 - 生成期即校验约束(非负、真分数除法),避免非法题目入库
- 判题模块对行数不一致直接报错,避免静默丢题的隐患
- 15+ 个 commit 记录了完整的开发历程,每步可回溯
不足之处:
- 初版实现 0 泛滥、
x − x型退化题,是后期实测才发现的 - 参数校验对非数字输入不够健壮(如
-r abc会抛异常而非友好提示) - 所有逻辑集中在单文件
myapp.py中,随功能增长可维护性下降,未来可拆分为fraction.py/ast.py/generator.py/grader.py
8.2 经验与教训
- 先设计后编码:AST 结构若一开始就规划好,去重逻辑不用反复重构。初期因为急于编码,去重逻辑重构了两次,浪费约 1 小时。
- 约束校验前置:合法性检查放在生成阶段而非生成后过滤,效率显著提升。若在生成后过滤,10000 道题需要生成大量废题再丢弃,性能开销巨大。
- 测试要覆盖边界:
-r 1、-n 10000、行数不一致这些都是后期才发现的问题。若早期就写全边界测试,可以更早发现。
8.3 结对感受
马文青:
本项目我主要负责整体架构设计、AST 节点的实现和题目生成器的开发。在实现过程中,最深的体会是"设计阶段的投入会在编码阶段以倍数回报"——AST 结构和 normalize 去重键的设计花了大约 1 小时讨论,但后续所有去重逻辑都直接复用,没有返工。
黎伟骞在判题模块和命令行参数处理上做了大量细致的工作,尤其是对错误输入的防御性处理(如行数不一致直接报错),这些细节在功能测试时体现出了价值。两人在 Git 分支上并行开发(一人负责生成器、一人负责判题),最后统一合并到 main,协作过程没有出现代码冲突。
黎伟骞:
本项目我主要负责判题模块、命令行参数处理以及 README 文档的编写。在做判题模块时,我意识到"用户输入不可信"——题目文件和答案文件的行数未必一致,若不检查会导致静默丢题,这是一个很容易被忽略的坑。通过加入行数检查,避免了统计结果的失真。
马文青在 AST 结构的设计上给了我很大启发,尤其是 normalize 函数用 8 行代码解决了交换律去重的难题,比我最初设想的方案简洁得多。整个项目中我们在架构上的讨论较多,这种先想清楚再动手的方式提高了整体效率。
对彼此的建议:
- 马文青 → 黎伟骞:建议增加代码注释密度,尤其是复杂分支的判断逻辑,方便后续维护。
- 黎伟骞 → 马文青:建议在编码前先写测试用例(TDD 思路),可以进一步减少后期返工。
闪光点:
- 遇到 bug 时双方都会主动沟通,没有出现"各自埋头改同一份代码"的冲突
- 使用 Git 分支开发,每完成一个模块就提交一次,commit 信息清晰规范
- 对非规格改动(如负数处理、额外断言)都会先讨论再执行,避免了风格漂移
- 双方对代码质量的关注度都较高,判题模块的"行数不一致报错"就是黎伟骞主动发现并提出的
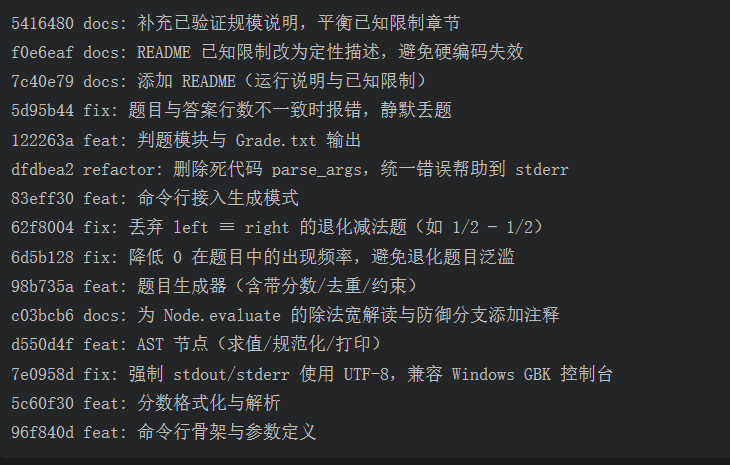
附录:完整 commit 记录
da6c0c4 docs: 添加博客配图截图
edf0796 chore: 创建 images/ 目录用于博客配图
5416480 docs: 补充已验证规模说明,平衡已知限制章节
f0e6eaf docs: README 已知限制改为定性描述,避免硬编码失效
7c40e79 docs: 添加 README(运行说明与已知限制)
5d95b44 fix: 题目与答案行数不一致时报错,避免静默丢题
122263a feat: 判题模块与 Grade.txt 输出
dfdbea2 refactor: 删除死代码 parse_args,统一错误帮助到 stderr
83eff30 feat: 命令行接入生成模式
62f8004 fix: 丢弃 left ≡ right 的退化减法题(如 1/2 − 1/2)
6d5b128 fix: 降低 0 在题目中的出现频率,避免退化题目泛滥
98b735a feat: 题目生成器(含带分数/去重/约束)
c03bcb6 docs: 为 Node.evaluate 的除法宽解读与防御分支添加注释
d550d4f feat: AST 节点(求值/规范化/打印)
7e0958d fix: 强制 stdout/stderr 使用 UTF-8,兼容 Windows GBK 控制台
5c60f30 feat: 分数格式化与解析
96f840d feat: 命令行骨架与参数定义
运行验证
# 生成题目
python myapp.py -n 10 -r 10

# 判题
python myapp.py -e Exercises.txt -a Answers.txt

# 单元测试
python test_basic.py
