
“机器学习“ 笔记 <开篇——范式>
引言
随着时代的不断发展,逐渐涌现出多种多样的算法模型。根据其应用特点简单的分为两大类别:应用型算法和研究型算法。
应用型算法:以解决现实问题为核心目标,因此强调实用性、稳定性和效率,常用于工业落地或商业应用场景。
研究型算法:以理论创新或性能突破为首要任务,因此侧重新颖性和极限性能。常见于学术研究或前沿技术探索。
本系列将作为学习笔记,记录应用型算法实战全过程、学习过程中所遇到的各类问题以及最终实现成果。
PS:
下面是博主的个人主页,可自行查看相关系列或获取源码,本人未设置收费望周知。
GitHub|博客园|CSDN
找不到源码或业其它需求可私信。
在正式开始应用型算法实战之前,首先需要先了解一些基本概念,以及各大类算法模型所适用的范围,否则可能会出现算法与业务场景不匹配情况,比如"在图像识别任务中使用文本分类算法"等。
一、经典三大范式
相信各位已经对机器学习(ML)有一定的了解,这里就不再对其基本概念进行赘述,下面将简单的讲解机器学习中经典的三大范式,帮助大家快速选择适合业务场景的算法。不过需要注意的是深度学习(DL),仅仅是ML的一个分支,需明确其属于机器学习技术体系的从属关系。
1.1 监督学习(Supervised Learning)
1.1.1 监督学习定义
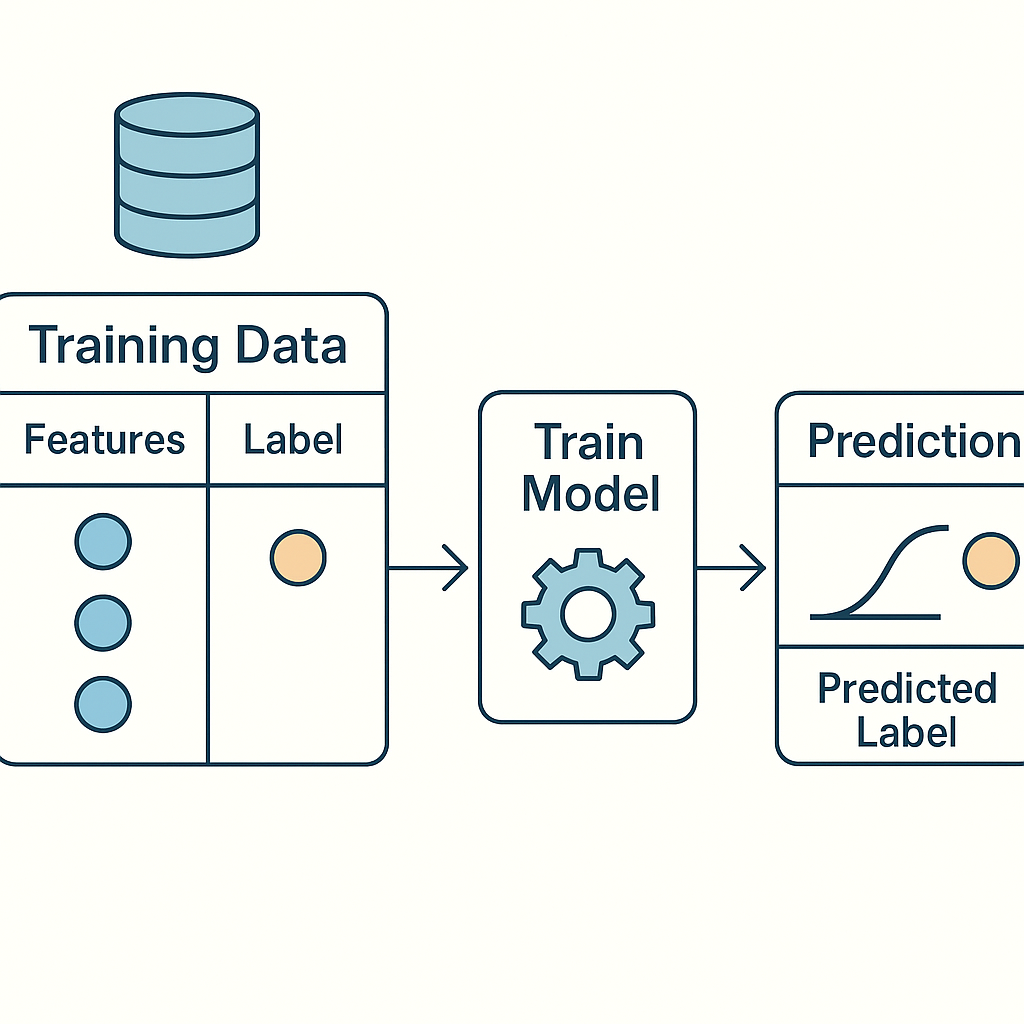
监督学习的核心思想是基于一组带有“正确答案”的训练样本,学习一个映射函数,之后用这个函数对新样本进行分析并给出结果。
在监督学习中训练数据里既有特征(Features),又有标签(Labels)(标签就是我们的目标),通过模型训练让模型学到特征与标签之间的关系,从而在只有特征没有标签的数据上,判断出此时的标签是什么。
通俗理解:我们可以把机器当成学生,监督学习就是我们教会它书本中习题的解法知识,并告知答案,让他在考试的时候可以用学到的知识自行给出答案。
1.1.2 监督学习任务
就像上学时要学习不同类别的书籍,监督学习也有它相应的类别划分。主要分为两类,分别是分类和回归。
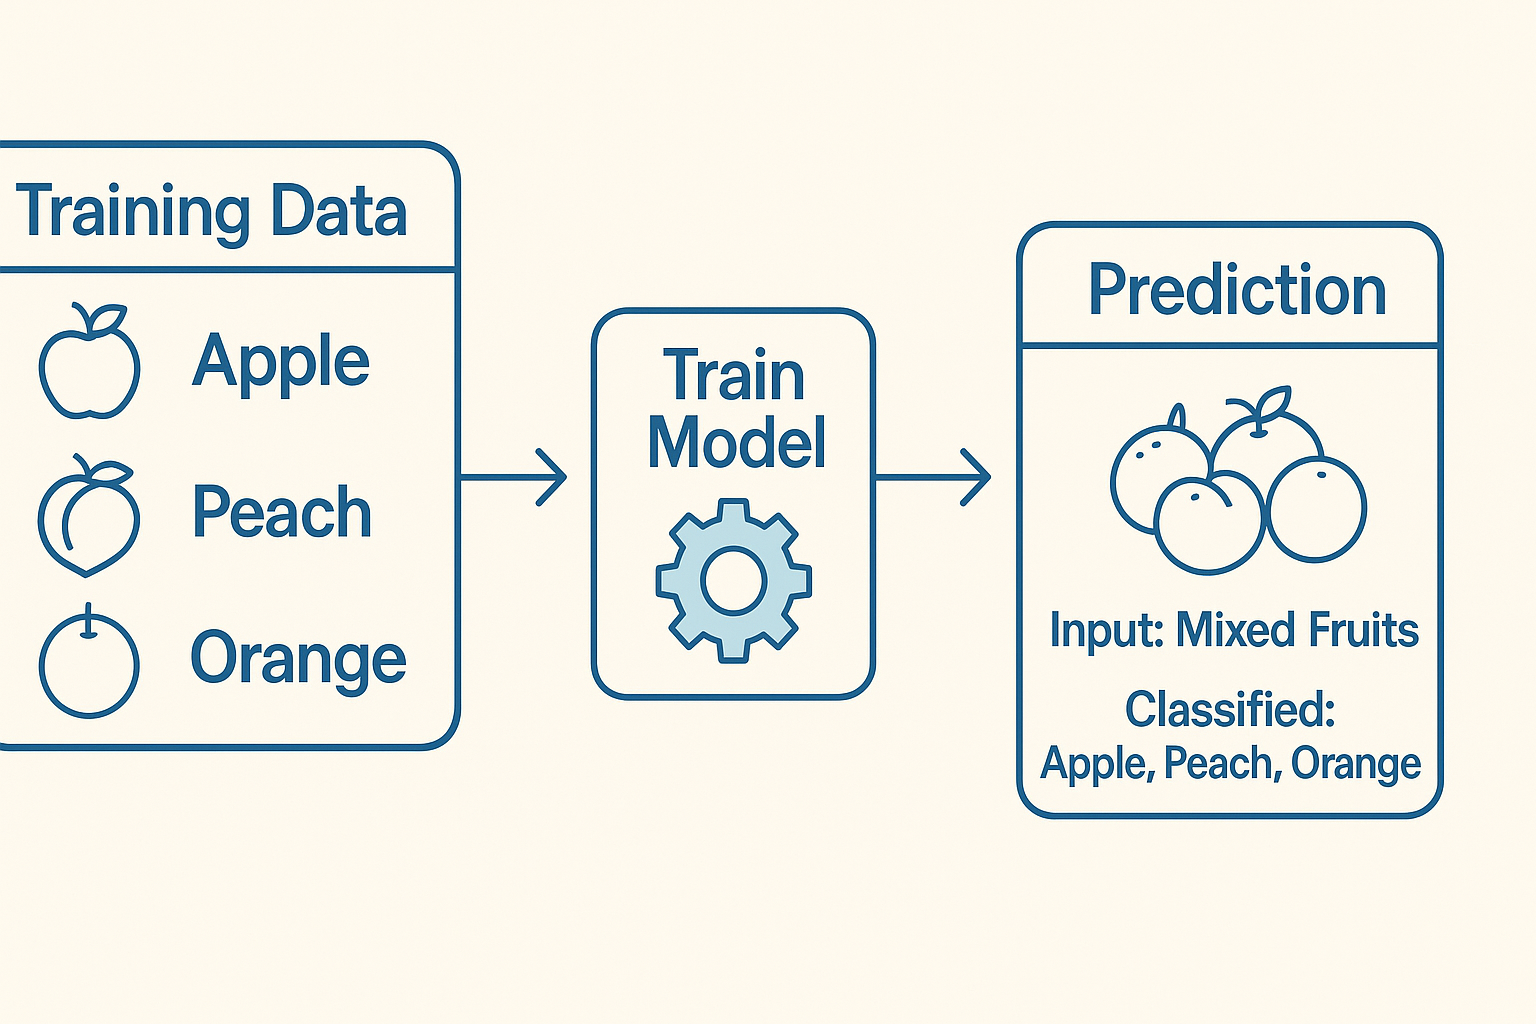
- 分类(Classification):分类的核心思想是根据输入的特征,将样本分配到预定义的类别之一,每个类别都有一个唯一的标签。算法在训练阶段,通过学习数据中的特征和标签之间的关系,构建出一个模型(Model)。最后在测试阶段,用模型在未见过的数据中来预测类别标签。例如:水果分类,邮件标记等。
通俗理解:我们教小朋友辨别水果,先拿来一堆水果教会他这里面什么是苹果,什么是桃子,什么是橘子,再把一堆苹果桃子橘子放一起,让他自己进行分类划分,这就是分类任务。
- 回归(Regression):回归的核心思想是预测连续型数值(非分类的离散类别),这里需要特别注意的是“连续”。算法在训练阶段,通过学习输入特征和连续标签之间的映射关系,构建出一个模型。最后在测试阶段,用模型在未见过的数据中来预测数据的标签值(输出值)。例如:房价预测,温度预测等等。
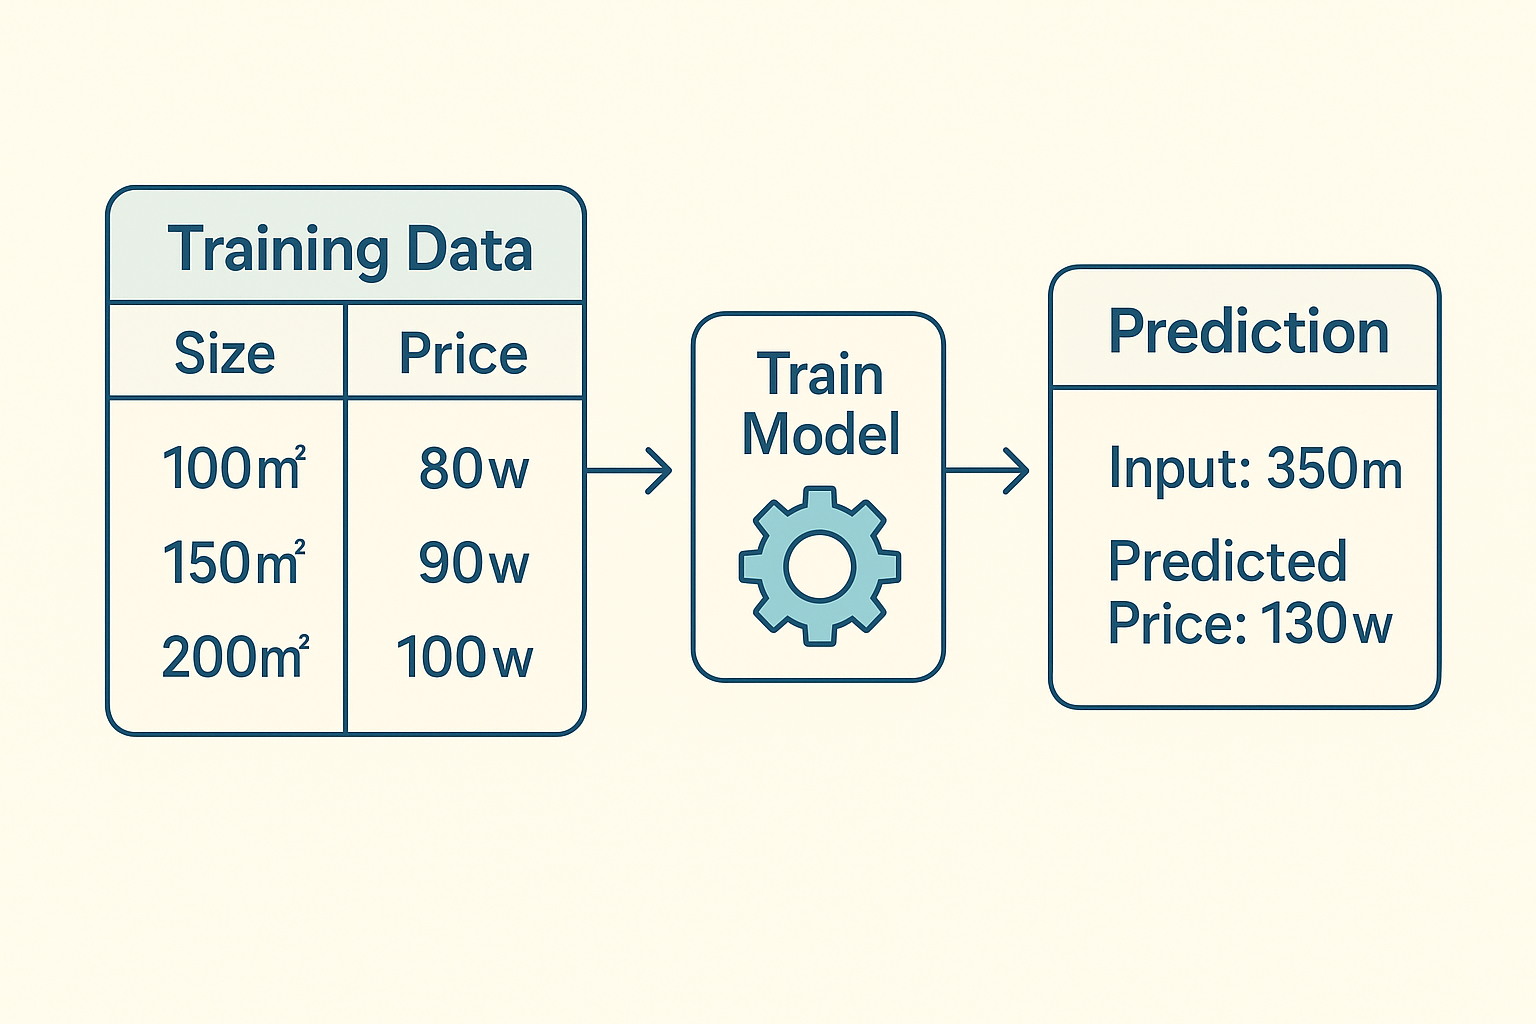
通俗理解:我们去买房子,销售告诉我们100平米的价格为80W,150平米的价格为90w,200平米的价格为100w,那么我们自然而然的可以推断出350平米的价格,这就是回归任务。
1.1.3 经典监督学习算法
监督学习算法类型也有很多种,这里的类型指在之前所提到的两大类的基础上进一步细分的分类,不要与之前的概念混淆。
1.线性模型类
- 线性回归(Linear Regression):线性回归通过假设输出与输入特征之间存在线性关系,求解参数使平方误差最小化(OLS)。
- 逻辑回归(Logistic Regression):逻辑回归尽管名字为回归,但是它实际上是属于二元(或多元)分类算法,其输出为映射到类别的概率。
2.邻域与核方法类
- k 最近邻 (k-Nearest Neighbors, k-NN):KNN是一种基于实例的模型。在预测时取训练集中与测试样本最近的 k 个邻居,分类则投票,回归则平均。
- 支持向量机(Support Vector Machine, SVM):SVM核心思想是在特征空间中找到一个超平面(决策边界),将不同类别的数据分开,并确保该边界到最近数据点(支持向量)的距离最大。而在具体使用时,我们可以将其划分为两类,用于分类时称为SVC,用于回归时称为SVR。
3.树与集成类
- 决策树 (Decision Tree):决策树是一种基于树形结构的监督学习算法,通过一系列规则对数据进行分类或回归。其核心思想是递归地划分特征空间,使得每个子区域的样本尽可能属于同一类别(分类)或具有相似的值(回归)。
- 随机森林 (Random Forest):随机森林是一种Bagging类型的集成学习算法,通过构建多棵决策树并综合它们的预测结果,得到最终结果。其作用于分类时通过投票(多数表决)决定最终类别,作用为回归时通过取平均值输出最终结果。其思想可以简单的理解成“三个臭皮匠,顶一个诸葛亮。”
- 梯度提升 (Gradient Boosting):梯度提升是一种基于加法模型(Additive Model)和前向分步算法(Forward Stagewise)的Boosting型集成学习算法,通过逐步优化残差来构建强预测模型。其核心思想是“用弱学习器的串联来纠正前序模型的错误”,最终组合成一个高性能模型。
4.概率类
- 朴素贝叶斯(Naive Bayes):朴素贝叶斯是一种基于贝叶斯定理的概率分类算法,通过假设特征条件独立(强假设现实可能不成立),基于贝叶斯定理计算 posterior 进行分类。
- 高斯过程回归(Gaussian Process Regression, GPR):高斯过程回归是一种非参数的贝叶斯回归方法,其核心思想是用“函数分布”的方式来直接对任意输入点上的函数值进行建模与推断,而不是事先假定一个固定形式的参数化模型。
5.判别分析类
-
线性判别分析(Linear Discriminant Analysis,LDA):线性判别分析通过将多维数据投影到一个或多个低维空间,使得同类样本在投影后尽可能聚拢,而不同类样本尽可能分离,以此达到分类目的。
-
神经网络类
-
多层感知机 (Multilayer Perceptron, MLP):多层感知机通过多层非线性变换实现复杂函数逼近,解决单层感知机无法处理线性不可分问题的局限性。其实某种意义上MLP也是深度学习(DL)的里程碑之一。
1.1.4 监督学习的应用领域
1.图像领域(Computer Vision)
- 图像分类:图像分类指将整张图像分配到某个类别,如猫-狗分类。
- 目标检测:目标检测指在图像中定位并标注出所有目标框,如车牌识别。
- 语义分割:语义分割指将图像中每个像素打上类别标签,如自动驾驶场景下道路-行人-车辆分割。
2.文本与语言领域(NLP)
- 文本分类 :文本分类指将整段文本归到一个或多个标签,如垃圾邮件过滤。
- 序列标注:为序列中每个元素打标签,如词性标注。
- 序列到序列:序列到序列指将一个序列映射到另一个序列,如机器翻译。
- 文本回归 :文本回归指根据文本预测数值,如新闻热度预测。
3.语音与音频领域(Speech & Audio)
- 语音识别:语音识别指将语音转换为文字,如电话客服语音转录。
- 人声识别:人声识别指根据声音判断说话人身份,如声纹验证。
- 音频分类:音频分类指为音频片段划分标签,如环境音分类(雨声、兽吼、鸟鸣)。
4.时序领域(Time Series)
- 时序预测 :时序预测指通过历史数据预测未来某点或某段时间的数值,如股票价格预测。
- 时序分类:时序分类指目的是为时间序列数据分配预定义的类别标签,如医疗信号。
1.2 无监督学习(Unsupervised Learning)
1.2.1 无监督学习定义
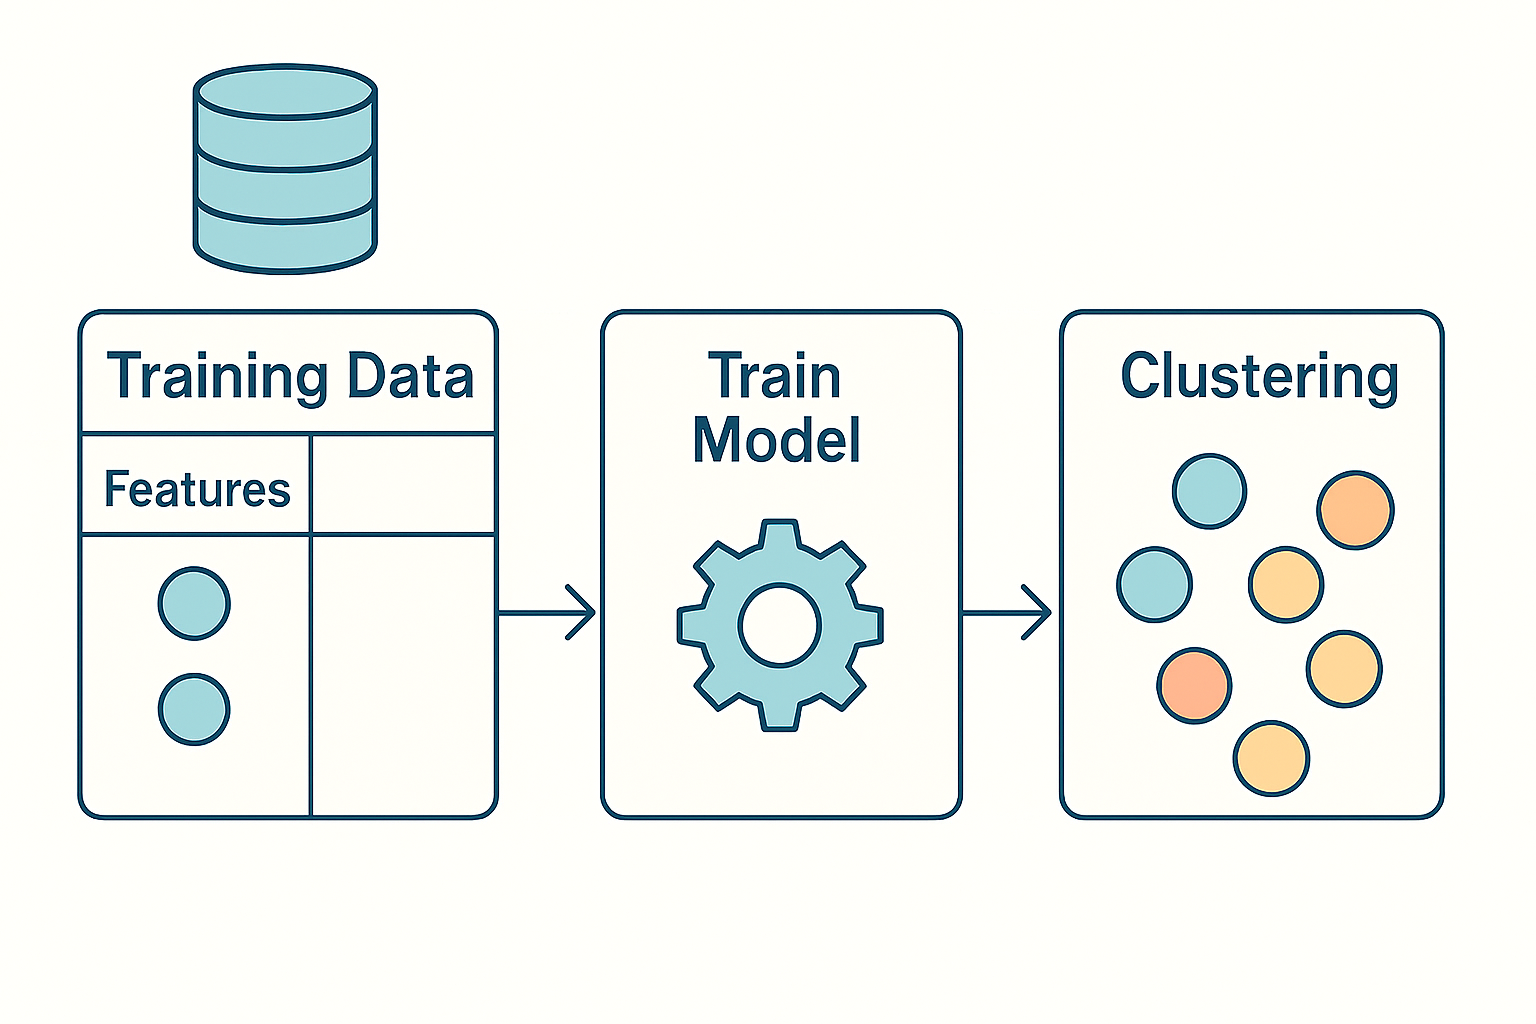
无监督学习的核心思想是从无标签数据中自动发现隐藏的模式、结构或规律,而不依赖于人工标注的指导信号。
在无监督学习的训练数据里只有输入特征(Features),没有对应的标签(Labels),模型需要自主挖掘数据的内在特性。
通俗理解:我们依然把机器当成学生,但是我们只丢给他一本书,让他自行去学习书中的内容,最后总结书中的知识结构和规律,这就是无监督学习。
1.2.2 无监督学习任务
无监督学习因为它自身的特殊性,无标签或目标值,其目标是从数据中自行挖掘隐藏的结构和模式,所以也有很多的类别划分:
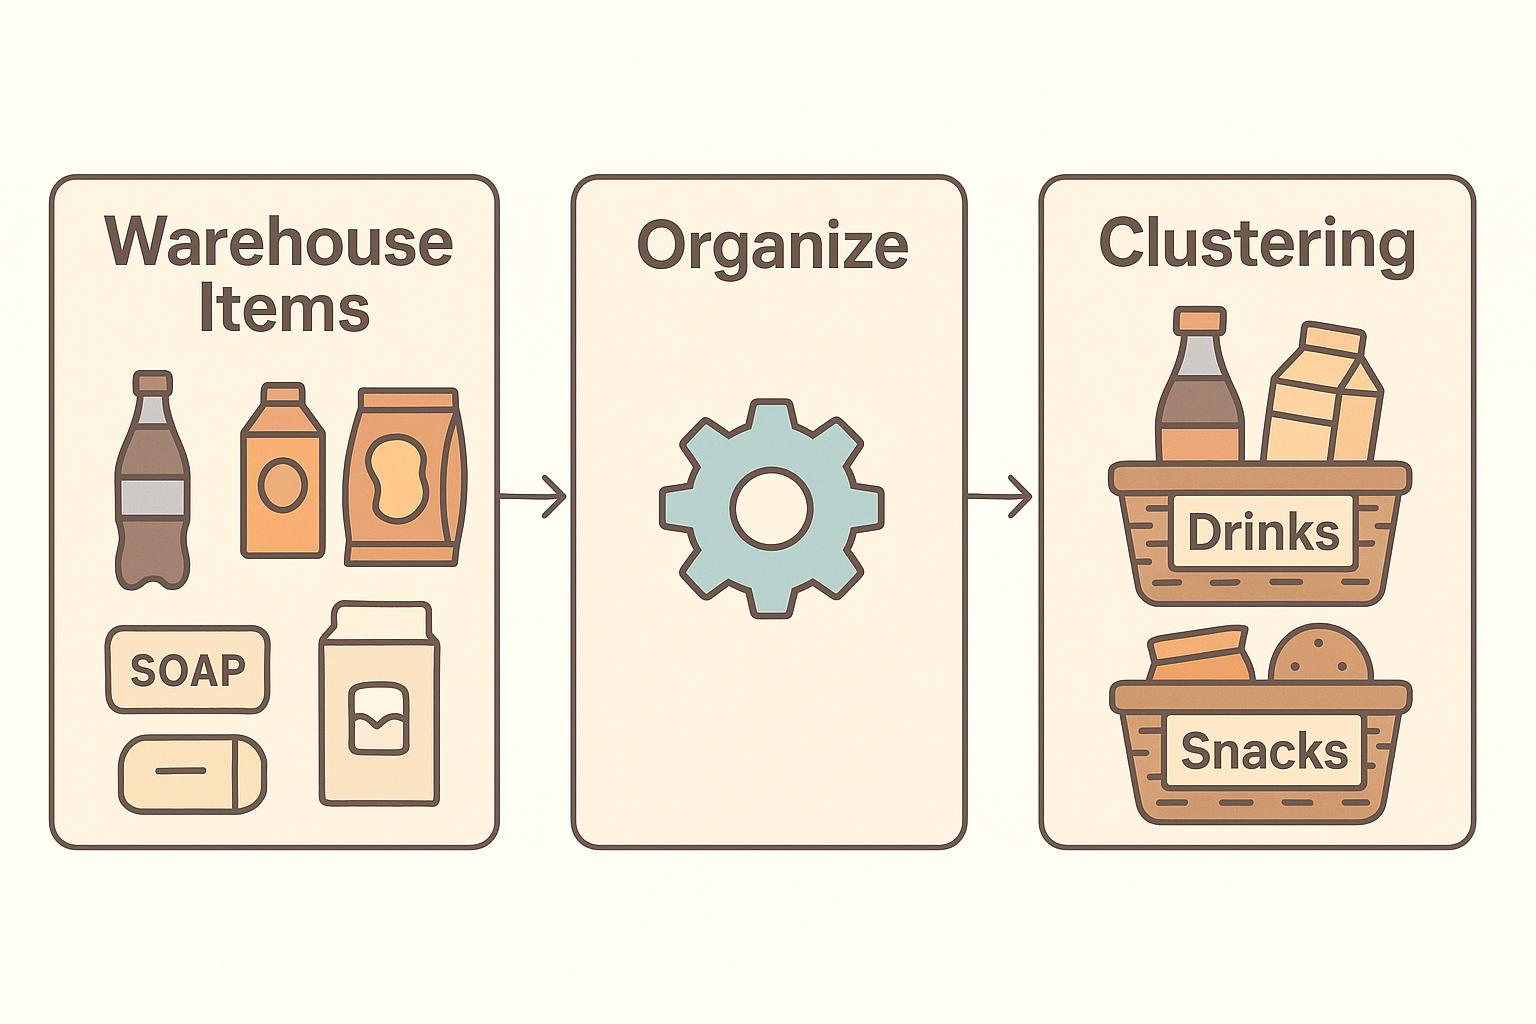
- 聚类(Clustering):聚类的核心是在没有标签的情况下,根据样本之间的相似度(如距离或密度)将数据划分成若干组,使得同一簇内的样本相似度高、不同簇间相似度低。需要注意的是不要把聚类和之前提到的分类混淆了,因为他们似乎形式上有些相似,但是这是两个完全不同的概念,聚类是无标签的,而分类是有标签的。
通俗理解:假设你是一名仓库管理员,此时货架上杂乱堆放着饮料、零食、日用品等所有商品,没有任何的标签。此时你的任务是将货物进行快速整理,那么观察后你会把可乐和果汁放在一起,因为它们都是饮料;类似的把薯片和饼干归到角落,它们都属于膨化食品。这种不依赖预定义标签,纯粹根据物品自身特性(包装/用途/材质)的相似性自动分组的过程,就是聚类的核心思想。
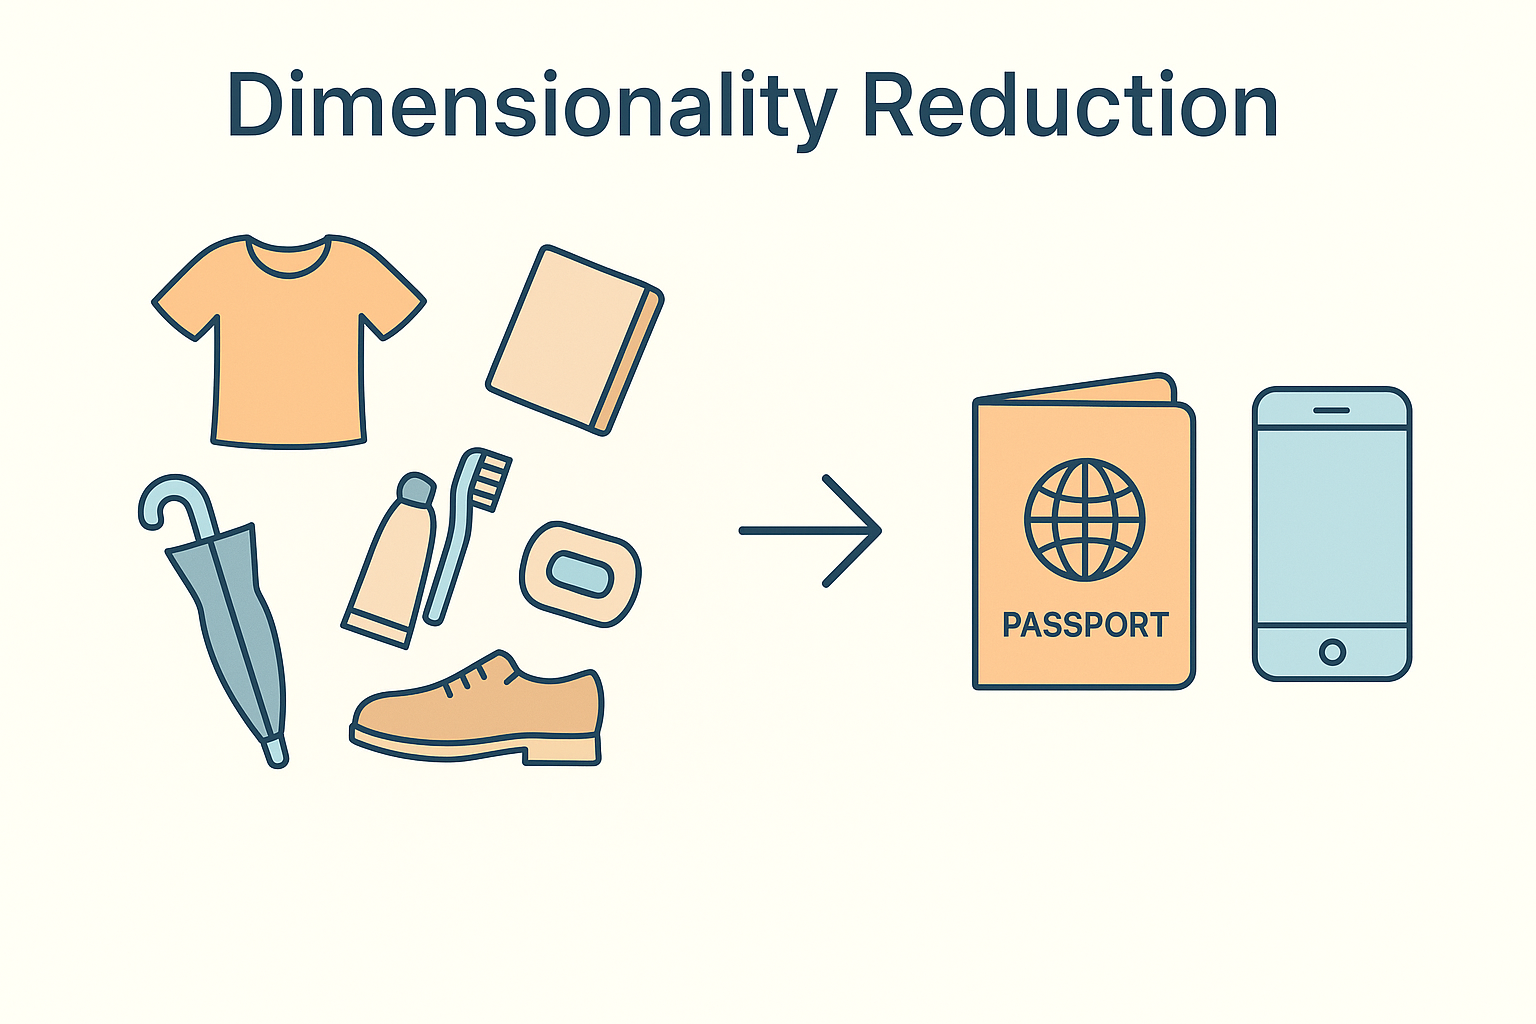
- 降维(Dimensionality Reduction):降维的核心思想是在保留数据主要信息(如方差或局部流形结构)的前提下,将高维数据映射到低维空间的过程。
通俗理解:假如你现在要进行一场为期3天的跨国短途旅行,为了提前准备列出了一张物品清单(每件物品代表一个维度),包括衣服,雨伞,鞋,洗漱物品,书等等,最终你发现物品似乎过多,所以需要去除一些不必要的行李。假设你从一堆物品精简到几个核心物品,使得行李更轻便,旅行体验更顺畅。就像旅行中带护照和手机是必须的,降维确保数据的主要结构被保留。
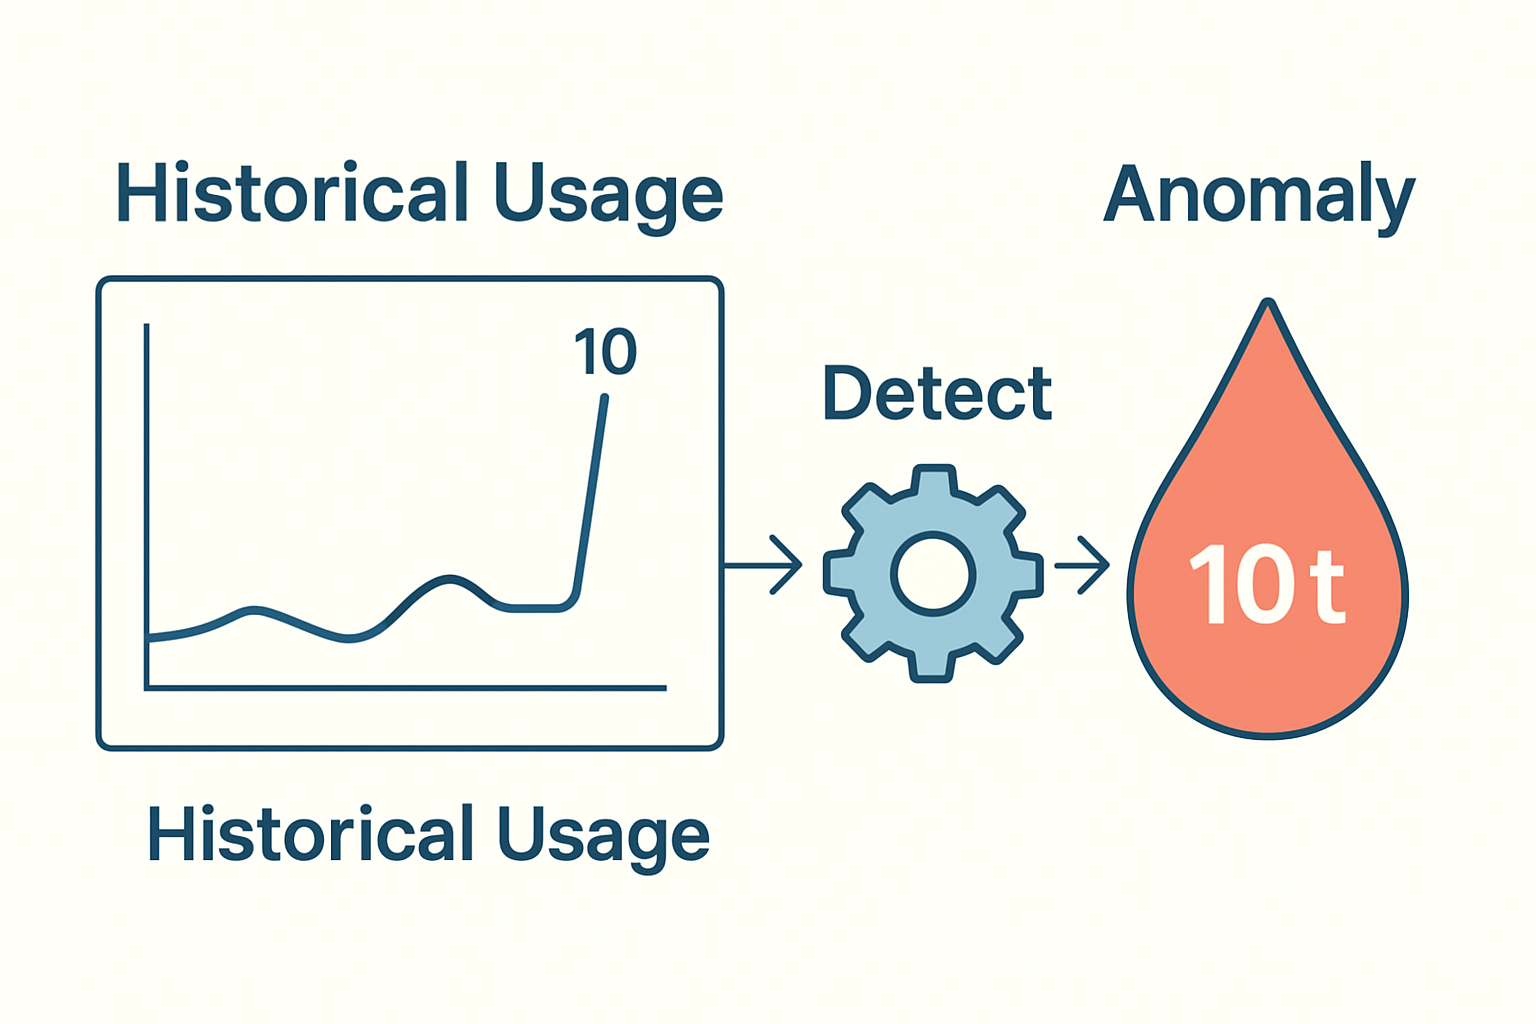
- 异常检测(Anomaly Detection) :异常检测的核心思想是识别偏离整体分布的少数“离群点”或“异常数据”,简单的讲就是"不合群的"。
通俗理解:假如你是水力资源管理的人员,负责监测某区域的用水情况。正常情况下每日用水是相对稳定的,如2吨/每天,后来某天突然用水变成了10吨,此时就可能出现了异常情况,如漏水等等。其本质就是通过建立历史行为基线,识别显著偏离常规模式的异常事件,也就是异常检测。
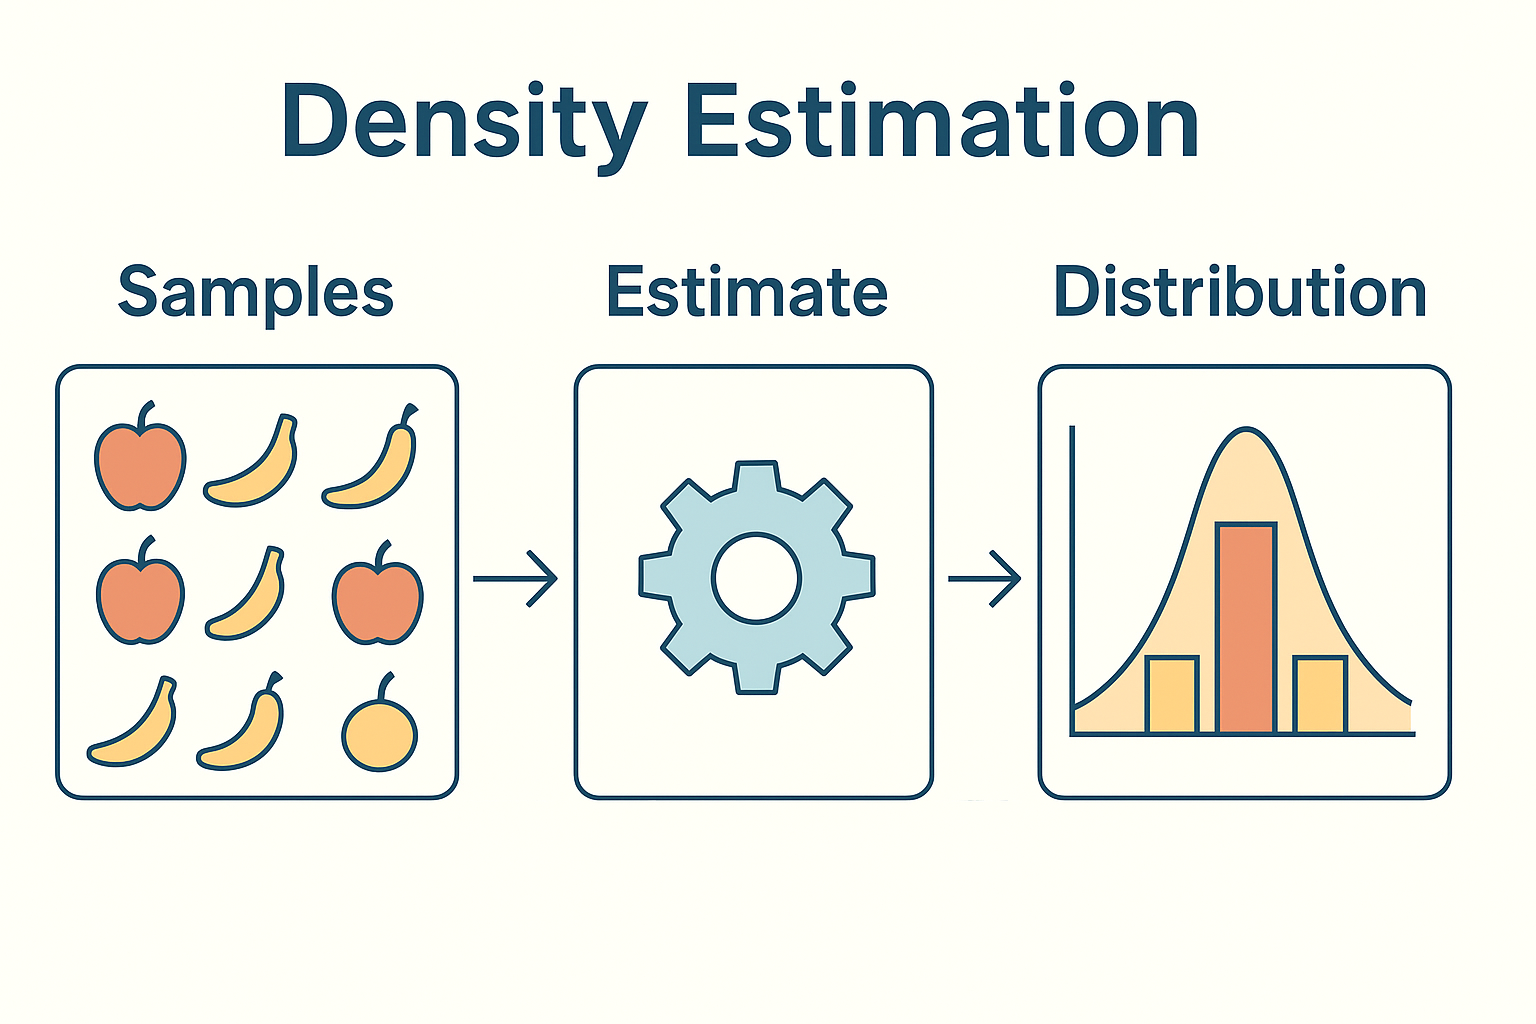
- 密度估计(Density Estimation):密度估计的核心思想是通过观测数据,推断出数据背后的概率分布(即数据在特征空间中的“密度”分布)。简单来说,它试图回答一个问题:“给定这些数据点,它们最可能是从什么样的概率分布中生成的?”
通俗理解:假如你是一位超市经理,想要了解顾客购买水果的偏好分布。你无法记录每位顾客的购买详情,但可以通过抽样观察来推断整体趋势。本质就是通过有限样本推断整体分布,也就是密度估计。
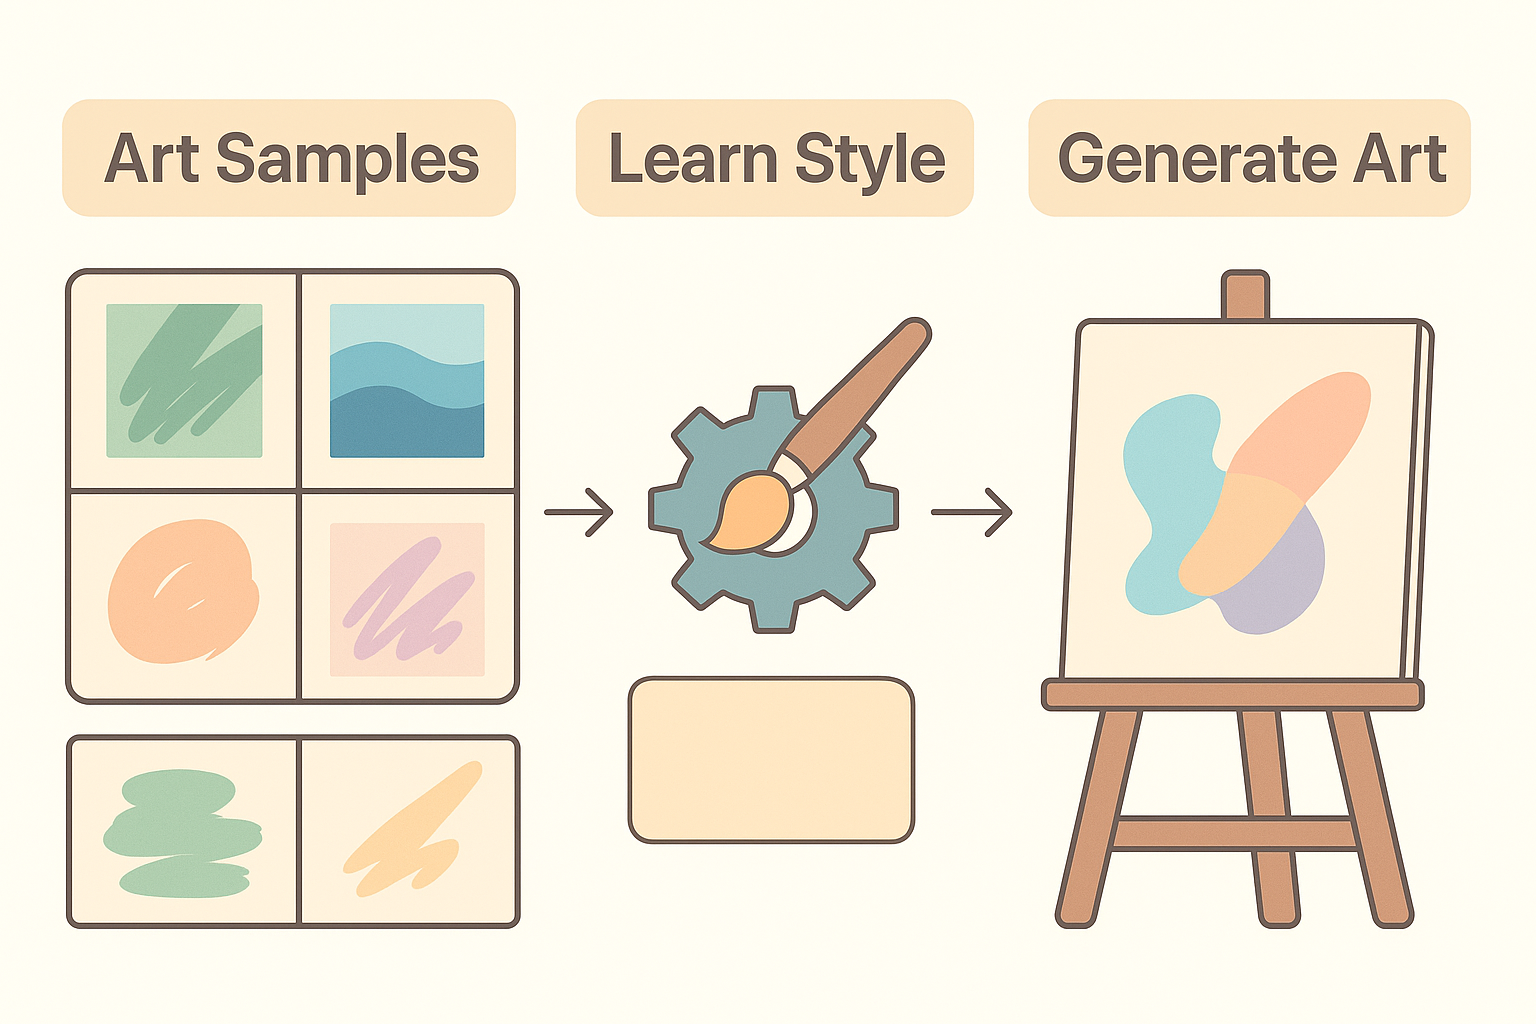
- 生成建模(Generative Modeling):生成建模的核心思想是一种从数据中学习概率分布,并利用该分布生成新样本。简单来说,就是理解数据的底层分布,学会创造类似的新数据。
通俗理解:假如你是一位美术老师,教学生如何绘画。学生通过观察许多样本来学习每种画的绘画风格、涂层深浅和整体构图等。一旦学生掌握了这些规律,他们就能自己创作出全新的绘画作品。本质就是理解底层逻辑,学会创新作品,也就是生成模型。
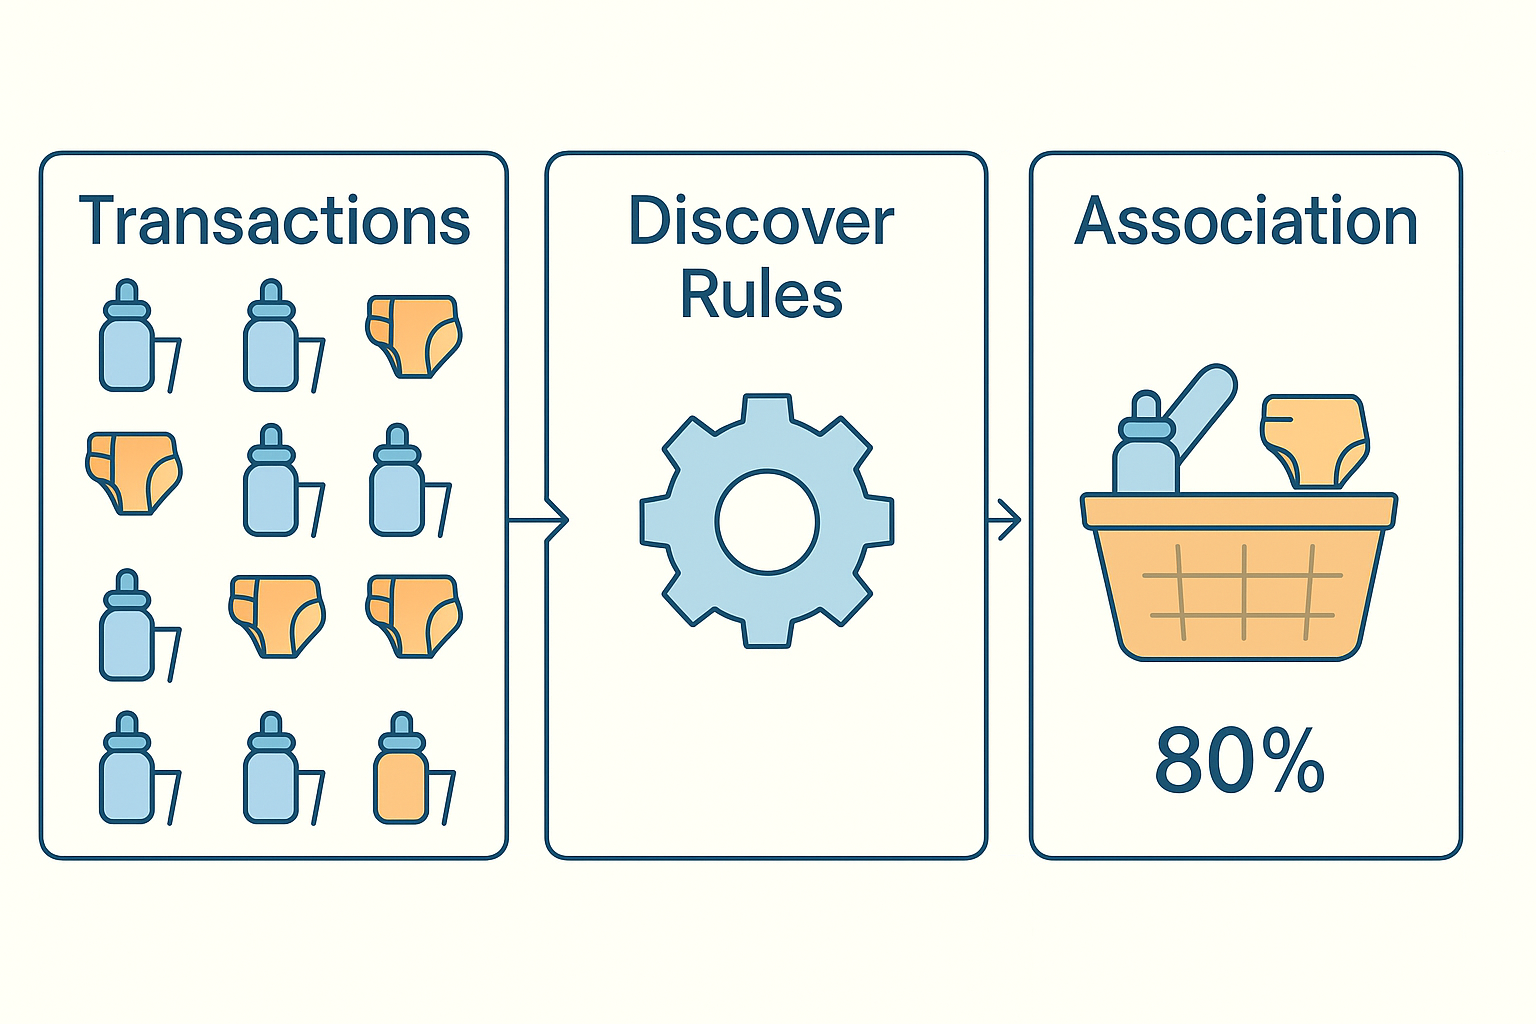
- 关联规则学习(Association Rule Learning):关联规则学习的核心思想是一种从大规模数据中发现频繁共现模式。简单来说,就是如果A发生,那么B也可能同时发生。
通俗理解:假如你现在是超市经理,你发现在购买婴儿用品的用户中,买奶粉和尿布的各占50%,但是同时购买奶粉和尿布的占了80%,所以它们之间存在一定的关联,把奶粉和尿布放同一区域才是合理的。本质就是从数据中自动发现"共生规律",也就是关联规则学习。
1.2.3 经典无监督学习算法
无监督学习的算法同样有很多,但是大部分属于之前所提到的大类里面,并没有如监督学习一样进一步的细分,下面将介绍几种经典的无监督学习算法。
1.聚类类
- K-Means聚类:K-Means是一种基于"质心"思想的模型。其通过假设每个簇可由一个中心点代表,将每个样本分配给最近的质心,然后更新质心位置(质心为簇内所有样本均值),最终使得每个样本到其簇中心的距离平方和最小。
- 层次聚类(Hierarchical Clustering):层次聚类是一种基于距离矩阵的模型,所以其无需预设簇数。主要分为两种思路,一种为凝聚型(自底向上),表现为每个样本单独为一簇,反复合并最近的两个簇,构成树状分层结构;另一种为分裂型(自顶向下),表现为整体为一簇,递归分裂为更小簇。
- DBSCAN(Density-Based Spatial Clustering of Applications with Noise):DBSCAN是一种基于密度可达性的模型,其通过设置半径 ε 和最小点数 minPts,把“在 ε 半径内有至少 minPts 点”的区域定义为高密度区,将其扩展连通为簇。无法归入任一簇的点即为噪声点。
- 高斯混合模型聚类(GMM Clustering):高斯混合模型模型聚类是一种基于概率的模型。其通过假设数据由若干高斯分布加权混合而成。用 EM 算法反复估计各高斯分布参数和样本属于各分布的概率。
2.降维类
- 主成分分析(PCA):主成分分析是一种基于线性代数的模型,其通过特征值分解协方差矩阵,找到最大方差的正交方向(主成分),以此压缩数据维度。
- t-SNE(t-Distributed Stochastic Neighbor Embedding):t-SNE是一种基于概率分布的模型,其通过使高维空间中邻近点在低维空间中也保持邻近,通过 KL 散度度量相似性差异。
- UMAP(Uniform Manifold Approximation and Projection):UMAP是一种基于拓扑流形和图论的模型,通过构建高维数据的邻域图,优化其在低维空间的嵌入以保留邻域结构。
- 自编码器(Autoencoder):自编码器是一种基于神经网络的模型,通过用编码器压缩输入到瓶颈层(低维表示),再由解码器还原原始输入,通过最小化重建误差学习。
3.密度估计类
- 核密度估计(KDE):核密度估计是一种基于核方法的模型,通过在每个样本点叠加核函数,平滑地估算概率密度函数,其结果是所有核的加权和。
4.异常检测类
- One-Class SVM:One-Class SVM是一种基于支持向量机的模型,通过学习包围大部分数据的高维超平面,将偏离这一“包裹”的样本判为异常。
- 孤立森林(Isolation Forest):孤立森林是一种基于树结构的模型。通过随机选特征随机切分,异常点更易在少数次分割后被“孤立”,以平均路径长度判定异常程度。
5.关联规则学习类
- Apriori:Apriori是一种基于先验性质的模型。通过频繁项集的逐层扩展和剪枝,从最小项集开始扩展到更大项集,最终生成规则。
- FP-Growth:FP-Growth是一种基于压缩数据结构(FP树)的模型。通过构建FP树压缩数据,发现所有频繁项集并挖掘关联性。
6.生成建模类
- 生成对抗网络(GAN):生成对抗网络是一种基于对抗学习思想的模型,通过生成器和判别器博弈,逼近真实数据分布以生成"假"样本。
- 变分自编码器(VAE):变分自编码器是一种基于概率图和神经网络的模型。通过用编码器输出分布参数,采样潜变量后由解码器生成新样本,最大化数据边际似然的下界(ELBO)。
- 扩散模型(Diffusion Models):扩散模型是一种基于概率生成的模型。其通过把数据逐步加噪变成纯噪声(正向过程),然后训练一个神经网络模型学会“逆过程”(反向过程),其中反向去噪步骤等价于从高斯噪声中“生”出高质量新数据。
1.2.4 无监督学习的应用领域
无监督学习在许多实际领域有广泛应用,尤其是在没有标签数据或需要数据探索的场景。
1.医学、生物信息学领域
- 基因数据降维与可视化:通过降维将高维基因表达数据投影到低维,帮助医生和生物学家直观区分不同疾病亚型。
- 疾病分型:通过聚类将患者按照症状、检测指标、病理数据自动分群,如肿瘤亚型分群、心脏病风险分层。
- 医学影像分割与聚类:通过聚类/自编码器将CT、MRI影像中的结构自动分组、去噪或压缩。
- 药物发现与分子生成:通过生成式模型生成新分子结构或发现药物候选分子。
2.金融领域
- 客户分群:通过聚类由客户自身消费/理财/信用把客户自动分为不同群体。
- 异常检测:通过异常检测自动识别信用卡欺诈、异常交易、反洗钱等场景中的可疑行为。
3.零售、电商与市场营销领域
- 用户消费行为分群:通过聚类将用户按购买行为自动分群,为个性化营销、会员分层、冷启动推荐提供基础。
- 商品关联规则挖掘:通过关联规则学习发现商品间的关联性,提高营收。
4.工业领域
- 设备异常检测与预测性维护:通过异常检测自动预警设备出现非正常运行或即将故障。
5.图像领域
- 图像自动分组:通过聚类将相册或社交应用里自动归并同一人脸或相似物体。
- 图片去噪压缩:通过自编码器将图片、音频的无损压缩与自动降噪。
- 图像生成:通过扩散模型或对抗网络生成生成新图片、艺术画作、视频帧等。
6.文本与自然语言处理领域(NLP)
- 文本归档:通过聚类自动分出不同话题的新闻/学术论文/网页。
- 关键词提取:通过降维方式了解文本数据的主流趋势、热点话题。
- 词嵌入:通过自编码器、Word2Vec等学习无标签语料的语义表征,用于后续检索/推荐。
1.3 强化学习(Reinforcement Learning, RL)
1.3.1 强化学习的定义
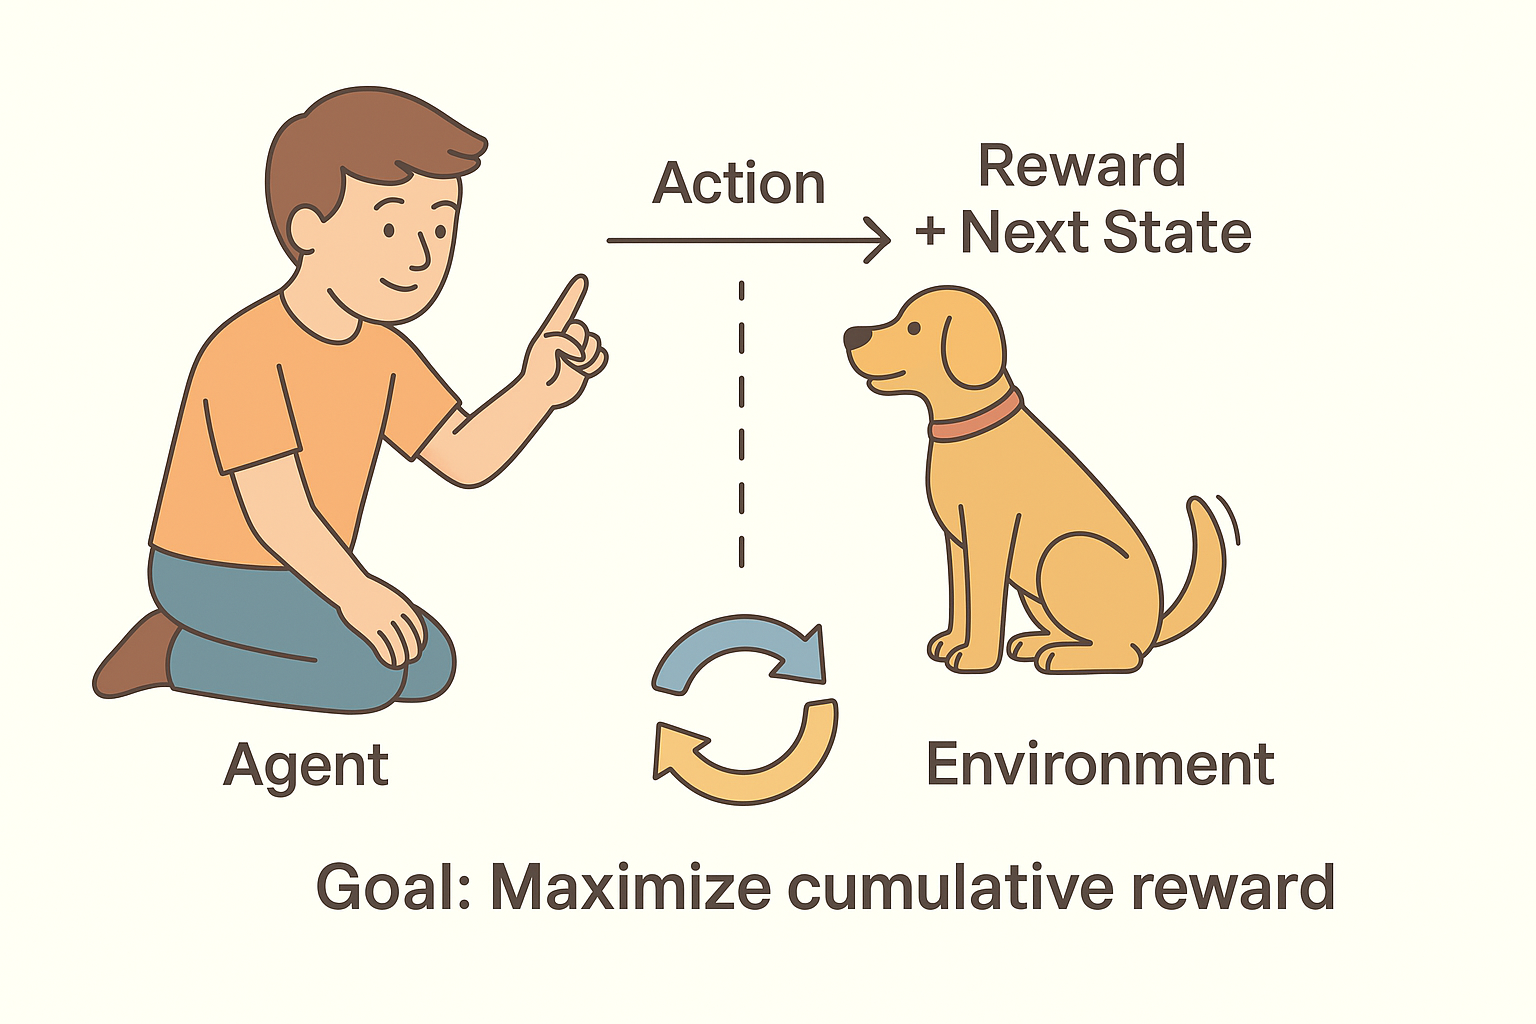
强化学习(Reinforcement Learning,RL)其核心思想是让智能体(Agent)通过与环境的交互学习最优策略,以最大化长期累积奖励。核心要素包括智能体与环境,策略,奖励信号,价值函数,探索与利用,而建模通常为马尔可夫决策过程(MDP)。
通俗理解:假设我们是一位宠物训练师,工作是训练一只宠物完成特定的任务。整个过程可以描述为:宠物根据当前环境状态(如手势)选择动作(如坐下),行动后环境状态改变,并获得奖励信号(如零食为正奖励,训斥为负奖励)。通过反复试错,宠物学习最大化长期累积奖励(如连续正确动作后获得更多零食),逐步掌握最佳行为的策略。这就是强化学习的本质,即在环境规则下,通过交互优化长期收益,获得最大化的期望回报。
1.3.2 强化学习的类别
强化学习有许多的类别,单独查看某一类别是不合理的,所以博主认为还是需要由面到点来了解,这与前文直接给出具体类别不尽相同。
1.按学习策略划分
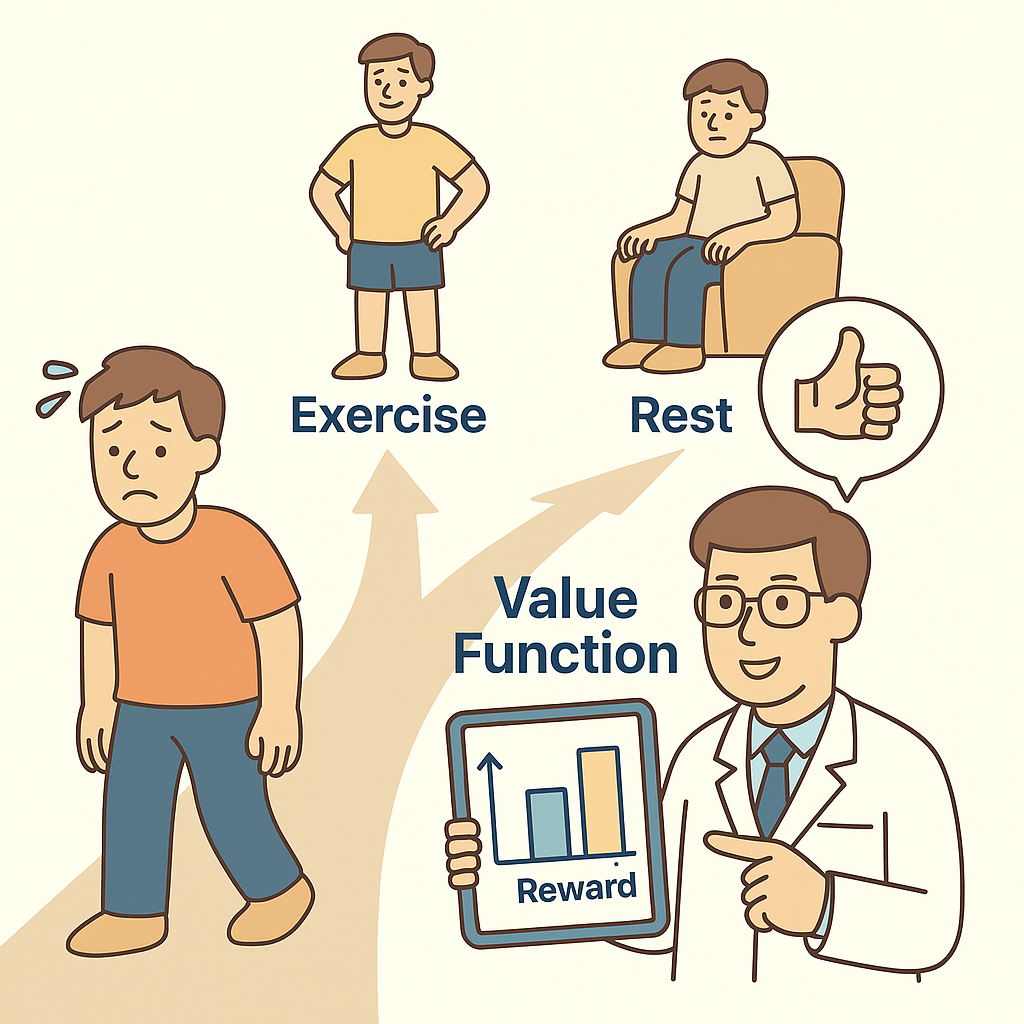
- 值函数方法(Value-based Methods):值函数方法的核心思想是通过学习状态的价值,间接引导智能体选择最优行为策略。简单的说就是智能体通过反复估算和更新各行为可能获得的“长期回报”,进而选出最优动作。
通俗理解:假设你现在要锻炼身体,目标是长期保持身体健康,而不是只追求短期的舒适。值函数方法在这充当一个“健康顾问”的角色,其作用是评估从当前状态开始,选择不同动作的长期好处。比如,在疲惫的状态A下,选择锻炼可能短期累人,但值函数会预测,如果坚持锻炼,未来几个月会更健康、精力更足;而选择休息,短期舒服但可能失去锻炼意义。
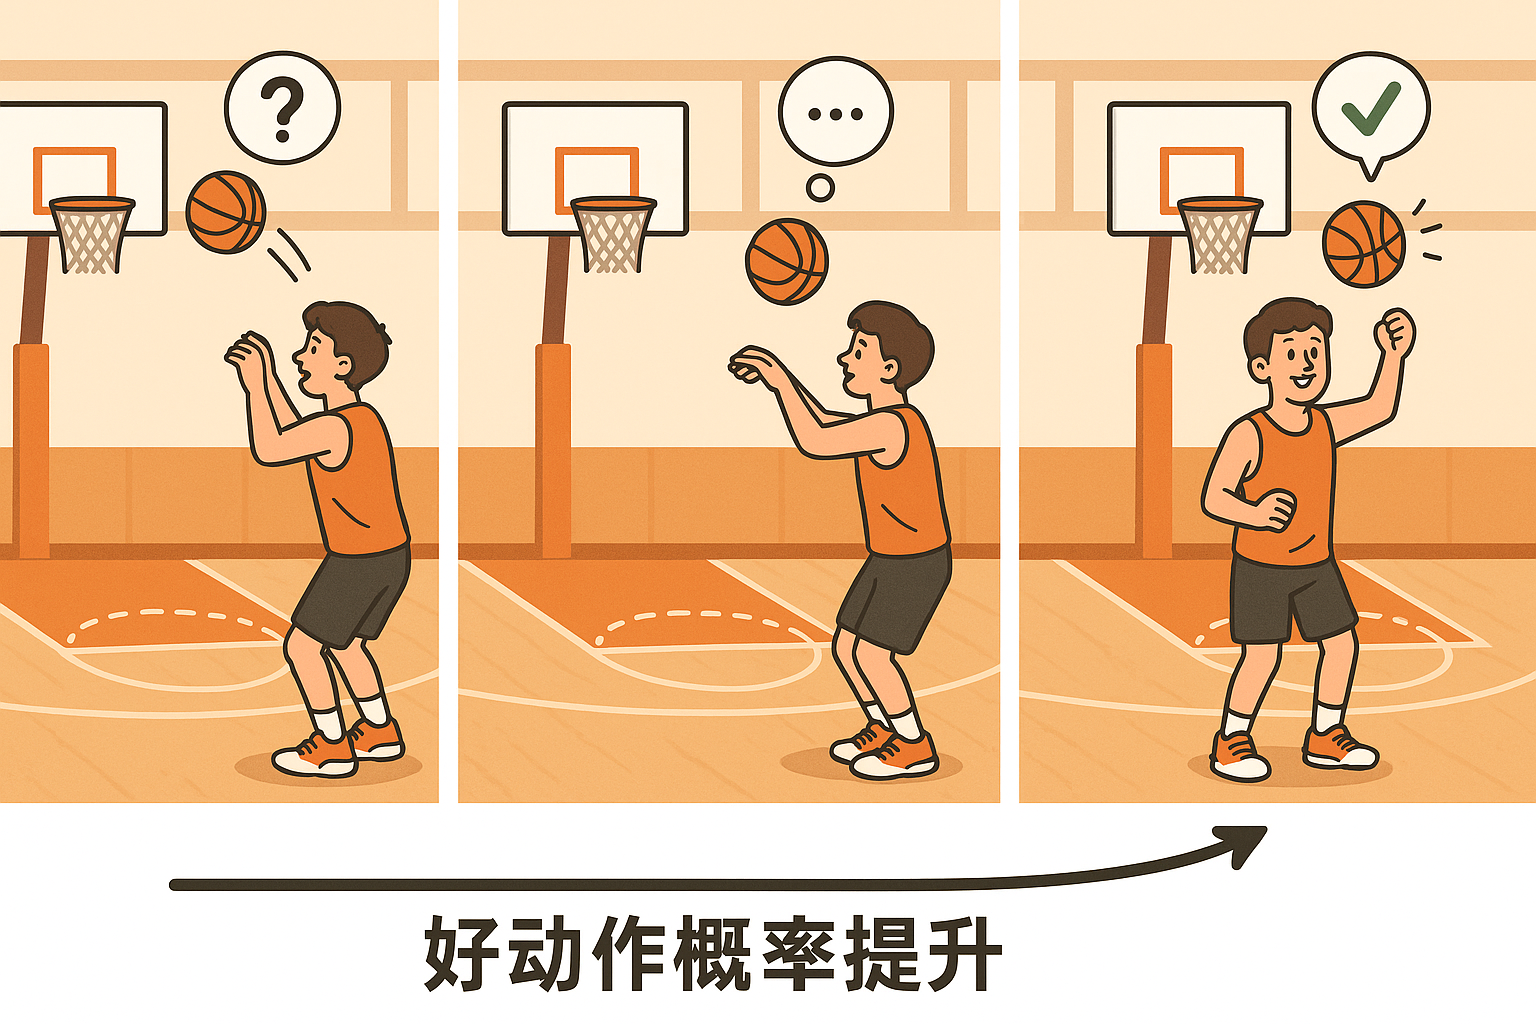
- 策略梯度方法(Policy-based Methods):策略梯度方法的核心思想是直接对策略函数建模和优化,使期望回报最大。简单的说就是智能体不评估价值函数,而是直接优化“做什么动作的概率分布”,以期获得更高奖励。
通俗理解:假设你现在开始练习罚球线投篮,目的是提高准确度。那么每次投篮时,你需要决定用多大的力气、什么角度投出(动作)。如果球进了篮筐,会获得成就感(奖励);如果没进,需要重投(惩罚)。通过反复尝试,你逐渐学会如何调整投篮方式,提高进球率。这个过程就类似于策略梯度方法的本质直接优化概率策略,使“好动作”概率越来越高。
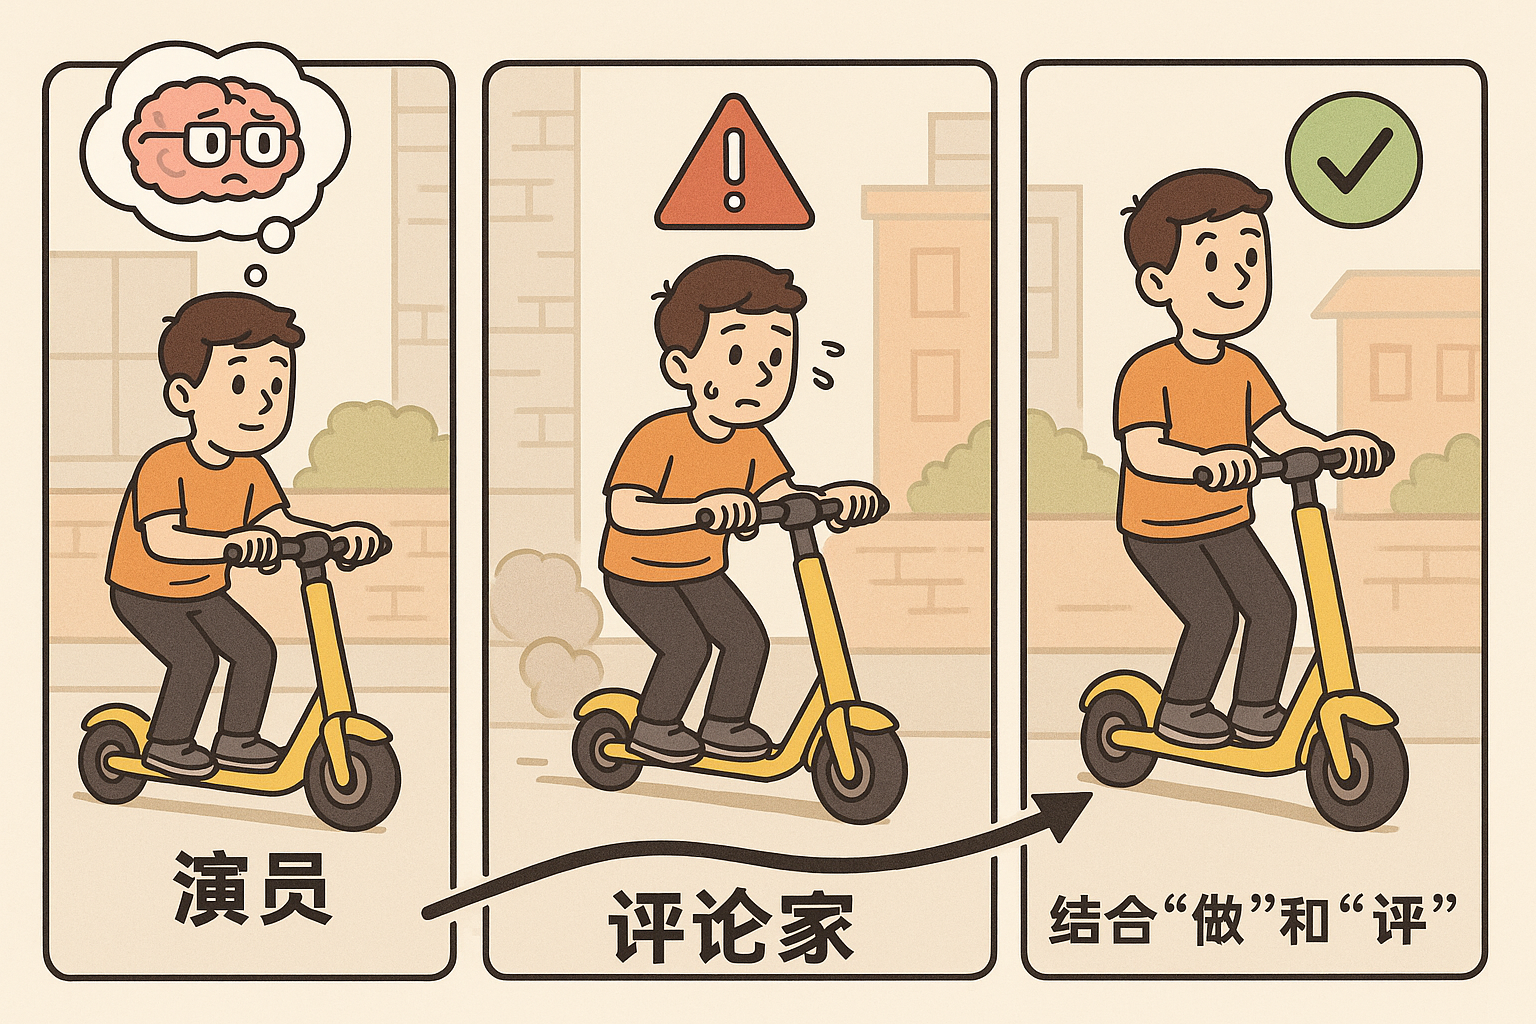
- 演员-评论家方法(Actor-Critic Methods):演员评论家方法的核心思想是结合值函数方法和策略方法,分别用“演员”生成动作(策略),用“评论家”评价当前策略的好坏,双向优化。简单的说就是智能体一边学习怎么“行动”,一边自我“评价”,两者配合提升决策能力。
通俗理解:假设你正在学习骑电瓶车,目标是在平稳且不摔倒的情况下安全到达目的地。你自己(也可以说你的身体)就像“演员”,负责每次的决策和实际操作(比如左转、加速、减速等);而你的“大脑意识”就像“评论家”,会基于你过去的经验(比如骑自行车)对每一次动作进行评价,比如太快了会提示你“容易摔倒”,如果操作得好大脑会给你愉快的感觉(奖励),如果差点摔倒则会让你产生紧张甚至后悔(惩罚)。
通过反复练习,你的“演员”根据“评论家”的反馈不断调整和优化动作,最终学会了如何安全、平稳地骑电瓶车。这就是“演员-评论家方法”的本质,结合“执行”和“评价”,帮助智能体在不确定的环境中不断优化自身行为。
2.按环境类型划分
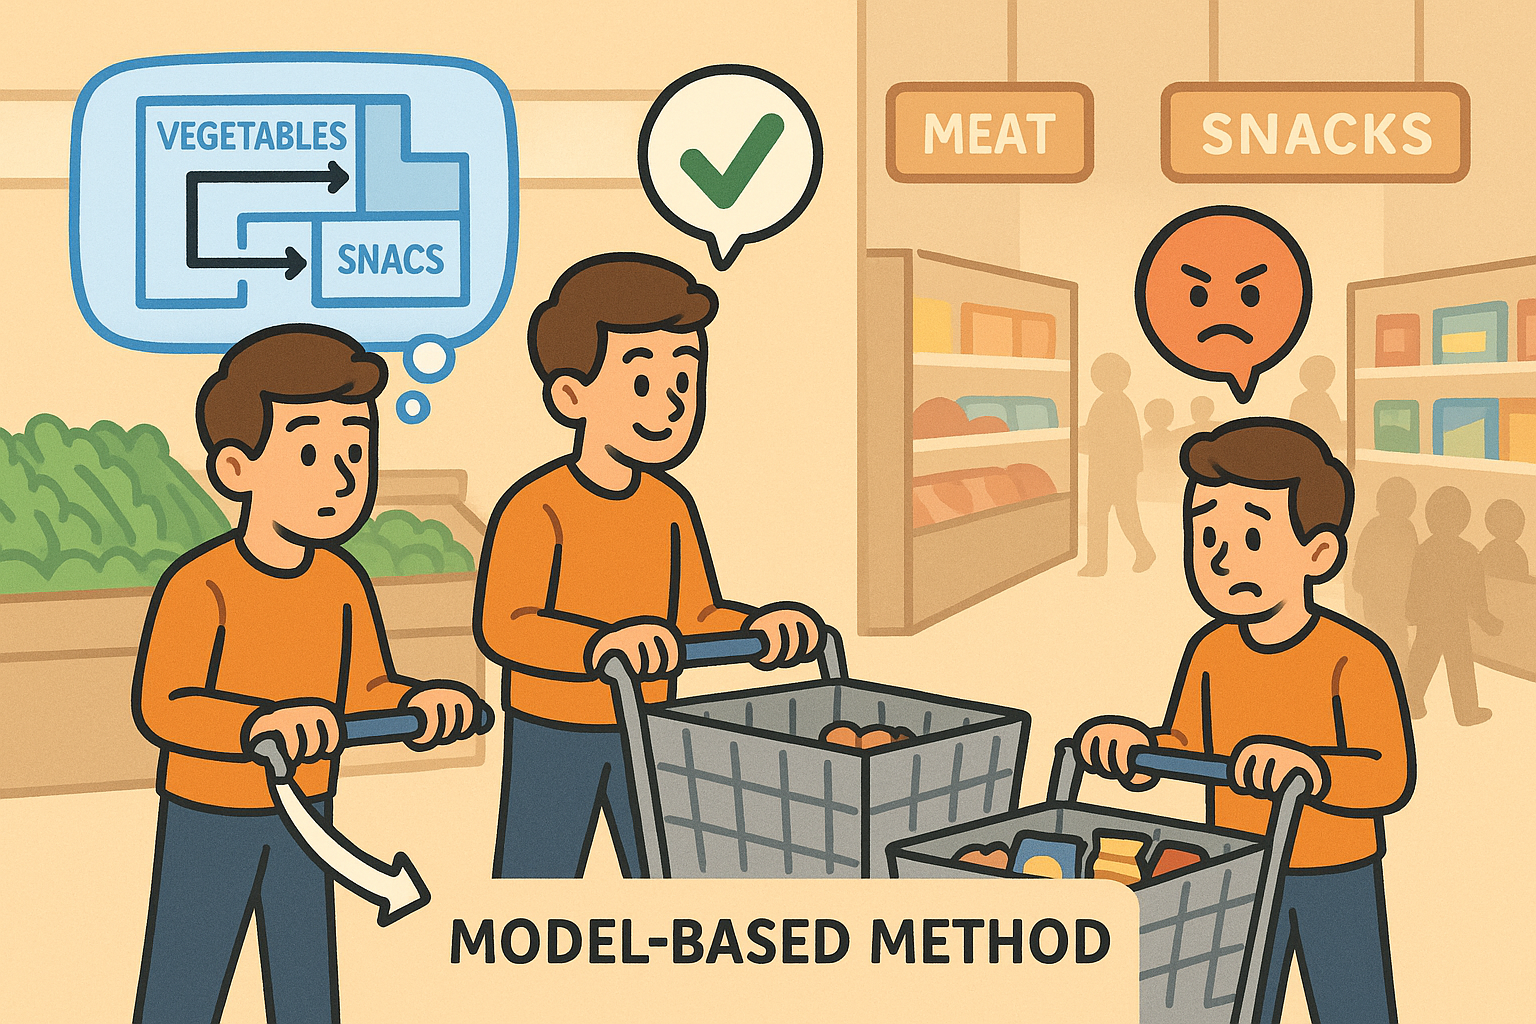
- 基于模型的方法(Model-based RL):基于模型的方法其核心思想是学习环境的模型,利用模型进行规划,优化行为策略。简单的说就是智能体""脑补"环境的规律和反应,借助自建模型规划和提升自身表现。
通俗理解:假设你(智能体)现在去一个很大的超市(环境)购物,你的目标是尽可能节约时间。刚开始你对超市并不熟悉,但通过几次购物后,你在心里逐渐形成了一张“超市蓝图”(模型),比如哪些区域在哪里、哪些通道人多、怎样走更快。
每次购物前,你会在脑海里根据“蓝图”规划路线(比如先去蔬菜区,再去肉区,最后去零食区),实际行动后,你会根据节约的时间获得“奖励”,如果某条路线人多、耽误了时间,就相当于获得了“惩罚”。
随着购物次数增多,你不断根据实际体验调整和完善自己的“蓝图”,甚至会提前在脑中“模拟”不同路线,选择最省时的那条。这就是基于模型的方法本质,先根据经验建立环境模型(蓝图),利用模型进行模拟和规划,再实际执行,并根据结果不断优化模型,实现目标。
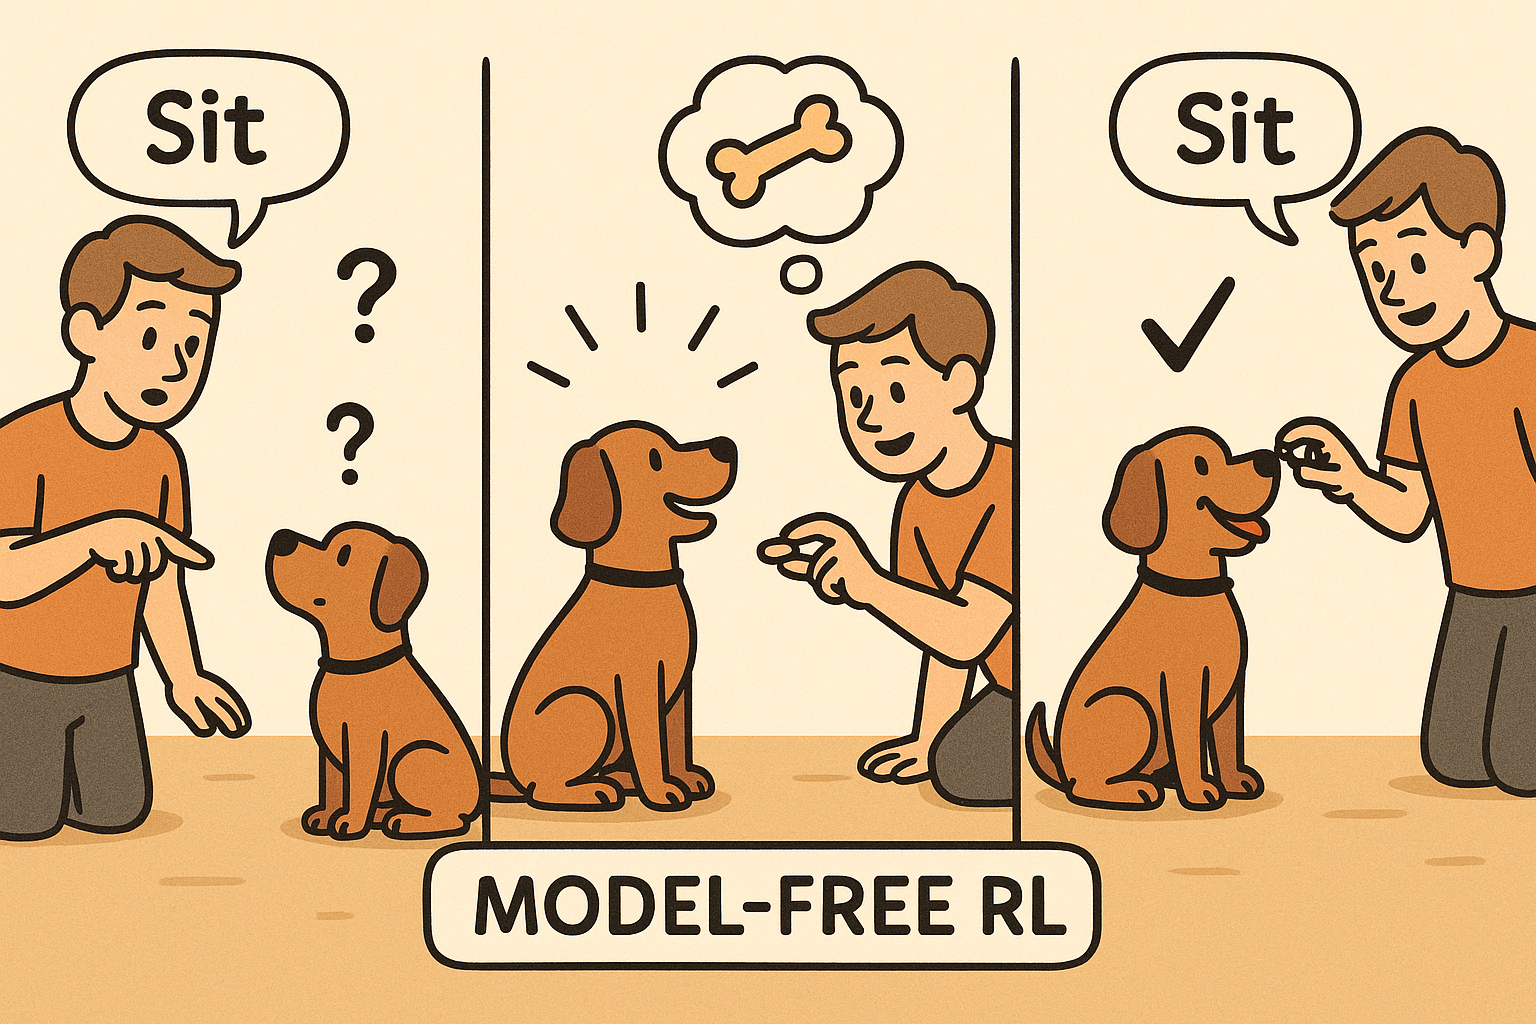
- 无模型的方法(Model-free RL):无模型的方法其核心思想是不显式建模环境,只依赖经验和采样数据来学习价值函数或策略。简单的说就是智能体只靠不断试错和经验总结,直接学会“怎么做才最优”。
通俗理解:假设你是一位驯兽师,想教宠物学会“坐下”。第一天你说“坐下”,宠物其实并不明白你的意思,只是尝试了各种动作,碰巧做对了动作坐下了,于是你奖励它零食。宠物发现“原来这样做有好处”。第二天你再说“坐下”,宠物记得昨天坐下得到奖励,于是再次选择坐下。如果宠物做错动作,你不理睬它(惩罚),它就慢慢明白“只有坐下才有奖励,其他动作没有用”。
在整个过程中,宠物其实并不需要理解“坐下”这个词或你的意图,也不会推测你希望它做什么,只是通过不断尝试、观察奖励与惩罚,逐步学会了在听到“坐下”时做出正确动作。这就是无模型方法的本质,智能体无需建立环境的规则或模型,仅靠经验、奖励和惩罚,直接优化自己的行为策略。
3.按动作空间划分
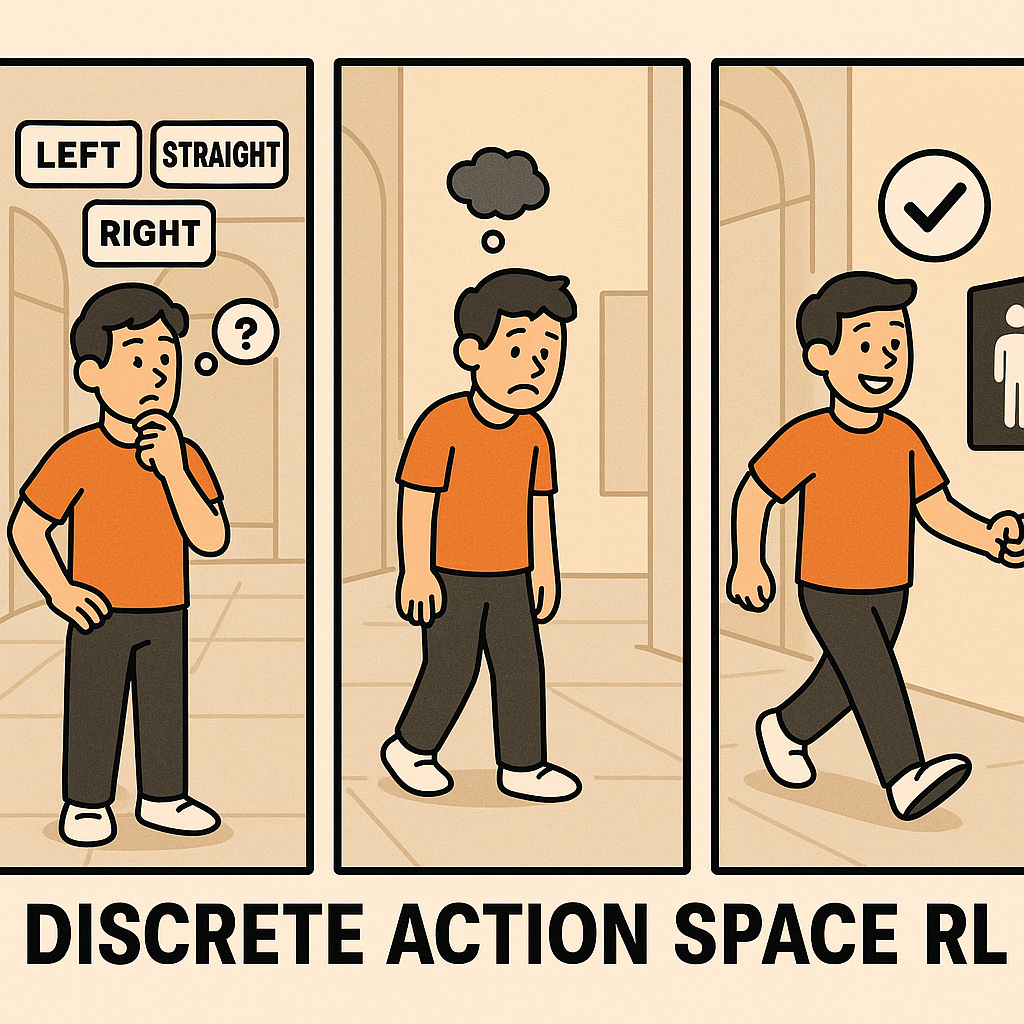
- 离散动作空间强化学习:离散动作空间强化学习的核心思想是在有限动作集合的前提下,策略与价值函数针对有限集合进行建模。简单的说就是智能体只需在有限动作里选最优,探索空间小,最易于实现的动作。
通俗理解:假设你第一次来到一个陌生的商场,目标是尽快找到洗手间。你对路线一无所知,所以每到一个路口,你只能在“左转”“右转”或“直走”这几个固定选项中做出选择——这就是离散动作空间,每一步只能选择有限的动作。如果最终没有找到洗手间,你会感到失望(惩罚);反之,成功找到则会很开心(奖励)。
当你以后再来这个商场时,你会根据上一次的经验,快速选择正确的路线,节省时间。这就像做选择题一样,在有限选项中不断尝试、积累经验,最终学会最快到达目标。所以离散动作空间强化学习的本质,就是智能体在有限的动作集合中,通过不断试错与学习,优化自己的决策路径。
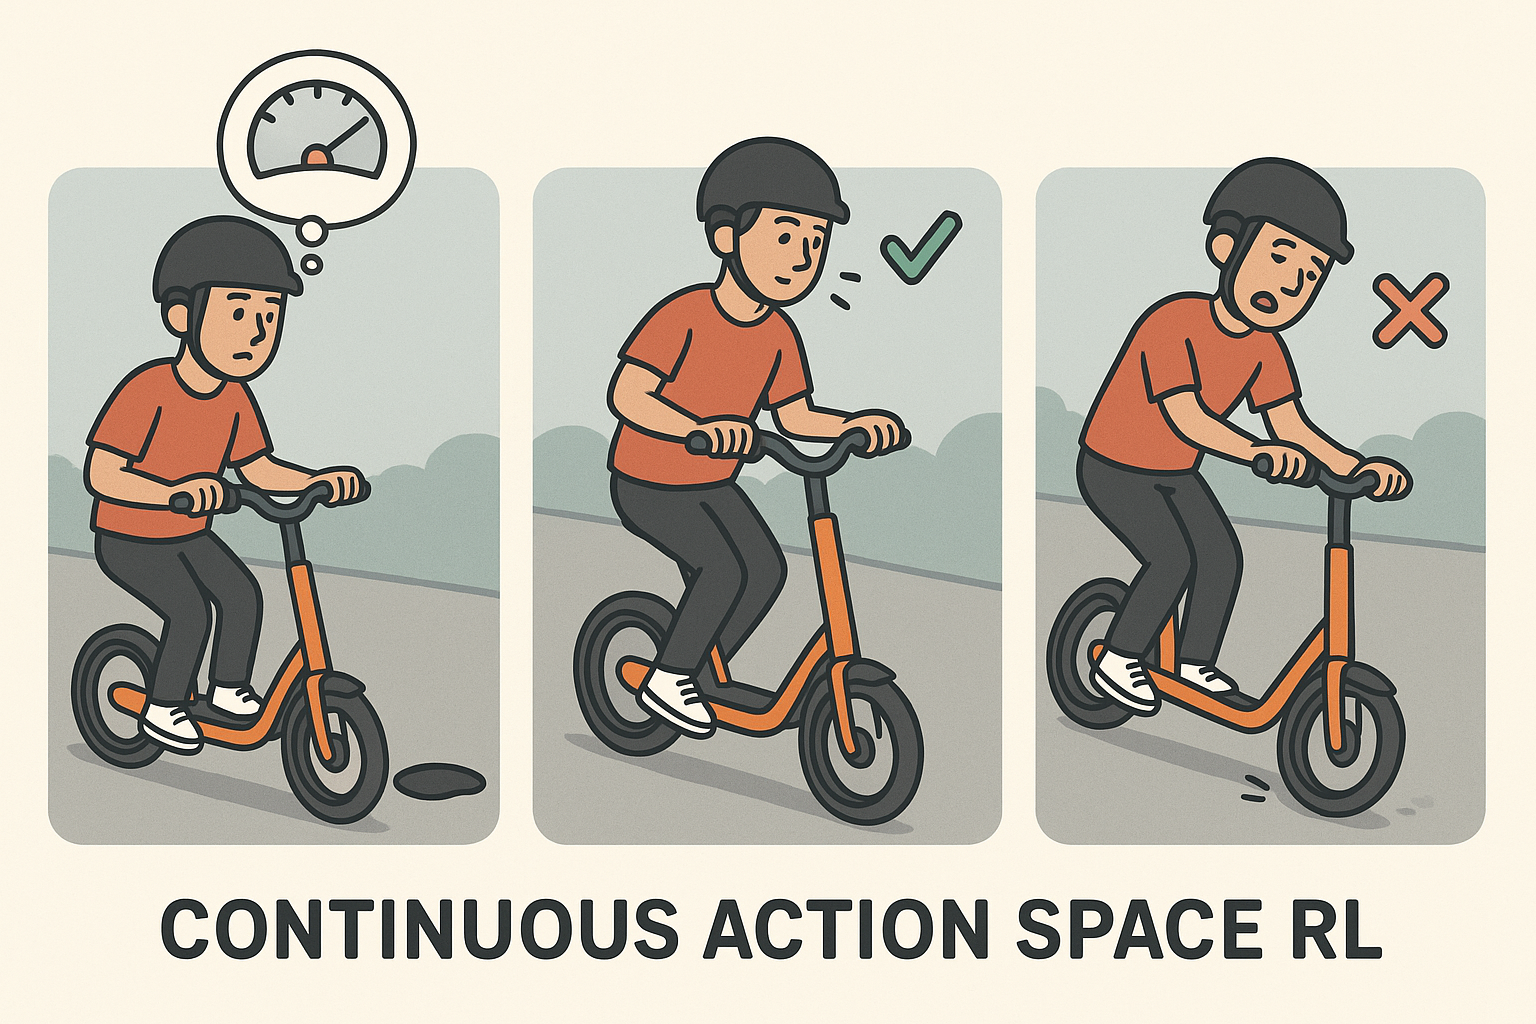
- 连续动作空间强化学习:连续动作空间强化学习的核心思想是动作可以为实数连续值,策略和学习方法需对连续空间进行优化。简单的讲就是智能体面对无穷多可能动作,需要更复杂的策略表达与优化手段。
通俗理解:我们仍然假设你(智能体)在学习骑电瓶车,某次前方突然出现一个小坑(环境变化),这时你需要灵活地调整车把的偏转角度,并适当减速,这些决策并不是简单的“左/右/不动”,而是在一个连续的范围内选择最合适的角度和速度(连续动作空间)。
如果你调整得好,就能顺利避开小坑,保持平衡(奖励);如果调整不当,可能会摔倒(惩罚)。通过不断尝试和优化,每次都对偏转角度和减速度量进行微调,最终你可以非常灵活地应对各种突发情况。这就是连续动作空间强化学习的本质,在无限多的动作选择(如角度、速度等连续变量)中,通过不断优化,实现最优策略。
4.桉数据交互方式划分
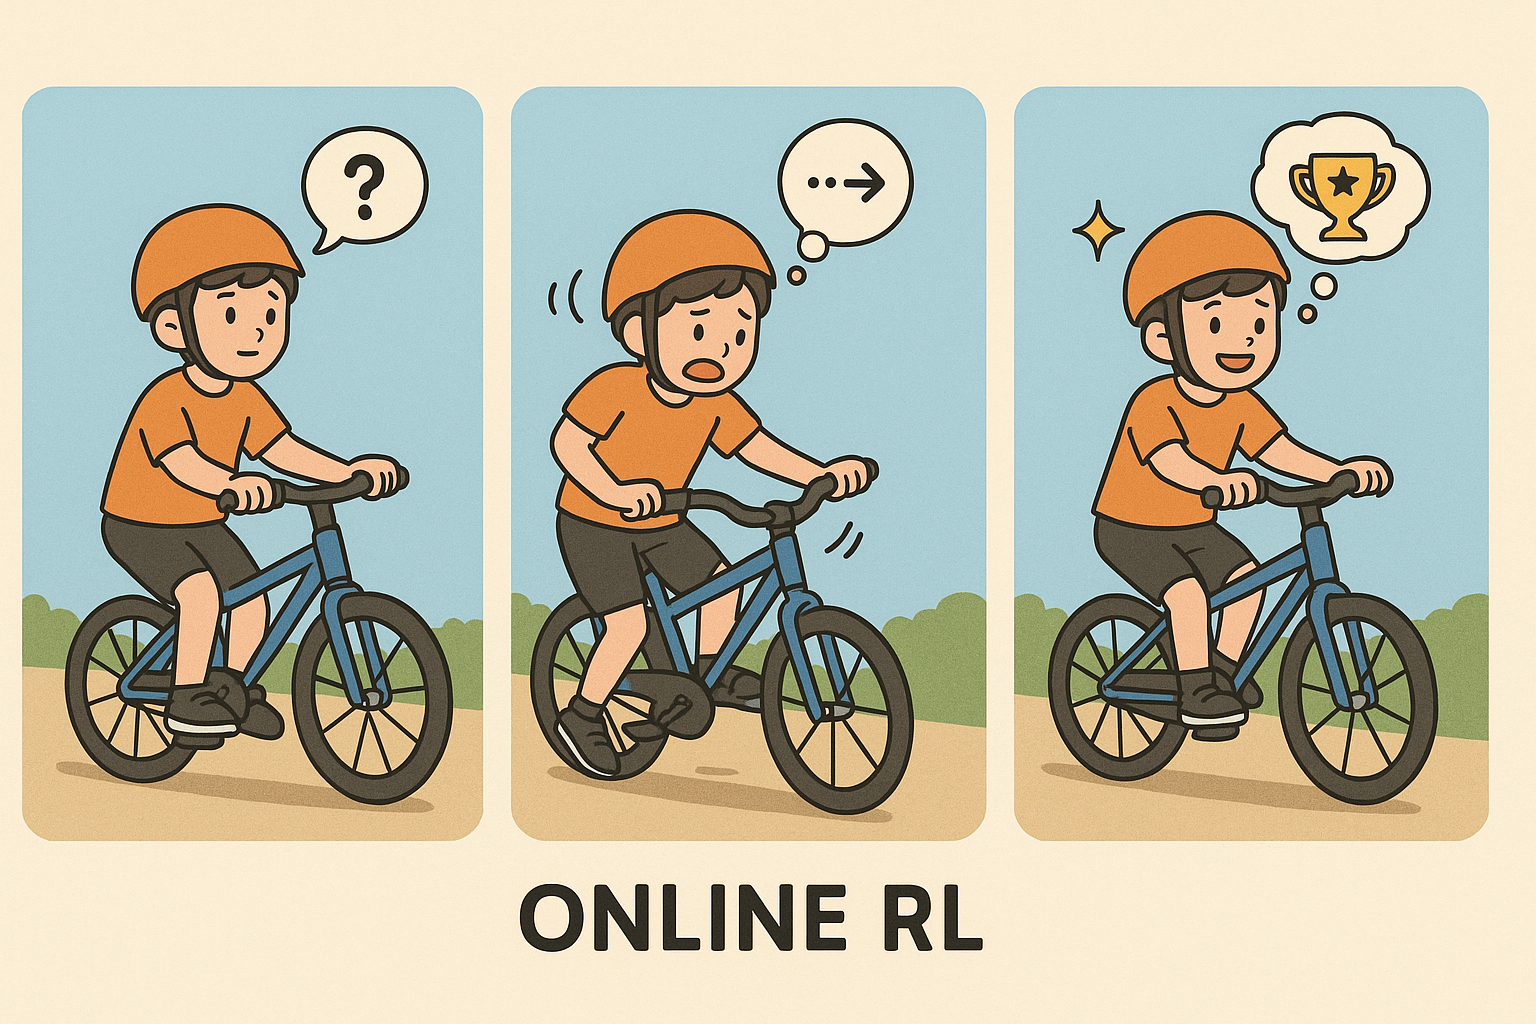
- 在线强化学习(Online RL):在线强化学习其核心思想是智能体边交互边学习,策略随经验持续更新,实时适应环境变化。简单的讲就是智能体“边做边学”,即时调整提升策略。
通俗理解:假设你第一次学骑自行车,目标是不摔倒、能顺利前进和拐弯。你没有提前阅读什么《骑车全解》,而是直接上车“实操”——这就是在线学习。
当你骑得很稳时,会觉得“成功了”(奖励);快要摔倒时会本能地伸脚撑地(惩罚),及时修正自己的动作(即时调整策略)。每次小小的平衡和调整,都是根据刚刚的体验,即时调整和优化。偶尔摔倒了,你会记住教训、下次更注意平衡(立即更新策略),于是下次能骑得更远。这样经过不断的实际尝试和调整,你的骑车技术就会越来越好,最后自然掌握平衡——不再需要每一步都小心翼翼地思考,策略实现了最优收敛。这就是在线强化学习的本质,每一步都在试错、获得反馈、即时更新、最终实现最佳策略。
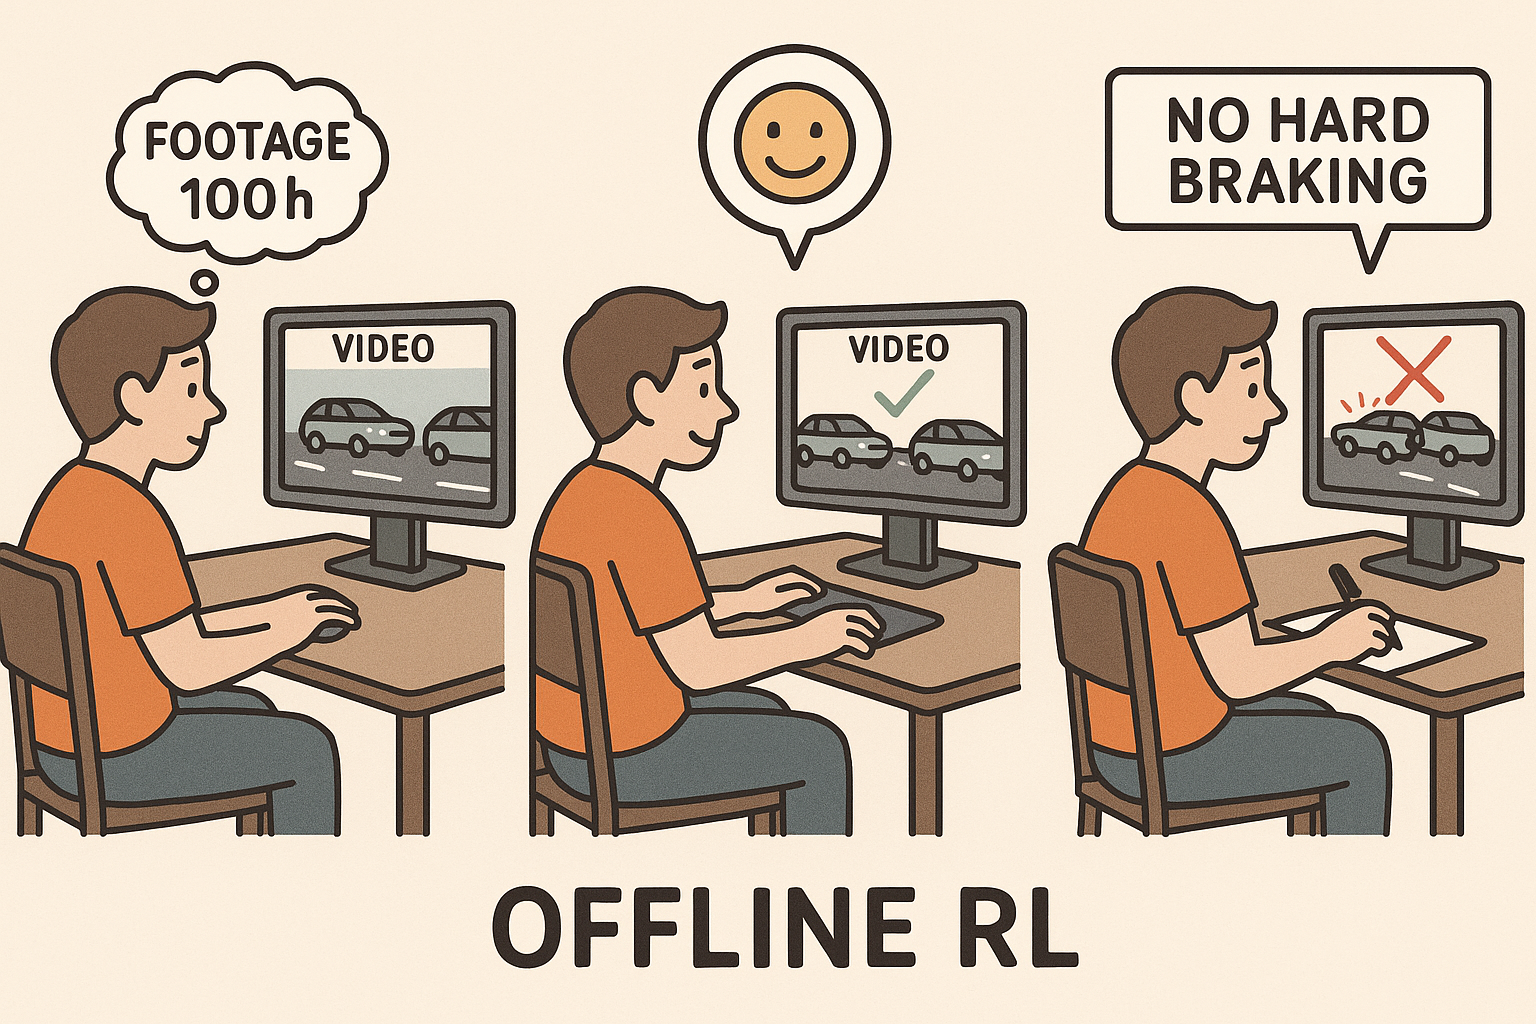
- 离线强化学习(Offine RL):离线强化学习的核心思想是智能体只能利用历史(离线)采集到的经验数据进行学习,不能直接和环境实时交互。简单的讲就是智能体“靠以往数据回顾总结经验”来达到目的。
通俗理解:假设你手头有一台记录了100小时行车过程的行车记录仪(数据集已经固定),你现在在学习如何安全驾驶。
你不是自己上路反复试错,而是反复观看这些录像,观察每一次“保留车距刹车”都能避免事故(奖励),而“急刹车”往往导致追尾(惩罚)。最终你总结出:行车时应该提前刹车,保持安全距离。这一切经验都是从录像中归纳出来的,而不是自己亲身经历“撞出来”的。这就是离线强化学习的本质,完全基于已有的数据经验来学习策略,不需要再做新的尝试或实际交互。
5.多智能体强化学习
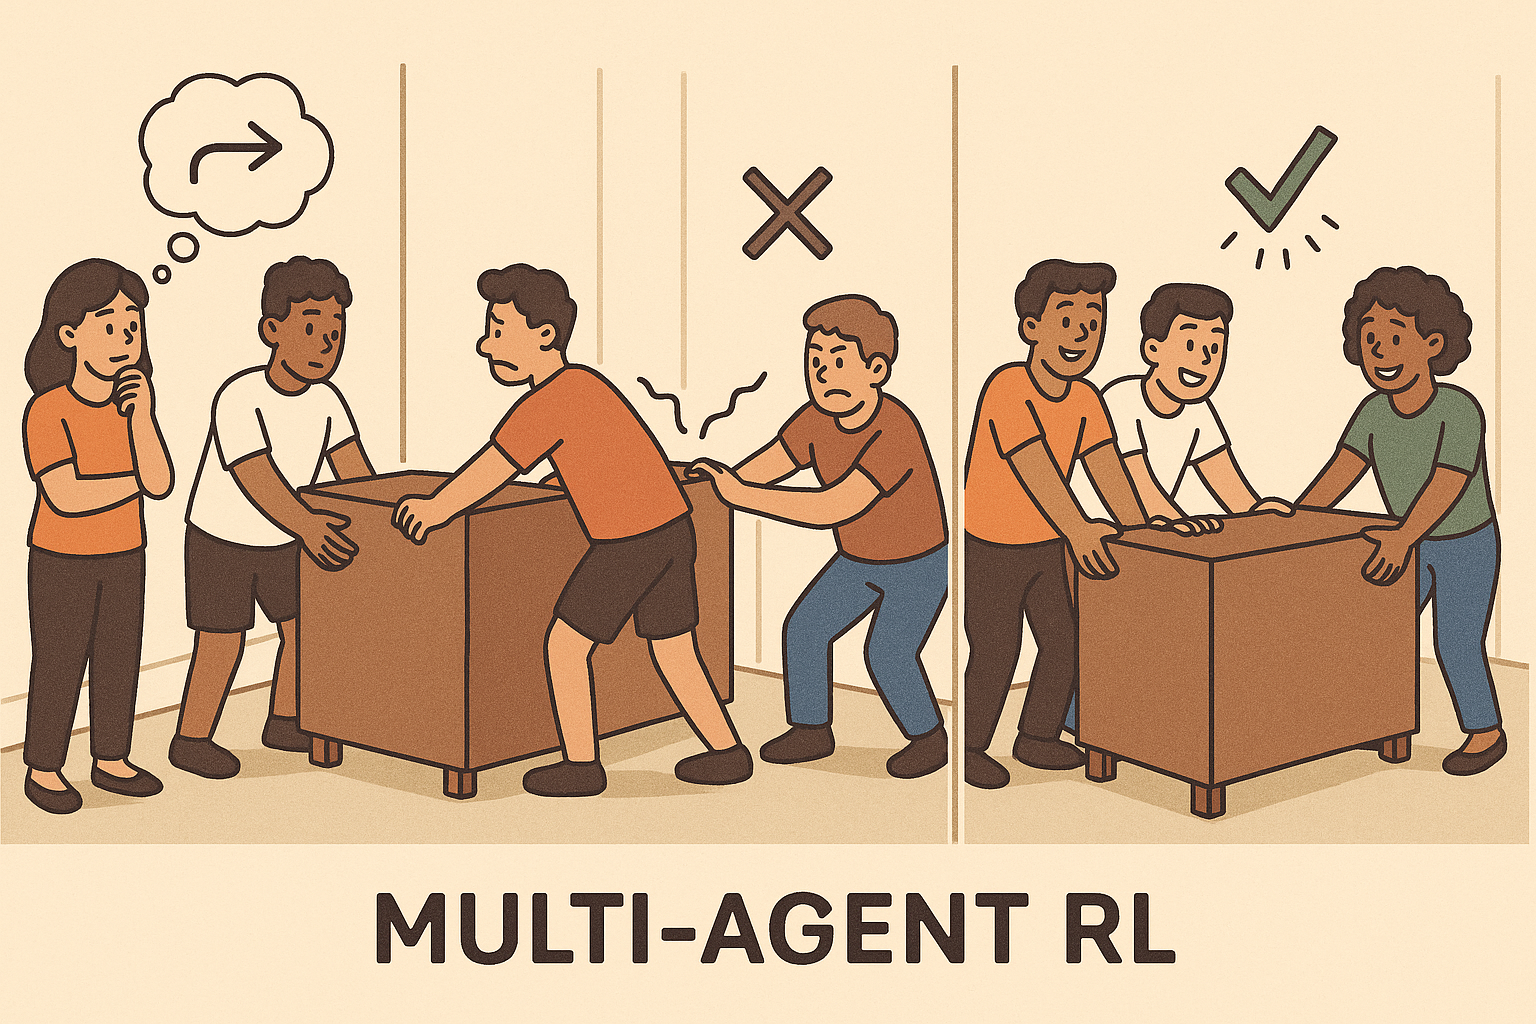
- 多智能体强化学习(Multi-agent RL,MARL):多智能体强化学习的核心思想是多个智能体在同一环境下协作或竞争,同时学习和适应彼此行为。简单的讲就是多个智能体彼此影响,相互博弈或协作,达到最终目的。
通俗理解:假设你找来好几个朋友一起帮忙搬家,有一个大件家具被卡在角落(环境),需要大家一起搬动。
每个人(多智能体)都自主决定如何用力和从哪个方向推拉,大家的行为会互相影响。如果A和B分别在两个方向使劲,可能家具会卡住(惩罚);如果大家步调一致、配合好,就能顺利搬出家具(奖励)。在这个过程中,没有专门的指挥,每个人都是根据自己的经验和反馈,不断调整行为,通过合作和试错,最终形成了最优的协作方式。这就是多智能体强化学习的本质,多个智能体在同一个环境中相互影响、彼此协作,通过各自的学习和调整,实现整体最优协作。
6.逆强化学习
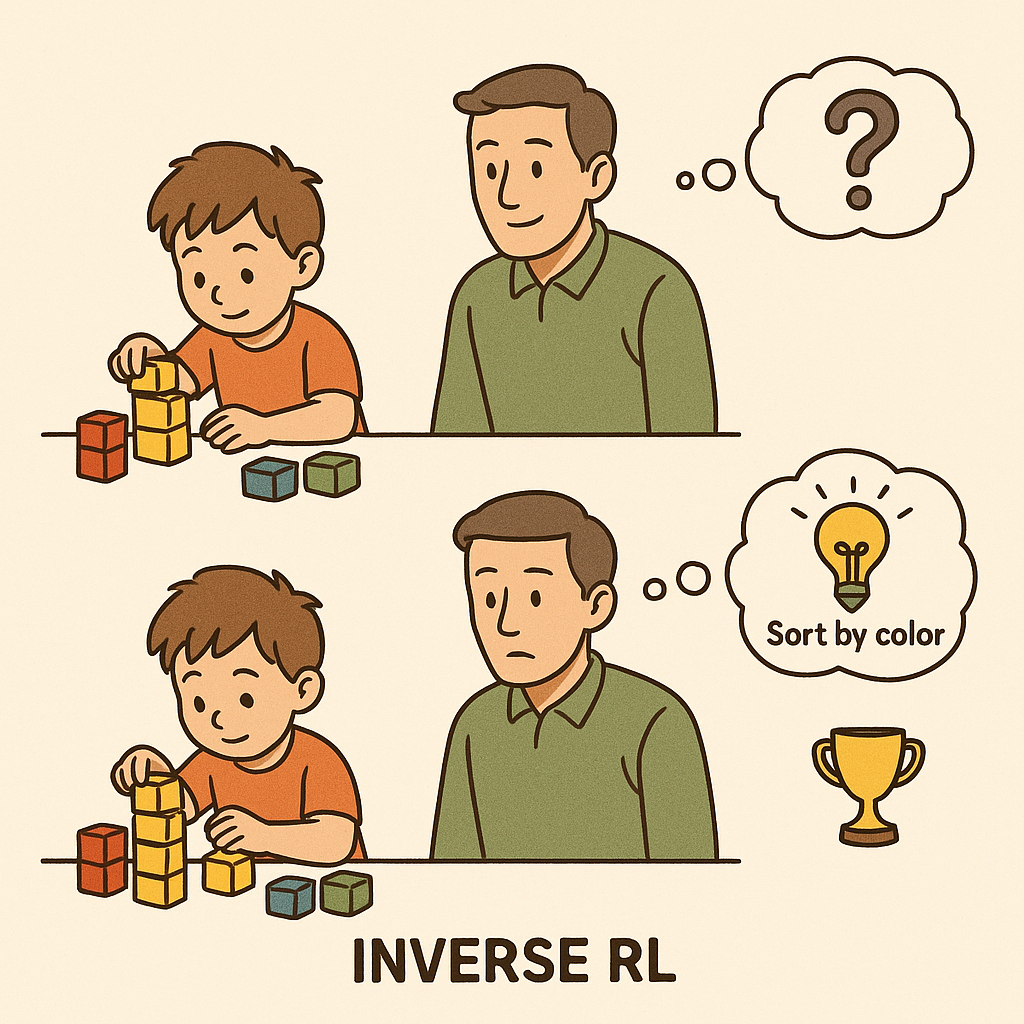
- 逆强化学习(Inverse RL):逆强化学习的核心思想是从专家演示中反推出奖励函数或策略,而不是直接优化给定的奖励函数。简单的讲就是智能体“观摩高手表现”,反推应奖惩什么,学习达到专家水准的行为。
通俗理解:假设你看到一个小孩在玩积木,他总是把相同颜色的积木堆在一起。你并不知道他事先的目标是什么,但通过反复观察他的行动,你可以推测出:他很可能的目标是“把积木按颜色分类”。
这就是逆强化学习的本质,不是直接教他怎么做,也不是已知目标去学习行为,而是通过观察已有的行为,反推出他内心真正的目标或奖励机制。
1.3.3 经典强化学习算法
1.无模型类
- 动态规划(Dynamic Programming, DP):动态规划是基于贝尔曼最优性原理(Bellman Optimality Principle)的方法,即在最优策略下,任何状态的最优价值等于当前采取最优动作获得的即时奖励,加上下一个状态最优价值的期望,通过“全局遍历+递归更新”,获得整个MDP的最优解。
- 蒙特卡洛方法(Monte Carlo, MC):蒙特卡洛方法是基于大数定律和采样平均的方法,通过统计经验,逼近状态或状态-动作的期望回报。
- 策略梯度(Policy Gradient, PG):策略梯度是基于策略梯度定理的方法,通过直接将策略参数化,把最大化累计奖励的问题转化为最大化参数化策略的期望回报,使优秀动作发生概率越来越高。
- DQN(Deep Q-Network):DQN是深度强化学习的一种,通过用深度神经网络逼近Q值函数,结合经验回放和目标网络,实现大规模状态空间的Q-Learning。
2.基于模型类
- Dyna-Q:Dyna-Q是基于"现实-模拟混合"思想的方法,通过学到的模型生成虚拟数据与真实经验混合更新Q值,最终快速收敛,减少真实交互。
- Model Predictive Control:Model Predictive Control是基于实时动态更新思想的方法,通过已知或学到的模型为基础,在每一步动态优化未来一定时间窗口内的动作序列,滚动前进,实时动态应对复杂环境变化,始终保持局部最优决策。
3.逆强化学习类
- 经典逆强化学习(Classic IRL):经典逆强化学习通过设计算法反推奖励函数,使得专家轨迹在该奖励下是最优策略,即专家行为的累计奖励最大于其他策略,最终复现/解释专家行为背后的动机或目标。
- 最大熵逆强化学习(Maximum Entropy IRL):最大熵逆强化学习是基于最大熵原理的方法,通过在所有能解释专家行为的奖励函数中,选取“最随机/最大不确定性”的那组,使得专家行为出现的概率最大,同时不过度偏向某一种解释,提升泛化性和鲁棒性。
- 生成对抗逆强化学习(Generative Adversarial IRL):生成对抗逆强化学习主要借鉴GAN思想,将判别器视为奖励函数,用来区分专家行为和智能体行为,最终实现无需显式指定奖励的模仿学习,直接从专家演示中端到端学会“像人一样做事”。
4.多智能体强化学习类
- 合作型值分解(Value Decomposition Networks, VDN / QMIX):合作型值分解主要利用分解结构把全局团队奖励拆解为各个体的局部奖励,或把全局值函数分解为各个体的局部值函数,最终提升多智能体协作效率,让局部学习能够带来全局最优团队表现。
- 多智能体策略梯度(Multi-Agent Policy Gradient, MADDPG等):多智能体策略梯度主要用于多体环境中,通过让每个智能体拥有自己的actor,但critic可以观测到其它智能体的状态/动作信息,即集中训练、分布执行(CTDE),最终实现高效协作或对抗。
- 联合行动学习(Joint Action Learners / Centralized Training, Decentralized Execution):联合行动学习通过在训练阶段允许智能体共享信息(中心化),但在实际部署时每个智能体独立决策(分布式),最终兼顾系统级训练效率和实际部署的分布式自治性。
1.3.4 强化学习的应用领域
- 智驾领域
RL用于端到端或分层决策控制(如在城市路口决策加速/减速/变道/避障),通过与仿真环境交互(如CARLA),不断试错,优化车辆行驶安全性与效率,如电车的智驾系统。 - 游戏领域
RL与蒙特卡洛树搜索结合,智能体自我对弈或模仿人类棋谱,不断调整策略参数,直接从胜负结果得到奖励信号,如AlphaGO。 - 机器人领域
RL用于机械臂、机器人手指的高维连续动作控制,通过反复尝试、奖励机制学会复杂抓取、拼装、工具使用等操作,如智能机器臂。 - 工业领域
RL代理根据实时订单、机器状态、原材料库存等信息,决定任务分配、生产排序,目标是缩短总工时、降低能耗或提升产量,如智能工厂。 - 能源领域
RL智能体对各区域/设备的能耗数据进行实时采集,决定每台设备的开关、负载分配或充放电时机,以削峰填谷、降低成本,如智能电网。
第一章小结
本章主要介绍了ML领域最为经典的三大范式,详细讲解了各大范式的定义、类型、经典算法、应用领域,虽然不可能囊括所有的算法和领域,但是可以帮助大家有一个初步的印象。当然范式不可能只有这三种还有许多别的范式,后续也会一 一讲解,但是不会这么详细的讲解了。
PS:因为实在太累了哈哈。
二、其余范式
PS:这章都是仅仅简单讲解哦。
2.1 半监督学习 (Semi-supervised Learning)
2.1.1 半监督学习定义
半监督学习介于监督学习和无监督学习之间,指的是利用少量有标签数据和大量无标签数据共同训练模型,以提升学习效果和泛化能力。简单的讲就是通过挖掘未标注数据中隐藏的结构信息(如聚类、流形等),结合少量标注数据,以更低成本提升模型性能。
2.1.2 半监督学习任务
- 半监督分类:在仅有少量有标签样本和大量无标签样本的情况下,学习一个分类决策函数,使得模型能够对所有数据准确分类,并提升泛化能力。
- 半监督回归:在仅有少量有标签样本和大量无标签样本的条件下,学习一个回归函数,能够对未知样本进行准确的连续数值预测。
- 半监督聚类:利用有限的标签信息或先验约束,引导聚类算法更合理地对所有样本进行分组,增强聚类结果的可解释性和一致性。
- 半监督降维:在降维过程中综合利用部分标签信息,使得降维后的数据分布既保留整体结构,又让同类样本在低维空间中靠近,异类样本分离,提高可视化效果。
- 半监督目标检测与分割:用有限的标注样本指导模型识别或分割数据中的目标/区域,通过引入无标签样本来提升检测或分割的鲁棒性和精度。
- 半监督异常检测:借助极少量已知异常标签,结合大量未标注样本,训练模型区分正常与异常数据,实现对未知异常的高效检测。
2.1.3 经典半监督学习算法
- 自训练(Self-training):模型先用标注数据训练初步模型,然后用该模型给无标签数据打“伪标签”,再把置信度高的伪标签样本加入训练集,迭代进行。
- 协同训练(Co-training):假设特征可分成两个独立视角,各自训练一个模型。两个模型相互为对方无标签样本提供伪标签,互补提升。
- 图半监督学习(Graph-based SSL, Label Propagation):将所有样本作为图节点,相似样本之间连边。已知标签作为“种子”,通过图结构传播标签信息到无标签节点。
- 一致性正则化与伪标签(Consistency Regularization & Pseudo-label):对于无标签样本输入做扰动,要求模型对扰动前后的预测一致。伪标签法将高置信度预测直接作为标签参与训练。
- 生成模型类方法(Semi-supervised Generative Models):生成模型在建模数据分布时同时利用标注信息提升分类/回归效果。
2.1.4 半监督学习的应用领域
- 自然语言处理(NLP):半监督学习能通过利用海量无标签文本,提升词向量、语法结构、语义关系等建模能力,大幅提高在小标签条件下的分类、序列标注、问答等任务的效果。
- 计算机视觉(Computer Vision):半监督学习允许用少量标注样本训练初步模型,然后利用无标签图片(如生成伪标签、图结构传播等)进一步提升性能,缓解标签不足导致的过拟合和低泛化。
- 医疗领域:半监督学习可以借助未标注数据学到更全面的病灶/解剖结构特征,提升模型对少数标注样本的利用率,有助于罕见病/小样本医学研究。
- 语言识别与音频处理:半监督方法(如伪标签、协同训练、生成模型)可以充分利用无标签音频提升声学模型、语言模型和语音事件检测的性能,特别适合多语种、方言、低资源语言场景。
2.2 自监督学习 (Self-supervised Learning)
2.2.1 自监督学习定义
自监督学习常常以无标签原始数据为基础,设计“预任务”,让模型在大规模数据上自我学习丰富的表示,之后可迁移至下游监督任务。简单的讲就是通过自动构造伪标签(pseudo-label)或预训练任务来学习特征表达,无需依赖人工标注的标签。
2.2.2 自监督学习任务
- 遮盖预测 (Masked Prediction):随机隐藏输入数据的部分内容,让模型根据剩余部分预测被遮盖的内容,从而学会数据的整体结构与内在关联。
- 对比学习(Contrastive Learning):让模型能够判别“同一实例的不同表达”与“不同实例”,通过拉近正对距离、推远负对距离,获得判别性强的特征表示。
- 上下文预测(Context Prediction):让模型根据输入数据的某一部分,预测其周围或相关部分,实现对数据内部关系和依赖的理解。
- 顺序/排序预测(Order/Permutation Prediction):将输入数据的顺序或结构打乱,要求模型还原正确的顺序或排列,从而学习到全局结构和序列依赖。
- 自回归预测(Autoregressive Prediction):让模型在给定部分数据的情况下,预测下一步/下一个元素,逐步学会建模数据的生成过程与条件分布。
- 重建/生成任务(Reconstruction/Generation):输入损坏、缺失或有噪声的数据,要求模型恢复或生成完整的原始数据,从而学会数据的本质特征和表示。
- 伪标签/自训练任务(Pseudo-labeling/Self-training):让模型使用自身高置信预测结果作为伪标签,对无标签数据进一步训练,提升模型对整体数据分布的表达能力。
- 多模态对齐/匹配任务(Multimodal Alignment/Matching):让模型通过不同模态的互相预测或对齐,学习不同数据类型之间的共享和映射关系。
2.2.3 自监督学习经典算法
- Word2Vec(Skip-gram / CBOW):设计上下文预测任务,让模型自动学习到词与词之间的关系,获得词向量表示。
- BERT(Bidirectional Encoder Representations from Transformers):采用遮盖预测和下句预测自监督任务,让模型在大规模文本上学到深层双向表达。
- GPT系列(Generative Pretrained Transformer):基于自回归预测任务,模型根据前文逐步生成后续内容,学会建模数据序列的条件概率分布。
- SimCLR / MoCo(对比学习类):对同一样本做不同增强,模型需区分正对和负对,从而学到具有判别性的全局特征表示。
- BYOL(Bootstrap Your Own Latent):不依赖显式负样本,通过主网络和目标网络的交互,直接学到高质量自监督表征。
2.2.4 自监督学习的应用领域
- 自然语言处理(NLP):自监督学习通过海量无标签文本自动生成“填空”“上下文预测”等预任务,让模型学到丰富的词义、语法结构和上下文关联。
- 计算机视觉(CV):自监督学习可利用海量未标注图片/视频,设计拼图、遮盖重建、对比学习等任务,促使模型自动学会识别物体形状、纹理、空间关系等底层视觉特征。
- 语音与音频处理:自监督学习(如wav2vec、HuBERT)利用遮盖预测、对比学习等任务,在大规模无标签音频数据上自我学习音素、语音特征和时序模式。
- 生命科学:自监督学习通过自动构造填空、对比等任务,在大规模生物序列上训练模型,帮助AI自动发现基因、蛋白间的结构与功能关联。
2.3 迁移学习 (Transfer Learning)
2.3.1 迁移学习定义
迁移学习强调将一个任务或领域中学到的知识迁移到另一个相关任务或领域,以提升目标任务的学习效率和泛化能力。简单的讲就是利用在源任务上学到的知识来提升目标任务的学习效率和性能。
2.3.2 迁移学习任务
- 跨领域迁移(Domain Adaptation / Domain Transfer):在源领域与目标领域任务相同但数据分布不同的情况下,迁移源领域的知识或模型,使其能在目标领域上获得良好表现,从而提升模型在新分布上的泛化能力。
- 跨任务迁移(Task Transfer / Inductive Transfer):将源任务中学到的知识迁移到相关但不同的目标任务,帮助目标任务在有限数据条件下快速提升学习效果,改善模型的泛化能力和收敛速度。
- 参数迁移(Parameter Transfer / Fine-tuning):通过迁移预训练模型的参数到目标任务,并对参数进行微调,使目标任务能够充分利用已有的知识基础,实现快速、高效的模型训练。
- 特征迁移(Feature Transfer):学习与任务或领域无关、可迁移的特征表达,使这些特征在新任务或新领域中依然有效,从而简化新问题的特征工程和提升性能。
- 多任务联合迁移(Multi-task Joint Transfer):在同时学习多个相关任务的过程中,通过共享模型参数或特征表征,实现知识的互补和迁移,提升各任务的学习效果。
- 跨模态迁移(Cross-modal Transfer):实现不同模态(如图像与文本、语音与文本等)之间的知识迁移,使模型能够在一种模态下学习到的信息辅助另一种模态的任务。
2.3.3 迁移学习算法
PS:迁移学习在应用中常作为其他范式的补充,专门设计的迁移学习算法虽存在,但并非主流,所以接下来会掺杂一些思想方法进行讲解,并非纯算法分享。
- 预训练-微调(Pretraining & Fine-tuning):在大规模数据集上预训练基础模型(如CNN/Transformer),再将其参数迁移到目标任务,并用目标数据微调,实现高效知识转移和快速适应。
- DANN(Domain-Adversarial Neural Network):通过引入领域判别器和对抗训练,迫使模型学习领域无关的特征,使得源域和目标域样本在特征空间难以区分,从而实现领域自适应。
- MMD(Maximum Mean Discrepancy):在特征空间最小化源域与目标域的均值距离,引导模型学习在两个领域分布对齐的特征表达,提升模型跨域泛化能力。
- 逐层冻结与逐步微调(Layer Freezing & Progressive Unfreezing):迁移学习时先冻结底层通用特征参数,仅微调上层或任务专属参数,或分阶段逐层解冻,防止过拟合并实现稳定迁移。
- 自监督预训练+迁移(Self-supervised Pretraining + Transfer):利用自监督任务(如对比学习、遮盖重建)在无标签大数据上预训练模型,获得通用特征表示,再迁移到下游监督任务中进行微调。
2.3.4 迁移学习的应用领域
- 自然语言处理(NLP):迁移模型通过在大规模通用语料(如Wikipedia、新闻语料库)上预训练语言模型(如BERT、GPT),让模型自发学到丰富的语义、语法和上下文关联。
- 计算机视觉(CV):迁移模型通过在ImageNet等大规模图像数据集上预训练卷积神经网络或视觉Transformer,获得强大通用视觉表征。
- 医疗领域:迁移模型通过将自然图像或公开医学数据集上预训练的模型参数迁移到具体医院或罕见病任务,模型能借助已有知识快速适应新的影像特征。
- 语言与音频处理:迁移模型通过在通用语音库上预训练声学模型,然后迁移到小语种、方言或专业场景,实现对不同用户、环境的快速适应。
2.4 元学习 (Meta-Learning / Learning to Learn)
2.4.1 元学习定义
元学习又称“学习如何学习”,是指让模型通过在多任务环境中训练,获得跨任务的快速适应能力,从而能在见到新任务时仅用极少样本、极少步骤迅速获得优异表现。简单的讲就是是训练模型能够从多个任务中学习如何更高效地学习新任务,实现“学会学习”的能力。
2.4.2 元学习任务
- 快速任务适应(Fast Task Adaptation):通过元学习方法,使模型能在面对全新任务或环境时,通过极少量梯度更新或有限交互,迅速获得优异表现。
- 元优化(Meta-Optimization / Learning to Optimize):通过元学习方法,训练模型自动发现和应用更优的学习规则或优化算法,加快在新任务上的训练速度,提高最终性能。
- 神经结构搜索(Neural Architecture Search, NAS, as Meta-learning):通过元学习方法,自动探索最适合不同任务的神经网络结构,减少人工设计和调参成本。
2.4.3 元学习算法
- MAML(Model-Agnostic Meta-Learning):通过在多任务上训练模型参数初始化,使得模型能在遇到新任务时,仅需极少梯度更新就能快速适应,广泛适用于分类、回归和强化学习。
- ProtoNet(Prototypical Networks):学习一种可泛化的嵌入空间,利用每个类别支持集的中心(原型)进行距离度量分类,实现高效的few-shot学习。
- Meta-Learner LSTM(LSTM-based Meta-Learner):用LSTM网络作为优化器,让其“学会”如何为另一网络设计更新规则,从而在面对新任务时自动调整学习过程。
- Learning to Optimize:直接让模型通过元学习自动发现最优学习率或优化算法,提高模型在新任务上的收敛速度与表现。
2.4.4 元学习的应用领域
- 医疗领域:在极度数据稀缺的领域,如罕见病诊断、基因序列分析、病理样本识别,元学习能让模型仅用极少标注数据就学会新疾病/结构的识别或预测。
- 机器人领域:机器人通过元学习方法,可在有限环境样本或极少演示下,快速学会新场景下的感知、抓取、导航等任务。
- 强化学习与多任务自适应:元学习能让智能体在多种任务/环境间迁移经验,遇到新任务时仅需极少探索即可获得高水平表现。
- AutoML与神经架构搜索:元学习为自动机器学习系统(AutoML)和神经网络结构搜索(NAS)提供“快速适应不同任务”的能力。
2.5 多任务学习 (Multi-Task Learning, MTL)
2.5.1 多任务学习定义
多任务学习指的是让模型同时在多个相关任务上进行训练,通过共享部分参数或表示,提升模型在所有任务上的泛化能力。简单的讲就是通过任务间的信息共享和知识迁移,提升每个任务的学习效果,减少过拟合和提升训练效率。
2.5.2 多任务学习任务
- 多标签分类(Multi-label Classification):让模型能够同时对一个样本预测多个不同的标签,实现并行化、多角度的类别识别。
- 多目标回归(Multi-output Regression):让模型能够为每个样本同时输出多个连续目标变量,提高对复杂问题的整体建模能力。
- 联合检测与分割(Joint Detection and Segmentation):让模型在同一输入下同时完成目标检测和区域分割等不同任务,提升整体场景理解能力。
- 联合文本理解任务(Joint Text Understanding Tasks):让模型同时执行文本分类、命名实体识别、关系抽取等多项自然语言处理任务,提升文本深层理解和信息抽取效果。
- 联合序列建模(Joint Sequence Modeling):让模型在时间序列、音频等数据上同时进行多种预测,提升对多维动态信息的捕捉能力。
2.5.3 多任务学习算法
- 硬参数共享(Hard Parameter Sharing):采用一个共享的底层特征提取网络,各任务仅在顶层拥有独立输出分支,通过参数共享实现任务间知识迁移和正则化。
- 软参数共享(Soft Parameter Sharing):每个任务拥有独立网络,但在训练时通过正则项(如参数距离、门控机制)对参数相互约束,实现软性知识共享。
- 分层共享结构(Hierarchical/Layer-wise Sharing):根据任务之间的相似性和复杂度,灵活地在不同层次设置共享或专属网络结构,实现更细粒度的知识融合。
- 动态任务加权(Dynamic Task Weighting):通过动态调整各任务损失函数的权重,自动平衡任务训练进度和模型关注重点,提升整体表现与收敛速度。
- Cross-stitch Networks:在各任务的网络之间插入“交织单元”,使不同任务间的信息在多个层次动态流动,实现更加自适应的知识融合。
2.5.4 多任务学习的应用领域
- 计算机视觉(CV):多任务学习通过共享视觉特征网络,实现同时进行图像分类、目标检测、语义分割、关键点定位等任务。
- 自然语言处理(NLP):多任务学习让模型能在同一框架下同时完成文本分类、情感分析、命名实体识别、关系抽取等子任务。
- 语音与音频处理:多任务学习支持模型同时进行语音识别、说话人识别、语音情感识别等任务。
2.6 在线学习 (Online Learning)
2.6.1 在线学习定义
在线学习指的是模型在数据流到达时实时接收并逐步更新参数,无需一次性获得完整数据集。简单的讲就是模型在接收到新数据时实时更新自身参数,从而逐步适应动态变化的数据流。
2.6.2 在线学习任务
- 在线分类(Online Classification):让模型在接收到每一个新样本时立即做出预测,并根据反馈结果即时调整参数,持续提升分类准确率。
- 在线回归(Online Regression):使模型在数据流环境下实时预测连续变量,并随着每个新样本的到来不断校准预测函数。
- 在线聚类(Online Clustering):不断接收新样本时,动态更新类别中心和分组结构,实时反映数据分布的最新变化。
- 在线异常检测(Online Anomaly Detection):模型能在连续数据流中及时识别异常点或突变行为,并能根据最新检测结果自适应调整判别标准。
- 在线排序/推荐(Online Ranking/Recommendation):在用户行为不断产生的场景下,模型能持续优化排序或推荐列表,动态提升个性化体验和点击率。
2.6.3 在线学习算法
- 感知机算法(Perceptron):每收到一个新样本,根据当前预测结果与真实标签差异即时调整权重,实现二分类在线学习。
- 在线梯度下降(Online/Stochastic Gradient Descent, SGD):用每个新到样本单独更新模型参数,实现高效、可扩展的连续学习,适用于回归、分类等多种任务。
- 被动-主动算法(Passive-Aggressive Algorithms, PA):对于新样本,只有在预测错误或不满足一定边界条件时才做较大权重调整,兼顾保守性和快速适应。
- 自适应窗口/遗忘机制(Adaptive Window/Forgetting Mechanism):仅用最新的样本或对历史样本加权衰减,提升模型对概念漂移和突变的响应能力。
2.6.4 在线学习的应用领域
- 金融领域:在线学习用于欺诈检测、股票走势预测、信贷评分等场景,能实时处理大规模交易数据,快速识别风险和机会。
- 网安领域:在面对实时网络流量和攻击行为时,在线模型能够持续识别新型威胁和异常流量,及时适应攻击手段变化。
- 实时推荐:推荐系统利用在线学习对用户兴趣、行为变化即时捕捉,持续优化推荐内容和广告投放策略。
- 智能交通:交通流量、公共设施等数据流经在线学习持续优化调度与分配策略,实现拥堵预警、路网优化和智慧城市实时决策。
2.7 联邦学习 (Federated Learning)
2.7.1 联邦学习定义
联邦学习指让多个数据拥有方(如用户、设备、机构)在不共享原始数据的前提下,协同训练全局模型。简单的讲就是让各参与方只上传本地模型参数或梯度,数据本身不出本地,聚合更新全局模型,兼顾数据隐私、数据孤岛和模型效果。
2.7.2 联邦学习任务
- 联邦分类(Federated Classification):在多方私有数据集上,联合训练一个分类模型,提升在各方数据上的综合分类性能。
- 联邦回归(Federated Regression):多方协同训练回归模型,实现精准的连续变量预测,而无需交换原始数据。
- 联邦推荐(Federated Recommendation):各设备/用户本地训练兴趣模型,通过联邦方式集成全局推荐能力,提升个性化推荐体验和隐私保护。
- 联邦聚类/异常检测(Federated Clustering/Anomaly Detection):分布式发现全局数据结构、聚类和异常,广泛用于金融风控、入侵检测、医疗多中心分析等。
2.7.3 联邦学习算法
- 联邦平均算法(FedAvg):各参与方本地用自身数据多轮训练,然后将模型参数上传服务器,服务器计算加权平均,得到新的全局模型,迭代优化。
- 联邦SGD(Federated SGD, FedSGD):各方在每批数据上独立计算梯度,服务器聚合所有梯度后统一更新全局模型参数。
- 联邦优化变体(FedProx、FedNova等):为处理数据/设备异构性,引入正则、归一化、局部更新等改进,提升收敛性和适应性。
- 隐私增强与安全防护算法:在参数/梯度上传和聚合过程中引入加密或扰动,防止模型/数据泄露和攻击,强化隐私保护。
2.7.4 联邦学习的应用领域
- 移动设备:联邦学习让每台手机本地数据(如输入习惯、APP使用、拍照、语音等)参与训练,无需上传敏感数据。
- 金融领域:各银行、保险机构在本地训练风控、信用评估模型,通过联邦聚合提升全行业风险识别和建模能力。
2.8 生成学习(Generative Learning / Generative Models)
2.8.1 生成学习定义
生成学习指学习数据的分布和结构,能够根据所学生成与原始数据相似的新样本。简单的讲就是通过学习数据的概率分布来生成新的数据样本,从而捕捉数据的本质特征。
2.8.2 生成学习任务
- 数据生成(Data Generation):从学习到的分布中采样,合成新的、与原始样本风格一致的数据(如图像、文本、音频等)。
- 数据增强与缺失补全(Data Augmentation / Imputation):利用生成模型合成数据样本,扩展训练集,或自动补全缺失/损坏的数据区域。
- 数据重建与去噪(Reconstruction / Denoising):模型输入部分损坏或有噪声的数据,输出原始、完整数据,实现去噪或修复。
- 风格迁移与变换(Style Transfer / Transformation):学习数据的不同风格或属性,实现跨域转换、风格迁移、图像编辑等。
- 潜变量建模与表示学习(Latent Variable Modeling / Representation Learning):通过生成模型学习到数据的低维、可解释潜变量表示,助力下游聚类、可视化、压缩等任务。
2.8.3 生成学习算法
- 生成对抗网络(GAN, Generative Adversarial Network):由生成器和判别器组成的博弈系统,生成器学会合成以假乱真的新样本,判别器学习区分真假数据,通过对抗过程提升生成质量。
- 变分自编码器(VAE, Variational Autoencoder):用概率自编码结构对数据进行编码和解码,显式建模数据分布,实现样本生成、重建和潜变量学习。
- 自回归模型(Autoregressive Models):通过逐步预测下一个数据元素,学习联合概率分布,实现高质量数据生成。
- 能量模型与玻尔兹曼机(Energy-based Models, Boltzmann Machine):通过能量函数描述数据概率分布,采样新样本,常用于早期生成建模和无监督特征学习。
- 扩散模型(Diffusion Models):通过将数据逐步加入噪声并学会反向去噪,实现高分辨率、极高质量的数据生成,是近年来生成模型领域的热点。
2.8.4 生成学习的应用领域
- 图像生成与编辑:生成学习可合成高清照片、艺术风格画作、人脸、卡通、医学影像等,支持图像修复、超分辨、无监督风格变换等任务。
- 文本生成与理解:生成模型可实现自动文本生成、对话系统、文章摘要、机器翻译等。
- 语音与音频合成:生成模型可用于TTS、音乐生成、语音转换、语音增强等。
- 数据增强与隐私保护:在医学、金融、工业等领域,生成学习能为小样本任务扩充数据、补全缺失、生成隐私保护数据。
- 表示学习与潜变量建模:生成学习可自动学习数据的深层结构和低维潜变量表达,助力下游聚类、可视化、异常检测、压缩等AI任务。
2.9 集成学习 (Ensemble Learning)
2.9.1 集成学习定义
集成学习指将多个模型的预测结果进行融合,形成一个更强、更稳定的最终模型的机器学习方法。简单的讲就是通过组合多个学习器的预测结果来提高整体模型的准确性和泛化能力。
2.9.2 集成学习任务
- 集成分类(Ensemble Classification):融合多个分类器的预测,提高最终分类准确率和抗干扰能力。
- 集成回归(Ensemble Regression):整合多个回归模型的输出,实现更精确和稳定的连续变量预测。
- 特征选择与模型筛选(Feature/Model Selection):利用集成模型评估特征或基模型的重要性,提升特征选择和模型选择的科学性和效果。
- 异构集成(Heterogeneous Ensemble):结合不同类型的基模型(如决策树+神经网络+SVM),融合各自优势,提升模型泛化和多样性。
2.9.3 集成学习算法
- Bagging(Bootstrap Aggregating, 典型如随机森林 RF):通过对训练数据有放回采样,训练多个独立基模型(如决策树),最终通过投票或平均融合预测结果,降低方差、提升鲁棒性。
- Boosting(典型如XGBoost):串行训练多个弱模型,每一步重点关注前一轮错误样本,通过加权融合提升难点样本表现,最终形成强分类器或回归器,兼具低偏差和低方差。
- Stacking(Stacked Generalization):用多种不同基模型预测同一问题,将这些预测作为新特征,再训练一个“次级模型”进行最终预测,实现多层次模型融合。
- Voting(Voting Ensemble):将多个基模型的输出直接采用投票或加权平均的方式进行融合,提升整体决策稳定性。
- Blending:类似于Stacking,但用独立的数据集训练次级模型,降低过拟合风险。
2.9.4 集成学习的应用领域
- 金融领域:集成学习通过融合多种基础模型,在风险识别、信用评分、欺诈检测等任务中取得更高准确率和更强鲁棒性。
- 医疗领域:集成学习能有效整合多种诊断模型或专家意见,实现医学影像识别、疾病预测、辅助诊断等任务的精度提升。
- 计算机视觉与语音识别:集成学习可整合不同特征、算法和模型,提升图像分类、目标检测、语音识别等任务的准确性和稳定性。
- 大规模竞赛与工业应用:在数据挖掘、机器学习竞赛及实际工业落地中,集成学习几乎成为“高分方案”的标配,通过模型集成实现超越单一算法的性能极限,推动AI在复杂环境的稳健应用。
2.10 多模态学习
2.10.1 多模态学习定义
多模态学习指的是联合建模和融合多种不同类型的数据模态(如文本、图像、音频、视频、传感器等),以更全面理解世界、增强AI系统的表达和推理能力。简单的讲就是让模型能同时感知、理解和生成多源、多样化的信息,实现“视听说读写”一体化智能。
2.10.2 多模态学习任务
- 跨模态检索(Cross-modal Retrieval):让模型能根据一种模态的信息(如文本)检索另一种模态的数据(如图片、音频等)。
- 多模态分类与融合(Multimodal Classification & Fusion):利用多个模态的特征联合进行分类或预测,提高识别准确率和鲁棒性。
- 图文/音视描述生成(Multimodal Generation/Captioning):让模型能根据图片、音频等内容自动生成自然语言描述,实现图文互转、音画同步等。
- 多模态问答与推理(Multimodal Question Answering/Reasoning):模型基于多模态输入(如图片+文本),进行推理、理解和回答问题,提升智能问答能力。
- 情感识别与用户建模(Multimodal Sentiment Analysis & User Profiling):结合语音、表情、文本等模态,提升对用户情感、意图和行为的建模能力。
2.10.3 多模态学习算法
- 融合网络(Fusion Networks):通过特征级、决策级、注意力机制等方法,将不同模态的特征在网络内部融合,提升表达能力。
- 共享嵌入空间(Shared Embedding Space):将多模态数据投影到同一个特征空间,通过对齐学习,实现跨模态检索和信息关联。
- 交互注意力机制(Co-attention, Cross-attention):让模型学会在不同模态间动态关注和信息流动,实现精准的模态协同与细粒度对齐。
- 多模态Transformer(Multimodal Transformers, 如CLIP、ALIGN、FLAVA等):利用Transformer结构实现多模态大规模预训练和融合,支持图文、音画等多任务、多场景应用。
- 多模态对比学习(Multimodal Contrastive Learning):通过正负样本对比,让模型学会不同模态之间的一致性和判别性,常用于跨模态检索和生成。
2.10.4 多模态学习的应用领域
- 智能搜索与跨模态检索:多模态学习让用户能通过图片找商品、以文本搜视频、通过语音查图等。
- 智能助手与人机交互:多模态模型支持对语音、图像、文本等多种输入的自然理解和响应。
- 内容生成与AIGC:多模态生成模型可实现文生图(如Stable Diffusion、DALL·E)、图生文(图像描述)、音画合成等。
- 智能监控与行为分析:多模态模型能融合视频、音频、文本等信息,实现多维度的异常检测、行为识别、情感分析。
- 自动驾驶与智慧交通:多模态学习结合视觉、雷达、GPS、语音等多源数据,实现复杂环境下的感知、决策与控制。
第二章小结
在这个章节中,采用了同样的方式介绍了大部分的范式,当然还有许多范式没有介绍,如主动学习,因果学习等等,因为确实是太多了,再写下去可能也写不完,只能在该系列后续碰到了再进行讲解,希望能帮助读者建立基本的范式认知框架。
总结
在本次笔记中,我们系统性地梳理了机器学习的核心范式,从经典的监督、无监督、强化学习三大支柱,到半监督、自监督、迁移学习等新兴范式,再到多任务、联邦、生成、集成、多模态学习等高级范式。需要注意的是机器学习的范式并非孤立存在,实际应用中常需组合创新。理解每种范式的适用场景和局限性,才能灵活选择技术路径,希望这份笔记能帮大家初步了解机器学习的范式。
PS:
其实最后还想做一个汇总表格,但是实在太多了不想弄了,哈哈。后续本人还会持续更新该系列,第一个方向,应该是“回归”。
找不到源码或其它需求的关注后私信哦,谢谢大家阅读。

 浙公网安备 33010602011771号