
MySQL数据库索引介绍
数据库索引
基本概念
索引本质是一种可以提升数据查询效率的数据结构
主要分类
主要分为两类:
- 聚簇(集)索引:一个叶子节点上存储的是索引(主键值)和数据为对应的行数据
- 非聚簇(集)索引:一个叶子节点上存储的是索引(某一个字段的值)和数据为对应的主键值
B+树
索引采用的数据结构为B+树
分析:为什么采用B+树
1.二叉树
存在的问题是,对应二叉树来说,存储数据时,可能会造成数据左右节点不平衡,并且树的深度会很深,不适合用来存储数据
2.二叉查找树和二叉平衡树
二叉查找树,在二叉树的基础上,对数据的存放进行了规定,大的数据会存到树的右边,小的则相反,但是如果数据添加时是递增的依旧会导致不平衡
二叉平衡树,在查找树的基础上,会进行自平衡的操作,会在树不平衡时进行旋转树的操作,从而使树处于一个平衡的状态
红黑树:是特殊的二叉平和树(不支持范围搜索)
平衡就是对于树上的任何一个节点上的两边的子树高度差不超过1
存在的问题:由于二叉树的限制,也会导致存储数据时,存在深度过深的问题
扩展:
红黑树规则
- 每个节点是红色或黑色。
- 根节点是黑色。
- 每个叶子节点(NIL节点)是黑色。
- 如果一个节点是红色,则它的两个子节点都是黑色。
- 从任一节点到其每个叶子的所有路径都包含相同数目的黑色节点。
3.B树和B+树

上面的一个B+树的结构
而B树则是在每一个节点内部存储了包括键值,指针还有数据的内容,在一页上大概有16k(16 * 1024B)的空间,而键值(索引)需要8B的空间,数据加上指针大概需要1k的空间,因此通过计算可以得出,每一页大概可以存储(16 * 1024)/1032 = 15个
第一层:可以存储15个数据
第二层:可以存储15 * 15 个数据
第三次:可以存储 15 * 15 * 15 个数据(大约3375)
以此类推
存在的问题:由于空间的问题,到第三层也只能存储3375个数据,数据量大的时候也会导致树过深,从而使效率低的问题存在。
而对于B+树来说,它只在叶子节点存储数据,因此非叶子节点就只存储键值(索引)和指针(大概占6B),通过计算可以得出,非叶子节点一页大概可以存储(16 * 1024)/(8 + 6)= 1170个数据
第一层:1170
第二层:1170 * 1170
第三次(叶子节点):1170 * 1170 * 15 大概可以存储2000W+的数据
对于大部分的常见三层的B+树完全足够,这样可以解决其他结构深度过深的问题,同时查询效率也高
在底层的叶子节点上,同时存在双向链表,由于双向链表每一个节点都有指向前后节点的指针,因此查询的效率就会提高
主键索引
InnoDB在创建表时一定需要主键,如果不创建,会自动维护一个主键索引,一般创建的主要需要的不参与业务的没有业务意义的列
结构:
非叶子节点内:每一个数据的索引放的是下一个节点中所存储的数据中最小的一个主键值,这样就可以实现范围搜索
叶子节点内:索引值即为主键值,数据即为对于的行数据
具体的结构大概如下:

需要设置主键自增的原因:
由于我们的B+树为平衡的树,当我们这种主键自增时,添加数据时,只会往树的右叶子节点内添加,当最右边的叶子节点未满时,即会加入到此节点,如果此叶子节点满了,但是当前第二层的非叶子节点下可存在的节点未满时,则会在此节点下新增一个叶子节点来存放数据,以此类推。因此就不会出现树旋转的情况,减少了额外的开销。
而如果不设置自增则出现的情况会很复杂,首先就是需要找到要插入的位置,然后还要考虑平衡的问题,就会出现旋转树等会造成额外开销的情况出现
因此一般推荐使用主键自增。
非主键索引
普通索引
不同于主键索引,普通索引存在的索引值为某列的数据值,
非叶子节点的索引存放规则是基本与主键索引一致,只是值变成了数据值而非主键值
叶子节点存在的数据则变成了对于的主键值
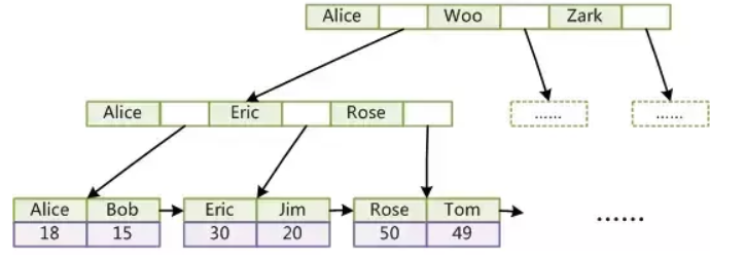
只存储主键值的原因:
由于主键值没有特殊情况树不会变化的,而如果存储了别的数据时,一旦数据值进行了修改,可能会导致树的结构变化,因为树需要保持平衡,
因此如果出现这样的情况,不仅主键索引需要变化,非主键索引也会进行变化,如果存在多个不同的非主键索引,这样带来的开销是巨大了,所以对于非主键索引,存储的数据值一般都只会是主键值
其他索引
唯一索引:
- 给唯一列创建索引,关键词为:unique
联合索引:
- 给主键多个列创建索引,
- 比如id,name,age,phone
- 索引 name,age,phone
- 一般联合索引的多个列组合可以查到唯一的值,才会建立联合索引来提高查询效率
全文索引:略
创建索引的要求
- 1、单表索引不超过5个,如果业务需要,表中需要更多的索引,那就大胆去建索引,为了提升性能,索引多几个没关系。(建索引一定要按照公司的发布流程来走)
- 2、联合索引的字段不超过5个
- 3、经常增删改的字段不适合创建索引
- 4、枚举值字段不适合创建索引
- 5、不经常修改,经常查询的字段适合创建索引
- 6、大长度的字段,可以设置前缀索引(为字段的前几个字符建立索引)
- CREATE TABLE users ( user_id INT AUTO_INCREMENT PRIMARY KEY, username VARCHAR(255), email VARCHAR(255) ); -- 创建前缀索引 CREATE INDEX idx_username_prefix ON users (username(10));
具体可以参考网上的规约文档,没有固定的要求,一切都需要从业务出发
创建索引的语法
- 主键索引
- 命名要求:pk_列名
- 普通索引
- create index 索引名称 on 表名(具体的列名)
- 命名要求:idx_列名
- 唯一索引
- create unique index 索引名称 on 表名(列名)
- 命名要求:uk_列名
- 联合索引
- create index 索引名称 on 表名(列1,列2)
- 命名要求:idx_列1_列2

 浙公网安备 33010602011771号