
MySQL基本sql语句
SQL语句
SQL:一门操作关系型数据库的编程语言,定义操作所有关系型数据库的统一标准。
分类:
| 分类 | 全称 | 说明 |
|---|---|---|
| DDL | Data Definition Language | 数据定义语言,用来定义数据库对象(数据库,表,字段) |
| DML | Data Manipulation Language | 数据操作语言,用来对数据库表中的数据进行增删改 |
| DQL | Data Query Language | 数据查询语言,用来查询数据库中表的记录 |
| DCL | Data Control Language | 数据控制语言,用来创建数据库用户、控制数据库的访问权限 |
DDL
数据库
操作语法:
-- 查询所有数据库
show databases;

-- 查询当前数据库
select database();

-- 使用/切换数据库
use 数据库名;

-- 创建数据库
create database [if not exists] 数据库名 [default charset utf8mb4];

-- 删除数据库
drop database [if exists] 数据库名;
上述语法中的database,也可以替换成 schema。如:create schema db01; MySQL8版本中,默认字符集为utf8mb4。
MySQL客户端工具-图形化工具:
介绍:DataGrip是JetBrains旗下的一款数据库管理工具,是管理和开发MySQL、Oracle、PostgreSQL的理想解决方案。
官网:https://www.jetbrains.com/zh-cn/datagrip/
安装:参考资料中提供的《DataGrip安装手册》
表结构-创建
创建表的语法:
create table tablename(
字段1 字段类型 [约束] [comment 字段1注释],
......
字段2 字段类型 [约束] [comment 字段2注释]
)[comment 表注释];
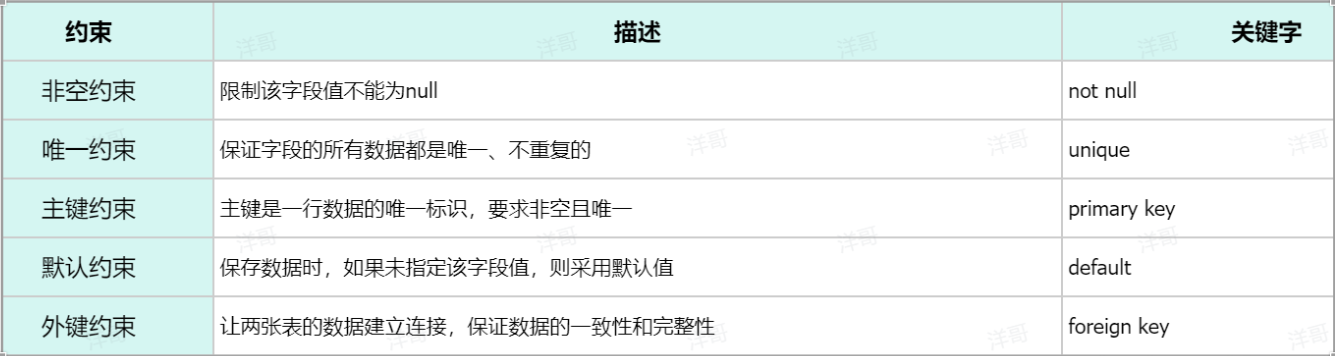
约束:
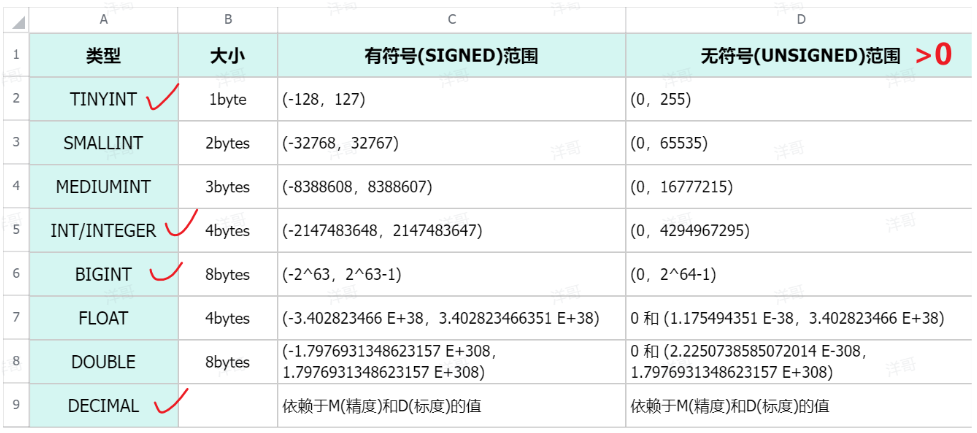
数据类型:
- 数值类型
- 字符类型
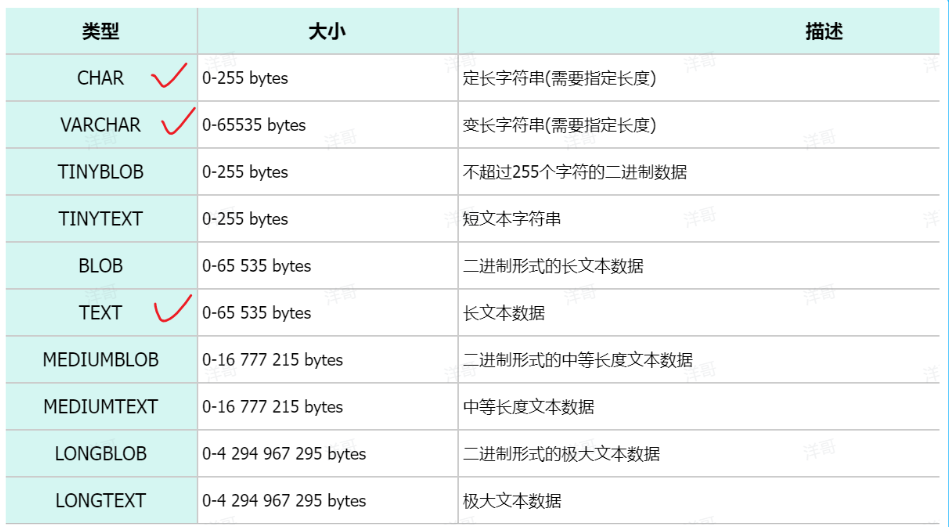
char:表示定长,适用于存储固定长度的数据,如身份证号码。如果长度为10,你存储了5个字符,实际占用空间也是10
varchar:表示变长,适用于变长度的数据,如用户名。如果长度为10,你存储了5个字符,实际占用空间也是5
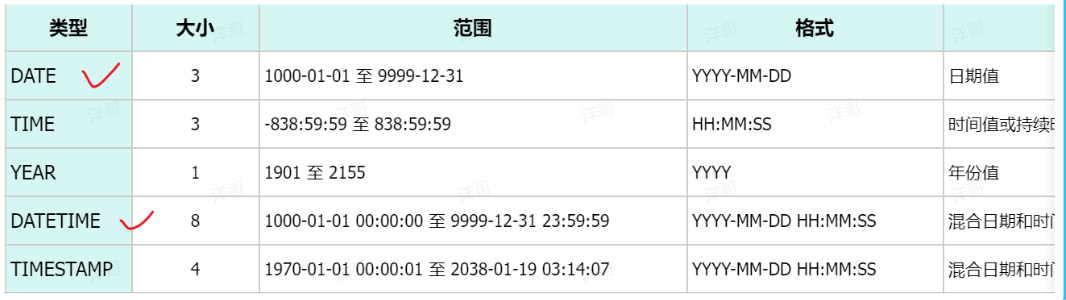
- 时间
表结构-查询、修改、删除
查询数据库表的具体的语法:
-- 查询当前数据库的所有表
show tables;

-- 查看指定的表结构
desc 表名 ;   -- 可以查看指定表的字段、字段的类型、是否可以为NULL、是否存在默认值等信息

-- 查询指定表的建表语句
show create table 表名 ;
修改数据库表结构的具体语法:
-- 添加字段
alter table 表名 add  字段名  类型(长度)  [comment 注释]  [约束];

-- 比如: 为tb_emp表添加字段qq,字段类型为 varchar(11)
alter table tb_emp add  qq  varchar(11) comment 'QQ号码';

-- 修改字段类型
alter table 表名 modify  字段名  新数据类型(长度);

-- 比如: 修改qq字段的字段类型,将其长度由11修改为13
alter table tb_emp modify qq varchar(13) comment 'QQ号码';

-- 修改字段名,字段类型
alter table 表名 change  旧字段名  新字段名  类型(长度)  [comment 注释]  [约束];

-- 比如: 修改qq字段名为 qq_num,字段类型varchar(13)
alter table tb_emp change qq qq_num varchar(13) comment 'QQ号码';

-- 删除字段
alter table 表名 drop 字段名;

-- 比如: 删除tb_emp表中的qq_num字段
alter table tb_emp drop qq_num;

-- 修改表名
rename table 表名 to  新表名;

-- 比如: 将当前的emp表的表名修改为tb_emp
rename table emp to tb_emp;
删除表结构:
-- 删除表
drop  table [ if exists ]  表名;

-- 比如:如果tb_emp表存在,则删除tb_emp表
drop table if exists tb_emp;  -- 在删除表时,表中的全部数据也会被删除。
DML
DML英文全称是Data Manipulation Language(数据操作语言),用来对数据库中表的数据记录进行增、删、改操作。
- 添加数据(INSERT)
- 修改数据(UPDATE)
- 删除数据(DELETE)
添加数据(INSERT)语法:
-- 向指定字段添加数据
insert into 表名 (字段名1, 字段名2) values (值1, 值2);  # 建议使用

-- 全部字段添加数据
insert into 表名 values (值1, 值2, ...);

-- 批量添加数据(指定字段)
insert into 表名 (字段名1, 字段名2) values (值1, 值2), (值1, 值2); # 建议使用

-- 批量添加数据(全部字段)
insert into 表名 values (值1, 值2, ...), (值1, 值2, ...);
修改数据(UPDATE)语法:
update 表名 set 字段名1 = 值1 , 字段名2 = 值2 , .... [where 条件] ;
⭕注意:一定要加上 where条件,否则会出现全表更新,很危险!
删除数据(DELETE)语法:(在实际的业务过程中,一般不会进行数据的删除,而是通过添加字段,比如is_del,通过update修改此字段的值来标记此数据已删除)
delete from 表名 [where 条件] ;
⭕注意:一定要加上 where条件,否则会出现全表删除,很危险!
扩展:
- 格式化表:先把表删了,再按原来的表结构创建一个新表,适合删除大数据量表
TRUNCATE TABLE 表名;
DQL
DQL英文全称是Data Query Language(数据查询语言),用来查询数据库表中的记录。
查询关键字:SELECT
查询操作是所有SQL语句当中最为常见,也是最为重要的操作。在一个正常的业务系统中,查询操作的使用频次是要远高于增删改操作的。当我们打开某个网站或APP所看到的展示信息,都是通过从数据库中查询得到的,而在这个查询过程中,还会涉及到条件、排序、分页等操作。
DQL查询语句,语法结构如下:
SELECT
        字段列表
FROM
        表名列表
WHERE
        条件列表
GROUP  BY
        分组字段列表
HAVING
        分组后条件列表
ORDER BY
        排序字段列表
LIMIT
        分页参数;
- 基本查询(不带任何条件)
- 条件查询(where)
- 分组查询(group by)
- 排序查询(order by)
- 分页查询(limit)
基本查询(不带任何条件)
-- 查询多个字段
select 字段1, 字段2, 字段3 from  表名;

-- 查询所有字段(通配符)
select *  from  表名;

-- 设置别名
select 字段1 [ as 别名1 ] , 字段2 [ as 别名2 ]  from  表名;

-- 去除重复记录
select distinct 字段列表 from  表名;
⭕补充:
- *号代表查询所有字段,在实际开发中尽量少用(不直观、影响效率)
- as关键字可以省略,别名建议不要起中文,但是要有意义
条件查询(where)
select 字段列表 from 表名 where 条件列表 ; -- 条件列表:意味着可以有多个条件
学习条件查询就是学习条件的构建方式,而在SQL语句当中构造条件的运算符分为两类:
- 比较运算符
- 逻辑运算符
常用的比较运算符如下:
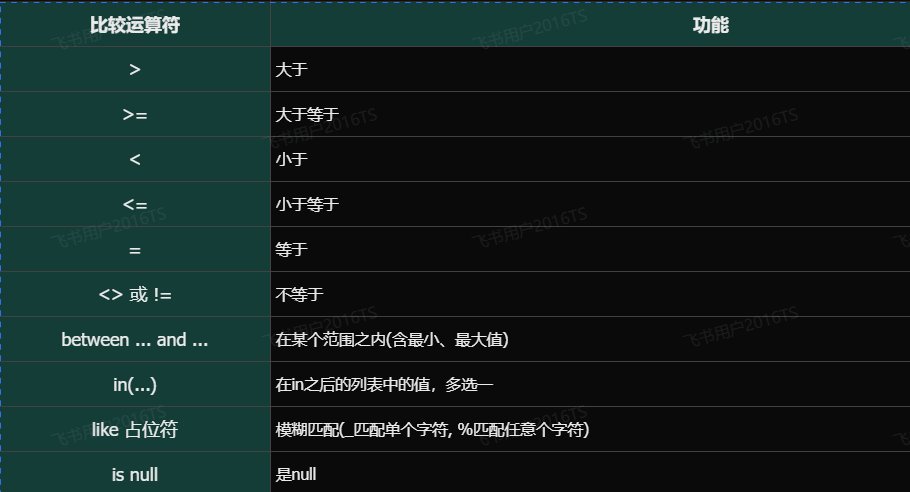
常用的逻辑运算符如下:
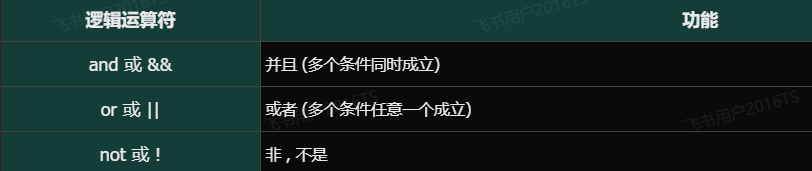
⭕注意:查询为NULL的数据时,不能使用 = null 或 !=null 。得使用 is null 或 is not null。
聚合函数
之前我们做的查询都是横向查询,就是根据条件一行一行的进行判断,而使用聚合函数查询就是纵向查询,它是对一列的值进行计算,然后返回一个结果值。(将一列数据作为一个整体,进行纵向计算)
常用聚合函数:
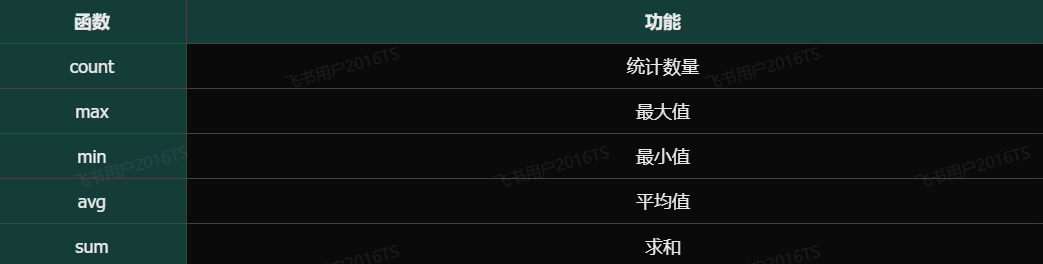
⭕注意 : 聚合函数会忽略空值,对NULL值不作为统计。
- count :按照列去统计有多少行数据。
- 在根据指定的列统计的时候,如果这一列中有null的行,该行不会被统计在其中。
- sum :计算指定列的数值和,如果不是数值类型,那么计算结果为0
- max :计算指定列的最大值
- min :计算指定列的最小值
- avg :计算指定列的平均值
分组查询(group by)
- 分组: 按照某一列或者某几列,把相同的数据进行合并输出。
- 分组其实就是按列进行分类(指定列下相同的数据归为一类),然后可以对分类完的数据进行合并计算。
- 分组查询通常会使用聚合函数进行计算。
select 字段列表 from 表名 [where 条件] group by 分组字段名 [having 分组后过滤条件];
注意事项:
- 分组之后,查询的字段一般为聚合函数和分组字段,查询其他字段无任何意义
- 执行顺序:where > 聚合函数 > having
where与having区别(面试题)
- 执行时机不同:where是分组之前进行过滤,不满足where条件,不参与分组;而having是分组之后对结果进行过滤。
- 判断条件不同:where不能对聚合函数进行判断,而having可以。
排序查询(order by)
排序在日常开发中是非常常见的一个操作,有升序排序,也有降序排序。
select  字段列表
from   表名
[where  条件列表]
[group by  分组字段 ]
order  by  字段1  排序方式1 , 字段2  排序方式2 … ;
- 排序方式:
- ASC :升序(默认值)
- DESC:降序
注意事项:如果是多字段排序,当第一个字段值相同时,才会根据第二个字段进行排序
分页查询(limit)
分页操作在业务系统开发时,也是非常常见的一个功能,日常我们在网站中看到的各种各样的分页条,后台也都需要借助于数据库的分页操作。
select 字段列表 from 表名 limit 起始索引, 查询记录数 ;
注意事项:
- 起始索引从0开始。 计算公式 :起始索引 = (查询页码 - 1)* 每页显示记录数
- 分页查询是数据库的方言,不同的数据库有不同的实现,MySQL中是LIMIT
- 如果查询的是第一页数据,起始索引可以省略,直接简写为 limit 条数

 浙公网安备 33010602011771号