ManySpeech 带图形界面的电脑端应用程序
ManySpeech GUI
- 支持多种模型的本地推理,本地音频转写,实时录音转写等等
- 支持多种语言,支持指定语种
- 支持超大音频,无时长限制
操作说明
-
下载最新版本软件包,安装并运行ManySpeech
-
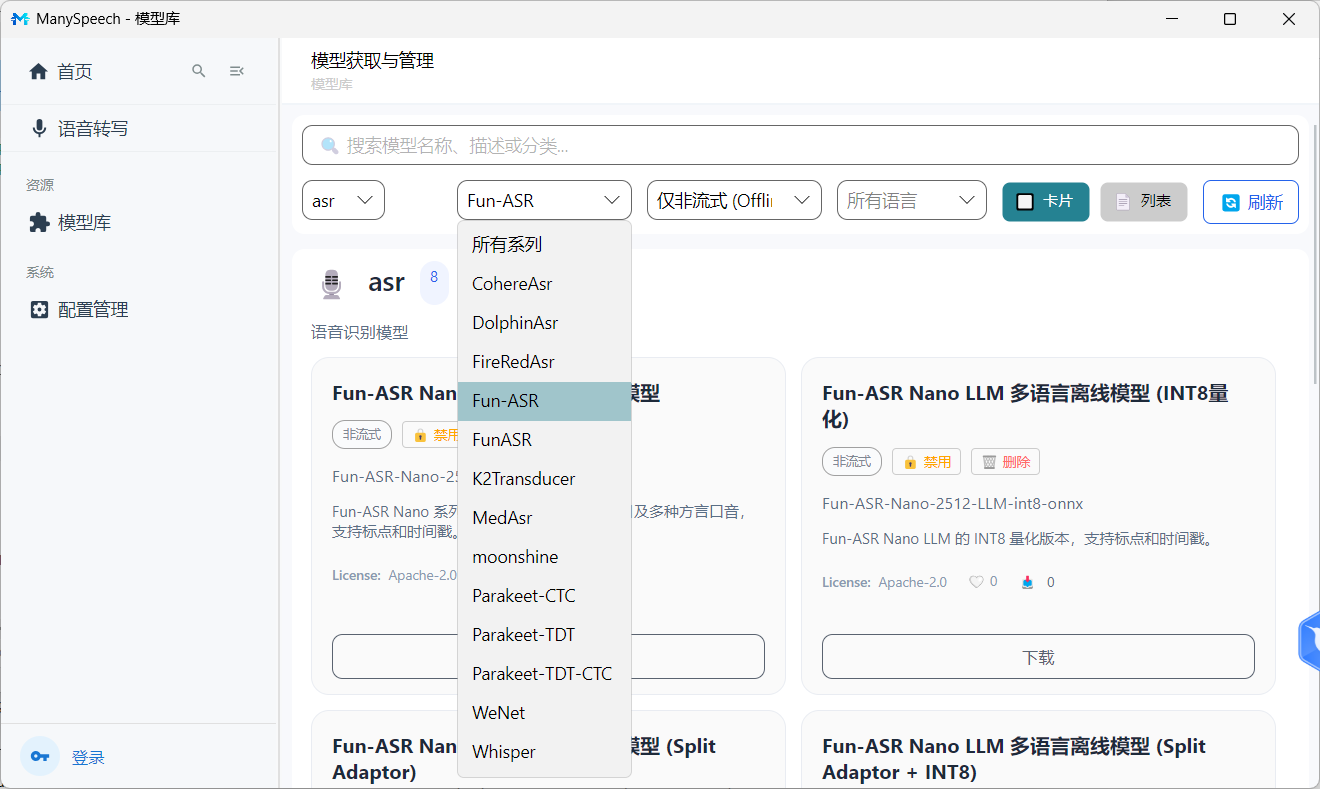
在「模型库」中选择模型,点击下载
-
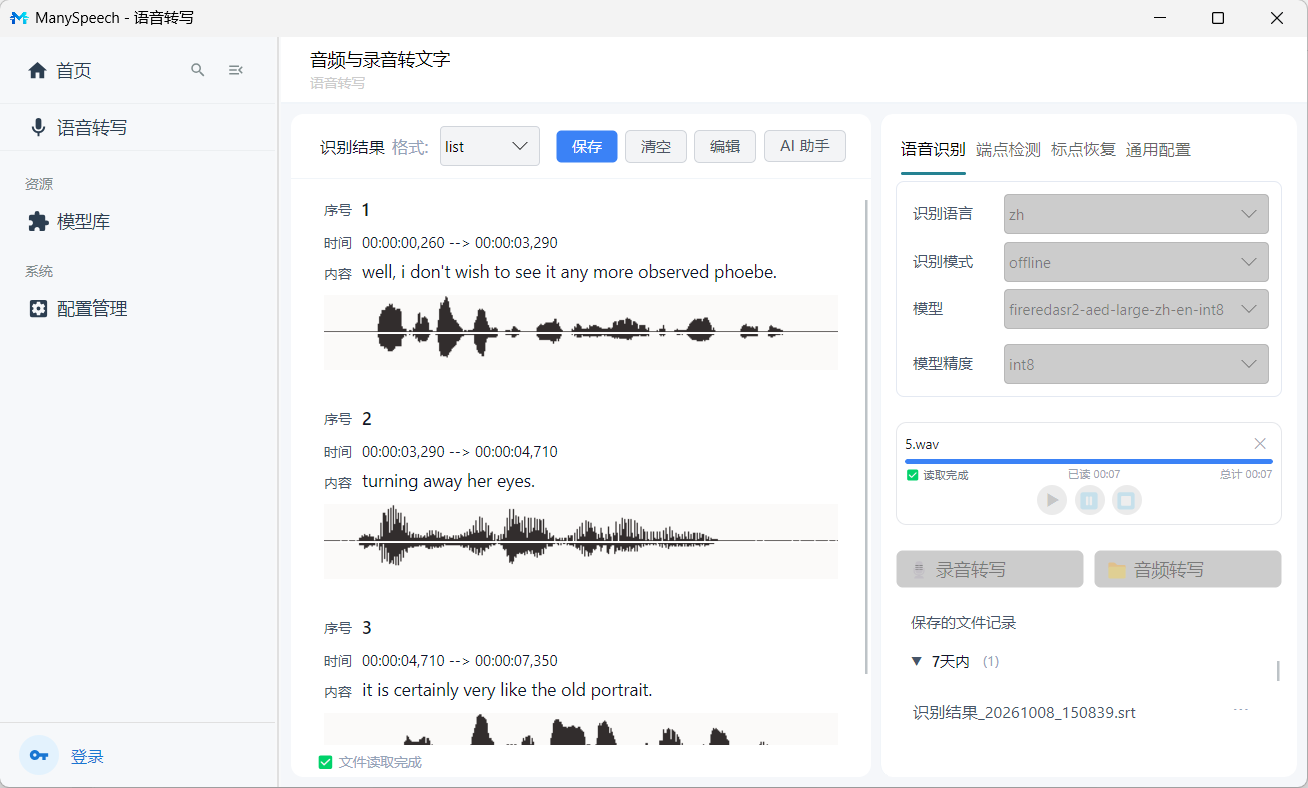
在「语音转写」中通过「识别语言」->「识别模式」筛选模型,并选择需要的模型。
根据使用场景选择转写方式:
- 「录音转写」将调用麦克风进行录音,可实时转写;
- 「音频转写」将打开本地目录,选择音频文件后,进行离线转写。
-
部分模型支持多语种识别与自动语种检测(如 dolphin、Fun-ASR-Nano、Whisper 等),也允许手动指定目标语言。你可以在「通用配置」→「指定语言」→「指定区域」中进行设置;如果不手动配置,大多数场景下会自动识别音频语种。
有的多语种识别模型不支持自动语种检测(例如 cohere),但允许手动指定目标语言,使用时需通过「通用配置」->「指定语言」->「指定区域」设置目标语言,以便获得更准确的识别结果。
运行截图
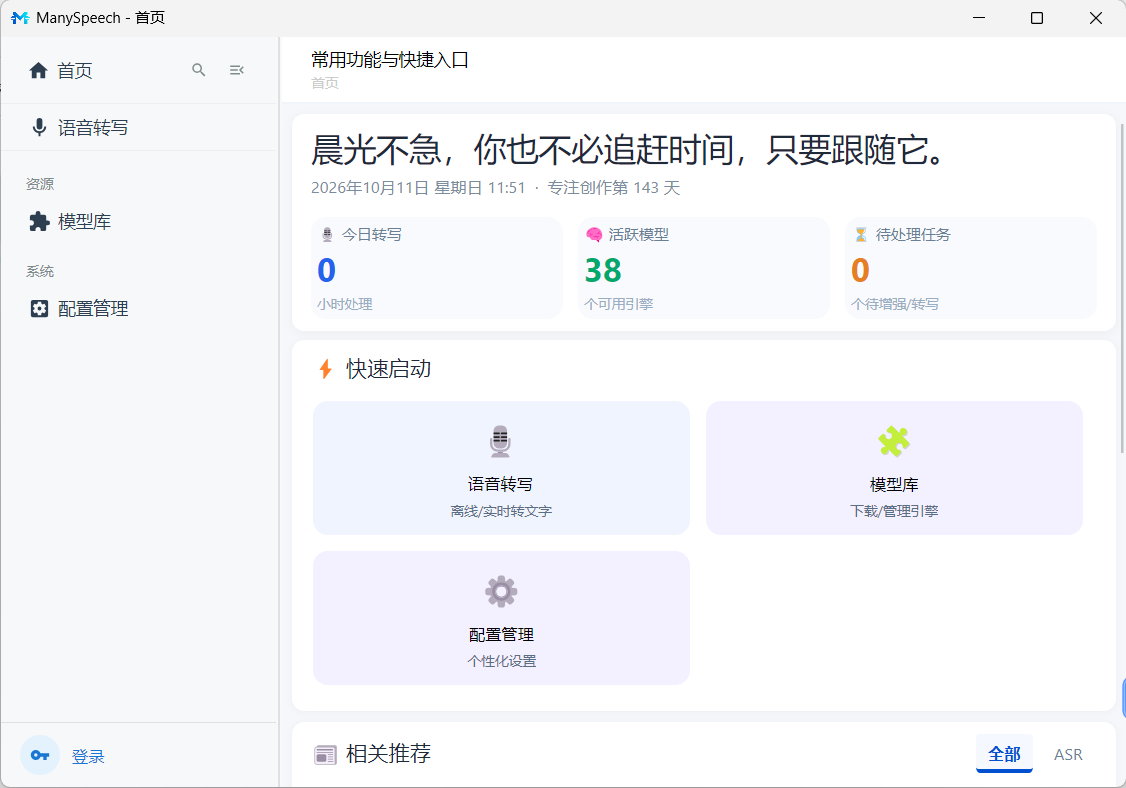
首页:
模型商店:
语音转写:
manyspeech交流-qq群:583249151

 浙公网安备 33010602011771号